Implementación y optimización de vLLM
Línea base de revisión: variante de imagen vLLM 0.29.0, CUDA 12.9; benchmark histórico 0.6.4.post1 separado Última versión comprobada: vLLM 0.31.0 (5 de octubre de 2026), comprobada el 12 de octubre de 2026 Última actualización: October 12, 2026
vLLM es un motor de inferencia de código abierto para modelos generativos y cargas de trabajo multimodales/de pooling compatibles. No debe expandirse como «Vector Language Model». Este capítulo revisa una versión específica y los límites operativos de EKS sin garantías universales de aceleración o compatibilidad con modelos.
Configuración del entorno de laboratorio
Los manifiestos y las comprobaciones locales de este capítulo usan v0.29.0, publicada el 9 de septiembre de 2026. Le siguieron versiones posteriores: v0.30.0 (22 de septiembre de 2026) y v0.31.0 (5 de octubre de 2026).
En v0.31.0:
mm_processor_kwargsymedia_io_kwargspor solicitud se rechazan de forma predeterminada. Permítalos solo con la opción explícita--trust-request-mm-kwargs.- Se eliminó
tokenizer_mode="slow".
Los ejemplos 0.29.0 de este capítulo no se han vuelto a ejecutar en v0.30.0 ni en v0.31.0. Revise los cambios de la versión y la compatibilidad antes de actualizar.
La ruta predeterminada de PyPI/Docker de 0.29.0 usa CUDA 13.0, con una imagen v0.29.0-cu129 independiente. Parte del texto de instalación etiquetado aún llama a CUDA 12.9 el valor predeterminado; inspeccione la variante/digest real de la imagen.
PyPI requiere Python >=3.10, ❤️.15, mientras que la guía GPU etiquetada enumera 3.10–3.13. Esto no es una garantía para cada combinación de Python/PyTorch/CUDA. La ruta NVIDIA requiere una capacidad de cómputo 7.5 o posterior, lo que excluye V100 (7.0). Los kernels, dtypes y la cuantización pueden imponer requisitos adicionales del dispositivo.
Siga las condiciones de AMI/driver/device-plugin en cargas de trabajo AI/ML. Una imagen CUDA no es una implementación directa para Trainium/Inferentia; valide Neuron u otros plugins de plataforma por separado. Dimensione GPU, RAM y disco para el modelo, la caché y la concurrencia en vez de tratar g5.2xlarge o 50GB como mínimos universales.
Introducción a vLLM
vLLM es un motor de inferencia LLM con las siguientes características:
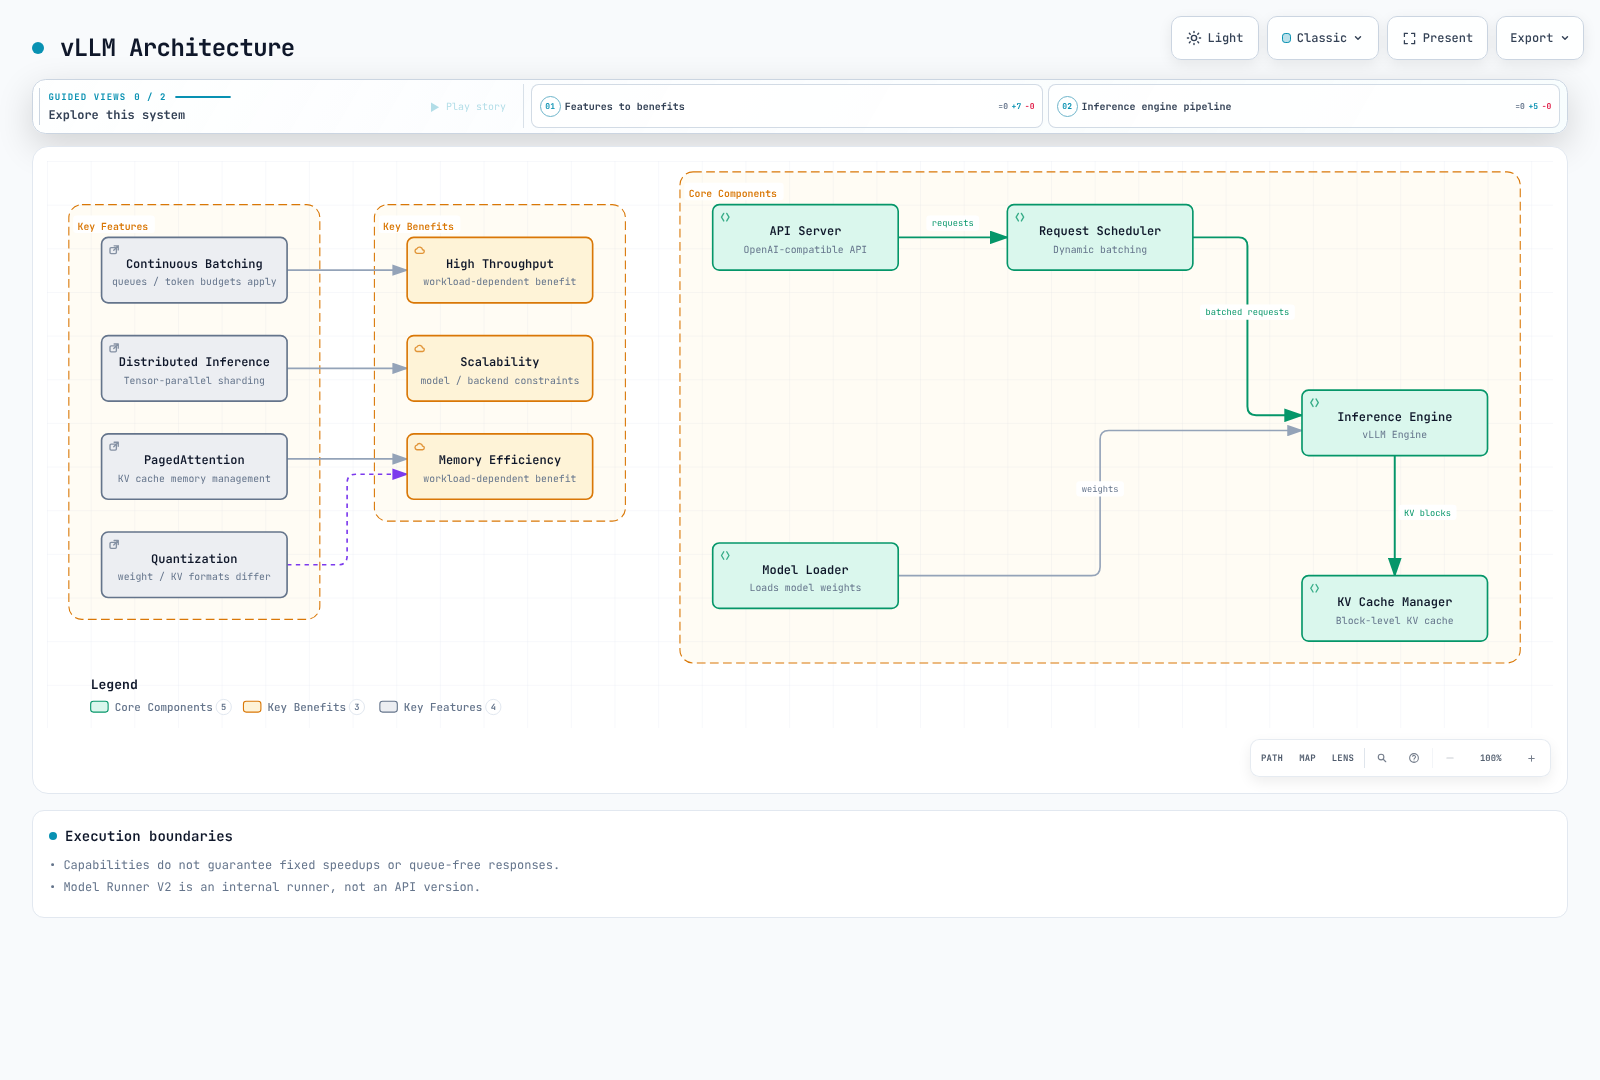
Capacidades y límites de compatibilidad
| Capacidad | Significado y condiciones |
|---|---|
| PagedAttention / caché KV | Gestiona bloques de tokens para reducir el desperdicio; los kernels/diseños de caché dependen del modelo/backend |
| Batching continuo | El scheduler ajusta el trabajo en cada paso; no garantiza admisión inmediata, ni cola ni aceleración fija |
| TP / PP / DP / EP | El paralelismo tensorial, de pipeline, de datos y de expertos son ejes distintos que requieren compatibilidad de modelo/backend/red |
| Precisión / cuantización | Distinga dtypes FP16/BF16 de formatos FP8/INT8/INT4/AWQ, y la cuantización de pesos de la cuantización de caché KV |
| Caché de prefijos / prefill fragmentado | Inspeccione valores predeterminados y anulaciones de modelos compatibles; no es caché de respuesta completa ni mejora de precisión |
| Salidas estructuradas | response_format o structured_outputs restringe el formato; la veracidad y validez empresarial requieren comprobaciones independientes |
| Llamada de herramientas | Requiere un modelo/chat template/parser y un bucle de ejecución del cliente; el servidor no ejecuta herramientas automáticamente |
| LoRA | Requiere compatibilidad del modelo y registro del adaptador; cambiar solo el modelo de la solicitud no carga un adaptador |
0.29.0 establece Model Runner V2 como el runner predeterminado. No es la versión de API compatible con OpenAI ni un «vLLM Engine V2» independiente. Los nombres de familias de modelos no garantizan todos los tamaños, variantes de cuantización o visión; verifique la arquitectura, el artefacto/tokenizer, el chat template y los kernels.
Configuración actual de funcionalidades de CLI
Use vllm serve en lugar de python -m vllm.entrypoints.openai.api_server, que está obsoleto. Las opciones anteriores --speculative-model/--num-speculative-tokens se reemplazan por --speculative-config en la CLI actual.
# Syntax when compatible target/draft models and sufficient memory are prepared.
vllm serve /models/target \
  --speculative-config '{"model":"/models/draft","method":"draft_model","num_speculative_tokens":5}'
Esto ilustra la sintaxis; no proporciona esos archivos de modelo ni establece una aceleración. La aceptación del borrador, la memoria adicional y los costes de comunicación pueden compensar las ganancias.
Registre LoRA al inicio con --enable-lora --lora-modules adapter=/models/adapter. La carga/descarga en tiempo de ejecución requiere la activación independiente VLLM_ALLOW_RUNTIME_LORA_UPDATING y una ruta restringida para operadores. --enable-auto-tool-choice necesita el --tool-call-parser apropiado. Las URL multimodales también requieren controles SSRF, dominios permitidos y límites de descarga/decodificación.
Requisitos del sistema
Requisitos del sistema para implementar vLLM en EKS:
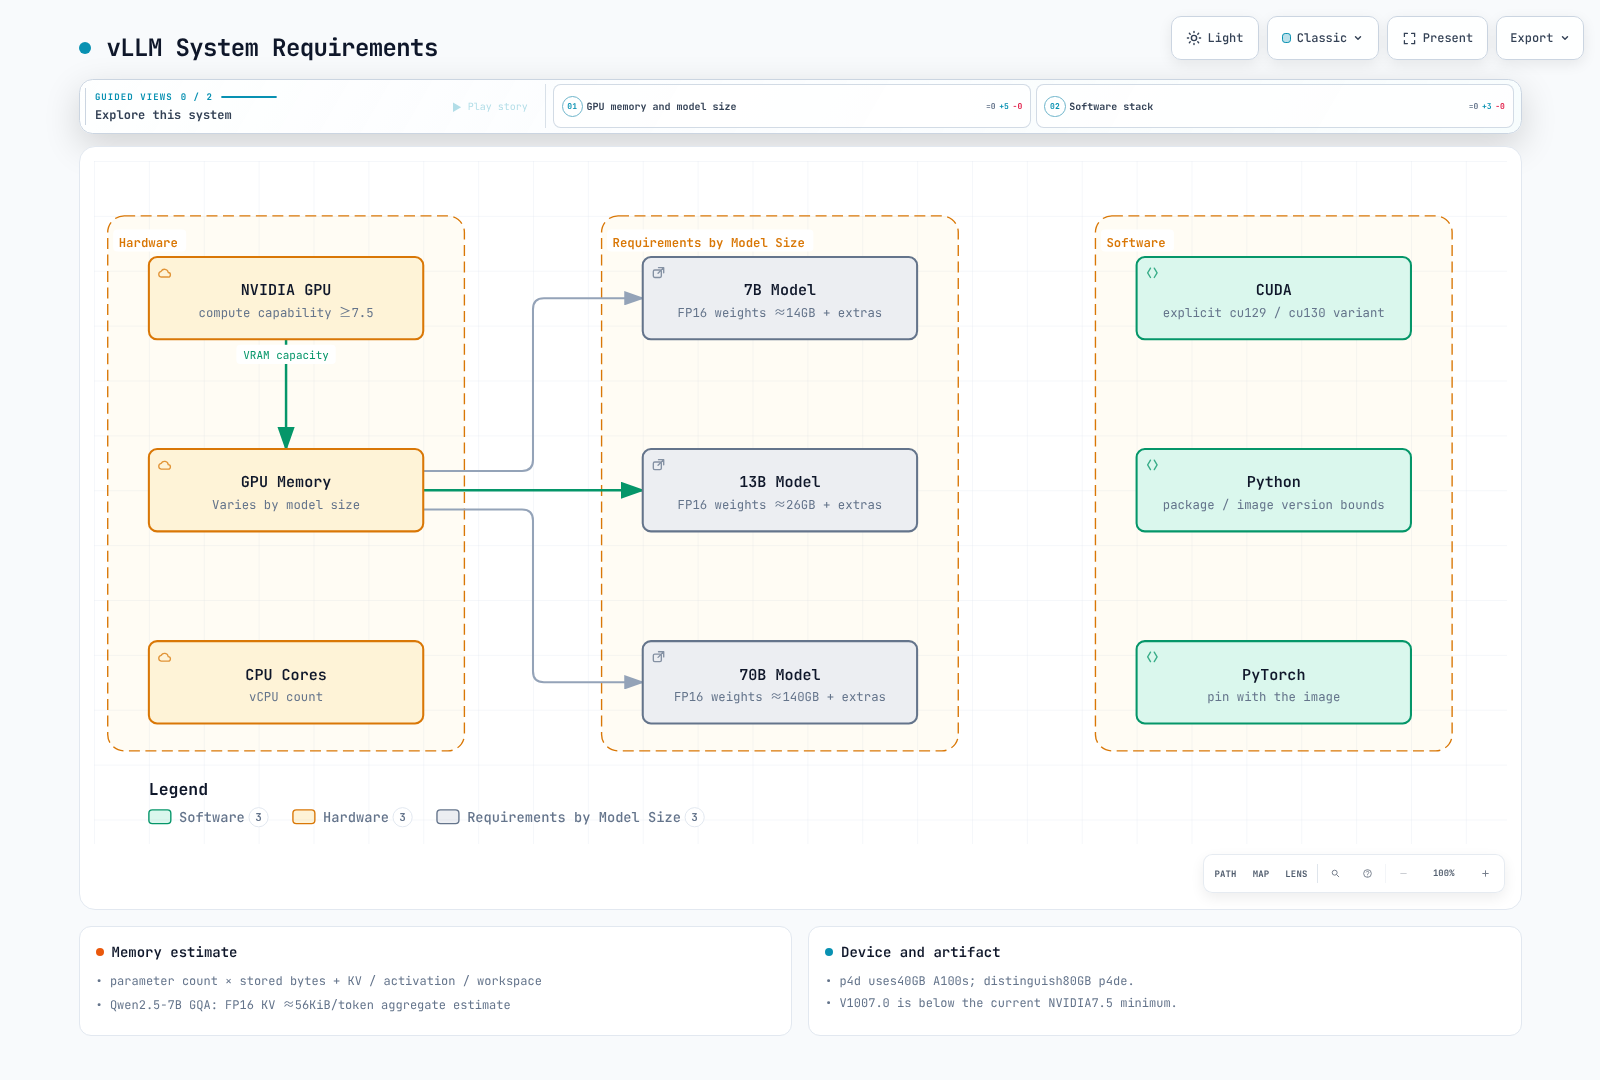
Inicie la estimación de memoria de los pesos con el número de parámetros × bytes almacenados. Los pesos FP16/BF16 por sí solos para 70B son aproximadamente 140GB, por lo que 80GB no es un requisito universal para 70B. Añada la caché KV, activaciones, grafos/espacios de trabajo CUDA y búferes de comunicación, teniendo en cuenta los metadatos de cuantización y tensores replicados.
A continuación se muestra una estimación común de KV con atención densa. Use el recuento de cabezas KV para GQA/MQA en lugar de sustituir el tamaño oculto de una fórmula exclusiva para MHA.
KV bytes ≈ 2 × layers × KV_heads × head_dim × cached_tokens × bytes_per_elementcached_tokens suma los tokens retenidos entre solicitudes concurrentes. El sharding/replicación TP, las ventanas deslizantes, MLA y las arquitecturas híbridas necesitan tratamiento independiente. La configuración actual de Qwen2.5-7B tiene 28 capas, 4 cabezas KV y dimensión de cabeza 128: aproximadamente 56KiB/token con dos bytes por elemento, o 224MiB para una secuencia de 4096 tokens. Es una estimación agregada, no memoria medida por GPU ni memoria total del modelo.
p4d.24xlarge usa A100 de 40GB; distinga las instancias p4de A100 de 80GB. Compare p5/g6/g6e y otras opciones con la capacidad regional, los drivers y las necesidades de la carga de trabajo. Reglas fijas como cuatro núcleos de CPU por GPU o RAM equivalente al doble de los pesos no sustituyen la medición.
Configuración de infraestructura de EKS
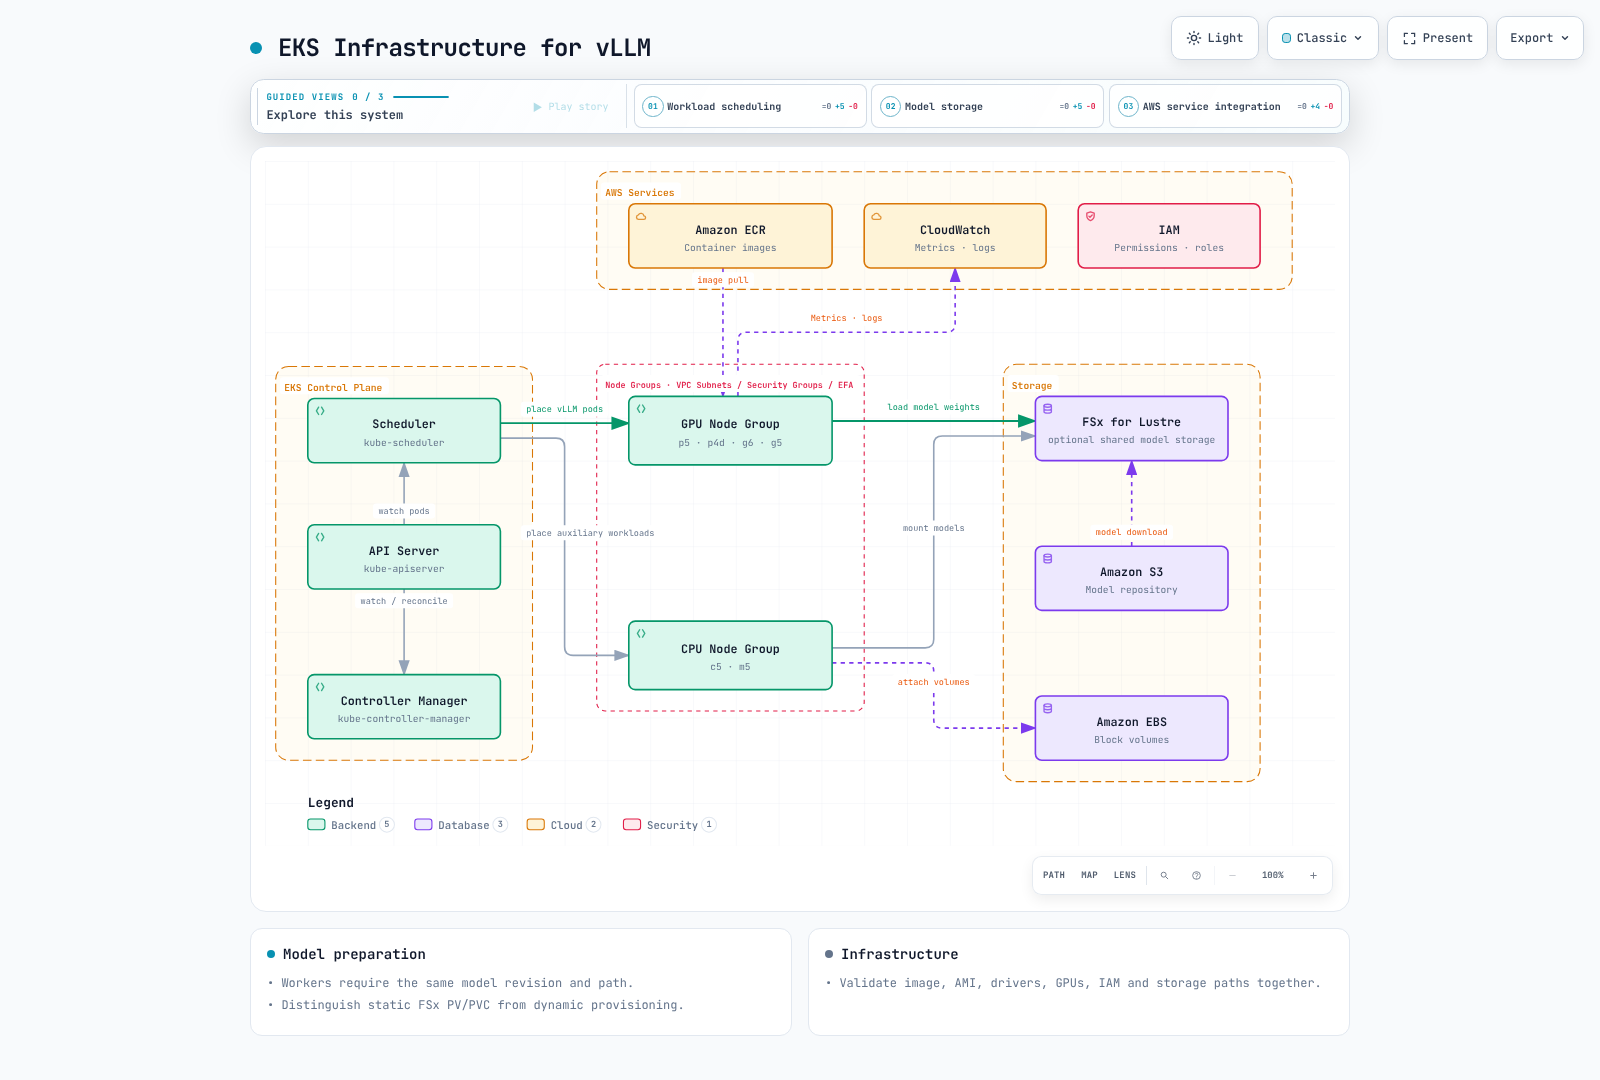
Almacenamiento y preparación de modelos
FSx for Lustre es una opción, no obligatoria ni universalmente óptima. Compare NVMe/EBS local, cachés reutilizables, almacenamiento de objetos y sistemas de archivos compartidos según tiempo de carga, coste y concurrencia. emptyDir puede sobrevivir al reinicio de un contenedor, pero no a la eliminación/recreación de un Pod.
Distinga PV/PVC de FSx estático y aprovisionamiento dinámico. snapshot_download de Hugging Face descarga desde Hugging Face, no desde S3. Registre la revisión del repositorio, integridad, licencia y permisos de acceso. Para modelos restringidos, monte tokens como archivos y use una etapa de descarga que lea el archivo. No habilite de forma predeterminada la confianza en código remoto ejecutable.
El siguiente ejemplo usa una revisión verificada de Qwen3-0.6B público sin un token. Su caché emptyDir vuelve a descargar después de la recreación del Pod. Los workers multinodo requieren la misma revisión/ruta de modelo.
Implementación de vLLM
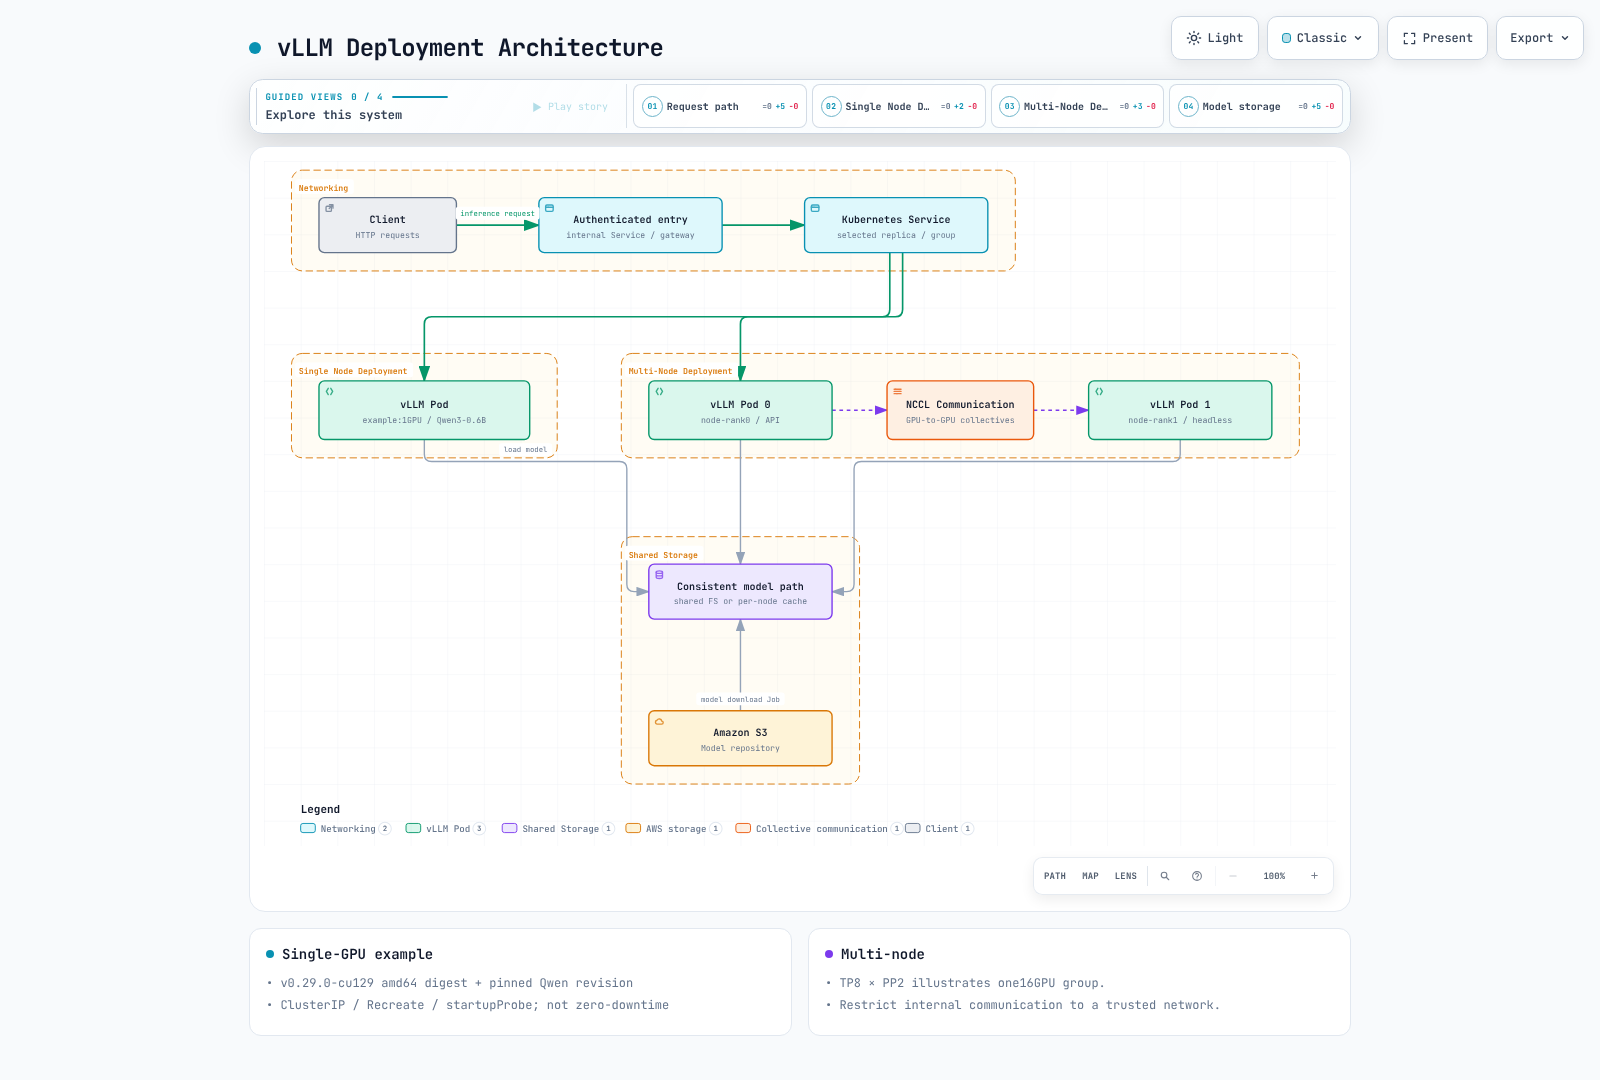
Arquitectura de implementación
El siguiente diagrama muestra dos arquitecturas principales para implementar vLLM en EKS:
Ejemplo de configuración de una sola GPU
Esta es una plantilla para revisión antes de la ejecución en GPU. Prepare el namespace y el driver/plugin de GPU. El digest identifica el artefacto amd64 v0.29.0-cu129; la revisión del modelo identifica la instantánea pública Qwen3-0.6B inspeccionada. La descarga de imagen, la ejecución sin root, la compilación de kernels y la inferencia no se ejecutaron en esta auditoría y requieren validación del entorno.
Recreate evita requerir una réplica de GPU adicional, pero provoca tiempo de inactividad durante la actualización. startupProbe permite unos 15 minutos para el inicio; la disponibilidad no es un SLA. El Service es ClusterIP y no crea ingreso público.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-demo
  namespace: ml-inference
spec:
  replicas: 1
  strategy:
    type: Recreate
  selector:
    matchLabels:
      app: vllm-demo
  template:
    metadata:
      labels:
        app: vllm-demo
    spec:
      automountServiceAccountToken: false
      nodeSelector:
        kubernetes.io/arch: amd64
      securityContext:
        runAsNonRoot: true
        runAsUser: 1000
        runAsGroup: 1000
        fsGroup: 1000
        seccompProfile:
          type: RuntimeDefault
      containers:
        - name: vllm
          image: vllm/vllm-openai@sha256:3e10e8189823e0f7ae4620c271bcdaaf64127ec7d0edc351591a508498b7684a
          command: ["vllm", "serve"]
          args:
            - Qwen/Qwen3-0.6B
            - --revision=c1899de289a04d12100db370d81485cdf75e47ca
            - --served-model-name=qwen3-demo
            - --dtype=float16
            - --max-model-len=2048
            - --max-num-seqs=8
            - --gpu-memory-utilization=0.80
            - --host=0.0.0.0
            - --port=8000
          env:
            - name: HF_HOME
              value: /cache/huggingface
            - name: XDG_CACHE_HOME
              value: /cache
            - name: XDG_CONFIG_HOME
              value: /cache/config
            - name: VLLM_NO_USAGE_STATS
              value: "1"
            - name: VLLM_CACHE_ROOT
              value: /cache/vllm
            - name: TORCHINDUCTOR_CACHE_DIR
              value: /cache/torchinductor
            - name: TRITON_CACHE_DIR
              value: /cache/triton
          ports:
            - name: http
              containerPort: 8000
          resources:
            requests:
              cpu: "2"
              memory: 4Gi
              ephemeral-storage: 4Gi
            limits:
              cpu: "4"
              memory: 12Gi
              ephemeral-storage: 12Gi
              nvidia.com/gpu: 1
          securityContext:
            allowPrivilegeEscalation: false
            readOnlyRootFilesystem: true
            capabilities:
              drop: [ALL]
          startupProbe:
            httpGet:
              path: /health
              port: http
            periodSeconds: 10
            failureThreshold: 90
          readinessProbe:
            httpGet:
              path: /health
              port: http
            periodSeconds: 10
          volumeMounts:
            - name: cache
              mountPath: /cache
            - name: tmp
              mountPath: /tmp
            - name: shm
              mountPath: /dev/shm
      volumes:
        - name: cache
          emptyDir:
            sizeLimit: 8Gi
        - name: tmp
          emptyDir:
            sizeLimit: 1Gi
        - name: shm
          emptyDir:
            medium: Memory
            sizeLimit: 2Gi
---
apiVersion: v1
kind: Service
metadata:
  name: vllm-demo
  namespace: ml-inference
  labels:
    app: vllm-demo
spec:
  type: ClusterIP
  selector:
    app: vllm-demo
  ports:
    - name: http
      port: 8000
      targetPort: http
Fragmentación multinodo frente a réplicas independientes
Fragmentar una réplica de modelo requiere TP/PP más coordinación de Ray o multiprocessing. Las réplicas independientes de servidor API cargan cada una el modelo y proporcionan escalado horizontal; son diseños diferentes.
0.29.0 admite multiprocessing --nnodes, --node-rank, --master-addr y --master-port. Los antiguos ejemplos --rank, --tensor-parallel-rank y --distributed-init-method no son estas opciones de CLI. Con dos nodos preparados que proporcionan ocho GPU cada uno, la forma de los comandos es:
# node0: substitute an actual trusted head IP and identical prepared model path.
vllm serve /models/model --distributed-executor-backend mp \
  --tensor-parallel-size 8 --pipeline-parallel-size 2 \
  --nnodes 2 --node-rank 0 --master-addr 10.0.0.10 --master-port 29500
# node1: the worker does not start a duplicate API server.
vllm serve /models/model --distributed-executor-backend mp \
  --tensor-parallel-size 8 --pipeline-parallel-size 2 \
  --nnodes 2 --node-rank 1 --master-addr 10.0.0.10 --master-port 29500 --headless
Estos comandos no crean nodos, archivos de modelo ni conectividad. Kubernetes requiere creación concurrente adecuada de workers, DNS antes de la disponibilidad, VLLM_HOST_IP por Pod, conectividad interna y memoria compartida. Ray requiere un clúster funcional y una dependencia Ray compatible antes de iniciar un punto de entrada API con --distributed-executor-backend ray; consulte Ray. Mantenga privados los puertos de comunicación interna.
Optimización del rendimiento
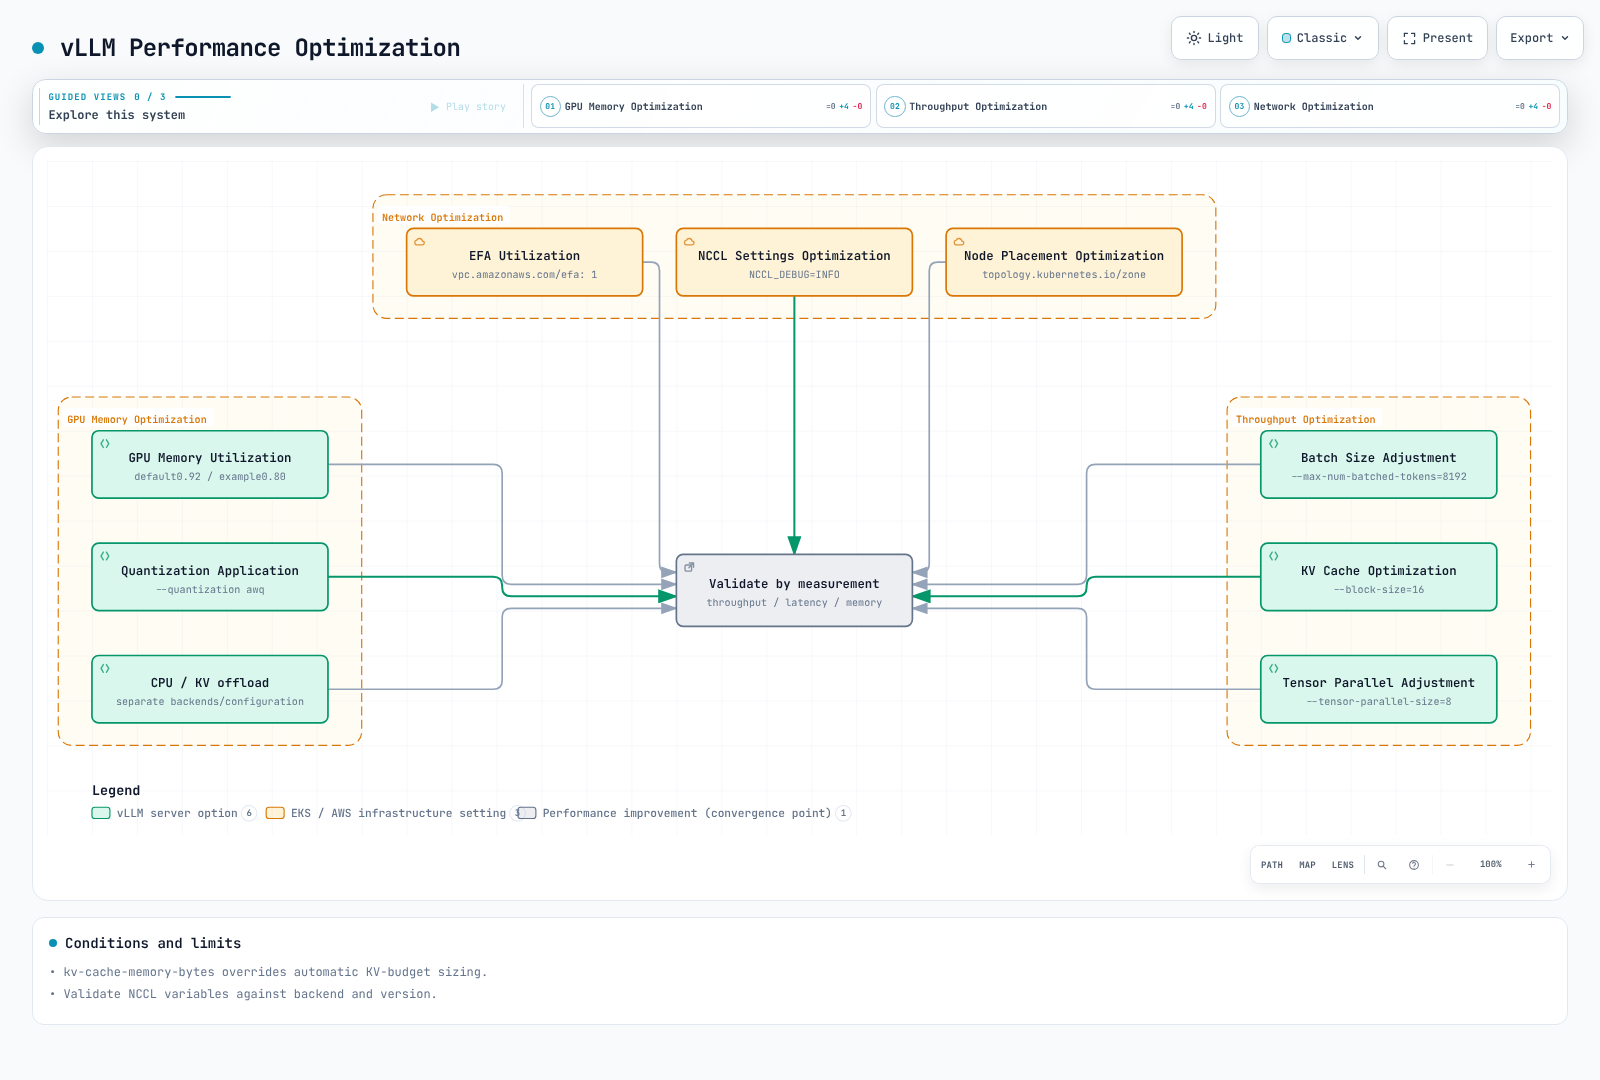
Opciones de memoria, scheduler y comunicación
CacheConfig en 0.29.0 usa gpu_memory_utilization con valor predeterminado 0.92; no es un límite estricto para toda la VRAM del proceso. El ejemplo elige explícitamente 0.80. --kv-cache-memory-bytes anula el dimensionamiento automático de caché KV, por lo que debe inspeccionar la precedencia de opciones.
--swap-space está ausente de la CLI actual. El offload de CPU de pesos y el offload KV son capacidades/configuraciones independientes, no una garantía de que la RAM del host resuelva los límites de GPU. La caché de prefijos puede estar activada de forma predeterminada para modelos compatibles; el prefill fragmentado también depende del modelo. Los límites de cola, presupuestos de tokens, max-num-seqs y max-model-len son controles distintos.
EFA requiere dispositivos EC2 compatibles, AMI/plugin/red y AWS OFI NCCL/libfabric. No copie flags NCCL_IB_ENABLE_RDMA inventados ni configuraciones arbitrarias de mlx5/GID como valores predeterminados universales. Compruebe las variables actuales de NVIDIA/PyTorch y los logs reales del backend. Las pruebas NCCL de un solo nodo no establecen el rendimiento EFA multinodo.
Medición histórica: Qwen2.5-7B en una sola GPU L4
Estas son mediciones históricas reportadas en el commit de repositorio del 4 de septiembre de 2026. Esta auditoría no encontró resultados brutos de solicitudes/logs de servidor ni un artefacto de cliente completo, y no volvió a ejecutar el experimento. Los números reportados se conservan, no se reetiquetan como rendimiento actual de 0.29.0 ni como resultados reproducidos independientemente.
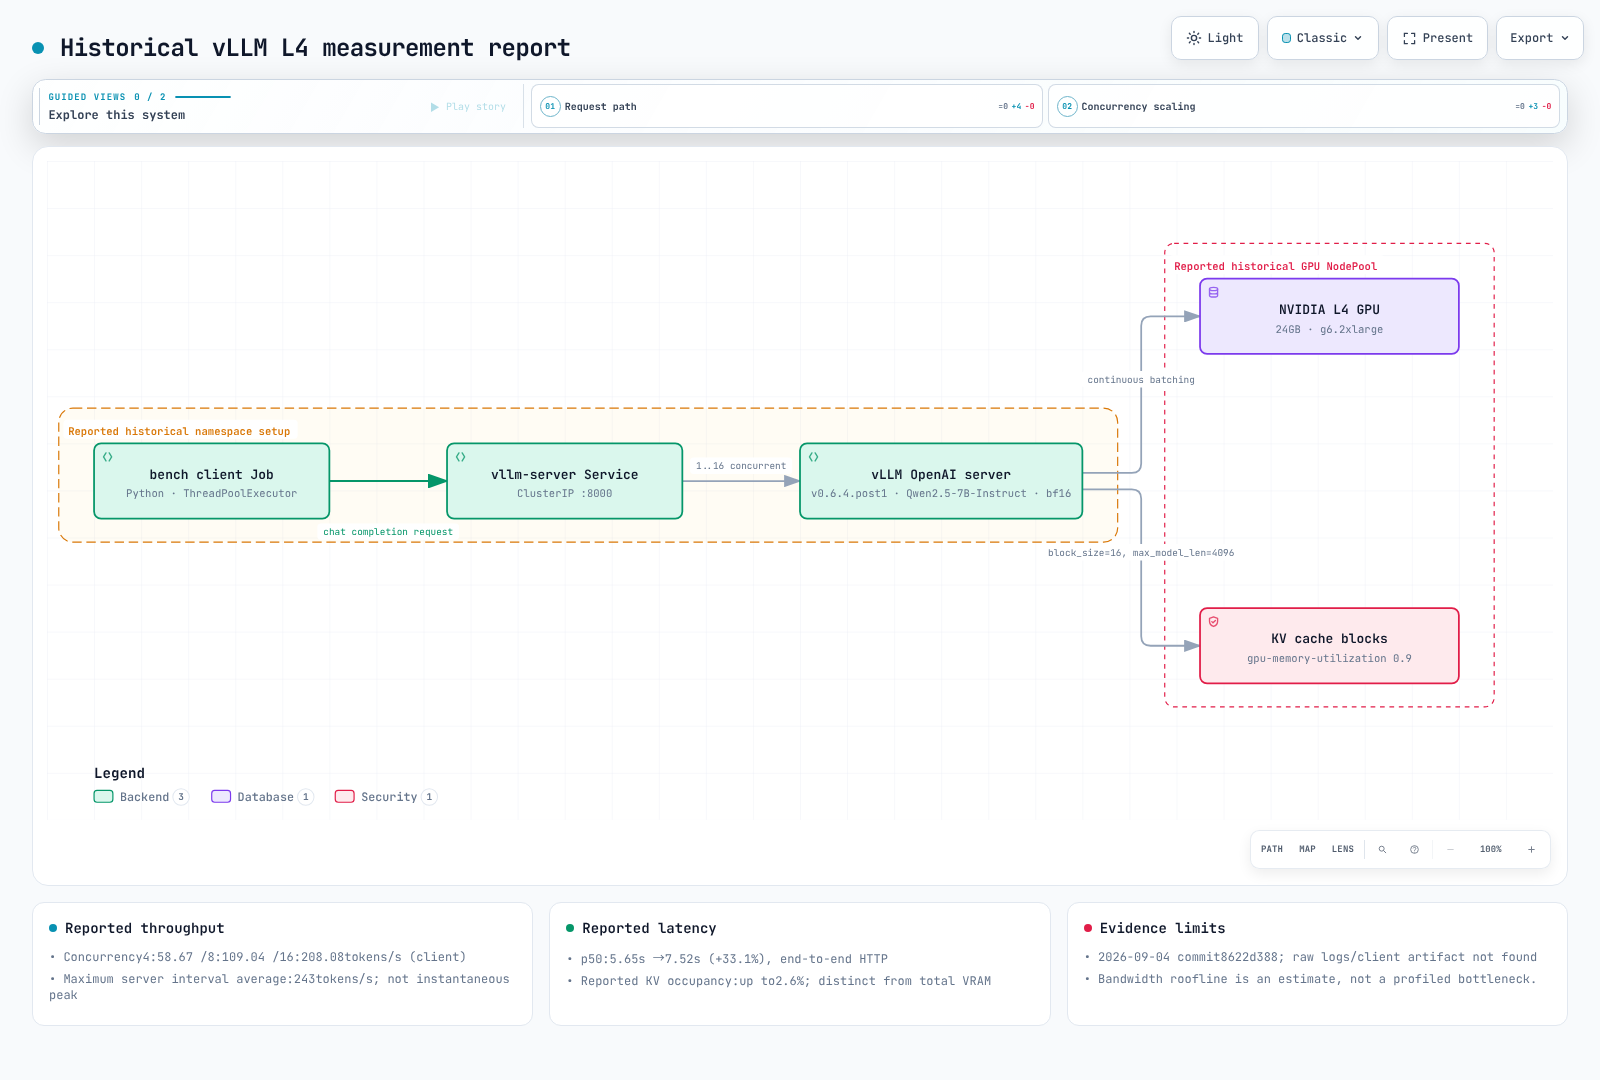
Configuración
- Clúster: un NodePool de Karpenter dedicado (
bench-gpu, bajo demandag6.2xlarge— 1x NVIDIA L4, 24GB de memoria GPU, 8 vCPU, 32 GiB de RAM), con taintnvidia.com/gpu=true:NoScheduley etiquetado para unirse a los daemonsets existentes denvidia-device-plugin, eliminado inmediatamente después de la ejecución. - Servidor:
vllm/vllm-openai:v0.6.4.post1(publicado el 2024-11-15 — desde entonces el proyecto vLLM ha lanzado su motor V1 con caché de prefijos activada de forma predeterminada, así que trátelo como una instantánea de esa línea de versiones, no como vLLM actual), modeloQwen/Qwen2.5-7B-Instruct,--dtype bfloat16 --max-model-len 4096 --gpu-memory-utilization 0.90. Una precisión (bf16, el dtype nativo del modelo) sin cuantización, decodificación especulativa ni caché de prefijos — los valores predeterminados simples que esta página describe en otro lugar. - Cliente: un Python
ThreadPoolExecutorejecutado como un Job dentro del clúster (un nodo independiente sin GPU), que llama a/v1/chat/completionsmediante el Service ClusterIPvllm-server. Sin streaming,temperature=0,max_tokens=128, 8 prompts cortos rotativos (preguntas sobre conceptos de Kubernetes que solicitan respuestas de 1-2 oraciones). En la práctica, cada respuesta se ejecutó cerca del límite de 128 tokens (una media consistente de ~102 tokens en los tres lotes concurrentes) en lugar de detenerse en 1-2 oraciones — útil para comparar el throughput de forma equivalente entre niveles de concurrencia, pero conviene saberlo antes de leer las cifras de latencia como «tiempo para responder una pregunta corta». - Inicio en frío: desde el log de inicio del motor vLLM hasta que su endpoint
/healthdevolvió200, unos 4.5 minutos — dominados por la descarga de los ~15 GB de pesos de Qwen2.5-7B-Instruct desde Hugging Face a la caché efímera del pod. El tiempo de descarga de la imagen no está incluido; no se midió por separado.
Reproducir
# NodePool (Karpenter) - dedicated, deleted after the run — nodeClassRef points at the cluster's existing GPU EC2NodeClass (AMI/subnets/SG), not shown here
apiVersion: karpenter.sh/v1
kind: NodePool
metadata: { name: bench-gpu }
spec:
  limits: { cpu: "16", memory: 128Gi, nvidia.com/gpu: "1" }
  template:
    metadata:
      labels: { node-type: bench-gpu, nvidia.com/device-plugin.config: default }
    spec:
      expireAfter: 6h
      nodeClassRef: { group: karpenter.k8s.aws, kind: EC2NodeClass, name: gpu }
      requirements:
        - { key: node.kubernetes.io/instance-type, operator: In, values: [g6.2xlarge] }
      taints: [{ key: nvidia.com/gpu, value: "true", effect: NoSchedule }]
---
# vLLM server (namespace bench-gpu) + the ClusterIP Service the client calls
apiVersion: apps/v1
kind: Deployment
metadata: { name: vllm-server, namespace: bench-gpu }
spec:
  replicas: 1
  selector: { matchLabels: { app: vllm-server } }
  template:
    metadata: { labels: { app: vllm-server } }
    spec:
      nodeSelector: { node-type: bench-gpu }
      tolerations: [{ key: nvidia.com/gpu, value: "true", effect: NoSchedule }]
      containers:
        - name: vllm
          image: vllm/vllm-openai:v0.6.4.post1
          args: ["--model", "Qwen/Qwen2.5-7B-Instruct", "--max-model-len", "4096",
                 "--gpu-memory-utilization", "0.90", "--dtype", "bfloat16"]
          ports: [{ containerPort: 8000 }]
          resources:
            limits: { nvidia.com/gpu: "1" }
            requests: { nvidia.com/gpu: "1", cpu: "3", memory: 20Gi }
          readinessProbe: { httpGet: { path: /health, port: 8000 }, initialDelaySeconds: 30, periodSeconds: 10, failureThreshold: 60 }
---
apiVersion: v1
kind: Service
metadata: { name: vllm-server, namespace: bench-gpu }
spec:
  selector: { app: vllm-server }
  ports: [{ port: 8000, targetPort: 8000 }]
Los manifiestos muestran parte del entorno reportado. Omiten la creación del namespace, el EC2NodeClass existente y un script de cliente completo, por lo que no establecen una reproducción completa. nvidia.com/device-plugin.config:default era una condición de esa configuración compartida de DaemonSet, no un requisito universal de etiqueta de programación. La afirmación reportada bajo demanda también necesita la configuración histórica real.
Resultados
| Concurrencia | Solicitudes | Tiempo de pared | Latencia p50 / p90 del cliente | Throughput agregado del cliente | Throughput máximo de generación informado por el servidor | Uso de caché KV de GPU |
|---|---|---|---|---|---|---|
| 1 (serie) | 10 | ~53.2 s (suma de latencias de solicitudes) | 5.65 s / 7.43 s | ~17-18 tokens/s por solicitud | ~17 tokens/s | 0.1-0.2% |
| 4 | 16 | 27.78 s | 6.99 s / 7.88 s | 58.67 tokens/s | 65-66 tokens/s | 0.4-0.7% |
| 8 | 32 | 30.02 s | 7.18 s / 8.15 s | 109.04 tokens/s | 123-129 tokens/s | 0.8-1.4% |
| 16 | 64 | 31.35 s | 7.52 s / 8.74 s | 208.08 tokens/s | hasta 243 tokens/s | 1.5-2.6% |
El throughput agregado del cliente es el recuento de tokens de finalización dividido por el tiempo de pared medido. El throughput de generación promedio del servidor es una media de intervalo; su mayor valor registrado no es un «pico verdadero» instantáneo. Las ventanas de tiempo, la contabilidad de tokens y los límites HTTP difieren, por lo que no son métricas directamente intercambiables.
Interpretación
El p50 reportado aumentó de 5.65s a 7.52s, aproximadamente un 33.1%. El throughput agregado con concurrencia 4→8→16 fue 58.67→109.04→208.08tokens/s. Distinga esta observación de batching de la prueba causal del cuello de botella subyacente.
Dividir aproximadamente 300GB/s de ancho de banda entre 15.2GB de pesos ofrece un roofline idealizado cercano a 20 tokens/s. Esta auditoría no tiene evidencia de profiler que mida directamente la ejecución de ancho de banda o FLOP, por lo que no establece «definitivamente limitado por memoria» ni «solicitudes adicionales casi gratuitas». La ocupación de caché KV y el uso total de VRAM son cantidades diferentes.
Advertencias
Esta es una única ejecución (n=1) en un modelo, una precisión (bf16), un tipo de GPU y una longitud de contexto — trátela como un punto de datos calibrado, no como una afirmación general de rendimiento vLLM/L4. El cliente se ejecutó dentro del clúster (un nodo independiente sin GPU), por lo que la latencia de red refleja saltos intra-clúster, no un llamador externo. La latencia aquí es el tiempo de respuesta HTTP completo de extremo a extremo, no el tiempo hasta el primer token (TTFT) — no se probó streaming. No se ejercitaron la caché de prefijos, la decodificación especulativa, FP8 y el paralelismo tensorial multi-GPU (todos descritos anteriormente en esta página). La reproducción completa necesita los artefactos de ejecución y detalles del entorno que faltan; no extrapole estos números a otro tamaño de modelo, GPU o longitud de prompt.
Monitorización y logging
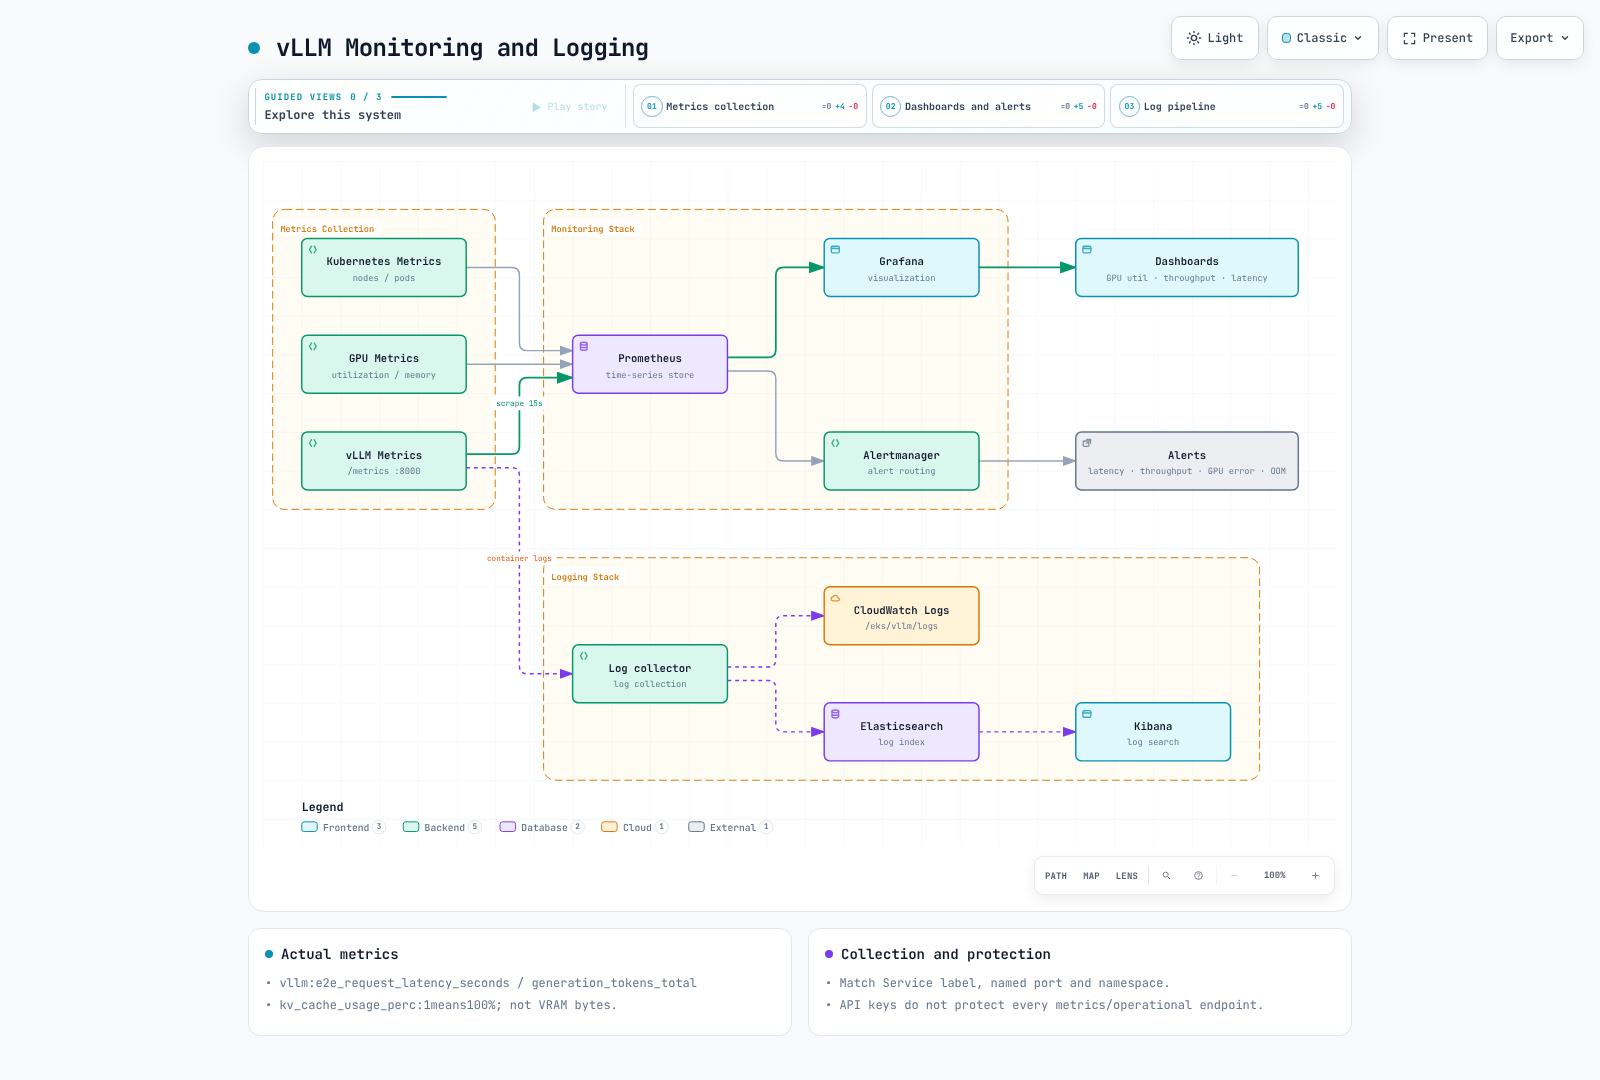
Métricas y logs
El endpoint /metrics predeterminado usa el puerto 8000 de la API. No invente un puerto 8001 independiente ni --enable-metrics=true. Haga coincidir etiquetas de Service, puertos con nombre y selección de namespace en ServiceMonitor.
# End-to-end p95 by model
histogram_quantile(0.95, sum by (le, model_name) (rate(vllm:e2e_request_latency_seconds_bucket[5m])))
# Generation-token throughput
sum by (model_name) (rate(vllm:generation_tokens_total[5m]))
# Queued requests
sum by (model_name) (vllm:num_requests_waiting)
vllm:kv_cache_usage_perc es una proporción donde 1 significa 100%, no bytes totales de memoria GPU. Observe errores/cancelaciones de gateway junto con contadores de éxito, y no denomine los períodos inactivos sanos como una interrupción de bajo throughput. Verifique los nombres/etiquetas reales de endpoints. Distinga el framing CRI de los logs de aplicación y evite el logging indiscriminado de prompts/salidas/tokens.
Autoescalado
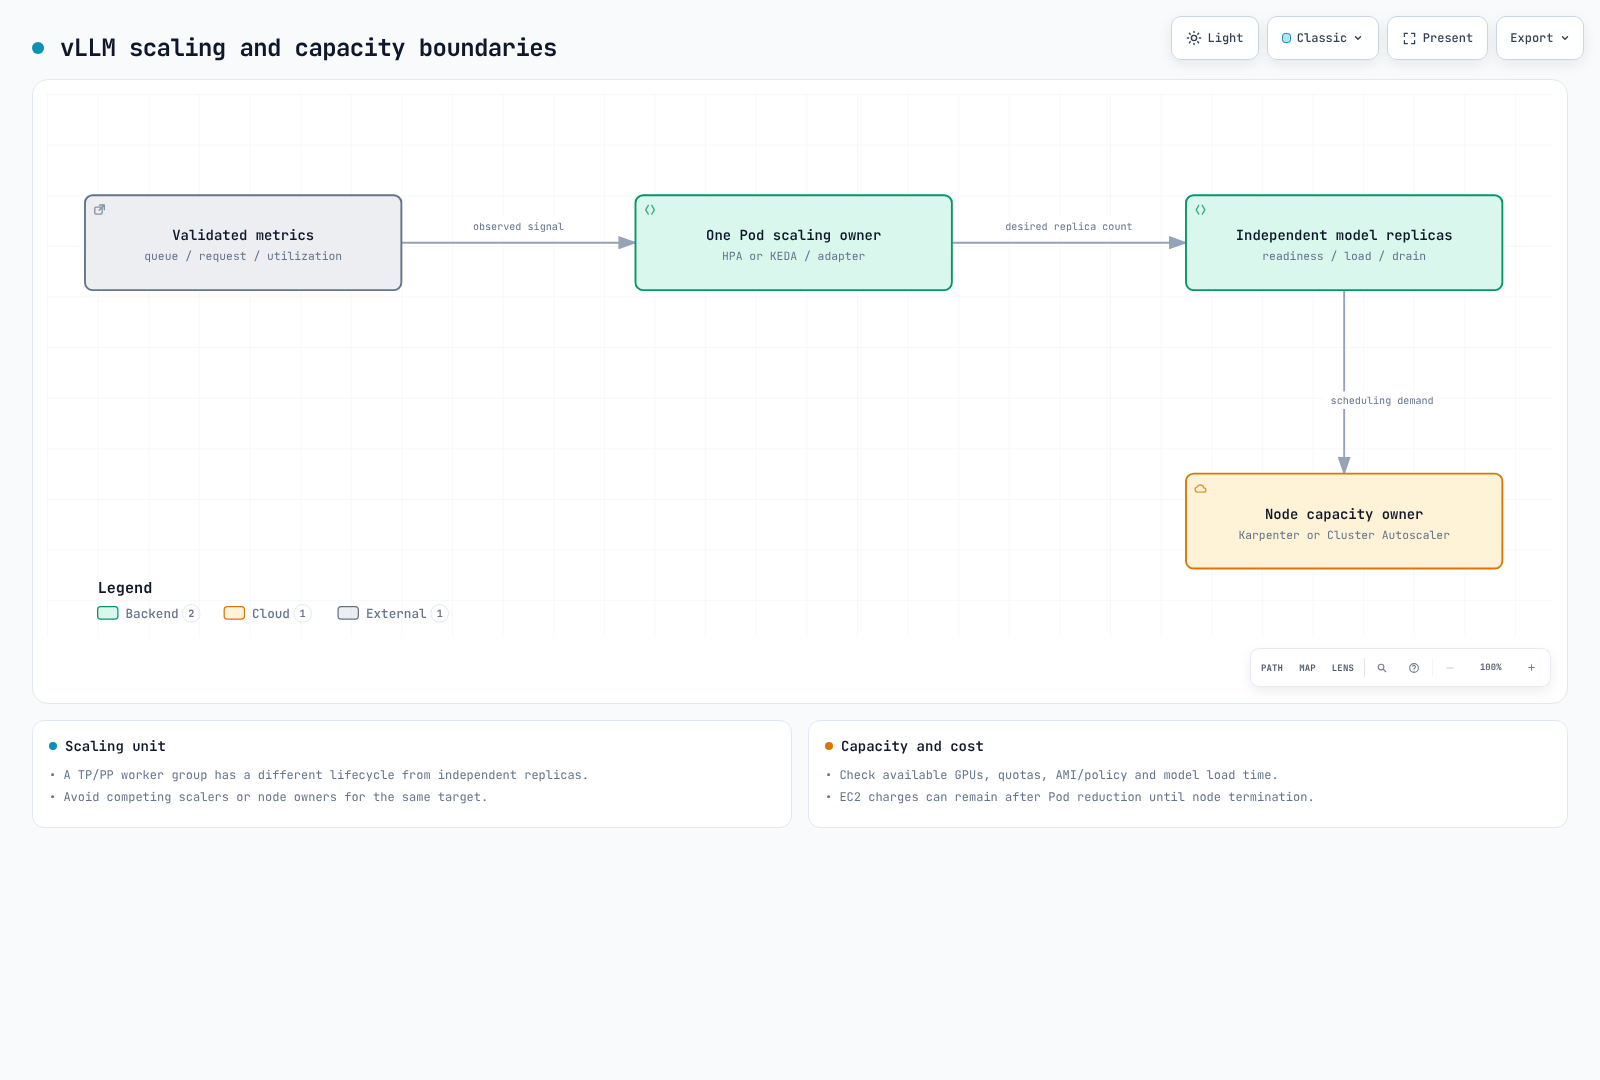
Autoescalado y disponibilidad
El escalado de réplicas independientes con HPA/KEDA difiere del escalado del grupo de workers de un modelo fragmentado. Aumentar las réplicas de StatefulSet no reconfigura automáticamente TP/PP. Valide las señales de solicitudes/cola de adaptadores y no use HPA de utilización de CPU sin solicitudes de CPU. Evite propiedad competitiva de Karpenter/Cluster Autoscaler sobre la misma capacidad.
Los PDB restringen algunas expulsiones voluntarias, no todos los fallos. Las réplicas independientes pueden abarcar AZ; colocar un grupo TP/PP con mucha comunicación entre AZ tiene implicaciones independientes de latencia/coste. Valide carga de modelos, warmup, drenaje, streams en vuelo y GPU de reserva antes de afirmar actualizaciones sin interrupciones.
Configuración de seguridad
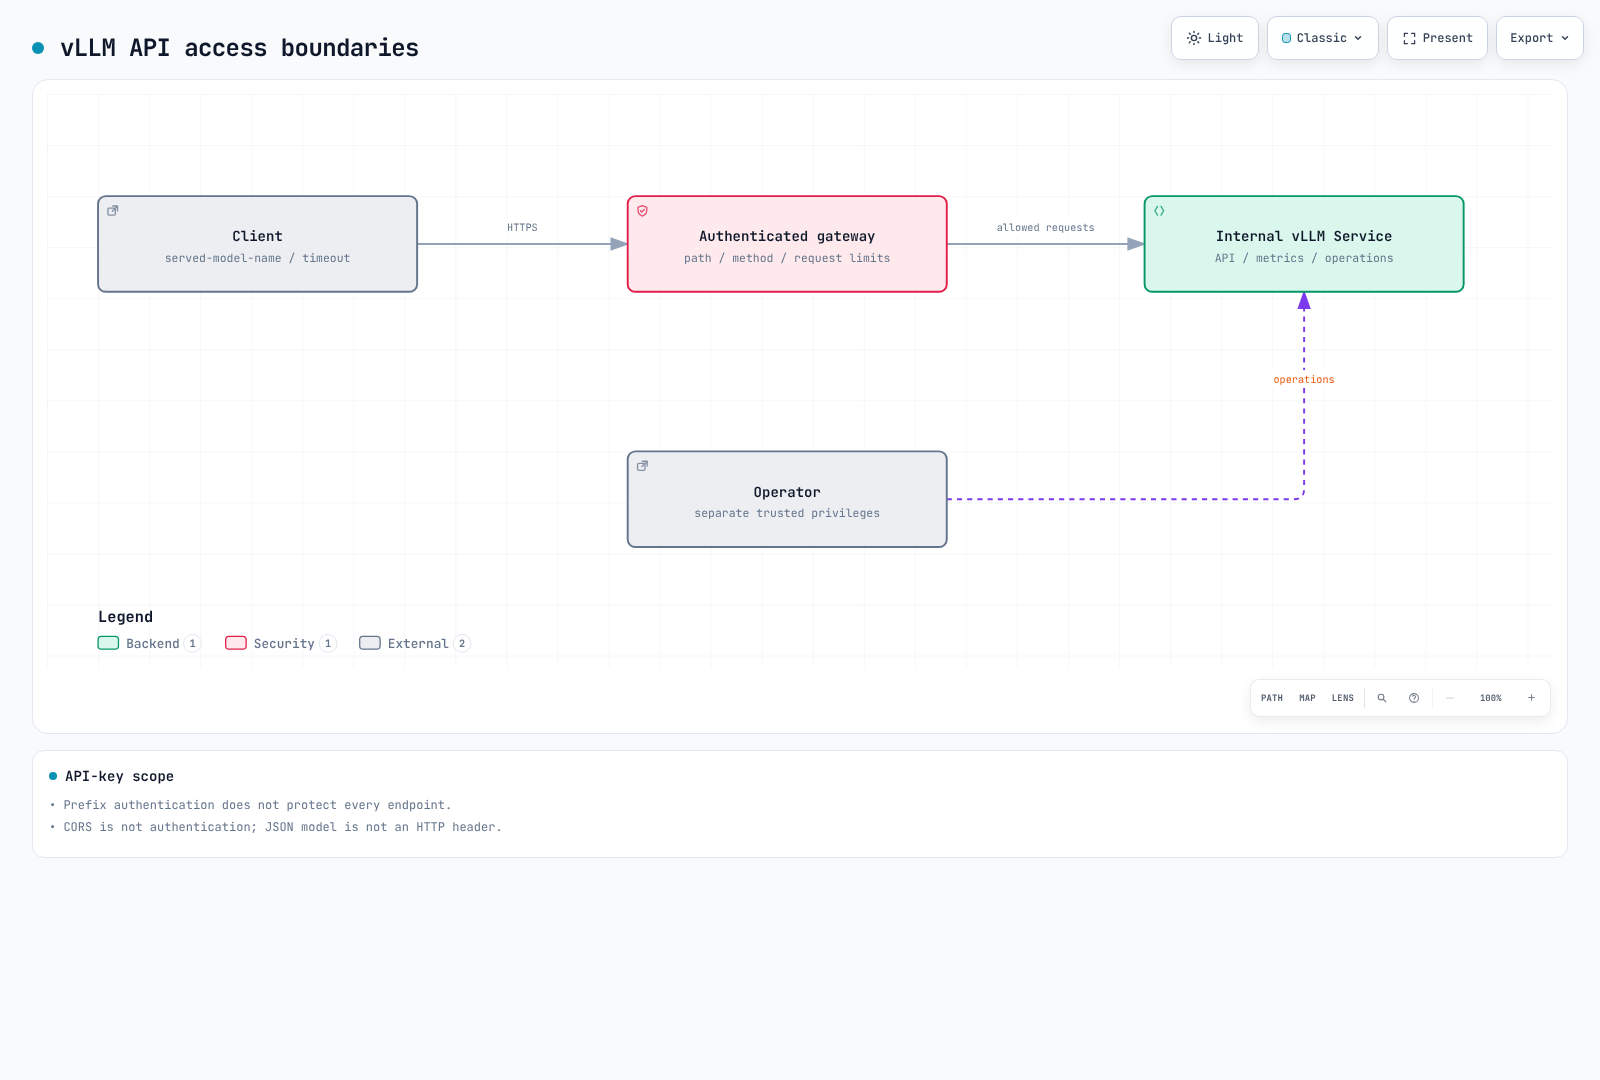
--api-key no protege todos los endpoints. El middleware de esta versión protege los prefijos /v1, /v2, /inference y /cohere; /invocations, /metrics y algunos endpoints operativos necesitan protección adicional. Un gateway autenticado debe permitir solo las rutas/métodos necesarios; restrinja la comunicación distribuida a redes de confianza. CORS no es autenticación.
LoRA en tiempo de ejecución, código de modelo remoto y URL multimodales introducen cada uno límites de confianza/permisos/SSRF. El bloqueo mediante regex de «ignore instructions» no evita toda inyección de prompts ni garantiza la eliminación de PII. Aplique permisos de herramientas/datos independientemente de la salida del modelo.
Proporcione secretos como archivos y ubique correctamente los campos securityContext de Pod/contenedor. Haga coincidir selectores de NetworkPolicy, DNS, dirección de scraping y tráfico interno con la configuración real. Las anotaciones de Pod no pueden habilitar la auditoría de API-server; no registre cuerpos RequestResponse de Secret. La auditoría de control plane de EKS y los logs de acceso de aplicación son independientes.
Integración de cliente
Solicitud de cliente
Después de validar la implementación/disponibilidad, un desarrollador autorizado puede usar kubectl port-forward -n ml-inference service/vllm-demo 8000:8000. Mantenga su vinculación localhost predeterminada. Este ejemplo local no sustituye la autenticación de gateway de producción.
import json
import urllib.request

payload = {
    "model": "qwen3-demo",
    "messages": [{"role": "user", "content": "Explain a Kubernetes Pod briefly."}],
    "max_tokens": 64,
    "temperature": 0,
    "chat_template_kwargs": {"enable_thinking": False},
}
request = urllib.request.Request(
    "http://127.0.0.1:8000/v1/chat/completions",
    data=json.dumps(payload).encode(),
    headers={"Content-Type": "application/json"},
    method="POST",
)
with urllib.request.urlopen(request, timeout=60) as response:
    result = json.load(response)
print(result["choices"][0]["message"]["content"])
El modelo de la solicitud debe coincidir con served-model-name o /v1/models. Los clientes de producción necesitan credenciales de gateway basadas en archivos, además de manejo de timeout/error/stream. Un campo model del cuerpo JSON no es un encabezado HTTP de modelo, por lo que el enrutamiento por encabezado no lo inspecciona automáticamente.
Alcance de validación
Se inspeccionó la fuente fijada para argumentos de CLI, métricas, autenticación y metadatos de artefactos. Los esquemas de Kubernetes/fixtures HTTP locales no validan la ejecución real de parser/kernel/GPU de vLLM. Esta auditoría no descargó pesos de modelos ni creó servidores GPU/recursos de nube.
Referencias
- Versión vLLM 0.29.0 (línea base de revisión)
- Versión vLLM 0.31.0 (última comprobada)
- Paralelismo y escalado
- Límites de seguridad
- Métricas de producción
- Salidas estructuradas
- Adaptadores LoRA
Cuestionario
Para comprobar lo que ha aprendido en este capítulo, pruebe el Cuestionario del tema.