Frameworks de inferencia para servir LLM
Base de revisión: Lanzamientos oficiales, API, charts y comprobaciones locales inspeccionados el 12 de septiembre de 2026; sin ejecución de modelos GPU/Neuron. Última actualización: October 12, 2026
Seleccione por separado los motores de inferencia, las capas de ejecución distribuida, los controladores de Kubernetes y las puertas de enlace de proveedores. «Compatible con OpenAI» no significa endpoints, campos, streaming, llamadas a herramientas ni autenticación idénticos.
Panorama de frameworks de inferencia
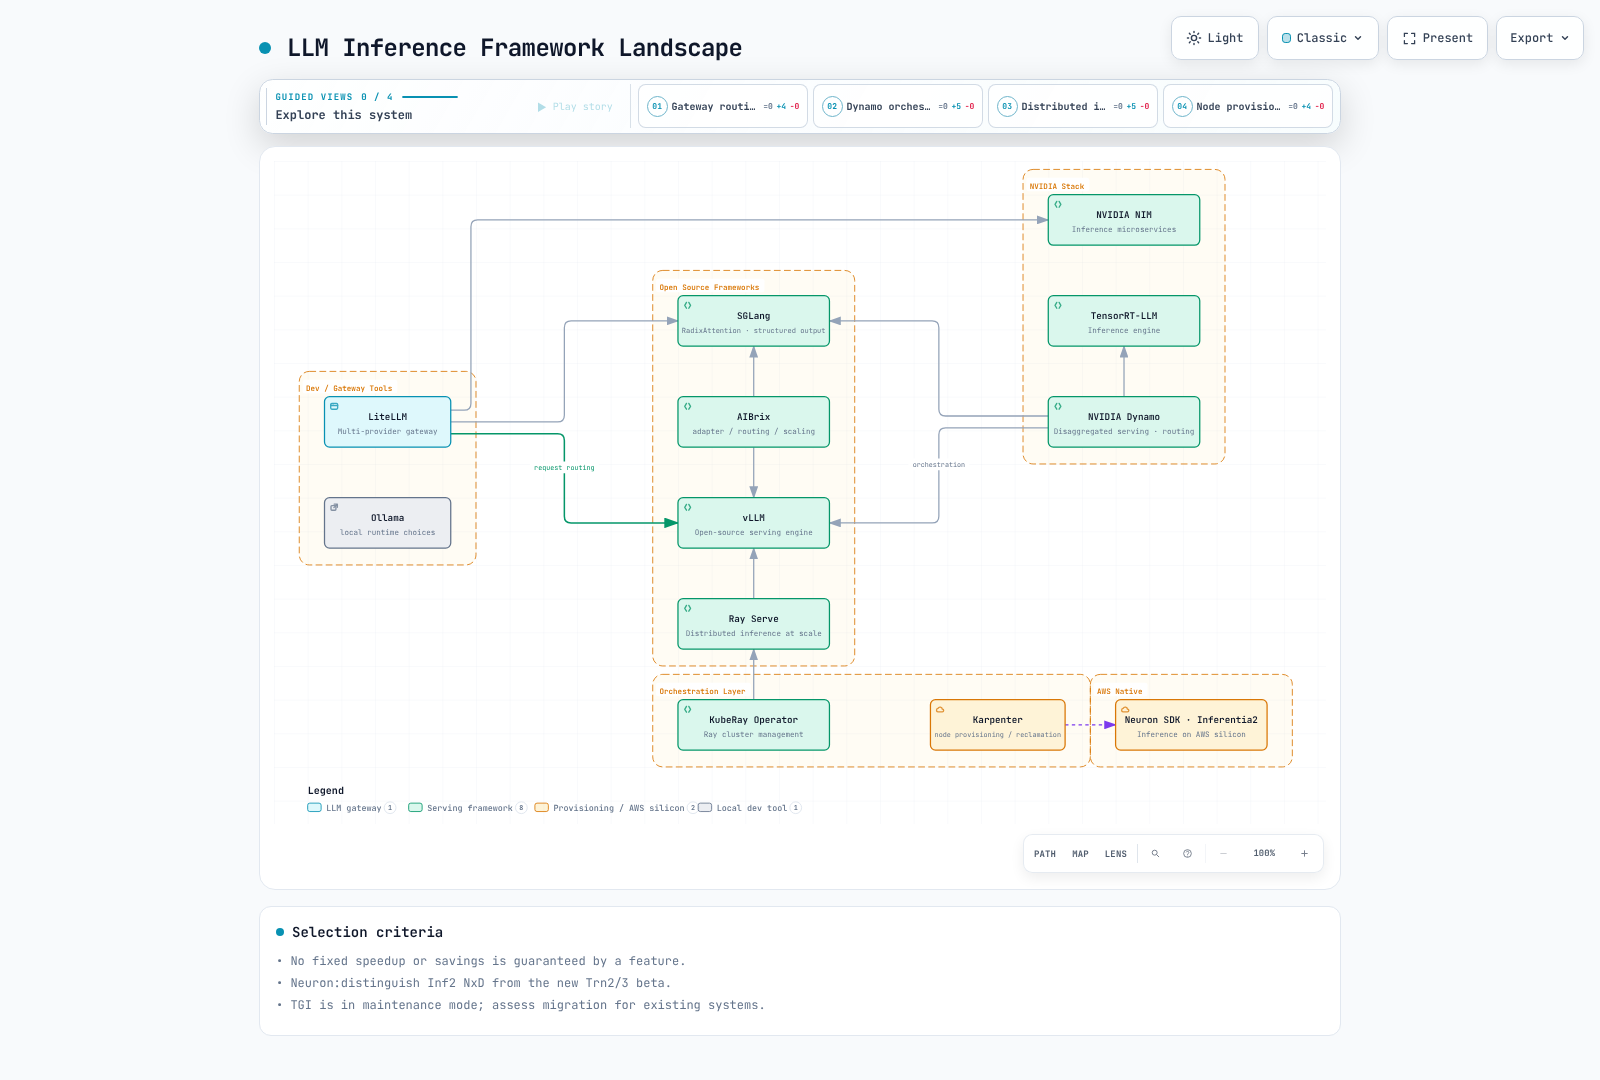
| Componente | Base inspeccionada | Comprobaciones de selección |
|---|---|---|
| NIM LLM/VLM | documentación 2.0.12; oferta 3.0 independiente | Modelo, perfil, hardware, acuerdo de soporte y backend |
| Dynamo | 1.4.2 | Serving agregado/desagregado, transferencia KV, planificador y controlador |
| AIBrix | 0.7.0 | Envoy Gateway, adaptador/controlador y escalado automático |
| SGLang | 0.5.19 | Modelo, backend de gramática, dispositivo y carga de trabajo medida |
| vLLM / Ray Serve | vLLM 0.29.0 / Ray 2.58.0 / KubeRay 1.7.0 | Combinaciones de imagen/modelo/controlador validadas individualmente |
| TGI | 3.3.7; modo de mantenimiento | Mantenimiento de sistemas existentes y planificación de migración |
| Ollama | 0.34.0 | Acceso a API local, almacenamiento y preparación de modelos |
| LiteLLM | 1.100.1 | Adaptación de proveedores, autenticación, fallback e instrumentación de costes |
| Neuron | SDK 2.32.0; Helm 1.10.0 | Compatibilidad del plugin/compilador/controlador específica de la instancia |
vLLM 0.31.0 se lanzó el 5 de octubre de 2026, después de la base de validación local existente 0.29.0 de la tabla. Las versiones de la tabla identifican las combinaciones comprobadas; no afirman ser los lanzamientos más recientes ni un conjunto mutuamente compatible. Consulte la actualización del capítulo de despliegue para el cambio de 0.31.0 que limita de forma predeterminada los argumentos multimodales por solicitud.
Evite una matriz universal de funcionalidades de sí/no. La planificación de Dynamo y la desagregación de vLLM/SGLang, el soporte de CPU y GGUF dependen del lanzamiento, el backend y el hardware. La carga de adaptadores y los alias de modelos no son límites de autenticación de tenants.
NVIDIA NIM
Compruebe conjuntamente el contenedor, el perfil de modelo, la compatibilidad de GPU y el acuerdo de soporte. NIM Operator 3.1.2 es independiente de los contenedores LLM/VLM 2.0.12. El lanzamiento 2.0.12 inspeccionado documenta vLLM 0.27.1; NIM no siempre usa TensorRT-LLM. No trate la oferta 3.0 basada en Dynamo como la misma ruta de despliegue que 2.0.
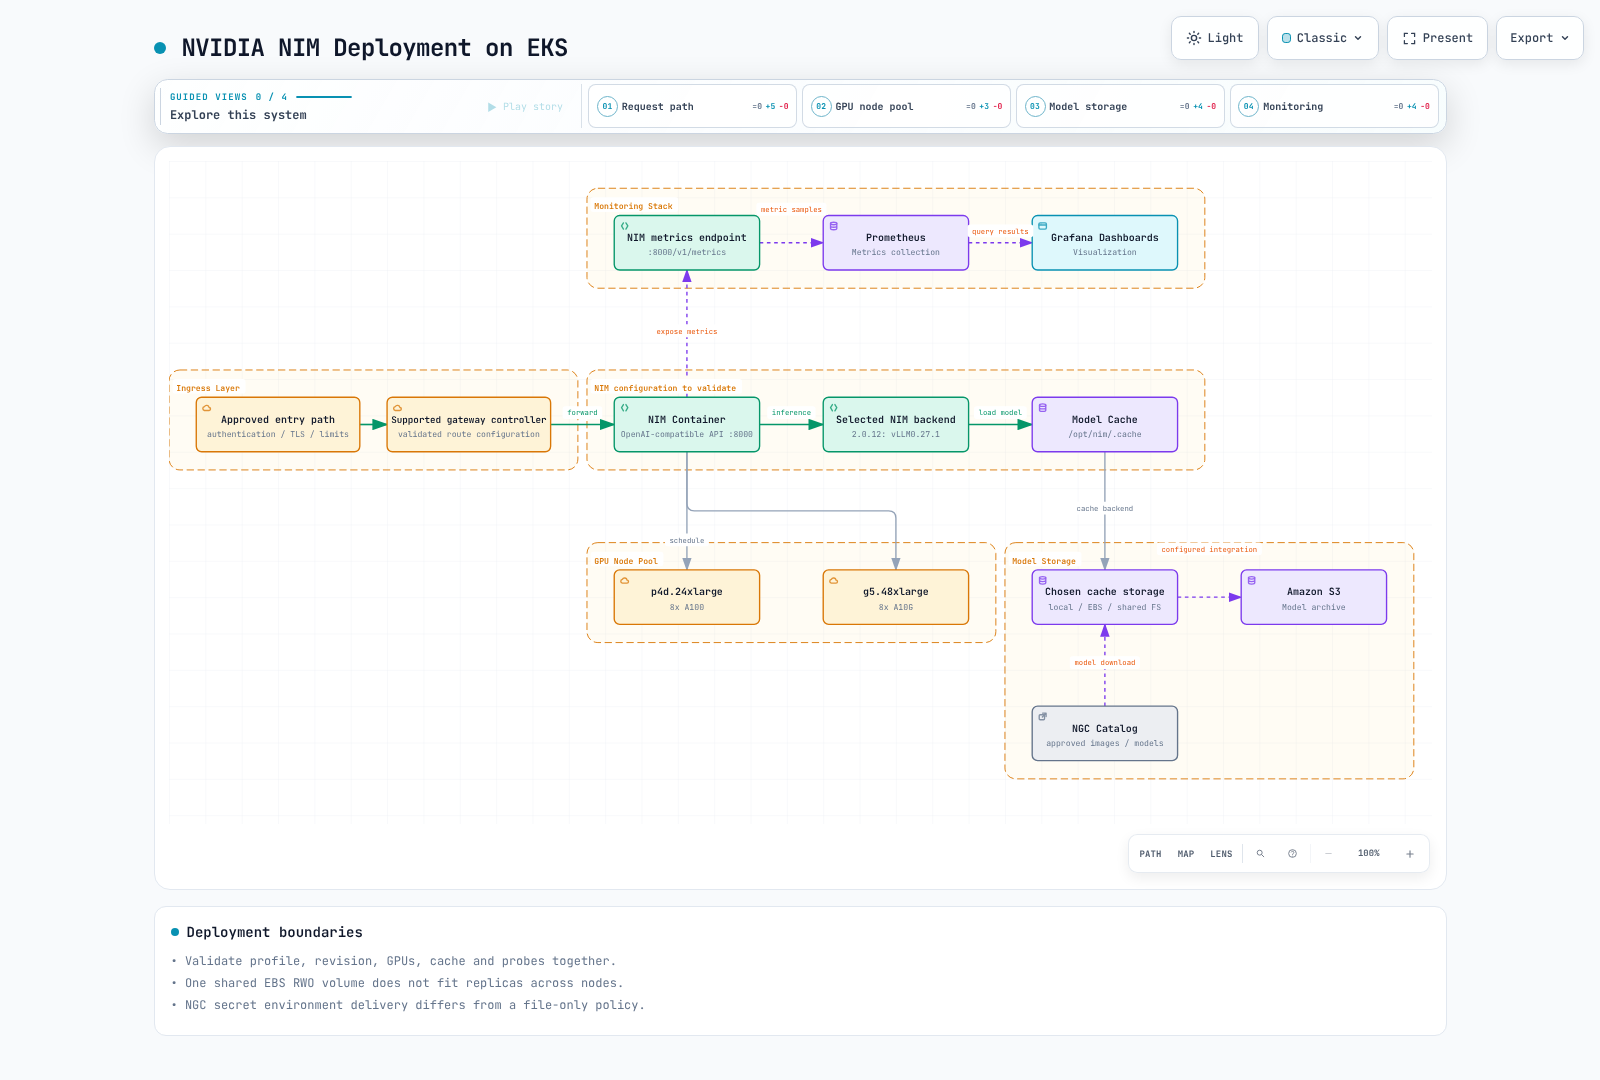
Preparación del despliegue y perfiles
Use la guía de GPU para los requisitos de AMI, controlador/toolkit y plugin de dispositivo. Habilitar siempre la instalación del controlador puede entrar en conflicto con una AMI de proveedor. Compruebe Karpenter NodePool/EC2NodeClass, los recursos reales de CPU/RAM/GPU planificables y los recuentos de dispositivos. Un Pod de ocho GPU no cabe en un nodo de una/cuatro GPU, y las Custom AMI necesitan una configuración explícita de bootstrap de EKS.
Use NIM_MODEL_PROFILE con un ID/nombre de perfil admitido de la lista de perfiles del contenedor. No suponga que el antiguo NIM_MANIFEST_PROFILE ni la cadena inventada vllm-bf16-tp8 son válidos. Registre conjuntamente el digest de imagen, la revisión del modelo, el perfil, los controladores y la verificación real.
Las credenciales de extracción de imágenes NGC y de descarga de modelos en tiempo de ejecución cumplen funciones diferentes. La ruta de entorno NGC_API_KEY documentada no satisface una política de credenciales exclusivamente basada en archivos. Use una ruta de modelo preparado aprobada o un adaptador de credenciales verificado; nunca incluya claves reales en argumentos de shell ni en el código fuente. Un Service interno por sí solo no autentica las solicitudes de inferencia.
Evite compartir un PVC EBS RWO entre réplicas en nodos diferentes. Elija almacenamiento/cachés locales por réplica o un sistema de archivos compartido adecuado, y pruebe el fallo de descarga, el rendimiento de almacenamiento, las sondas de inicio y el rollout. Los modelos no están integrados universalmente en las imágenes, y las cachés no se sincronizan automáticamente con FSx/S3.
Métricas y GenAI-Perf
La documentación de NIM 2.0.12 inspeccionada expone /v1/metrics, pasando las métricas nativas del backend vLLM. Inspeccione los nombres, las unidades y las etiquetas reales en vez de copiar nombres nim_* inventados o /metrics. Un ConfigMap de Grafana necesita el datasource/sidecar correspondiente y el scraping de Prometheus. No muestre segundos sin modificar en un panel de milisegundos.
Defina SLO específicos de la carga de trabajo para TTFT, ITL, latencia de extremo a extremo, throughput exitoso y encolado. Con intervalos de tokens uniformes, la aproximación es TTFT + (output tokens - 1) × ITL, más la sobrecarga independiente de red/postprocesamiento. Objetivos como 500ms o GPU80% no son estándares universales de estado saludable.
GenAI-Perf 0.0.16 usa el subcomando profile y las opciones synthetic-input-tokens-mean/output-tokens-mean. El siguiente comando cargaría un endpoint interno preparado y no se ejecutó en esta auditoría. Prepare primero perf_analyzer, tokenizer y otras dependencias de distribución.
genai-perf profile --endpoint-type chat --service-kind openai --url http://127.0.0.1:8000 --model approved-model-alias --concurrency 2 --synthetic-input-tokens-mean 128 --output-tokens-mean 64 --num-prompts 20 --profile-export-file profile_export.jsonNo suponga que analyze es solo postprocesamiento JSON: los ajustes de barrido pueden realizar perfilado adicional. Conserve las solicitudes sin procesar, los fallos, el tokenizer, el warmup, la concurrencia y las revisiones de modelo/backend. La utilización de GPU necesita recopilación de métricas real.
NVIDIA Dynamo
La ruta oficial de Kubernetes 1.4.2 usa la plataforma Dynamo, DynamoGraphDeployment (DGD) y DynamoGraphDeploymentRequest (DGDR). No está implementada por las antiguas imágenes inventadas dynamo-router/dynamo-worker, KV_CACHE_HOST ni YAML de router arbitrario. Una DGDR solicita perfilado y creación de DGD; no es una inspección de solo lectura.
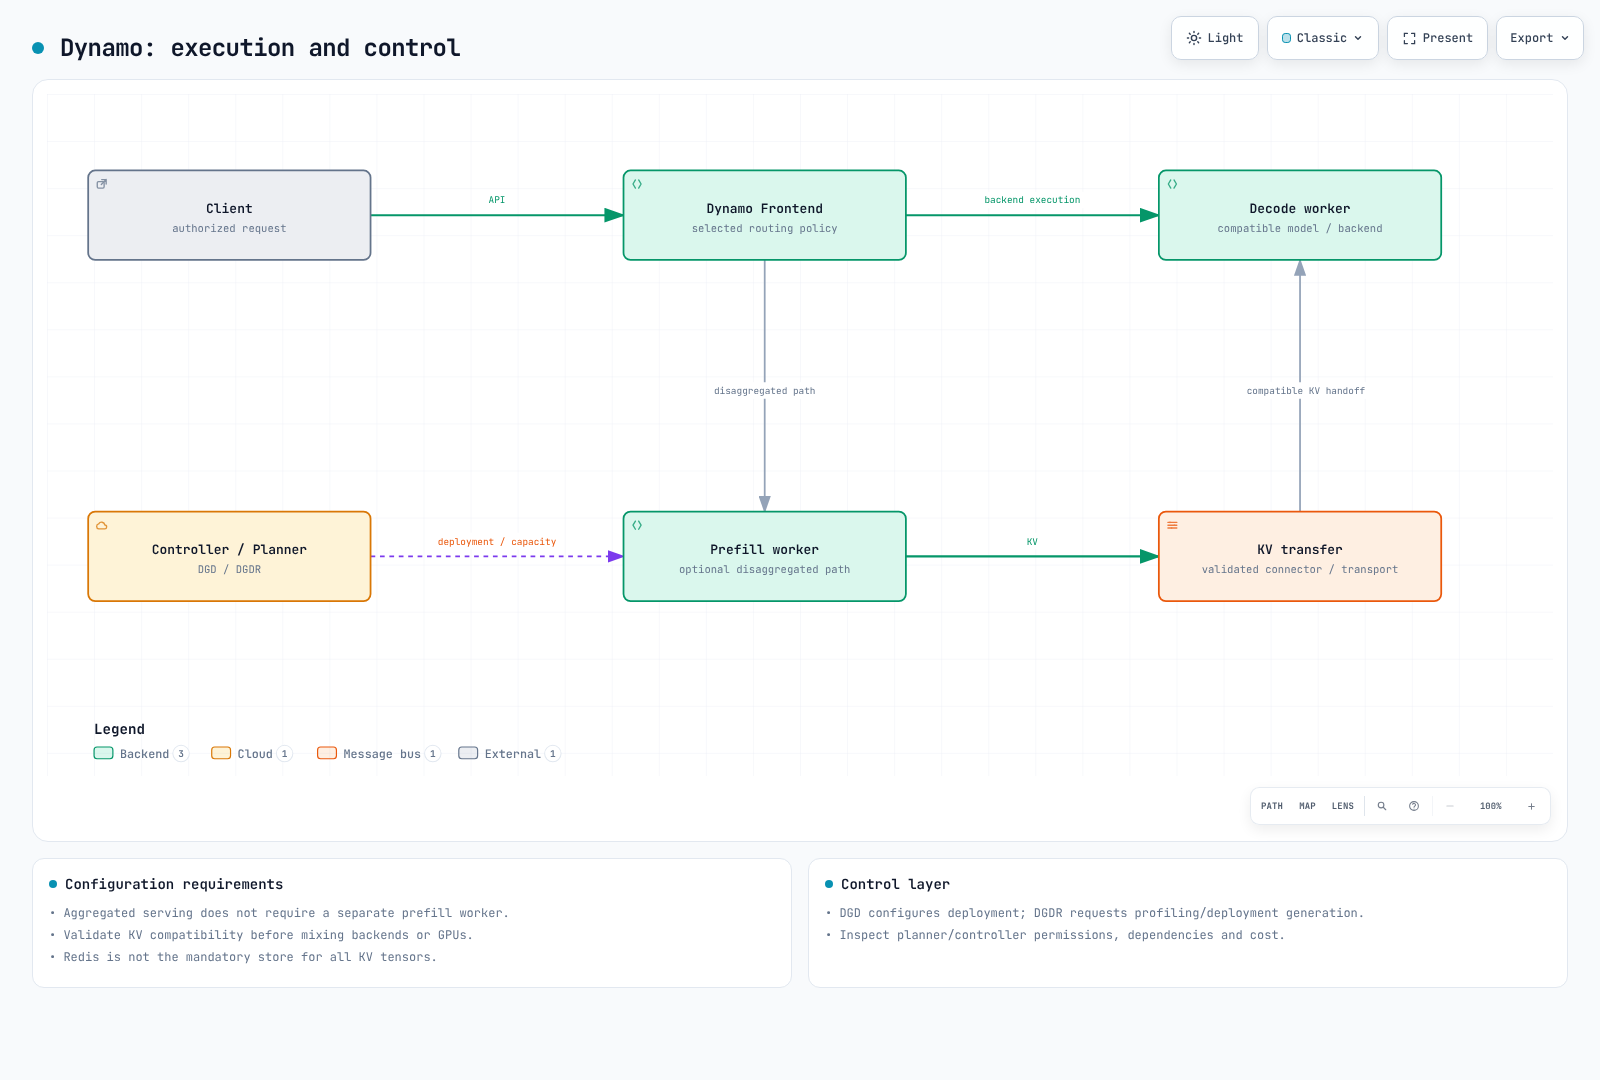
Estructura real de DGD
Esta configuración comprobada contra el esquema adapta el ejemplo oficial agregado v1beta1 1.4.2 para un modelo público y ajustes de ejecución acotados. Requiere la plataforma/controlador, el namespace, GPU, acceso al modelo y redes. Fije los digests de modelo/imagen y verifique el hardware real antes del despliegue; no se ejecutó ningún modelo en esta auditoría.
apiVersion: nvidia.com/v1beta1
kind: DynamoGraphDeployment
metadata:
  name: vllm-agg
  namespace: dynamo-system
spec:
  components:
  - name: Frontend
    podTemplate:
      spec:
        containers:
        - image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.2
          name: main
          resources:
            requests:
              cpu: 250m
              memory: 512Mi
            limits:
              cpu: '1'
              memory: 2Gi
    replicas: 1
    type: frontend
  - name: VllmDecodeWorker
    podTemplate:
      spec:
        containers:
        - args:
          - --model
          - Qwen/Qwen3-0.6B
          - --max-model-len
          - '2048'
          - --max-num-seqs
          - '8'
          command:
          - python3
          - -m
          - dynamo.vllm
          image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.2
          name: main
          resources:
            limits:
              nvidia.com/gpu: '1'
              cpu: '4'
              memory: 12Gi
            requests:
              ephemeral-storage: 2Gi
              cpu: '2'
              memory: 4Gi
          workingDir: /workspace/examples/backends/vllm
    replicas: 1
    type: worker
La desagregación requiere roles de prefill/decode compatibles, conectores/formatos KV, revisiones de modelo y redes. Las combinaciones arbitrarias de backends o GPU no son interoperables automáticamente. El enrutamiento consciente de KV equilibra localidad y carga; una fórmula fija0.7/0.3 no es una implementación universal. Redis no es el almacén obligatorio de tensores KV para todos los despliegues de Dynamo.
El operador de todo el clúster del chart de plataforma inspeccionado administra los CRD mediante un contenedor init crd-apply. upgradeCRD=false selecciona la gestión externa; no elimina el requisito del CRD. Compruebe el planificador, descubrimiento, NATS/etcd, Grove/KAI y otros ajustes específicos del lanzamiento. El renderizado del chart no verifica la aplicación de CRD, la autorización ni el descubrimiento en vivo.
AIBrix
La versión0.7.0 usa Envoy Gateway, un plugin de gateway, controller-manager y servicios de metadatos. KubeRay es opcional para capacidades basadas en Ray. El anterior servidor independiente aibrix-registry y la API /v1/lora/register no son la ruta de instalación 0.7.0 inspeccionada.
ModelAdapter y PodAutoscaler
Los campos reales de ModelAdapter incluyen baseModel, podSelector y artifactURL. Omitir replicas carga el adaptador en todos los Pods coincidentes;1 selecciona un Pod; los demás valores se rechazan. Sustituya el bucket/la revisión de ejemplo y el modelo base por valores aprobados. Verifique por separado los permisos de descarga del controlador, la compatibilidad en tiempo de ejecución, la capacidad/ciclo de vida del adaptador y la autorización del tenant.
apiVersion: model.aibrix.ai/v1alpha1
kind: ModelAdapter
metadata:
  name: support-lora
  namespace: ai-inference
spec:
  baseModel: approved-base-model
  podSelector:
    matchLabels:
      model.aibrix.ai/name: approved-base-model
  artifactURL: s3://REPLACE_WITH_APPROVED_BUCKET/adapters/support/REVISION/
  replicas: 1
PodAutoscaler0.7.0 usa metricsSources y estrategias HPA/KPA/APA, no un ConfigMap de autoscaler arbitrario. Este ejemplo de CPU requiere metrics-server, solicitudes de CPU de la carga de trabajo y el controlador. No valida el escalado basado en colas de GPU. Evite propietarios de escaladores en competencia para el mismo objetivo.
apiVersion: autoscaling.aibrix.ai/v1alpha1
kind: PodAutoscaler
metadata:
  name: model-cpu
  namespace: ai-inference
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: prepared-model-server
  minReplicas: 1
  maxReplicas: 3
  scalingStrategy: HPA
  metricsSources:
  - metricSourceType: resource
    targetMetric: cpu
    targetValue: '70'
Integración de Ray Serve
Use las API auditadas de Ray Serve y KubeRay. La reconciliación de KubeRay, el escalado automático de workers Ray y el escalado automático de réplicas Serve tienen funciones diferentes. No use RayCluster como objetivo de escalado HPA de un Deployment normal ni adivine los nombres y selectores de Service de clúster/Serve generados.
El código y las dependencias deben llegar a los workers de ejecución, no solo al head. user_config no cambia automáticamente los argumentos del constructor; implemente la ruta de reconfigure adecuada. Una API compatible necesita la plantilla de chat, el streaming, la cancelación, los motivos de finalización, el uso y los errores reales. Concatenar cadenas de roles e ignorar stream=true no es suficiente. Se eliminaron los antiguos ejemplos de Ray2.9/operator1.1 y trust_remote_code=True incondicional.
SGLang
La versión0.5.19 RadixAttention reutiliza KV para prefijos comunes; las subcadenas intermedias superpuestas arbitrarias no son prefijos almacenados en caché intercambiables. El modelo, el formato KV y las políticas de acceso deben coincidir. Los backends de gramática actuales incluyen XGrammar predeterminado y las alternativas Outlines/Llguidance. «Siempre10x más rápido debido a FSM comprimido» no es una conclusión general.
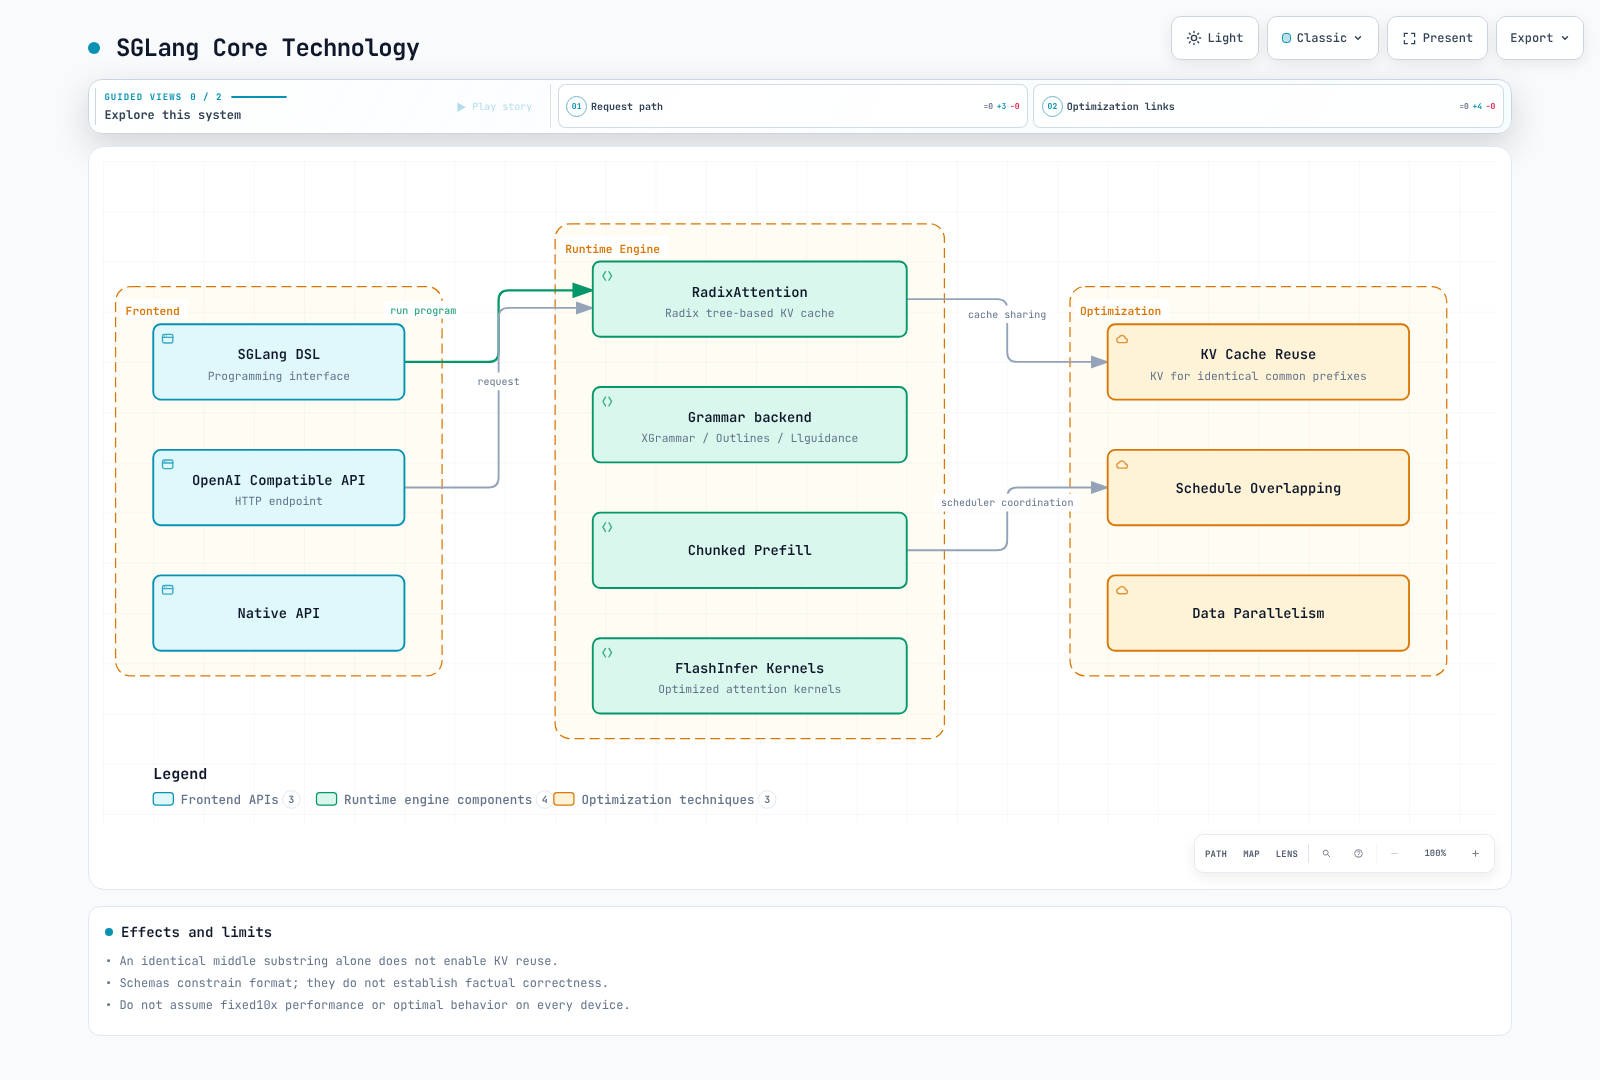
Ejemplo de solicitud estructurada
Este cliente presupone un gateway aprobado que admite la forma de solicitud json_schema de SGLang. Comprueba la finalización normal y la forma de salida. La validación utiliza un fixture HTTP local con respuestas sintéticas y casos de fallo; no mide la precisión del modelo. La validez de JSON no establece la corrección factual ni la autorización de herramientas.
from pathlib import Path
import json
from urllib.request import Request, urlopen

# Existing private gateway and a scoped credential mounted as a file.
base_url = "https://inference.example.internal/v1"
credential = Path("/run/secrets/inference/token").read_text().strip()
payload = {
    "model": "approved-model-alias",
    "messages": [{"role": "user", "content": "Return the city Seoul and country Korea."}],
    "temperature": 0,
    "max_tokens": 128,
    "response_format": {
        "type": "json_schema",
        "json_schema": {
            "name": "location",
            "schema": {
                "type": "object",
                "properties": {"city": {"type": "string"}, "country": {"type": "string"}},
                "required": ["city", "country"],
                "additionalProperties": False,
            },
        },
    },
}
request = Request(
    base_url + "/chat/completions",
    data=json.dumps(payload).encode(),
    headers={"Content-Type": "application/json", "Authorization": "Bearer " + credential},
    method="POST",
)
with urlopen(request, timeout=30) as response:
    result = json.load(response)
choice = result["choices"][0]
if choice["finish_reason"] != "stop":
    raise RuntimeError("Generation did not complete normally")
location = json.loads(choice["message"]["content"])
if set(location) != {"city", "country"} or not all(isinstance(v, str) for v in location.values()):
    raise ValueError("Unexpected output shape")
print(location)
Las API DSL function/system/user/assistant/gen de SGLang permanecen en este lanzamiento. Declarar una función no ejecuta la inferencia: conecte un RuntimeEndpoint/backend preparado y ejecútela. Verifique la compatibilidad de Torch, FlashInfer y hardware durante la instalación. Esta auditoría no instaló el SDK completo de GPU ni conectó el DSL a un modelo.
Hugging Face TGI
El repositorio oficial declara modo de mantenimiento; el último lanzamiento inspeccionado es3.3.7(19 de diciembre de 2025). Acepta correcciones menores, documentación y mantenimiento, y dirige la adopción de nuevos motores hacia vLLM/SGLang y otros. Ya no es una recomendación predeterminada genérica para un proyecto nuevo. Valide la compatibilidad de modelo, plantilla, streaming, métricas y SLO al migrar despliegues existentes.
Añadir --quantize=awq no produce automáticamente pesos AWQ a partir de un modelo ordinario. Use un modelo compatible preparado en ese formato. Las etiquetas flotantes, las credenciales de modelos restringidos ausentes y los plazos breves de liveness perjudican la reproducibilidad y el inicio exitoso.
Ollama
En0.34.0, extraer un modelo y servirlo son operaciones independientes. Un hook postStart con sleep10 no garantiza preparación. Prepare previamente los modelos aprobados o use un procedimiento de preparación independiente con comprobaciones de estado, reintentos acotados y gestión de fallos. Registre las etiquetas de modelo mutables y los permisos de almacenamiento.
La API local de Ollama no proporciona autenticación de usuario; coloque autorización y controles de ruta delante antes de exponerla. No se puede acceder mediante su Service a un servidor enlazado solo a localhost del Pod. OLLAMA_HOST cambia el ámbito de escucha, no la autenticación. Delimite por separado los endpoints de gestión de modelos e inferencia.
Un Modelfile define el modelo base, el prompt del sistema y los ajustes de generación; no entrena un modelo ni crea una imagen de Kubernetes. Verifique el soporte de CPU/GPU por tamaño de modelo, dispositivo y backend en vez de asumir multitenencia a gran escala.
LiteLLM
Use la configuración Router 1.100.1 auditada en la guía de Agentic AI. Un gateway de proveedor es una capa distinta de un motor de inferencia. Llamar a un alias gpt-4-equivalent no establece una calidad equivalente. El fallback debe cumplir primero las políticas de proveedor permitido y salida de datos.
Conecte el archivo de configuración real al comando de proxy y configure las credenciales de cliente, DB/Redis y callbacks según sea necesario. Una clave ficticia o ClusterIP no es autenticación; drop_params=true puede eliminar condiciones significativas de la solicitud. Distinga las solicitudes, los éxitos, los fallos, los reintentos y los costes de caché.
AWS Neuron e Inferentia2
Distinga chips, NeuronCores y RAM/HBM del host. Cada chip Inferentia2 tiene dos núcleos NeuronCore-v2 y32GiB de HBM.
| Instancia | Chips | NeuronCores-v2 | HBM de dispositivo (GiB) | RAM de host (GiB) | vCPU |
|---|---|---|---|---|---|
| inf2.xlarge | 1 | 2 | 32 | 16 | 4 |
| inf2.8xlarge | 1 | 2 | 32 | 128 | 32 |
| inf2.24xlarge | 6 | 12 | 192 | 384 | 96 |
| inf2.48xlarge | 12 | 24 | 384 | 768 | 192 |
Asignación de dispositivos y rutas de plugin
aws.amazon.com/neuron asigna dispositivos completos; aws.amazon.com/neuroncore asigna núcleos. El anterior ejemplo de inf2.xlarge solicitaba neuron:2, ocho CPU y24Gi de RAM en un nodo con un dispositivo, cuatro vCPU y16Gi de RAM; no se puede planificar. NEURON_RT_VISIBLE_CORES selecciona el ámbito de tiempo de ejecución y no crea dispositivos no asignados. Compruebe la precedencia con NUM_CORES y la política de núcleos lógicos respecto al lanzamiento elegido.
El Helm1.10.0 oficial inspeccionado incluye opciones de device-plugin, scheduler y node-problem-detector. Inspeccione los DaemonSets renderizados, hostPaths, RBAC y el comportamiento de recuperación antes de la instalación. Este comando solo genera salida local.
helm template neuron-audit oci://public.ecr.aws/neuron/neuron-helm-chart --version 1.10.0 --namespace kube-system --include-crds > neuron-rendered.yamlSDK2.32.0 documenta dos rutas independientes: plugin NxD Inference0.5.x con vLLM0.16 para Inf2/Trn1/Trn2, y el nuevo beta vLLM Neuron0.24.0.1.1.0 solo para Trn2/Trn3. La guía detallada de NxD aún muestra0.5.0/SDK2.29 mientras que la descripción general muestra0.5.3; verifique la etiqueta de plugin elegida, el DLC y las dependencias exactas. Instalar el beta más reciente en Inf2 o añadir pip install a un DLC2.18 antiguo no es validación de compatibilidad.
La compilación Neuron requiere implementaciones de modelo compatibles, buckets de forma/lote/secuencia, TP, compilador/SDK, hardware y artefactos de caché. Llamar a torch_neuronx.trace en un modelo Transformers genérico con un diccionario tp_degree sin usar no implementa serving causal-LM distribuido. Los archivos de salida del compilador y los directorios tokenizer son artefactos distintos. No se ejecutaron compilador ni instancia Neuron en esta auditoría.
Rendimiento, coste y operaciones
Se eliminaron la tabla de clasificación A100 sin fuentes y las afirmaciones fijas de ahorro de40–70%. Compare el mismo modelo/revisión/precisión, distribución de tokens de entrada/salida, concurrencia, tasa de éxito, SLO, warmup y precios fechados. Un millón de solicitudes/día durante30días son30millones de solicitudes: unos hipotéticos48.000 dólares mensuales son1,60 dólares por1.000 solicitudes. La cifra anterior de0,80 era aritméticamente incorrecta; esta ilustración no corresponde a los precios actuales de AWS.
Pruebe mediante regresión las cargas útiles, plantillas, streaming, uso y comportamiento ante fallos reales al cambiar de motor. Distinga los grupos de modelos fragmentados de las réplicas independientes, y compruebe si la preparación ordenada de StatefulSet bloquea workers que se esperan mutuamente. StatefulSet por sí solo no configura TP/PP, rendezvous ni NCCL.
Compare las cachés locales, EBS, EFS y FSx usando tamaño de modelo, concurrencia de reinicio/descarga, autorización y coste. EFS no es universalmente más lento que FSx, y los límites históricos de gp3 no son garantías actuales. Consulte los ejemplos de GPU/almacenamiento.
Antes de las operaciones, pruebe la autenticación, TLS, rutas de gestión, sondas, ubicación, cuotas, un único propietario del escalador, unidades de métricas, revisiones de modelo fijadas, ciclo de vida de caché, rollout/rollback y recuperación de interrupciones en el entorno real.
Alcance de la verificación
Las comprobaciones cubren charts/CRD oficiales, fuente de SDK/CLI real, fixtures locales de solicitud/fallo HTTP, Markdown e imágenes. No se realizaron ejecución de modelos GPU/Neuron, mediciones de throughput/coste, despliegue en la nube ni descarga de modelos. El éxito de esquema/chart no establece admisión, autorización, compatibilidad de modelo ni preparación para producción.
Referencias
- Notas de lanzamiento de NIM 2.0
- Configuración de NIM
- Observabilidad de NIM
- Dynamo 1.4.2
- AIBrix 0.7.0
- Salida estructurada de SGLang 0.5.19
- Aviso de mantenimiento de TGI
- Ollama 0.34.0
- GenAI-Perf 0.0.16
- Rutas de inferencia de Neuron SDK 2.32.0
- Arquitectura de Inf2
- Componentes de Kubernetes de Neuron