Parte 2: Flink Kubernetes Operator
Última actualización: 12 de septiembre de 2026. Operator/gráfico Helm 1.15.0; Flink 2.2.1 / Java 17.
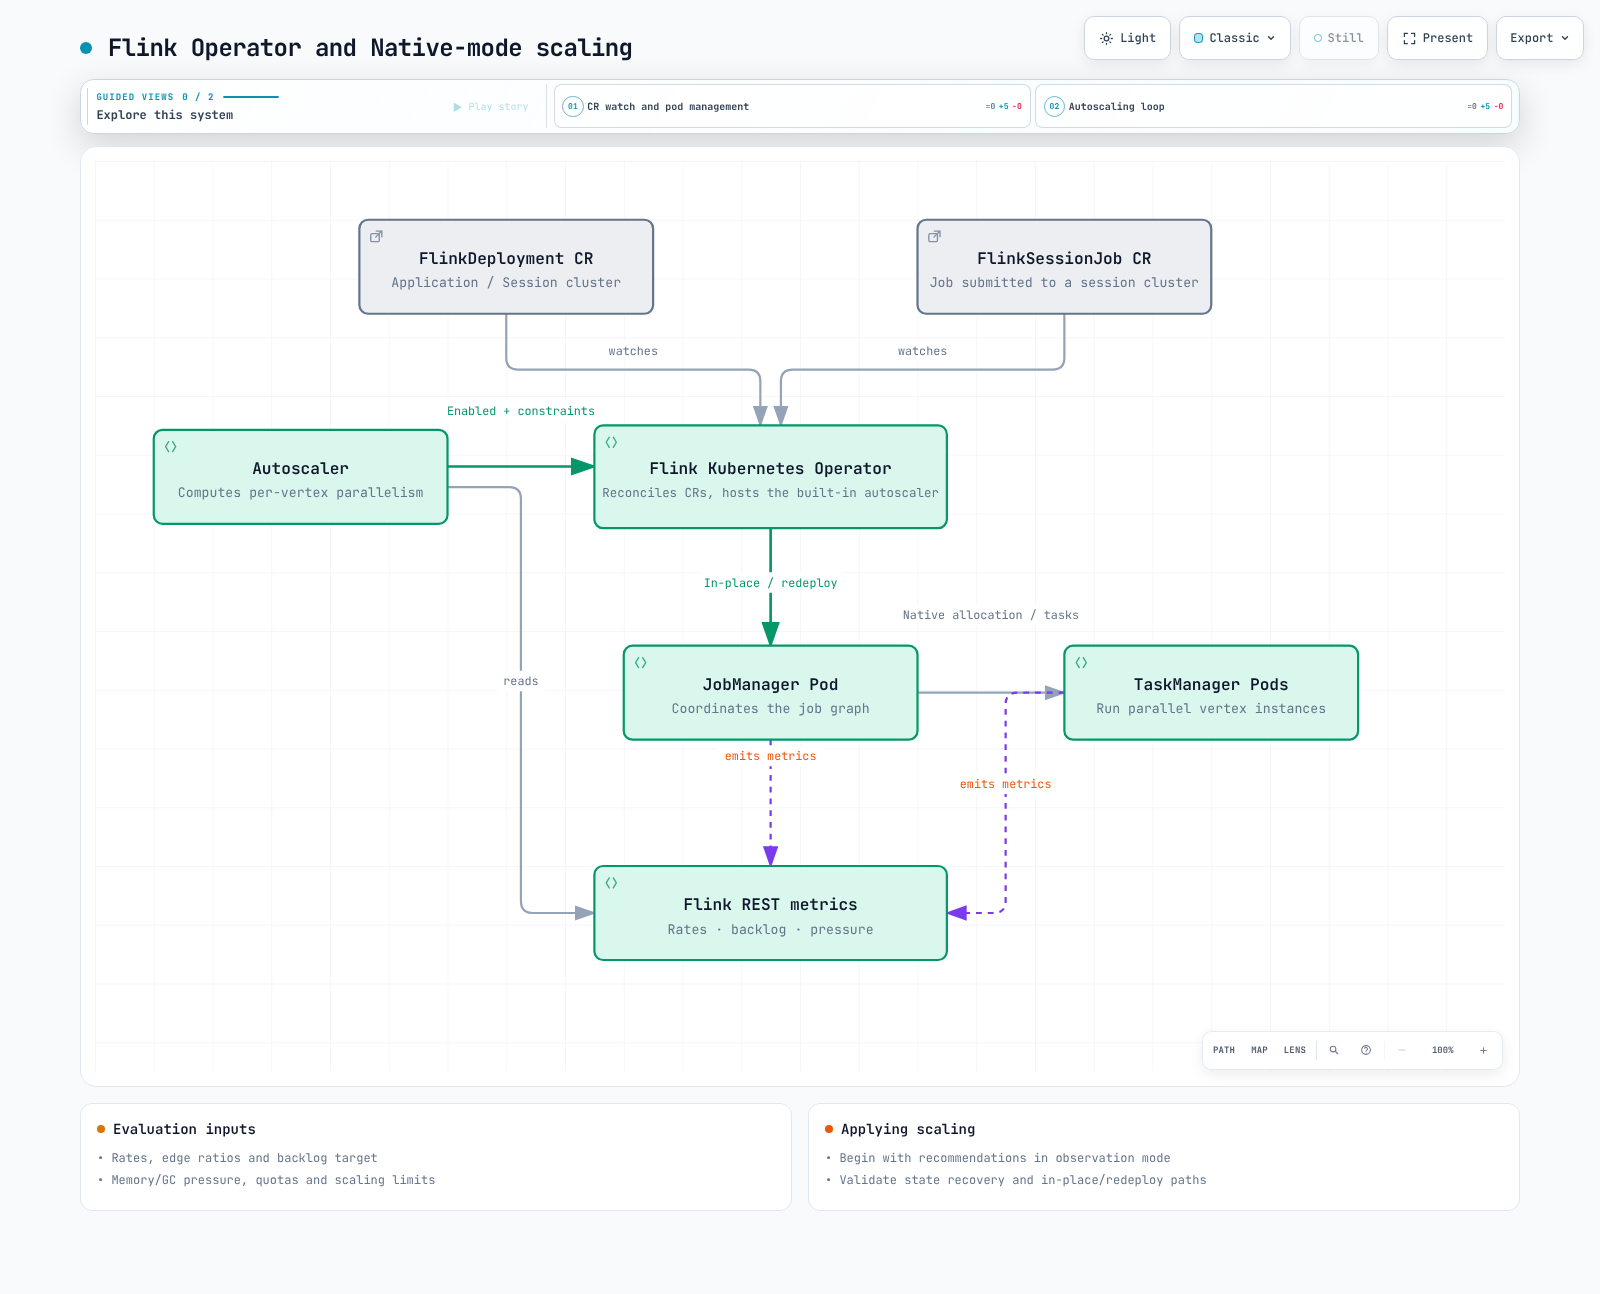
El Operator reconcilia el estado deseado de clústeres/trabajos y administra actualizaciones, instantáneas, recuperación y escalado automático. No garantiza tiempo de inactividad cero ni pérdida de datos cero para todos los cambios. Consulte la parte 1 para conocer los límites entre Native/Standalone y Application/Session.
1. Recursos y límites operativos
| CR | Función |
|---|---|
| FlinkDeployment | Estado deseado de un clúster Application o Session |
| FlinkSessionJob | Trabajo enviado a un clúster Session administrado existente |
| FlinkStateSnapshot | Administración de savepoints/checkpoints de un Deployment/SessionJob vinculado |
| FlinkBlueGreenDeployment | Transiciones blue/green mediante dos implementaciones secundarias |
SessionJobs tienen especificaciones independientes, pero comparten capacidad JM/TM y los fallos del clúster subyacente. Los clústeres Application no están completamente aislados de los nodos, la red, el almacenamiento ni las cuotas de EKS compartidos. Un CR blue/green no garantiza automáticamente transiciones seguras de grupos de consumidores de Kafka, ID transaccionales ni escrituras en sinks. Valide la compatibilidad del estado/ruta de datos, el procesamiento duplicado y la capacidad adicional temporal.
2. Instalación: preparar cert-manager y los espacios de nombres
Use versiones compatibles de EKS/Kubernetes y de kubectl/Helm. El gráfico de webhook predeterminado de esta versión crea recursos Certificate e Issuer de cert-manager, no un Job interno de generación de certificados. Primero compruebe que cert-manager esté instalado en una versión compatible y que funcionen su controlador, webhook y cainjector. Deshabilitar la validación no es el remedio predeterminado para fallos de instalación.
El archivo operator-values.yaml siguiente limita el espacio de nombres de las cargas de trabajo a data-processing y fija el digest verificado de la imagen del Operator. La etiqueta corta predeterminada del gráfico y la etiqueta 1.15.0 se resuelven en el mismo digest multiarquitectura.
watchNamespaces:
- data-processing
image:
  repository: ghcr.io/apache/flink-kubernetes-operator
  tag: 1.15.0
  digest: sha256:5372e4461b433ee37391b0ee3fc3e4029980d14e9b64576b0cb78493d1cafe3a
webhook:
create: true# Existing cert-manager installation; adjust its namespace if necessary.
kubectl get crd certificates.cert-manager.io issuers.cert-manager.io
kubectl rollout status deployment/cert-manager -n cert-manager --timeout=180s
kubectl rollout status deployment/cert-manager-webhook -n cert-manager --timeout=180s
kubectl rollout status deployment/cert-manager-cainjector -n cert-manager --timeout=180s
# Create the watched workload namespace before Helm creates its SA/RBAC.
kubectl create namespace data-processing --dry-run=client -o yaml | kubectl apply -f -
helm repo add flink-operator-repo https://downloads.apache.org/flink/flink-kubernetes-operator-1.15.0/
helm repo update flink-operator-repo
helm upgrade --install flink-kubernetes-operator flink-operator-repo/flink-kubernetes-operator \
--version 1.15.0 \
--namespace flink-operator --create-namespace \
-f operator-values.yaml \
--wait --timeout 10m
kubectl wait --for=condition=Ready certificate/flink-operator-serving-cert \
-n flink-operator --timeout=180s
kubectl get serviceaccount/flink -n data-processingUn watchNamespaces vacío vigila todos los espacios de nombres. Con la lista explícita anterior, el gráfico también crea la cuenta de servicio de trabajos flink, el Role y el RoleBinding en ese espacio de nombres de carga de trabajo, que ya debe existir. Inspeccione conjuntamente el alcance de vigilancia, el RBAC real y las demás concesiones; limitarse a un espacio de nombres no aísla completamente a los inquilinos que no son de confianza.
Para las actualizaciones, revise los cambios de CRD, la compatibilidad del webhook y los trabajos en ejecución junto con la versión/los valores del gráfico. Una actualización de Helm por sí sola no actualiza todos los CRD existentes de crds/. Mantenga los CRD y la imagen alineados con la versión revisada.
3. Primero verificar la ejecución con un trabajo incluido
flink-smoke.yaml ejecuta StateMachineExample desde la imagen oficial. No presupone que esa imagen contenga un JAR ficticio order-events ni una clase de entrada con ese nombre. Es una demostración de larga duración con actualizaciones sin estado, no una configuración de producción que conserve el estado.
apiVersion: flink.apache.org/v1beta1
kind: FlinkDeployment
metadata:
  name: flink-smoke
  namespace: data-processing
spec:
  image: flink:2.2.1-java17
  flinkVersion: v2_2
  mode: native
  flinkConfiguration:
    taskmanager.numberOfTaskSlots: '2'
  serviceAccount: flink
  jobManager:
    resource:
      memory: 2048m
      cpu: 1
  taskManager:
    resource:
      memory: 2048m
      cpu: 1
  job:
    jarURI: local:///opt/flink/examples/streaming/StateMachineExample.jar
    parallelism: 2
    upgradeMode: stateless
state: running# This readiness sequence is for the initial deployment.
kubectl apply -f flink-smoke.yaml
kubectl wait --for=condition=Running flinkdeployment/flink-smoke \
-n data-processing --timeout=300s
kubectl get flinkdeployment/flink-smoke -n data-processing -o yaml
kubectl get pods -n data-processing -l app=flink-smoke
kubectl logs deployment/flink-smoke -n data-processing --tail=100En modo Native, Operator/Flink crea el Deployment de JM y ResourceManager de JM administra dinámicamente los Pods TM. Los TM Native no siempre son Deployments. Distinga esto de los Deployments TM administrados externamente en modo Standalone.
La condición de la versión 1.15.0 es Running, no Available. Pasa a True cuando se observa un trabajo Application en estado RUNNING o un Deployment JM Session en estado READY. No demuestra que los datos sean correctos, que los checkpoints hayan tenido éxito ni que se alcance el rendimiento objetivo. Esta implementación no establece observedGeneration en la condición. Después de actualizar un CR existente, no trate un Running=True que se conserva como prueba de que se reconcilió la nueva especificación. Inspeccione también el estado de reconciliación y el estado real de imagen/configuración/trabajo.
4. Requisitos adicionales para implementaciones con estado
Empaquete un JAR de aplicación real con runtime/conectores compatibles o use una ruta compatible de entrega de artefactos. Compruebe también los esquemas/hosts de artefactos permitidos por el Operator para SessionJobs.
Una URL de S3 y una anotación de cuenta de servicio no bastan por sí solas para completar una implementación con estado:
- Instale el complemento del sistema de archivos S3 y el proveedor de credenciales apropiados en las imágenes JM/TM.
- Verifique la confianza/asociación de IRSA o Pod Identity, Agent/SDK y los permisos del prefijo del bucket/KMS.
- Configure los intervalos de checkpoints, el almacenamiento accesible de checkpoints/savepoints y los metadatos/la recuperación de alta disponibilidad.
- Verifique los serializadores de estado, los UID del operador, el paralelismo máximo y la compatibilidad del estado de los conectores.
La parte 3 trata la configuración del backend/complemento/checkpoint; la parte 4 trata la alta disponibilidad. RocksDB usa E/S de disco local y la recuperación puede requerir descargar el estado. Mida la capacidad de memoria/disco/red de TM y el tiempo de reubicación. Distribuir entre nodos/AZ por sí solo no garantiza la continuidad de los trabajos; planifique solicitudes, taints, afinidad y capacidad de reserva.
5. Elegir modos de actualización junto con los requisitos previos de restauración
| Modo | Tratamiento del estado | Qué comprobar |
|---|---|---|
| stateless | Reiniciar sin el estado anterior | Si es aceptable repetir el procesamiento, incluidos los offsets de origen y los efectos secundarios externos |
| savepoint | Crear y restaurar un savepoint | Trabajo ejecutable, compatibilidad del almacenamiento/estado y política alternativa ante fallos |
| last-state | Restaurar mediante metadatos HA accesibles o el último checkpoint/savepoint | Checkpointing, metadatos/estado válidos, credenciales y capacidad real de recuperación |
Los savepoints no son universalmente la opción más lenta, segura y con detención total. El tiempo y la capacidad de restauración dependen del trabajo, el backend y los cambios de estado. Con la alternativa predeterminada last-state y metadatos HA accesibles, una actualización por savepoint de un trabajo en mal estado puede cambiar a last-state. Haga explícita la política alternativa.
Last-state no garantiza la recuperación después de perder los metadatos ni desde un estado obsoleto/incompatible. Los límites de antigüedad de checkpoints también pueden activar un savepoint para trabajos sanos. SessionJobs pueden usar last-state, pero requieren la configuración Session subyacente y almacenamiento de checkpoints; una cadena con el nombre del modo no basta.
6. Autoscaler: empezar por la observación
El objetivo principal del autoscaler es el paralelismo de los vértices del trabajo. Su modelo de rendimiento usa la ingesta/retraso de origen, la tasa/tiempo ocupado de procesamiento y las proporciones de salida de las aristas. Para los vértices descendentes, suma la tasa objetivo ascendente × la proporción de salida de esa arista. Esto difiere de sumar sin más las tasas de salida ascendentes observadas.
Se diferencia del HPA basado en CPU, pero no ignora todas las señales de CPU/memoria. El código revisado comprueba la presión de GC/memoria y las cuotas de CPU/memoria, y puede ajustar opcionalmente la memoria de TM. El ajuste de memoria está deshabilitado de forma predeterminada.
Combine la siguiente configuración de modo de observación con una especificación existente. El reescalado real está deshabilitado. Elija pipeline.max-parallelism al diseñar un trabajo nuevo; no lo cambie a la ligera para un estado existente.
flinkConfiguration:
  job.autoscaler.enabled: 'true'
  job.autoscaler.scaling.enabled: 'false'
  job.autoscaler.utilization.target: '0.6'
  job.autoscaler.utilization.min: '0.4'
  job.autoscaler.utilization.max: '0.8'
  job.autoscaler.stabilization.interval: 5m
  job.autoscaler.metrics.window: 10m
  job.autoscaler.catch-up.duration: 10m
  pipeline.max-parallelism: '360'
Las claves actuales son utilization.target/min/max; los ajustes antiguos target.utilization y de límites están obsoletos. Aquí, 0.4/0.8 definen la banda de utilización, mientras que las decisiones también tienen en cuenta la acumulación de trabajo pendiente, el tiempo de reinicio, las ventanas de métricas, las cuotas, los límites y la estabilización. Superar un umbral instantáneo de tiempo ocupado no garantiza un reescalado inmediato.
catch-up.duration es el tiempo objetivo para procesar el trabajo pendiente después del reescalado. Una acumulación de 6,000 registros requiere 10 registros/segundo adicionales durante 600 segundos o 100 registros/segundo durante 60 segundos. Los intervalos más cortos exigen más capacidad; el valor cero deshabilita el escalado basado en la acumulación. No es un periodo de gracia para ignorarla.
Una ventana de métricas de 3–60 minutos es un punto de partida para ajustar el sistema, no un requisito universal. Ajústela junto con la estabilización, los intervalos de reducción de escala y los SLO. Un paralelismo máximo con muchos divisores puede ayudar a alinear grupos de claves/particiones del autoscaler, pero Flink no exige que todos los valores de paralelismo dividan uniformemente el máximo. El modo de alineación, las particiones de origen y las entradas con/sin clave afectan a la selección.
El escalado aplica anulaciones de paralelismo y, cuando es posible, usa localmente la API de requisitos de recursos del planificador adaptativo. Según la compatibilidad, el tipo de cambio, la configuración y el resultado, puede volver a una implementación completa. No siempre es una actualización last-state. El escalado in situ aún puede reiniciar tareas y recuperar el estado. Habilite scaling.enabled solo después de revisar las recomendaciones y probar la recuperación con estado y la carga máxima.
Alcance de la validación
Se verificó el digest del gráfico oficial y se renderizaron con Helm las variantes de comparación predeterminada, con alcance por espacio de nombres y con webhook deshabilitado. Se comprobaron los esquemas CRD, los manifiestos de imagen, el código publicado de preparación/escalado y la estructura del ejemplo. No se realizó ninguna implementación de Kubernetes, emisión de certificados, operación S3/HA, prueba de rendimiento de trabajo en vivo ni reescalado.