Parte 6: KServe — Servicio de modelos en Kubernetes
Línea base revisada: KServe 0.18.0 / Models Web Application 0.18.0 / Community Distribution 26.03.1 Última actualización: October 12, 2026
Configuración del entorno de laboratorio
Use Kubernetes compatible, controlador/CRDs de KServe, ServingRuntime, acceso al almacenamiento y una ruta de red autenticada. No se requiere Kubeflow completo; la aplicación web es opcional. El modo Knative necesita Knative Serving/networking; la ruta KEDA de Standard necesita KEDA y proveedores de métricas. Las GPU dependen de la carga de trabajo.
KServe y Kubeflow
KServe evolucionó de KFServing a un proyecto independiente de serving. Este capítulo revisa KServe y Models Web Application 0.18.0, incluidos en Community Distribution 26.03.1.
La última versión pública de KServe comprobada el October 12, 2026 es la 0.21.0 (September 25, 2026). La versión 0.20.0 (August 6, 2026) fue anterior. Ninguna de las dos versiones corresponde a la línea base 0.18.0 de la distribución.
El controlador, los CRD y la aplicación web son artefactos independientes que requieren comprobaciones de compatibilidad. Sus números de versión no tienen por qué coincidir siempre ni ser siempre distintos. Registre las imágenes reales, los esquemas de CRD y las revisiones de la aplicación web.
InferenceService es la API de serving que se trata aquí, no toda la arquitectura de KServe. ServingRuntime/ClusterServingRuntime, ModelMesh y la API independiente LLMInferenceService tienen dependencias y modelos operativos distintos.
InferenceService: Predictor, Transformer, Explainer
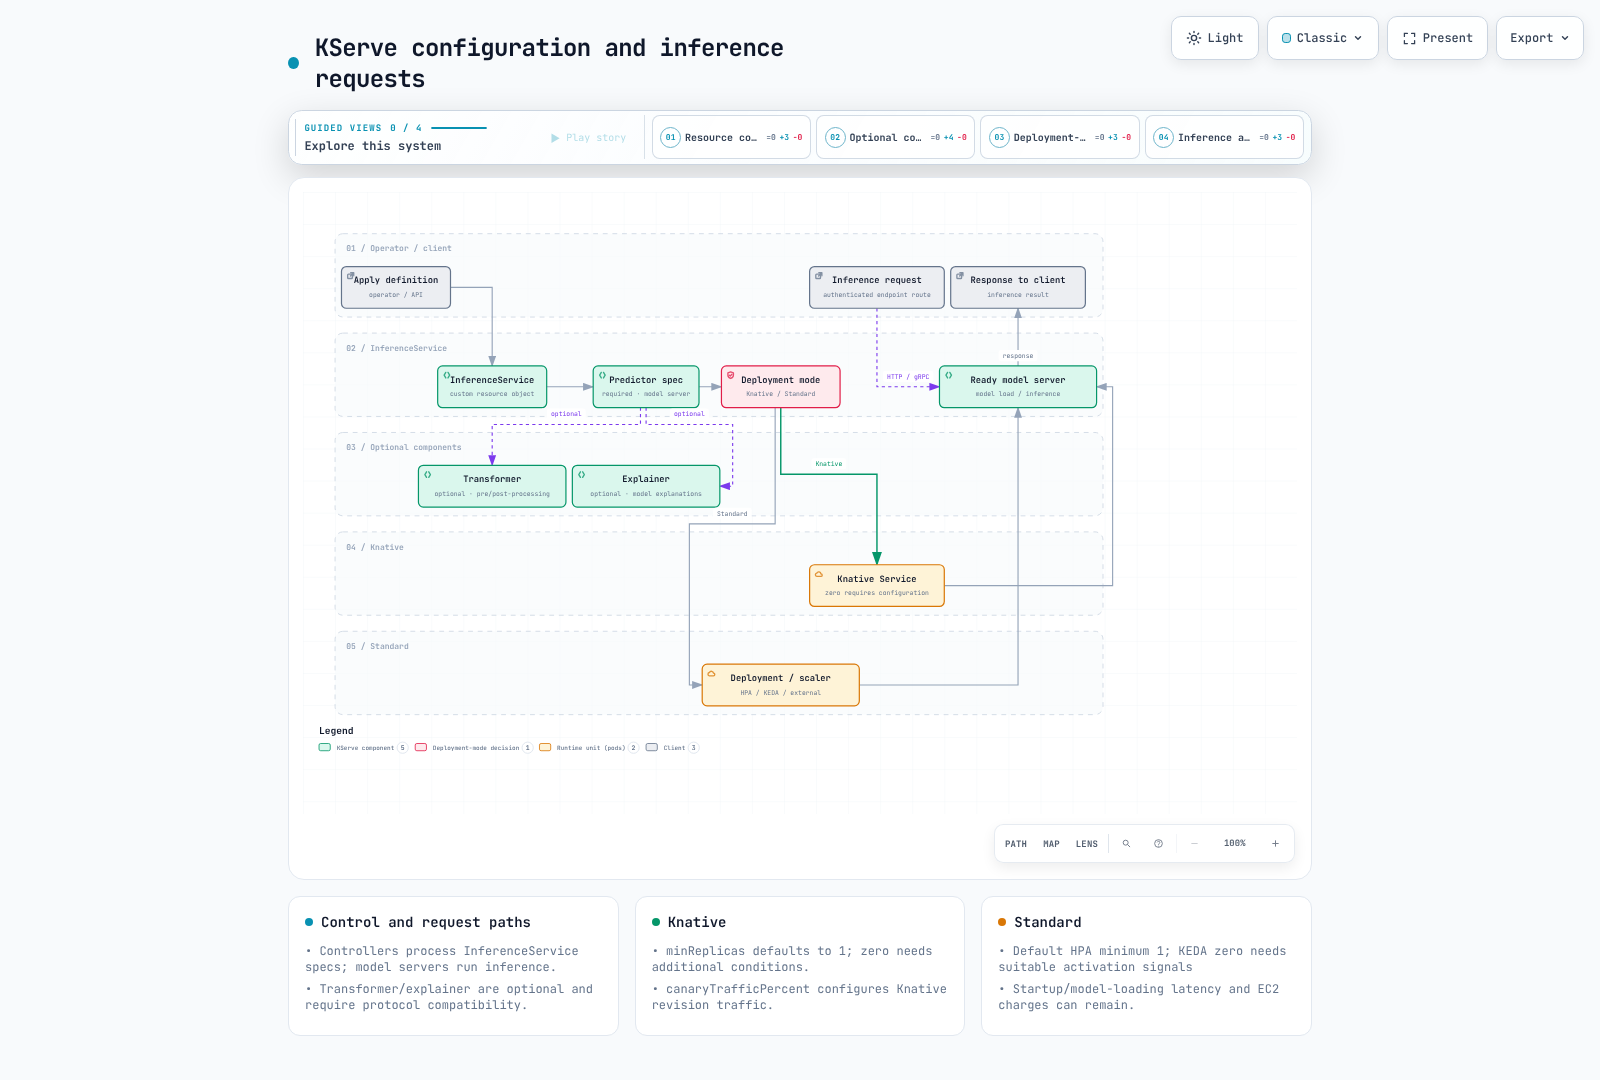
InferenceService tiene un predictor obligatorio y un transformer/explainer opcionales. Predictor configura el servidor de modelos, transformer proporciona preprocesamiento/posprocesamiento y explainer gestiona las solicitudes de explicación. Las explicaciones no se adjuntan automáticamente a cada predicción; es importante contar con soporte de runtime/protocolo.
Haga coincidir modelFormat, ServingRuntime, la versión de la disposición de archivos/biblioteca, URI/credenciales, puertos/probes y el protocolo de solicitud. Una URI por sí sola no puede hacer que todos los modelos se puedan servir. Los contenedores personalizados también deben cumplir el contrato del cliente y los requisitos de routing/comprobación de estado de KServe.
El chart oficial runtime-config no genera recursos de forma predeterminada. Renderizar con kserve.servingruntime.enabled=true produce 12 ClusterServingRuntimes. La presencia en el catálogo no establece la vigencia de la imagen, el soporte de seguridad ni la compatibilidad del modelo.
El aviso del proyecto de TorchServe indica que no se prevén nuevas características, correcciones de errores ni parches de seguridad. Su presencia en un catálogo de runtimes antiguo no lo convierte en una opción predeterminada mantenida para usos nuevos en producción. Valide un runtime mantenido para el formato de modelo y los requisitos de GPU.
Modos de Deployment: Knative y Standard
Los nombres de 0.18.0 son Knative y Standard. Los valores de anotación Serverless y RawDeployment son alias obsoletos normalizados a esos nombres. Inspeccione serving.kserve.io/deploymentMode e inferenceservice-config instalados. El valor de reserva del código es Standard, mientras que el chart de recursos OCI descargado usa Knative de forma predeterminada. No infiera los valores predeterminados de instalación solo a partir de la terminología.
| Elemento | Knative | Standard |
|---|---|---|
| Recursos de carga de trabajo | Ruta de Knative Service/Revision | Deployment/Service y el autoscaler seleccionado |
| Reducción de escala | Es posible llegar a cero con soporte de KPA/política y minReplicas=0 | La ruta HPA predeterminada conserva al menos uno; KEDA puede admitir cero con señales de activación externas adecuadas |
| minReplicas predeterminado | KServe usa uno de forma predeterminada; elegir solo Knative no habilita cero | HPA limita un cero solicitado a al menos uno |
| Dependencias | Knative Serving/networking y el autoscaler seleccionado | Ingress/gateway elegido, métricas HPA o KEDA, etc. |
| Latencia de inicio | Programación/carga de imagen/modelo al comenzar desde cero | Los reinicios, rollouts y el escalado horizontal aún generan latencia de inicio pese a las réplicas activas |
Ningún modo garantiza réplicas disponibles ni un SLA de latencia. Valide la carga del modelo, la preparación, la capacidad, los timeouts y la recuperación. El escalado desde cero de KEDA requiere una señal observable sin ejecutar Pods y una ruta de reactivación; las métricas de CPU/memoria por sí solas no implican una activación basada en solicitudes.
Autoscaling y métricas
Knative KPA admite concurrencia/RPS, mientras que la clase HPA de Knative es otra ruta. Standard selecciona hpa, keda o external/none mediante serving.kserve.io/autoscalerClass. No todos los Deployments Standard crean un HPA.
Las métricas de CPU, externas o de Pod compatibles necesitan las dependencias reales de metrics-server/adapter/provider. Las solicitudes de GPU no crean automáticamente métricas de GPU. La velocidad de respuesta depende de los intervalos de observación, la estabilización y el comportamiento del modelo; las métricas de concurrencia no son universalmente más rápidas.
Actualizaciones graduales y tráfico canary
El canaryTrafficPercent de esta versión se verificó en la ruta de división de tráfico de Knative Revision. KServe establece la revisión previamente desplegada y la nueva revisión como destinos de tráfico de Knative Service; el networking de Knative distribuye las solicitudes. El controlador de KServe no es el proxy para cada llamada de inferencia.
No equipare una actualización continua de un Deployment Standard con ese routing por porcentaje de revisión. El routing ponderado en Standard necesita servicios/gateway/mesh diseñados por separado o herramientas de rollout y una propiedad claramente definida. Al usar la gestión de tráfico de Istio o Argo Rollouts, evite conflictos de propiedad de los objetos gestionados por KServe.
Un porcentaje por sí solo no valida la calidad ni automatiza la promoción/el rollback. Compruebe las métricas de comparación, los errores/latencia, las revisiones/artefactos de modelo conservados y la preparación de la ruta.
Inferencia con GPU en EKS
La solicitud nvidia.com/gpu de un Pod habilita la programación/asignación de dispositivos. La inferencia real con GPU requiere CUDA/drivers compatibles, imagen de servidor, backend del modelo y configuración del dispositivo. Revise la configuración del modelo Triton o la selección de dispositivos del framework; una solicitud de GPU no mueve automáticamente un modelo de CPU a GPU.
Karpenter aprovisiona para Pods Pending aptos, NodePools, cuotas y capacidad disponible. El escalado de Pods de KServe/Knative/HPA/KEDA y el aprovisionamiento/recuperación de EC2 son bucles independientes. Incluso con cero Pods de modelo, otras cargas de trabajo o políticas de interrupción pueden mantener nodos y costos en ejecución.
Validación y fuentes
Los charts OCI oficiales de CRD/resource/runtime-config 0.18.0 se descargaron y renderizaron localmente para inspeccionar el esquema/la configuración. Se revisaron el aliasing de modos, los mínimos de HPA, KEDA ScaledObject y el código de tráfico de Knative. No se ejecutaron descargas/serving de modelos, GPU, autoscaling del clúster ni solicitudes canary en vivo.
- Nombres y valores predeterminados de modos de 0.18.0
- Gestión de réplicas mínimas de HPA
- Gestión de KEDA ScaledObject
- Gestión de tráfico de Knative
- Versión 0.20.0
- Versión 0.21.0 (última comprobada)
Próximos pasos
Conecte esta ruta de serving con los capítulos de arquitectura, Pipelines, Notebooks, Katib y Trainer de la serie de Kubeflow, al tiempo que trata el despliegue y la validación de artefactos de modelo como pasos independientes.
Cuestionario
Para poner a prueba lo que ha aprendido en este capítulo, pruebe el cuestionario del tema.