Parte 1: Arquitectura de Airflow en Kubernetes
Versión de referencia para la revisión: Airflow 3.3.1 / Helm chart 1.22.0 Último parche upstream comprobado: Airflow 3.3.2; los ejemplos siguen usando 3.3.1 · 12 de octubre de 2026
1. Componentes y ejecución de tareas
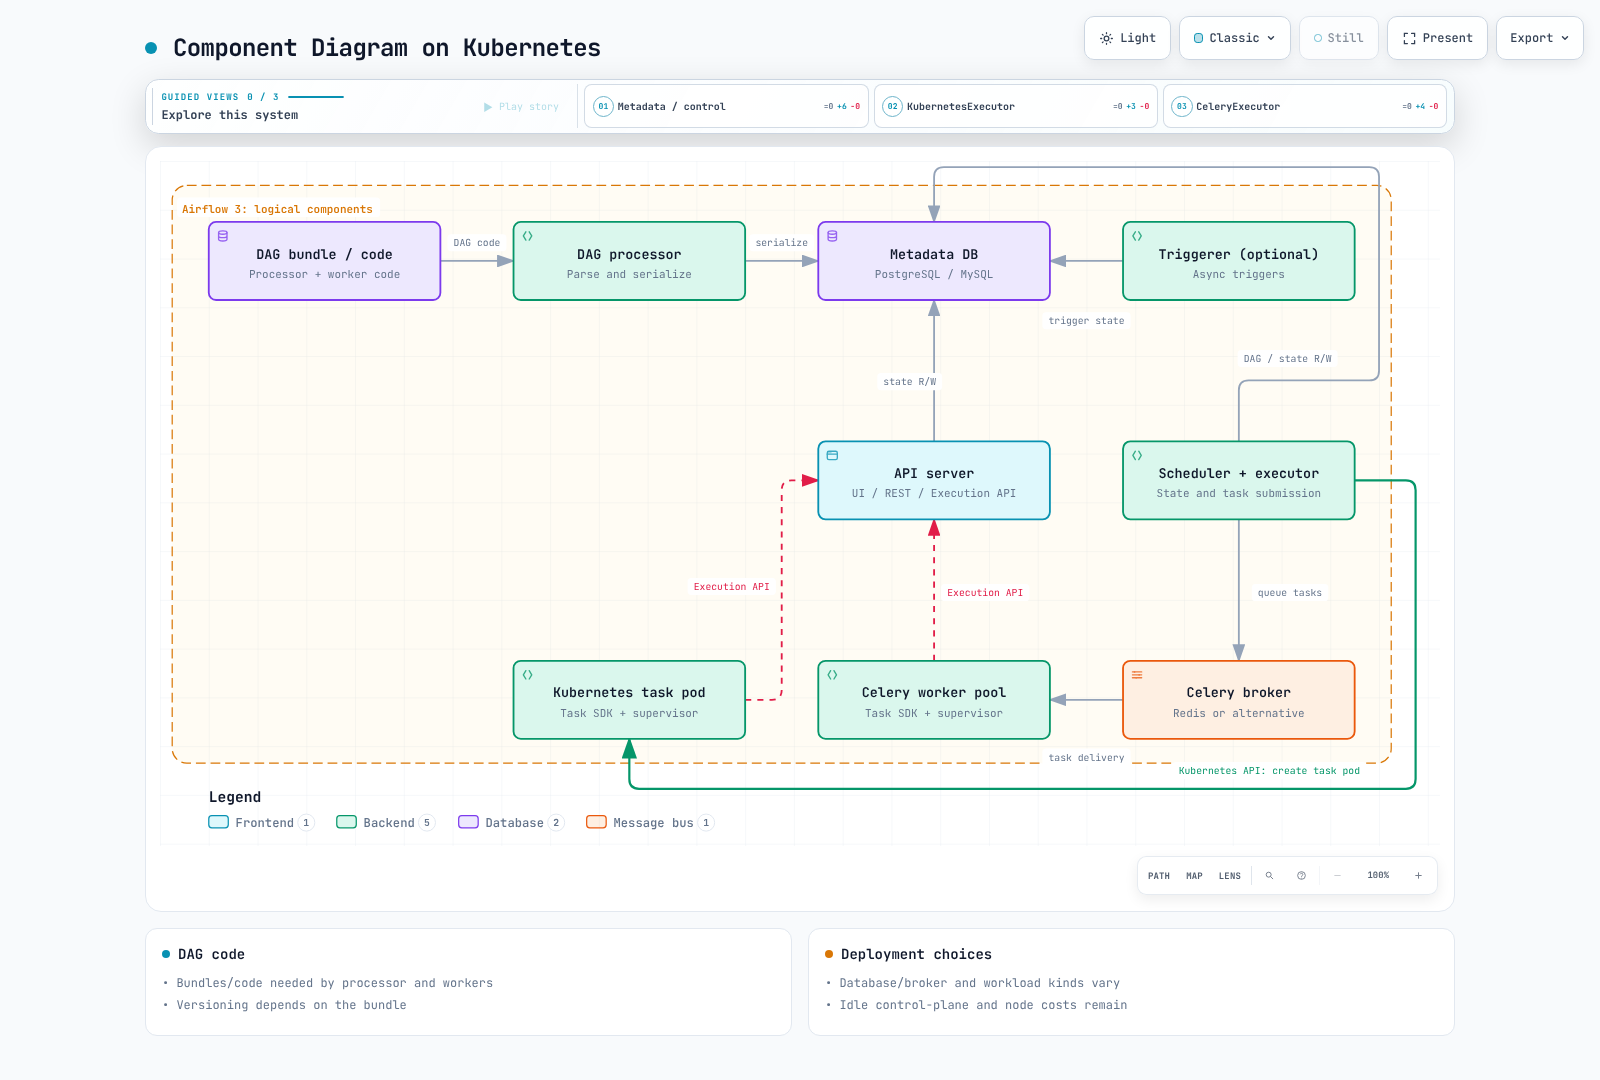
Airflow programa y supervisa las instancias de tareas de acuerdo con las dependencias de los DAG. El trabajo puede ejecutarse en un worker del executor, en un pod externo o en un servicio invocado por la tarea. Los servidores de API de Kubernetes procesan solicitudes y estados; el scheduler y kubelet ubican e inician pods.
| Componente | Responsabilidad y alcance |
|---|---|
| Scheduler + executor | Evalúan la disponibilidad de DAG/tareas, envían trabajo, administran el estado y los heartbeats; leen y escriben metadatos |
| Procesador de DAG | Accede a los bundles, analiza/serializa DAG y actualiza los metadatos relacionados con versiones; es un rol separado obligatorio en Airflow 3 |
| Servidor de API | Interfaz de usuario, REST API v2 y Execution API; autenticación/autorización mediante el gestor de autenticación y la configuración del despliegue |
| Runtime de tareas / worker | Ejecuta código de operator/Task SDK y se comunica con las API de ejecución y los servicios requeridos |
| Triggerer | Ejecuta los triggers de las tareas diferidas en un bucle asíncrono; es opcional si no se usa la funcionalidad de diferimiento |
| Base de datos de metadatos | Estado compartido de DAG/tareas, estructuras serializadas y metadatos relacionados |
Execution API de Airflow 3
En una ejecución normal de una tarea Python Task SDK supervisada, el worker inicia un proceso supervisor que ejecuta un subproceso ejecutor de tareas. El código de la tarea del usuario se comunica con el supervisor a través de un socket; el supervisor llama a la Execution API usando un JWT de tarea de corta duración. El acceso público del SDK a Connections, Variables, XComs y al estado reemplaza el acceso directo del código de la tarea a la base de datos de metadatos.
El direccionamiento, la autenticación y la red entre el worker y el servidor de API son dependencias reales. Una flecha del scheduler al worker por sí sola no explica Airflow 3. Por separado, inspecciona los elementos internos del executor, los workers del sistema y los almacenes como el backend de resultados de Celery; no generalices esto como si ningún proceso de backend se conectara jamás a ninguna base de datos. La ejecución dentro del mismo proceso, como dag.test local, tampoco tiene por qué usar la misma ruta de subproceso/HTTP que un despliegue supervisado.
Triggerer frente a worker
Un operator se inicia en un worker y puede registrar un trigger y diferir su ejecución mientras espera. El triggerer ejecuta ese trigger; después de un evento, se vuelve a programar la tarea y esta continúa en un worker. El operator completo no se ejecuta en el triggerer. Las tareas diferidas liberan los slots de worker y, de forma predeterminada, los slots del pool; el comportamiento del pool se puede configurar. Las tareas asíncronas ordinarias pueden conservar los slots de worker y son distintas.
2. Qué cambió realmente entre Airflow 2 y 3
Airflow 2 llegó al fin de vida el 22 de abril de 2026. La comparación que sigue sirve como contexto para la migración.
| Aspecto | Airflow 2.x | Airflow 3.x |
|---|---|---|
| Interfaz de usuario/API | Webserver basado en Flask | api-server basado en FastAPI y rutas de Execution API para tareas |
| Análisis de DAG | Manager y subprocesos de procesamiento de archivos; dag-processor independiente opcional | El procesador de DAG independiente es un rol obligatorio |
| Estructura de DAG | La programación basada en DAG serializados ya existía | Se mantienen las estructuras serializadas y los metadatos de versiones |
| Alta disponibilidad del scheduler | Ya existía compatibilidad con varios schedulers basada en la base de datos | La alta disponibilidad, la capacidad y la carga de la base de datos aún deben validarse |
| Executors simultáneos | Compatibles desde 2.10.0 | Se mantiene y generaliza la configuración |
| Executors híbridos fijos | Estaban disponibles LocalKubernetesExecutor y CeleryKubernetesExecutor | No compatibles desde 3.0 |
Es inexacto afirmar que Airflow 2 analizaba todos los archivos en el mismo bucle de Python del scheduler o que la alta disponibilidad del scheduler solo se hizo posible en Airflow 3. La separación facilita el ajuste independiente, pero el análisis lento de DAG nuevos, la contención compartida de CPU/memoria/base de datos y una concurrencia excesiva del analizador aún pueden afectar la latencia de programación. Agregar réplicas por sí solo no garantiza la fiabilidad.
3. Metadatos, brokers y código de DAG
Airflow 3.3.1 enumera como probadas PostgreSQL 14–18, MySQL 8.0/8.4/Innovation y SQLite 3.15.0+. SQLite es para desarrollo/pruebas, no para producción. MariaDB no es compatible. Los ejemplos de PostgreSQL de esta serie no implican que MySQL no sea compatible. Las bases de datos administradas aún requieren una configuración real de alta disponibilidad, retención de copias de seguridad y políticas de eliminación.
CeleryExecutor necesita un broker compatible, con opciones como Redis o RabbitMQ. KubernetesExecutor y LocalExecutor no requieren Redis de forma inherente. Distingue entre el almacenamiento de metadatos, el broker y el backend de resultados de Celery seleccionado. Connections/Variables pueden usar un backend de secretos; el almacenamiento de cargas útiles de XCom también puede usar otro backend.
Tanto los workers como el procesador de DAG necesitan el código ejecutable de DAG/tareas y sus paquetes. La ejecución normal de tareas no requiere que el servidor de API analice archivos de DAG, pero los plugins, los gestores de autenticación y los triggers siguen necesitando la distribución adecuada de código/dependencias.
| Bundle de DAG | Compatibilidad actual con versiones |
|---|---|
| GitDagBundle | Compatible |
| LocalDagBundle | No compatible; usa el código local actual |
| S3DagBundle / GCSDagBundle | No compatible; es distinto del versionado del almacén de objetos |
git-sync sigue disponible en el chart 1.22.0. El renderizado confirma sidecars y contenedores init para el procesador/triggerer, además de un contenedor init en la plantilla del pod de tareas de Kubernetes. Elige git-sync, DAG incluidos en la imagen, un volumen compartido o bundles remotos, según corresponda. Verifica si el bundle conserva la versión del código de la ejecución y qué código lee un reintento.
4. Opciones de executor y executors simultáneos
| Opción | Unidad de ejecución | Consideraciones sobre costo, latencia y aislamiento |
|---|---|---|
| LocalExecutor | Procesos de tareas locales del lado del scheduler | No necesita un broker separado; comparte los recursos/límites del scheduler |
| KubernetesExecutor | Un pod de worker por instancia de tarea | Latencia de inicio del pod/imagen; los límites y la identidad dependen de la especificación real del pod |
| CeleryExecutor | Pool de workers que consume mensajes del broker | Los workers activos pueden iniciarse rápidamente; escalar a cero introduce arranques en frío |
Aunque KubernetesExecutor no tenga pods de worker inactivos, siguen existiendo costos del plano de control, la base de datos, los nodos y el registro de logs. Un pod separado no constituye automáticamente un límite de seguridad sólido. KubernetesPodOperator es un operator que lanza otro pod; es distinto de KubernetesExecutor.
Con executors simultáneos, la primera entrada configurada es la predeterminada. El campo executor de una tarea selecciona uno; un DAG puede establecer valores predeterminados de tarea usando default_args={"executor": "KubernetesExecutor"}, con anulaciones por tarea. El executor/alias debe estar configurado realmente con providers, versiones y permisos compatibles. Esta funcionalidad existe desde 2.10.0 y es distinta de la eliminación de los executors híbridos en 3.0.
5. Preparación para la Parte 2 y límites de la validación
Chart 1.22.0 requiere Helm 3.19.0+ y Airflow 3.1.0+. La lista de versiones de Kubernetes probadas para Airflow 3.3.1 es 1.30–1.35. Esto no es una garantía general para versiones futuras ni una recomendación de elegir EKS 1.30, que es antiguo. Comprueba también los periodos de soporte de EKS y la compatibilidad del provider/chart seleccionado.
La Parte 2 prepara las imágenes, las conexiones a la base de datos/broker, la entrega de DAG, los permisos y el almacenamiento. No des por sentado que el servidor de API, el scheduler, el procesador y el triggerer siempre consumen pocos recursos; mide el número de DAG, el costo de análisis, la carga de la API y la concurrencia de tareas.
helm version --short
helm repo add apache-airflow https://airflow.apache.org
helm repo update apache-airflow
helm show chart apache-airflow/airflow --version 1.22.0
kubectl config current-context
# Prints the namespace manifest; does not create it.
kubectl create namespace airflow --dry-run=client -o yaml
No esperes exactamente cuatro Deployments. En las variantes renderizadas del chart, el triggerer es un StatefulSet o un Deployment, según la persistencia, y hay recursos adicionales de StatsD, base de datos, broker o worker, según los valores. Las bases de datos externas no necesitan un pod de PostgreSQL en el clúster.
Este capítulo renderiza variantes de KubernetesExecutor, CeleryExecutor y git-sync con una anulación de 3.3.1. El renderizado no prueba una base de datos activa, tareas, descarga de imágenes ni recuperación ante fallos de alta disponibilidad; siguen siendo necesarias las comprobaciones del entorno de la Parte 2.