Parte 2: Spark Operator
Fecha de referencia de la revisión: Kubeflow operator/chart 2.5.2; Apache operator 1.0.0 / chart 1.8.0
Runtimes de ejemplo: el laboratorio Kubeflow usa Spark 4.0.4, que coincide con el runtime de envío de su imagen de controlador; el ejemplo de Apache usa Spark 4.2.0
Última revisión: 12 de septiembre de 2026
Dos proyectos y API distintas
Son proyectos que se mantienen por separado, no implementaciones intercambiables de un mismo manifiesto. Elige según la API/ciclo de vida que necesites, los recursos existentes, las combinaciones de runtime compatibles y las pruebas operativas. La antigüedad o una afirmación de popularidad no medida no garantizan compatibilidad.
| Elemento | Kubeflow Spark Operator | Apache Spark Kubernetes Operator |
|---|---|---|
| Versión revisada | 2.5.2 | 1.0.0 |
| Helm chart | 2.5.2 | 1.8.0; las versiones del chart y de la aplicación son distintas |
| API de aplicación usada aquí | sparkoperator.k8s.io/v1beta2 | spark.apache.org/v1 |
| Tipos principales de carga | SparkApplication, ScheduledSparkApplication; API SparkConnect separada | SparkApplication y SparkCluster |
| Modelo de configuración | type/mode/driver/executor/restartPolicy | runtimeVersions/driverSpec/executorSpec/applicationTolerations/sparkConf |
| Admisión que instalan estos charts | Webhooks mutantes y de validación | Este chart no instala un webhook equivalente que modifique Pods |
Apache SparkCluster puede administrar un clúster Spark residente, un modelo de ejecución distinto del flujo nativo SparkApplication de Kubernetes. Sus ejemplos de Comet/Gluten aún requieren binarios/complementos e imágenes adecuados, classpaths, configuración y compatibilidad de runtime/arquitectura. Instalar el operator no habilita automáticamente la aceleración, y esos complementos no justifican suponer que siempre gana un operator.
Ambos grupos de API pueden coexistir, pero hace falta planificar los ámbitos de observación, nombres, selectores de webhooks y RBAC. El laboratorio de abajo elige una sola ruta de instalación. Usa los nombres de recursos completos para evitar los atajos ambiguos de sparkapp.
Qué añade la conciliación
spark-submit puede esperar a que termine la ejecución y mostrar el estado de Pods/registros/interfaz/registros de eventos; los scripts, propiedades y plantillas de Pod también se pueden versionar en Git. No es intrínsecamente un proceso que se ejecuta sin esperar. Lo que no añade por sí solo es un CR SparkApplication administrado por un operator, un controlador de recursos programados ni reintentos automáticos de la aplicación.
Kubeflow envía intencionalmente el trabajo con spark.kubernetes.submission.waitAppCompletion=false y después concilia el estado de la aplicación y los Pods. También observa los Pods de executor y realiza la limpieza de ciclo de vida; es incorrecto decir que «el operator solo toca el driver». El driver de Spark sigue solicitando capacidad para executors y asignando tareas Spark.
Preparar el espacio de nombres y las identidades del laboratorio
Usa kubectl/Helm compatibles con tu clúster. Los ejemplos del chart se renderizaron con Kubernetes 1.36; la carga de trabajo Apache Spark 4.2 requiere Kubernetes 1.34 o posterior. No deduzcas el mínimo recomendado actual de Kubernetes a partir de una tabla antigua de README.
El Dockerfile fijado del controlador Kubeflow usa Spark 4.0.4 para el envío. Este capítulo alinea esa carga de laboratorio con 4.0.4; el envío directo de Spark 4.2 de la Parte 1 es independiente. Un campo sparkVersion de SparkApplication no actualiza la instalación de Spark dentro del controlador. Antes de adoptar otra combinación de submitter/carga, pruébala explícitamente.
Guarda/aplica job-rbac.yaml antes de instalar cualquiera de los dos charts. Coincide con los permisos de trabajo limitados al espacio de nombres de la Parte 1 y separa las identidades del driver y los executors. Si ya usas esos nombres, revisa los recursos existentes.
apiVersion: v1
kind: Namespace
metadata:
  name: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-driver
  namespace: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-executor
  namespace: spark-jobs
automountServiceAccountToken: false
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: spark-driver
  namespace: spark-jobs
rules:
- apiGroups:
  - ''
  resources:
  - pods
  - services
  - configmaps
  verbs:
  - create
  - get
  - list
  - watch
  - delete
  - patch
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: spark-driver
  namespace: spark-jobs
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: spark-driver
subjects:
- kind: ServiceAccount
  name: spark-driver
namespace: spark-jobskubectl apply -f job-rbac.yamlSparkPi no requiere acceso a datos de AWS. Los permisos de API del operator, los permisos de API del driver y los permisos de datos de AWS son aspectos distintos.
Opción A: instalación de Kubeflow
Guárdalo como kubeflow-values.yaml. De forma predeterminada, el chart observa default, no su propio espacio de nombres de instalación; el espacio de nombres observado debe coincidir con el espacio de nombres de los trabajos. Aquí los trabajos se ejecutan en spark-jobs, y el chart reutiliza el RBAC de trabajos preparado anteriormente. Los tamaños de recursos y la concurrencia de envíos son valores iniciales para el laboratorio que deben medirse.
spark:
  jobNamespaces:
  - spark-jobs
  jobNamespaceSelector: ''
  serviceAccount:
    create: false
  rbac:
    create: false
webhook:
  enable: true
  resources:
    requests:
      cpu: 100m
      memory: 128Mi
    limits:
      cpu: '1'
      memory: 512Mi
controller:
  workers: 2
  resources:
    requests:
      cpu: 500m
      memory: 1Gi
    limits:
      cpu: '2'
      memory: 2Gi
webhook.enable ya es true de forma predeterminada en 2.5.2. Se declara explícitamente para documentar la elección, no porque omitir el indicador deshabilite el webhook. Algunas personalizaciones usan admission; otras se traducen a configuración nativa de Spark. Deshabilitar el webhook no implica que se ignore toda configuración.
El checksum siguiente coincide con el activo de versión de GitHub descargado. Durante esta revisión, el digest del índice del repositorio no coincidía con los metadatos/la descarga del activo, así que el ejemplo usa directamente el archivo de versión verificado.
# Fresh installation after reviewing/applying job-rbac.yaml.
curl --fail --location --silent --show-error 'https://github.com/kubeflow/spark-operator/releases/download/v2.5.2/spark-operator-2.5.2.tgz' -o spark-operator-2.5.2.tgz
printf '%s\n' '762be5b8632ecfe12eb20fff54450ddae0427f09506422107c508a0d1d38655b  spark-operator-2.5.2.tgz' | sha256sum --check -
helm install spark-operator ./spark-operator-2.5.2.tgz \
  --namespace spark-operator --create-namespace \
  --values kubeflow-values.yaml --wait --timeout 5m
kubectl -n spark-operator get deployments,pods
Este ejemplo es para una instalación nueva. Para las actualizaciones, revisa el procedimiento de migración de CRD: las actualizaciones normales de Helm no reemplazan automáticamente las CRD de crds/, y hook.upgradeCrd de este chart es una opción que se habilita explícitamente. No elimines CRD compartidas como paso rutinario de actualización porque eso afecta a sus recursos personalizados.
En EKS, verifica el acceso del plano de control al Service/endpoints del webhook, el certificado de servicio/paquete de CA y los selectores. En este chart, el servidor escucha en 9443. Con failurePolicy=Fail, si un webhook no está disponible puede bloquear las admisiones coincidentes. Que el Deployment esté listo no demuestra que se pueda admitir una carga de Spark.
SparkApplication de Kubeflow
Guárdalo como spark-pi.yaml. Usa un ejemplo real que ya se incluye en la imagen fijada, así evita depender de un objeto S3 no especificado o de una clase ETL personalizada ausente.
apiVersion: sparkoperator.k8s.io/v1beta2
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: spark-jobs
spec:
  type: Scala
  mode: cluster
  image: apache/spark:4.0.4@sha256:94ad730f7510002d8a1615de269f27cdeca4d4eef51657384db3fa9246b5a4d8
  imagePullPolicy: IfNotPresent
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: local:///opt/spark/examples/jars/spark-examples_2.13-4.0.4.jar
  arguments:
  - '10'
  sparkVersion: 4.0.4
  restartPolicy:
    type: OnFailure
    onFailureRetries: 3
    onFailureRetryInterval: 30
    onSubmissionFailureRetries: 3
    onSubmissionFailureRetryInterval: 30
  driver:
    cores: 1
    coreLimit: '1'
    memory: 1g
    serviceAccount: spark-driver
    podSecurityContext: &id001
      runAsNonRoot: true
      runAsUser: 185
      seccompProfile:
        type: RuntimeDefault
    securityContext: &id002
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
  executor:
    cores: 1
    coreLimit: '1'
    instances: 2
    memory: 1g
    serviceAccount: spark-executor
    terminationGracePeriodSeconds: 60
    podSecurityContext: *id001
    securityContext: *id002
En esta versión, los campos driver.serviceAccount y executor.serviceAccount son válidos. La configuración de reintentos se aplica a los intentos de envío/aplicación, no solo al reinicio local de un contenedor. Una nueva ejecución puede repetir los efectos secundarios de salida; en trabajos reales, diseña una salida idempotente o transaccional.
El campo de período de gracia del executor lo aplica el mutador de Pods de Kubeflow. No es lo mismo que la anulación de la plantilla nativa de Spark 4.2 que se comenta en la Parte 1. Si habilitas el decomisionamiento de Spark o hooks de ciclo de vida personalizados, inspecciona cómo interactúan el operator elegido, el runtime de Spark y el webhook.
kubectl apply -f spark-pi.yaml
kubectl -n spark-jobs get sparkapplications.sparkoperator.k8s.io spark-pi \
  -o jsonpath='{.status.applicationState.state}{"\n"}'
kubectl -n spark-jobs describe sparkapplications.sparkoperator.k8s.io spark-pi
DRIVER_POD="$(kubectl -n spark-jobs get sparkapplications.sparkoperator.k8s.io spark-pi \
  -o jsonpath='{.status.driverInfo.podName}')"
: "${DRIVER_POD:?Driver pod name is not available yet; inspect submission events}"
kubectl -n spark-jobs logs "$DRIVER_POD"
Lee el estado y los eventos actuales, incluidos los fallos de envío, y luego identifica el nombre real del Pod driver. kubectl get -w abre una observación continua que hay que interrumpir; no es un paso finito de «esperar hasta el éxito». COMPLETED indica que terminó el proceso, no que un conjunto de datos externo sea correcto.
Programación explícita en UTC
Guárdalo como scheduled-spark-pi.yaml. Programa intencionalmente el mismo ejemplo inocuo de Pi; para procesar datos reales, reemplázalo por un programa ETL empaquetado y probado.
apiVersion: sparkoperator.k8s.io/v1beta2
kind: ScheduledSparkApplication
metadata:
  name: daily-spark-pi
  namespace: spark-jobs
spec:
  schedule: 0 2 * * *
  timeZone: UTC
  concurrencyPolicy: Forbid
  successfulRunHistoryLimit: 2
  failedRunHistoryLimit: 2
  template:
    type: Scala
    mode: cluster
    image: apache/spark:4.0.4@sha256:94ad730f7510002d8a1615de269f27cdeca4d4eef51657384db3fa9246b5a4d8
    imagePullPolicy: IfNotPresent
    mainClass: org.apache.spark.examples.SparkPi
    mainApplicationFile: local:///opt/spark/examples/jars/spark-examples_2.13-4.0.4.jar
    arguments:
    - '10'
    sparkVersion: 4.0.4
    restartPolicy:
      type: OnFailure
      onFailureRetries: 3
      onFailureRetryInterval: 30
      onSubmissionFailureRetries: 3
      onSubmissionFailureRetryInterval: 30
    driver:
      cores: 1
      coreLimit: '1'
      memory: 1g
      serviceAccount: spark-driver
      podSecurityContext: &id001
        runAsNonRoot: true
        runAsUser: 185
        seccompProfile:
          type: RuntimeDefault
      securityContext: &id002
        allowPrivilegeEscalation: false
        capabilities:
          drop:
          - ALL
    executor:
      cores: 1
      coreLimit: '1'
      instances: 2
      memory: 1g
      serviceAccount: spark-executor
      terminationGracePeriodSeconds: 60
      podSecurityContext: *id001
      securityContext: *id002
timeZone es compatible con 2.5.2; si no se especifica, el valor predeterminado es Local del controlador. Aquí, el horario significa las 02:00 UTC. Forbid comprueba la ejecución anterior de este recurso programado; no evita efectos duplicados por reintentos, ejecuciones manuales u otro planificador. Los límites del historial limitan el historial de ejecuciones secundarias retenido, no las copias de seguridad de los datos.
kubectl apply -f scheduled-spark-pi.yaml
kubectl -n spark-jobs get scheduledsparkapplications.sparkoperator.k8s.io daily-spark-pi -o yaml
# Stop future schedule triggers; this does not itself terminate an active child run.
kubectl -n spark-jobs patch scheduledsparkapplications.sparkoperator.k8s.io daily-spark-pi \
  --type=merge -p '{"spec":{"suspend":true}}'
Opción B: Apache operator, una ruta aparte
Para este laboratorio, usa apache-values.yaml en lugar de la Opción A. Observa spark-jobs, usa roles de espacio de nombres para el operator y reutiliza las identidades de trabajo existentes. Los comentarios del chart pueden usar nombres de propiedades antiguos; la configuración renderizada establece spark.kubernetes.operator.watchedNamespaces=spark-jobs.
workloadResources:
  namespaces:
    create: false
    overrideWatchedNamespaces: true
    data:
    - spark-jobs
  serviceAccount:
    create: false
  role:
    create: false
  clusterRole:
    create: false
  roleBinding:
    create: false
operatorRbac:
  clusterRole:
    create: false
  clusterRoleBinding:
    create: false
  role:
    create: true
  roleBinding:
create: true# Fresh installation after reviewing/applying job-rbac.yaml.
curl --fail --location --silent --show-error 'https://github.com/apache/spark-kubernetes-operator/releases/download/1.0.0/spark-kubernetes-operator-1.8.0.tgz' -o spark-kubernetes-operator-1.8.0.tgz
printf '%s\n' '7536a8849b8a7c242283d0e393b5e0ec56365f34ec93717b158c76dfa1036a06 spark-kubernetes-operator-1.8.0.tgz' | sha256sum --check -
helm install asf-spark-operator ./spark-kubernetes-operator-1.8.0.tgz \
--namespace spark-operator-asf --create-namespace \
--values apache-values.yaml --wait --timeout 5m
kubectl -n spark-operator-asf get deployments,podsLa versión de Apache tiene un modelo de ciclo de vida y una imagen de runtime distintos de los de Kubeflow. Usa la imagen publicada por ese proyecto; las suposiciones sobre la versión de Java de la carga de trabajo no determinan los requisitos de Java de la imagen del operator.
Este ejemplo v1 usa Spark 4.2.0 y conserva brevemente los recursos para inspeccionarlos:
apiVersion: spark.apache.org/v1
kind: SparkApplication
metadata:
  name: spark-pi-asf
  namespace: spark-jobs
spec:
  runtimeVersions:
    sparkVersion: 4.2.0
  mainClass: org.apache.spark.examples.SparkPi
  jars: local:///opt/spark/examples/jars/spark-examples.jar
  driverArgs:
  - '10'
  sparkConf:
    spark.kubernetes.namespace: spark-jobs
    spark.kubernetes.container.image: spark:4.2.0-scala2.13-java21-ubuntu
    spark.kubernetes.authenticate.driver.serviceAccountName: spark-driver
    spark.kubernetes.authenticate.executor.serviceAccountName: spark-executor
    spark.executor.instances: '2'
  applicationTolerations:
    resourceRetainPolicy: Always
    ttlAfterStopMillis: 600000
ttlAfterStopMillis: 600000 permite que el controlador elimine la aplicación y los recursos asociados después de su parada final. resourceRetainPolicy: Always conserva los recursos creados por el operator hasta la limpieza; no anula la configuración del driver para eliminar sus propios executors/Services ni conserva los recursos entre reintentos.
kubectl apply -f apache-spark-pi.yaml
kubectl -n spark-jobs get sparkapplications.spark.apache.org spark-pi-asf -o yaml
La versión también sirve el esquema v1beta1 anterior, pero en los ejemplos nuevos de aquí se usa v1. Cambiar solo apiVersion en un recurso de Kubeflow no migra sus campos, su estado ni su comportamiento de reintento/retención. No apliques el esquema ScheduledSparkApplication ni restartPolicy de Kubeflow a la API de Apache.
Qué ocurre alrededor de la creación de Pods
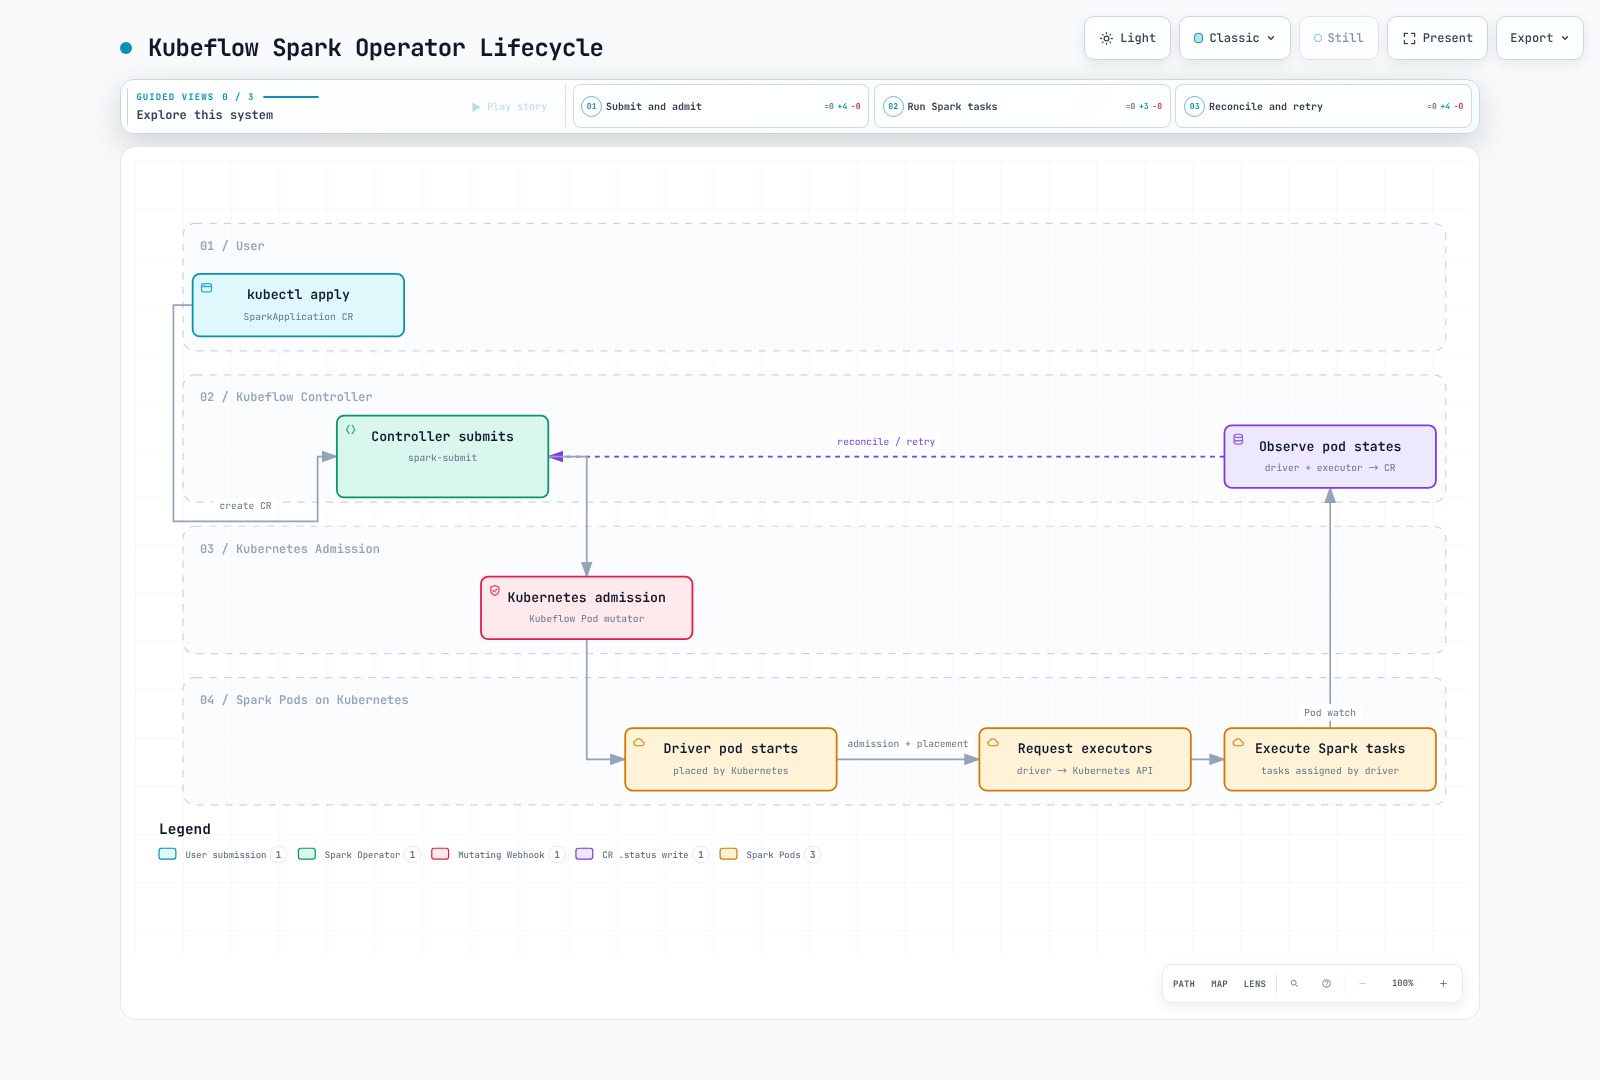
El webhook forma parte de la admisión de Kubernetes; no sustituye la programación en nodos ni la programación de tareas de Spark. Los dos operators requieren su propio análisis de arquitectura/API; este flujo ilustra Kubeflow.
Almacenamiento, identidad y métricas
Ubicación correcta del volumen temporal
En la API de Kubeflow, los volúmenes se definen en spec.volumes, con los mounts bajo driver/executor. spec.driver.volumes y spec.executor.volumes no son campos de esta CRD. Este parche merge aplica al ejemplo completo de Kubeflow:
spec:
  volumes:
  - name: spark-local-dir-scratch
    emptyDir:
      sizeLimit: 8Gi
  driver:
    volumeMounts:
    - name: spark-local-dir-scratch
      mountPath: /var/data/spark-local
  executor:
    volumeMounts:
    - name: spark-local-dir-scratch
mountPath: /var/data/spark-localkubectl -n spark-jobs patch sparkapplications.sparkoperator.k8s.io spark-pi \
--type=merge --patch-file scratch.patch.yamlAplica la personalización de almacenamiento antes de ejecutar una carga real; al actualizar una aplicación puede volver a enviarse. Los parches merge JSON reemplazan arrays, así que al adaptar otra aplicación, combina las listas existentes de volúmenes/mounts con este parche.
El prefijo spark-local-dir- tiene tratamiento especial: el operator traduce estos volúmenes/mounts locales a configuración nativa de volúmenes de Spark, mientras que el mutador genérico de volúmenes del Pod los omite. Se pueden pasar otros volúmenes personalizados por la ruta del webhook. No des por sentado que todos los campos se implementan mediante un único mecanismo.
Un emptyDir adicional no crea un disco físico independiente ni selecciona NVMe. Usa el sistema de archivos configurado en el nodo, salvo que esté respaldado por memoria. El sistema de archivos de kubelet/contenedor podría residir en EBS, almacenamiento de instancia u otra distribución configurada. Configura/verifica el almacenamiento del nodo o un volumen persistente adecuado, y planifica requests, limits y comportamiento ante presión de disco para almacenamiento efímero.
IRSA y Pod Identity son diferentes
Para trabajos de S3, configura los permisos de datos y la confianza/asociación reales de las identidades del driver/executor, además de proveedores de credenciales y bibliotecas Hadoop S3A/AWS compatibles. Una imagen estándar, una anotación ARN o el texto s3a:// no bastan por sí solos. El proceso que obtiene un artefacto/plantilla también necesita los permisos correspondientes.
- IRSA usa la anotación del rol en la cuenta de servicio, confianza OIDC e intercambio de credenciales web identity.
- EKS Pod Identity usa una asociación y la ruta de credenciales de contenedor del Pod Identity Agent; no usa la anotación de rol de IRSA como asociación.
- RBAC de Kubernetes no concede permisos de S3. Usa credenciales temporales y comprueba la identidad/acceso efectivo a datos en los Pods reales.
La Parte 5 incluye ejemplos completos de acceso a datos y seguridad. No coloques claves estáticas de AWS en la especificación ni en la imagen de la aplicación.
Las métricas del controlador no son JMX de la carga de trabajo
El endpoint Prometheus predeterminado del chart expone métricas del operator en 8080. No añade automáticamente un agente Java JMX a cada JVM de Spark. El monitoreo de la carga se configura explícitamente y requiere el JAR/configuración adecuados del exportador en la imagen, además de scraping/descubrimiento. Los endpoints nativos de métricas de Spark y los registros de eventos/historial son mecanismos adicionales. Consulta la Parte 5 para la configuración detallada.
Alcance de la limpieza y la validación
Pausa las programaciones antes de eliminar las ejecuciones de demostración y comprueba si la eliminación de un recurso principal se propagará a los recursos secundarios. Usa el grupo de API correspondiente:
# Kubeflow demo resources, if installed:
kubectl -n spark-jobs delete scheduledsparkapplications.sparkoperator.k8s.io daily-spark-pi
kubectl -n spark-jobs delete sparkapplications.sparkoperator.k8s.io spark-pi
# Apache demo resource, if installed:
kubectl -n spark-jobs delete sparkapplications.spark.apache.org spark-pi-asf
El renderizado del chart y las comprobaciones de CRD publicadas validan la forma de los recursos, los espacios de nombres y las rutas de configuración. No demuestran que un webhook en vivo, la combinación de controlador/runtime, el acceso a S3, la corrección de los datos o la recuperación de reintentos funcionen. Antes de promover una carga de trabajo real, inspecciona los Pods generados, el estado y la salida.
- Kubeflow Spark Operator 2.5.2
- API de aplicación de Kubeflow 2.5.2
- API programada de Kubeflow 2.5.2
- Conversión de envío/configuración de Kubeflow
- Mutador de Pods de Kubeflow
- Apache operator 1.0.0
- Configuración de Apache operator
- Ejemplo de Comet de Apache y requisitos previos
- Ejemplo de Gluten de Apache y requisitos previos
- Configuración de Spark en Kubernetes