Arquitectura del clúster
Versiones compatibles: Kubernetes 1.35, 1.36, 1.37 Última actualización: October 12, 2026
El encabezado de versiones se refiere a Kubernetes upstream. El proyecto mantiene ramas de lanzamiento para las tres versiones menores más recientes (1.35–1.37). Upstream 1.34 está en modo de mantenimiento y continúa recibiendo versiones de parche hasta el fin de su vida útil el October 27, 2026, por separado de su fecha de finalización de soporte de AWS en EKS.
A fecha de October 12, 2026, el soporte estándar de EKS cubre las versiones 1.34–1.37; EKS 1.37 estuvo disponible el October 1, 2026. Consulte el estado de versiones de Kubernetes y el ciclo de vida de EKS antes de seleccionar una versión.
Los comandos de componentes que aparecen a continuación ilustran clústeres autogestionados; EKS administra su control plane. Las etiquetas de imágenes y los ID de infraestructura son ejemplos: seleccione imágenes compatibles y mantenidas, y sustituya los marcadores de posición antes de utilizarlos.
Configuración del entorno de laboratorio
Para practicar los conceptos de este documento, necesita las siguientes herramientas y entorno:
Herramientas necesarias
- kubectl dentro de una versión menor del servidor de API
- Un clúster de Kubernetes funcional (EKS, minikube, kind, etc.)
Configuración del entorno de desarrollo local
# Install minikube (for local development)
curl -LO https://storage.googleapis.com/minikube/releases/latest/minikube-linux-amd64
sudo install minikube-linux-amd64 /usr/local/bin/minikube

# Start cluster
minikube start

# Check cluster status
kubectl cluster-info

# Check control plane components
kubectl get pods -n kube-system
Descripción general de la arquitectura del clúster
Concepto principal: Un clúster de Kubernetes consta del control plane y los worker nodes, cada uno compuesto por varios componentes que desempeñan roles específicos.
Un clúster de Kubernetes consta de un conjunto de nodos (máquinas virtuales o físicas) para ejecutar aplicaciones en contenedores. El clúster se divide principalmente en el control plane y los worker nodes.
Diagrama de arquitectura del clúster
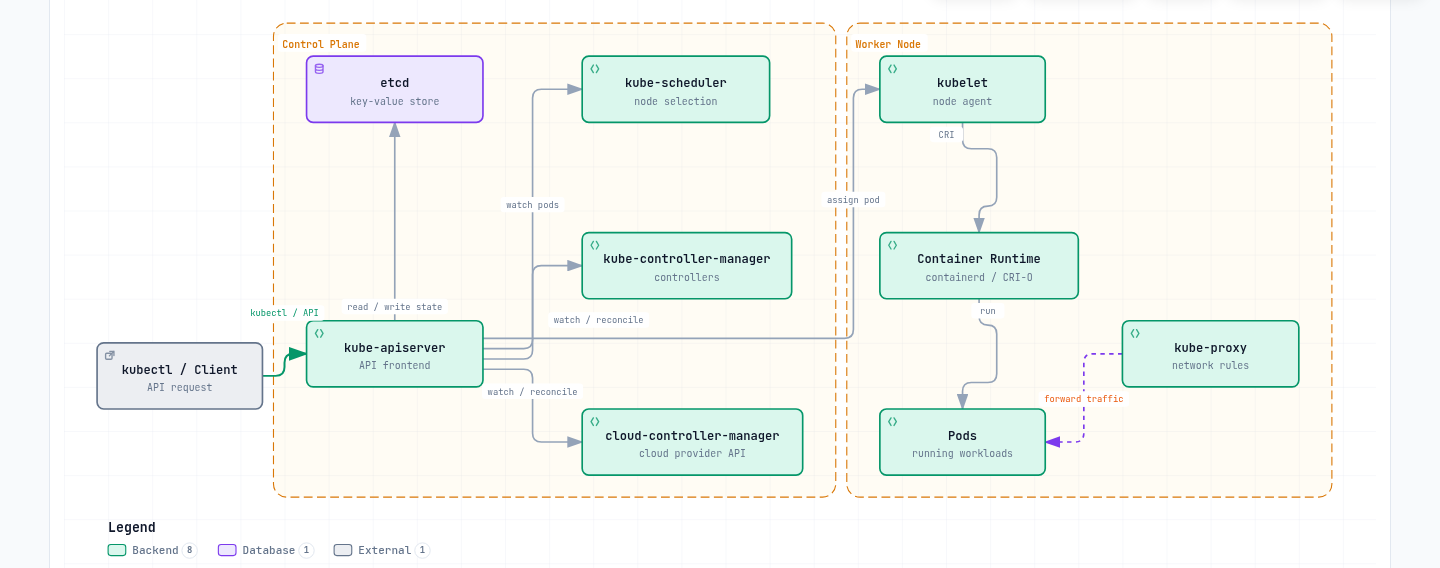
Componentes del control plane:
- kube-apiserver: Frontend que expone la API de Kubernetes
- etcd: Almacén de clave-valor que guarda el estado de la API de Kubernetes
- kube-scheduler: Selecciona nodos para ejecutar pods recién creados
- kube-controller-manager: Ejecuta controllers que administran el estado del clúster
- cloud-controller-manager: Interactúa con las API de proveedores de nube
Componentes de worker node:
- kubelet: Agente que se ejecuta en cada nodo y administra la ejecución de contenedores
- kube-proxy: Mantiene reglas de red y realiza el reenvío de conexiones
- Container Runtime: Ejecuta contenedores (containerd, CRI-O, etc.)
Componentes del control plane
El control plane actúa como el "cerebro" del clúster de Kubernetes, administrando y controlando el estado general del clúster. Los componentes del control plane normalmente se ejecutan en máquinas dedicadas y se pueden replicar en varias instancias para lograr alta disponibilidad.
Detalles de los componentes del control plane
| Componente | Funciones principales | Destinos de comunicación | Configuración de alta disponibilidad |
|---|---|---|---|
| kube-apiserver | - Proporciona la API de Kubernetes - Autenticación y autorización - Procesamiento de solicitudes de API | - Todos los componentes - etcd | Escalado horizontal con varias instancias |
| etcd | - Almacena datos del clúster - Almacén distribuido de clave-valor - Garantiza la consistencia | - kube-apiserver | Clúster multinodo |
| kube-scheduler | - Decisiones de ubicación de Pod - Evalúa recursos de nodo - Aplica afinidad/antiafinidad | - kube-apiserver | Configuración activo-en-espera |
| kube-controller-manager | - Node controller - Replication controller - Endpoint controller - Service account controller | - kube-apiserver | Configuración activo-en-espera |
| cloud-controller-manager | - Integración de proveedores de nube - Ciclo de vida de nodos - Enrutamiento y balanceo de carga | - kube-apiserver - API de nube | Configuración activo-en-espera |
Flujo de comunicación del control plane
- El usuario o controller envía una solicitud a kube-apiserver
- kube-apiserver realiza autenticación, autorización y admisión
- kube-apiserver lee/escribe datos desde/hacia etcd
- Los controllers y el scheduler observan el estado del clúster mediante kube-apiserver
- kubelet informa el estado del nodo a kube-apiserver
kube-apiserver
kube-apiserver es el frontend del control plane que expone la API de Kubernetes. Todas las solicitudes internas y externas se procesan a través de este servidor de API.
Funciones principales:
- Proporciona API REST
- Autenticación y autorización
- Validación y procesamiento de solicitudes
- Comunicación con etcd
- Escalable horizontalmente (puede escalar a varias instancias)
Principales flags y opciones de configuración:
# Basic configuration example
kube-apiserver \
  --advertise-address=192.168.1.10 \
  --allow-privileged=true \
  --authorization-mode=Node,RBAC \
  --client-ca-file=/etc/kubernetes/pki/ca.crt \
  --enable-admission-plugins=NodeRestriction \
  --enable-bootstrap-token-auth=true \
  --etcd-servers=https://127.0.0.1:2379 \
  --etcd-cafile=/etc/kubernetes/pki/etcd/ca.crt \
  --etcd-certfile=/etc/kubernetes/pki/apiserver-etcd-client.crt \
  --etcd-keyfile=/etc/kubernetes/pki/apiserver-etcd-client.key \
  --kubelet-client-certificate=/etc/kubernetes/pki/apiserver-kubelet-client.crt \
  --kubelet-client-key=/etc/kubernetes/pki/apiserver-kubelet-client.key \
  --service-account-key-file=/etc/kubernetes/pki/sa.pub \
  --service-account-signing-key-file=/etc/kubernetes/pki/sa.key \
  --service-account-issuer=https://kubernetes.default.svc.cluster.local \
  --service-cluster-ip-range=10.96.0.0/12 \
  --tls-cert-file=/etc/kubernetes/pki/apiserver.crt \
  --tls-private-key-file=/etc/kubernetes/pki/apiserver.key
Seguridad del servidor de API:
- Comunicación segura mediante certificados TLS
- Admite varios métodos de autenticación (certificados X.509, tokens de service account, OIDC, webhooks, etc.)
- Administración de permisos mediante RBAC (Role-Based Access Control)
- Validación y modificación de solicitudes mediante admission controllers
etcd
etcd es un almacén de clave-valor consistente y de alta disponibilidad que guarda el estado de la API de Kubernetes. Actúa como la "fuente de verdad" de Kubernetes.
Características principales:
- Sistema distribuido
- Consistencia fuerte (utiliza el algoritmo de consenso Raft)
- Alta disponibilidad (se puede configurar con varios nodos)
- Almacenamiento seguro de datos
- Funcionalidad de observación para supervisar cambios
Configuración de clúster de etcd:
# etcd cluster configuration example (3 nodes)
etcd \
  --name etcd-1 \
  --initial-advertise-peer-urls https://192.168.1.11:2380 \
  --listen-peer-urls https://192.168.1.11:2380 \
  --listen-client-urls https://192.168.1.11:2379,https://127.0.0.1:2379 \
  --advertise-client-urls https://192.168.1.11:2379 \
  --initial-cluster-token etcd-cluster \
  --initial-cluster etcd-1=https://192.168.1.11:2380,etcd-2=https://192.168.1.12:2380,etcd-3=https://192.168.1.13:2380 \
  --initial-cluster-state new \
  --data-dir=/var/lib/etcd \
  --cert-file=/etc/kubernetes/pki/etcd/server.crt \
  --key-file=/etc/kubernetes/pki/etcd/server.key \
  --trusted-ca-file=/etc/kubernetes/pki/etcd/ca.crt \
  --client-cert-auth=true \
  --peer-cert-file=/etc/kubernetes/pki/etcd/peer.crt \
  --peer-key-file=/etc/kubernetes/pki/etcd/peer.key \
  --peer-trusted-ca-file=/etc/kubernetes/pki/etcd/ca.crt \
  --peer-client-cert-auth=true
Copia de seguridad y recuperación de etcd:
# etcd backup
ETCDCTL_API=3 etcdctl snapshot save snapshot.db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key

# etcd recovery
etcdutl snapshot restore snapshot.db \
  --bump-revision=1000000000 --mark-compacted \
  --data-dir=/var/lib/etcd-restore \
  --name=etcd-1 \
  --initial-cluster=etcd-1=https://192.168.1.11:2380 \
  --initial-cluster-token=etcd-cluster \
  --initial-advertise-peer-urls=https://192.168.1.11:2380
Optimización del rendimiento de etcd:
- Optimización de I/O de disco (se recomienda SSD)
- Asignación de memoria adecuada
- Compactación y desfragmentación periódicas
- Cantidad adecuada de nodos de etcd según el tamaño del clúster (normalmente 3 o 5)
Actualización de July 2026: lanzamiento de etcd v3.7.0
El July 8, 2026, SIG etcd lanzó etcd v3.7.0. Aspectos destacados:
- RangeStream: transmite resultados de rangos grandes en fragmentos en lugar de almacenar toda la respuesta en memoria (una función solicitada desde hace tiempo)
- Mejoras de rendimiento: solicitudes de rango solo de claves optimizadas, leases más rápidos y confiables
- Elimina los últimos restos del v2store heredado y completa una importante renovación de protobuf
- Incluye las dependencias básicas actualizadas bbolt v1.5.0 y raft v3.7.0
Consulte el anuncio oficial y el registro de cambios de etcd v3.7 para obtener detalles.
kube-scheduler
kube-scheduler es el componente del control plane que selecciona nodos para ejecutar pods recién creados.
Proceso de scheduling:
Filtrado: Identificación de nodos que pueden ejecutar el pod
- Requisitos de recursos (CPU, memoria)
- Selectores de nodos, afinidad de nodos
- Taints y tolerations
- Restricciones de volumen
Puntuación: Asignación de puntuaciones a nodos adecuados
- Utilización de recursos
- Interafinidad/antiafinidad de Pod
- Localidad de datos
- Balanceo de carga entre nodos
Vinculación: Asignación del pod al nodo óptimo
Configuración de Scheduler:
# Basic configuration example
kube-scheduler \
  --kubeconfig=/etc/kubernetes/scheduler.conf \
  --leader-elect=true \
  --v=2
Perfiles y plugins de Scheduler:
- Perfiles de scheduler predeterminados
- Perfiles de scheduler personalizados
- Puntos de extensión del scheduler (filter, score, bind, etc.)
- Compatibilidad con varios schedulers
Política de scheduling:
# Scheduling policy example
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
- schedulerName: default-scheduler
  pluginConfig:
  - name: NodeResourcesFit
    args:
      scoringStrategy:
        type: MostAllocated
        resources:
        - name: cpu
          weight: 1
        - name: memory
          weight: 1
kube-controller-manager
kube-controller-manager es el componente del control plane que ejecuta varios procesos de controller. Cada controller administra un aspecto específico del clúster.
Controllers principales:
- Node Controller: Supervisa y responde al estado del nodo
- Replication Controller: Mantiene el número de réplicas de pod
- EndpointSlice Controller: Realiza seguimiento de los backends de Service en EndpointSlices
- Service Account & Token Controllers: Crean ServiceAccounts predeterminadas y mantienen Secrets de tokens heredados solicitados explícitamente; los Pods actuales usan tokens TokenRequest de corta duración
- Job Controller: Administra tareas de una sola ejecución
- CronJob Controller: Administra tareas programadas
- DaemonSet Controller: Garantiza que pods específicos se ejecuten en todos los nodos
- StatefulSet Controller: Administra aplicaciones con estado
- PV Controller: Administra volúmenes persistentes
- Namespace Controller: Administra el ciclo de vida de namespaces
- Garbage Collector: Limpia objetos huérfanos
Configuración de Controller Manager:
# Basic configuration example
kube-controller-manager \
  --kubeconfig=/etc/kubernetes/controller-manager.conf \
  --leader-elect=true \
  --use-service-account-credentials=true \
  --root-ca-file=/etc/kubernetes/pki/ca.crt \
  --service-account-private-key-file=/etc/kubernetes/pki/sa.key \
  --cluster-signing-cert-file=/etc/kubernetes/pki/ca.crt \
  --cluster-signing-key-file=/etc/kubernetes/pki/ca.key \
  --controllers=*,bootstrapsigner,tokencleaner
Operación de controllers:
- Los controllers observan continuamente el estado del clúster a través del servidor de API
- Detectan diferencias entre el estado actual y el deseado
- Realizan operaciones para reconciliar la diferencia
- Informan cambios de estado al servidor de API
cloud-controller-manager
cloud-controller-manager es el componente del control plane que contiene lógica de control específica de la nube. Esto permite separar el núcleo de Kubernetes de las API de proveedores de nube.
Controllers principales:
- Node Controller: Comprueba el estado del nodo mediante la API del proveedor de nube
- Route Controller: Configura rutas en entornos de nube
- Service Controller: Crea, actualiza y elimina balanceadores de carga de nube
El aprovisionamiento y la conexión de almacenamiento en nube utilizan controllers CSI; kubelet y los plugins de nodo CSI manejan los montajes. Estas no son responsabilidades de cloud-controller-manager.
Implementaciones de proveedores de nube:
- AWS Cloud Controller Manager
- Azure Cloud Controller Manager
- GCP Cloud Controller Manager
- OpenStack Cloud Controller Manager
- vSphere Cloud Controller Manager
Configuración de Cloud Controller Manager:
# AWS Cloud Controller Manager example
cloud-controller-manager \
  --cloud-provider=aws \
  --cloud-config=/etc/kubernetes/cloud-config \
  --kubeconfig=/etc/kubernetes/cloud-controller-manager.conf \
  --leader-elect=true
Beneficios de Cloud Controller Manager:
- Separación del código específico del proveedor de nube del núcleo de Kubernetes
- Los proveedores de nube pueden desarrollar sus propias funciones de forma independiente
- Añada funciones de nube sin cambiar el núcleo de Kubernetes
Componentes de nodo
Los nodos son las máquinas worker del clúster de Kubernetes que ejecutan aplicaciones en contenedores. Cada nodo es administrado por el control plane y consta de varios componentes.
kubelet
kubelet es un agente que se ejecuta en cada nodo y administra contenedores dentro de pods. kubelet recibe PodSpecs mediante diversos mecanismos y garantiza que los contenedores se ejecuten correctamente de acuerdo con esas especificaciones.
Funciones principales:
- Ejecuta contenedores según PodSpec
- Supervisa e informa el estado de los contenedores
- Administra el ciclo de vida de los contenedores
- Administra montajes de volúmenes
- Informa el estado del nodo
- Realiza comprobaciones de estado de los contenedores
Configuración de kubelet:
# Basic configuration example
kubelet \
  --kubeconfig=/etc/kubernetes/kubelet.conf \
  --config=/var/lib/kubelet/config.yaml \
  --container-runtime-endpoint=unix:///run/containerd/containerd.sock
Ejemplo de archivo de configuración de kubelet:
# /var/lib/kubelet/config.yaml
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
address: 0.0.0.0
authentication:
  anonymous:
    enabled: false
  webhook:
    cacheTTL: 2m0s
    enabled: true
  x509:
    clientCAFile: /etc/kubernetes/pki/ca.crt
authorization:
  mode: Webhook
  webhook:
    cacheAuthorizedTTL: 5m0s
    cacheUnauthorizedTTL: 30s
cgroupDriver: systemd
clusterDomain: cluster.local
cpuManagerPolicy: none
evictionHard:
  memory.available: 100Mi
  nodefs.available: 10%
  nodefs.inodesFree: 5%
failSwapOn: true
healthzBindAddress: 127.0.0.1
healthzPort: 10248
Static Pods: El manifiesto siguiente es un fragmento, no una instalación completa de control plane; también necesita redes de host, certificados, montajes y la configuración completa del servidor de API. kubelet puede ejecutar static pods que administra directamente sin pasar por el servidor de API. Esto se utiliza principalmente para ejecutar componentes del control plane.
# /etc/kubernetes/manifests/kube-apiserver.yaml
apiVersion: v1
kind: Pod
metadata:
  name: kube-apiserver
  namespace: kube-system
spec:
  containers:
  - name: kube-apiserver
    image: registry.k8s.io/kube-apiserver:v1.37.1
    command:
    - kube-apiserver
    - --advertise-address=192.168.1.10
    # ... additional flags
kube-proxy
kube-proxy es un proxy de red que se ejecuta en cada nodo e implementa el concepto de Service de Kubernetes. Mantiene reglas de red en los nodos y realiza el reenvío de conexiones.
Funciones principales:
- Mantiene reglas de red para IP y puertos de servicio
- Reenvío de conexiones
- Implementa balanceo de carga
- Admite descubrimiento de servicios
Modos de operación:
- iptables: Modo predeterminado de Linux; instala reglas de procesamiento de paquetes del kernel
- nftables: Estable desde v1.33; compruebe la compatibilidad del kernel y de CNI
- IPVS: Modo heredado de Linux, obsoleto desde v1.35; migre a una alternativa compatible
- kernelspace: Modo de Windows
El antiguo modo userspace se eliminó. Algunas implementaciones de red reemplazan kube-proxy por completo.
Configuración de kube-proxy:
# Basic configuration example
kube-proxy \
  --config=/var/lib/kube-proxy/config.conf \
  --hostname-override=node1
Ejemplo de archivo de configuración de kube-proxy:
# /var/lib/kube-proxy/config.conf
apiVersion: kubeproxy.config.k8s.io/v1alpha1
kind: KubeProxyConfiguration
bindAddress: 0.0.0.0
clientConnection:
  acceptContentTypes: ""
  burst: 10
  contentType: application/vnd.kubernetes.protobuf
  kubeconfig: /var/lib/kube-proxy/kubeconfig.conf
  qps: 5
clusterCIDR: 10.244.0.0/16
configSyncPeriod: 15m0s
conntrack:
  maxPerCore: 32768
  min: 131072
  tcpCloseWaitTimeout: 1h0m0s
  tcpEstablishedTimeout: 24h0m0s
enableProfiling: false
healthzBindAddress: 0.0.0.0:10256
hostnameOverride: node1
iptables:
  masqueradeAll: false
  masqueradeBit: 14
  minSyncPeriod: 0s
  syncPeriod: 30s
ipvs:
  excludeCIDRs: null
  minSyncPeriod: 0s
  scheduler: ""
  syncPeriod: 30s
mode: "iptables"
Comparación de modos IPVS e iptables:
| Característica | Modo iptables | Modo IPVS |
|---|---|---|
| Rendimiento | Degradación de rendimiento con muchos servicios | Mejor rendimiento en clústeres grandes |
| Algoritmos de balanceo de carga | Selección aleatoria de backend de forma predeterminada | Se admiten varios algoritmos (rr, lc, dh, sh, sed, nq) |
| Implementación | Cadenas de filtrado de paquetes de red | Basada en tabla hash |
| Requisitos del kernel | Módulos de kernel predeterminados | Se requiere módulo de kernel IPVS |
Container Runtime
Container runtime es el software que ejecuta contenedores. Kubernetes admite varios container runtimes mediante Container Runtime Interface (CRI).
Principales container runtimes:
- containerd: Container runtime ligero (actualmente el más utilizado)
- CRI-O: Runtime ligero diseñado específicamente para Kubernetes
- Docker Engine: Requiere un adaptador CRI externo como cri-dockerd; el dockershim integrado se eliminó en v1.24. Las imágenes OCI creadas con Docker siguen funcionando con containerd/CRI-O.
Estructura de capas de Container Runtime:
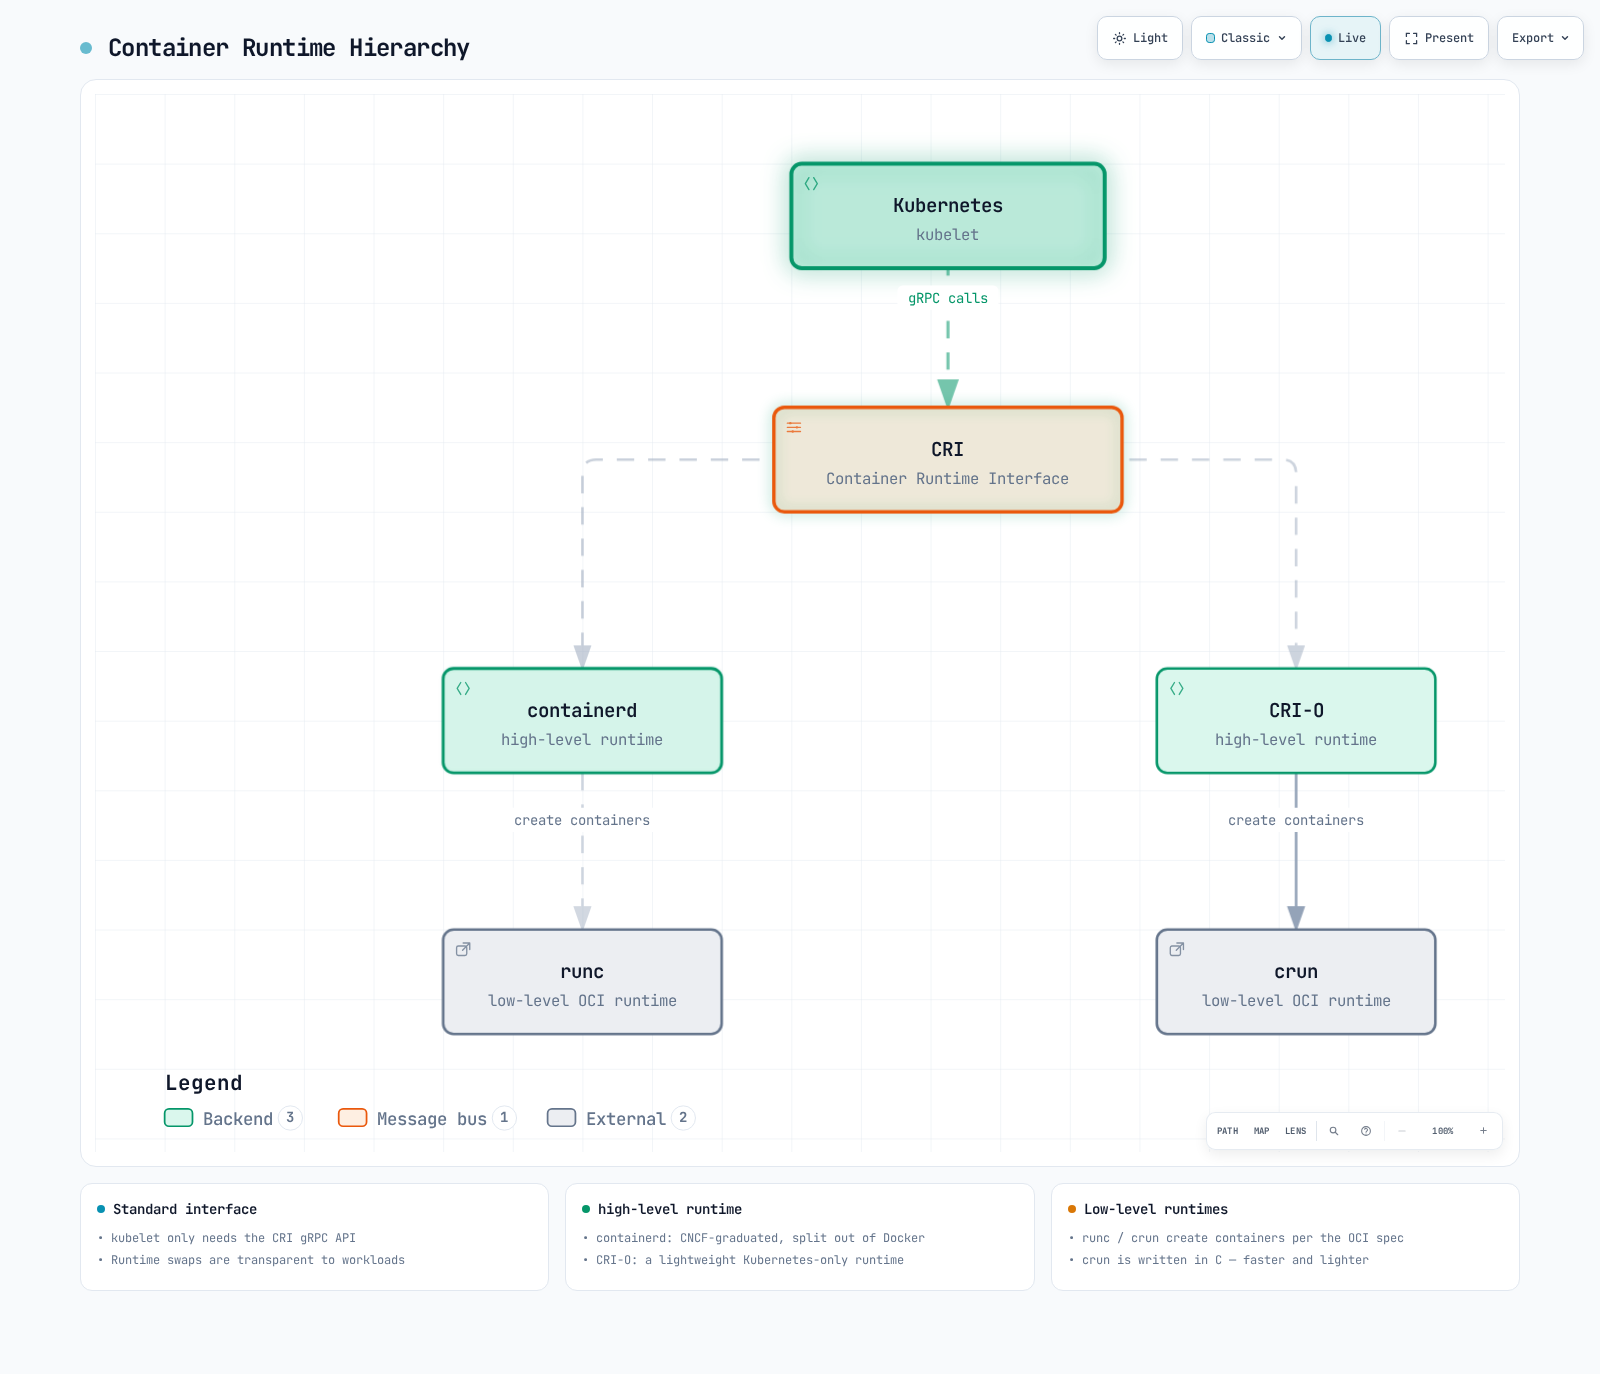
Ejemplo de configuración de containerd 1.x (2.x usa ID de plugin diferentes; genere valores predeterminados para la versión instalada):
# /etc/containerd/config.toml
version = 2

[plugins]
  [plugins."io.containerd.grpc.v1.cri"]
    sandbox_image = "registry.k8s.io/pause:3.10"
    [plugins."io.containerd.grpc.v1.cri".containerd]
      default_runtime_name = "runc"
      [plugins."io.containerd.grpc.v1.cri".containerd.runtimes]
        [plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc]
          runtime_type = "io.containerd.runc.v2"
          [plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options]
            SystemdCgroup = true
Ejemplo de configuración de CRI-O:
# /etc/crio/crio.conf
[crio]
root = "/var/lib/containers/storage"
runroot = "/var/run/containers/storage"
storage_driver = "overlay"
storage_option = ["overlay.mountopt=nodev"]

[crio.runtime]
default_runtime = "runc"
conmon = "/usr/bin/conmon"
conmon_cgroup = "pod"
cgroup_manager = "systemd"

[crio.image]
pause_image = "registry.k8s.io/pause:3.10"
Componentes add-on
Los add-ons son componentes adicionales que extienden la funcionalidad de los clústeres de Kubernetes. Algunos add-ons importantes incluyen:
Plugins de red CNI: Implementan la red de pods
- Calico, Cilium, Flannel, etc.
DNS: Proporciona servicio DNS dentro del clúster
- CoreDNS (predeterminado)
Dashboard: Proporciona UI basada en web
- Headlamp (Kubernetes Dashboard está archivado)
Ingress Controller: Administra el enrutamiento HTTP/HTTPS
- Traefik, HAProxy, etc.
Metrics Server: Recopila métricas de uso de recursos
- Metrics Server
Logging y monitoring: Recopilación y supervisión de logs
- Prometheus, Grafana, Elasticsearch, Fluentd, Kibana, etc.
Ejemplo de configuración de CoreDNS:
apiVersion: v1
kind: ConfigMap
metadata:
  name: coredns
  namespace: kube-system
data:
  Corefile: |
    .:53 {
        errors
        health {
            lameduck 5s
        }
        ready
        kubernetes cluster.local in-addr.arpa ip6.arpa {
            pods insecure
            fallthrough in-addr.arpa ip6.arpa
            ttl 30
        }
        prometheus :9153
        forward . /etc/resolv.conf {
            max_concurrent 1000
        }
        cache 30
        loop
        reload
        loadbalance
    }
Ejemplo de configuración de Calico CNI:
apiVersion: v1
kind: ConfigMap
metadata:
  name: calico-config
  namespace: kube-system
data:
  calico_backend: "bird"
  cni_network_config: |-
    {
      "name": "k8s-pod-network",
      "cniVersion": "0.3.1",
      "plugins": [
        {
          "type": "calico",
          "log_level": "info",
          "datastore_type": "kubernetes",
          "nodename": "__KUBERNETES_NODE_NAME__",
          "mtu": __CNI_MTU__,
          "ipam": {
            "type": "calico-ipam"
          },
          "policy": {
            "type": "k8s"
          },
          "kubernetes": {
            "kubeconfig": "__KUBECONFIG_FILEPATH__"
          }
        },
        {
          "type": "portmap",
          "snat": true,
          "capabilities": {"portMappings": true}
        }
      ]
    }
Rutas de comunicación del clúster
La comunicación entre los distintos componentes se produce dentro de un clúster de Kubernetes. Comprender estas rutas de comunicación es importante para el diseño, la seguridad y la resolución de problemas del clúster.
Comunicación interna del control plane
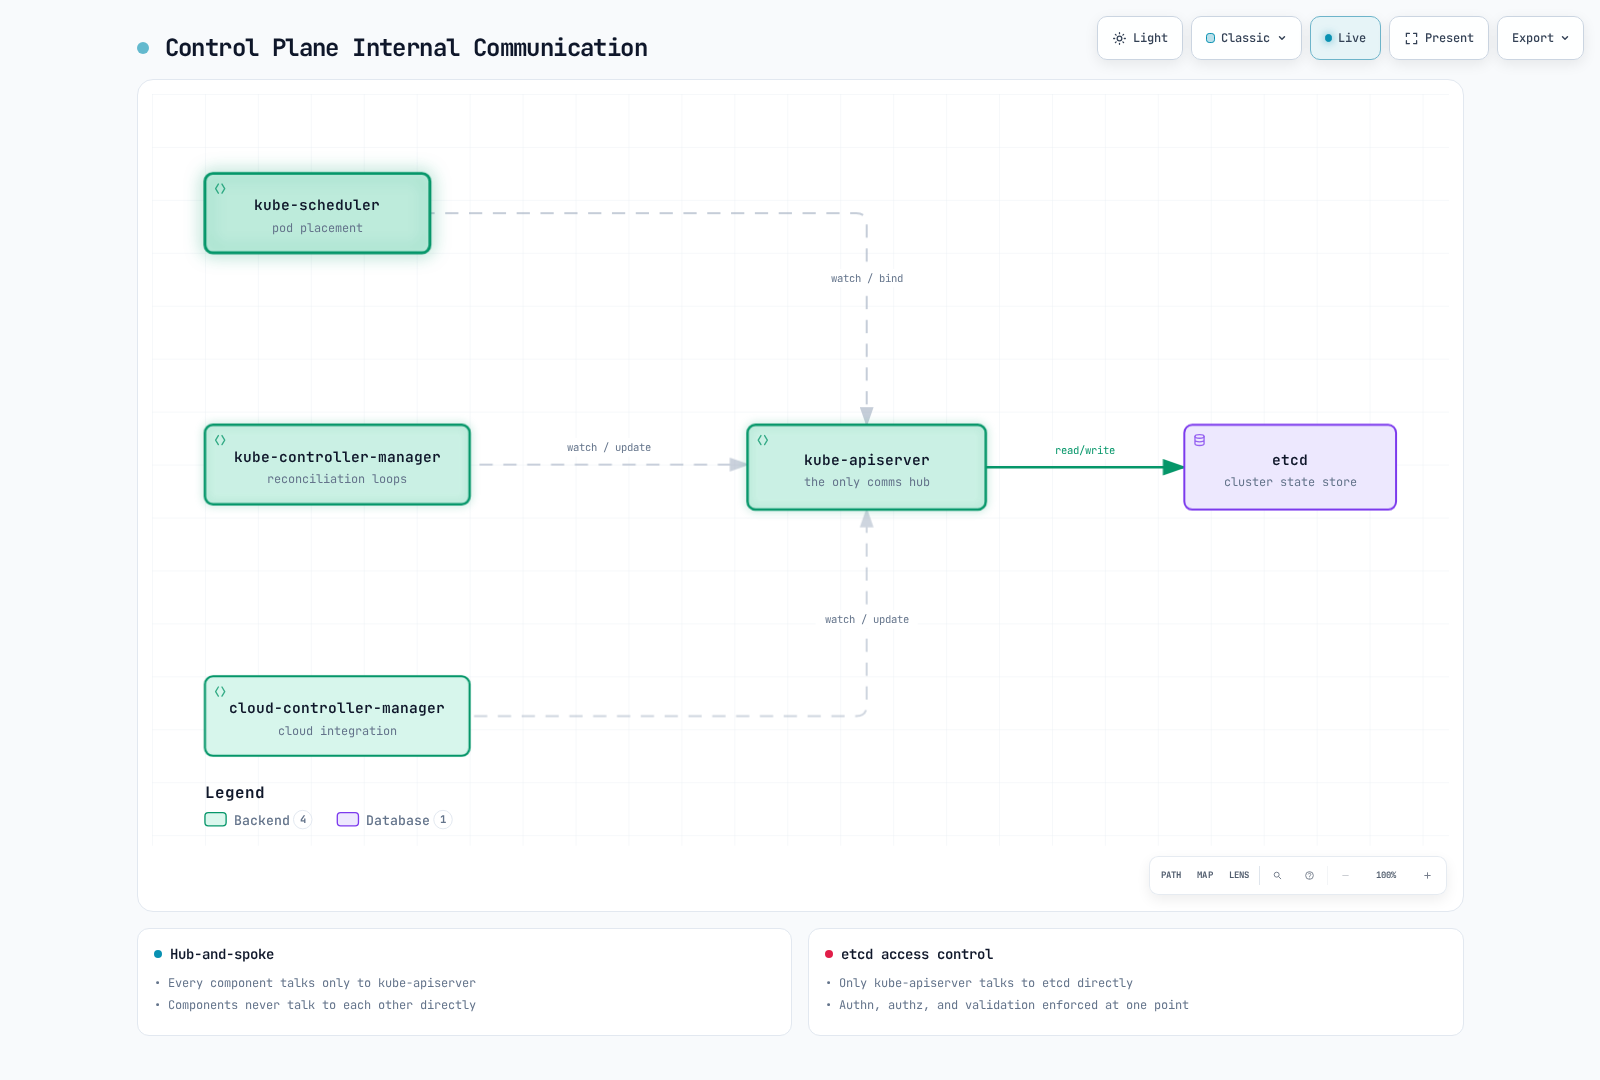
La comunicación entre componentes del control plane es la siguiente:
kube-apiserver y etcd: kube-apiserver se comunica con etcd para almacenar y recuperar el estado del clúster.
- Protocolo: gRPC
- Puerto: 2379/TCP
- Seguridad: Autenticación basada en certificados TLS
kube-scheduler y kube-apiserver: kube-scheduler se comunica con kube-apiserver para el scheduling de pods.
- Protocolo: HTTPS
- Puerto: 6443/TCP (kube-apiserver)
- Seguridad: Autenticación basada en certificados TLS
kube-controller-manager y kube-apiserver: Los controllers se comunican con kube-apiserver para observar y modificar el estado del clúster.
- Protocolo: HTTPS
- Puerto: 6443/TCP (kube-apiserver)
- Seguridad: Autenticación basada en certificados TLS
cloud-controller-manager y kube-apiserver: Cloud controller se comunica con kube-apiserver para observar el estado del clúster y administrar recursos de nube.
- Protocolo: HTTPS
- Puerto: 6443/TCP (kube-apiserver)
- Seguridad: Autenticación basada en certificados TLS
Comunicación entre control plane y nodos
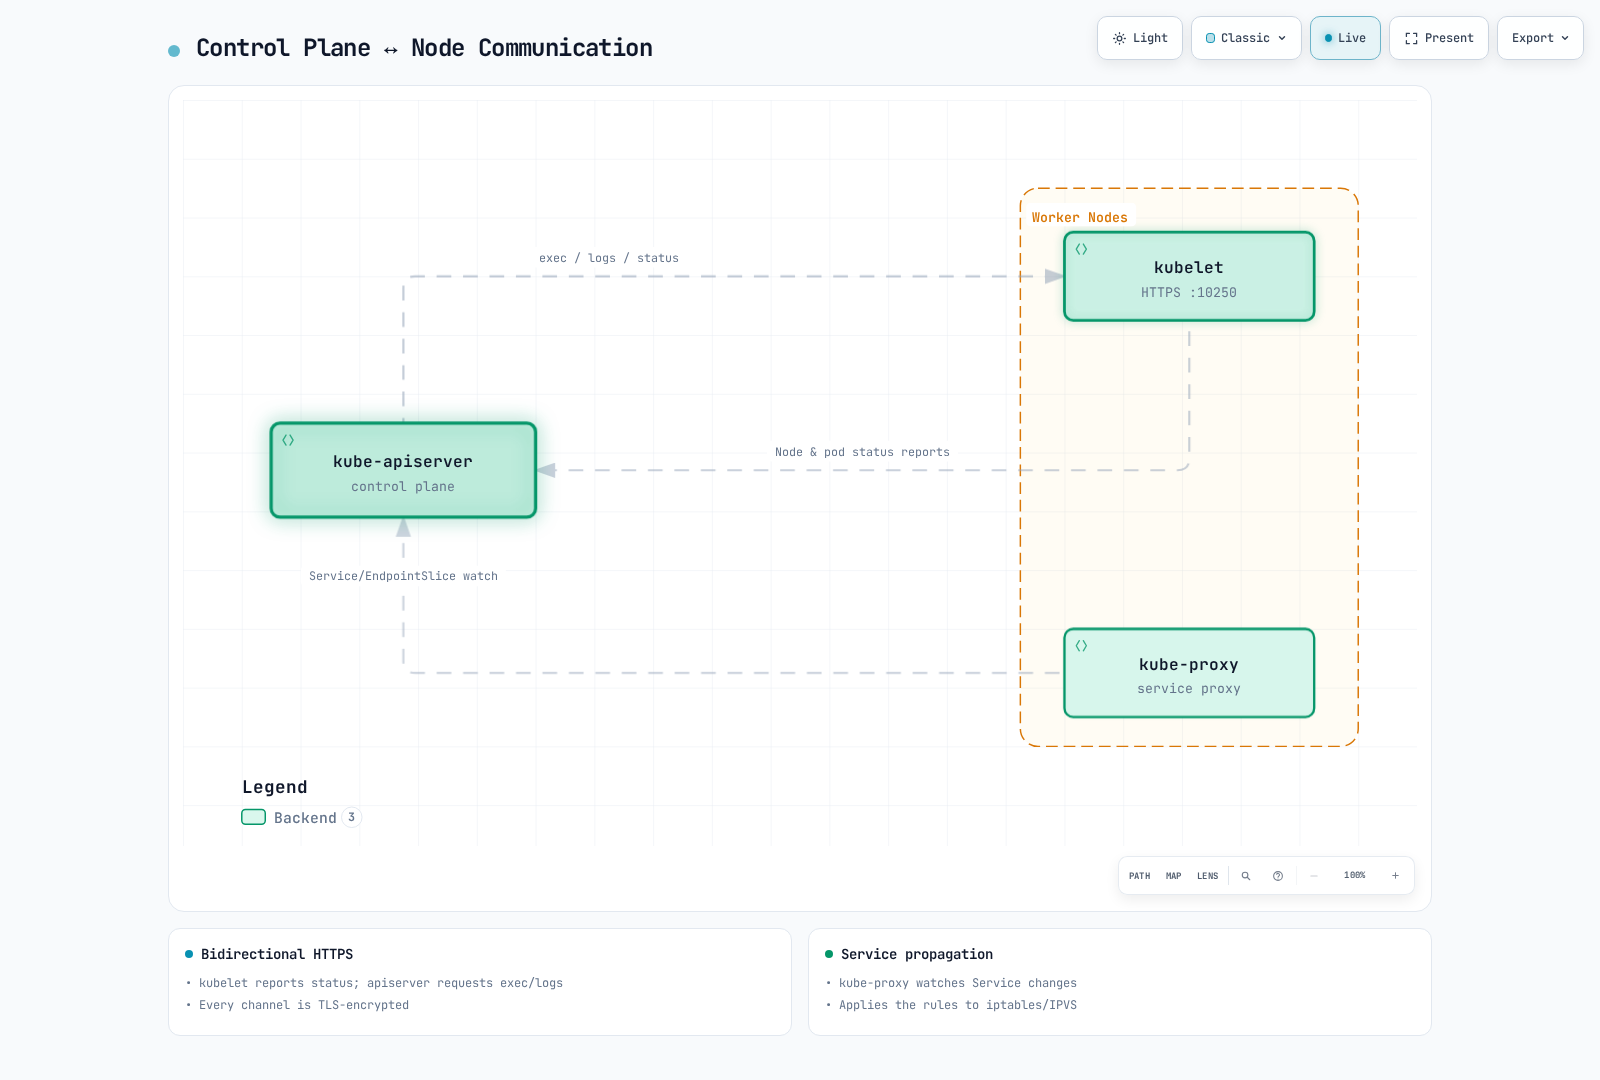
La comunicación entre el control plane y los nodos es la siguiente:
kube-apiserver → kubelet: El servidor de API llama a la API de kubelet para logs, exec/attach y reenvío de puertos.
- Protocolo: HTTPS
- Puerto: 10250/TCP (kubelet)
- Seguridad: Autenticación basada en certificados TLS
kubelet y kube-apiserver: kubelet se comunica con kube-apiserver para observar PodSpecs asignados, registrar el nodo e informar el estado y los eventos de nodo/Pod.
- Protocolo: HTTPS
- Puerto: 6443/TCP (kube-apiserver)
- Seguridad: Autenticación basada en certificados TLS
kube-proxy y kube-apiserver: kube-proxy se comunica con kube-apiserver para recuperar información de servicios.
- Protocolo: HTTPS
- Puerto: 6443/TCP (kube-apiserver)
- Seguridad: Autenticación basada en certificados TLS
Comunicación entre nodos
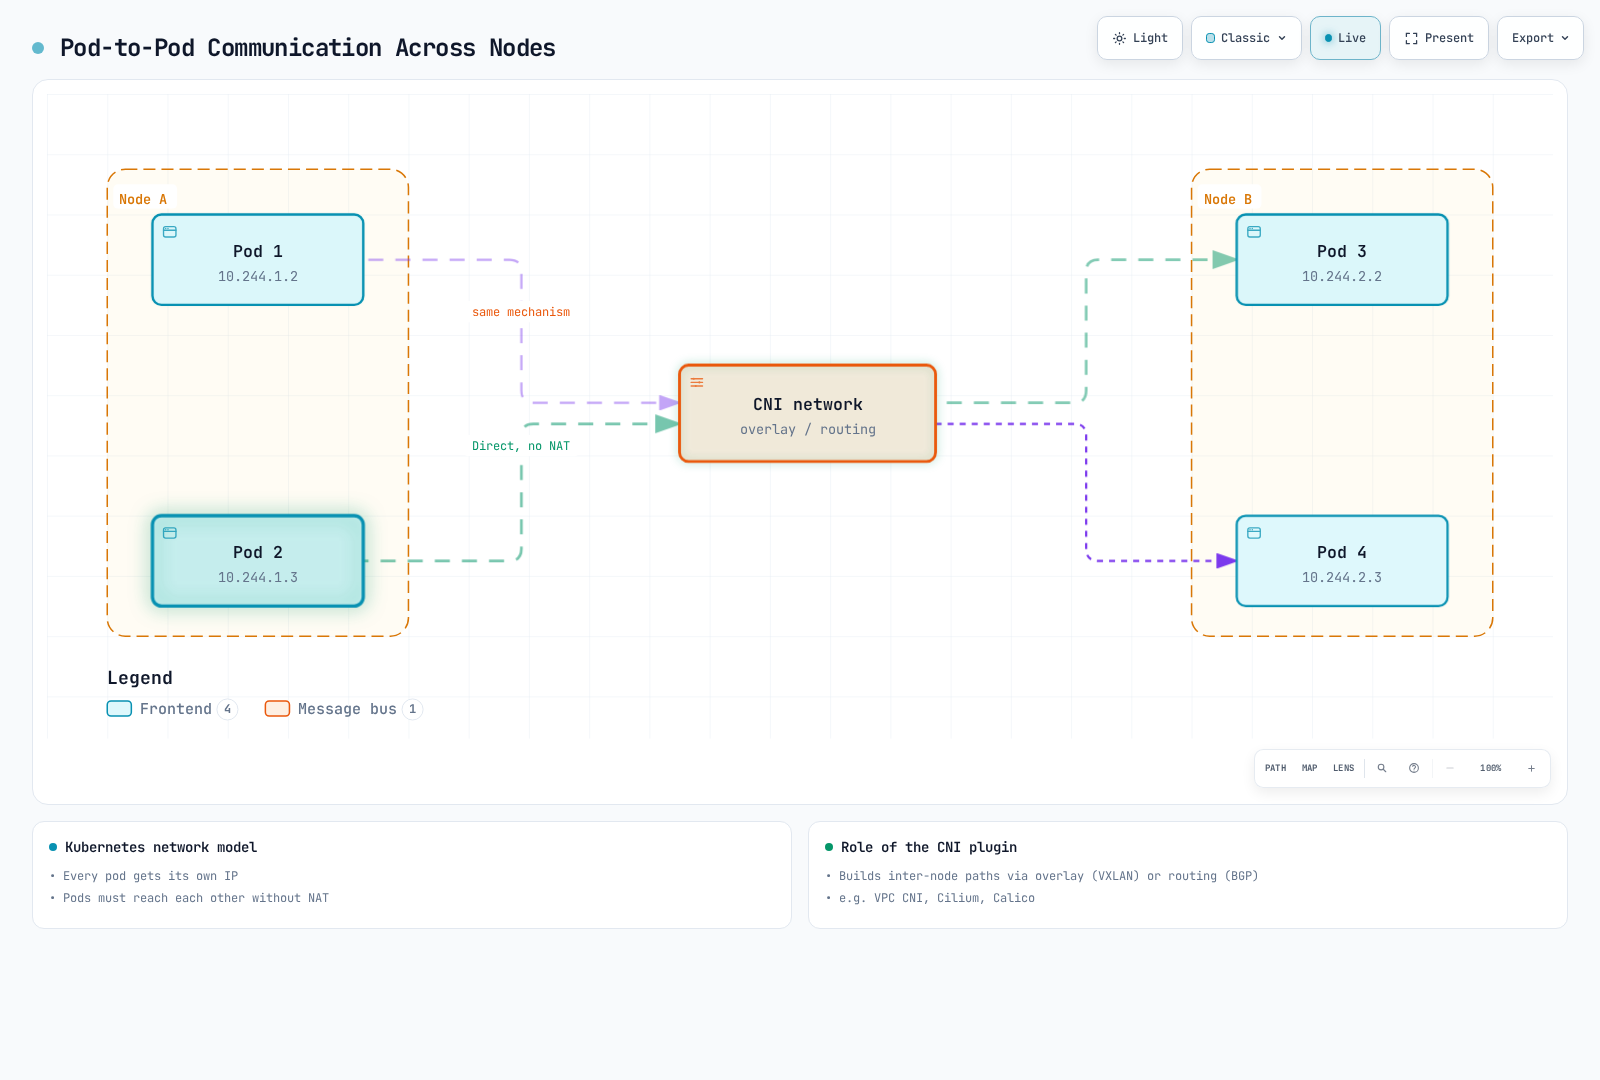
La comunicación entre nodos es la siguiente:
Comunicación de Pod a Pod: Los Pods se comunican entre sí mediante la red proporcionada por plugins CNI.
- Protocolo: Depende de la aplicación (TCP, UDP, etc.)
- Puerto: Depende de la aplicación
- Seguridad: Se puede controlar mediante network policies
Comunicación de Pod entre nodos: La comunicación entre pods en nodos distintos la gestiona el plugin CNI.
- Protocolo: Depende de la aplicación (TCP, UDP, etc.)
- Puerto: Depende de la aplicación
- Seguridad: Se puede controlar mediante network policies
Comunicación externa
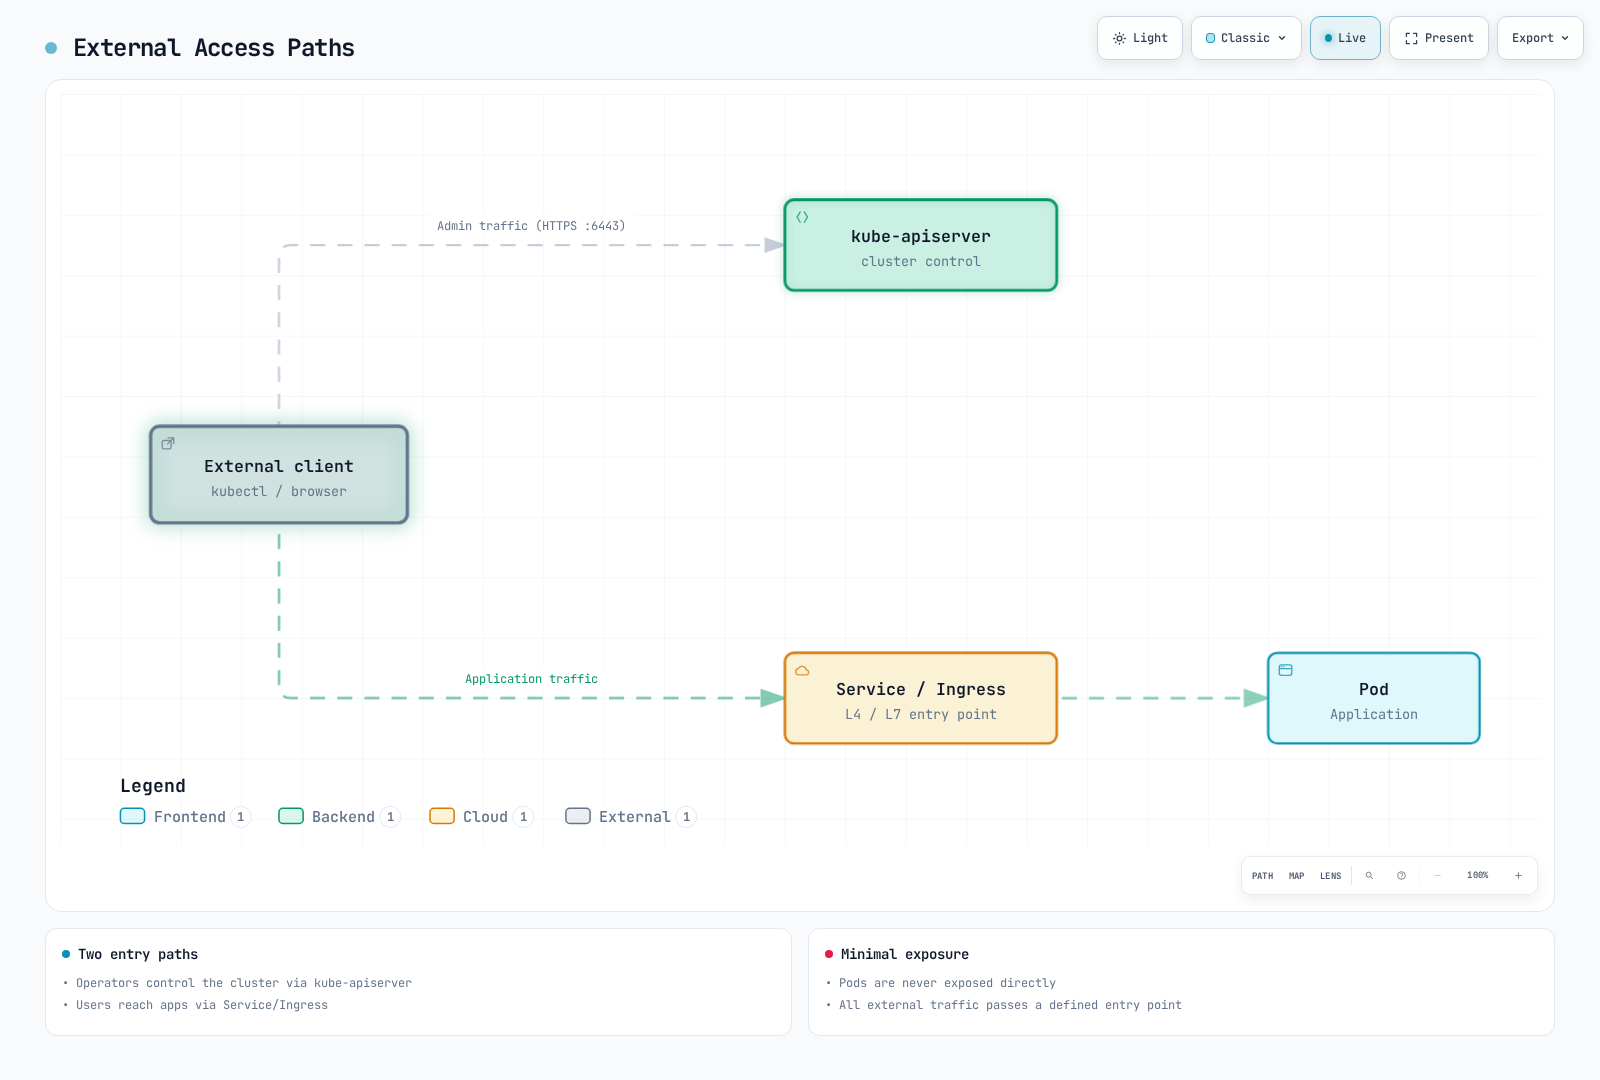
La comunicación con entidades externas es la siguiente:
Cliente y kube-apiserver: Los usuarios y sistemas externos interactúan con el clúster mediante kube-apiserver.
- Protocolo: HTTPS
- Puerto: 6443/TCP (kube-apiserver)
- Seguridad: Certificados TLS, tokens, autenticación de usuarios, etc.
Tráfico externo y Services: El tráfico externo accede a aplicaciones dentro del clúster mediante servicios NodePort, LoadBalancer o Ingress.
- Protocolo: HTTP, HTTPS, TCP, UDP, etc.
- Puerto: Depende de la configuración del servicio
- Seguridad: Depende del ingress controller y de la configuración del servicio
Seguridad de la comunicación
La seguridad de la comunicación dentro de un clúster de Kubernetes se implementa mediante los siguientes métodos:
- Certificados TLS: Toda la comunicación entre componentes del control plane se cifra con certificados TLS.
- Autenticación y autorización: Todas las solicitudes al servidor de API pasan por procesos de autenticación y autorización.
- Network Policies: La comunicación de pod a pod se puede restringir mediante network policies.
- Secrets cifrados: Los Secrets almacenados en etcd se pueden cifrar.
Ejemplo de cifrado de datos de API en reposo (configure el servidor de API con --encryption-provider-config; vuelva a escribir los Secrets existentes para cifrarlos):
apiVersion: apiserver.config.k8s.io/v1
kind: EncryptionConfiguration
resources:
  - resources:
    - secrets
    providers:
    - aescbc:
        keys:
        - name: key1
          secret: <base64-encoded-key>
    - identity: {}
Configuración de clúster de alta disponibilidad
Los clústeres de Kubernetes de alta disponibilidad (HA) están diseñados para eliminar puntos únicos de fallo y continuar operando sin interrupción del servicio.
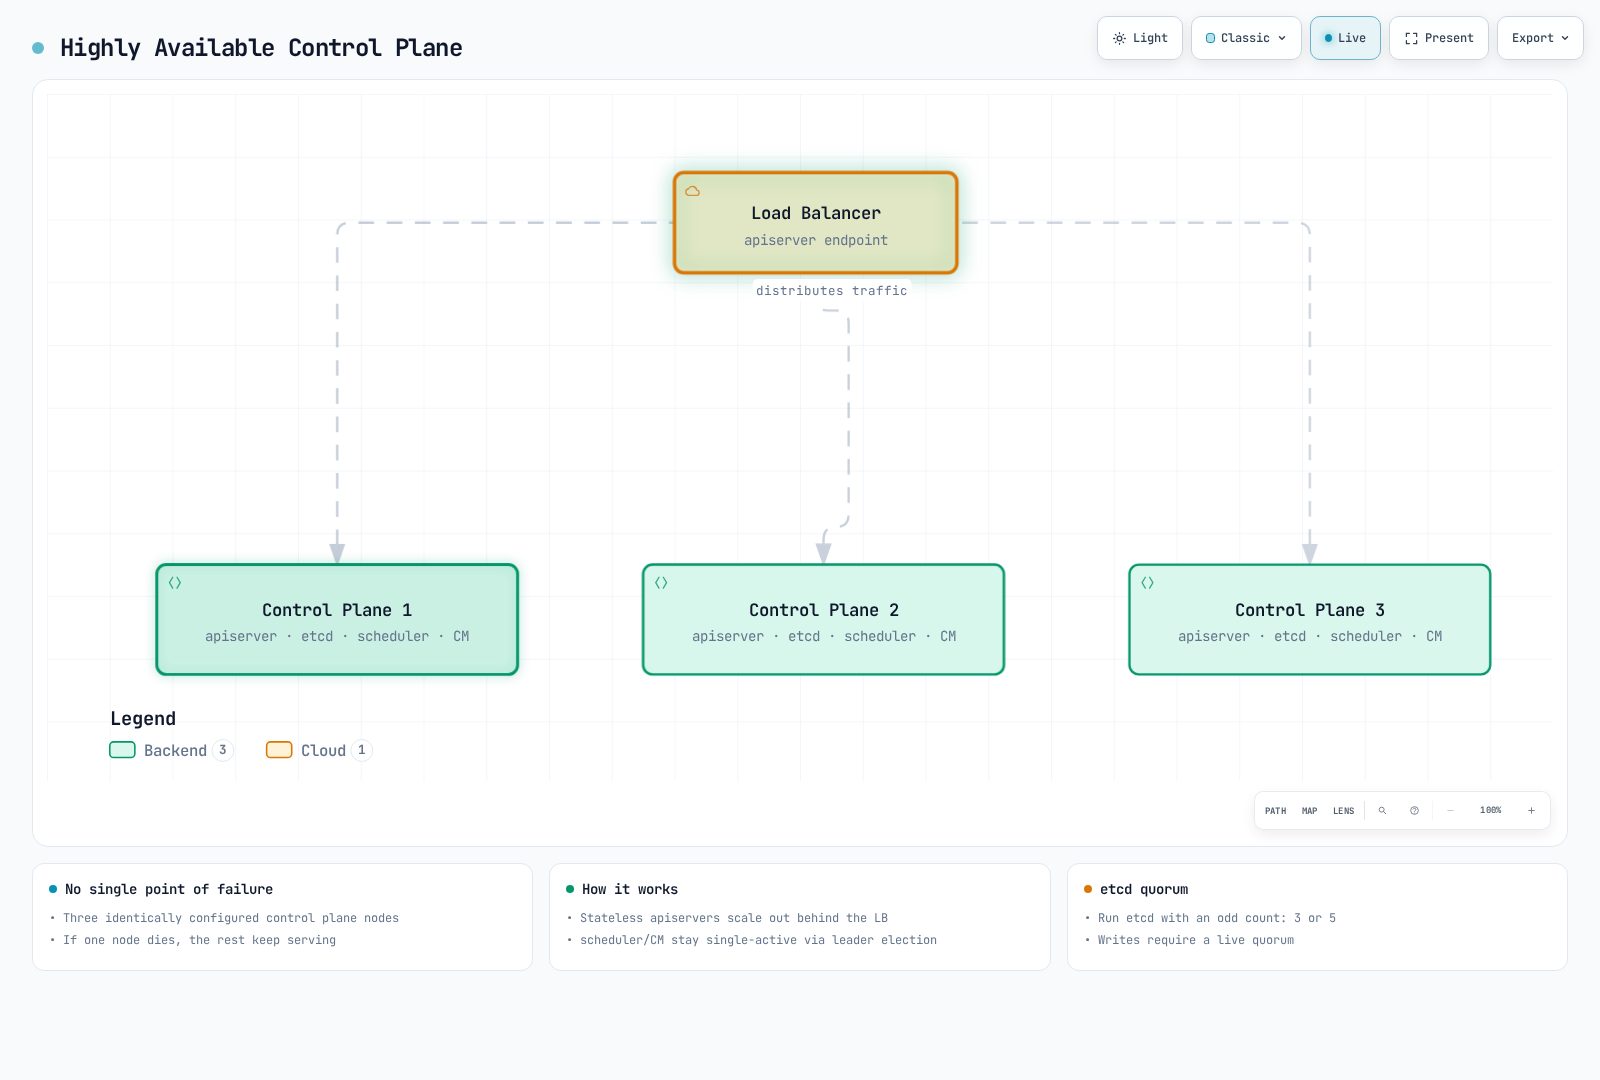
Alta disponibilidad del control plane
La alta disponibilidad del control plane se implementa mediante los siguientes métodos:
- Varios nodos de control plane: Normalmente se implementan 3 o 5 nodos de control plane para redundancia
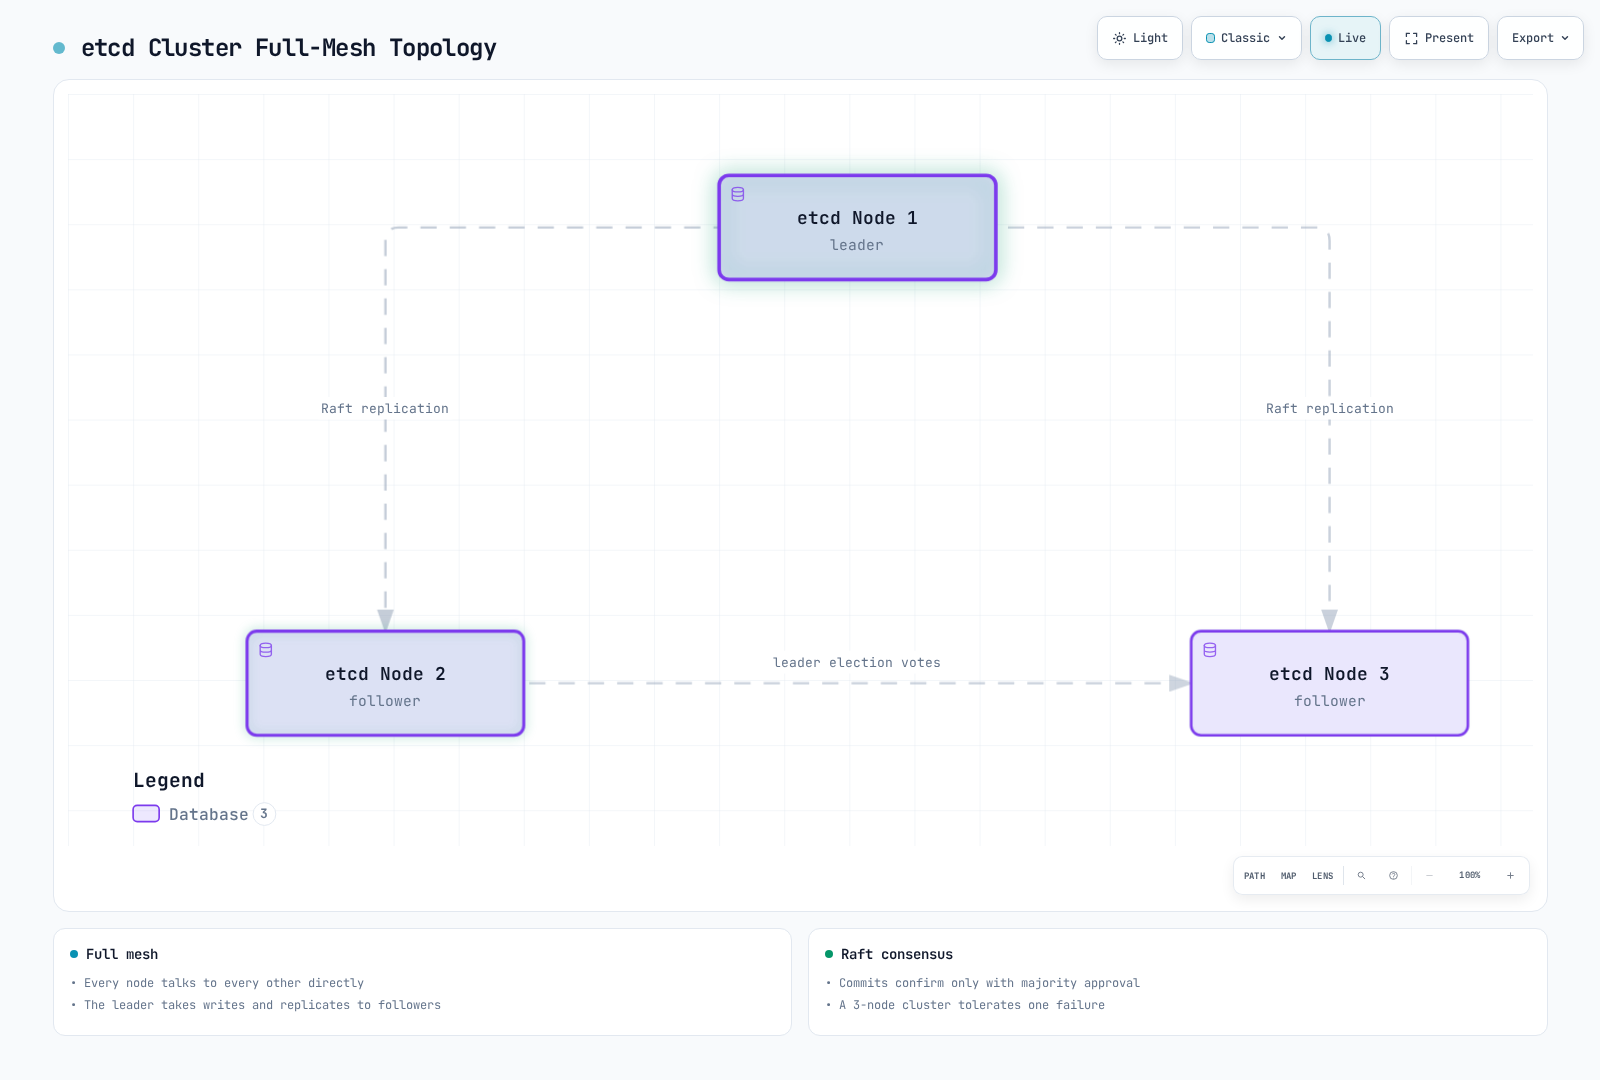
- Clúster de etcd: Implemente un clúster compuesto por varias instancias de etcd (normalmente 3 o 5)
- Balanceador de carga: Coloque un balanceador de carga delante de los servidores de API para distribuir el tráfico
Arquitectura de control plane de alta disponibilidad:
Configuración del clúster de etcd:
Alta disponibilidad de worker nodes
La alta disponibilidad de worker nodes se implementa mediante los siguientes métodos:
- Varios worker nodes: Distribuya las cargas de trabajo entre varios worker nodes
- Recuperación automática de nodos: Utilice las funciones de recuperación automática del proveedor de nube
- Auto Scaling: Escalado automático de nodos mediante cluster autoscaler
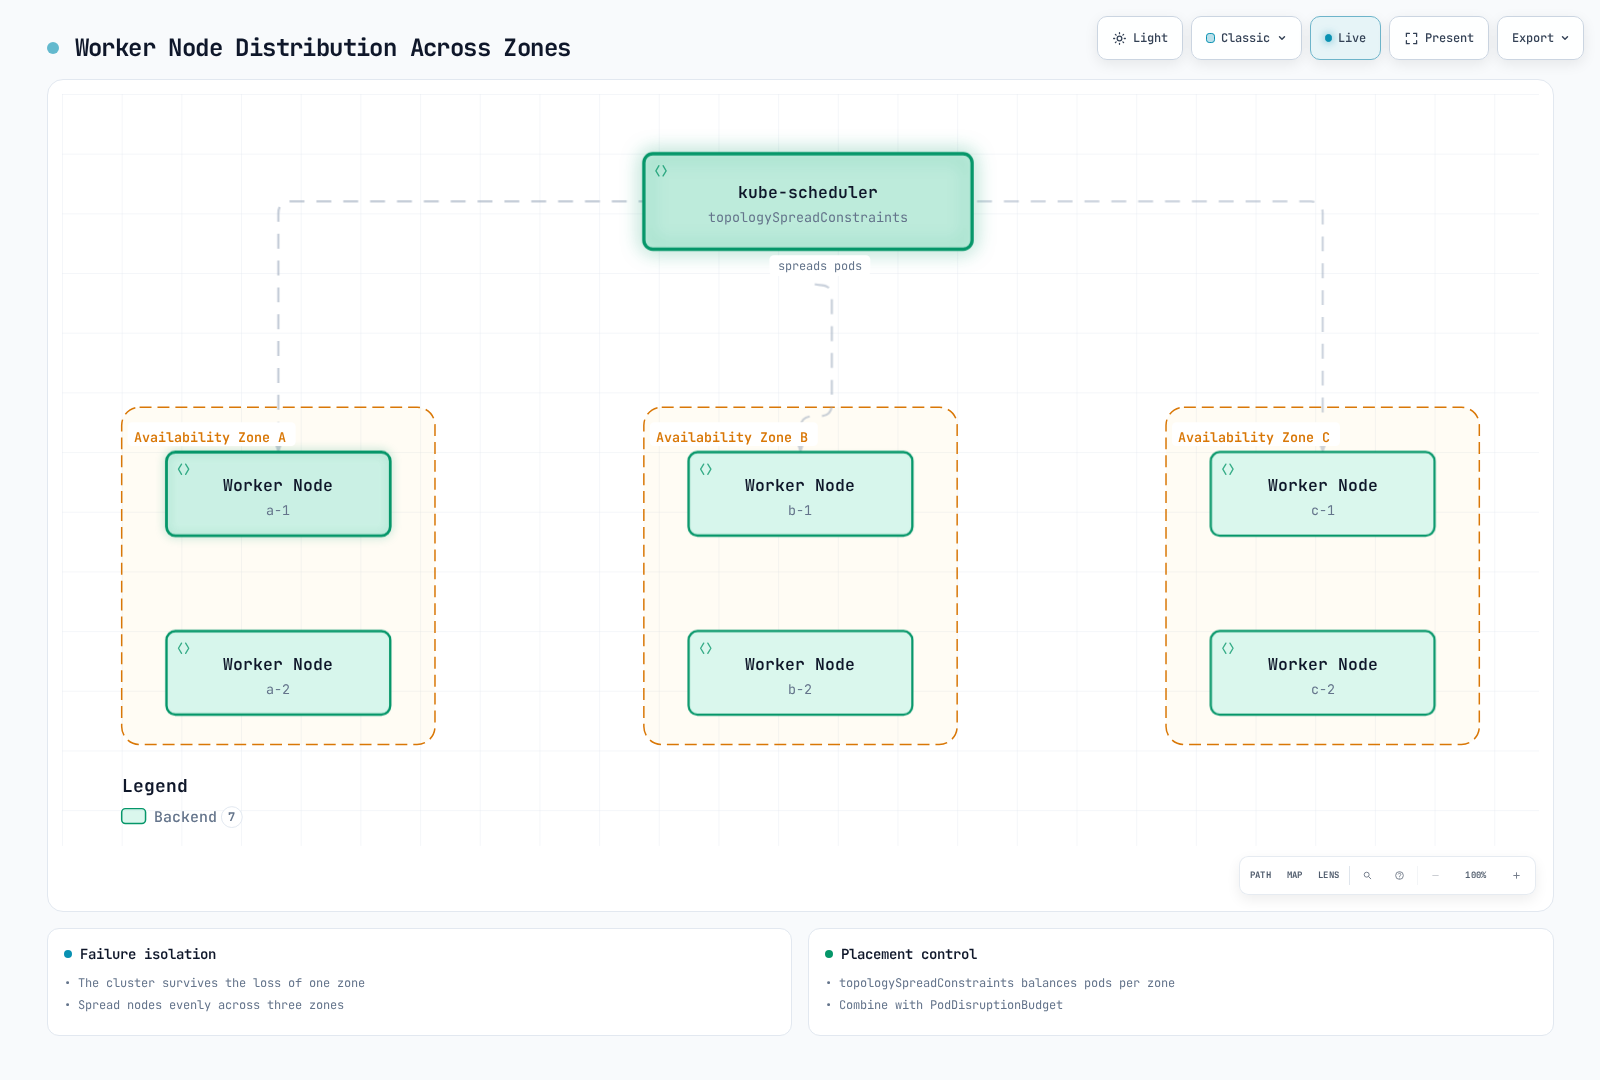
- Varias zonas de disponibilidad: Implemente nodos en varias zonas de disponibilidad
Implementación distribuida de worker nodes:
Alta disponibilidad de aplicaciones
La alta disponibilidad de las aplicaciones se implementa mediante los siguientes métodos:
- ReplicaSet/Deployment: Ejecute varias réplicas de pod
- Reglas de distribución de Pod: Distribuya pods entre varios nodos mediante antiafinidad de pod
- PodDisruptionBudget: Garantice disponibilidad mínima durante interrupciones planificadas
- Service y balanceo de carga: Distribuya el tráfico entre varios pods
Ejemplo de antiafinidad de Pod:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web-server
  template:
    metadata:
      labels:
        app: web-server
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - web-server
            topologyKey: "kubernetes.io/hostname"
      containers:
      - name: web-server
        image: nginx:1.30.4
Ejemplo de PodDisruptionBudget:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: web-server-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: web-server
Estrategia de recuperación ante desastres
Las estrategias de recuperación ante desastres para clústeres de Kubernetes se implementan mediante los siguientes métodos:
- Copia de seguridad y recuperación de etcd: Establezca procedimientos periódicos de copia de seguridad y recuperación de datos de etcd
- Implementación multirregión: Implemente clústeres en varias regiones
- Federación de clústeres: Administre varios clústeres en federación
- Copia de seguridad continua: Realice copias de seguridad continuas de los datos de aplicaciones
Ejemplo de script de copia de seguridad de etcd:
#!/bin/bash
ETCDCTL_API=3 etcdctl snapshot save /backup/etcd-snapshot-$(date +%Y%m%d-%H%M%S).db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key
Procedimiento de recuperación de etcd (clústeres autogestionados):
- Valide el snapshot con
etcdutl snapshot status. Restaure en un nuevo directorio de datos con unetcdutlcompatible, como se muestra arriba. - Antes de cambiar directorios de datos, detenga todas las instancias del servidor de API y los procesos de etcd afectados mediante el runbook del clúster. Detener kubelet por sí solo no detiene los contenedores static Pod existentes.
- Para una recuperación con varios miembros, restaure el mismo snapshot en cada miembro con un nombre/URL de peer únicos y la misma membresía completa de
--initial-cluster. El ejemplo de un solo miembro anterior no es una receta de recuperación HA. - Use
--bump-revisiony--mark-compactedpara las cachés de observación de Kubernetes; elija un incremento que supere las revisiones desde el snapshot (el valor mostrado es un ejemplo). - Actualice el hostPath del static Pod de etcd al directorio restaurado, reinicie etcd, verifique quorum/salud y luego reinicie los servidores de API y controllers. Conserve los datos y la copia de seguridad originales hasta que finalice la verificación.
Siga la guía de recuperación de etcd. Los usuarios de EKS no operan ni restauran directamente el etcd del control plane administrado.
Redes del clúster
Las redes de Kubernetes permiten la comunicación entre pods, servicios y el mundo exterior. El modelo de redes de Kubernetes supone que cada pod tiene una dirección IP única y puede comunicarse con los demás sin NAT.
Modelo de redes
El modelo de redes de Kubernetes tiene los siguientes requisitos:
- Comunicación de Pod a Pod: Todos los pods deben poder comunicarse con todos los demás pods sin NAT
- Comunicación de nodo a Pod: Los agentes de nodo deben poder comunicarse con los Pods de ese nodo
- Comunicación de Pod a externo: La conectividad externa depende del enrutamiento, NAT cuando se necesita y la política de seguridad/egress; no es un requisito que cada Pod alcance Internet
CNI (Container Network Interface)
CNI es una interfaz estándar para implementar redes en Kubernetes. Existen varios plugins CNI, cada uno con características y rendimiento diferentes.
Plugins CNI principales:
Calico: Redes basadas en BGP, compatibilidad con network policy
- Características: Alto rendimiento, network policies, cifrado, compatibilidad con eBPF
- Casos de uso: Clústeres grandes, entornos centrados en la seguridad
Cilium: Redes y seguridad basadas en eBPF
- Características: Políticas de seguridad L3-L7, alto rendimiento, observabilidad
- Casos de uso: Microservicios, entornos centrados en la seguridad
Flannel: Red de superposición sencilla
- Características: Configuración sencilla, ligero
- Casos de uso: Clústeres pequeños, entornos de desarrollo
Weave Net (histórico): El proyecto se archivó en June 2024; evalúe alternativas mantenidas para nuevas implementaciones.
Ejemplo de configuración de CNI (Calico):
apiVersion: v1
kind: ConfigMap
metadata:
  name: calico-config
  namespace: kube-system
data:
  calico_backend: "bird"
  cni_network_config: |-
    {
      "name": "k8s-pod-network",
      "cniVersion": "0.3.1",
      "plugins": [
        {
          "type": "calico",
          "log_level": "info",
          "datastore_type": "kubernetes",
          "nodename": "__KUBERNETES_NODE_NAME__",
          "mtu": __CNI_MTU__,
          "ipam": {
            "type": "calico-ipam"
          },
          "policy": {
            "type": "k8s"
          },
          "kubernetes": {
            "kubeconfig": "__KUBECONFIG_FILEPATH__"
          }
        },
        {
          "type": "portmap",
          "snat": true,
          "capabilities": {"portMappings": true}
        }
      ]
    }
Redes de Service
Los Services de Kubernetes proporcionan endpoints estables para un conjunto de pods. Los Services tienen varios tipos, incluidos ClusterIP, NodePort, LoadBalancer y ExternalName.
Componentes de redes de Service:
- ClusterIP: IP virtual accesible solo dentro del clúster
- kube-proxy: Enruta el tráfico de IP de servicio hacia pods
- CoreDNS: Servicio DNS para descubrimiento de servicios
Flujo de redes de Service:
Client -> kernel rules programmed by kube-proxy (ClusterIP DNAT) -> PodEjemplo de Service:
apiVersion: v1
kind: Service
metadata:
  name: my-service
spec:
  selector:
    app: my-app
  ports:
  - port: 80
    targetPort: 8080
  type: ClusterIP
Redes de Ingress
Ingress administra el enrutamiento HTTP y HTTPS desde fuera del clúster hacia servicios dentro del clúster. Los ingress controllers implementan recursos de ingress.
Principales Ingress Controllers:
- Controllers de Ingress/Gateway mantenidos: Compruebe el ciclo de vida del controller y la compatibilidad con Gateway API
- AWS Load Balancer Controller: Aprovisiona ALB para Ingress
- Traefik: Router de borde nativo de la nube
- HAProxy Ingress: Ingress controller basado en HAProxy
Flujo de redes de Ingress:
Client -> Ingress Controller -> Service -> PodEl ingress-nginx de la comunidad se retiró en March 2026; consulte el aviso de retirada. Este ejemplo requiere un controller Traefik instalado con una IngressClass denominada traefik; /app se reenvía sin cambios.
Ejemplo de Ingress:
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: my-ingress
spec:
  ingressClassName: traefik
  rules:
  - host: example.com
    http:
      paths:
      - path: /app
        pathType: Prefix
        backend:
          service:
            name: my-service
            port:
              number: 80
Network Policies
Las network policies proporcionan una forma de controlar la comunicación entre pods. De forma predeterminada, todos los pods pueden comunicarse entre sí, pero las network policies pueden restringirlo.
Ejemplo de Network Policy:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: db-network-policy
spec:
  podSelector:
    matchLabels:
      role: db
  policyTypes:
  - Ingress
  - Egress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          role: frontend
    ports:
    - protocol: TCP
      port: 3306
  egress:
  - to:
    - podSelector:
        matchLabels:
          role: monitoring
    ports:
    - protocol: TCP
      port: 9090
Resolución de problemas de red
Herramientas y comandos comunes para resolver problemas de red de Kubernetes:
- ping, traceroute: Pruebas básicas de conectividad de red
- tcpdump: Captura y análisis de paquetes de red
- netstat, ss: Comprueban el estado de conexión de red
- nslookup, dig: Pruebas de búsqueda DNS
- kubectl exec: Ejecuta comandos de red dentro de pods
Ejemplo de depuración de red:
# Test network connectivity within a pod
kubectl exec -it <pod-name> -- ping <target-ip>

# Test DNS lookup within a pod
kubectl exec -it <pod-name> -- nslookup <service-name>

# Capture network packets within a pod
kubectl exec -it <pod-name> -- tcpdump -i eth0 -n

# Check service endpoints
kubectl get endpointslices -l kubernetes.io/service-name=<service-name>
Almacenamiento del clúster
El almacenamiento de Kubernetes proporciona persistencia de datos para aplicaciones en contenedores. Kubernetes proporciona varias opciones y abstracciones de almacenamiento para ayudar a las aplicaciones a utilizar el almacenamiento eficientemente.
Arquitectura de almacenamiento
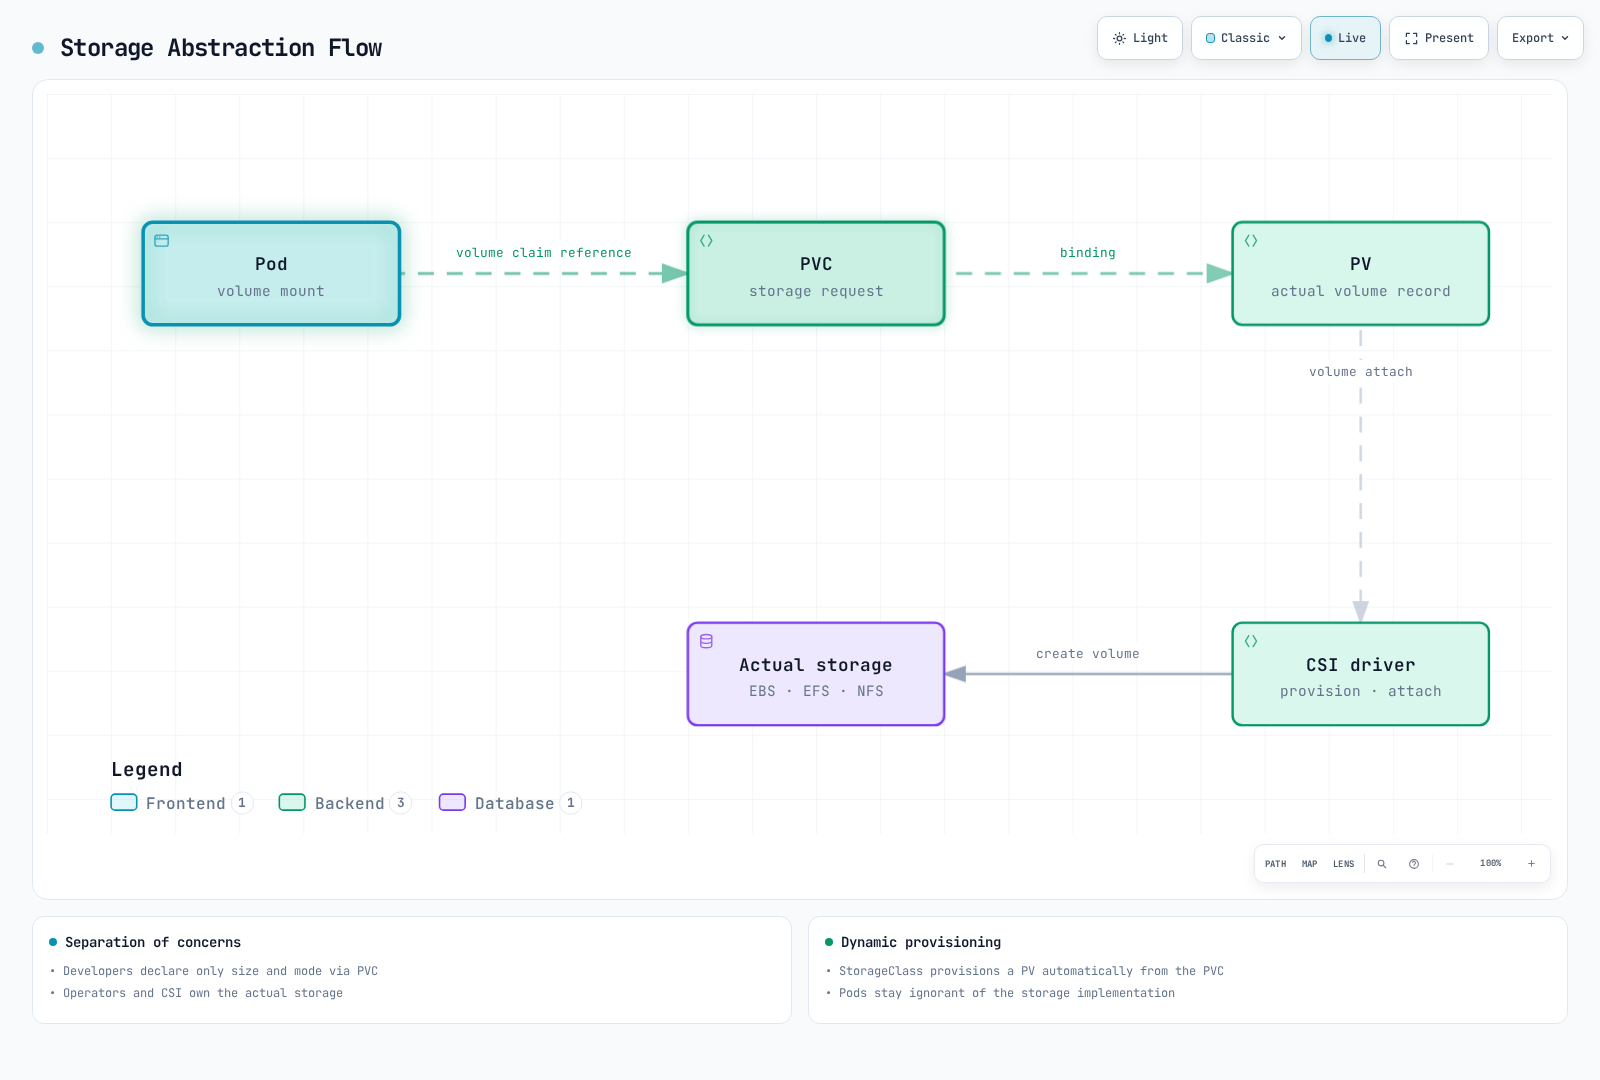
La arquitectura de almacenamiento de Kubernetes consta de los siguientes componentes:
- Volumes: Directorios que se pueden montar en contenedores dentro de pods
- Persistent Volumes (PV): Recursos de almacenamiento en el clúster
- Persistent Volume Claims (PVC): Solicitudes de almacenamiento de usuarios
- Storage Classes: Define "clases" o tipos de almacenamiento
- CSI (Container Storage Interface): Interfaz estándar con sistemas de almacenamiento
Flujo de arquitectura de almacenamiento:
Tipos de volumen
Kubernetes admite varios tipos de volúmenes:
Volúmenes efímeros:
- emptyDir: Comienza como un directorio vacío y se elimina al eliminar el pod
- configMap: Monta ConfigMap como volumen
- secret: Monta Secret como volumen
- downwardAPI: Expone información de pod y contenedor como archivos
Volúmenes persistentes:
- Almacenamiento de bloques en nube mediante CSI: AWS EBS, Azure Disk y GCE Persistent Disk; sus implementaciones in-tree heredadas se han eliminado
- nfs: Volúmenes NFS
- csi: Volúmenes mediante drivers CSI
Ejemplo de volumen:
apiVersion: v1
kind: Pod
metadata:
  name: test-pd
spec:
  containers:
  - name: test-container
    image: nginx
    volumeMounts:
    - mountPath: /test-pd
      name: test-volume
  volumes:
  - name: test-volume
    persistentVolumeClaim:
      claimName: test-pvc
Persistent Volumes y Claims
Los Persistent Volumes (PV) son recursos de almacenamiento del clúster aprovisionados por administradores o aprovisionados dinámicamente mediante storage classes. Los Persistent Volume Claims (PVC) son solicitudes de almacenamiento de usuarios.
Instale primero el driver EBS CSI con permisos IAM. Para el PV estático de abajo, sustituya el ID de volumen y la zona por un volumen EBS existente y su zona real. EBS no puede montarse en Fargate; EKS Auto Mode usa ebs.csi.eks.amazonaws.com en su lugar.
Ejemplo de Persistent Volume:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: pv-example
spec:
  capacity:
    storage: 10Gi
  accessModes:
    - ReadWriteOnce
  persistentVolumeReclaimPolicy: Retain
  storageClassName: standard
  csi:
    driver: ebs.csi.aws.com
    volumeHandle: vol-0123456789abcdef0
    fsType: ext4
  nodeAffinity:
    required:
      nodeSelectorTerms:
      - matchExpressions:
        - key: topology.kubernetes.io/zone
          operator: In
          values: [ap-northeast-2a]
Ejemplo de Persistent Volume Claim:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: pvc-example
spec:
  accessModes:
    - ReadWriteOnce
  resources:
    requests:
      storage: 5Gi
  storageClassName: standard
Storage Classes
Las storage classes describen las "clases" de almacenamiento que proporcionan los administradores. Las storage classes permiten el aprovisionamiento dinámico de PV cuando se solicitan PVC.
Ejemplo de Storage Class:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: standard
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  csi.storage.k8s.io/fstype: ext4
  encrypted: "true"
reclaimPolicy: Delete
allowVolumeExpansion: true
volumeBindingMode: WaitForFirstConsumer
CSI (Container Storage Interface)
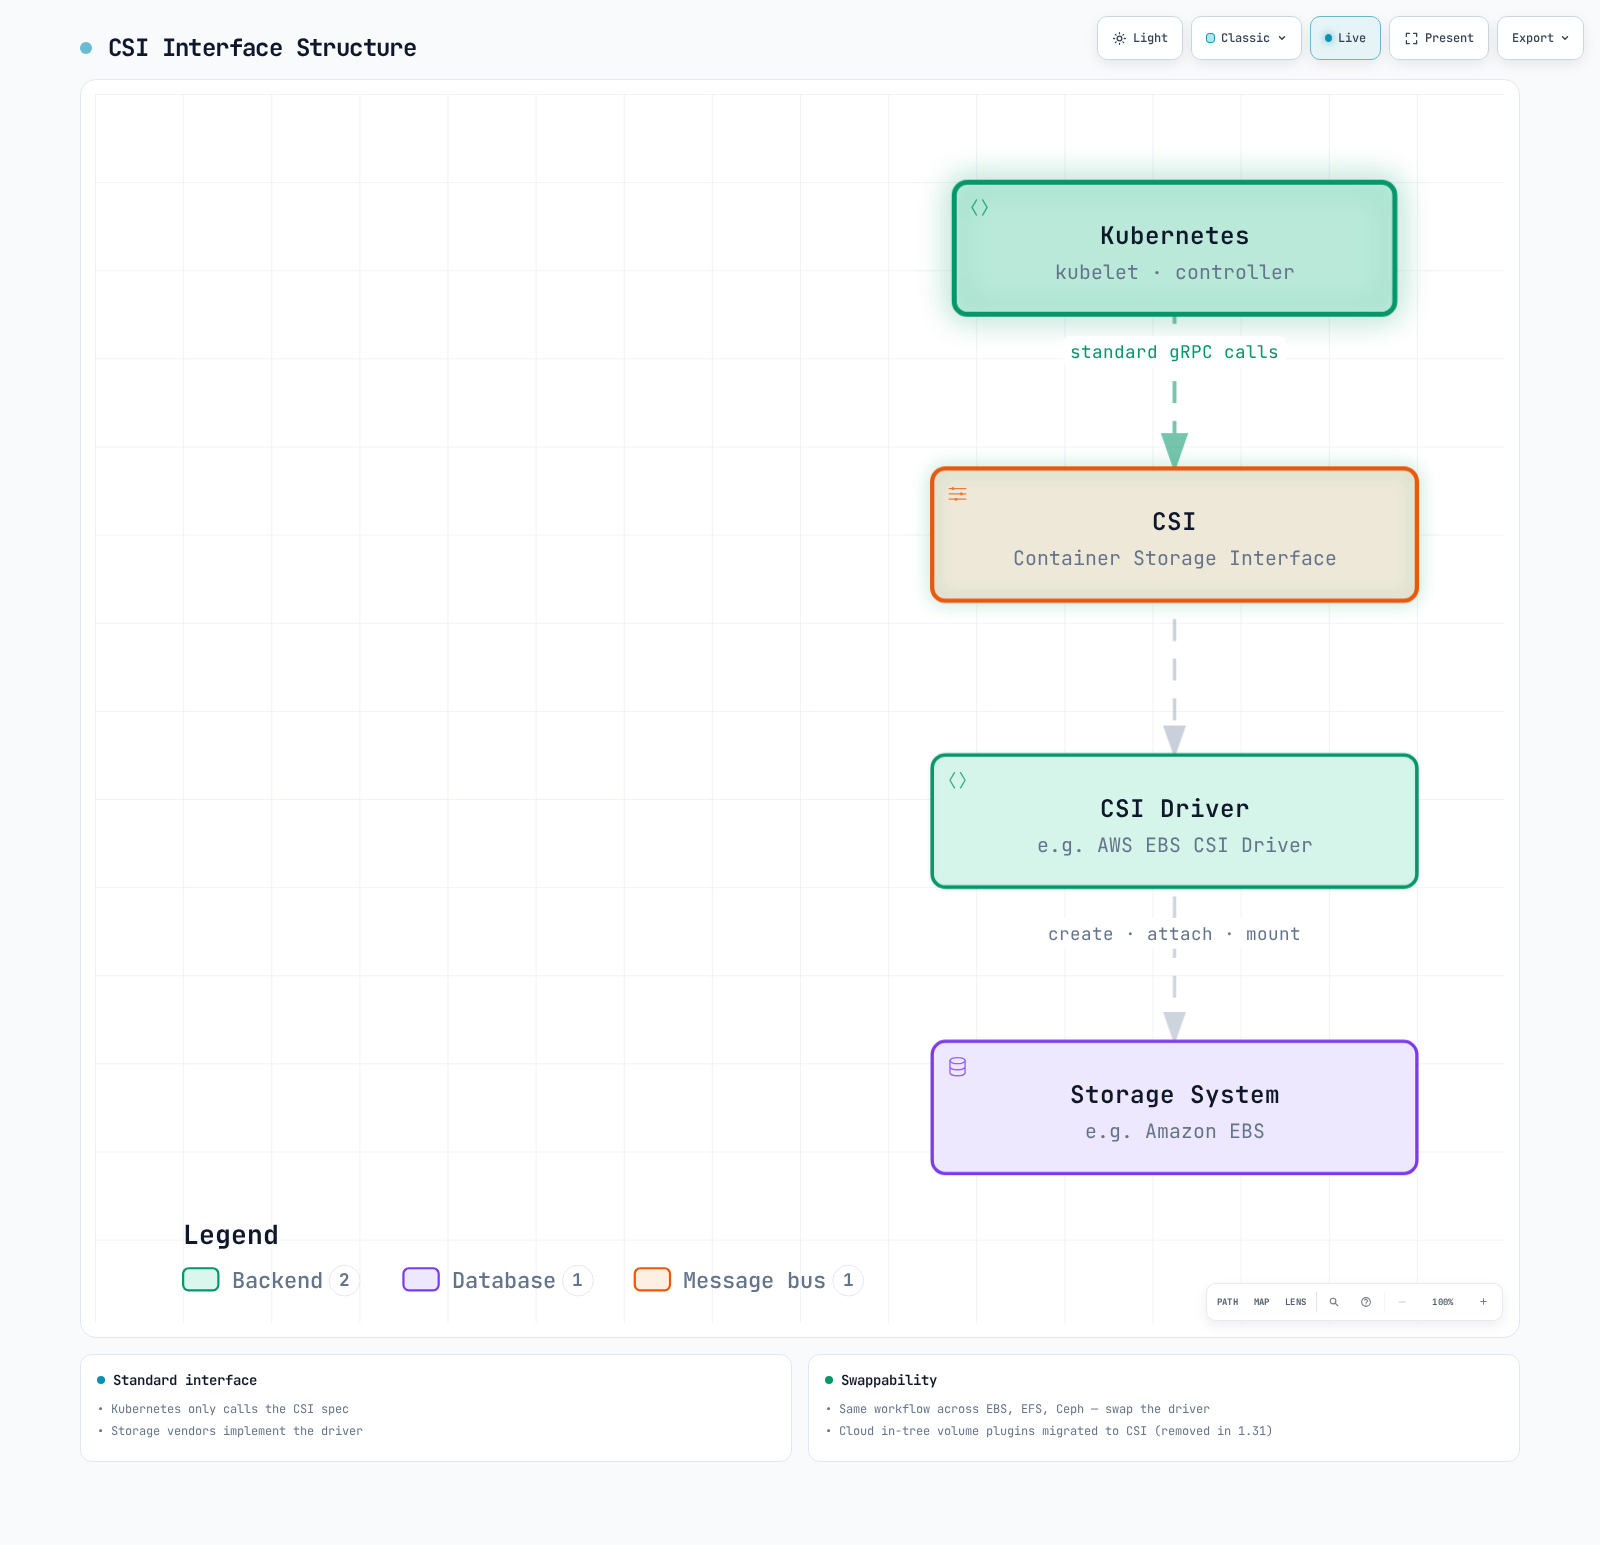
CSI proporciona una interfaz estándar entre Kubernetes y los sistemas de almacenamiento. Mediante CSI, los proveedores de almacenamiento pueden desarrollar sus propios drivers de almacenamiento sin modificar el código de Kubernetes.
Arquitectura de CSI:
Ejemplo de implementación de driver CSI:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-sc
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  csi.storage.k8s.io/fstype: ext4
  encrypted: "true"
volumeBindingMode: WaitForFirstConsumer
Mejores prácticas de almacenamiento
Mejores prácticas para utilizar almacenamiento de Kubernetes:
- Elija el tipo de almacenamiento adecuado: Seleccione el tipo de almacenamiento que coincida con las características de la carga de trabajo
- Use aprovisionamiento dinámico: Utilice el aprovisionamiento dinámico mediante storage classes
- Elija modos de acceso adecuados: Seleccione los modos de acceso que coincidan con los requisitos de la carga de trabajo
- Establezca solicitudes y límites de recursos: Solicite capacidad de almacenamiento adecuada
- Establezca una estrategia de copia de seguridad y recuperación: Prepare estrategias de copia de seguridad y recuperación para datos críticos
- Supervise el almacenamiento: Supervise el uso y el rendimiento del almacenamiento
Escalabilidad del clúster
La escalabilidad de un clúster de Kubernetes se refiere a la capacidad del clúster para manejar cargas y requisitos crecientes. La escalabilidad se puede implementar mediante escalado horizontal (scale out) y escalado vertical (scale up).
Límites de escala del clúster
La guía de clústeres grandes upstream describe un margen de soporte probado: 5.000 nodos, 150.000 Pods totales, 300.000 contenedores totales y 110 Pods por nodo. Estos criterios se aplican conjuntamente; no son límites rígidos universales de la API. No existe un límite general de 20 contenedores por Pod. La capacidad de Service también depende del rango de direcciones y del plano de datos. Los límites y cuotas de redes de nube pueden ser menores.
Escalado horizontal
El escalado horizontal incrementa la capacidad del clúster añadiendo más nodos.
Auto Scaling de nodos: Kubernetes Cluster Autoscaler ajusta automáticamente la cantidad de nodos en función de los requisitos de carga de trabajo.
# AWS Auto Scaling Group tags example
tags:
  k8s.io/cluster-autoscaler/enabled: "true"
  k8s.io/cluster-autoscaler/my-cluster: "owned"
Fragmento de implementación de Cluster Autoscaler (ejemplo de clúster v1.36): Seleccione una versión parcheada que coincida con la versión menor del clúster. Proporcione ServiceAccount, Kubernetes RBAC y un rol IAM dedicado; este fragmento no es una instalación completa.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cluster-autoscaler
  namespace: kube-system
spec:
  replicas: 1
  selector:
    matchLabels:
      app: cluster-autoscaler
  template:
    metadata:
      labels:
        app: cluster-autoscaler
    spec:
      containers:
      - name: cluster-autoscaler
        image: registry.k8s.io/autoscaling/cluster-autoscaler:v1.36.0
        command:
        - ./cluster-autoscaler
        - --cloud-provider=aws
        - --nodes=2:10:my-asg-group
- --scale-down-unneeded-time=10mKarpenter: Karpenter es una nueva herramienta de autoescalado de nodos desarrollada por AWS que proporciona un aprovisionamiento de nodos más rápido y eficiente.
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot", "on-demand"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default-class
  limits:
    cpu: 1000
    memory: 1000Gi
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default-class
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
    - alias: al2023@latest
  subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
Escalado vertical
El escalado vertical de cargas de trabajo ajusta las solicitudes de CPU/memoria de Pod. VPA no redimensiona el nodo subyacente; la capacidad adicional de nodos debe aprovisionarse por separado.
Vertical Pod Autoscaler (VPA): VPA ajusta automáticamente las solicitudes de CPU y memoria para pods.
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: my-app-vpa
spec:
  targetRef:
    apiVersion: "apps/v1"
    kind: Deployment
    name: my-app
  updatePolicy:
    updateMode: "Recreate"
  resourcePolicy:
    containerPolicies:
    - containerName: '*'
      minAllowed:
        cpu: 100m
        memory: 50Mi
      maxAllowed:
        cpu: 1
        memory: 500Mi
Escalado de aplicaciones
El escalado a nivel de aplicación se implementa ajustando la cantidad de réplicas de pod.
Horizontal Pod Autoscaler (HPA): HPA ajusta automáticamente la cantidad de réplicas de pod según la utilización de CPU o métricas personalizadas.
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80
KEDA (Kubernetes Event-driven Autoscaling): KEDA proporciona autoescalado basado en eventos, lo que permite escalar según distintas fuentes de eventos.
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: my-app-scaledobject
spec:
  scaleTargetRef:
    name: my-app
  minReplicaCount: 0
  maxReplicaCount: 10
  triggers:
  - type: kafka
    metadata:
      bootstrapServers: kafka.svc:9092
      consumerGroup: my-group
      topic: my-topic
      lagThreshold: "10"
Mejores prácticas de escalabilidad
Mejores prácticas para la escalabilidad del clúster de Kubernetes:
- Establezca solicitudes y límites de recursos: Establezca solicitudes y límites de recursos adecuados para todos los pods
- Estrategia de node pool: Configure varios node pools para diferentes características de carga de trabajo
- Configure Auto Scaling: Configure correctamente Cluster Autoscaler, HPA y VPA
- Ubicación eficiente de Pod: Utilice afinidad de nodo y afinidad/antiafinidad de pod
- Supervisión del clúster: Supervise continuamente el uso de recursos y el rendimiento
- Pruebas de carga: Realice pruebas de carga periódicas para validar las estrategias de escalado
Seguridad del clúster
La seguridad del clúster de Kubernetes debe implementarse en varias capas. Esto incluye autenticación, autorización, network policies, seguridad de pods y más.
Autenticación
Métodos para autenticar el acceso al servidor de API de Kubernetes:
- Certificados X.509: Autenticación mediante certificados de cliente TLS
- Tokens de Service Account: Tokens para acceder al servidor de API dentro de pods
- OpenID Connect (OIDC): Autenticación mediante proveedores de identidad externos
- Autenticación de token Webhook: Autenticación mediante servicios de autenticación externos
- Proxy de autenticación: Autenticación mediante proxies de autenticación
Ejemplo de kubeconfig:
apiVersion: v1
kind: Config
clusters:
- name: my-cluster
  cluster:
    certificate-authority-data: <CA-DATA>
    server: https://api.my-cluster.example.com
users:
- name: admin
  user:
    client-certificate-data: <CERT-DATA>
    client-key-data: <KEY-DATA>
contexts:
- name: my-context
  context:
    cluster: my-cluster
    user: admin
current-context: my-context
Autorización
Métodos para controlar acciones de usuarios autenticados:
- RBAC (Role-Based Access Control): Control de acceso basado en roles
- ABAC (Attribute-Based Access Control): Control de acceso basado en atributos
- Node Authorization: Autorización especial para nodos
- Webhook Authorization: Autorización mediante servicios externos
Ejemplo de RBAC:
# Role definition
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: default
  name: pod-reader
rules:
- apiGroups: [""]
  resources: ["pods"]
  verbs: ["get", "watch", "list"]
---
# Role binding
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: read-pods
  namespace: default
subjects:
- kind: User
  name: jane
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: pod-reader
  apiGroup: rbac.authorization.k8s.io
Seguridad de red
Métodos para proteger el tráfico de red dentro del clúster:
- Network Policies: Controlan la comunicación de pod a pod
- Comunicación cifrada: Cifrado de comunicaciones mediante TLS
- Service Mesh: Seguridad de red avanzada mediante Istio, Linkerd, etc.
Ejemplo de Network Policy:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
Seguridad de Pod
Implementación de seguridad a nivel de pod:
- Pod Security Context: Configuración de seguridad a nivel de pod y contenedor
- Pod Security Standards: Define requisitos de seguridad de pod
- Perfiles seccomp: Restricciones de llamadas al sistema
- AppArmor/SELinux: Control de acceso obligatorio
Ejemplo de Pod Security Context:
apiVersion: v1
kind: Pod
metadata:
  name: security-context-pod
spec:
  securityContext:
    runAsUser: 1000
    runAsGroup: 3000
    fsGroup: 2000
  containers:
  - name: app
    image: myapp:1.0
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
Administración de Secrets
Métodos para administrar información confidencial de forma segura:
- Kubernetes Secrets: Use recursos básicos de Secret
- etcd cifrado: Cifre los Secrets almacenados en etcd
- Administración externa de Secrets: Utilice HashiCorp Vault, AWS Secrets Manager, etc.
Ejemplo de configuración de etcd cifrado:
apiVersion: apiserver.config.k8s.io/v1
kind: EncryptionConfiguration
resources:
  - resources:
    - secrets
    providers:
    - aescbc:
        keys:
        - name: key1
          secret: <base64-encoded-key>
    - identity: {}
Mejores prácticas de seguridad
Mejores prácticas para la seguridad del clúster de Kubernetes:
- Principio de mínimo privilegio: Conceda solo los privilegios mínimos necesarios
- Actualizaciones periódicas: Actualice periódicamente el clúster y los componentes
- Aislamiento de red: Restrinja la comunicación de pod a pod mediante network policies
- Seguridad de imágenes: Use solo imágenes de confianza e implemente análisis de vulnerabilidades
- Audit Logging: Habilite logs de auditoría para la actividad del clúster
- Benchmarks de seguridad: Cumpla estándares de seguridad como los benchmarks CIS
Actualizaciones del clúster
Las actualizaciones del clúster de Kubernetes son necesarias para aplicar nuevas funciones, parches de seguridad y correcciones de errores. Las actualizaciones deben planificarse y ejecutarse cuidadosamente.
Actualización de August 2026: lanzamiento de Kubernetes v1.37 "Garhwal"
Kubernetes v1.37 "Garhwal" se lanzó según lo programado el August 26, 2026. La versión consta de 67 mejoras: 16 pasaron a Stable, 23 pasaron a Beta y el resto entró como Alpha. Aspectos destacados:
- Los certificados de Pod y ClusterTrustBundles pasan a Stable: la función PodCertificate, que emite y rota automáticamente certificados X.509 para cargas de trabajo como alternativa a los tokens de service account, y el recurso ClusterTrustBundle para distribuir anclajes de confianza ahora son funciones estándar (publicación detallada)
- La API de métricas (metrics.k8s.io) alcanza GA: la API de métricas de recursos utilizada por
kubectl topy HPA ha pasado a estable (publicación detallada) - También Stable: varias funciones de DRA (Dynamic Resource Allocation), inicialización resiliente de watchcache y más / Beta: HPA scale-to-zero, configuración de admission control basada en manifiestos y más / Alpha: checkpoint y restauración a nivel de pod y más
- Obsolescencias: kube-dns y
kubectl run --filename/-festán obsoletos;ipvsya estaba obsoleto en v1.35 y los static Pods ya no pueden hacer referencia a Secrets ni ConfigMaps. La eliminación de la compatibilidad con cgroup v1 también sigue avanzando.
Antes de actualizar, asegúrese de revisar las obsolescencias y eliminaciones en las notas oficiales de la versión.
Estrategias de actualización
Estrategias para actualizaciones del clúster de Kubernetes:
- Actualización blue/green: Cree un clúster de nueva versión por separado y migre las cargas de trabajo
- Actualización in-place: Actualice directamente el clúster existente
- Actualización canary: Actualice primero solo algunos nodos para validación
Orden de actualización
Orden habitual para actualizaciones de clústeres de Kubernetes:
- Actualización del control plane: kube-apiserver, kube-controller-manager, kube-scheduler, etcd
- Actualización de DNS y CNI: CoreDNS, plugins CNI y otros add-ons principales
- Actualización de worker nodes: Actualización secuencial de worker nodes
Secuencia de actualización de kubeadm:
Siga la guía de actualización de kubeadm específica de la versión y configure el repositorio de paquetes pkgs.k8s.io de la versión menor de destino. Actualice solo una versión menor cada vez.
- Realice una copia de seguridad de etcd y verifique la compatibilidad de los add-ons. Actualice
kubeadmen el primer nodo de control plane, ejecutekubeadm upgrade plany luegokubeadm upgrade apply <target-version>. - En nodos de control plane adicionales, actualice
kubeadmy ejecutekubeadm upgrade node. - Drene cada nodo antes de actualizar su kubelet; actualice los paquetes kubelet/kubectl al parche elegido, recargue systemd, reinicie kubelet, verifique la disponibilidad y quite el cordon.
- En workers, actualice
kubeadm, ejecutekubeadm upgrade nodey luego realice la secuencia de drenaje/kubelet/quitar cordon. Mantenga kubelet no más reciente que el servidor de API.
Consideraciones de actualización
Consideraciones al actualizar clústeres de Kubernetes:
- Cambios de API: Compruebe los cambios de API en las nuevas versiones
- Feature Gates: Compruebe los nuevos feature gates y cambios en los valores predeterminados
- Dependencias: Compruebe la compatibilidad de componentes dependientes como CNI y CSI
- Tiempo de inactividad: Planifique el tiempo de inactividad previsto durante las actualizaciones
- Plan de reversión: Establezca un plan de reversión en caso de problemas
Mejores prácticas de actualización
Mejores prácticas para las actualizaciones del clúster de Kubernetes:
- Pruebe primero en el entorno de pruebas: Valide en el entorno de pruebas antes de actualizar producción
- Actualización gradual: Actualice una versión menor a la vez
- Copia de seguridad: Realice copia de seguridad de los datos de etcd antes de actualizar
- Documentación: Documente los procedimientos y resultados de actualización
- Supervisión: Supervise el estado del clúster durante y después de la actualización
- Ventana de actualización: Realice actualizaciones durante períodos de poco tráfico
Arquitectura del clúster de Amazon EKS
Amazon EKS (Elastic Kubernetes Service) es un servicio de Kubernetes administrado proporcionado por AWS. EKS proporciona todas las funciones básicas de Kubernetes y añade integración con servicios de AWS y facilidad de administración.
Descripción general de la arquitectura de EKS
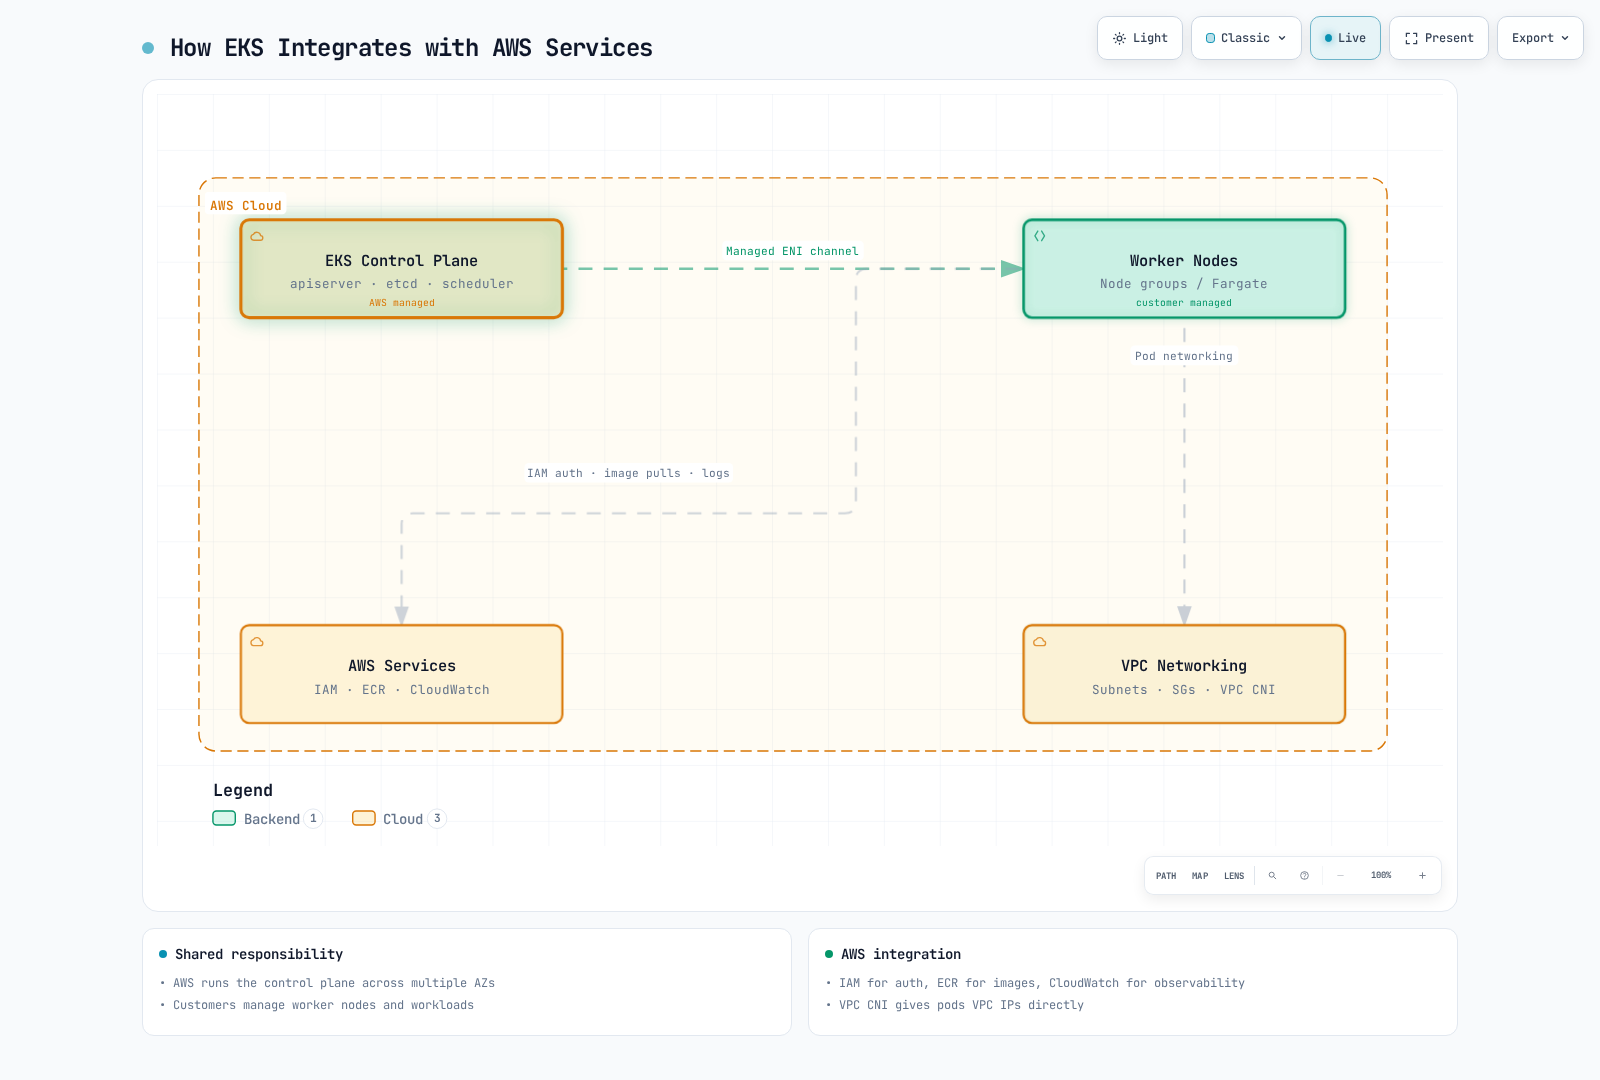
Los clústeres de EKS constan de los siguientes componentes:
- EKS Control Plane: Control plane de Kubernetes administrado por AWS
- EKS Nodes: Worker nodes administrados por usuarios (instancias EC2)
- EKS Managed Node Groups: Grupos de nodos administrados por AWS
- EKS Fargate Profiles: Entorno de ejecución de contenedores serverless
- VPC and Subnets: VPC y subnets para las redes del clúster
Diagrama de arquitectura de EKS:
Control plane de EKS
El control plane de EKS es administrado por AWS y proporciona alta disponibilidad en varias zonas de disponibilidad.
Características principales:
- Servicio administrado: AWS administra el mantenimiento y las actualizaciones del control plane
- Alta disponibilidad: Implementado en varias zonas de disponibilidad
- Auto Scaling: Se escala automáticamente según la carga
- Seguridad: Integrado con los servicios de seguridad de AWS
Tipos de nodos de EKS
EKS admite varios tipos de nodos:
- Self-Managed Nodes: Los usuarios administran directamente las instancias EC2
- Managed Node Groups: AWS administra el ciclo de vida de los nodos
- Fargate: Entorno de ejecución de contenedores serverless
- EKS Auto Mode: AWS administra la computación y la infraestructura integrada
- EKS Hybrid Nodes: Nodos on-premises administrados por el cliente
Bottlerocket es un sistema operativo de nodo, no un tipo independiente de administración de computación.
Ejemplo de Managed Node Group:
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-cluster
  region: ap-northeast-2
managedNodeGroups:
  - name: ng-1
    instanceType: m5.large
    desiredCapacity: 3
    minSize: 2
    maxSize: 5
    volumeSize: 80
    privateNetworking: true
    labels:
      role: worker
    tags:
      nodegroup-role: worker
Redes de EKS
Las redes de EKS se basan en Amazon VPC e incluyen los siguientes componentes:
- VPC CNI Plugin: Integración con las redes de AWS VPC
- Security Groups: Seguridad de red a nivel de nodo y pod
- Load Balancer Integration: Integración con ELB, ALB, NLB
- VPC Endpoints: Comunicación privada con servicios de AWS
Ejemplo de configuración del add-on VPC CNI (valores de configuración JSON, no un ConfigMap):
{
  "enableNetworkPolicy": "true",
  "env": {
    "WARM_IP_TARGET": "5",
    "MINIMUM_IP_TARGET": "10"
  }
}
Combine estos valores con la configuración del add-on instalado y valide su esquema antes de actualizarlo. La compatibilidad con Pod ENI utiliza la variable de entorno ENABLE_POD_ENI y además requiere nodos compatibles, permisos IAM y una SecurityGroupPolicy; una clave ConfigMap por sí sola no la habilita. Consulte la configuración de network policy.
Almacenamiento de EKS
EKS se integra con varios servicios de almacenamiento de AWS:
- EBS CSI Driver: Administración de volúmenes Amazon EBS
- EFS CSI Driver: Administración de sistemas de archivos Amazon EFS
- FSx for Lustre CSI Driver: Administración de sistemas de archivos FSx for Lustre
- S3: Almacenamiento de objetos
Ejemplo de EBS CSI Driver:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-sc
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  encrypted: "true"
volumeBindingMode: WaitForFirstConsumer
Seguridad de EKS
EKS se integra con servicios de seguridad de AWS para proporcionar seguridad robusta:
- IAM Integration: Integración de AWS IAM y Kubernetes RBAC
- VPC Security: Security groups de VPC y ACL de red
- AWS KMS: Integración de KMS para cifrado de Secrets
- AWS WAF: Integración de firewall de aplicaciones web
- AWS Shield: Protección DDoS
Ejemplo de IAM Role Service Account:
apiVersion: v1
kind: ServiceAccount
metadata:
  name: s3-reader
  namespace: default
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/s3-reader-role
Supervisión y logging de EKS
EKS se integra con servicios de supervisión y logging de AWS:
- CloudWatch Container Insights: Supervisión de contenedores
- CloudWatch Logs: Recopilación y análisis de logs
- X-Ray: Trazado distribuido
- Prometheus and Grafana: Integración de herramientas de supervisión de código abierto
Ejemplo de CloudWatch Container Insights:
apiVersion: v1
kind: Namespace
metadata:
  name: amazon-cloudwatch
---
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: cloudwatch-agent
  namespace: amazon-cloudwatch
spec:
  selector:
    matchLabels:
      name: cloudwatch-agent
  template:
    metadata:
      labels:
        name: cloudwatch-agent
    spec:
      containers:
      - name: cloudwatch-agent
        image: amazon/cloudwatch-agent:1.247347.6b250880
        # ... additional configuration
Optimización de costos de EKS
Métodos para optimizar los costos del clúster de EKS:
- Spot Instances: Utilice instancias Spot rentables
- Fargate: Reduzca los costos de recursos inactivos con ejecución de contenedores serverless
- Auto Scaling: Optimización de recursos mediante cluster autoscaler
- Graviton Processors: Utilice instancias Graviton basadas en ARM
- Resource Request Optimization: Establezca solicitudes y límites de recursos adecuados
Ejemplo de Node Group de Spot Instances:
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-cluster
  region: ap-northeast-2
managedNodeGroups:
  - name: spot-ng
    instanceTypes: ["m5.large", "m5a.large", "m5d.large", "m5ad.large"]
    spot: true
    desiredCapacity: 3
    minSize: 2
    maxSize: 10
Más información
Para profundizar su comprensión de la arquitectura de clúster explicada en este documento, consulte los siguientes temas:
- Introducción a Kubernetes - Conceptos básicos e historia de Kubernetes
- Pods y cargas de trabajo - Administración de cargas de trabajo que se ejecutan en el clúster
- Servicios y redes - Configuración de red dentro del clúster
- Scheduling, preemption y eviction - Cómo se colocan los pods en nodos
- Administración de clústeres - Operación y administración de clústeres
- Introducción a EKS - Descripción general del servicio Amazon EKS
- Creación de clústeres EKS - Cómo crear clústeres de EKS
Aprendizaje práctico y avanzado
- Tutoriales oficiales de Kubernetes - Aprendizaje mediante práctica directa
- Kubernetes The Hard Way - Construcción manual de un clúster de Kubernetes
- Redes de Cilium - Funciones avanzadas de redes y seguridad
Conclusión
En este documento, hemos examinado la arquitectura de los clústeres de Kubernetes, los componentes principales y cómo trabajan juntos. También cubrimos aspectos importantes como las redes, el almacenamiento, la escalabilidad, la seguridad y las actualizaciones del clúster, así como la arquitectura de los clústeres de Amazon EKS.
Comprender la arquitectura de clúster de Kubernetes es la base para diseñar, implementar y operar clústeres eficazmente. Con este conocimiento, puede crear entornos de Kubernetes estables, escalables y con mayor seguridad.
Cuestionario
Para poner a prueba lo que aprendió en este capítulo, pruebe el Cuestionario de arquitectura de clúster.