Observabilidad de Linkerd
Última actualización: 11 de septiembre de 2026 · Linkerd edge-26.9.1 / charts 2026.9.1 · Ejemplos de Prometheus Operator comprobados con 0.93.1
Linkerd expone métricas del proxy y de los protocolos; Viz añade Prometheus, metrics-api, tap, tap-injector y el panel web. El chart actual de Viz no instala Grafana. El rastreo distribuido también necesita un colector/backend configurado, contexto de traza y muestreo; no se habilita instalando un panel de métricas.
Los ejemplos presuponen la guía de instalación, cargas de trabajo web/api existentes en la malla y tráfico real en my-app. Configure el namespace, los nombres de cargas de trabajo y Services, los puertos y las identidades correctos para su instalación. Una base de datos con TCP opaco no produce automáticamente mediciones de éxito y latencia HTTP.
Significado de las métricas
| Métrica | Significado |
|---|---|
| response_total | Clasificaciones finales de respuestas, incluido el tratamiento de errores y del fin del flujo |
| request_total | Solicitudes observadas; no es un recuento de operaciones de negocio exitosas |
| response_latency_ms_bucket | Histograma de tiempo hasta el primer byte en milisegundos |
| tcp_open_connections | Conexiones de transporte abiertas actualmente |
| tcp_open_total | Acumulado de conexiones abiertas, no conexiones activas actualmente |
Las métricas de servicio habituales son la tasa de éxito, la tasa de solicitudes y la latencia. Añada métricas de capacidad/saturación, de aplicación y de Kubernetes según sea necesario. La clasificación HTTP predeterminada del proxy considera los errores del servidor como fallos; un HTTP 400 puede contar como éxito. El estado de gRPC y las políticas de respuesta configuradas pueden cambiar la clasificación. Esto no constituye automáticamente un SLI de éxito de negocio.
La latencia no es la duración completa del flujo de respuesta. El proxy publicado la registra en el primer fragmento disponible del cuerpo de la respuesta, con una alternativa cuando se descarta el cuerpo, independientemente de la clasificación final de la respuesta. Por tanto, las observaciones del histograma y del contador de respuestas pueden estar disponibles en momentos diferentes. No aplique etiquetas de clasificación de éxito o fallo a un histograma que no las exponga.
Estadísticas de la CLI e inspección en directo
linkerd viz stat deploy -n my-app
linkerd viz stat deploy/web -n my-app --to deploy/api
linkerd viz stat deploy/api -n my-app --from deploy/web
linkerd viz stat pods -n my-app
linkerd viz stat namespaces
linkerd viz stat deploy -n my-app --time-window 10m -o wide
linkerd viz stat deploy -n my-app -o json
La tabla incluye MESHED, SUCCESS, RPS, percentiles de latencia y TCP_CONN. La salida ampliada añade tasas de bytes de transporte; no es un inventario de versiones del proxy. Las vistas de Pods y Deployments y las vistas de Services tienen puntos de observación diferentes: las estadísticas de Service utilizan métricas de salida de los clientes y omiten los clientes ajenos a la malla. Mantenga esa distinción al comparar totales.
linkerd viz top deploy/web -n my-app --hide-sources=false
linkerd viz tap deploy/web -n my-app --method GET --path /api
linkerd viz tap deploy/web -n my-app --to deploy/api --max-rps 20
linkerd viz tap deploy/web -n my-app -o json
linkerd viz edges deploy -n my-app
linkerd viz edges pods -n my-app
top resume el tráfico observado en directo mediante Tap. --hide-sources=false muestra la columna de origen, no las cabeceras HTTP. tap --path es un filtro de prefijo de ruta; --max-rps limita la tasa de solicitudes observadas mediante Tap, no el número total de solicitudes de la aplicación. El tap actual no tiene --from ni --show-headers. Observe la carga de trabajo de origen con --to o utilice los filtros de estadísticas compatibles.
Tap es un flujo de observación muestreado y limitado, no una captura de paquetes ni una auditoría completa. Restrinja el acceso a su API porque las rutas y los metadatos de las solicitudes pueden ser sensibles. Las conexiones del grafo muestran conexiones observadas; una vista vacía no demuestra ausencia de tráfico ni cifrado universal.
Panel y almacenamiento de Viz
linkerd viz dashboard --address 127.0.0.1 --port 8084 --show urlAbra la URL local mostrada. Mantenga esta vía de acceso local vinculada a la interfaz de bucle local; un panel publicado externamente necesita su propio diseño de autenticación y acceso. Una dirección de escucha o una comprobación de la cabecera Host no es autenticación de usuarios.
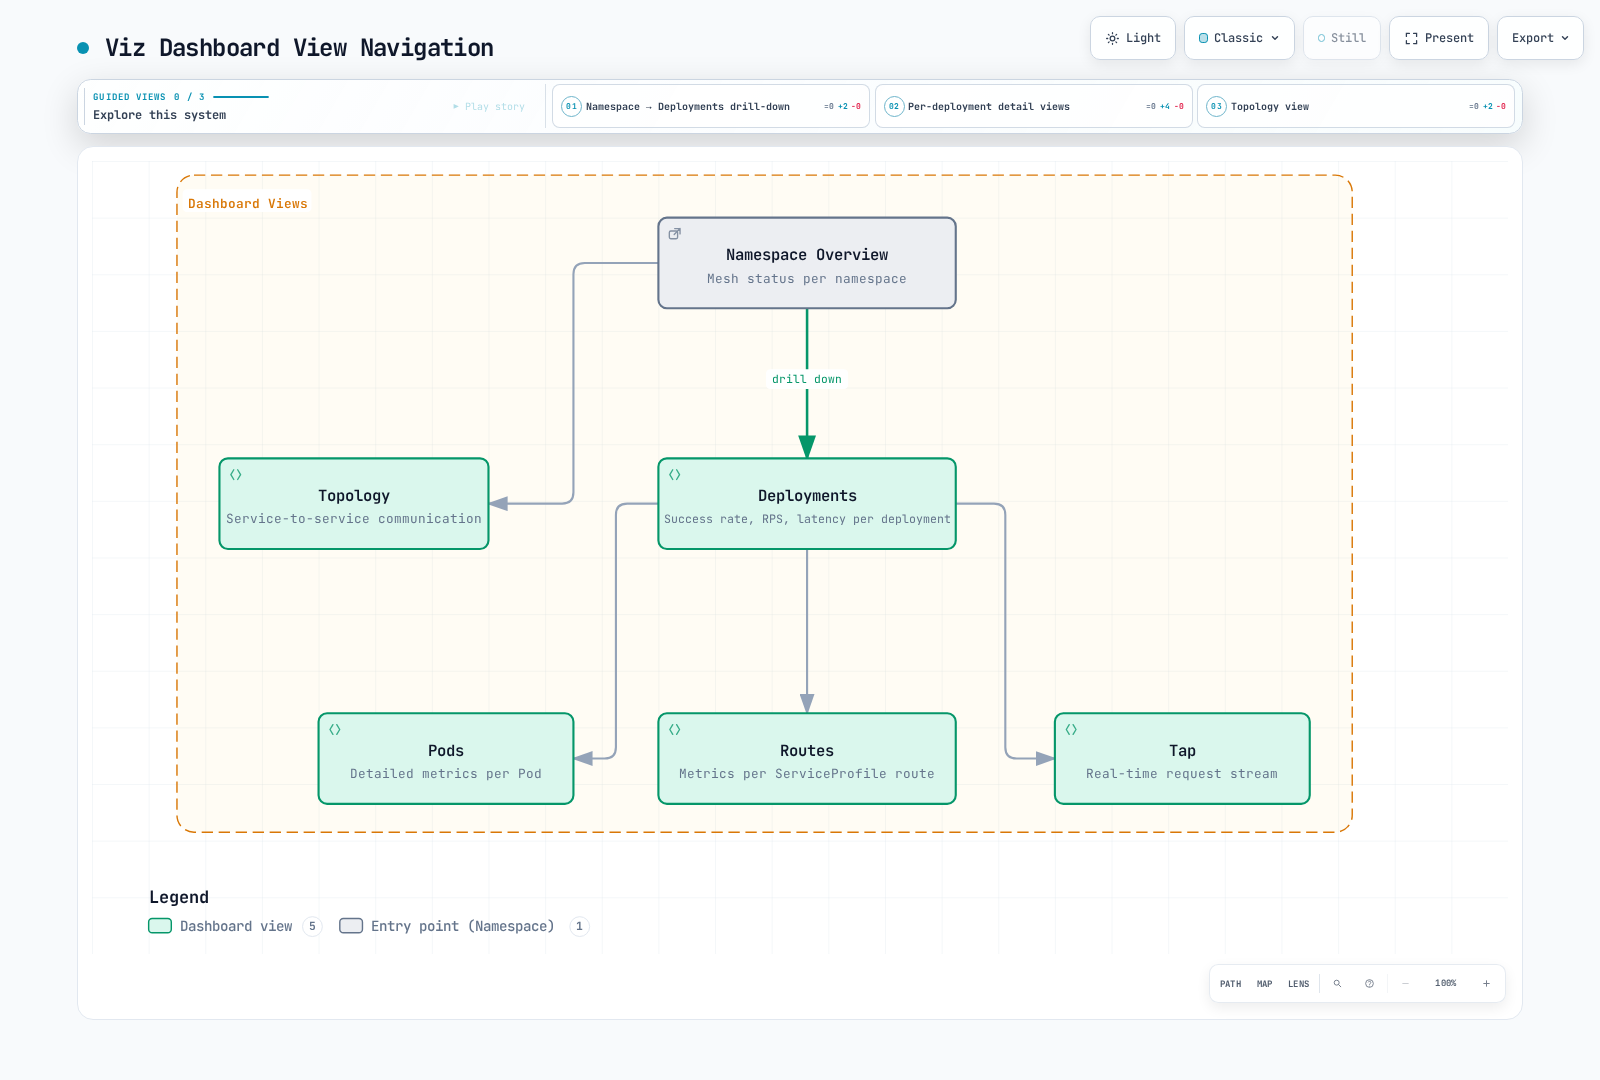
El Prometheus incluido por defecto conserva seis horas y utiliza almacenamiento transitorio. El chart seleccionado fija su propia imagen de Prometheus; no sustituya silenciosamente esa versión por una nueva versión principal. La persistencia se puede configurar como se describe en la guía de instalación, y el almacenamiento a largo plazo o de alta disponibilidad requiere un diseño independiente.
kubectl -n linkerd-viz port-forward --address 127.0.0.1 svc/prometheus 9090:9090
# In another terminal:
curl --fail --get --data-urlencode 'query=up{job="linkerd-proxy"}' \
  http://127.0.0.1:9090/api/v1/query
Prometheus externo
Elija deliberadamente la recopilación directa, la federación o una canalización adecuada de escritura remota. Recopilar las mismas series por varias vías sin deduplicación puede duplicar los resultados del recuento.
Configuración de recopilación directa
Integre esto en la configuración existente de Prometheus. Sigue la correspondencia de trabajos y etiquetas del chart de Viz seleccionado, con etiquetas explícitas de namespace/Pod añadidas a los destinos del controlador:
scrape_configs:
- job_name: linkerd-controller
  kubernetes_sd_configs:
  - role: pod
    namespaces:
      names:
      - linkerd
      - linkerd-viz
  relabel_configs:
  - source_labels:
    - __meta_kubernetes_pod_container_port_name
    action: keep
    regex: .*admin$
  - source_labels:
    - __meta_kubernetes_pod_container_port_name
    action: drop
    regex: linkerd-admin
  - source_labels:
    - __meta_kubernetes_pod_container_name
    action: replace
    target_label: component
  - source_labels:
    - __meta_kubernetes_namespace
    target_label: namespace
  - source_labels:
    - __meta_kubernetes_pod_name
    target_label: pod
- job_name: linkerd-proxy
  kubernetes_sd_configs:
  - role: pod
  relabel_configs:
  - source_labels:
    - __meta_kubernetes_pod_phase
    regex: (Pending|Running)
    action: keep
  - source_labels:
    - __meta_kubernetes_pod_container_name
    - __meta_kubernetes_pod_container_port_name
    - __meta_kubernetes_pod_label_linkerd_io_control_plane_ns
    action: keep
    regex: ^linkerd-proxy;linkerd-admin;linkerd$
  - source_labels:
    - __meta_kubernetes_namespace
    action: replace
    target_label: namespace
  - source_labels:
    - __meta_kubernetes_pod_name
    action: replace
    target_label: pod
  - source_labels:
    - __meta_kubernetes_pod_label_linkerd_io_proxy_job
    action: replace
    target_label: k8s_job
  - action: labeldrop
    regex: __meta_kubernetes_pod_label_linkerd_io_proxy_job
  - action: labelmap
    regex: __meta_kubernetes_pod_label_linkerd_io_proxy_(.+)
  - action: labeldrop
    regex: __meta_kubernetes_pod_label_linkerd_io_proxy_(.+)
  - action: labelmap
    regex: __meta_kubernetes_pod_label_linkerd_io_(.+)
  - action: labelmap
    regex: __meta_kubernetes_pod_label_(.+)
    replacement: __tmp_pod_label_$1
  - action: labelmap
    regex: __tmp_pod_label_linkerd_io_(.+)
    replacement: __tmp_pod_label_$1
  - action: labeldrop
    regex: __tmp_pod_label_linkerd_io_(.+)
  - action: labelmap
    regex: __tmp_pod_label_(.+)
El antiguo filtro de puertos de controlador admin-http omitía puertos actuales como dest-admin e ident-admin. El filtro del proxy conserva el destino con nombres linkerd-proxy/linkerd-admin para el plano de control previsto. El descubrimiento de Pods de Kubernetes incluye contenedores de inicialización, por lo que no debe descartar destinos solo porque __meta_kubernetes_pod_container_init sea true: el sidecar nativo predeterminado reside allí.
Estas etiquetas permiten las consultas de cargas de trabajo mostradas. Conserve las etiquetas que requieran las consultas y los paneles adicionales de Viz; revise la cardinalidad y los datos sensibles de las etiquetas de aplicación mapeadas. Configure el RBAC de descubrimiento de Kubernetes, el acceso a la API y la conectividad con los puertos de métricas. Un archivo YAML válido no demuestra que el descubrimiento o la recopilación funcionen.
Alternativas de Prometheus Operator
El recurso Prometheus debe seleccionar tanto estos monitores como su namespace. Los metadatos del ejemplo suponen que su selector acepta release: monitoring; adapte esa etiqueta a la instalación real.
apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
  name: linkerd-proxies
  namespace: monitoring
  labels:
    release: monitoring
spec:
  namespaceSelector:
    any: true
  selector:
    matchLabels:
      linkerd.io/control-plane-ns: linkerd
  podMetricsEndpoints:
  - port: linkerd-admin
    path: /metrics
    interval: 10s
    relabelings:
    - sourceLabels:
      - __meta_kubernetes_pod_phase
      regex: (Pending|Running)
      action: keep
    - sourceLabels:
      - __meta_kubernetes_pod_container_name
      - __meta_kubernetes_pod_container_port_name
      - __meta_kubernetes_pod_label_linkerd_io_control_plane_ns
      action: keep
      regex: ^linkerd-proxy;linkerd-admin;linkerd$
    - sourceLabels:
      - __meta_kubernetes_namespace
      action: replace
      targetLabel: namespace
    - sourceLabels:
      - __meta_kubernetes_pod_name
      action: replace
      targetLabel: pod
    - sourceLabels:
      - __meta_kubernetes_pod_label_linkerd_io_proxy_job
      action: replace
      targetLabel: k8s_job
    - action: labeldrop
      regex: __meta_kubernetes_pod_label_linkerd_io_proxy_job
    - action: labelmap
      regex: __meta_kubernetes_pod_label_linkerd_io_proxy_(.+)
    - action: labeldrop
      regex: __meta_kubernetes_pod_label_linkerd_io_proxy_(.+)
    - action: labelmap
      regex: __meta_kubernetes_pod_label_linkerd_io_(.+)
    - action: labelmap
      regex: __meta_kubernetes_pod_label_(.+)
      replacement: __tmp_pod_label_$1
    - action: labelmap
      regex: __tmp_pod_label_linkerd_io_(.+)
      replacement: __tmp_pod_label_$1
    - action: labeldrop
      regex: __tmp_pod_label_linkerd_io_(.+)
    - action: labelmap
      regex: __tmp_pod_label_(.+)
    - targetLabel: job
      replacement: linkerd-proxy
---
apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
  name: linkerd-destination
  namespace: monitoring
  labels:
    release: monitoring
spec:
  namespaceSelector:
    matchNames:
    - linkerd
  selector:
    matchLabels:
      linkerd.io/control-plane-component: destination
  podMetricsEndpoints:
  - port: dest-admin
    path: /metrics
    interval: 10s
    relabelings:
    - sourceLabels:
      - __meta_kubernetes_pod_container_name
      targetLabel: component
    - targetLabel: job
      replacement: linkerd-controller
  - port: spval-admin
    path: /metrics
    interval: 10s
    relabelings:
    - sourceLabels:
      - __meta_kubernetes_pod_container_name
      targetLabel: component
    - targetLabel: job
      replacement: linkerd-controller
  - port: policy-admin
    path: /metrics
    interval: 10s
    relabelings:
    - sourceLabels:
      - __meta_kubernetes_pod_container_name
      targetLabel: component
    - targetLabel: job
      replacement: linkerd-controller
El segundo PodMonitor cubre los tres endpoints de métricas del Deployment destination. No cubre todos los controladores. Para otros componentes, use sus puertos declarados reales:
| Componente | Nombre del puerto de métricas |
|---|---|
| Identidad | ident-admin |
| Inyector del proxy | injector-admin |
| Componentes de Viz | admin |
El Service destination no expone un puerto de Service admin-http, por lo que un ServiceMonitor que seleccione ese puerto inexistente no descubre ningún endpoint de ese tipo. Use PodMonitors para los puertos de contenedor declarados o aprovisione deliberadamente un Service adecuado. No configure recopilaciones directas y PodMonitors duplicados para los mismos destinos.
La federación es otra opción. En el chart de Viz seleccionado, el puerto del Service de Prometheus se llama admin, y el endpoint es /federate. Conserve las etiquetas exportadas, seleccione los trabajos previstos y autorice el ServiceAccount del cliente de la malla frente al Server prometheus-admin de Viz. Un ejemplo genérico del proyecto original que nombre admin-http no coincide con este chart.
Permitir que Viz consulte un Prometheus existente
Para un Prometheus configurado por separado, accesible y que conserve los datos de Linkerd necesarios:
prometheus:
  enabled: false
prometheusUrl: http://prometheus.monitoring.svc.cluster.local:9090
Integre estos valores en la configuración completa de la versión de Viz seleccionada. Verifique el comportamiento de la API de consultas, las etiquetas de recopilación, la retención, la autenticación y la autorización antes de deshabilitar su Prometheus local. Esta URL no instala Prometheus ni concede acceso.
Consultas con alcance explícito
Estas consultas seleccionan una sola vez las observaciones de entrada de la API. Adapte namespace/deployment y añada un alcance de clúster si el backend es compartido.
Proporción de éxito:
((sum(rate(response_total{namespace="my-app",deployment="api",direction="inbound",classification="success"}[5m])) or vector(0)) / sum(rate(response_total{namespace="my-app",deployment="api",direction="inbound"}[5m])))
and on() (sum(rate(response_total{namespace="my-app",deployment="api",direction="inbound"}[5m])) > 0)
El numerador recurre a cero cuando todas las respuestas observadas fallaron y no existe una serie de éxitos. La condición de total positivo deja el tráfico ausente o inactivo sin resultado de éxito; no muestra los datos ausentes como un 100%.
Tasa de solicitudes:
sum(rate(request_total{namespace="my-app",deployment="api",direction="inbound"}[5m]))Percentiles de tiempo hasta el primer byte, en milisegundos:
histogram_quantile(0.5, sum by (le) (rate(response_latency_ms_bucket{namespace="my-app",deployment="api",direction="inbound"}[5m])))

histogram_quantile(0.95, sum by (le) (rate(response_latency_ms_bucket{namespace="my-app",deployment="api",direction="inbound"}[5m])))

histogram_quantile(0.99, sum by (le) (rate(response_latency_ms_bucket{namespace="my-app",deployment="api",direction="inbound"}[5m])))
Conexiones TCP activas de entrada en el lado de origen:
sum(tcp_open_connections{namespace="my-app",deployment="api",direction="inbound",peer="src"})peer="src" evita incluir en ese recuento la conexión independiente del proxy con la aplicación local. Para las conexiones abiertas por segundo, aplique rate a tcp_open_total con el mismo alcance de observación previsto.
No existe una etiqueta genérica retry="true" en request_total. Para los ServiceProfiles, inspeccione route_actual_request_total, route_request_total y route_retryable_total con un alcance y una ventana coincidentes. Las respuestas reintentables no son lo mismo que los reintentos realmente enviados; la serie sin presupuesto es un subconjunto. Las métricas de políticas actuales y las pruebas de intentos de la aplicación requieren su propia interpretación. Consulte gestión del tráfico.
Grafana
Grafana se instala por separado desde Linkerd 2.12. No hay un svc/grafana incluido al que redirigir puertos en una instalación actual predeterminada de Viz, y grafana.enabled:false no configura la integración compatible.
Use un Grafana existente con una fuente de datos Prometheus que contenga las métricas necesarias. Para un Grafana en la malla que se ejecute como ServiceAccount grafana en el namespace monitoring, esto permite el acceso al Prometheus existente de Viz:
apiVersion: policy.linkerd.io/v1alpha1
kind: AuthorizationPolicy
metadata:
  name: prometheus-admin-grafana
  namespace: linkerd-viz
spec:
  targetRef:
    group: policy.linkerd.io
    kind: Server
    name: prometheus-admin
  requiredAuthenticationRefs:
  - kind: ServiceAccount
    name: grafana
    namespace: monitoring
Si Grafana utiliza una identidad diferente o un Prometheus externo, configure allí el acceso adecuado. Una concesión a un ServiceAccount requiere que el cliente presente realmente esa identidad de la malla.
Para vincular Viz a un Grafana accesible externamente:
grafana:
  externalUrl: https://grafana.example.com/
Las alternativas compatibles son grafana.externalUrl para una URL completa accesible desde el navegador y grafana.url para la integración mediante proxy inverso dentro del clúster. Esta última también requiere configurar la raíz y la subruta de Grafana. grafana.uidPrefix distingue los UID de los paneles importados; no es un control de autorización de inquilinos.
La colección de paneles publicada incluye vistas de salud, resumen general, namespace/carga de trabajo, Service, ruta, autoridad y múltiples clústeres. Autoridad significa host/:authority de HTTP, no permisos de autorización. Importe paneles de una versión revisada y verifique su fuente de datos, etiquetas, unidades y enlaces de UID.
Ejemplo de panel pequeño
Este JSON de panel clásico incluye una entrada de importación de fuente de datos, variables constantes de namespace/deployment y unidades de los paneles. Seleccione su fuente de datos y ajuste las constantes durante la importación. Se comprobaron las consultas y el JSON; no se ejecutó ninguna importación en un servidor Grafana.
{
  "__inputs": [
    {
      "name": "DS_PROMETHEUS",
      "label": "Prometheus",
      "type": "datasource",
      "pluginId": "prometheus",
      "pluginName": "Prometheus"
    }
  ],
  "id": null,
  "uid": "linkerd-api-overview",
  "title": "Linkerd API Overview",
  "schemaVersion": 39,
  "version": 1,
  "time": {
    "from": "now-1h",
    "to": "now"
  },
  "templating": {
    "list": [
      {
        "name": "namespace",
        "type": "constant",
        "query": "my-app",
        "current": {
          "text": "my-app",
          "value": "my-app"
        }
      },
      {
        "name": "deployment",
        "type": "constant",
        "query": "api",
        "current": {
          "text": "api",
          "value": "api"
        }
      }
    ]
  },
  "panels": [
    {
      "id": 1,
      "title": "Proxy-classified Success Rate",
      "type": "gauge",
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "gridPos": {
        "x": 0,
        "y": 0,
        "w": 8,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "percent"
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "datasource": {
            "type": "prometheus",
            "uid": "${DS_PROMETHEUS}"
          },
          "expr": "100 * (((sum(rate(response_total{namespace=\"$namespace\",deployment=\"$deployment\",direction=\"inbound\",classification=\"success\"}[5m])) or vector(0)) / sum(rate(response_total{namespace=\"$namespace\",deployment=\"$deployment\",direction=\"inbound\"}[5m])))\nand on() (sum(rate(response_total{namespace=\"$namespace\",deployment=\"$deployment\",direction=\"inbound\"}[5m])) > 0))",
          "legendFormat": "success"
        }
      ]
    },
    {
      "id": 2,
      "title": "Request Rate",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "gridPos": {
        "x": 8,
        "y": 0,
        "w": 8,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "reqps"
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "datasource": {
            "type": "prometheus",
            "uid": "${DS_PROMETHEUS}"
          },
          "expr": "sum(rate(request_total{namespace=\"$namespace\",deployment=\"$deployment\",direction=\"inbound\"}[5m]))",
          "legendFormat": "requests/s"
        }
      ]
    },
    {
      "id": 3,
      "title": "Time to First Byte",
      "type": "timeseries",
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "gridPos": {
        "x": 16,
        "y": 0,
        "w": 8,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "ms"
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "datasource": {
            "type": "prometheus",
            "uid": "${DS_PROMETHEUS}"
          },
          "expr": "histogram_quantile(0.5, sum by (le) (rate(response_latency_ms_bucket{namespace=\"$namespace\",deployment=\"$deployment\",direction=\"inbound\"}[5m])))",
          "legendFormat": "p50"
        },
        {
          "refId": "B",
          "datasource": {
            "type": "prometheus",
            "uid": "${DS_PROMETHEUS}"
          },
          "expr": "histogram_quantile(0.95, sum by (le) (rate(response_latency_ms_bucket{namespace=\"$namespace\",deployment=\"$deployment\",direction=\"inbound\"}[5m])))",
          "legendFormat": "p95"
        },
        {
          "refId": "C",
          "datasource": {
            "type": "prometheus",
            "uid": "${DS_PROMETHEUS}"
          },
          "expr": "histogram_quantile(0.99, sum by (le) (rate(response_latency_ms_bucket{namespace=\"$namespace\",deployment=\"$deployment\",direction=\"inbound\"}[5m])))",
          "legendFormat": "p99"
        }
      ]
    }
  ]
}
Rastreo distribuido
La extensión Linkerd-Jaeger se eliminó en Linkerd 2.19. El rastreo actual utiliza un colector/backend compatible con OpenTelemetry gestionado por separado; los antiguos comandos linkerd jaeger, la dirección del webhook de la extensión y un ConfigMap arbitrario linkerd-jaeger-config no lo configuran.
Para un colector OTLP/gRPC existente en la malla en el puerto 4317, que se ejecute como ServiceAccount collector en el namespace tracing, integre estos valores en la configuración completa de Linkerd:
proxy:
  tracing:
    enabled: true
    collector:
      endpoint: collector.tracing.svc.cluster.local:4317
      meshIdentity:
        serviceAccountName: collector
        namespace: tracing
El chart seleccionado requiere el endpoint del colector y ambos campos meshIdentity, y deriva de ellos la identidad DNS esperada del colector. Ejecutar simplemente un receptor OTLP fuera de la malla no satisface esta configuración. Verifique su puerto de Service, la canalización de recepción, el acceso de red y autorización, el almacenamiento y los spans muestreados. Actualice las cargas de trabajo mediante el responsable de gestión de la instalación para que sus proxies reciban la configuración de rastreo.
Linkerd participa en el contexto de traza W3C y en las trazas B3; cuando aparecen ambos, W3C tiene prioridad. x-request-id es un ID de correlación, no un formato obligatorio de contexto de traza. Un ingress, una aplicación o un generador de pruebas debe establecer el contexto y el muestreo, y las aplicaciones deben propagar el contexto a través de sus propias llamadas.
Ejemplos de propagación en la aplicación
Prefiera una biblioteca de OpenTelemetry adecuada para la extracción validada, la creación de spans hijos, el muestreo y la exportación. Estos pequeños adaptadores GET solo transmiten el contexto W3C; no crean spans de aplicación, no validan la identidad del usuario ni proporcionan un proxy inverso general. Configure la URL del backend desde ajustes de despliegue confiables.
Python (Flask 3.1.3 / Requests 2.32.5 utilizados en la comprobación local):
from flask import Flask, Response, request
import requests

app = Flask(__name__)
BACKEND_URL = "http://backend-service/api/backend"  # Trusted configuration.
MAX_RESPONSE_BYTES = 1024 * 1024
app.config["DOWNSTREAM_TIMEOUT"] = (2, 5)  # Connect/read inactivity, not total time.


@app.get("/api/data")
def get_data():
    headers = {}
    if request.headers.get("traceparent"):
        for name in ("traceparent", "tracestate"):
            if request.headers.get(name):
                headers[name] = request.headers[name]
    try:
        with requests.get(
            BACKEND_URL,
            headers=headers,
            timeout=app.config["DOWNSTREAM_TIMEOUT"],
            allow_redirects=False,
            stream=True,
        ) as upstream:
            # This small API adapter does not follow or relay redirects.
            if 300 <= upstream.status_code < 400:
                return Response("Unexpected upstream redirect\n", status=502)
            body = bytearray()
            for chunk in upstream.iter_content(chunk_size=16384):
                body.extend(chunk)
                if len(body) > MAX_RESPONSE_BYTES:
                    return Response("Upstream response too large\n", status=502)
            return Response(
                bytes(body),
                status=upstream.status_code,
                content_type=upstream.headers.get(
                    "Content-Type", "application/octet-stream"
                ),
            )
    except requests.Timeout:
        return Response("Upstream timeout\n", status=504)
    except requests.RequestException:
        return Response("Upstream request failed\n", status=502)
El tiempo de espera de conexión/lectura limita la espera de conexión y la inactividad de lectura, no la duración total de extremo a extremo. Una respuesta que llega continuamente a cuentagotas o la cancelación del cliente requieren un diseño de plazos de aplicación/servidor que va más allá de este ejemplo síncrono. El búfer de respuesta está limitado y las redirecciones se rechazan explícitamente.
Manejador de Go para un servidor HTTP existente:
package main

import (
	"errors"
	"io"
	"net"
	"net/http"
	"time"
)

var backendURL = "http://backend-service/api/backend" // Trusted configuration.
var downstreamClient = &http.Client{
	Timeout: 5 * time.Second,
	CheckRedirect: func(req *http.Request, via []*http.Request) error {
		return http.ErrUseLastResponse
	},
}

const maxResponseBytes = 1024 * 1024

func handler(w http.ResponseWriter, r *http.Request) {
	if r.Method != http.MethodGet {
		w.Header().Set("Allow", http.MethodGet)
		http.Error(w, "Method not allowed", http.StatusMethodNotAllowed)
		return
	}
	req, err := http.NewRequestWithContext(r.Context(), http.MethodGet, backendURL, nil)
	if err != nil {
		http.Error(w, "Invalid backend configuration", http.StatusInternalServerError)
		return
	}
	if r.Header.Get("traceparent") != "" {
		for _, name := range []string{"traceparent", "tracestate"} {
			if value := r.Header.Get(name); value != "" {
				req.Header.Set(name, value)
			}
		}
	}
	resp, err := downstreamClient.Do(req)
	if err != nil {
		status := http.StatusBadGateway
		var networkError net.Error
		if errors.As(err, &networkError) && networkError.Timeout() {
			status = http.StatusGatewayTimeout
		}
		http.Error(w, "Upstream request failed", status)
		return
	}
	defer resp.Body.Close()
	if resp.StatusCode >= 300 && resp.StatusCode < 400 {
		http.Error(w, "Unexpected upstream redirect", http.StatusBadGateway)
		return
	}
	body, err := io.ReadAll(io.LimitReader(resp.Body, maxResponseBytes+1))
	if err != nil || len(body) > maxResponseBytes {
		http.Error(w, "Invalid or oversized upstream response", http.StatusBadGateway)
		return
	}
	contentType := resp.Header.Get("Content-Type")
	if contentType == "" {
		contentType = "application/octet-stream"
	}
	w.Header().Set("Content-Type", contentType)
	w.WriteHeader(resp.StatusCode)
	_, _ = w.Write(body)
}
Esto propaga la cancelación de la solicitud, limita la llamada del cliente, comprueba los errores antes de utilizar una respuesta y reenvía el estado y el cuerpo del backend. Ambos ejemplos rechazan deliberadamente las redirecciones y las respuestas demasiado grandes. Las pruebas locales ejercitan estas vías; no demuestran rastreo, ingestión, muestreo ni comportamiento bajo carga en producción.
Confirme que una traza muestreada conocida llega al backend con los spans de proxy y aplicación esperados. Que un panel de trazas se abra correctamente no demuestra propagación del contexto, muestreo correcto ni trazas completas.
Registros de diagnóstico y de acceso
El nivel y el formato del registro de diagnóstico del proxy y el registro de acceso HTTP son ajustes independientes. Guarde este parche de combinación para un Deployment existente en la malla como proxy-logging-patch.yaml; no es un manifiesto de Deployment independiente:
spec:
  template:
    metadata:
      labels:
        mesh-required: 'true'
      annotations:
        config.linkerd.io/access-log: json
        config.linkerd.io/proxy-log-format: json
config.linkerd.io/proxy-log-level: warn,linkerd=info# This changes the existing workload's Pod template and triggers its rollout.
kubectl -n my-app patch deployment/api --type merge --patch-file proxy-logging-patch.yaml
kubectl -n my-app rollout status deployment/api --timeout=5m
kubectl -n my-app logs deployment/api -c linkerd-proxy --tail=100config.linkerd.io/access-log:json habilita los registros de acceso HTTP. proxy-log-format:json solo cambia el formato del diagnóstico. Evite el registro indiscriminado de depuración, trazas o cabeceras; limite la recopilación de diagnósticos y el tratamiento de datos a la investigación. Estos ajustes no convierten el tráfico TCP opaco en un registro de solicitudes HTTP.
La etiqueta de Pod mesh-required:true marca la carga de trabajo como una que requiere deliberadamente un proxy sano para la alerta siguiente; no realiza la inyección. La incorporación sigue obedeciendo a la política de instalación y del namespace.
Métricas de rutas de ServiceProfile y de políticas
Los ServiceProfiles siguen siendo compatibles por motivos de compatibilidad. Añadir uno puede anular los ajustes actuales de fiabilidad del HTTPRoute de salida para ese Service; no añada un perfil en conflicto únicamente para que un panel parezca tener datos.
Para un ejercicio independiente de métricas heredadas sobre un api-service existente, este perfil añade nombres de rutas sin habilitar reintentos:
apiVersion: linkerd.io/v1alpha2
kind: ServiceProfile
metadata:
  name: api-service.my-app.svc.cluster.local
  namespace: my-app
spec:
  routes:
  - name: GET /api/users
    condition:
      all:
      - method: GET
      - pathRegex: ^/api/users$
    isRetryable: false
  - name: POST /api/orders
    condition:
      all:
      - method: POST
      - pathRegex: ^/api/orders$
    isRetryable: false
  - name: GET /health
    condition:
      all:
      - method: GET
      - pathRegex: ^/health$
    isRetryable: false
Las condiciones all explícitas aclaran la coincidencia de método y ruta. Las rutas de perfil, las métricas de políticas HTTPRoute y las rutas arbitrarias de la aplicación son vistas diferentes:
linkerd viz routes service/api-service -n my-app
linkerd viz routes deploy/web -n my-app --to svc/api-service --time-window 10m
linkerd viz stat httproute/api-inbound -n my-app
linkerd viz authz deploy/api -n my-app
El ejemplo de HTTPRoute presupone una ruta de entrada existente vinculada a un Server. viz routes es la vista de ServiceProfile; no es una lista universal de todas las rutas de Gateway API.
Para las llamadas de salida desde web, conserve tanto las etiquetas de destino como las de ruta al agregar:
(sum by (dst, rt_route) (rate(route_response_total{namespace="my-app",deployment="web",direction="outbound",classification="success"}[5m]))
 or on(dst, rt_route) (0 * sum by (dst, rt_route) (rate(route_response_total{namespace="my-app",deployment="web",direction="outbound"}[5m])))) / sum by (dst, rt_route) (rate(route_response_total{namespace="my-app",deployment="web",direction="outbound"}[5m]))
and on(dst, rt_route) (sum by (dst, rt_route) (rate(route_response_total{namespace="my-app",deployment="web",direction="outbound"}[5m])) > 0)histogram_quantile(0.99, sum by (le, dst, rt_route) (rate(route_response_latency_ms_bucket{namespace="my-app",deployment="web",direction="outbound"}[5m])))sum by (dst, rt_route) (rate(route_request_total{namespace="my-app",deployment="web",direction="outbound"}[5m]))El numerador cero alineado conserva una ruta en la que todo falla en vez de descartarla. Agrupar solo por nombre de ruta podría combinar Services no relacionados con la misma etiqueta de ruta.
Alertas e investigación
El siguiente PrometheusRule supone que sus etiquetas de selector son aceptadas, que se recopilan los trabajos de Linkerd mostrados y que kube-state-metrics expone etiquetas de Pods además de las métricas de ejecución tanto de contenedores normales como de inicialización. Habilite la etiqueta de Pod mesh-required en su lista de etiquetas de métricas permitidas; de lo contrario, el selector de Pods previstos no tendrá datos.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: linkerd-alerts
  namespace: monitoring
  labels:
    release: monitoring
spec:
  groups:
  - name: linkerd
    rules:
    - alert: LinkerdAPIHighErrorRate
      expr: |-
        (((sum(rate(response_total{namespace="my-app",deployment="api",direction="inbound",classification="failure"}[5m])) or vector(0)) / sum(rate(response_total{namespace="my-app",deployment="api",direction="inbound"}[5m])))
        and on() (sum(rate(response_total{namespace="my-app",deployment="api",direction="inbound"}[5m])) > 0)) > 0.05
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: API proxy-classified response error ratio exceeds 5%
    - alert: LinkerdAPIHighTTFB
      expr: histogram_quantile(0.99, sum by (le) (rate(response_latency_ms_bucket{namespace="my-app",deployment="api",direction="inbound"}[5m])))
        > 1000
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: API p99 time-to-first-byte exceeds 1000ms
    - alert: LinkerdExpectedProxyNotRunning
      expr: |-
        max by (namespace, pod) (
          (kube_pod_status_phase{namespace="my-app",phase="Running"} == 1)
          and on(namespace, pod) kube_pod_labels{namespace="my-app",label_mesh_required="true"}
        )
        unless on(namespace, pod) max by (namespace, pod) (
          (kube_pod_container_status_running{namespace="my-app",container="linkerd-proxy"} == 1)
          or (kube_pod_init_container_status_running{namespace="my-app",container="linkerd-proxy"} == 1)
        )
      for: 10m
      labels:
        severity: warning
      annotations:
        summary: Expected proxy is not running for {{ $labels.namespace }}/{{ $labels.pod }}
    - alert: LinkerdScrapeTargetDown
      expr: up{job=~"linkerd-proxy|linkerd-controller"} == 0
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: A discovered Linkerd metrics target cannot be scraped
La alerta del proxy comprueba Pods previstos en ejecución sin un proxy en ejecución, no simplemente la presencia de inyección. Contempla tanto sidecars normales como sidecars nativos de inicialización e ignora los Pods que no estén marcados como dependientes de la malla. La ausencia de recopilación de kube-state-metrics puede aun así eliminar el inventario esperado; supervise la salud de la recopilación por separado.
El umbral de latencia es de 1000ms de TTFB, no de duración total de la solicitud. Los umbrales de error basados en clasificación deben ajustarse a su SLI. up == 0 detecta destinos descubiertos que fallan, no todos los destinos ausentes del descubrimiento.
Inicie una investigación validando la salud de la recopilación y el alcance del tráfico seleccionado. Después compare estadísticas de cargas de trabajo y Services, inspeccione las rutas pertinentes, utilice observaciones limitadas de Tap y registros, y compruebe la identidad y las políticas cuando corresponda. Diagnostique y corrija la causa, luego reproduzca la solicitud y verifique la recuperación. Una secuencia de comandos de diagnóstico por sí sola no resuelve un incidente.
Referencias y próximos pasos
- Múltiples clústeres, buenas prácticas, cuestionario de observabilidad
- Panel, exportación de métricas, Grafana
- Métricas del proxy y configuración del proxy
- Rastreo
- Implementación publicada del momento de registro de las métricas
- Configuración publicada de recopilación de Viz
- Colección publicada de paneles de Grafana
- Métricas de Pods de kube-state-metrics
- Contexto de traza W3C