Programación, preemption y eviction de Kubernetes
Versiones compatibles: Kubernetes 1.34 - 1.36 (ejemplo de Descheduler v0.36) Última actualización: September 17, 2026
En Kubernetes, la programación es el proceso de colocar pods en nodos adecuados. La preemption es el proceso de eliminar pods de menor prioridad para dejar espacio a pods de mayor prioridad, y la eviction termina un Pod; su controlador de carga de trabajo puede crear un reemplazo que el scheduler coloca por separado. En este capítulo, aprenderemos sobre los mecanismos de programación de Kubernetes, la selección de nodos, la preemption, la eviction y los métodos de optimización de programación en Amazon EKS.
Configuración del entorno de laboratorio
Para seguir los ejemplos de este documento, necesita las siguientes herramientas y entorno:
Herramientas necesarias
- kubectl dentro de una versión secundaria del servidor de API
- Un clúster de Kubernetes funcional (EKS, minikube, kind, etc.)
- Un clúster con varios nodos (para pruebas de programación)
Configuración del ejemplo de programación
# Create namespace
kubectl create namespace scheduling-demo

# Add labels to nodes (if you have multiple nodes)
kubectl label nodes <node-name> disktype=ssd
kubectl label nodes <node-name> gpu=true

# Create a pod using node affinity
kubectl -n scheduling-demo apply -f - <<EOF
apiVersion: v1
kind: Pod
metadata:
  name: nginx-ssd
  labels:
    app: nginx
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: disktype
            operator: In
            values:
            - ssd
  containers:
  - name: nginx
    image: nginx
EOF

# Create priority class
kubectl apply -f - <<EOF
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical service pods only."
EOF

# Create Pod Disruption Budget (PDB)
kubectl -n scheduling-demo apply -f - <<EOF
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: nginx-pdb
spec:
  minAvailable: 1
  selector:
    matchLabels:
      app: nginx
EOF
Arquitectura de programación de Kubernetes
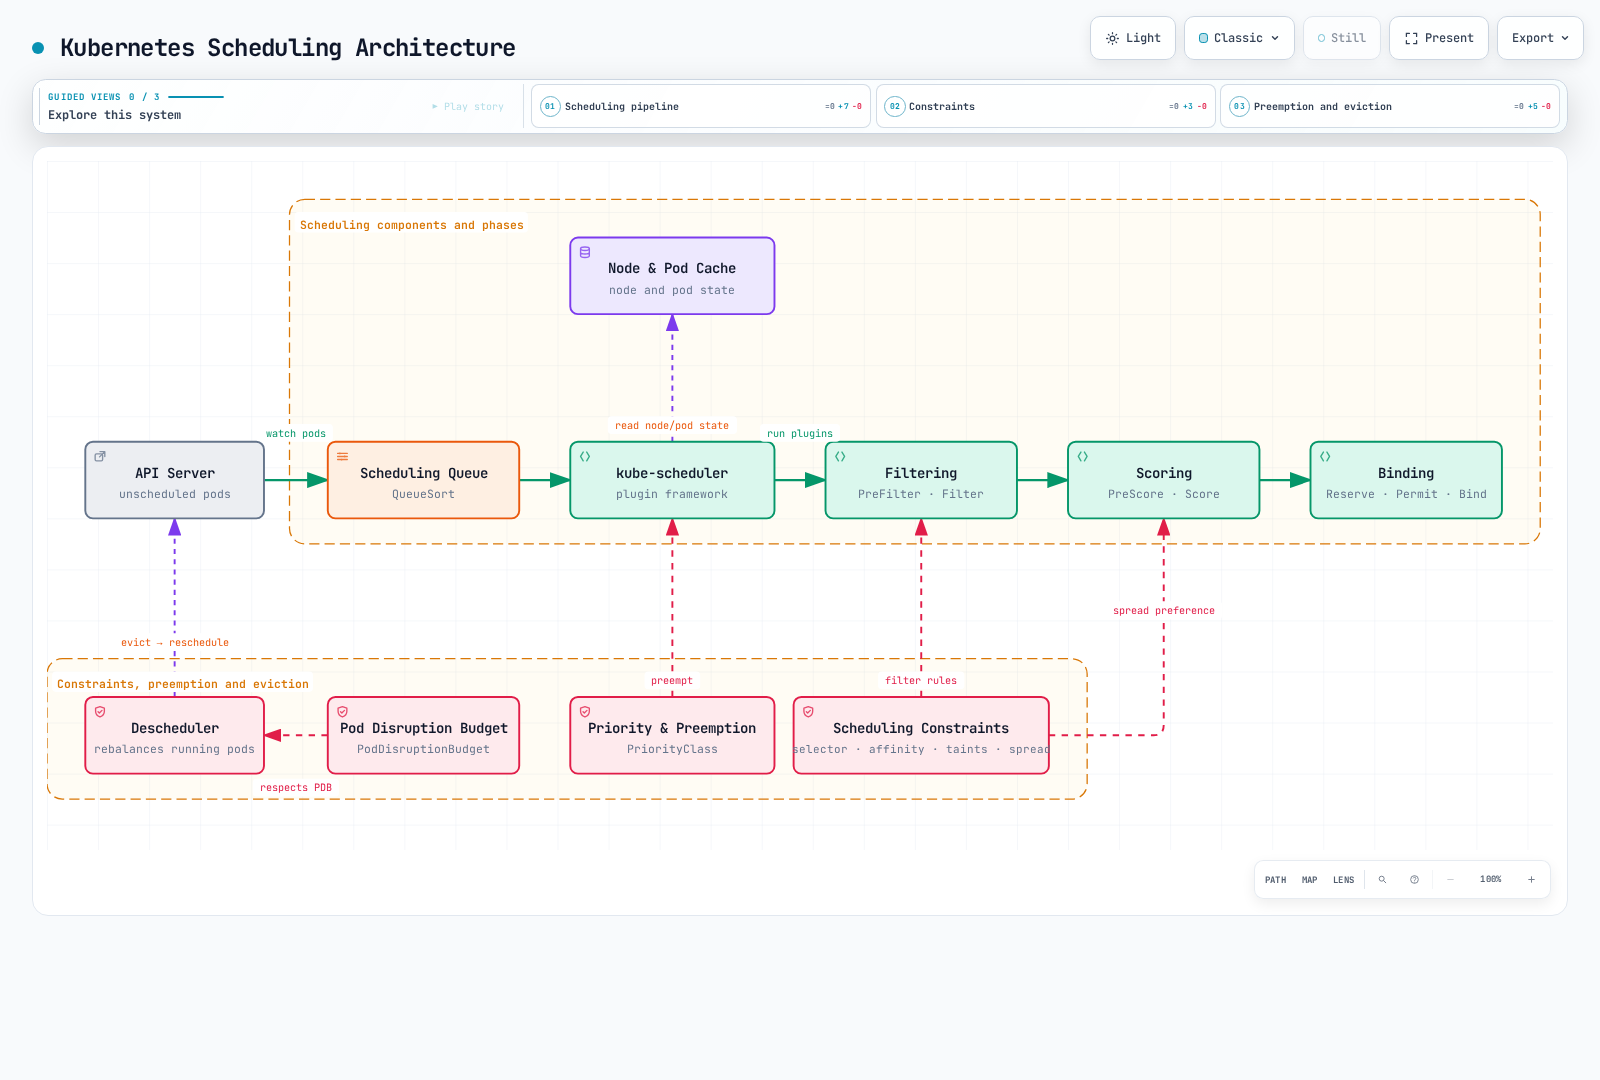
Comparación de conceptos de programación
| Concepto | Propósito | Casos de uso | Versión de Kubernetes |
|---|---|---|---|
| Node Selector | Colocar pods en nodos con etiquetas específicas | Selección simple de nodos | Todas las versiones |
| Node Affinity | Definir reglas complejas de selección de nodos | Selección avanzada de nodos | 1.6+ |
| Pod Affinity | Colocar pods cerca de otros pods | Ubicar conjuntamente servicios relacionados | 1.6+ |
| Pod Anti-Affinity | Colocar pods lejos de otros pods | Garantizar alta disponibilidad | 1.6+ |
| Taints and Tolerations | Permitir solo pods específicos en nodos | Nodos dedicados, aislamiento de nodos | 1.6+ |
| Topology Spread Constraints | Distribuir pods entre dominios de topología | Distribución entre zonas de disponibilidad | 1.16+ (GA en 1.19) |
| Priority and Preemption | Priorizar cargas de trabajo importantes | Garantías para servicios críticos | 1.8+ (GA en 1.11) |
| Pod Disruption Budget | Limitar los pods interrumpidos simultáneamente | Garantizar alta disponibilidad | 1.4+ (GA en 1.21) |
Conceptos básicos de programación
Concepto clave: El scheduler de Kubernetes es un componente del plano de control que selecciona el nodo óptimo para ejecutar pods y opera en dos fases: filtrado y puntuación.
Proceso de programación
Fase de filtrado (Predicates)
- Identifica un conjunto adecuado de nodos que pueden ejecutar el pod
- Considera requisitos de recursos, selectores de nodos, reglas de affinity, taints/tolerations, etc.
- Excluye un nodo si no se cumple alguna condición
Fase de puntuación (Priorities)
- Asigna puntuaciones a los nodos que superaron el filtrado
- Considera utilización de recursos, distribución de pods, preferencias de affinity, etc.
- Selecciona el nodo con la puntuación más alta
Fase de asociación (Binding)
- Asigna el pod al nodo seleccionado
- Actualiza la información de asociación en el servidor de API
Tabla de contenidos
- Descripción general de programación
- Cómo funciona el scheduler
- Selección de nodos
- Pod Affinity y Anti-Affinity
- Taints and Tolerations
- Node Affinity
- Prioridad y preemption de Pod
- Pod Eviction
- Pod Disruption Budget (PDB)
- Node Pressure Eviction
- TopologySpreadConstraints
- Costo de eliminación de Pod
- Descheduler
- Optimización de programación en Amazon EKS
- Prácticas recomendadas de programación
- Conclusión
Descripción general de programación
El scheduler de Kubernetes es un componente del plano de control que coloca pods en nodos adecuados. El scheduler considera diversos factores para determinar el nodo óptimo donde colocar pods:
- Requisitos de recursos: CPU, memoria y otros recursos solicitados por el pod
- Restricciones de hardware/software/políticas: Selectores de nodos, node affinity, taints, etc.
- Especificaciones de affinity/anti-affinity: Relaciones de colocación con otros pods
- Localidad de datos: Colocar pods cerca de los datos
- Interferencia entre cargas de trabajo: Minimizar la interferencia entre distintas cargas de trabajo
- Objetivos personalizados: La programación basada en fechas límite o consciente de la interferencia entre cargas de trabajo requiere lógica personalizada adecuada; el scheduler predeterminado no infiere las fechas límite de la aplicación
Proceso de programación
El proceso de programación se divide, en términos generales, en dos fases:
Filtrado: Identifica un conjunto de nodos que pueden ejecutar el pod
- Comprueba si se cumplen los requisitos de recursos
- Comprueba restricciones como selectores de nodos, affinity y taints
Puntuación: Puntúa los nodos filtrados para seleccionar el nodo óptimo
- Equilibrio de utilización de recursos
- Affinity/anti-affinity entre pods
- Localidad de datos
- Taints/tolerations
Cómo funciona el scheduler
El scheduler de Kubernetes opera mediante el siguiente proceso:
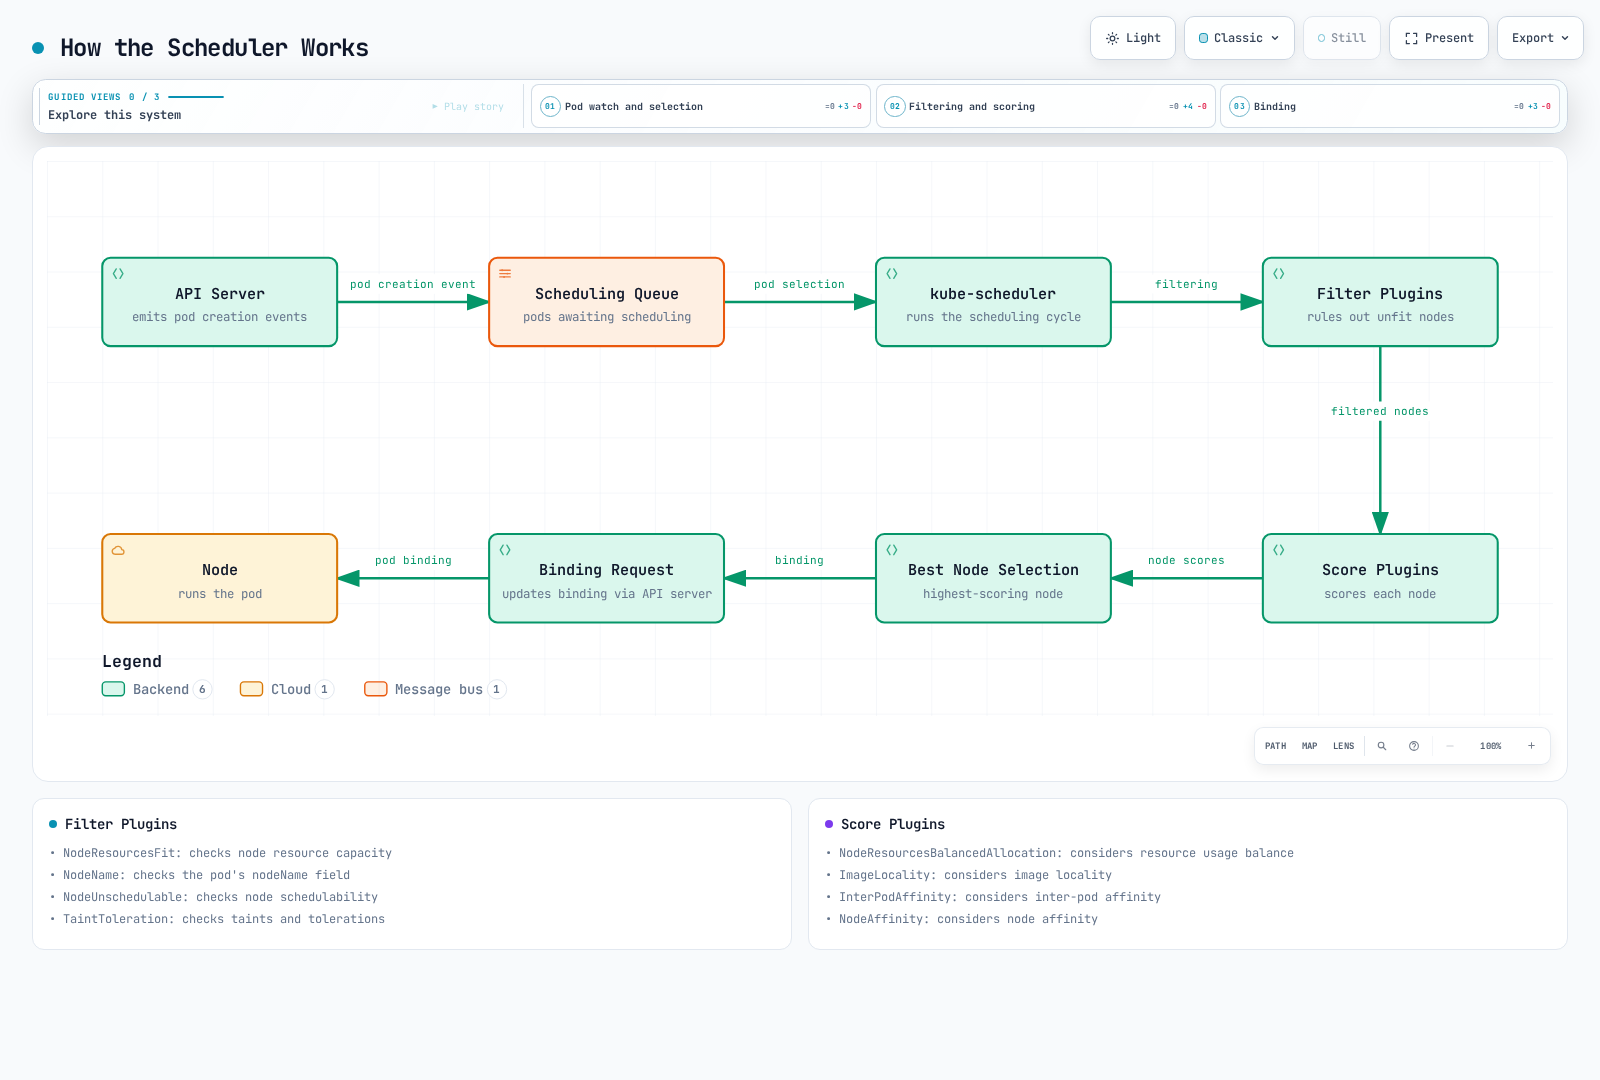
- Observación de la cola de Pods: El scheduler observa el servidor de API en busca de pods sin programar.
- Filtrado de nodos: Identifica un conjunto de nodos que pueden ejecutar el pod.
- Puntuación de nodos: Puntúa los nodos filtrados.
- Selección de nodos: Selecciona el nodo con la puntuación más alta.
- Asociación: Asocia el pod al nodo seleccionado.
Plugins de programación
El scheduler de Kubernetes está diseñado para ser extensible mediante una arquitectura de plugins. Varios plugins operan en distintas etapas del proceso de programación:
Plugins de filtro: Filtran los nodos donde el pod no puede ejecutarse
- NodeResourcesFit: Comprueba la capacidad de recursos del nodo
- NodeName: Comprueba el campo nodeName del pod
- NodeUnschedulable: Comprueba la programabilidad del nodo
- TaintToleration: Comprueba taints y tolerations
Plugins de puntuación: Asignan puntuaciones a los nodos
- NodeResourcesBalancedAllocation: Considera el equilibrio del uso de recursos
- ImageLocality: Considera la localidad de la imagen
- InterPodAffinity: Considera la affinity entre pods
- NodeAffinity: Considera la node affinity
Estrategia de puntuación de NodeResourcesFit: LeastAllocated frente a MostAllocated
NodeResourcesFit es tanto un plugin de filtro (¿el nodo tiene suficiente CPU/memoria asignable para el pod?) como un plugin de puntuación. El comportamiento de su plugin de puntuación se controla mediante scoringStrategy.type, configurado a través de KubeSchedulerConfiguration:
LeastAllocated(predeterminado): otorga mayor puntuación a los nodos cuanto menos asignados estén. Los nuevos pods se dirigen hacia los nodos más vacíos, distribuyendo la carga de forma uniforme.MostAllocated: otorga mayor puntuación a los nodos cuanto más asignados estén (siempre que el pod aún quepa). Los nuevos pods se empaquetan primero en los nodos con mayor carga, dejando otros nodos sin tocar o vacíos.RequestedToCapacityRatio: una curva configurable entre las dos opciones, útil para recursos extendidos como GPU cuando desea una forma personalizada en lugar de un mínimo/máximo puro.
apiVersion: kubescheduler.config.k8s.io/v1
kind: KubeSchedulerConfiguration
profiles:
- schedulerName: most-allocated-scheduler
  pluginConfig:
  - name: NodeResourcesFit
    args:
      scoringStrategy:
        type: MostAllocated
        resources:
        - name: cpu
          weight: 1
        - name: memory
          weight: 1
El plano de control de Amazon EKS está totalmente administrado, por lo que no puede editar directamente el KubeSchedulerConfiguration del kube-scheduler predeterminado. Para usar MostAllocated, ejecute un segundo scheduler (un Deployment que ejecute el binario kube-scheduler con esta configuración, asociado a system:kube-scheduler/system:volume-scheduler mediante un ServiceAccount dedicado) y dirija pods específicos hacia él con spec.schedulerName, como se muestra en Multiple Schedulers más adelante; es el mismo patrón utilizado en Building a Custom Scheduler.
Prueba verificada — comportamiento de distribución frente a bin-packing. Para confirmar la diferencia práctica, un clúster kind desechable de 3 workers (kubectl version v1.37.0, aislado y eliminado después de la prueba; no se modificó infraestructura compartida) se inicializó con carga base desigual usando pods de relleno fijados mediante nodeName (16 CPU asignables por nodo): worker=12 pods (75 %), worker2=6 pods (37 %), worker3=0 pods (0 %). A continuación, se programaron seis pods idénticos de 1 CPU dos veces —una con el scheduler predeterminado (LeastAllocated) y otra con un segundo scheduler configurado con MostAllocated— respecto al mismo estado inicial:
| Scheduler / estrategia | Dónde llegaron los 6 nuevos pods | Utilización final de CPU (worker / worker2 / worker3) |
|---|---|---|
Predeterminado (LeastAllocated) | Los 6 en worker3 (el nodo más vacío) | 75 % / 37 % / 37 % — los tres nodos ahora están ocupados |
MostAllocated | 3 en worker, 3 en worker2 (los dos nodos con mayor carga) | 93 % / 56 % / 0 % — worker3 permaneció completamente inactivo |
LeastAllocated elevó worker3 hasta igualarlo con worker2, por lo que todos los nodos quedan parcialmente utilizados y ninguno puede reducirse de forma segura. MostAllocated continuó concentrando la carga en los nodos ya ocupados y dejó worker3 intacto, precisamente el nodo que un clúster autoscaler o una pasada de consolidación de Karpenter terminaría después.
Por este motivo, MostAllocated se recomienda habitualmente para cargas de trabajo de jobs por lotes o de corta duración que se ejecutan junto con Karpenter o Cluster Autoscaler: empaquetar jobs en menos nodos maximiza el número de nodos que quedan completamente inactivos y pasan a ser aptos para consolidación, lo que reduce directamente el coste de cómputo. LeastAllocated sigue siendo la mejor opción predeterminada para servicios de larga ejecución y sensibles a la latencia, ya que distribuir la carga deja margen en cada nodo para absorber picos de tráfico o un kubectl drain sin trasladar presión en cascada a un único nodo empaquetado.
Reproduzca esta comparación exacta usted mismo, paso a paso, en Scheduler Scoring Strategy Lab.
Multiple Schedulers
Kubernetes puede ejecutar varios schedulers simultáneamente. Esto permite implementar lógica de programación personalizada para cargas de trabajo específicas.
apiVersion: v1
kind: Pod
metadata:
  name: custom-scheduled-pod
spec:
  schedulerName: my-custom-scheduler
  containers:
  - name: container
    image: nginx
En el ejemplo anterior, el campo schedulerName especifica el scheduler que programará el pod.
Selección de nodos
Kubernetes proporciona varios mecanismos para colocar pods en nodos específicos.
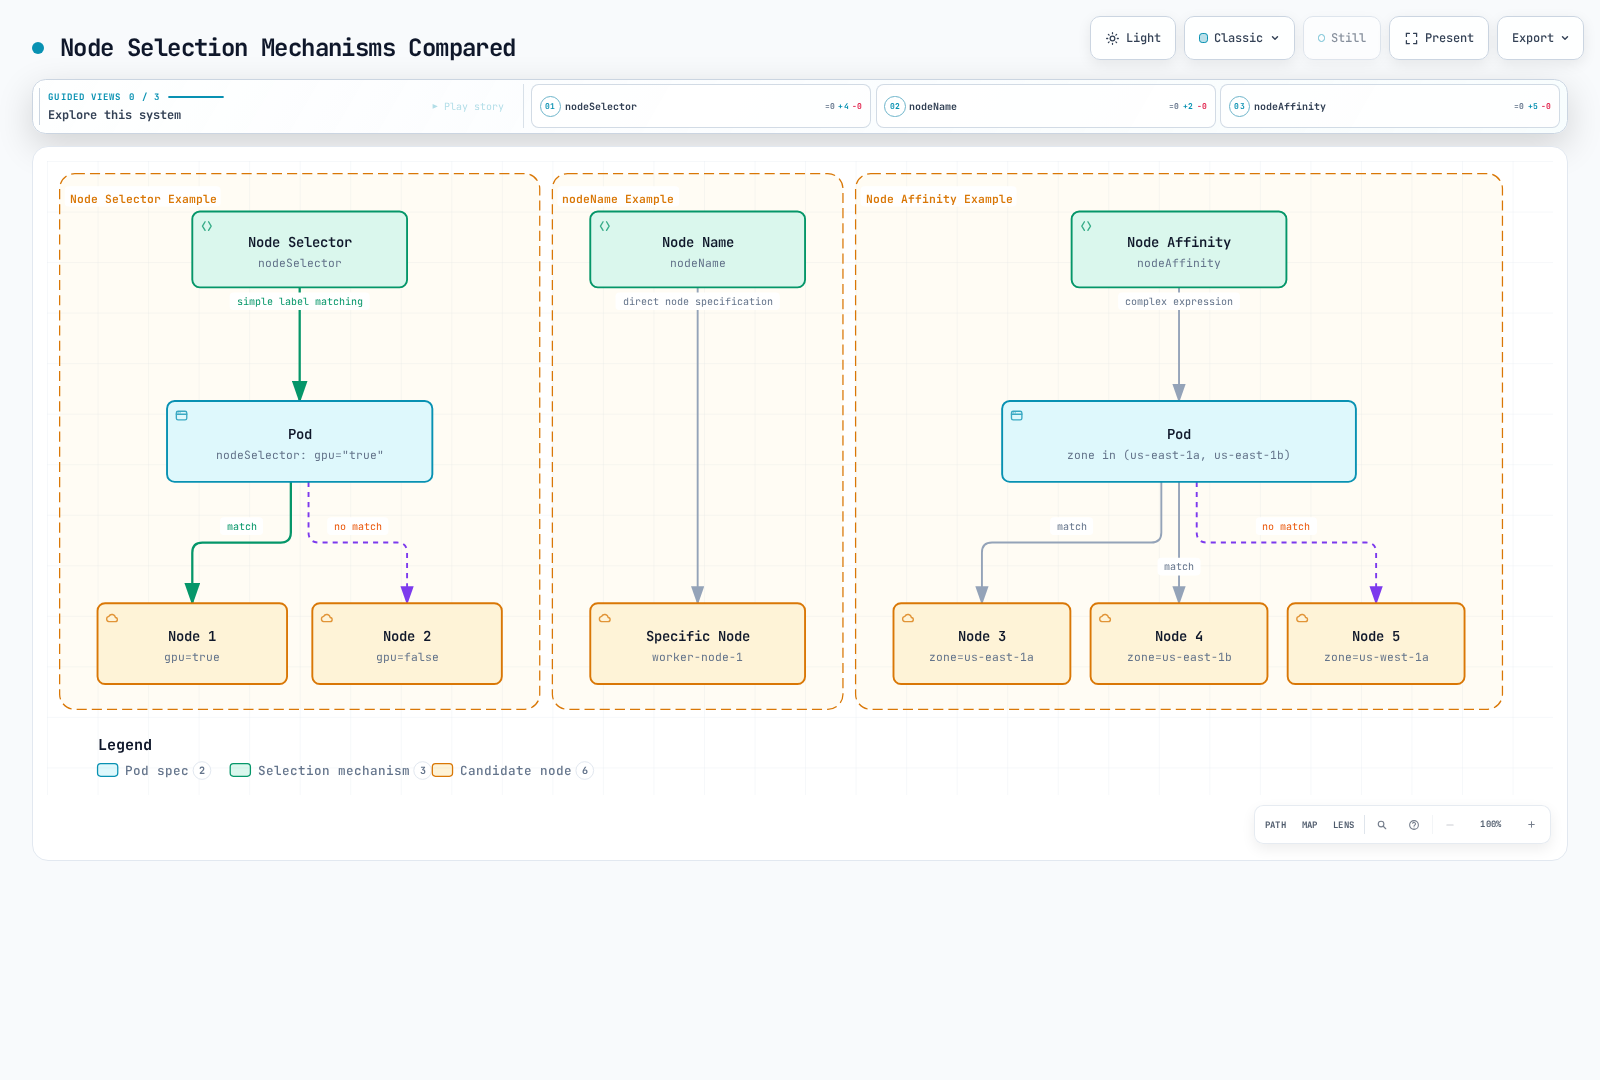
Node Selector
El selector de nodos es la forma más sencilla de restringir los pods para que solo se coloquen en nodos con etiquetas específicas.
apiVersion: v1
kind: Pod
metadata:
  name: gpu-pod
spec:
  nodeSelector:
    gpu: "true"
  containers:
  - name: gpu-container
    image: busybox:1.36
    command: ["sh", "-c", "sleep 3600"]
    resources:
      limits:
        nvidia.com/gpu: 1
En el ejemplo anterior, el pod solo se coloca en nodos con la etiqueta gpu=true.
El ejemplo de GPU solo prueba la programación: el nodo debe tener realmente una GPU y un device plugin funcional que anuncie nvidia.com/gpu. Una etiqueta gpu=true por sí sola no asigna recursos de GPU.
nodeName
Puede usar el campo nodeName para colocar directamente un pod en un nodo específico. Este método omite el scheduler y, en general, no se recomienda.
apiVersion: v1
kind: Pod
metadata:
  name: specific-node-pod
spec:
  nodeName: worker-node-1
  containers:
  - name: container
    image: nginx
En el ejemplo anterior, el pod se coloca directamente en el nodo denominado worker-node-1.
Pod Affinity y Anti-Affinity
Pod affinity y anti-affinity proporcionan formas de colocar pods según las relaciones entre ellos.
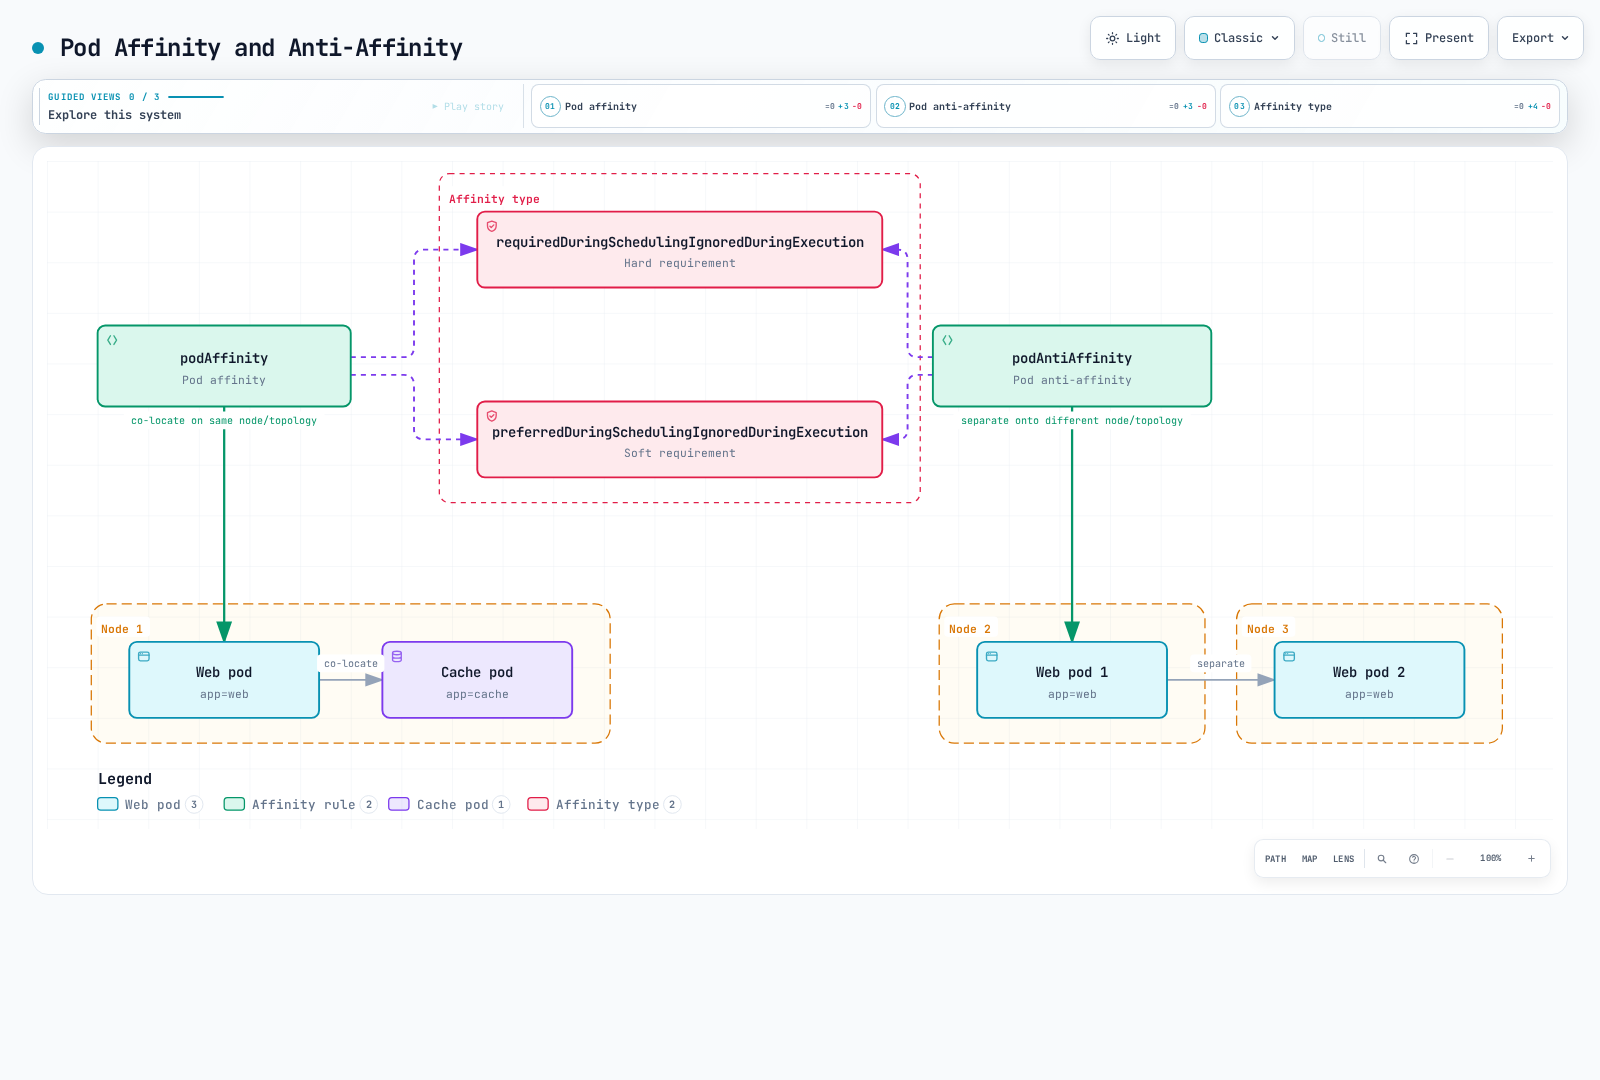
Pod Affinity
Pod affinity hace que los pods se coloquen en el mismo nodo o dominio de topología que los pods con etiquetas específicas.
apiVersion: v1
kind: Pod
metadata:
  name: frontend
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: kubernetes.io/hostname
  containers:
  - name: frontend
    image: nginx
En el ejemplo anterior, el pod frontend se coloca en el mismo host que los pods con la etiqueta app=cache.
Pod Anti-Affinity
Pod anti-affinity hace que los pods se coloquen en un nodo o dominio de topología diferente de los pods con etiquetas específicas.
apiVersion: v1
kind: Pod
metadata:
  name: frontend
  labels:
    app: frontend
spec:
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - frontend
        topologyKey: kubernetes.io/hostname
  containers:
  - name: frontend
    image: nginx
En el ejemplo anterior, el pod frontend se coloca en un host diferente de otros pods con la etiqueta app=frontend. Esto es útil para distribuir instancias de la misma aplicación entre varios nodos para lograr alta disponibilidad.
Tipos de affinity
Pod affinity y anti-affinity tienen dos tipos:
- requiredDuringSchedulingIgnoredDuringExecution: Requisito estricto que debe cumplirse durante la programación
- preferredDuringSchedulingIgnoredDuringExecution: Requisito flexible que se prefiere, pero no es obligatorio
# preferredDuringSchedulingIgnoredDuringExecution example
affinity:
  podAffinity:
    preferredDuringSchedulingIgnoredDuringExecution:
    - weight: 100
      podAffinityTerm:
        labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: kubernetes.io/hostname
En el ejemplo anterior, el campo weight indica el peso de esta preferencia. Cuando hay varias preferencias, las de mayor peso se consideran más importantes.
Taints and Tolerations
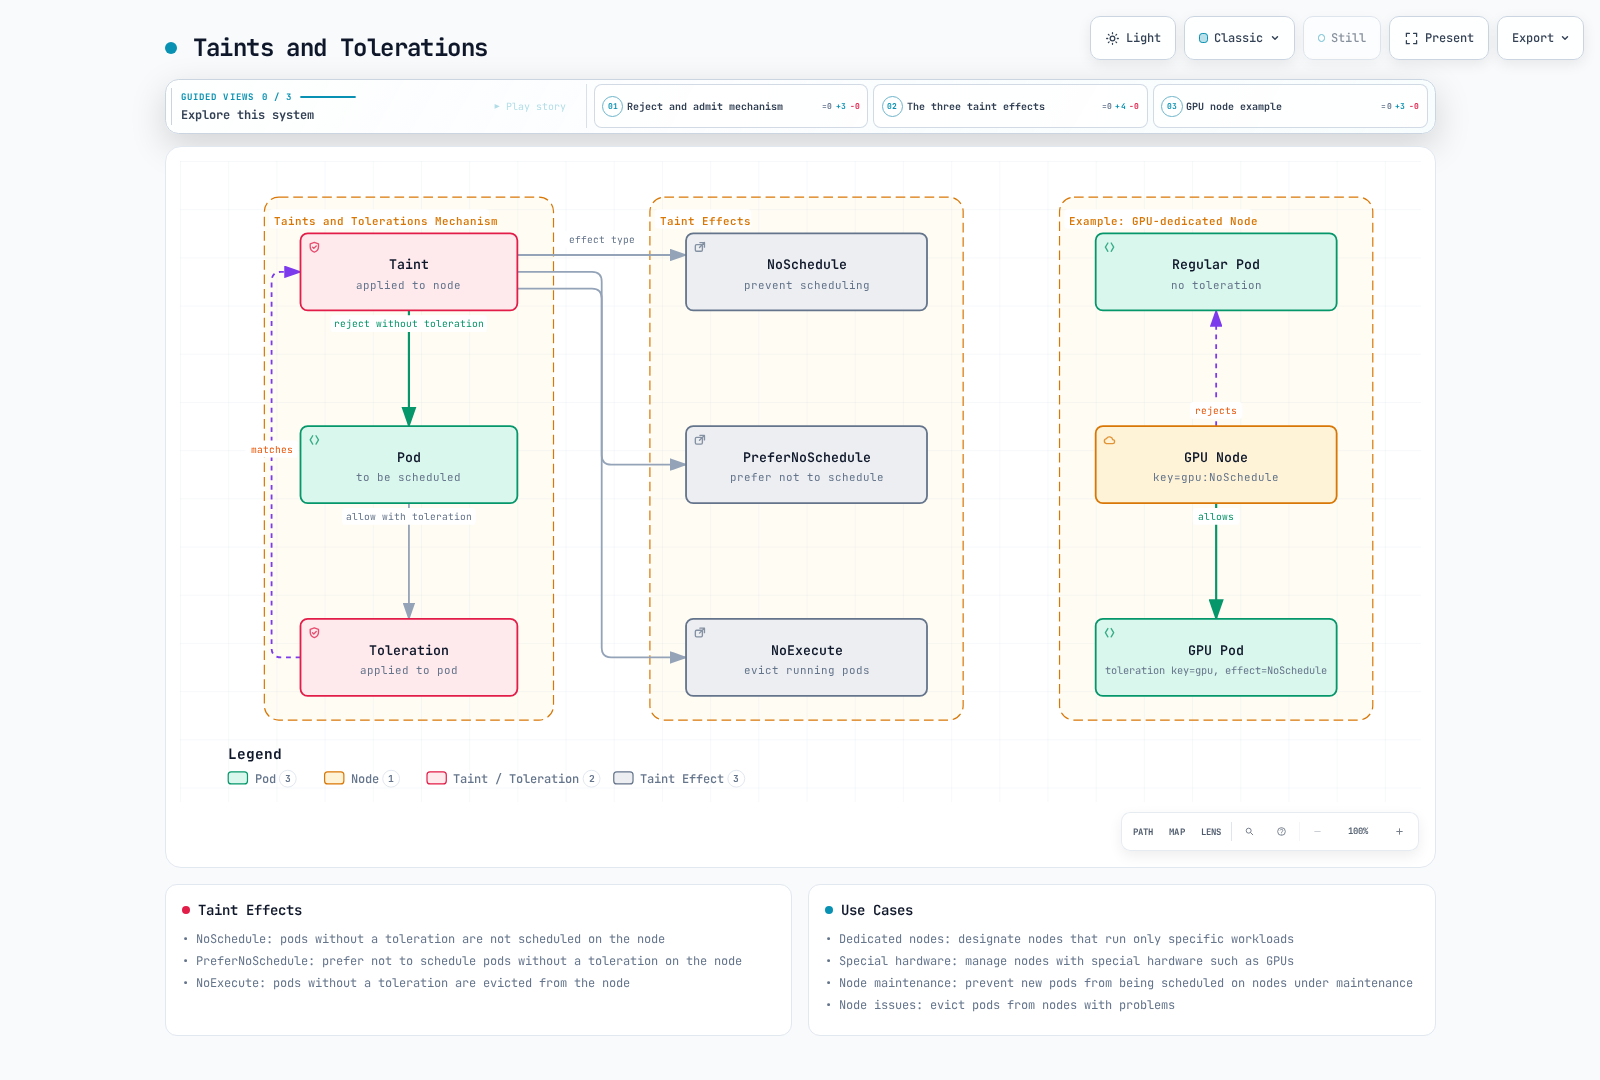
Taints y tolerations son mecanismos que permiten a los nodos rechazar pods específicos.
Taints
Los taints se aplican a los nodos para impedir que los pods se programen en ellos.
# Add taint to node
kubectl taint nodes node1 key=value:NoSchedule
Hay tres efectos de taint:
- NoSchedule: Los Pods sin tolerations no se programan en el nodo
- PreferNoSchedule: Se prefiere no programar en el nodo los Pods sin tolerations
- NoExecute: Los Pods sin tolerations son expulsados del nodo
Tolerations
Las tolerations se aplican a los pods para permitir que se programen en nodos con taints.
apiVersion: v1
kind: Pod
metadata:
  name: nginx
spec:
  tolerations:
  - key: "key"
    operator: "Equal"
    value: "value"
    effect: "NoSchedule"
  containers:
  - name: nginx
    image: nginx
En el ejemplo anterior, el pod puede programarse en nodos con el taint key=value:NoSchedule.
Casos de uso
Casos de uso habituales de taints y tolerations:
- Nodos dedicados: Designar nodos para ejecutar solo cargas de trabajo específicas
- Hardware especial: Administrar nodos con hardware especial como GPU
- Mantenimiento de nodos: Evitar la programación de nuevos pods en nodos en mantenimiento
- Problemas de nodos: Expulsar pods de nodos con problemas
Taints predeterminados
Kubernetes aplica taints predeterminados a algunos nodos:
- node.kubernetes.io/not-ready: El nodo no está listo
- node.kubernetes.io/unreachable: No se puede alcanzar el nodo
- node.kubernetes.io/memory-pressure: El nodo tiene presión de memoria
- node.kubernetes.io/disk-pressure: El nodo tiene presión de disco
- node.kubernetes.io/pid-pressure: El nodo tiene presión de PID
- node.kubernetes.io/network-unavailable: La red del nodo no está disponible
- node.kubernetes.io/unschedulable: El nodo no es programable
Node Affinity
Node affinity proporciona una forma más expresiva de colocar pods en conjuntos específicos de nodos. Permite especificar condiciones más complejas que el selector de nodos.
Tipos de Node Affinity
Node affinity tiene dos tipos:
- requiredDuringSchedulingIgnoredDuringExecution: Requisito estricto que debe cumplirse durante la programación
- preferredDuringSchedulingIgnoredDuringExecution: Requisito flexible que se prefiere, pero no es obligatorio
apiVersion: v1
kind: Pod
metadata:
  name: with-node-affinity
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: topology.kubernetes.io/zone
            operator: In
            values:
            - us-west-2a
            - us-west-2b
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 1
        preference:
          matchExpressions:
          - key: another-node-label-key
            operator: In
            values:
            - another-node-label-value
  containers:
  - name: with-node-affinity
    image: nginx
En el ejemplo anterior, el pod solo se coloca en nodos donde la etiqueta topology.kubernetes.io/zone sea us-west-2a o us-west-2b. Además, se coloca preferentemente en nodos con la etiqueta another-node-label-key=another-node-label-value.
Operadores
Node affinity admite varios operadores:
- In: El valor de la etiqueta coincide con uno de los valores especificados
- NotIn: El valor de la etiqueta no coincide con los valores especificados
- Exists: Existe una etiqueta con la clave especificada
- DoesNotExist: No existe una etiqueta con la clave especificada
- Gt: El valor de la etiqueta es mayor que el valor especificado
- Lt: El valor de la etiqueta es menor que el valor especificado
Prioridad y preemption de Pod
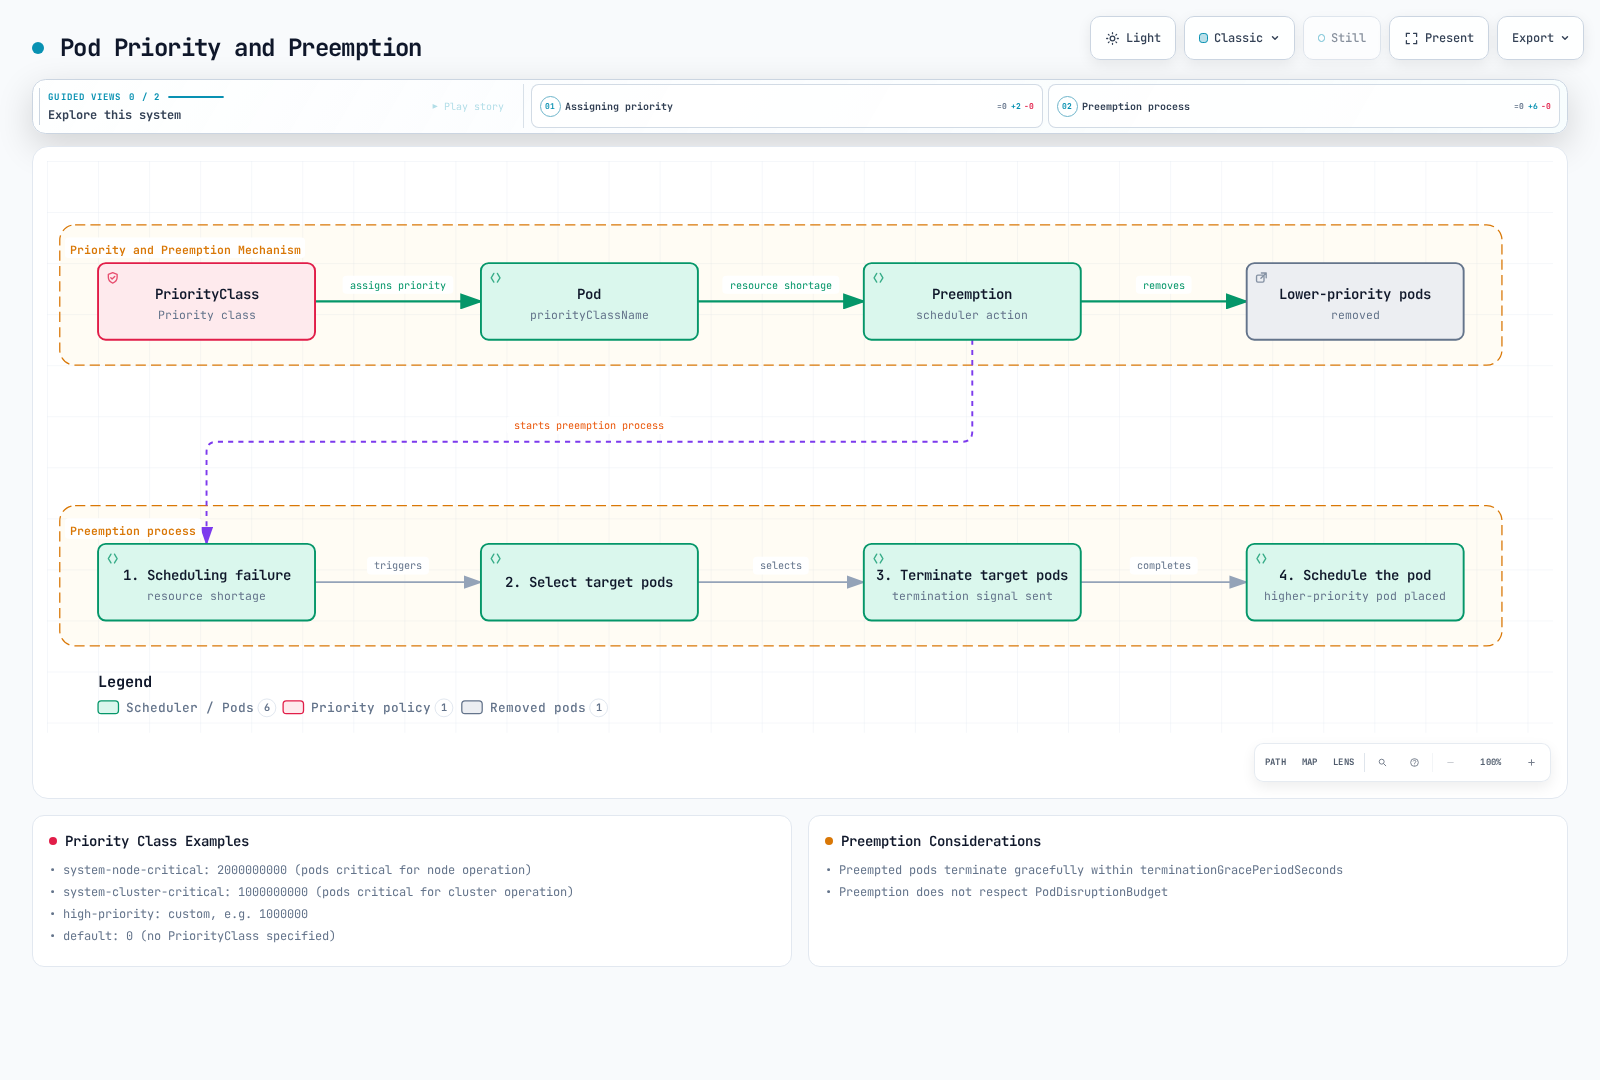
Kubernetes proporciona funciones de prioridad y preemption de pods para garantizar que las cargas de trabajo importantes puedan obtener recursos del clúster.
PriorityClass
PriorityClass define la importancia relativa de los pods. Cuanto mayor sea el valor de prioridad, más importante será el pod.
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical workloads."
En el ejemplo anterior, el campo value indica el valor de prioridad. Cuanto mayor sea el valor, mayor será la prioridad. Si el campo globalDefault se establece en true, esta clase de prioridad se aplica a pods sin una clase de prioridad especificada.
Aplicar PriorityClass a Pods
Para aplicar una clase de prioridad a un pod, use el campo priorityClassName.
apiVersion: v1
kind: Pod
metadata:
  name: high-priority-pod
spec:
  priorityClassName: high-priority
  containers:
  - name: container
    image: nginx
Preemption
La preemption es el proceso de eliminar pods de menor prioridad para programar pods de mayor prioridad. Cuando el scheduler no puede encontrar un nodo donde programar un pod de mayor prioridad, realiza preemption de pods de menor prioridad para obtener recursos.
Proceso de preemption:
- El scheduler no puede encontrar un nodo donde programar un pod de mayor prioridad
- El scheduler selecciona un nodo del que eliminar pods de menor prioridad mediante preemption
- Solicita mediante la API la eliminación de los Pods seleccionados de menor prioridad; kubelet/runtime realizan la terminación
- Cuando los pods terminan correctamente, programa el pod de mayor prioridad en ese nodo
Consideraciones sobre preemption
Aspectos que se deben considerar al usar preemption:
- Período de terminación correcta: Los pods sujetos a preemption pasan por el proceso de terminación correcta durante el tiempo especificado en
terminationGracePeriodSeconds - PodDisruptionBudget: El scheduler intenta evitar infracciones, pero la preemption puede infringir un PDB cuando ningún conjunto adecuado de víctimas lo evita
- Clases de prioridad del sistema: Kubernetes proporciona clases de prioridad para componentes del sistema
system-cluster-critical: Pods críticos para el funcionamiento del clústersystem-node-critical: Pods críticos para el funcionamiento del nodo
Pod Eviction
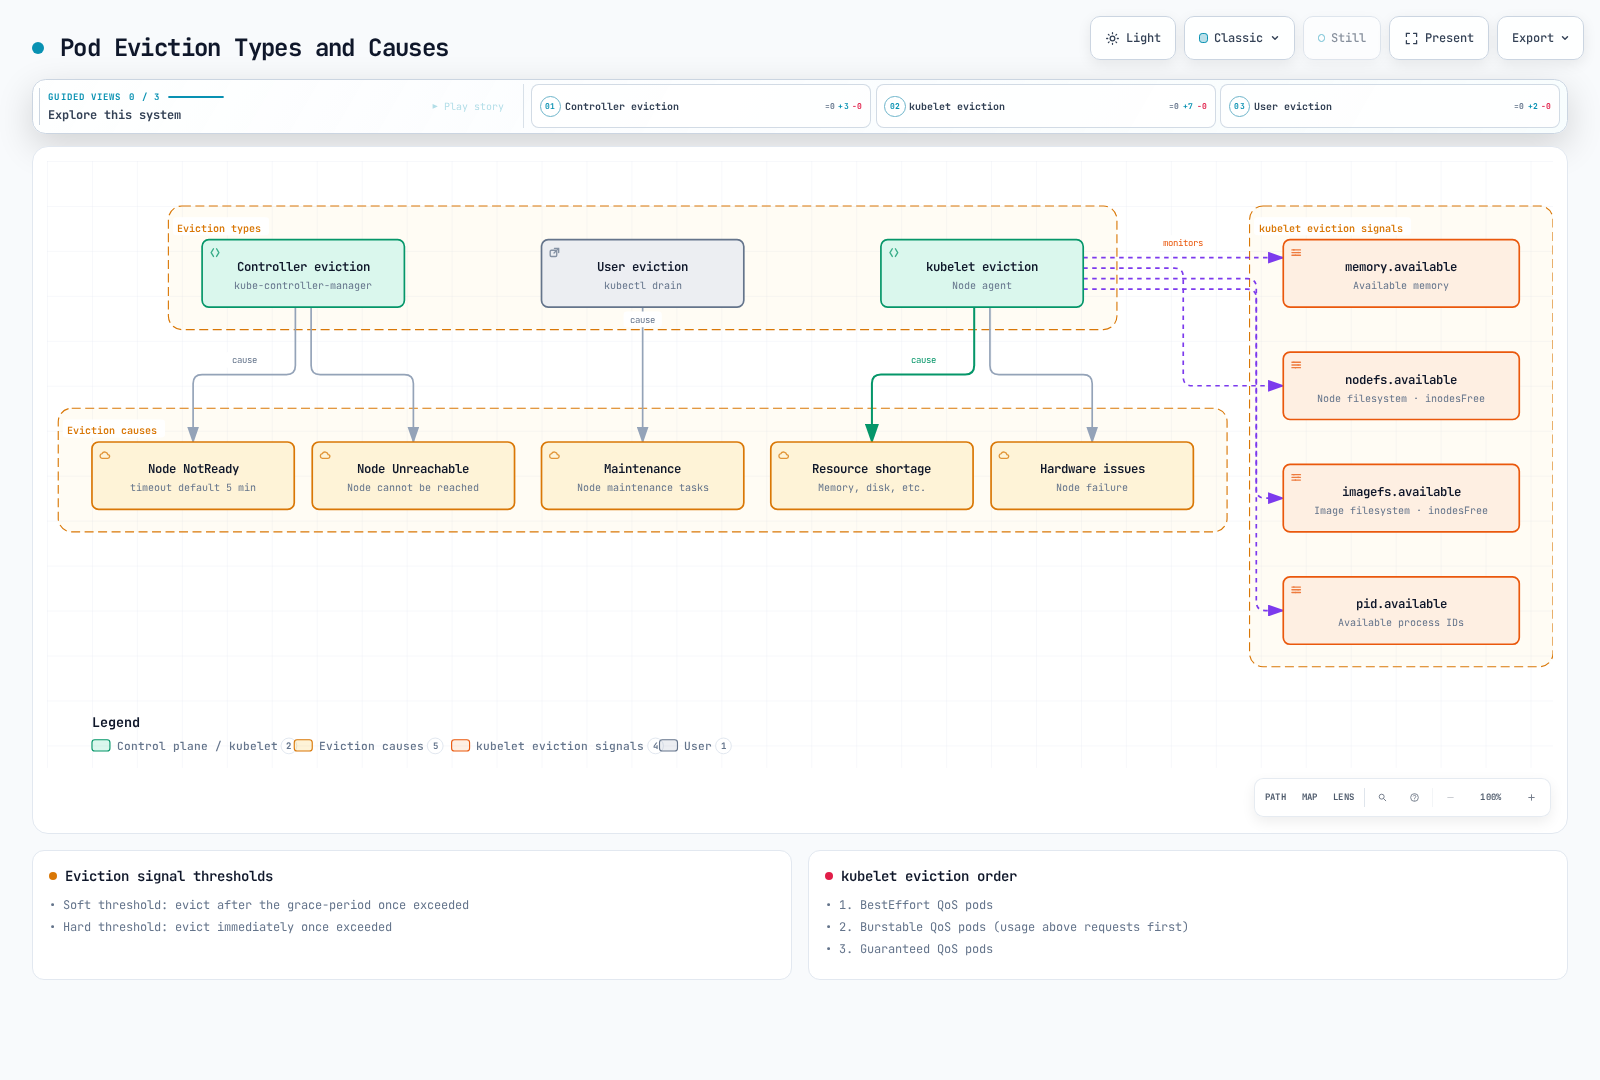
La eviction de Pod termina un Pod; su controlador de carga de trabajo puede crear un reemplazo que el scheduler coloca por separado. La eviction puede producirse por diversos motivos.
Tipos de eviction
Eviction por kube-controller-manager:
- El taint-eviction-controller maneja los taints NoExecute. Los Pods normalmente reciben tolerations de 300 segundos para not-ready/unreachable; la eviction sigue su configuración de toleration
- Cuando un nodo está en estado Unreachable
Eviction por kubelet:
- Escasez de recursos del nodo (memoria, disco, etc.)
- Los fallos de hardware pueden provocar indisponibilidad del nodo; no son una señal genérica de eviction por presión de kubelet
Eviction por el usuario:
- Ejecución del comando
kubectl drain - Tareas de mantenimiento del nodo
- Ejecución del comando
Señales de eviction de kubelet
kubelet supervisa las siguientes señales de eviction:
- memory.available: Memoria disponible
- nodefs.available: Espacio disponible en el sistema de archivos del nodo
- nodefs.inodesFree: Inodos disponibles en el sistema de archivos del nodo
- imagefs.available: Espacio disponible en el sistema de archivos de imágenes
- imagefs.inodesFree: Inodos disponibles en el sistema de archivos de imágenes
- pid.available: ID de procesos disponibles
Se pueden establecer umbrales flexibles y estrictos para cada señal:
- Umbral flexible: Expulsa pods después de
grace-periodcuando se supera el umbral - Umbral estricto: Expulsa pods inmediatamente cuando se supera el umbral
# kubelet configuration example
evictionHard:
  memory.available: "100Mi"
  nodefs.available: "10%"
  nodefs.inodesFree: "5%"
  imagefs.available: "15%"
  imagefs.inodesFree: "5%"
evictionSoft:
  memory.available: "200Mi"
  nodefs.available: "15%"
evictionSoftGracePeriod:
  memory.available: "1m"
  nodefs.available: "2m"
evictionMaxPodGracePeriod: 30
evictionPressureTransitionPeriod: "30s"
Prioridad de eviction
kubelet clasifica los candidatos según si el uso supera las solicitudes, luego según la prioridad de Pod y después según el uso relativo a las solicitudes. No expulsa simplemente primero todos los Pods BestEffort, luego todos los Burstable y finalmente todos los Guaranteed. La presión de disco/PID tiene restricciones de contabilidad diferentes; QoS no es un orden universal de eviction.
Pod Disruption Budget (PDB)
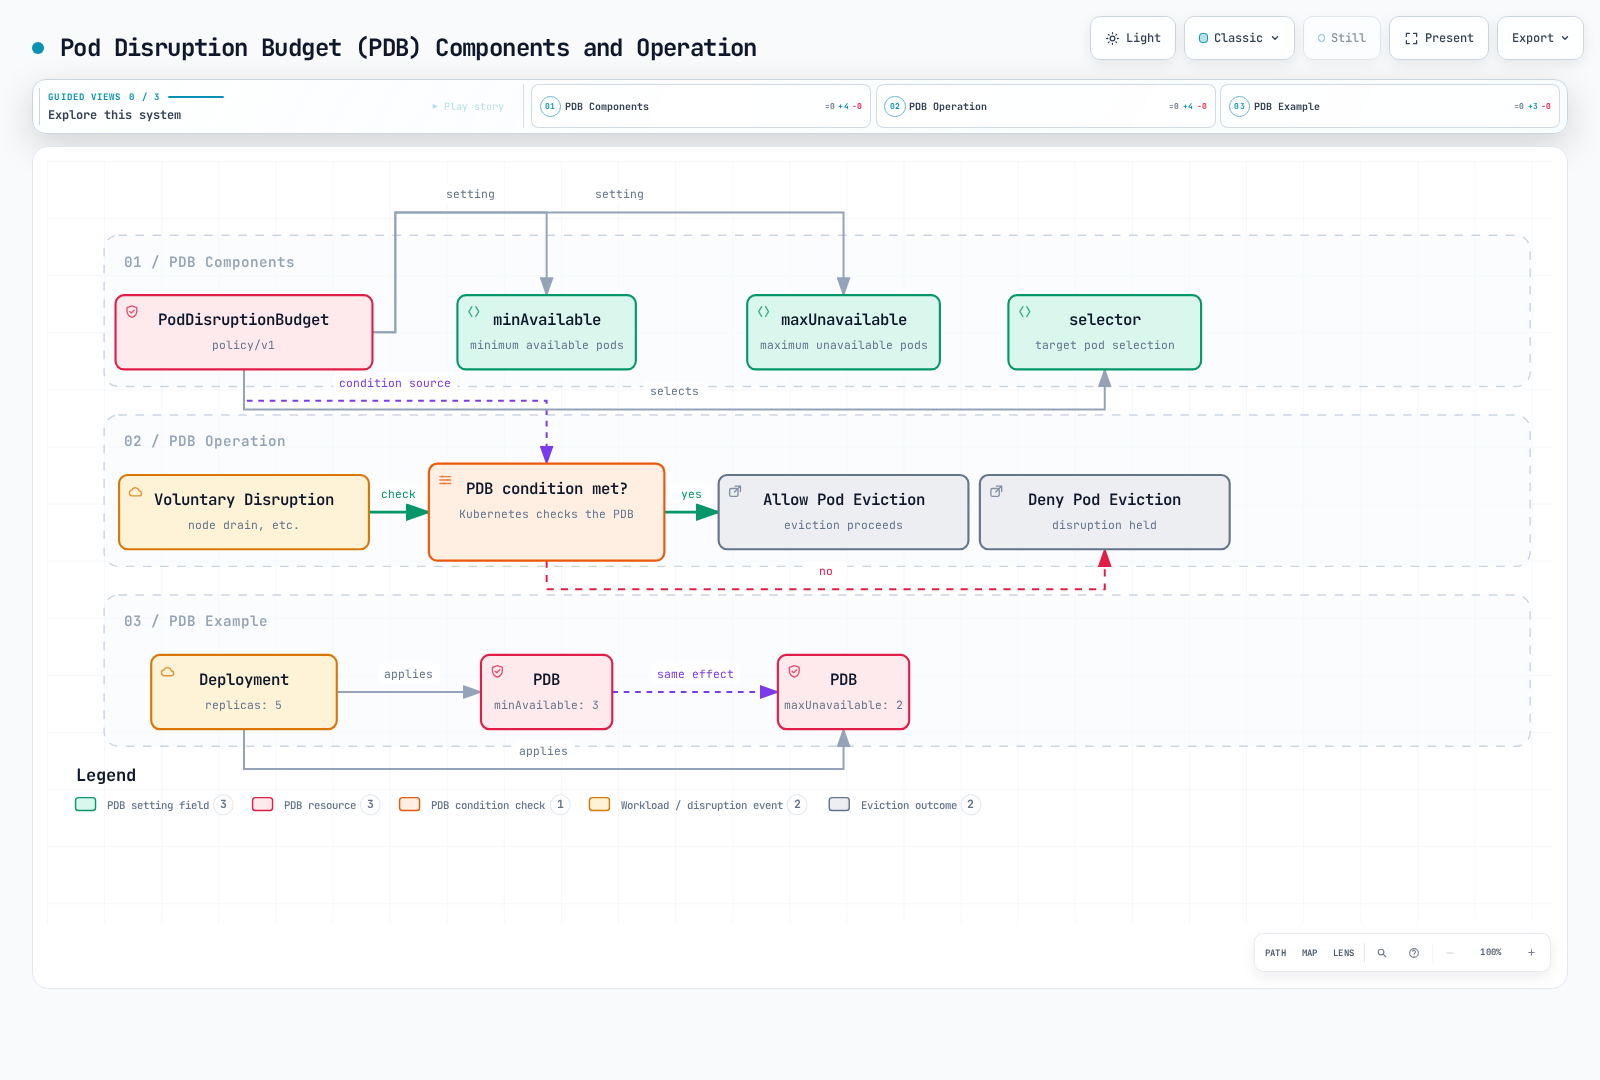
Pod Disruption Budget (PDB) es una forma de mantener la disponibilidad de la aplicación durante interrupciones voluntarias. PDB limita el número de pods que pueden interrumpirse simultáneamente.
Definición de PDB
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: frontend-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: frontend
u
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: frontend-pdb
spec:
  maxUnavailable: 1
  selector:
    matchLabels:
      app: frontend
En los ejemplos anteriores:
minAvailable: Número mínimo de pods que siempre deben estar disponiblesmaxUnavailable: Número máximo de pods que pueden no estar disponibles al mismo tiemposelector: Selector de etiquetas que selecciona los pods a los que se aplica el PDB
Funcionamiento de PDB
- Cuando ocurren interrupciones voluntarias, como el drenaje de nodos, Kubernetes comprueba el PDB
- Si se cumplen las condiciones del PDB, continúa con la eviction de pod
- Si no se cumplen las condiciones del PDB, deniega la eviction de pod
Los PDB controlan las solicitudes de la Eviction API, como las operaciones normales de drain/descheduler. La eliminación directa de Pod, los despliegues de controladores y la eviction por presión de nodo omiten este control. minAvailable: 2 y maxUnavailable: 1 son equivalentes solo para una carga de trabajo con tres réplicas deseadas; ninguno crea capacidad de reemplazo.
Prácticas recomendadas de PDB
- Establezca PDB para todas las cargas de trabajo críticas: Establezca PDB para todas las cargas de trabajo que requieran alta disponibilidad
- Elija valores adecuados: Seleccione valores de
minAvailableomaxUnavailableadecuados para las características de la carga de trabajo - Considere el número de réplicas:
minAvailablepuede ser igual a las réplicas para bloquear evictions voluntarias, pero el mantenimiento podría detenerse; configure una tolerancia de interrupción deliberada - Pruebas periódicas: Pruebe el funcionamiento de PDB mediante drenaje de nodos y tareas similares
Node Pressure Eviction
Node pressure eviction es un mecanismo por el cual los pods son expulsados debido a la escasez de recursos del nodo.
Estado de las condiciones del nodo
kubelet informa los siguientes estados de condición del nodo:
- MemoryPressure: El nodo tiene poca memoria
- DiskPressure: El nodo tiene poco espacio en disco
- PIDPressure: El nodo tiene pocos ID de proceso
Cuando se producen estas condiciones, kubelet expulsa pods para obtener recursos.
Configuración de la política de eviction
Las políticas de eviction se pueden establecer en la configuración de kubelet:
# kubelet configuration example
evictionHard:
  memory.available: "100Mi"
  nodefs.available: "10%"
  nodefs.inodesFree: "5%"
  imagefs.available: "15%"
  imagefs.inodesFree: "5%"
evictionSoft:
  memory.available: "200Mi"
  nodefs.available: "15%"
evictionSoftGracePeriod:
  memory.available: "1m"
  nodefs.available: "2m"
evictionMinimumReclaim:
  memory.available: "50Mi"
  nodefs.available: "5%"
evictionMaxPodGracePeriod: 30
evictionPressureTransitionPeriod: "30s"
En el ejemplo anterior:
evictionMinimumReclaim: Recursos mínimos que deben recuperarse después de la evictionevictionPressureTransitionPeriod: Tiempo de espera entre transiciones de estado de presión
TopologySpreadConstraints
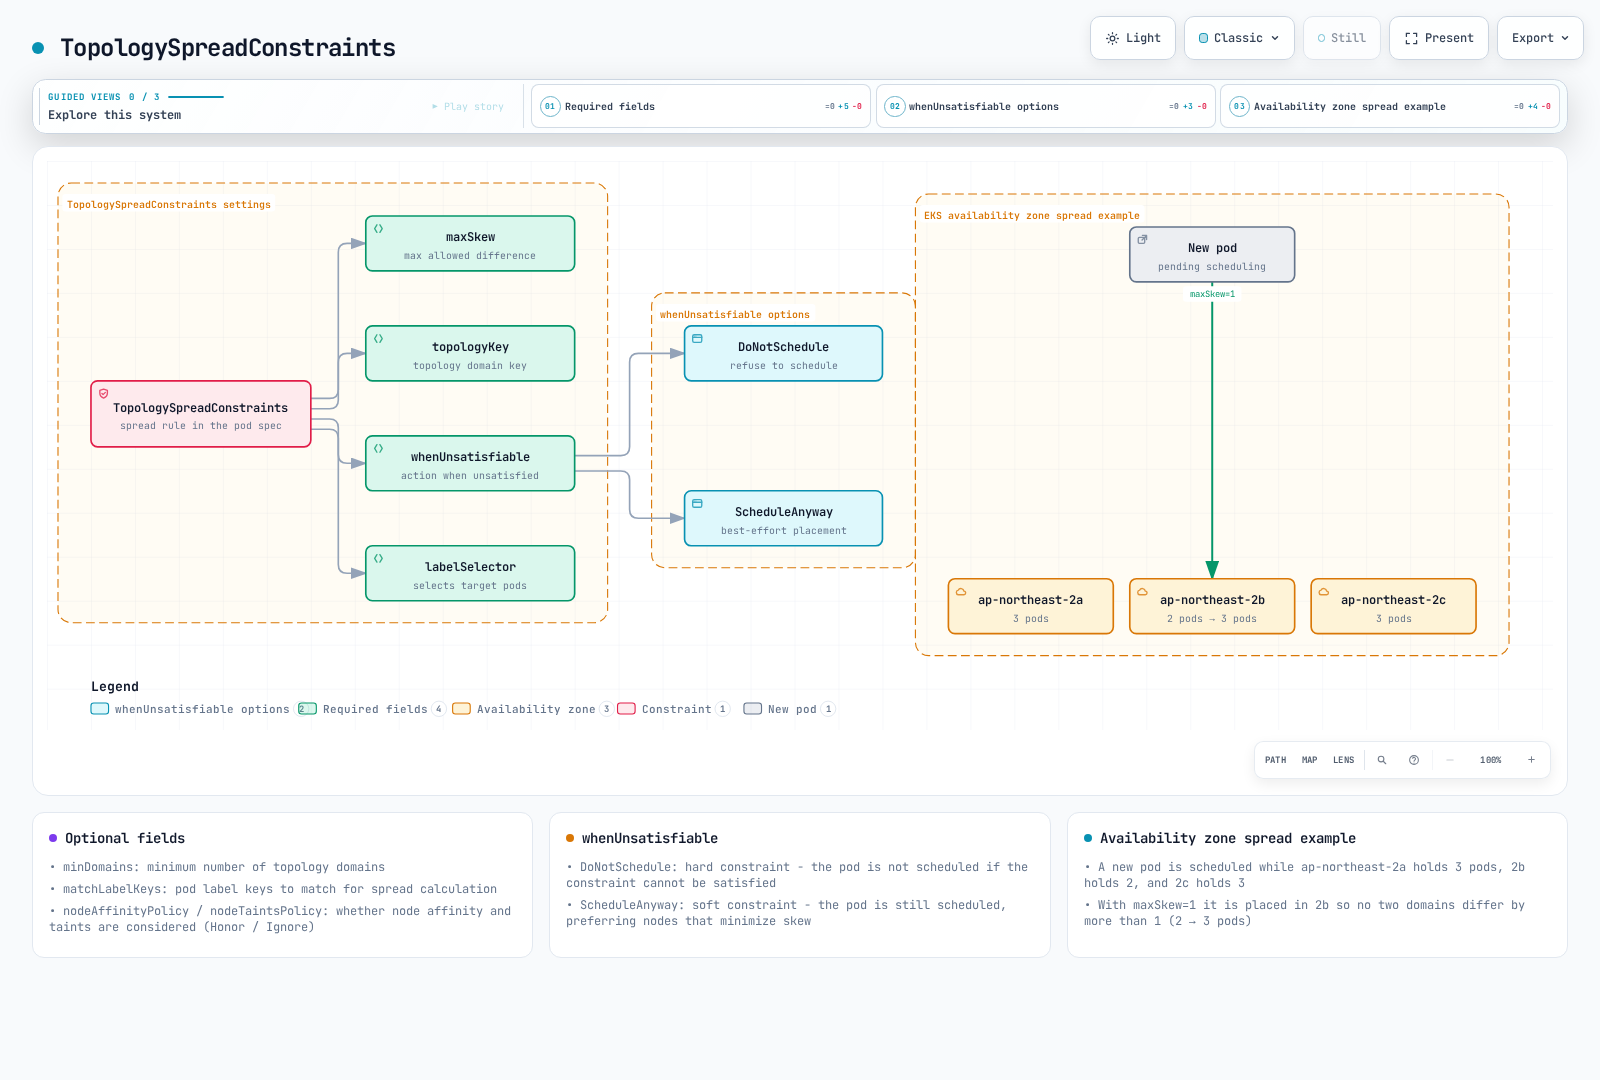
TopologySpreadConstraints proporciona control detallado sobre cómo se distribuyen los pods entre dominios de topología, como zonas de disponibilidad, nodos o regiones. Esta función ofrece más flexibilidad que Pod anti-affinity para lograr alta disponibilidad y una utilización eficiente de recursos.
Campos clave
| Campo | Descripción | Obligatorio |
|---|---|---|
| maxSkew | Para DoNotSchedule, diferencia permitida entre un dominio objetivo y el mínimo global; ScheduleAnyway usa el skew como preferencia | Sí |
| topologyKey | Clave de etiqueta de nodo que define dominios de topología | Sí |
| whenUnsatisfiable | Acción cuando no se pueden satisfacer las restricciones: DoNotSchedule o ScheduleAnyway | Sí |
| labelSelector | Selecciona Pods para contarlos; normalmente especifíquelo junto con las etiquetas de Pod coincidentes | No (null no coincide con ningún Pod) |
| minDomains | Número mínimo de dominios elegibles para el cálculo de skew (estable desde v1.30) | No |
| matchLabelKeys | Claves de etiquetas de Pod que deben coincidir para el cálculo de distribución (1.27+) | No |
Opciones de whenUnsatisfiable
- DoNotSchedule: El scheduler no programará el pod si no se puede satisfacer la restricción (restricción estricta)
- ScheduleAnyway: El scheduler seguirá programando el pod, dando mayor prioridad a los nodos que minimicen el skew (restricción flexible)
Ejemplo de distribución entre zonas de disponibilidad de EKS
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-app
spec:
  replicas: 6
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: web
      - maxSkew: 1
        topologyKey: kubernetes.io/hostname
        whenUnsatisfiable: ScheduleAnyway
        labelSelector:
          matchLabels:
            app: web
      containers:
      - name: web
        image: nginx:1.30.4
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
Esta configuración garantiza:
- Los Pods se distribuyen uniformemente entre zonas de disponibilidad (restricción estricta)
- Los Pods se distribuyen preferentemente entre nodos dentro de cada zona (restricción flexible)
minDomains y matchLabelKeys
apiVersion: apps/v1
kind: Deployment
metadata:
  name: app-with-min-domains
spec:
  replicas: 4
  selector:
    matchLabels:
      app: distributed-app
  template:
    metadata:
      labels:
        app: distributed-app
        version: v1
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: distributed-app
        minDomains: 3
        matchLabelKeys:
        - version
      containers:
      - name: app
image: myapp:v1- minDomains: Si existen menos de 3 dominios elegibles, el mínimo global pasa a ser cero. Con maxSkew 1, aún puede programarse un Pod coincidente por dominio elegible; los Pods adicionales pueden permanecer Pending. No bloquea inmediatamente todos los Pods.
- matchLabelKeys: Usa automáticamente el valor de la etiqueta
versiondel pod en el selector, lo que permite distribución por revisión sin modificar el selector.
Ventajas respecto a Pod Anti-Affinity
| Aspecto | TopologySpreadConstraints | Pod Anti-Affinity |
|---|---|---|
| Flexibilidad | Permite skew controlado (maxSkew > 1) | Binario: mismo dominio o dominio distinto |
| Restricciones flexibles | ScheduleAnyway para best-effort | preferredDuringScheduling, pero con menos control |
| Varios niveles | Varias restricciones con distintos topologyKeys | Requiere reglas anidadas complejas |
| Rendimiento | Mejor rendimiento del scheduler a escala | Puede ralentizar la programación con muchos pods |
| Caso de uso | Distribución uniforme con tolerancia | Separación estricta |
Costo de eliminación de Pod
El costo de eliminación de Pod es una preferencia de mejor esfuerzo que utiliza el controlador ReplicaSet durante la reducción de escala. HPA cambia el número de réplicas deseado; no elige Pods víctima individuales. La anotación no protege Jobs/StatefulSets, no evita la eviction ni garantiza el orden de eliminación.
Cómo funciona
Cuando un controlador (como HPA o una reducción de escala manual) necesita reducir réplicas, considera:
- Los pods con menor costo de eliminación se eliminan primero
- El costo de eliminación predeterminado es 0
- Intervalo válido: -2147483648 a 2147483647
Ejemplo básico
apiVersion: v1
kind: Pod
metadata:
  name: worker-pod
  annotations:
    controller.kubernetes.io/pod-deletion-cost: "100"
spec:
  containers:
  - name: worker
    image: worker:latest
Control de prioridad de reducción de escala de HPA
Use el costo de eliminación para proteger pods importantes durante la reducción de escala de HPA:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-service
spec:
  replicas: 5
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
      # Lower cost pods are deleted first during scale-down
      annotations:
        controller.kubernetes.io/pod-deletion-cost: "0"
    spec:
      containers:
      - name: web
        image: nginx:1.30.4
Patrón de protección de caché
Ejecute la caché con solicitudes de CPU explícitas si se va a escalar usando HPA de utilización de CPU. Lo siguiente es un ejemplo de programación, no una configuración completa de Redis para producción:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: cache-service
spec:
  replicas: 3
  selector:
    matchLabels:
      app: cache
  template:
    metadata:
      labels:
        app: cache
    spec:
      automountServiceAccountToken: false
      containers:
      - name: cache
        image: redis:7
        resources:
          requests:
            cpu: 100m
            memory: 128Mi
Después de medir la calidez real de la caché, un operador/controlador autorizado puede anotar una vez un Pod seleccionado propiedad de ReplicaSet antes de la reducción de escala:
kubectl -n default annotate pod "$CACHE_POD" \
  controller.kubernetes.io/pod-deletion-cost="1000" --overwrite
Establezca CACHE_POD en un Pod de caché real. Las escrituras frecuentes de anotaciones generan carga de API. Un actualizador personalizado necesitaría herramientas de cliente tanto de Redis como de Kubernetes, además de permisos de parche de Pod con alcance limitado; el tiempo transcurrido por sí solo no demuestra que una caché esté caliente. Este ejemplo no instala ningún actualizador.
Casos de uso prácticos
- Cachés con estado administradas por un ReplicaSet: Preferir conservar réplicas calientes
- Elección de líder: Mantener los pods líderes en ejecución durante más tiempo
- Drenaje de conexiones: Dar tiempo a las conexiones de larga duración
- Calentamiento de caché: Conservar pods con cachés calientes
- Limitaciones: Los controladores Job y StatefulSet no utilizan esta preferencia
Descheduler
El Descheduler es un componente de Kubernetes que expulsa pods de los nodos para permitir que el scheduler los reprograme en nodos más apropiados. A diferencia del scheduler, que solo coloca pods nuevos, el descheduler ayuda a mantener una colocación óptima de pods con el tiempo.
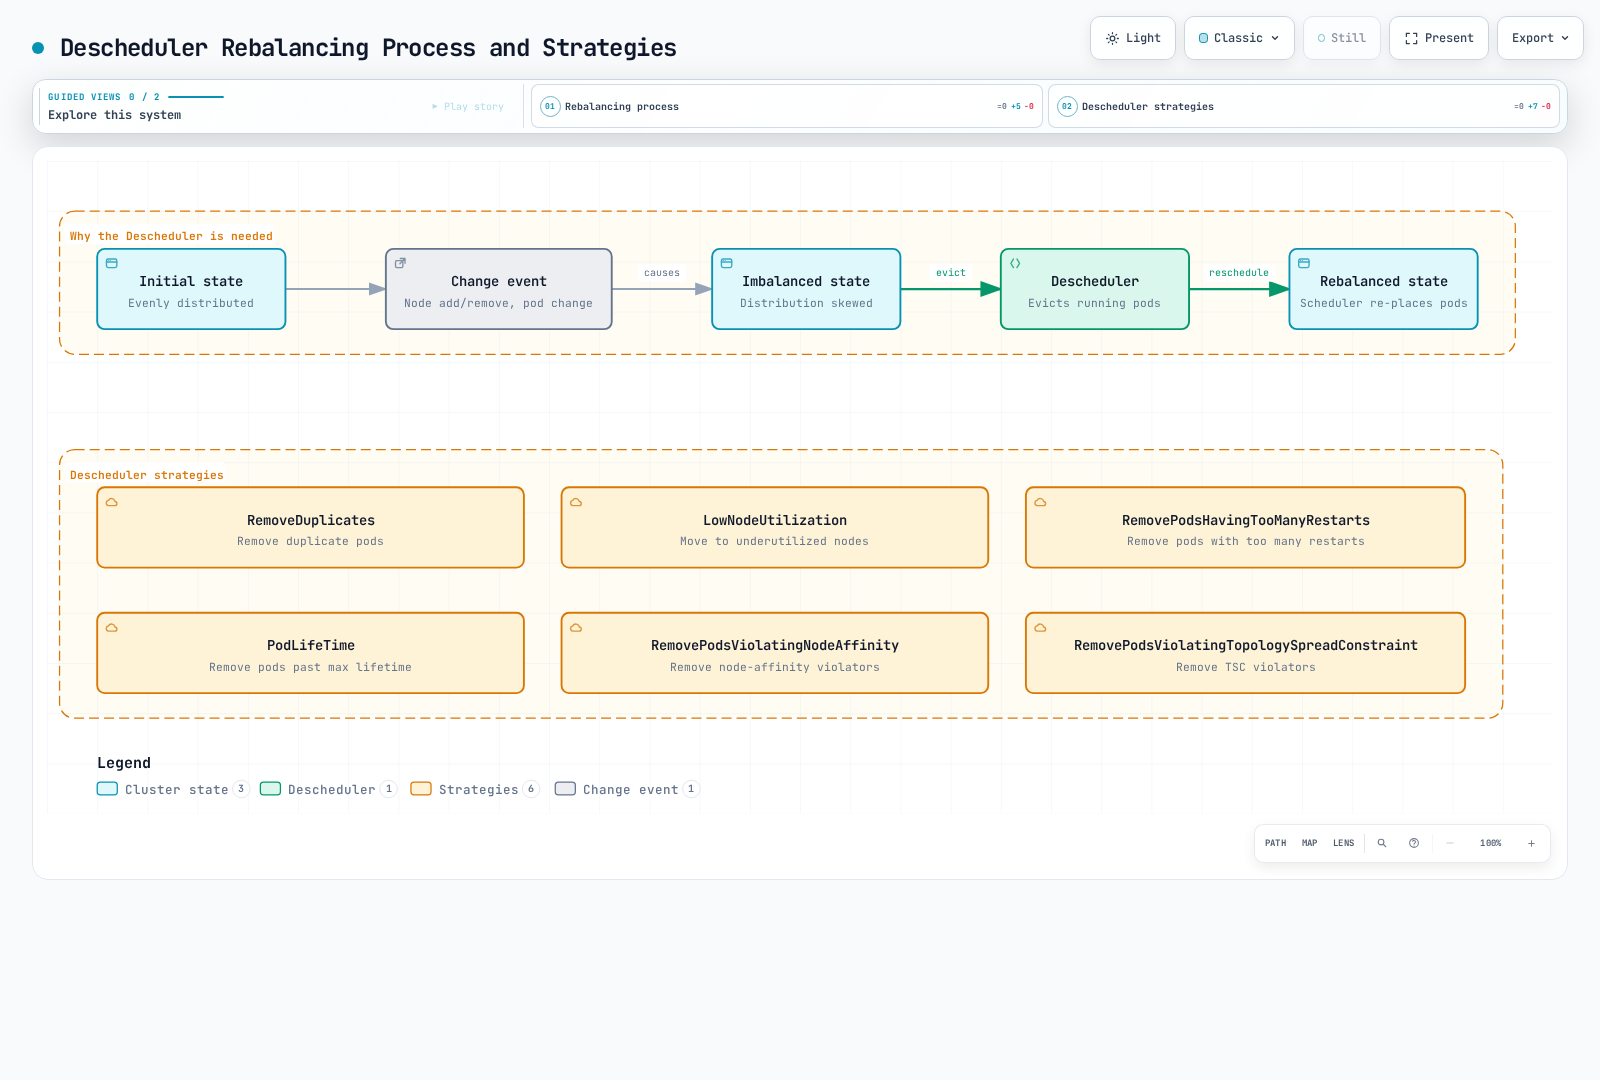
Por qué se necesita la desprogramación
- Cambios en el clúster: Se agregaron nodos nuevos, cambiaron las etiquetas de nodo
- Deriva de pods: La colocación inicial se vuelve subóptima con el tiempo
- Infracciones de affinity: Reglas infringidas después de cambios en el clúster
- Desequilibrio de recursos: Algunos nodos están sobreutilizados y otros subutilizados
- Pods con errores: Pods bloqueados en bucles de reinicio
Estrategias principales
| Estrategia | Descripción | Caso de uso |
|---|---|---|
| RemoveDuplicates | Elimina pods duplicados del mismo nodo | Garantizar HA después de fallos de nodo |
| LowNodeUtilization | Mueve pods de nodos sobreutilizados a nodos subutilizados | Equilibrar recursos del clúster |
| RemovePodsHavingTooManyRestarts | Expulsa pods con reinicios excesivos | Limpiar pods problemáticos |
| PodLifeTime | Expulsa pods más antiguos que la edad especificada | Forzar una programación nueva |
| RemovePodsViolatingInterPodAntiAffinity | Expulsa pods que infringen reglas de anti-affinity | Restaurar el cumplimiento de affinity |
| RemovePodsViolatingNodeAffinity | Expulsa pods que infringen node affinity | Restaurar el cumplimiento de affinity |
| RemovePodsViolatingTopologySpreadConstraint | Expulsa pods que infringen restricciones de distribución | Restaurar una distribución uniforme |
Instalación con Helm
Descheduler v0.36.0 es la versión de ejemplo verificada, orientada a Kubernetes v1.36 y las dos versiones secundarias anteriores en su ventana de pruebas. Compruebe la matriz de compatibilidad antes de aplicarla a otra versión. Guarde valores de Helm revisados en descheduler-values.yaml con schedule y deschedulerPolicy.profiles (los perfiles de política mostrados a continuación); los antiguos valores strategies.*.enabled no configuran esta API.
helm repo add descheduler https://kubernetes-sigs.github.io/descheduler/
helm upgrade --install descheduler descheduler/descheduler \
  --version 0.36.0 --namespace kube-system \
  --values descheduler-values.yaml
Configuración de DeschedulerPolicy
apiVersion: descheduler/v1alpha2
kind: DeschedulerPolicy
profiles:
- name: default
  pluginConfig:
  - name: DefaultEvictor
    args:
      nodeFit: true
  - name: RemoveDuplicates
    args:
      excludeOwnerKinds: [StatefulSet]
  - name: LowNodeUtilization
    args:
      thresholds:
        cpu: 20
        memory: 20
        pods: 20
      targetThresholds:
        cpu: 50
        memory: 50
        pods: 50
  - name: RemovePodsHavingTooManyRestarts
    args:
      podRestartThreshold: 100
      includingInitContainers: true
  - name: PodLifeTime
    args:
      maxPodLifeTimeSeconds: 86400
      labelSelector:
        matchLabels:
          app.kubernetes.io/lifecycle: ephemeral
  - name: RemovePodsViolatingNodeAffinity
    args:
      nodeAffinityType: [requiredDuringSchedulingIgnoredDuringExecution]
  - name: RemovePodsViolatingTopologySpreadConstraint
    args:
      constraints: [DoNotSchedule]
  plugins:
    balance:
      enabled:
      - RemoveDuplicates
      - LowNodeUtilization
      - RemovePodsViolatingTopologySpreadConstraint
    deschedule:
      enabled:
      - RemovePodsHavingTooManyRestarts
      - PodLifeTime
      - RemovePodsViolatingNodeAffinity
Respeto de PDB
El descheduler respeta los Pod Disruption Budgets (PDB). Si expulsar un pod infringiría un PDB, el descheduler no expulsará ese pod:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: web-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: web
Con este PDB, el descheduler garantizará que al menos 2 pods con la etiqueta app: web permanezcan disponibles durante las operaciones de desprogramación.
La política anterior es un archivo de configuración de Descheduler, no un objeto de API para kubectl apply. Utiliza plugins Balance para la redistribución de grupos y plugins Deschedule para decisiones por Pod. LowNodeUtilization normalmente evalúa las solicitudes de recursos en lugar del uso de CPU en tiempo real, y la eviction no garantiza que el Pod de reemplazo llegue a otro lugar. Revise las protecciones y pruebe en modo dry-run antes de habilitar la eviction recurrente.
Ejemplo de CronJob de Descheduler
apiVersion: batch/v1
kind: CronJob
metadata:
  name: descheduler
  namespace: kube-system
spec:
  schedule: "*/30 * * * *"
  concurrencyPolicy: Forbid
  jobTemplate:
    spec:
      template:
        spec:
          serviceAccountName: descheduler
          containers:
          - name: descheduler
            image: registry.k8s.io/descheduler/descheduler:v0.36.0
            args:
            - --policy-config-file=/policy/policy.yaml
            - --v=3
            volumeMounts:
            - name: policy
              mountPath: /policy
          volumes:
          - name: policy
            configMap:
              name: descheduler-policy
          restartPolicy: OnFailure
El CronJob independiente es una alternativa a Helm, no una instalación adicional. Requiere el ServiceAccount/RBAC descheduler y un ConfigMap descheduler-policy con la clave policy.yaml; use el chart/manifiestos oficiales para proporcionar estos requisitos previos.
Análisis detallado: Para información detallada sobre schedulers personalizados, consulte:
Optimización de programación en Amazon EKS
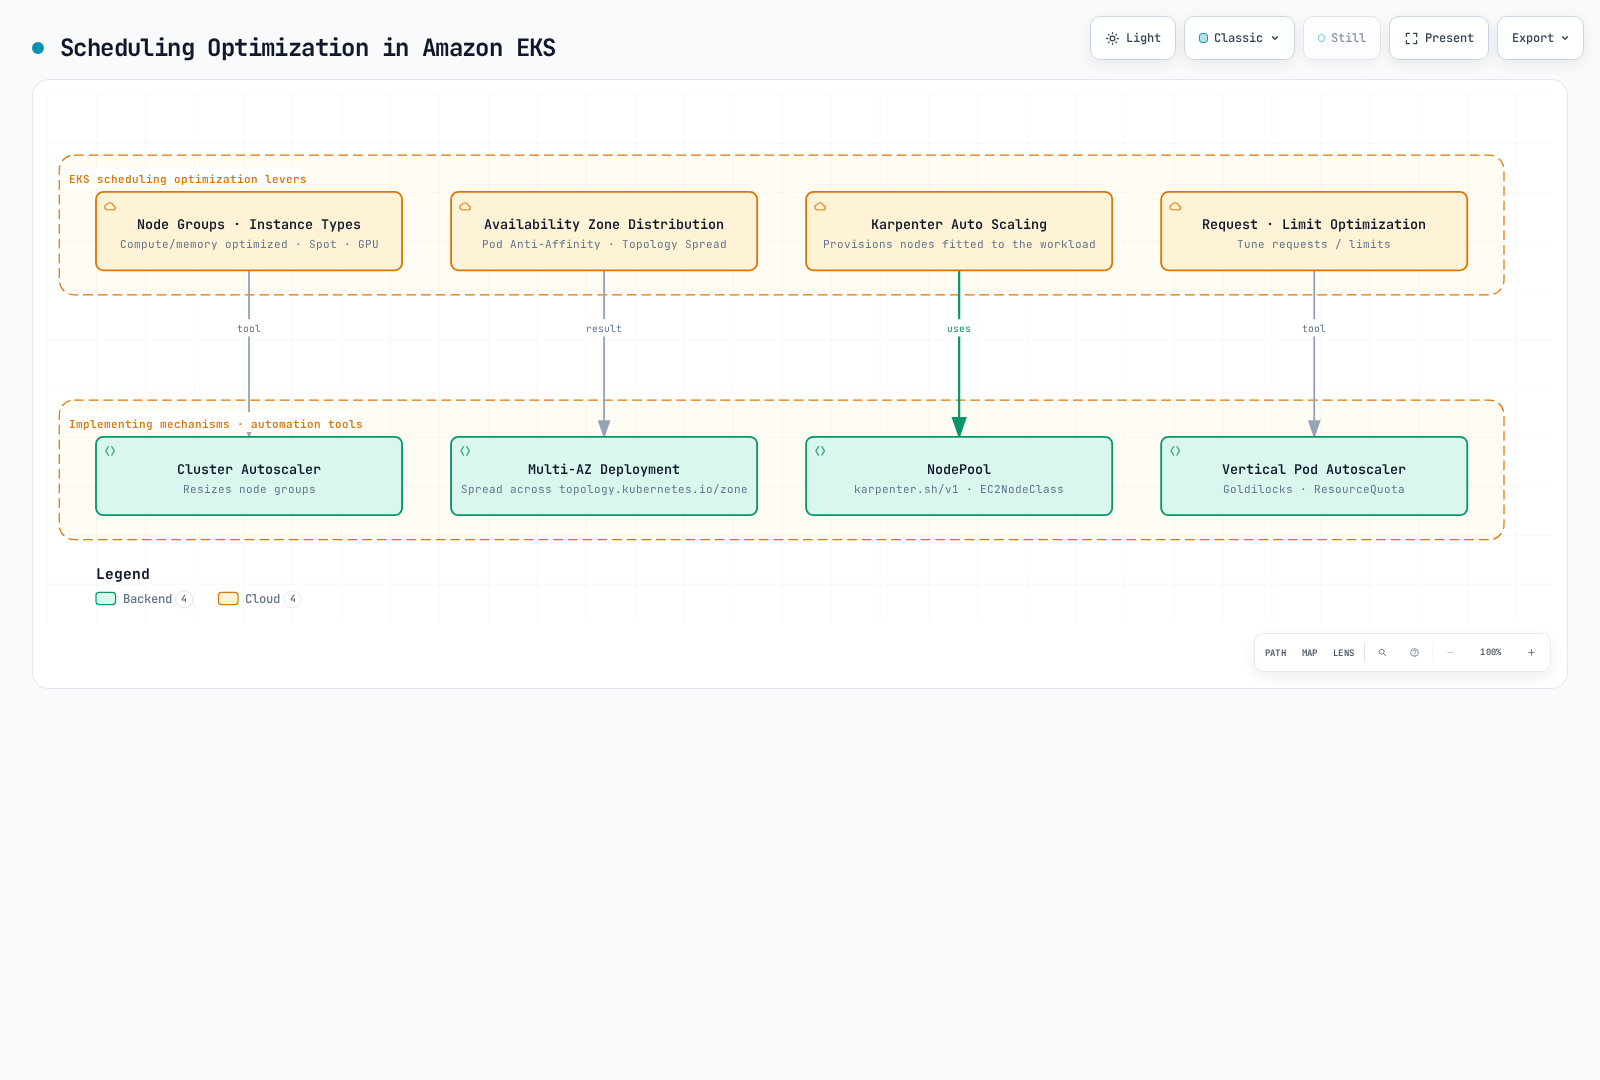
En Amazon EKS, puede optimizar cargas de trabajo mediante las funciones de programación de Kubernetes.
Grupos de nodos y tipos de instancia
En EKS, puede proporcionar recursos adecuados para las cargas de trabajo utilizando diversos grupos de nodos y tipos de instancia:
- Diversos tipos de instancia: Optimizados para cómputo, memoria, almacenamiento, etc.
- Instancias Spot: Instancias Spot para cargas de trabajo rentables
- Instancias GPU: Instancias GPU para cargas de trabajo de AI/ML
Puede usar etiquetas de nodo y taints para colocar cargas de trabajo específicas en grupos de nodos específicos:
Use una configuración de eksctl revisada para el clúster existente, con Region coincidente, instancia/AMI de GPU compatible y los permisos IAM necesarios:
# gpu-nodegroup.yaml
apiVersion: eksctl.io/v1alpha5
kind: ClusterConfig
metadata:
  name: my-cluster
  region: us-west-2
managedNodeGroups:
- name: gpu-nodes
  instanceType: p3.2xlarge
  desiredCapacity: 1
  privateNetworking: true
  labels:
    workload-type: gpu
  taints:
  - key: gpu
    value: "true"
effect: NoScheduleeksctl create nodegroup --config-file=gpu-nodegroup.yamlDistribución entre zonas de disponibilidad
En EKS, puede distribuir cargas de trabajo entre varias zonas de disponibilidad usando pod anti-affinity y restricciones de distribución de topología:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web-server
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      topologySpreadConstraints:
      - maxSkew: 1
        topologyKey: topology.kubernetes.io/zone
        whenUnsatisfiable: DoNotSchedule
        labelSelector:
          matchLabels:
            app: web
      containers:
      - name: web
        image: nginx
En el ejemplo anterior, topologySpreadConstraints distribuye los pods de manera uniforme entre varias zonas de disponibilidad.
Autoescalado con Karpenter
En Amazon EKS, puede usar Karpenter para aprovisionar automáticamente nodos adecuados para las cargas de trabajo:
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: default
spec:
  template:
    spec:
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot", "on-demand"]
        - key: kubernetes.io/arch
          operator: In
          values: ["amd64", "arm64"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default-class
  limits:
    cpu: 1000
    memory: 1000Gi
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
---
apiVersion: karpenter.k8s.aws/v1
kind: EC2NodeClass
metadata:
  name: default-class
spec:
  role: KarpenterNodeRole-my-cluster
  amiSelectorTerms:
    - alias: al2023@latest
  subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
  securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: my-cluster
Karpenter optimiza costes seleccionando el tipo de instancia óptimo según los requisitos de recursos del pod.
Optimización de solicitudes y límites de recursos
Es importante optimizar las solicitudes y límites de recursos de las cargas de trabajo en EKS:
- Vertical Pod Autoscaler (VPA): Optimizar solicitudes de recursos según el uso real de recursos de la carga de trabajo
- Goldilocks: Visualizar las recomendaciones de VPA para facilitar la optimización de solicitudes de recursos
- Resource Quotas: Limitar el uso de recursos por namespace
# VPA example
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: frontend-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: frontend
  updatePolicy:
    updateMode: "Recreate"
Prácticas recomendadas de programación
Prácticas recomendadas para optimizar la programación en Kubernetes y EKS:
Establezca solicitudes y límites de recursos adecuados:
- Establezca solicitudes de recursos según el uso real de recursos de la carga de trabajo
- Establezca límites de recursos adecuados para las cargas de trabajo importantes
- Use VPA para optimizar automáticamente las solicitudes de recursos
Distribución de cargas de trabajo:
- Use pod anti-affinity para distribuir cargas de trabajo importantes entre varios nodos
- Use restricciones de distribución de topología para distribuir cargas de trabajo entre varias zonas de disponibilidad
- Use node affinity para colocar cargas de trabajo específicas en nodos específicos
Optimización de recursos de nodos:
- Use diversos tipos de instancia para proporcionar recursos adecuados para las cargas de trabajo
- Use instancias spot para optimizar costes
- Use Karpenter para el aprovisionamiento automático de nodos adecuado para las cargas de trabajo
Configuración de PDB:
- Establezca PDB para cargas de trabajo importantes
- Seleccione valores de
minAvailableomaxUnavailableadecuados para las características de la carga de trabajo - Pruebe periódicamente el funcionamiento de PDB
Configuración de prioridad y preemption:
- Establezca clases de alta prioridad para cargas de trabajo importantes
- Use las clases de prioridad
system-cluster-criticalosystem-node-criticalpara componentes del sistema - Comprenda y pruebe el impacto de la preemption
Taints y tolerations de nodos:
- Establezca nodos dedicados para cargas de trabajo especializadas
- Aplique taints a los nodos en mantenimiento
- Establezca tolerations adecuadas
Conclusión
Los mecanismos de programación, preemption y eviction de Kubernetes desempeñan funciones importantes para administrar eficazmente los recursos del clúster y mantener la disponibilidad de las cargas de trabajo. Al comprender y utilizar estas funciones, puede optimizar y operar de forma fiable las cargas de trabajo en clústeres de Amazon EKS.
La optimización de programación es un proceso continuo, y se deben realizar ajustes continuamente según las características de la carga de trabajo y el estado del clúster. Es importante supervisar el uso de recursos del clúster mediante herramientas de monitorización y ajustar las políticas de programación según sea necesario.
Cuestionario
Para comprobar lo aprendido en este capítulo, pruebe el Cuestionario de programación, preemption y eviction.