Operaciones de clústeres por zona: cambio de tráfico, reversión de actualizaciones y afinidad de la capa de datos con la AZ
Base de la revisión: documentación de reversión de EKS y ARC, Strimzi 1.2.0, Valkey GLIDE 2.5.2, AWS Advanced JDBC Wrapper 4.4.0 Última revisión: September 11, 2026. Se comprobaron los ejemplos de configuración; no se realizaron cambios de tráfico entre clústeres reales ni experimentos de fallos.
< Anterior: Tekton Pipelines | Índice | Siguiente: Manual de solución de problemas >
Esta guía combina el cambio de tráfico entre clústeres cuyos nodos de trabajo están en una AZ, la reversión condicional de versiones y las lecturas de datos conscientes de la AZ. Una flota por zonas no es la arquitectura predeterminada para todos los equipos. Considérela cuando pueda operar de forma independiente la capacidad, las rutas, los despliegues y las dependencias de datos de cada celda.
Aquí, zonal describe la ubicación de los nodos de trabajo y de las aplicaciones. El plano de control administrado de EKS sigue distribuido entre varias AZ. El clúster completo no reside en una única AZ.
Índice
- Por qué operar por zonas
- Capa de tráfico: grupo de destino + TargetGroupBinding + cambio de pesos
- Actualizaciones: condiciones para la actualización in situ y la reversión nativa
- Capa de datos: preferir lecturas en la misma AZ
- Resumen de combinaciones recomendadas
Por qué operar por zonas
| Aspecto | Un clúster distribuido en varias AZ | Clústeres con nodos de trabajo en una AZ cada uno |
|---|---|---|
| Aislamiento de fallos | Las réplicas y la capacidad de reserva de AZ sanas permiten la recuperación | Una celda puede perder todos sus nodos de trabajo; las bases de datos compartidas, las rutas y las dependencias regionales pueden afectar a otras celdas |
| Coste entre AZ | Depende de los servicios y de las rutas de datos | Puede disminuir el tráfico local de aplicaciones, pero la replicación, los servicios compartidos y el reenvío del equilibrador pueden seguir cruzando AZ |
| Actualizaciones | El plano de control y los nodos cambian por etapas, gestionando el desfase de versiones | Actualizar celdas secuencialmente exige versiones compatibles y capacidad en las celdas restantes |
| Complejidad operativa | Un clúster | Varios clústeres y enrutamiento coordinado |
Consulte la guía de arquitectura basada en celdas para Amazon EKS de AWS. Minimice las dependencias entre celdas y dimensione las sanas para absorber el tráfico de la celda averiada. Seleccionar equilibradores por celda mediante DNS y ponderar grupos de destino detrás de un equilibrador son diseños de enrutamiento distintos. Mida los costes según las rutas reales de tráfico y las reglas de cobro de cada servicio.
Guías relacionadas: Infraestructura avanzada y Resiliencia de EKS.
Capa de tráfico: grupo de destino + TargetGroupBinding + cambio de pesos
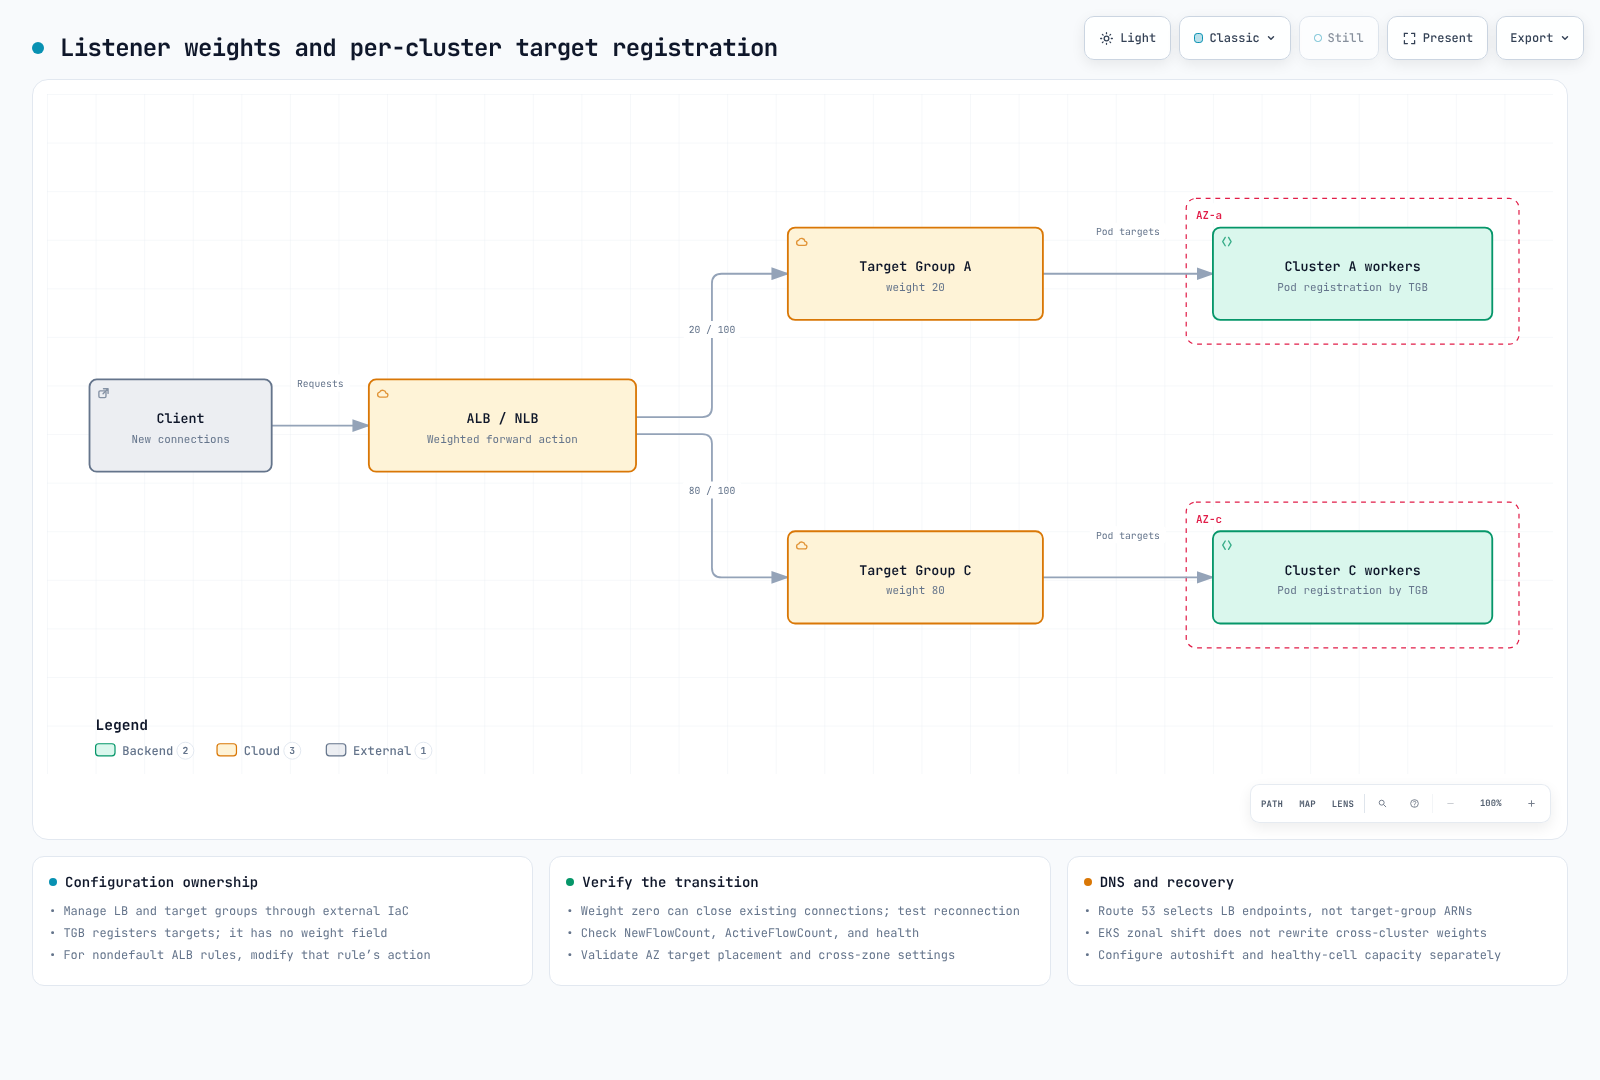
Para dos clústeres que comparten un equilibrador:
- Cree el NLB/ALB y los grupos de destino fuera de los clústeres mediante IaC, para que sustituir un clúster no elimine el equilibrador.
- Vincule el Service de cada clúster a su propio grupo de destino mediante
TargetGroupBinding. - Cambie los pesos en la acción de reenvío del listener. TGB no tiene un campo de peso. Asigne explícitamente la gestión de los grupos de destino y de la configuración del listener entre IaC y los controladores.
El ejemplo de TGB presupone que ya existen el espacio de nombres production, app-service:80, un grupo de destino de tipo IP en la VPC prevista y AWS Load Balancer Controller. Sustituya el ARN de ejemplo y verifique la salud de los destinos y el acceso de red.
Este ejemplo utiliza AWS Load Balancer Controller instalado por separado. El TGB integrado de Auto Mode utiliza eks.amazonaws.com/v1, con otras reglas de etiquetas y ciclo de vida. AWS documenta que el grupo de destino se elimina cuando se borra ese TGB integrado o el clúster; no mezcle ese modelo de gestión con este grupo de destino administrado externamente.
apiVersion: elbv2.k8s.aws/v1beta1
kind: TargetGroupBinding
metadata:
  name: zone-a-tgb
  namespace: production
spec:
  targetGroupARN: arn:aws:elasticloadbalancing:ap-northeast-2:ACCOUNT:targetgroup/zone-a-tg/xxxxxxxxxxxx
  serviceRef:
    name: app-service
    port: 80
targetType: ipset -euo pipefail
# NLB listener whose existing default action forwards to these two groups.
# Nondefault ALB rules require modify-rule, not this operation.
: "${LISTENER_ARN:?}" "${ZONE_A_TG_ARN:?}" "${ZONE_C_TG_ARN:?}"
aws elbv2 describe-listeners \
--listener-arns "$LISTENER_ARN" \
--query 'Listeners[0].DefaultActions' --output json > current-actions.json
jq -e --arg a "$ZONE_A_TG_ARN" --arg c "$ZONE_C_TG_ARN" '
if $a == $c or length != 1 or .[0].Type != "forward"
or ([.[0].ForwardConfig.TargetGroups[].TargetGroupArn] | sort)
!= ([$a, $c] | sort)
then error("Expected one forward action with exactly the two selected groups")
else
.[0].ForwardConfig.TargetGroups |= map(
.Weight = (if .TargetGroupArn == $a then 20 else 80 end))
end
' current-actions.json > proposed-actions.json &&
aws elbv2 modify-listener \
--listener-arn "$LISTENER_ARN" \
--default-actions file://proposed-actions.jsonAntes de ejecutarlo, concilie este cambio con el plan de IaC. Los cambios ordinarios de pesos de NLB afectan a los flujos nuevos, pero el peso cero necesita un tratamiento separado. La guía de usuario actual indica que, poco después de establecer cero, el grupo deja de recibir conexiones nuevas y las existentes se cierran. No suponga que las conexiones existentes sobreviven hasta su cierre natural; pruebe el drenaje de la aplicación, la reconexión y los reintentos antes de cambiar a cero. Siga la guía oficial para inspeccionar NewFlowCount y ActiveFlowCount por grupo de destino, la salud, las tasas de error y el drenaje de conexiones antes de cambiar nodos. Verifique la compatibilidad de protocolos y versiones IP de los grupos y la configuración entre zonas. Si los destinos están confinados a AZ diferentes, deshabilitar el equilibrio entre zonas puede impedir la distribución de pesos prevista.
Los registros ponderados de Route 53 seleccionan endpoints DNS de equilibradores, no ARN de grupos de destino. Los TTL, las cachés de los clientes y las conexiones de larga duración también impiden un cambio DNS instantáneo. Consulte AWS Load Balancer Controller e Infraestructura avanzada para la configuración complementaria.
Cambios planificados y respuesta ante fallos: modificar los pesos permite transiciones planificadas, pero no detecta fallos automáticamente. ARC zonal shift lo inicia el operador. Zonal autoshift requiere activación, prácticas y configuración de alarmas por separado. Un desplazamiento del recurso EKS cambia el tratamiento de endpoints y nodos de la AZ afectada dentro de ese clúster; no reescribe los pesos de los grupos de destino de otro clúster. Planifique también por separado el desplazamiento del recurso equilibrador.
Compatibilidad con EKS Auto Mode: tras el lanzamiento de July 2026, habilitar zonal shift en el clúster permite que Auto Mode limite el aprovisionamiento nuevo y las interrupciones voluntarias en la AZ afectada durante un desplazamiento. Esto no habilita autoshift por sí solo. Desviar el tráfico de la única AZ que contiene nodos de trabajo puede causar una interrupción. El desplazamiento de EKS necesita réplicas, CoreDNS y capacidad de reserva en AZ sanas. Una celda cuyos nodos de trabajo ocupan una sola AZ necesita enrutamiento externo entre celdas como parte de la recuperación.
Actualizaciones: condiciones para la actualización in situ y la reversión nativa
La reversión nativa de versiones de EKS, introducida en July 2026, permite volver a la versión secundaria inmediatamente anterior si se inicia dentro de los siete días posteriores a la finalización de la actualización. Siete días es una ventana de elegibilidad, no una garantía de tiempo de recuperación. Compruebe la versión de creación, el estado de soporte, las actualizaciones posteriores, la compatibilidad de funciones y Rollback Readiness Insights.
- Auto Mode: EKS revierte primero los nodos de Auto Mode y después el plano de control. Siguen aplicándose los PDB y los presupuestos de interrupción de NodePool; la reversión no es instantánea.
- Grupos de nodos administrados: reviértalos por separado con
UpdateNodegroupVersion. Los operadores preparan por separado los nodos autoadministrados y Hybrid. Los nodos no deben ejecutar una versión más reciente que el plano de control. - Complementos, datos y aplicaciones: la reversión no restaura versiones de complementos, datos de etcd, datos de volúmenes persistentes ni cambios de aplicación. Planifique de forma independiente la compatibilidad y la recuperación de migraciones de datos.
--force: puede omitir las comprobaciones de preparación, pero no los requisitos de elegibilidad ni los controles de interrupción de Auto Mode. Resuelva los problemas antes de seguir el procedimiento normal de reversión.
La función de reversión no tiene un cargo adicional por sí misma; siguen aplicándose los cargos existentes de clúster, cómputo y tráfico. Elija una actualización in situ o azul/verde después de validar la capacidad de las celdas restantes y los objetivos de recuperación.
| Enfoque | Condiciones adecuadas |
|---|---|
| Clústeres azul/verde | Validar en un entorno separado y conservar la posibilidad de devolver el tráfico al entorno anterior; los cambios de datos compartidos necesitan su propio plan de recuperación |
| Actualización zonal in situ + reversión nativa | La flota de celdas existente puede absorber el tráfico y se han probado la elegibilidad, la compatibilidad y el tiempo de recuperación |
| Cambio mediante DNS ponderado de Route 53 | Endpoints de equilibradores distintos, incluidos diseños entre regiones/cuentas, considerando la caché DNS y el comportamiento de salud |
La secuencia operativa es comprobar la capacidad de las celdas restantes → cambiar los pesos → confirmar el drenaje de conexiones → actualizar → validar → restaurar los pesos. Consulte Operaciones de actualización y Actualizaciones de EKS para los procedimientos detallados y las condiciones específicas de cada tipo de nodo.
Capa de datos: preferir lecturas en la misma AZ
Prefiera lecturas locales cuando exista una réplica adecuada en la misma AZ y la aplicación acepte su comportamiento de coherencia. Las escrituras, la replicación, las solicitudes iniciales de metadatos y la alternativa ante fallos pueden seguir cruzando AZ. Mida conjuntamente el retraso de replicación, los errores, los destinos reales de las conexiones y el volumen transferido.
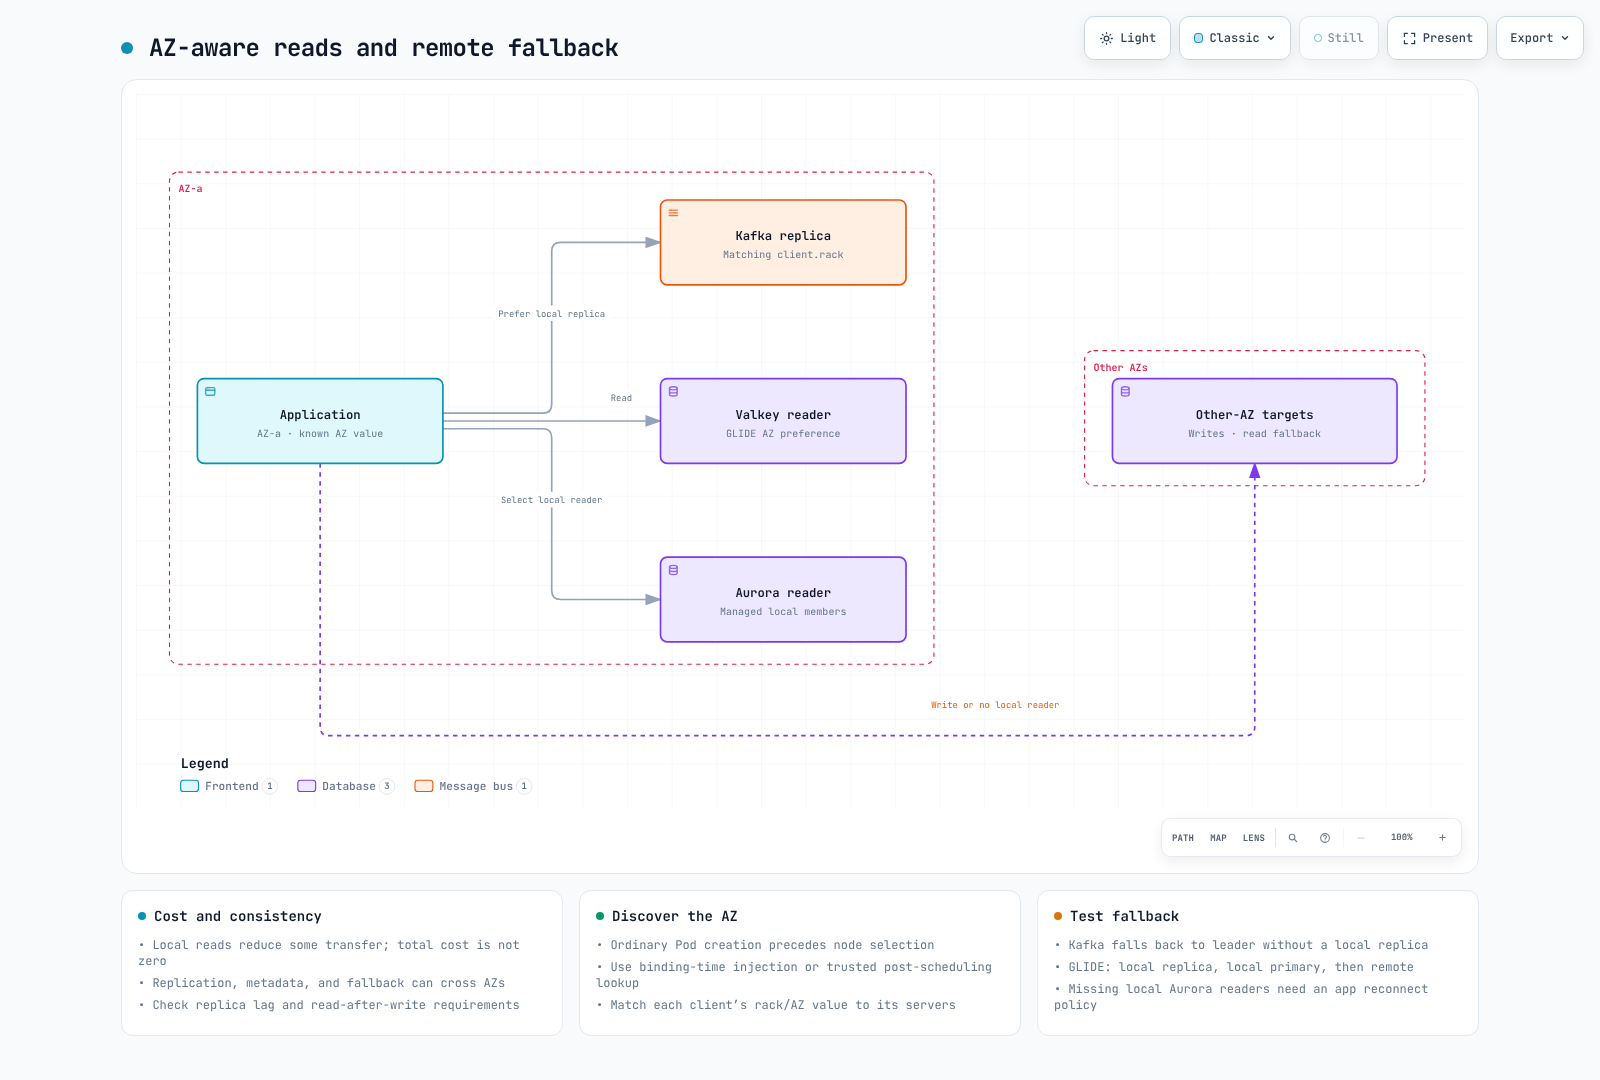
Determine primero la AZ del Pod. Downward API expone campos del Pod; no consulta directamente las etiquetas del nodo.
- Inyección de metadatos del nodo: la admisión ordinaria de creación de Pods ocurre antes de la planificación, por lo que todavía no se conoce el nodo de destino. La guía de AWS MSK procesa solicitudes
Pod/bindingpara leer el nodo elegido e inyectar su ID de AZ. Configure conjuntamente los filtros de solicitudes binding de Kyverno, el RBAC de lectura de nodos y la finalización antes del inicio del Pod. - Consulta posterior a la planificación: exponga
spec.nodeNamemediante Downward API y utilice un componente de inicialización de confianza para leer etiquetas de nodos. No conceda a todas las aplicaciones un acceso amplio de lectura de nodos. - EC2 IMDSv2: cuando se permita deliberadamente acceder a los metadatos de EC2, obtenga un token antes de leer la información de ubicación. No suponga que funciona un GET de IMDSv1 ni elimine indiscriminadamente las restricciones de metadatos. Esto no se aplica directamente a Fargate.
- Compatibilidad del operador: Strimzi configura la conciencia de racks en los brokers que administra y en los recursos cliente compatibles. No configura automáticamente
client.racken Deployments de aplicaciones ajenas.
No mezcle nombres e ID de AZ. broker.rack y client.rack de Kafka deben utilizar cadenas coincidentes. Si MSK utiliza ID de AZ, no los sustituya por un nombre como ap-northeast-2a. Asimismo, client_az de GLIDE debe coincidir con los valores de AZ comunicados por los servidores.
Kafka: lecturas desde réplicas seguidoras con KIP-392
KIP-392, introducido en Kafka 2.4, permite que los consumidores lean desde una réplica del mismo rack. Esa es la versión de introducción de la función, no una recomendación de desplegar Kafka 2.4 hoy.
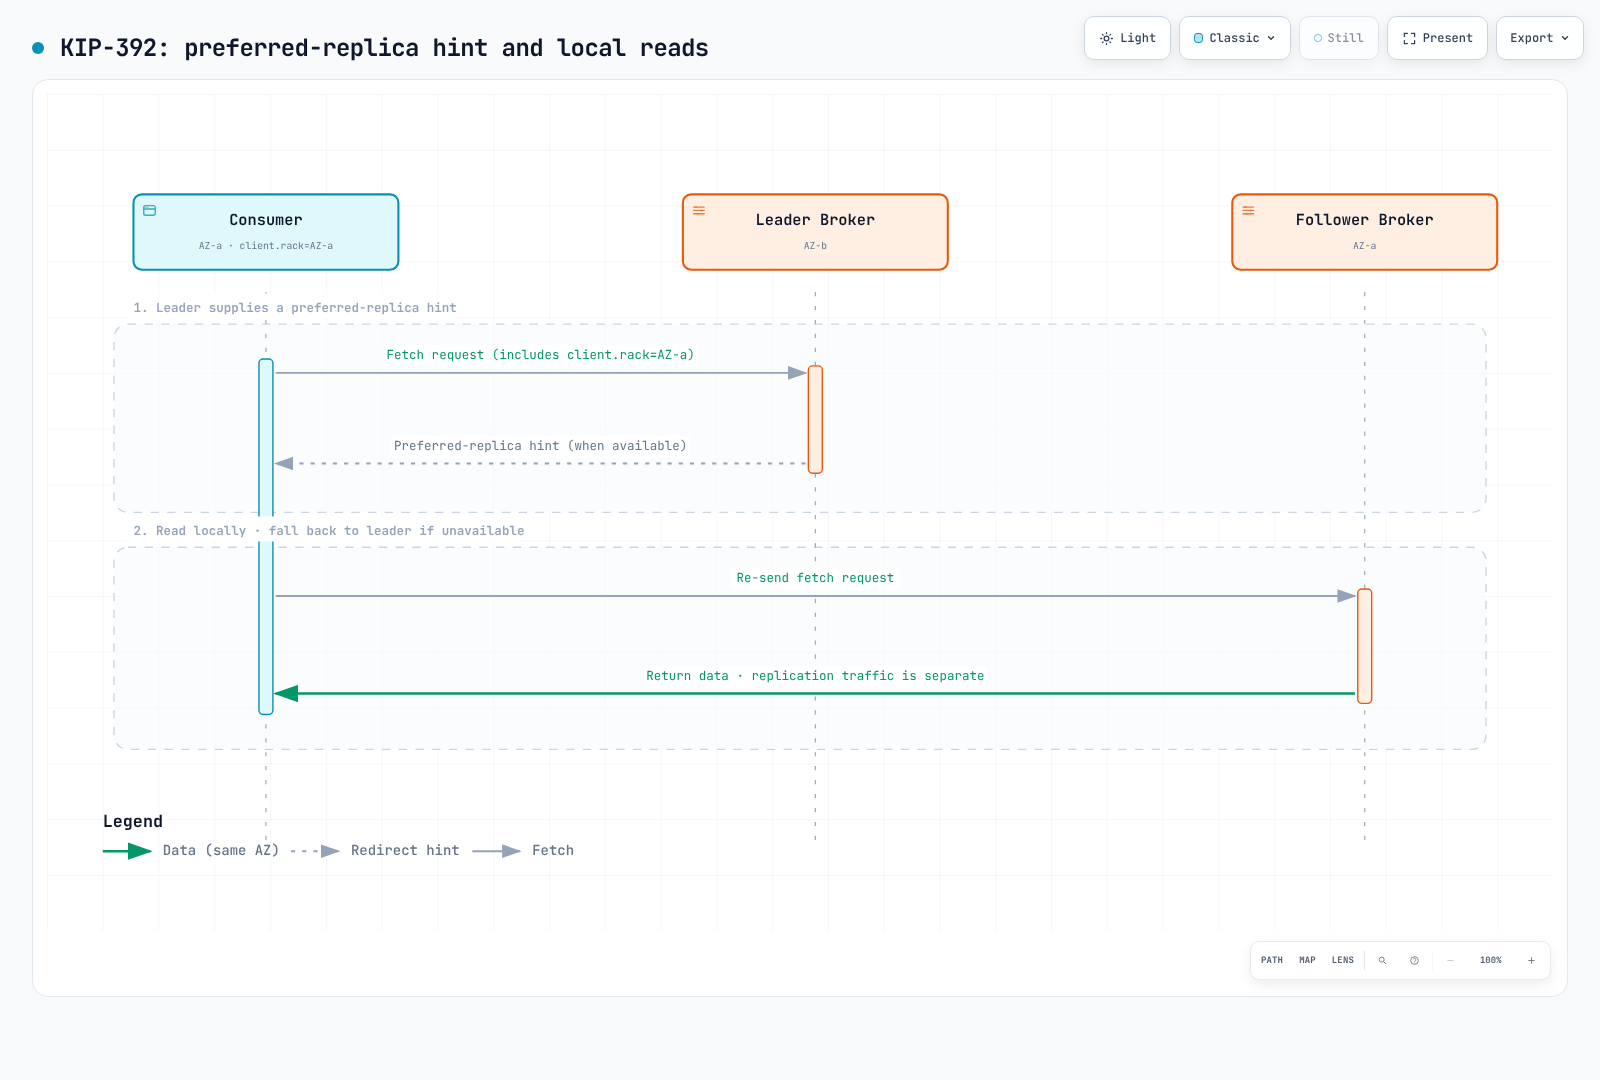
- Brokers: configure
replica.selector.class=org.apache.kafka.common.replica.RackAwareReplicaSelectorybroker.rack. - Consumidores: establezca
client.racken el rack del consumidor. Si no existe una réplica local adecuada, la selección vuelve al líder. - Strimzi 1.2.0: lo siguiente es un fragmento de configuración que debe combinarse con un CR Kafka existente, no un despliegue completo. También se requieren KafkaNodePools, listeners, almacenamiento y otras configuraciones. Desde Strimzi 1.0, la API del CR es
v1; especifique también el tipo de rack.
apiVersion: kafka.strimzi.io/v1
kind: Kafka
metadata:
  name: my-cluster
spec:
  kafka:
    rack:
      type: topology-label
      topologyKey: topology.kubernetes.io/zone
    config:
      replica.selector.class: org.apache.kafka.common.replica.RackAwareReplicaSelector
Esto configura broker.rack de los brokers. Configure por separado client.rack de los consumidores de aplicaciones ordinarias. KafkaConnect, MirrorMaker 2 y Bridge tienen sus propios ajustes de rack en sus CR. Siga también la documentación de Strimzi para distribuir la ubicación de los brokers. Leer de una réplica seguidora puede aumentar la latencia de lectura debido al retraso de replicación.
KIP-881 se refiere a la asignación de particiones consciente del rack, que es un mecanismo separado. Compruebe la compatibilidad de la versión del consumidor y del asignador. Consulte Kafka en EKS para las indicaciones de despliegue.
Redis/Valkey (ElastiCache): estrategias de lectura con afinidad de AZ
Estas son las principales opciones de ReadFrom de Valkey GLIDE tratadas aquí. GLIDE 2.5.2 también dispone de ALL_NODES; esta no es la lista completa del enumerado.
| Estrategia | Comportamiento |
|---|---|
PRIMARY | Leer desde el primario (predeterminado) |
PREFER_REPLICA | Turnos rotativos entre réplicas y, si no hay ninguna disponible, el primario |
AZ_AFFINITY | Primero réplicas locales; después otras réplicas o el primario |
AZ_AFFINITY_REPLICAS_AND_PRIMARY | Réplicas locales → primario local → réplicas o primario de otras AZ |
Considere las lecturas de réplicas cuando la aplicación tolere datos desactualizados; el porcentaje de lecturas por sí solo no determina la estrategia. Verifique la compatibilidad y configuración de metadatos de AZ del servidor, la carga del primario y las alternativas ante fallos. Diseñe por separado las solicitudes que necesitan datos recientes o lectura después de escritura, por ejemplo mediante lecturas del primario cuando sean adecuadas para el modelo de datos.
Este ejemplo de valkey-glide==2.5.2 crea la configuración para el modo clúster sin abrir una conexión. Habilita TLS; proporcione credentials cuando se requiera autenticación. Si el modo clúster está deshabilitado, utilice GlideClientConfiguration y GlideClient.
from glide import GlideClusterClientConfiguration, NodeAddress, ReadFrom


def cache_config(host: str, client_az: str, credentials=None):
    if not host or not client_az:
        raise ValueError("Cache endpoint and client AZ are required")
    return GlideClusterClientConfiguration(
        addresses=[NodeAddress(host, 6379)],
        use_tls=True,
        credentials=credentials,
        read_from=ReadFrom.AZ_AFFINITY_REPLICAS_AND_PRIMARY,
        client_az=client_az,
    )
El caso de HotelTrader comunica un coste de transferencia entre AZ un 95% menor y una latencia media un 49% menor tras aplicar tanto enrutamiento consciente de AZ como procesamiento de solicitudes por lotes. Son resultados de esa carga de trabajo ECS/ElastiCache, no garantías de la opción de enrutamiento por sí sola.
Aurora/RDS: límites del endpoint lector y alternativas
El endpoint lector predeterminado de Aurora equilibra conexiones entre réplicas de lectura; no garantiza preferencia de AZ ni equilibrio por consulta. Si no hay réplicas, puede conectarse al escritor. Los cambios DNS por sí solos no trasladan las conexiones existentes del pool a otra instancia.
Endpoints personalizados por AZ: seleccione explícitamente los ID de instancia después de verificar su AZ y su función de lector. Sustituya los nombres de este ejemplo de creación por recursos reales.
bashaws rds create-db-cluster-endpoint \ --db-cluster-identifier my-aurora-cluster \ --db-cluster-endpoint-identifier reader-az-a \ --endpoint-type READER \ --static-members db-instance-az-a-1 db-instance-az-a-2La CLI/API admite endpoints
READER. Un miembro promovido a escritor queda excluido, y las réplicas nuevas no se añaden automáticamente a una lista estática. Compruebe el comportamiento de pertenencia y proporcione un endpoint alternativo de aplicación o una política explícita de fallo cuando no quede un lector local.AWS Advanced JDBC Wrapper 4.4.0:
fastestResponseselecciona un host mediante el tiempo de respuesta medido. Cargue también el pluginfastestResponseStrategy. Esto no impone una restricción por etiqueta de AZ; no se garantiza que el host más rápido sea local.
El issue #1139 se cerró en May 2025 después de discutir que la función de tiempo de respuesta de 2.5.5 satisfacía la solicitud. No es una petición de función abierta que demuestre que los endpoints personalizados sean la única solución.
Opciones complementarias de la capa Service de Kubernetes
Enrutamiento consciente de topología y enrutamiento consciente de zonas de Istio complementan la selección de endpoints de Service. La escasez de endpoints locales, los cambios de salud y la configuración pueden enviar tráfico a otras AZ. No controlan automáticamente las conexiones externas de DB/cache/Kafka. Una preferencia no garantiza que toda la ruta de lectura permanezca en una sola AZ.
Resumen de combinaciones recomendadas
| Capa | Criterios de selección | Alternativa o mecanismo de respaldo |
|---|---|---|
| Arquitectura | Operaciones independientes por celda y capacidad de las celdas sanas | Un clúster distribuido en varias AZ sigue siendo una opción válida |
| Cambio de tráfico | Pesos de la acción de reenvío del equilibrador y registro de destinos mediante TGB | Route 53 selecciona endpoints de equilibradores |
| Respuesta ante fallos | Zonal shift manual / autoshift habilitado por separado | Las celdas con nodos de trabajo en una AZ necesitan enrutamiento externo entre celdas |
| Actualizaciones | Elegibilidad, compatibilidad y tiempo de recuperación probados | Azul/verde, gestionando la recuperación de datos por separado |
| Lecturas Kafka | Selector de broker y rack del consumidor coincidente | Líder si no hay una réplica local adecuada |
| Lecturas de caché | Estrategia GLIDE adecuada para la frescura de datos y los metadatos de AZ | Verificar la alternativa remota y la carga del primario |
| Lecturas de base de datos | Lista mantenida de lectores locales o selección por tiempo de respuesta | Gestionar la ausencia de lectores locales y las reconexiones |
Mida las referencias de carga, coste y tiempo de recuperación; después ensaye el cambio de tráfico y la reversión fuera de producción. La optimización de la ruta de lectura también puede introducirse de forma independiente: valide la coherencia, las alternativas ante fallos y el coste en un alcance pequeño antes de ampliarlo.
< Anterior: Tekton Pipelines | Índice | Siguiente: Manual de solución de problemas >