Administración de clústeres de Kubernetes
Versiones compatibles: Soporte estándar de EKS para Kubernetes 1.34–1.37 (verificado el 12 de octubre de 2026) Última actualización: October 12, 2026
La administración de clústeres de Kubernetes es una tarea importante que incluye la configuración, el mantenimiento, la supervisión, la resolución de problemas y las actualizaciones del clúster. En este capítulo, exploraremos varios aspectos de la administración de clústeres de Kubernetes y las prácticas recomendadas para la gestión de clústeres en Amazon EKS.
Las operaciones de kubeadm autogestionado y las operaciones del servicio EKS son distintas. EKS no expone hosts del plano de control, manifiestos de Pod estáticos ni acceso directo a etcd. Considere los bloques siguientes como ejemplos independientes, no como un único script que se ejecuta secuencialmente. Compruebe la compatibilidad ascendente y la compatibilidad de los complementos para la versión real del clúster.
Conceptos básicos
- Gestión del ciclo de vida del clúster: Todo el proceso, desde la creación del clúster hasta su retirada
- Gestión del plano de control: Gestión de componentes básicos como el servidor de API, el programador y el administrador de controladores
- Gestión de nodos: Incorporación, eliminación y mantenimiento de nodos de trabajo
- Asignación de recursos: Configuración de la asignación y los límites de recursos para CPU, memoria, almacenamiento, etc.
- Estrategia de actualización: Estrategias de actualización del clúster y las aplicaciones para minimizar el tiempo de inactividad
Tabla de contenido
- Descripción general de la administración de clústeres
- Gestión de componentes del clúster
- Gestión de recursos
- Redes del clúster
- Gestión de autenticación y autorización
- Actualizaciones de clústeres
- Copia de seguridad y recuperación
- Supervisión y registro
- Resolución de problemas
- Administración de clústeres de Amazon EKS
- Prácticas recomendadas para la administración de clústeres
- Conclusión
Configuración del entorno
Se requieren las siguientes herramientas para la administración de clústeres:
Use la guía oficial de instalación de kubectl, manteniendo kubectl dentro de una versión secundaria del servidor de API. Para clústeres autogestionados, instale kubeadm/kubelet desde el repositorio pkgs.k8s.io de la versión secundaria de destino; los antiguos ejemplos de paquetes 1.x.y-00 están obsoletos. Elija una versión exacta del paquete en el repositorio configurado antes de la instalación.
Instale Helm y k9s a partir de sus instrucciones oficiales de Helm y versiones de k9s, comprobando la arquitectura de la plataforma y las sumas de comprobación. La administración de EKS también requiere una AWS CLI autenticada y un eksctl compatible.
kubectl version --client
helm version
k9s version
# Self-managed nodes only, after configuring the target minor repository:
apt-cache madison kubeadm
Descripción general de la administración de clústeres
La administración de clústeres de Kubernetes es el proceso de gestionar todo el ciclo de vida de un clúster. Incluye las siguientes áreas principales:
- Configuración y ajuste del clúster: Creación de clústeres, incorporación de nodos, configuración de redes, configuración de almacenamiento, etc.
- Gestión de operaciones: Supervisión de recursos, optimización del rendimiento, planificación de capacidad, resolución de problemas
- Gestión de seguridad: Autenticación, autorización, políticas de red, contextos de seguridad, etc.
- Actualizaciones y parches: Actualizaciones de versiones del clúster, aplicación de parches de seguridad
- Copia de seguridad y recuperación: Copia de seguridad de los datos del clúster, planificación de recuperación ante desastres
El siguiente diagrama muestra las áreas principales de la administración de clústeres de Kubernetes y las herramientas relacionadas:
Gestión de componentes del clúster
Un clúster de Kubernetes consta de componentes del plano de control y componentes de nodo. Gestionar cada componente es fundamental para la estabilidad y el rendimiento del clúster.
Gestión de componentes del plano de control
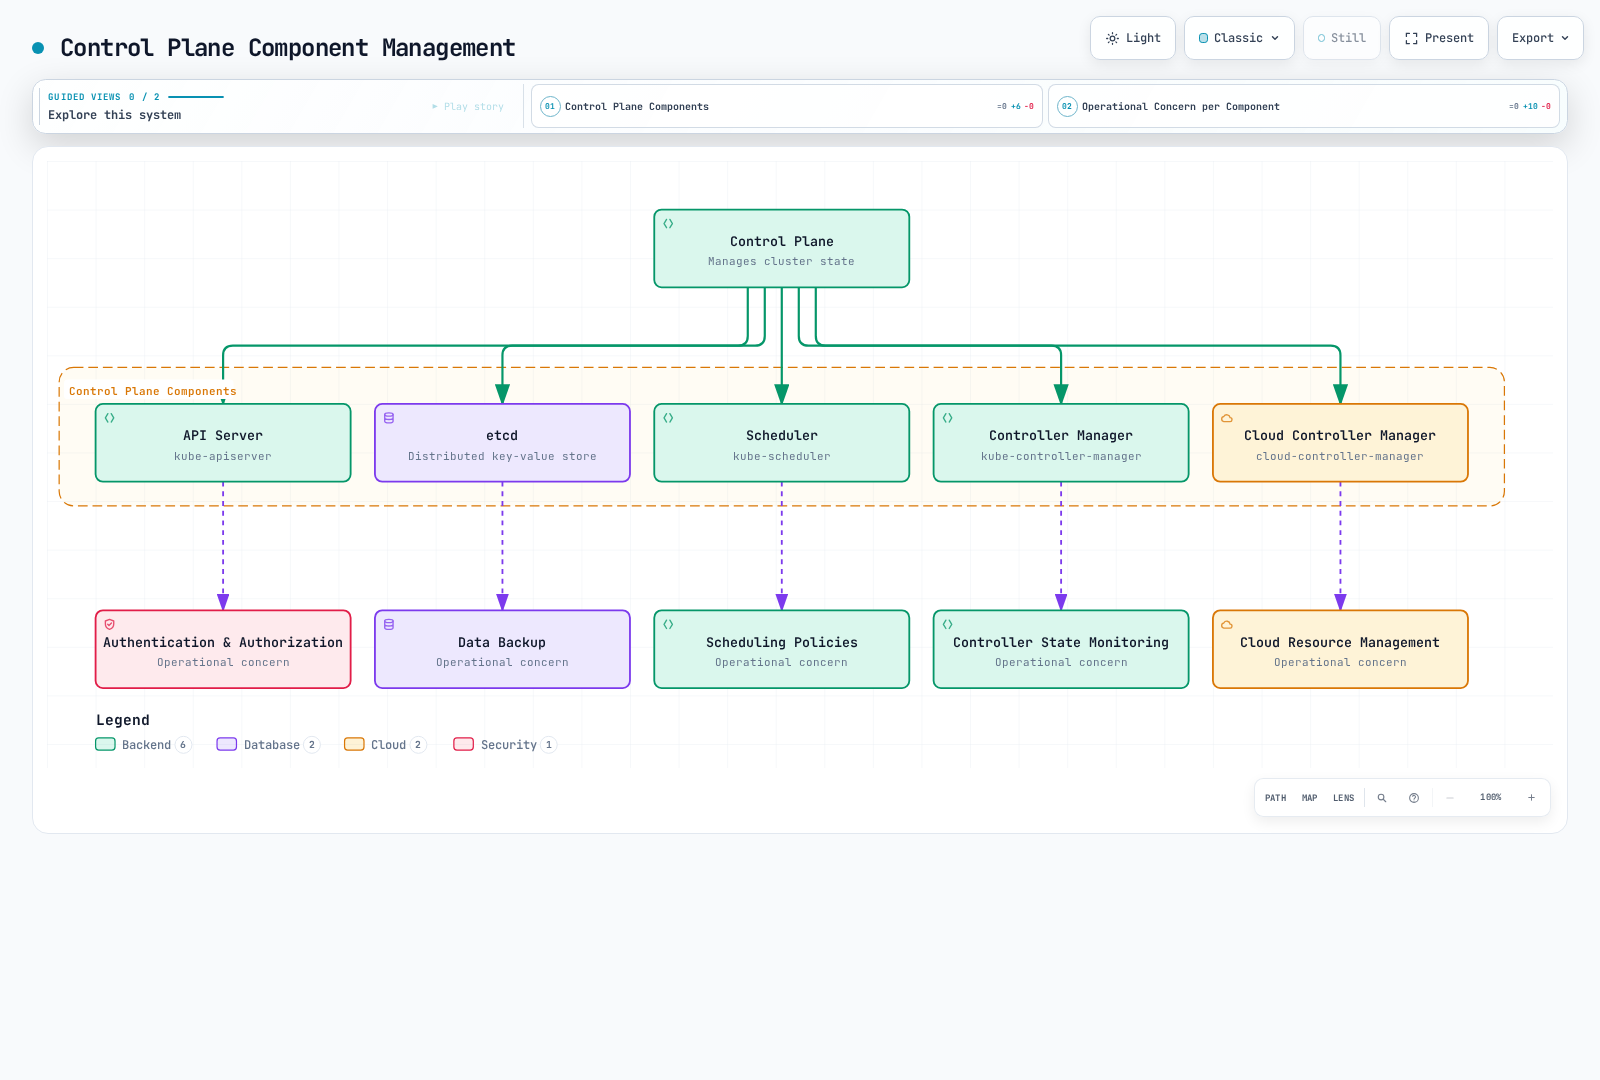
Gestión del servidor de API
El servidor de API es un componente básico del plano de control que expone la API de Kubernetes.
# Check API server logs
kubectl logs -n kube-system kube-apiserver-<master-node-name>

# Check API server configuration (kubeadm cluster)
sudo cat /etc/kubernetes/manifests/kube-apiserver.yaml

# Check API server status
kubectl get --raw='/readyz?verbose'
Gestión de etcd
etcd es un almacén distribuido de clave-valor que guarda el estado de la API de Kubernetes.
# etcd backup
ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key \
  snapshot save /backup/etcd-snapshot-$(date +%Y-%m-%d).db

# Check etcd status
ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key \
  endpoint health
Gestión de nodos
Los nodos son máquinas de trabajo que ejecutan aplicaciones en contenedores.
# List nodes
kubectl get nodes

# Check node detailed information
kubectl describe node <node-name>

# Add node label
kubectl label node <node-name> environment=production

# Set node to maintenance mode
kubectl drain <node-name> --ignore-daemonsets

# Return node after maintenance
kubectl uncordon <node-name>
Supervisión del estado de los componentes
# Check control plane component status
kubectl get --raw='/readyz?verbose'

# Check system pod status
kubectl get pods -n kube-system

# Check node resource usage
kubectl top nodes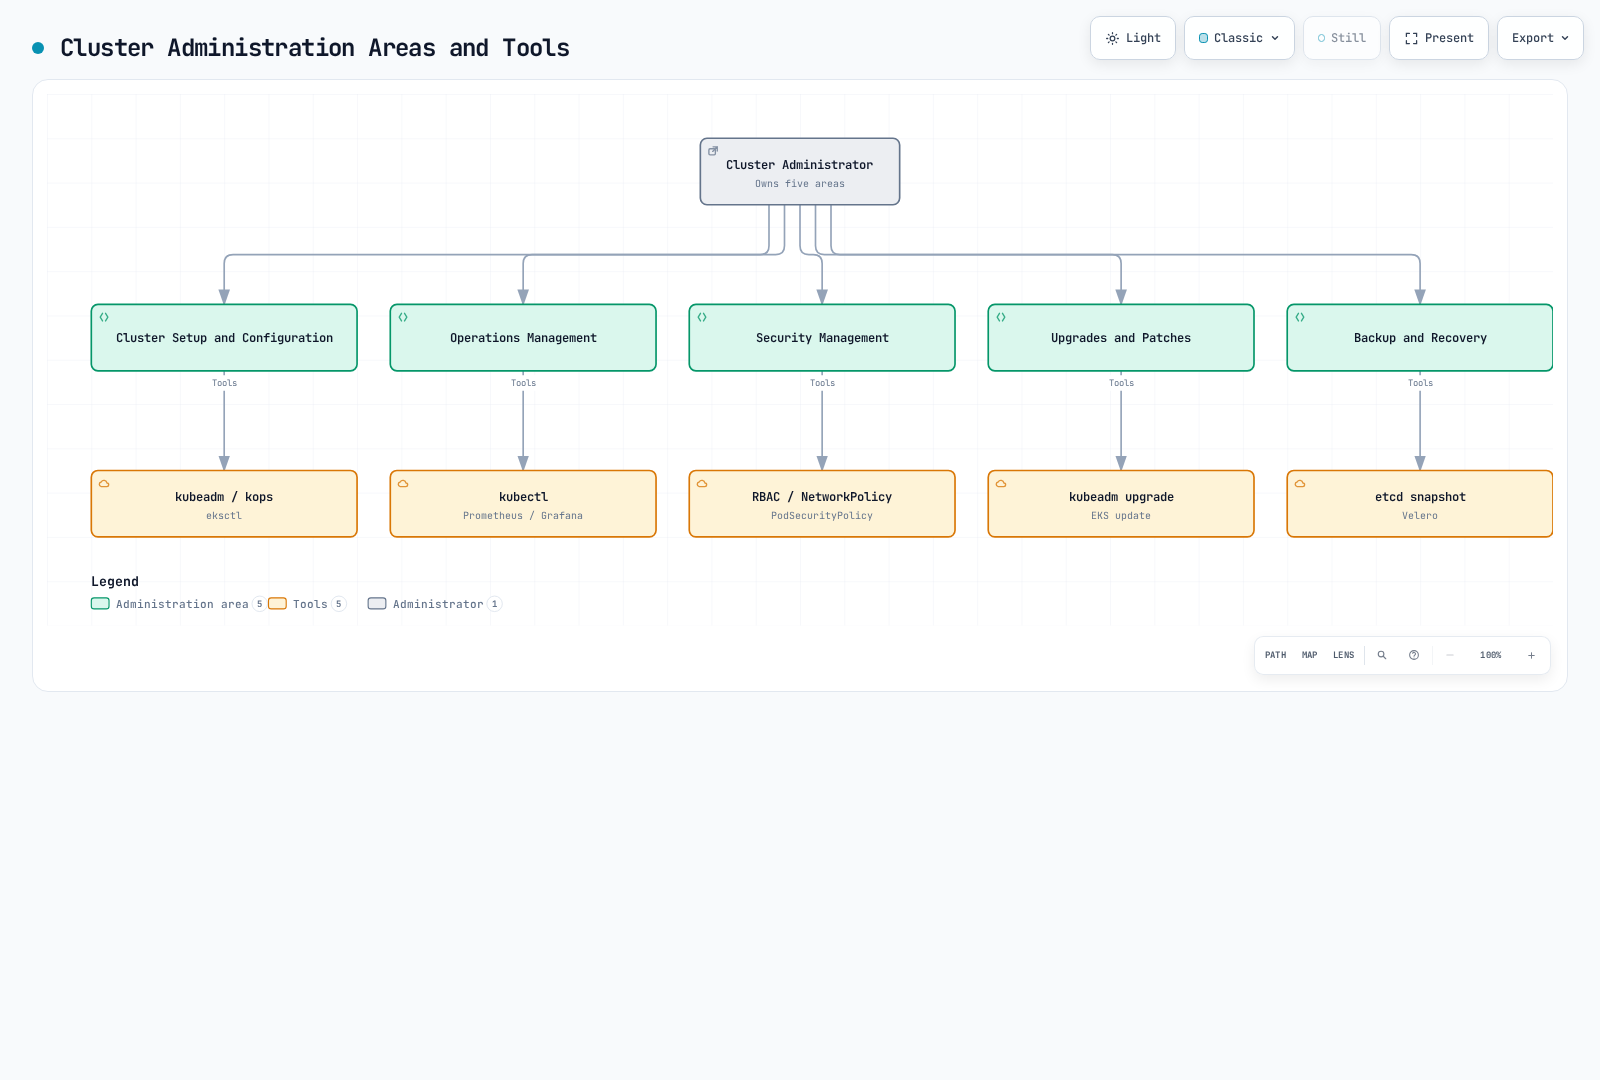
Herramientas de administración de clústeres
Hay varias herramientas disponibles para la administración de clústeres de Kubernetes:
- kubectl: Herramienta de línea de comandos para interactuar con clústeres de Kubernetes
- kubeadm: Herramienta para crear y gestionar clústeres de Kubernetes
- kops: Herramienta para crear, actualizar y gestionar clústeres de Kubernetes
- eksctl: Herramienta para crear y gestionar clústeres de Amazon EKS
- Helm: Gestor de paquetes de aplicaciones de Kubernetes
- Headlamp: IU web de Kubernetes; el antiguo proyecto Kubernetes Dashboard está archivado
- Prometheus & Grafana: Herramientas de supervisión y alertas
- Fluentd & Elasticsearch: Herramientas de registro
Gestión de componentes del clúster
Un clúster de Kubernetes consta de varios componentes, y gestionar estos componentes de forma eficaz es importante.
Componentes del plano de control
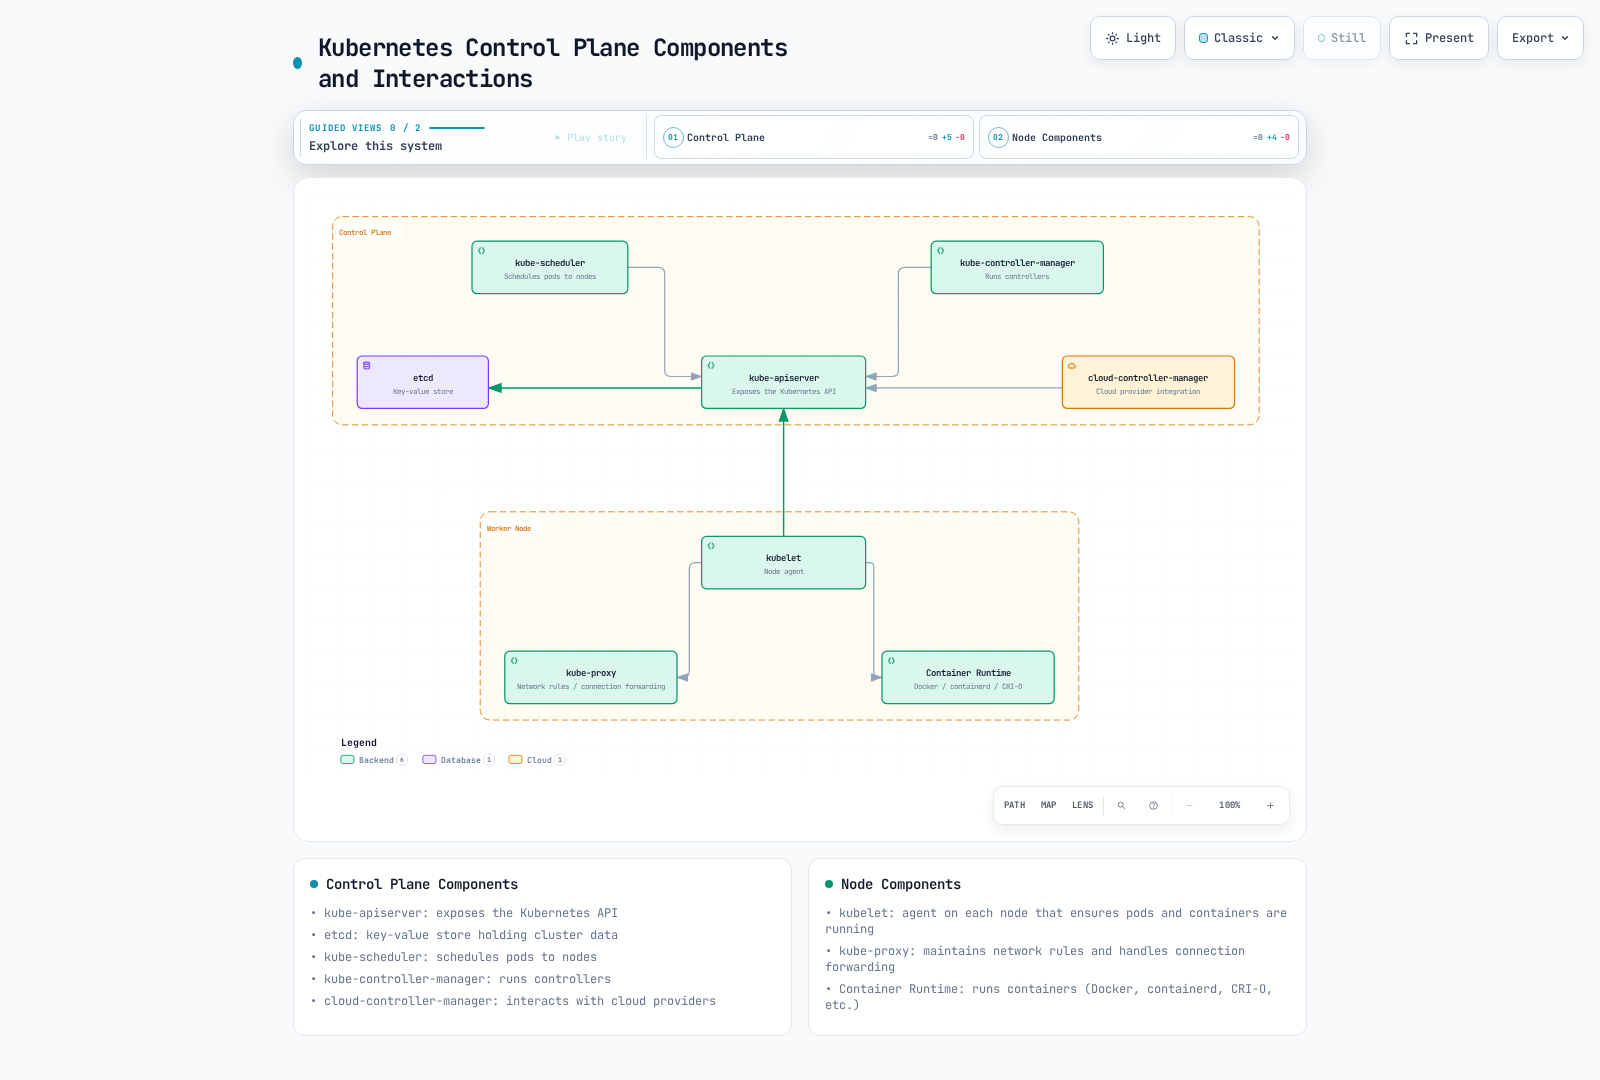
Los componentes del plano de control gestionan el estado general del clúster:
- kube-apiserver: Componente que expone la API de Kubernetes
- etcd: Almacén de clave-valor que guarda los datos del clúster
- kube-scheduler: Componente que programa Pods en nodos
- kube-controller-manager: Componente que ejecuta controladores
- cloud-controller-manager: Componente que interactúa con proveedores de nube
El siguiente diagrama muestra los componentes del plano de control de Kubernetes y sus interacciones:
Supervisión de componentes del plano de control
Es importante supervisar el estado de los componentes del plano de control:
# Check control plane component status
kubectl get --raw='/readyz?verbose'

# Check API server logs
kubectl logs -n kube-system kube-apiserver-<node-name>

# Check etcd status
kubectl exec -n kube-system etcd-<node-name> -- etcdctl \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt \
  --key=/etc/kubernetes/pki/etcd/healthcheck-client.key endpoint health
Configuración de componentes del plano de control
El manifiesto siguiente es solo un fragmento de marcas/configuración. Omite las redes de host, los montajes de certificados y otros ajustes generados por kubeadm; no reemplace un manifiesto de plano de control en ejecución con este fragmento. Haga coincidir la imagen con el plan de actualización del clúster.
Cómo gestionar la configuración de componentes del plano de control:
# kube-apiserver configuration example
apiVersion: v1
kind: Pod
metadata:
  name: kube-apiserver
  namespace: kube-system
spec:
  containers:
  - command:
    - kube-apiserver
    - --advertise-address=192.168.1.10
    - --allow-privileged=true
    - --authorization-mode=Node,RBAC
    - --client-ca-file=/etc/kubernetes/pki/ca.crt
    - --enable-admission-plugins=NodeRestriction
    - --enable-bootstrap-token-auth=true
    - --etcd-cafile=/etc/kubernetes/pki/etcd/ca.crt
    - --etcd-certfile=/etc/kubernetes/pki/apiserver-etcd-client.crt
    - --etcd-keyfile=/etc/kubernetes/pki/apiserver-etcd-client.key
    - --etcd-servers=https://127.0.0.1:2379
    - --kubelet-client-certificate=/etc/kubernetes/pki/apiserver-kubelet-client.crt
    - --kubelet-client-key=/etc/kubernetes/pki/apiserver-kubelet-client.key
    - --kubelet-preferred-address-types=InternalIP,ExternalIP,Hostname
    - --secure-port=6443
    - --service-account-key-file=/etc/kubernetes/pki/sa.pub
    - --service-account-signing-key-file=/etc/kubernetes/pki/sa.key
    - --service-account-issuer=https://kubernetes.default.svc.cluster.local
    - --service-cluster-ip-range=10.96.0.0/12
    - --tls-cert-file=/etc/kubernetes/pki/apiserver.crt
    - --tls-private-key-file=/etc/kubernetes/pki/apiserver.key
    image: registry.k8s.io/kube-apiserver:v1.36.4
    name: kube-apiserver
Componentes de nodo
Los componentes de nodo se ejecutan en cada nodo y gestionan Pods:
- kubelet: Agente que se ejecuta en cada nodo y garantiza que los Pods y contenedores estén en ejecución
- kube-proxy: Mantiene reglas de red y gestiona el reenvío de conexiones
- Container Runtime: Software que ejecuta contenedores (containerd, CRI-O o Docker Engine con un adaptador CRI externo)
Gestión de nodos
Comandos clave para la gestión de nodos:
# List nodes
kubectl get nodes

# Check node detailed information
kubectl describe node <node-name>

# Add node label
kubectl label node <node-name> key=value

# Add node taint
kubectl taint node <node-name> key=value:NoSchedule

# Set node to maintenance mode
kubectl cordon <node-name>

# Drain node
kubectl drain <node-name> --ignore-daemonsets
El drenaje puede detenerse en Pods independientes, PDB o datos locales. Investigue en lugar de agregar --force o --delete-emptydir-data de forma predeterminada; este último autoriza explícitamente la pérdida de datos de emptyDir. Espere a que el drenaje y la salud de las cargas de trabajo sean correctos antes del mantenimiento.
Resolución de problemas de nodos
Comandos para resolver problemas de nodos:
# Check node status
kubectl describe node <node-name> | grep Conditions -A 10

# Check node resource usage
kubectl top node <node-name>

# Check kubelet logs
journalctl -u kubelet

# Check container runtime status
systemctl status docker  # When using Docker
systemctl status containerd  # When using containerd
Gestión de recursos
Gestionar eficazmente los recursos de un clúster de Kubernetes es importante para mantener la estabilidad y el rendimiento del clúster.
Gestión de Namespace
Use un Namespace desechable para practicar operaciones de ciclo de vida. Eliminar un Namespace elimina sus recursos con ámbito de Namespace; inspeccione y haga una copia de seguridad de los datos necesarios primero. get all es solo un subconjunto de cargas de trabajo.
kubectl create namespace admin-demo
kubectl get all -n admin-demo
# Cleanup only the disposable exercise namespace:
kubectl delete namespace admin-demo
Cuotas de recursos
Las cuotas de recursos limitan el uso de recursos por Namespace:
apiVersion: v1
kind: ResourceQuota
metadata:
  name: compute-resources
  namespace: dev
spec:
  hard:
    requests.cpu: "1"
    requests.memory: 1Gi
    limits.cpu: "2"
    limits.memory: 2Gi
    pods: "10"
En el ejemplo anterior, el Namespace dev puede tener un máximo de 10 Pods, solicitudes de 1 CPU y 1Gi de memoria, y límites de 2 CPU y 2Gi de memoria.
Rangos de límites
Los rangos de límites establecen valores predeterminados y límites para los recursos individuales dentro de un Namespace:
apiVersion: v1
kind: LimitRange
metadata:
  name: limit-range
  namespace: dev
spec:
  limits:
  - default:
      cpu: 500m
      memory: 512Mi
    defaultRequest:
      cpu: 200m
      memory: 256Mi
    max:
      cpu: 1
      memory: 1Gi
    min:
      cpu: 100m
      memory: 128Mi
    type: Container
En el ejemplo anterior, todos los contenedores del Namespace dev tienen límites predeterminados de 500m de CPU y 512Mi de memoria, solicitudes predeterminadas de 200m de CPU y 256Mi de memoria, un máximo de 1 CPU y 1Gi de memoria, y un mínimo de 100m de CPU y 128Mi de memoria.
Horizontal Pod Autoscaler (HPA)
HPA ajusta automáticamente el número de Pods según el uso de CPU o métricas personalizadas:
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: frontend-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: frontend
  minReplicas: 2
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80
En el ejemplo anterior, el Deployment frontend tiene como objetivo una utilización media de CPU del 80 % de la CPU solicitada, sujeta a tolerancia, métricas faltantes, ventanas de estabilización y políticas de escalado. Mantiene un mínimo de 2 y un máximo de 10 réplicas.
Vertical Pod Autoscaler (VPA)
VPA ajusta automáticamente las solicitudes de CPU y memoria de los Pods:
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: frontend-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: frontend
  updatePolicy:
    updateMode: "Recreate"
En el ejemplo anterior, los Pods del Deployment frontend tienen sus solicitudes de CPU y memoria ajustadas automáticamente según el uso real de recursos.
Redes del clúster
Las redes de clúster de Kubernetes gestionan la comunicación entre Pods, servicios y nodos.
Modelo de red del clúster
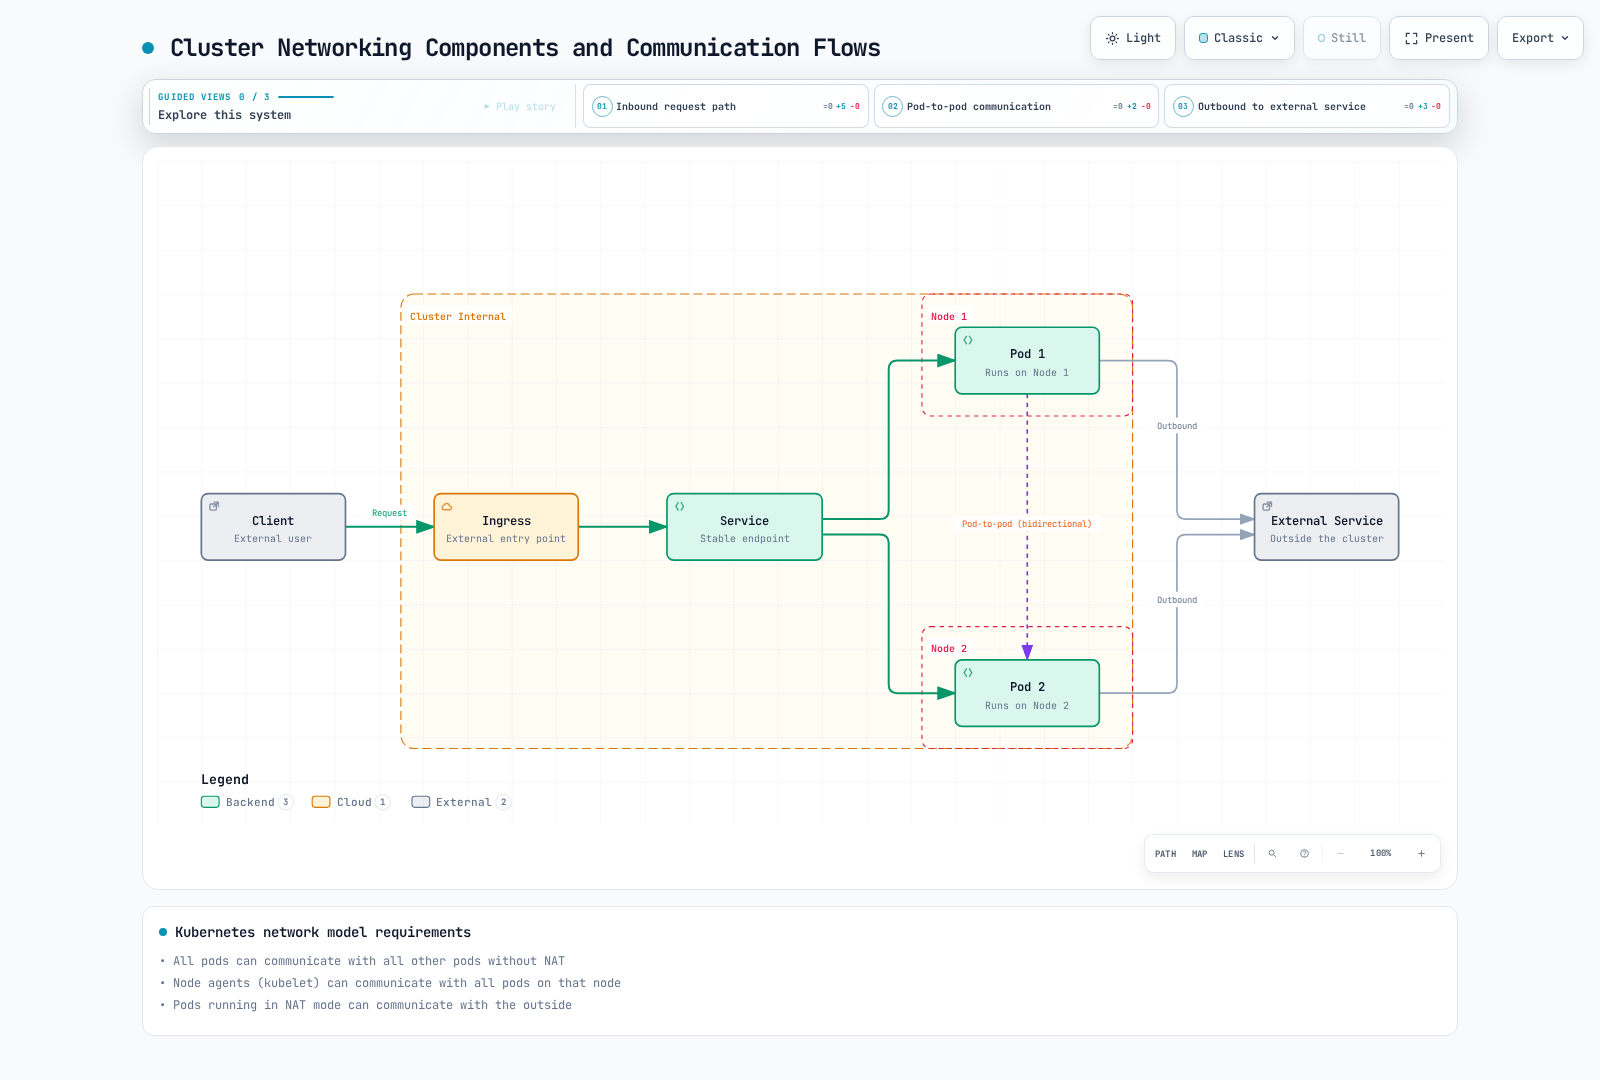
Requisitos básicos del modelo de red de Kubernetes:
- Todos los Pods pueden comunicarse con todos los demás Pods sin NAT
- Los agentes de nodo (kubelet) pueden comunicarse con todos los Pods de ese nodo
- La conectividad externa depende de la política de enrutamiento y salida; no hay un requisito universal de modo NAT para Pod
El siguiente diagrama muestra los componentes de red de Kubernetes y los flujos de comunicación:
Complementos CNI (Container Network Interface)
Kubernetes implementa las redes mediante complementos CNI. Complementos CNI comunes:
- Calico: CNI con funciones mejoradas de política de red y seguridad
- Flannel: Proporciona redes de superposición sencillas
- Cilium: Solución de redes y seguridad basada en eBPF
- AWS VPC CNI: CNI integrado con AWS VPC
- Weave Net (histórico): Archivado; elija una alternativa mantenida para instalaciones nuevas
Instalación y configuración de complementos CNI
Ejemplo de instalación de complemento CNI (Calico):
Elija un CNI o una configuración documentada de encadenamiento/migración. Las alternativas Calico, Flannel y Cilium no deben instalarse secuencialmente en el mismo clúster en ejecución. Use una versión compatible y fijada, y las instrucciones específicas del proveedor; en EKS, siga el procedimiento de VPC CNI o de CNI alternativo planificado en el capítulo de redes.
# Inspect the installed networking components before making changes
kubectl get daemonsets -A
kubectl get pods -A -l k8s-app=calico-node
Redes de Service
Los Services de Kubernetes proporcionan puntos de conexión estables para conjuntos de Pods:
- ClusterIP: Service accesible solo dentro del clúster
- NodePort: Service accesible a través de un puerto específico en todos los nodos
- LoadBalancer: Service accesible a través de un equilibrador de carga externo
- ExternalName: Proporciona un registro CNAME para servicios externos
Configuración de CIDR de Service
El CIDR de Service define el rango de direcciones IP de Service:
# Set service CIDR in kube-apiserver configuration
--service-cluster-ip-range=10.96.0.0/12
Gestión de CoreDNS
CoreDNS proporciona servicios DNS para Kubernetes:
# Check CoreDNS status
kubectl get pods -n kube-system -l k8s-app=kube-dns

# Check CoreDNS configuration
kubectl get configmap -n kube-system coredns -o yaml
Ejemplo de configuración de CoreDNS:
apiVersion: v1
kind: ConfigMap
metadata:
  name: coredns
  namespace: kube-system
data:
  Corefile: |
    .:53 {
        errors
        health {
           lameduck 5s
        }
        ready
        kubernetes cluster.local in-addr.arpa ip6.arpa {
           pods insecure
           fallthrough in-addr.arpa ip6.arpa
           ttl 30
        }
        prometheus :9153
        forward . /etc/resolv.conf
        cache 30
        loop
        reload
        loadbalance
    }
Políticas de red
Las políticas de red controlan la comunicación entre Pods:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: db-network-policy
  namespace: default
spec:
  podSelector:
    matchLabels:
      role: db
  policyTypes:
  - Ingress
  - Egress
  ingress:
  - from:
    - podSelector:
        matchLabels:
          role: frontend
    ports:
    - protocol: TCP
      port: 3306
  egress:
  - to:
    - podSelector:
        matchLabels:
          role: monitoring
    ports:
    - protocol: TCP
      port: 9090
En el ejemplo anterior, los Pods con la etiqueta role=db solo permiten tráfico entrante en el puerto TCP 3306 desde Pods con la etiqueta role=frontend y tráfico saliente en el puerto TCP 9090 hacia Pods con la etiqueta role=monitoring.
Gestión de autenticación y autorización
La gestión de autenticación y autorización de Kubernetes es un elemento central de la seguridad del clúster.
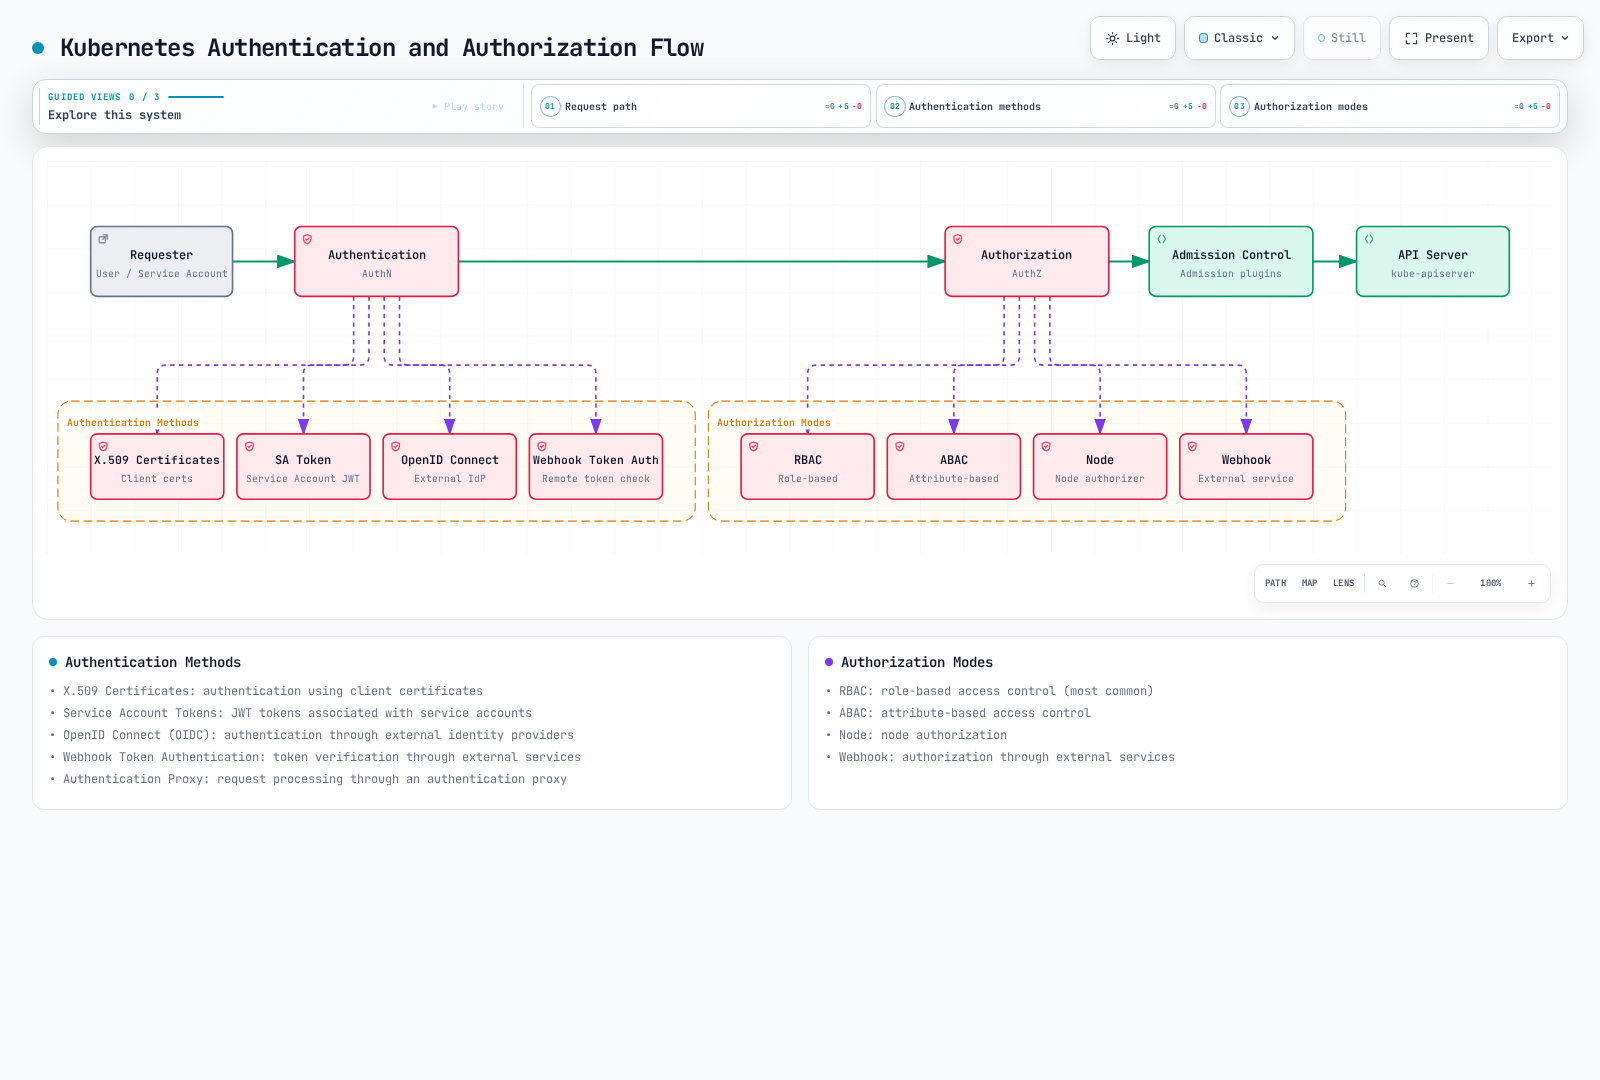
El siguiente diagrama muestra el flujo de autenticación y autorización de Kubernetes:
Autenticación
Kubernetes admite varios métodos de autenticación:
- Certificados X.509: Autenticación mediante certificados de cliente
- Tokens de Service Account: Tokens JWT asociados a cuentas de servicio
- OpenID Connect (OIDC): Autenticación mediante proveedores de identidad externos
- Autenticación de tokens mediante Webhook: Verificación de tokens mediante servicios externos
- Proxy de autenticación: Procesamiento de solicitudes mediante proxy de autenticación
Gestión de certificados X.509
Creación y gestión de certificados X.509:
# Generate a protected private key and CSR
umask 077
openssl genrsa -out user.key 2048
openssl req -new -key user.key -out user.csr -subj "/CN=user/O=group"

# Submit CSR to Kubernetes
cat <<EOF | kubectl apply -f -
apiVersion: certificates.k8s.io/v1
kind: CertificateSigningRequest
metadata:
  name: user-csr
spec:
  request: $(cat user.csr | base64 | tr -d '\n')
  signerName: kubernetes.io/kube-apiserver-client
  usages:
  - client auth
EOF

# Approve CSR
kubectl certificate approve user-csr
kubectl wait --for=jsonpath='{.status.certificate}' csr/user-csr --timeout=60s

# Get certificate
kubectl get csr user-csr -o jsonpath='{.status.certificate}' | base64 --decode > user.crt
Configuración de autenticación OIDC
Ejemplo de configuración de autenticación OIDC:
# Add OIDC flags to kube-apiserver configuration
--oidc-issuer-url=https://accounts.google.com
--oidc-client-id=kubernetes
--oidc-username-claim=email
--oidc-groups-claim=groups
Autorización
Kubernetes admite varios modos de autorización:
- RBAC (Role-Based Access Control): Control de acceso basado en roles
- ABAC (Attribute-Based Access Control): Control de acceso basado en atributos
- Node: Autorización de nodos
- Webhook: Autorización mediante servicios externos
Configuración de RBAC
RBAC es el mecanismo de autorización más común:
# Role example
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  namespace: default
  name: pod-reader
rules:
- apiGroups: [""]
  resources: ["pods"]
  verbs: ["get", "watch", "list"]

# RoleBinding example
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: read-pods
  namespace: default
subjects:
- kind: User
  name: user
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: Role
  name: pod-reader
  apiGroup: rbac.authorization.k8s.io
En el ejemplo anterior, user tiene permiso para ver Pods en el Namespace default.
ClusterRole y ClusterRoleBinding
Gestiona permisos para recursos de todo el clúster:
# ClusterRole example
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  name: node-reader
rules:
- apiGroups: [""]
  resources: ["nodes"]
  verbs: ["get", "watch", "list"]

# ClusterRoleBinding example
---
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: read-nodes
subjects:
- kind: User
  name: user
  apiGroup: rbac.authorization.k8s.io
roleRef:
  kind: ClusterRole
  name: node-reader
  apiGroup: rbac.authorization.k8s.io
En el ejemplo anterior, user tiene permiso para ver todos los nodos del clúster.
Gestión de Service Account
Las cuentas de servicio son usadas por los Pods para comunicarse con el servidor de API:
# Create service account
apiVersion: v1
kind: ServiceAccount
metadata:
  name: my-service-account
  namespace: default

# Grant permissions to service account
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: my-service-account-binding
  namespace: default
subjects:
- kind: ServiceAccount
  name: my-service-account
  namespace: default
roleRef:
  kind: Role
  name: pod-reader
  apiGroup: rbac.authorization.k8s.io

# Use service account in pod
---
apiVersion: v1
kind: Pod
metadata:
  name: my-pod
spec:
  serviceAccountName: my-service-account
  containers:
  - name: my-container
    image: nginx
Contexto de seguridad
El contexto de seguridad define permisos y control de acceso para Pods y contenedores:
apiVersion: v1
kind: Pod
metadata:
  name: security-context-pod
spec:
  securityContext:
    runAsUser: 1000
    runAsGroup: 3000
    fsGroup: 2000
    runAsNonRoot: true
    seccompProfile:
      type: RuntimeDefault
  containers:
  - name: security-context-container
    image: busybox:1.36
    command: ["sh", "-c", "sleep 3600"]
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      readOnlyRootFilesystem: true
En el ejemplo anterior, el Pod se ejecuta con UID 1000 y GID 3000, y el contenedor no puede escalar privilegios, tiene todas las capacidades de Linux eliminadas y tiene el sistema de archivos raíz montado como de solo lectura.
Actualizaciones de clústeres
Las actualizaciones de clústeres de Kubernetes son necesarias para aplicar características nuevas, mejoras de rendimiento y parches de seguridad.
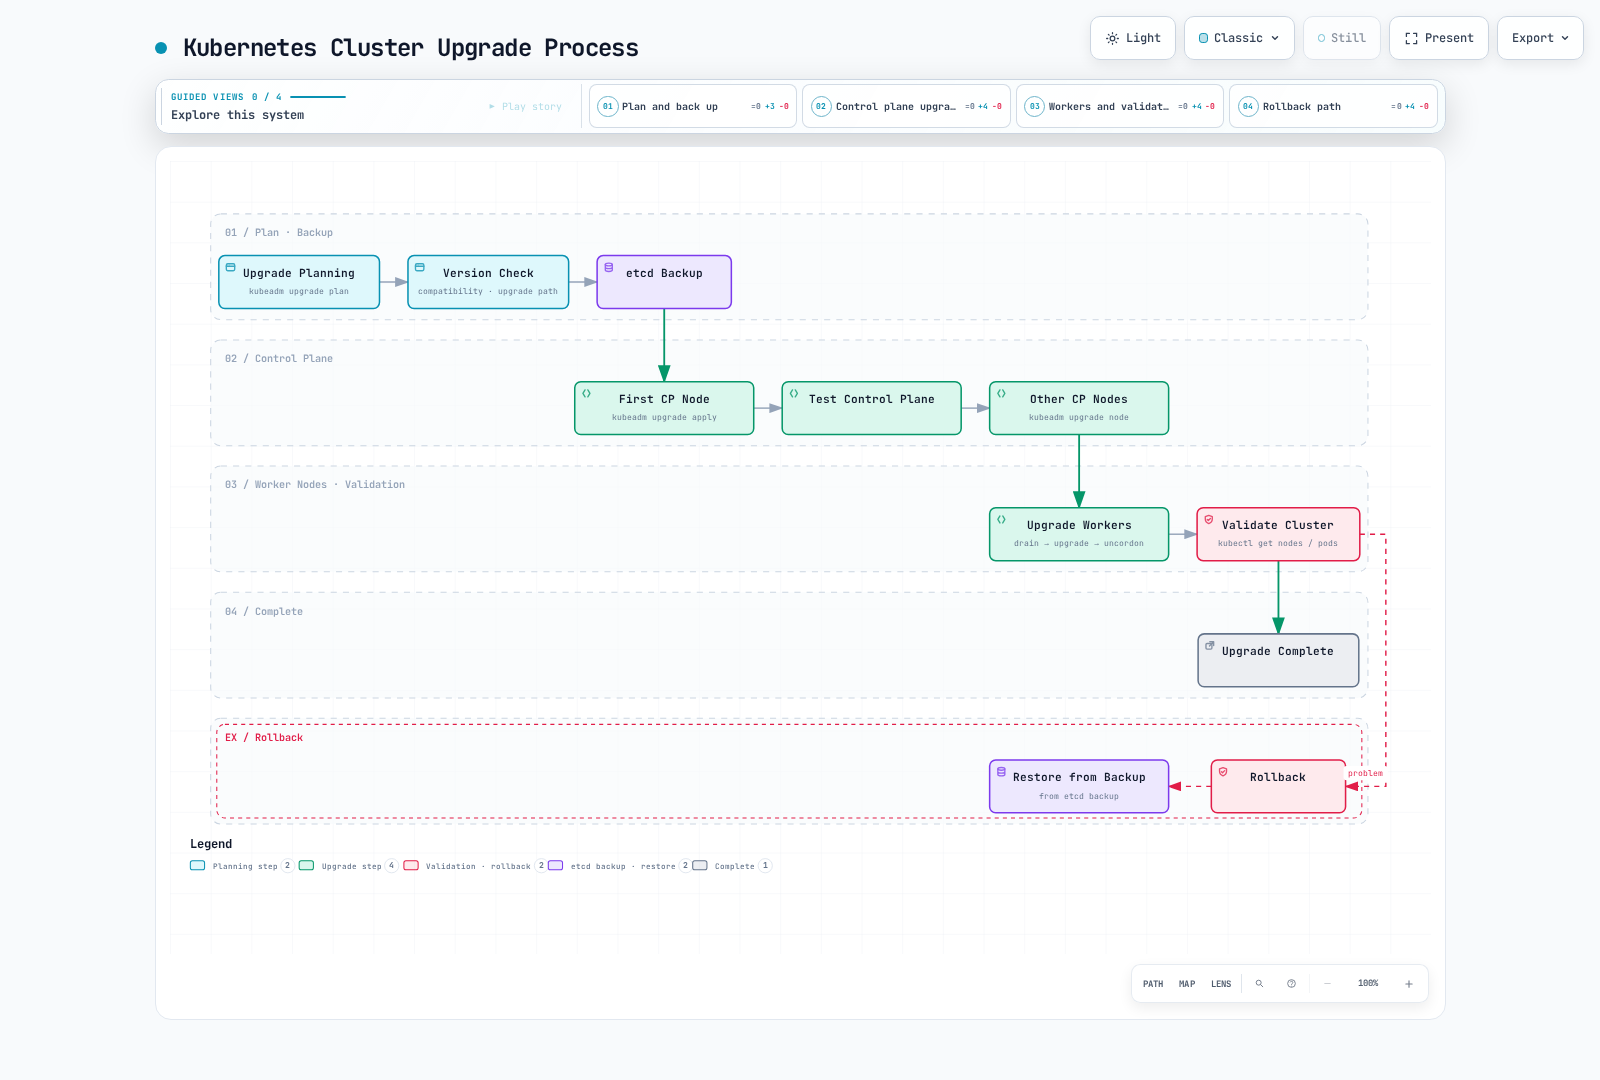
El siguiente diagrama muestra el proceso de actualización de clústeres de Kubernetes:
Planificación de actualizaciones
Consideraciones al planificar actualizaciones de clústeres:
- Compatibilidad de versiones: Compruebe la compatibilidad entre versiones de Kubernetes
- Ruta de actualización: Compruebe las rutas de actualización admitidas
- Tiempo de inactividad: Planifique el tiempo de inactividad previsto durante la actualización
- Plan de reversión: Desarrolle un plan de reversión en caso de problemas
- Impacto en las aplicaciones: Evalúe el impacto de las actualizaciones en las aplicaciones
Actualización del plano de control
Actualización del plano de control mediante kubeadm:
Use el procedimiento de actualización de kubeadm específico de la versión. Habilite el repositorio pkgs.k8s.io de la versión secundaria de destino y seleccione una versión exacta de paquete publicada; actualice una versión secundaria cada vez.
- Haga una copia de seguridad de etcd y valide la compatibilidad de las cargas de trabajo y los complementos. En el primer nodo del plano de control, actualice kubeadm, ejecute
kubeadm upgrade plany, después,kubeadm upgrade apply <target-version>. - En nodos adicionales del plano de control, actualice kubeadm y ejecute
kubeadm upgrade node. - Drene cada nodo antes de actualizar su kubelet. Si el drenaje falla, detenga el procedimiento y resuelva la causa. Actualice kubelet/kubectl a versiones compatibles, recargue systemd, reinicie kubelet, verifique Ready y las cargas de trabajo, y después ejecute uncordon desde un cliente administrativo.
- En cada nodo de trabajo, actualice kubeadm y ejecute
kubeadm upgrade node; después realice la secuencia de drenaje/kubelet/verificación/uncordon. No ejecute una actualización genérica de todo el sistema como sustituto del procedimiento de Kubernetes específico de la versión.
Ejecute los comandos en el nodo identificado explícitamente o en el cliente administrativo; una secuencia de sesiones ssh anidadas no es un script de automatización multinodo.
Actualización de nodos de trabajo
Proceso de actualización de nodos de trabajo:
Use el procedimiento de actualización de kubeadm específico de la versión. Habilite el repositorio pkgs.k8s.io de la versión secundaria de destino y seleccione una versión exacta de paquete publicada; actualice una versión secundaria cada vez.
- Haga una copia de seguridad de etcd y valide la compatibilidad de las cargas de trabajo y los complementos. En el primer nodo del plano de control, actualice kubeadm, ejecute
kubeadm upgrade plany, después,kubeadm upgrade apply <target-version>. - En nodos adicionales del plano de control, actualice kubeadm y ejecute
kubeadm upgrade node. - Drene cada nodo antes de actualizar su kubelet. Si el drenaje falla, detenga el procedimiento y resuelva la causa. Actualice kubelet/kubectl a versiones compatibles, recargue systemd, reinicie kubelet, verifique Ready y las cargas de trabajo, y después ejecute uncordon desde un cliente administrativo.
- En cada nodo de trabajo, actualice kubeadm y ejecute
kubeadm upgrade node; después realice la secuencia de drenaje/kubelet/verificación/uncordon. No ejecute una actualización genérica de todo el sistema como sustituto del procedimiento de Kubernetes específico de la versión.
Ejecute los comandos en el nodo identificado explícitamente o en el cliente administrativo; una secuencia de sesiones ssh anidadas no es un script de automatización multinodo.
Verificación de actualizaciones
Verifique el estado del clúster después de la actualización:
# Check node versions
kubectl get nodes

# Check component status
kubectl get --raw='/readyz?verbose'

# Check pod status
kubectl get pods --all-namespaces

# Test cluster functionality
kubectl create deployment nginx --image=nginx
kubectl expose deployment nginx --port=80
kubectl get svc nginx
Copia de seguridad y recuperación
La copia de seguridad y recuperación de clústeres de Kubernetes es una parte importante de la planificación de recuperación ante desastres.
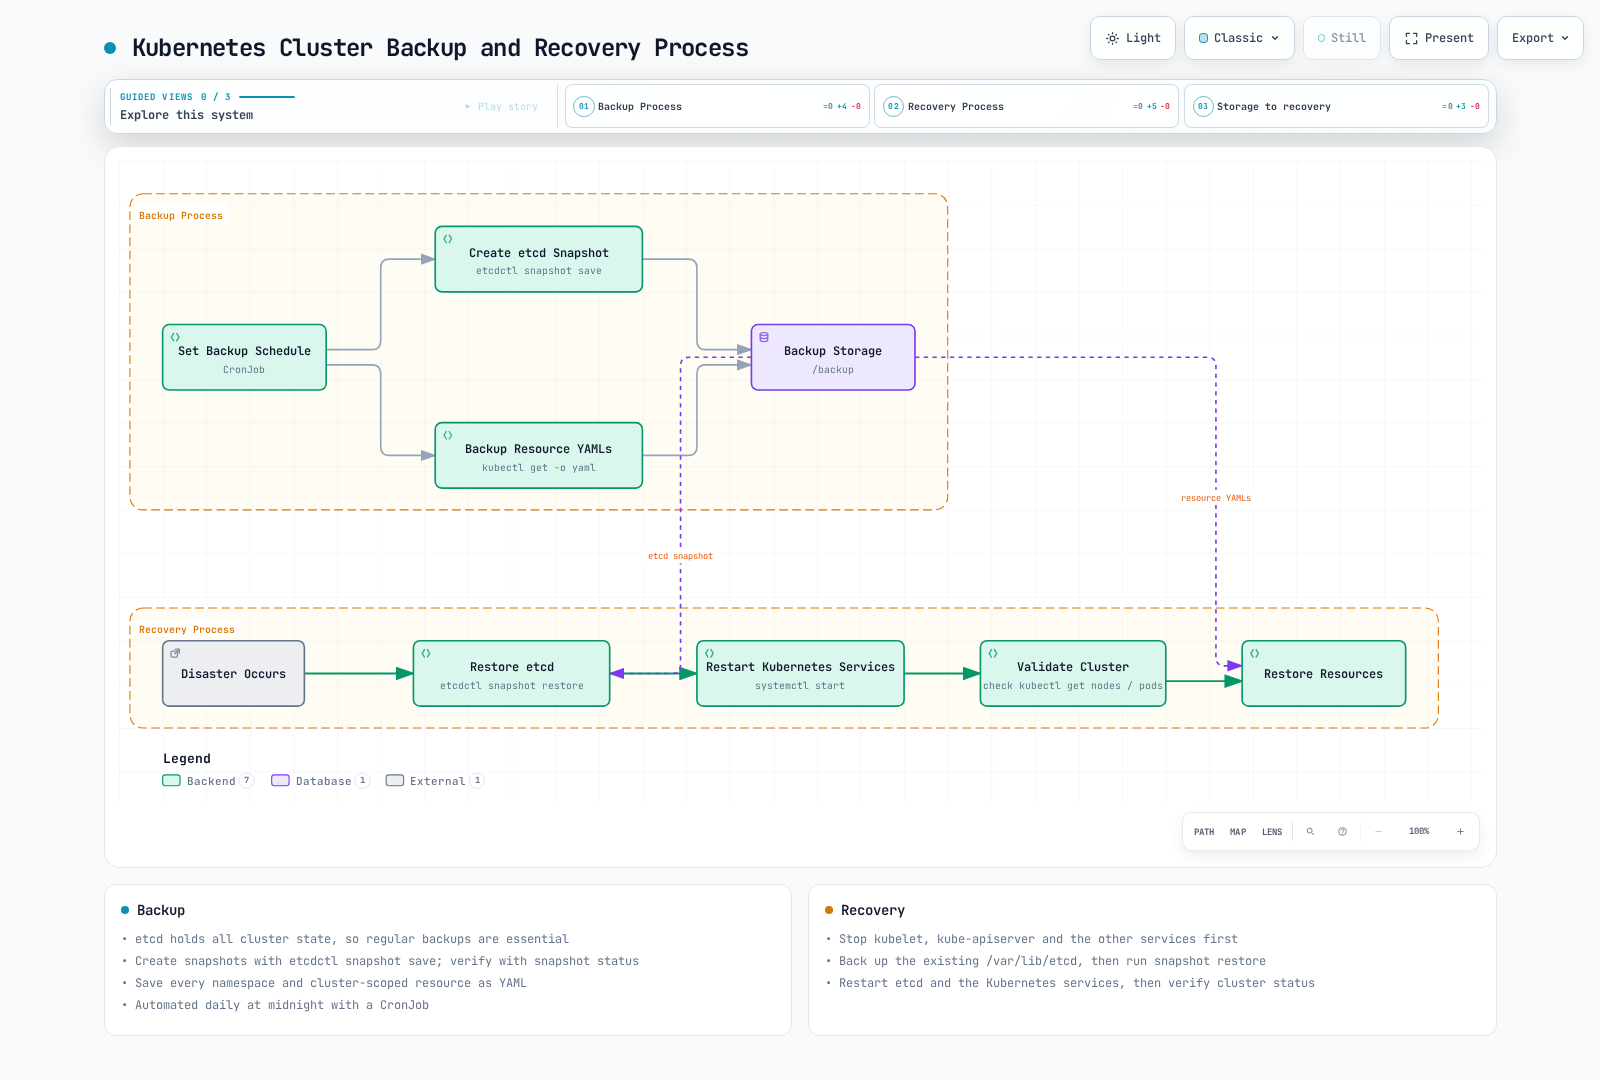
El siguiente diagrama muestra el proceso de copia de seguridad y recuperación de clústeres de Kubernetes:
Copia de seguridad de etcd
etcd guarda toda la información de estado del clúster de Kubernetes, por lo que las copias de seguridad periódicas son importantes:
# Create etcd snapshot
ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt \
  --key=/etc/kubernetes/pki/etcd/server.key \
  snapshot save /backup/etcd-snapshot-$(date +%Y-%m-%d-%H-%M-%S).db

# Check snapshot status
etcdutl snapshot status --write-out=table /backup/etcd-snapshot-2023-01-01-12-00-00.db
Recuperación de etcd
Restaure desde una instantánea de etcd:
Para la recuperación ante desastres autogestionada, detenga todos los servidores de API y los procesos de etcd afectados mediante el runbook específico de la distribución. Detener solo kubelet deja en ejecución los contenedores de Pod estáticos existentes. Restaure en un directorio nuevo con un etcdutl compatible; preserve los datos originales hasta verificar la recuperación. Este comando para un solo miembro es una ilustración, no una restauración de HA con varios miembros:
etcdutl snapshot status "$SNAPSHOT_FILE" --write-out=table
etcdutl snapshot restore "$SNAPSHOT_FILE" \
  --data-dir=/var/lib/etcd-restore \
  --name=etcd-1 \
  --initial-cluster=etcd-1=https://127.0.0.1:2380 \
  --initial-cluster-token=restored-cluster \
  --initial-advertise-peer-urls=https://127.0.0.1:2380 \
  --bump-revision=1000000000 --mark-compacted
Establezca SNAPSHOT_FILE en la instantánea verificada. Para HA, restaure la misma instantánea en cada miembro con su nombre/URL de par único y la misma lista completa de miembros. Elija un incremento de revisión que supere los cambios desde la instantánea. Actualice el manifiesto/servicio de etcd a la ruta restaurada con la propiedad y los certificados correctos, verifique el quórum/la salud y después reinicie los servidores de API/controladores. Consulte la guía oficial de recuperación. Los usuarios de EKS no pueden restaurar directamente etcd del plano de control administrado.
Copia de seguridad de recursos
Estas exportaciones son inventarios protegidos, no un plan de restauración portátil completo. Incluyen Secrets, necesitan permisos restringidos/cifrado y no incluyen datos de PV. Use umask 077 y compruebe cada error de comando; restaure CRD/dependencias en orden y elimine los metadatos propiedad del servidor según corresponda. kubectl get all solo devuelve un subconjunto de tipos de recursos.
Haga una copia de seguridad de recursos de Kubernetes como archivos YAML:
# Export listable resources (includes sensitive Secrets)
set -eu
umask 077
for ns in $(kubectl get ns -o jsonpath='{.items[*].metadata.name}'); do
  mkdir -p /backup/resources/$ns
  for resource in $(kubectl api-resources --verbs=list --namespaced=true -o name); do
    kubectl get -n "$ns" "$resource" -o yaml > "/backup/resources/$ns/$resource.yaml"
  done
done

# Backup cluster-scoped resources
mkdir -p /backup/resources/cluster-scoped
for resource in $(kubectl api-resources --verbs=list --namespaced=false -o name); do
  kubectl get "$resource" -o yaml > "/backup/resources/cluster-scoped/$resource.yaml"
done
Automatización de copias de seguridad
Ejemplo solo para kubeadm autogestionado: reemplace la imagen de herramientas por una imagen verificada que contenga un etcdctl compatible, haga coincidir la etiqueta/taint del plano de control y las rutas de certificados, y cree el PVC de copia de seguridad. El host seleccionado debe exponer etcd en la dirección de bucle invertido indicada y permitir el montaje del PVC. Esto no se ejecuta en el plano de control administrado de EKS. Verifique la instantánea y cópiela al almacenamiento externo protegido; un PVC dentro del clúster por sí solo no es recuperación ante desastres.
Automatice tareas de copia de seguridad con CronJob:
apiVersion: batch/v1
kind: CronJob
metadata:
  name: etcd-backup
  namespace: kube-system
spec:
  concurrencyPolicy: Forbid
  schedule: "0 0 * * *"  # Run daily at midnight
  jobTemplate:
    spec:
      template:
        spec:
          hostNetwork: true
          automountServiceAccountToken: false
          nodeSelector:
            node-role.kubernetes.io/control-plane: ""
          tolerations:
          - key: node-role.kubernetes.io/control-plane
            operator: Exists
            effect: NoSchedule
          containers:
          - name: etcd-backup
            image: example.invalid/etcd-backup-tools:replace-me
            command:
            - /bin/sh
            - -c
            - |
              set -eu
              umask 077
              ETCDCTL_API=3 etcdctl --endpoints=https://127.0.0.1:2379 \
                --cacert=/etc/kubernetes/pki/etcd/ca.crt \
                --cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt \
                --key=/etc/kubernetes/pki/etcd/healthcheck-client.key \
                snapshot save /backup/etcd-snapshot-$(date +%Y-%m-%d-%H-%M-%S).db
            volumeMounts:
            - name: etcd-ca
              mountPath: /etc/kubernetes/pki/etcd/ca.crt
              readOnly: true
            - name: etcd-client-cert
              mountPath: /etc/kubernetes/pki/etcd/healthcheck-client.crt
              readOnly: true
            - name: etcd-client-key
              mountPath: /etc/kubernetes/pki/etcd/healthcheck-client.key
              readOnly: true
            - name: backup
              mountPath: /backup
          restartPolicy: OnFailure
          volumes:
          - name: etcd-ca
            hostPath:
              path: /etc/kubernetes/pki/etcd/ca.crt
              type: File
          - name: etcd-client-cert
            hostPath:
              path: /etc/kubernetes/pki/etcd/healthcheck-client.crt
              type: File
          - name: etcd-client-key
            hostPath:
              path: /etc/kubernetes/pki/etcd/healthcheck-client.key
              type: File
          - name: backup
            persistentVolumeClaim:
              claimName: etcd-backup-pvc
Supervisión y registro
La supervisión y el registro eficaces son un elemento central de la administración de clústeres.
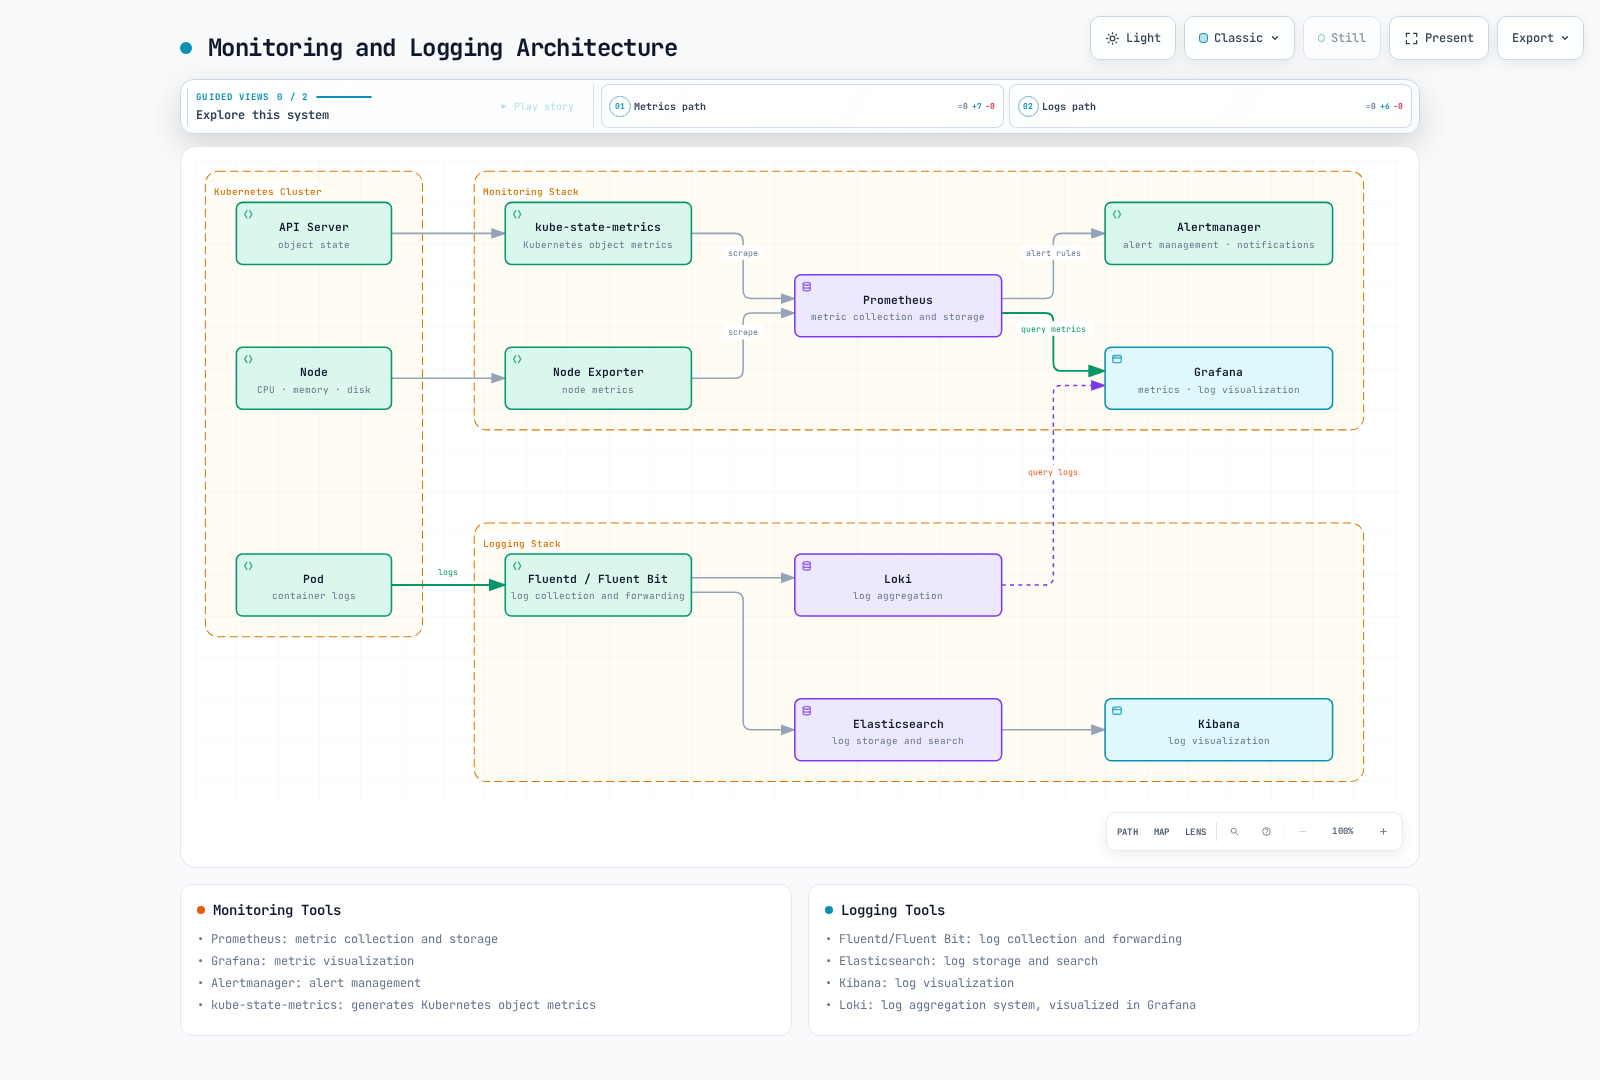
El siguiente diagrama muestra la arquitectura de supervisión y registro de clústeres de Kubernetes:
Herramientas de supervisión
Herramientas para la supervisión de clústeres de Kubernetes:
- Prometheus: Recopilación y almacenamiento de métricas
- Grafana: Visualización de métricas
- Alertmanager: Gestión de alertas
- kube-state-metrics: Generar métricas de objetos de Kubernetes
- metrics-server: Proporcionar métricas de uso de recursos
Instalación de Prometheus y Grafana
Instale Prometheus y Grafana mediante Helm:
# Add Helm repository
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update

# Install Prometheus stack
helm install prometheus prometheus-community/kube-prometheus-stack \
  --namespace monitoring \
  --create-namespace
Métricas clave de supervisión
Métricas clave para supervisar:
- Métricas de nodo: Uso de CPU, memoria, disco y red
- Métricas de Pod: Uso de CPU y memoria, número de reinicios
- Métricas de contenedor: Uso de CPU, memoria y sistema de archivos
- Métricas de servidor de API: Latencia de solicitudes, número de solicitudes, tasa de errores
- Métricas de etcd: E/S de disco, cambios de líder, latencia de confirmación
Herramientas de registro
Herramientas para el registro de clústeres de Kubernetes:
- Elasticsearch: Almacenamiento y búsqueda de registros
- Fluentd/Fluent Bit: Recopilación y reenvío de registros
- Kibana: Visualización de registros
- Loki: Sistema de agregación de registros
- Grafana: Visualización de registros
Instalación de la pila EFK (Elasticsearch, Fluentd, Kibana)
El repositorio independiente de gráficos Helm de Elastic Stack está archivado. Para implementaciones mantenidas, use Elastic Cloud on Kubernetes (ECK), y después defina recursos de Elasticsearch/Kibana y un recopilador de registros compatible. La instalación del operador por sí sola no crea una pila EFK:
helm repo add elastic https://helm.elastic.co
helm upgrade --install elastic-operator elastic/eck-operator \
  --namespace elastic-system --create-namespace \
  --version "${ECK_CHART_VERSION:?Select a supported ECK chart version}"
Mantenga los paneles detrás de acceso ClusterIP/autenticado; configure almacenamiento, TLS, credenciales, análisis del recopilador y RBAC conforme a la guía de ECK.
Configuración de recopilación de registros
Este ejemplo analiza la envoltura de registro CRI en lugar de asumir JSON de Docker. La imagen del recopilador debe incluir los complementos de metadatos/salida, montar los registros de nodo y almacenamiento grabable para archivos de posición, y recibir RBAC de metadatos con ámbito limitado. Configure TLS/autenticación para el servicio real de Elasticsearch; el host de marcador de posición por sí solo no es una integración ECK completa. Gestione registros parciales/multilínea según el recopilador seleccionado.
Ejemplo de configuración de Fluentd:
apiVersion: v1
kind: ConfigMap
metadata:
  name: fluentd-config
  namespace: logging
data:
  fluent.conf: |
    <source>
      @type tail
      path /var/log/containers/*.log
      pos_file /var/log/fluentd-containers.log.pos
      tag kubernetes.*
      read_from_head true
      <parse>
        @type regexp
        expression /^(?<time>[^ ]+) (?<stream>stdout|stderr) (?<logtag>[^ ]*) (?<log>.*)$/
        time_type string
        time_format %Y-%m-%dT%H:%M:%S.%N%:z
      </parse>
    </source>

    <filter kubernetes.**>
      @type kubernetes_metadata
      kubernetes_url https://kubernetes.default.svc
      bearer_token_file /var/run/secrets/kubernetes.io/serviceaccount/token
      ca_file /var/run/secrets/kubernetes.io/serviceaccount/ca.crt
    </filter>

    <match kubernetes.**>
      @type elasticsearch
      host elasticsearch-master
      port 9200
      logstash_format true
      logstash_prefix k8s
    </match>
Resolución de problemas
La resolución de problemas de clústeres de Kubernetes es una parte importante de la administración de clústeres.
Resolución de problemas de Pods
Comandos para resolver problemas de Pods:
# Check pod status
kubectl get pod <pod-name> -o wide

# Check pod detailed information
kubectl describe pod <pod-name>

# Check pod logs
kubectl logs <pod-name>
kubectl logs <pod-name> -c <container-name>  # For multi-container pods
kubectl logs <pod-name> --previous  # Logs from previous container

# Execute command in pod
kubectl exec -it <pod-name> -- /bin/sh
Resolución de problemas de nodos
Comandos para resolver problemas de nodos:
# Check node status
kubectl get node <node-name> -o wide

# Check node detailed information
kubectl describe node <node-name>

# Check node resource usage
kubectl top node <node-name>

# SSH to node
ssh <node-name>

# Check node system logs
journalctl -u kubelet

# Check node resource usage
top
df -h
free -m
Resolución de problemas de red
Comandos para resolver problemas de red:
# Check service status
kubectl get svc <service-name>

# Check service detailed information
kubectl describe svc <service-name>

# Check endpoints
kubectl get endpointslices -l kubernetes.io/service-name=<service-name>

# Check DNS
kubectl run -it --rm --restart=Never busybox --image=busybox -- nslookup <service-name>

# Test network connectivity
kubectl run -it --rm --restart=Never busybox --image=busybox -- wget -O- <service-name>:<port>

# Check network policies
kubectl get networkpolicy
kubectl describe networkpolicy <policy-name>
Resolución de problemas del plano de control
Comandos para resolver problemas del plano de control:
# Check component status
kubectl get --raw='/readyz?verbose'

# Check API server logs
kubectl logs -n kube-system kube-apiserver-<node-name>

# Check controller manager logs
kubectl logs -n kube-system kube-controller-manager-<node-name>

# Check scheduler logs
kubectl logs -n kube-system kube-scheduler-<node-name>

# Check etcd logs
kubectl logs -n kube-system etcd-<node-name>
Administración de clústeres de Amazon EKS
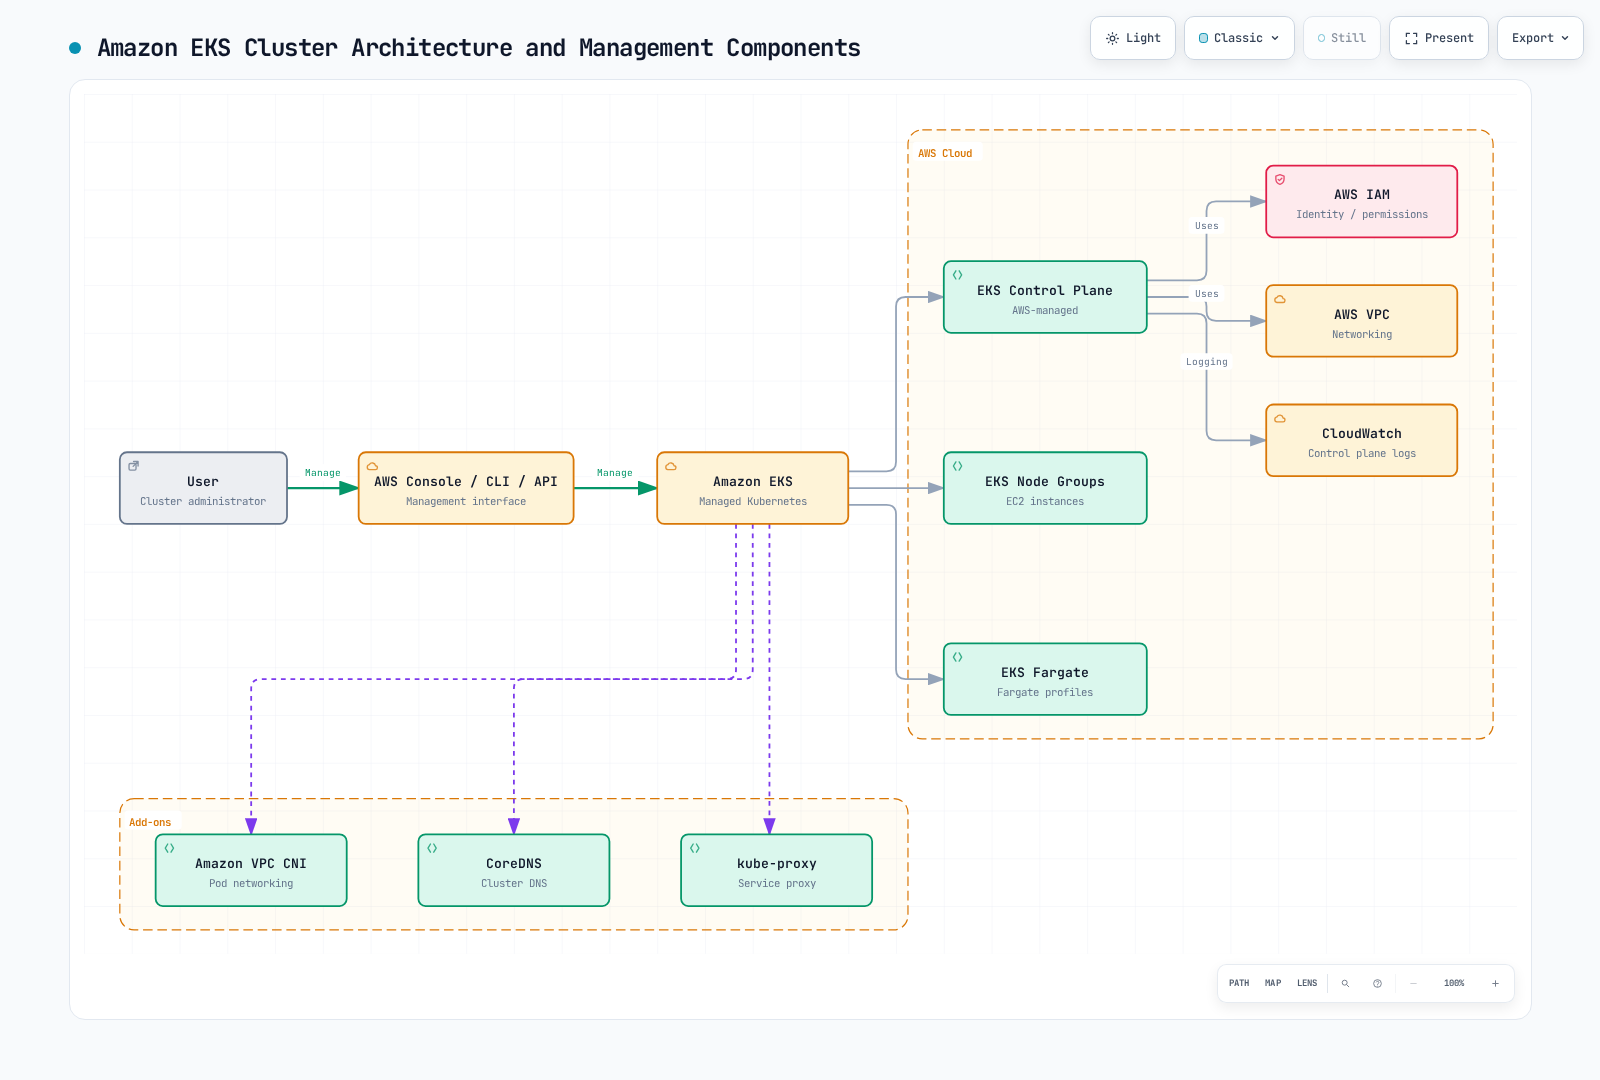
Amazon EKS es un servicio de Kubernetes administrado que automatiza muchos aspectos de la administración de clústeres.
El siguiente diagrama muestra la arquitectura del clúster de Amazon EKS y los componentes de gestión:
Configuración del clúster de EKS
Establezca el CIDR real de administrador antes de cambiar el acceso al punto de conexión y verifique que el acceso privado siga siendo accesible. Una actualización de versión debe ser la siguiente versión secundaria compatible con complementos/nodos compatibles; no use el ejemplo como una operación de degradación ni de salto de versiones secundarias. Sondee el ID de actualización devuelto y detenga los cambios dependientes si falla.
Gestión de configuración del clúster de EKS:
# Check EKS cluster information
aws eks describe-cluster --name my-cluster

# Update EKS cluster
aws eks update-cluster-config \
  --name my-cluster \
  --resources-vpc-config "endpointPublicAccess=true,endpointPrivateAccess=true,publicAccessCidrs=${ADMIN_CIDR:?Set an approved administrator public CIDR}"

# Update EKS cluster version
aws eks update-cluster-version \
  --name my-cluster \
  --kubernetes-version "${TARGET_VERSION:?Select the next EKS-supported minor version}"
Gestión de grupos de nodos de EKS
Gestión de grupos de nodos de EKS:
# Check node group information
aws eks describe-nodegroup \
  --cluster-name my-cluster \
  --nodegroup-name my-nodegroup

# Scale node group
aws eks update-nodegroup-config \
  --cluster-name my-cluster \
  --nodegroup-name my-nodegroup \
  --scaling-config minSize=2,maxSize=10,desiredSize=5

# Update node group
aws eks update-nodegroup-version \
  --cluster-name my-cluster \
  --nodegroup-name my-nodegroup
Gestión de complementos de EKS
Lea la versión actual mediante aws eks describe-cluster --name my-cluster --query cluster.version --output text; úsela para descubrir complementos y seleccione una versión compatible y fijada. Revise la configuración/IAM existente antes de crear/actualizar y no vuelva a crear un complemento ya administrado. El ejemplo de eliminación usa --preserve para mantener CNI en ejecución al eliminar la gestión de EKS; desinstalar redes activas es una operación disruptiva independiente.
Gestión de complementos de EKS:
# Check available add-ons
aws eks describe-addon-versions --addon-name vpc-cni \
  --kubernetes-version "${CLUSTER_VERSION:?Set the actual cluster version}"

# Install add-on
aws eks create-addon \
  --cluster-name my-cluster \
  --addon-name vpc-cni \
  --addon-version "${CNI_ADDON_VERSION:?Select a compatible pinned VPC CNI add-on version}"

# Update add-on
aws eks update-addon \
  --cluster-name my-cluster \
  --addon-name vpc-cni \
  --addon-version "${CNI_ADDON_VERSION:?Select a compatible pinned VPC CNI add-on version}"

# Delete add-on
aws eks delete-addon \
  --cluster-name my-cluster \
  --addon-name vpc-cni --preserve
Actualización del clúster de EKS
Proceso de actualización del clúster de EKS:
Actualización del plano de control:
bashaws eks update-cluster-version \ --name my-cluster \ --kubernetes-version "${TARGET_VERSION:?Select the next EKS-supported minor version}"Actualización de complementos:
bashaws eks update-addon \ --cluster-name my-cluster \ --addon-name vpc-cni \ --addon-version "${CNI_ADDON_VERSION:?Select a compatible pinned VPC CNI add-on version}"Actualización de grupos de nodos:
bashaws eks update-nodegroup-version \ --cluster-name my-cluster \ --nodegroup-name my-nodegroup
Supervisión del clúster de EKS
El registro del plano de control exporta registros de api/audit/authenticator/controllerManager/scheduler. Container Insights requiere el agente/complemento de CloudWatch y permisos IAM de telemetría con ámbito limitado; no se habilita mediante update-cluster-logging. El complemento de observabilidad de CloudWatch instala componentes de CloudWatch/Fluent Bit, no Prometheus/Grafana. Consulte la configuración oficial del complemento.
Herramientas de supervisión de clústeres de EKS:
- Amazon CloudWatch: Métricas, registros y alertas
- AWS CloudTrail: Registro de llamadas a API
- Amazon Managed Grafana: Visualización de métricas
- Amazon Managed Service for Prometheus: Recopilación y almacenamiento de métricas
Habilite el registro del plano de control de EKS:
# Enable EKS control-plane logs
eksctl utils update-cluster-logging \
--enable-types all \
--cluster my-cluster \
--approvePrácticas recomendadas para la administración de clústeres
Prácticas recomendadas para la administración de clústeres de Kubernetes y EKS:
Prácticas recomendadas para la configuración del clúster
- Infraestructura como código (IaC): Gestione la configuración del clúster con Terraform, AWS CDK, eksctl, etc.
- Control de versiones: Almacene la configuración del clúster en sistemas de control de versiones
- Varios entornos: Separe los entornos de desarrollo, preparación y producción
- Separación de red: Configure la separación de red y los grupos de seguridad apropiados
- Principio de mínimo privilegio: Conceda solo los permisos mínimos necesarios
Prácticas recomendadas para operaciones
- Copias de seguridad periódicas: Copia de seguridad periódica de etcd y recursos importantes
- Supervisión y alertas: Cree sistemas integrales de supervisión y alertas
- Registro centralizado: Centralice y analice los registros
- Automatización: Automatice tareas repetitivas
- Planificación de recuperación ante desastres: Establezca y pruebe planes claros de recuperación ante desastres
Prácticas recomendadas de seguridad
- Actualizaciones periódicas: Actualizaciones periódicas del clúster y los nodos
- Políticas de red: Configure políticas de red adecuadas
- Cifrado: Cifre los datos en reposo y en tránsito
- Contexto de seguridad: Configure contextos de seguridad adecuados
- Análisis de imágenes: Analice imágenes de contenedor en busca de vulnerabilidades
Prácticas recomendadas para la gestión de recursos
- Solicitudes y límites de recursos: Establezca solicitudes y límites de recursos adecuados para todos los Pods
- Separación de Namespace: Separe las cargas de trabajo por Namespace
- Cuotas de recursos: Establezca cuotas de recursos por Namespace
- HPA y VPA: Configure el escalado automático
- Afinidad y taints de nodo: Optimice la ubicación de cargas de trabajo
Prácticas recomendadas específicas de EKS
- Grupos de nodos administrados: Use grupos de nodos administrados cuando sea posible
- Fargate: Use Fargate para cargas de trabajo sin servidor
- Complementos de EKS: Use complementos oficiales de EKS
- IAM Roles for Service Accounts (IRSA): Gestione permisos IAM por Pod
- Personalización de VPC CNI: Configure VPC CNI según los requisitos de red
Conclusión
La administración de clústeres de Kubernetes desempeña un papel importante para mantener la estabilidad, seguridad y rendimiento del clúster. Este capítulo cubrió diversos aspectos de la administración de clústeres, incluidos la gestión de componentes del clúster, la gestión de recursos, las redes, la gestión de autenticación y autorización, las actualizaciones, la copia de seguridad y recuperación, la supervisión y el registro, y la resolución de problemas.
El uso de Amazon EKS reduce la complejidad de la gestión del plano de control de Kubernetes y simplifica la administración de clústeres mediante la integración con servicios de AWS. Sin embargo, comprender los conceptos fundamentales de Kubernetes y las prácticas recomendadas sigue siendo importante para una gestión eficaz de clústeres.
La administración de clústeres es un proceso continuo que debe ajustarse constantemente de acuerdo con los requisitos del clúster y las características de las cargas de trabajo. Es importante usar herramientas de supervisión para seguir el estado del clúster, minimizar las tareas repetitivas mediante automatización y seguir las prácticas recomendadas para mantener la estabilidad y seguridad del clúster.
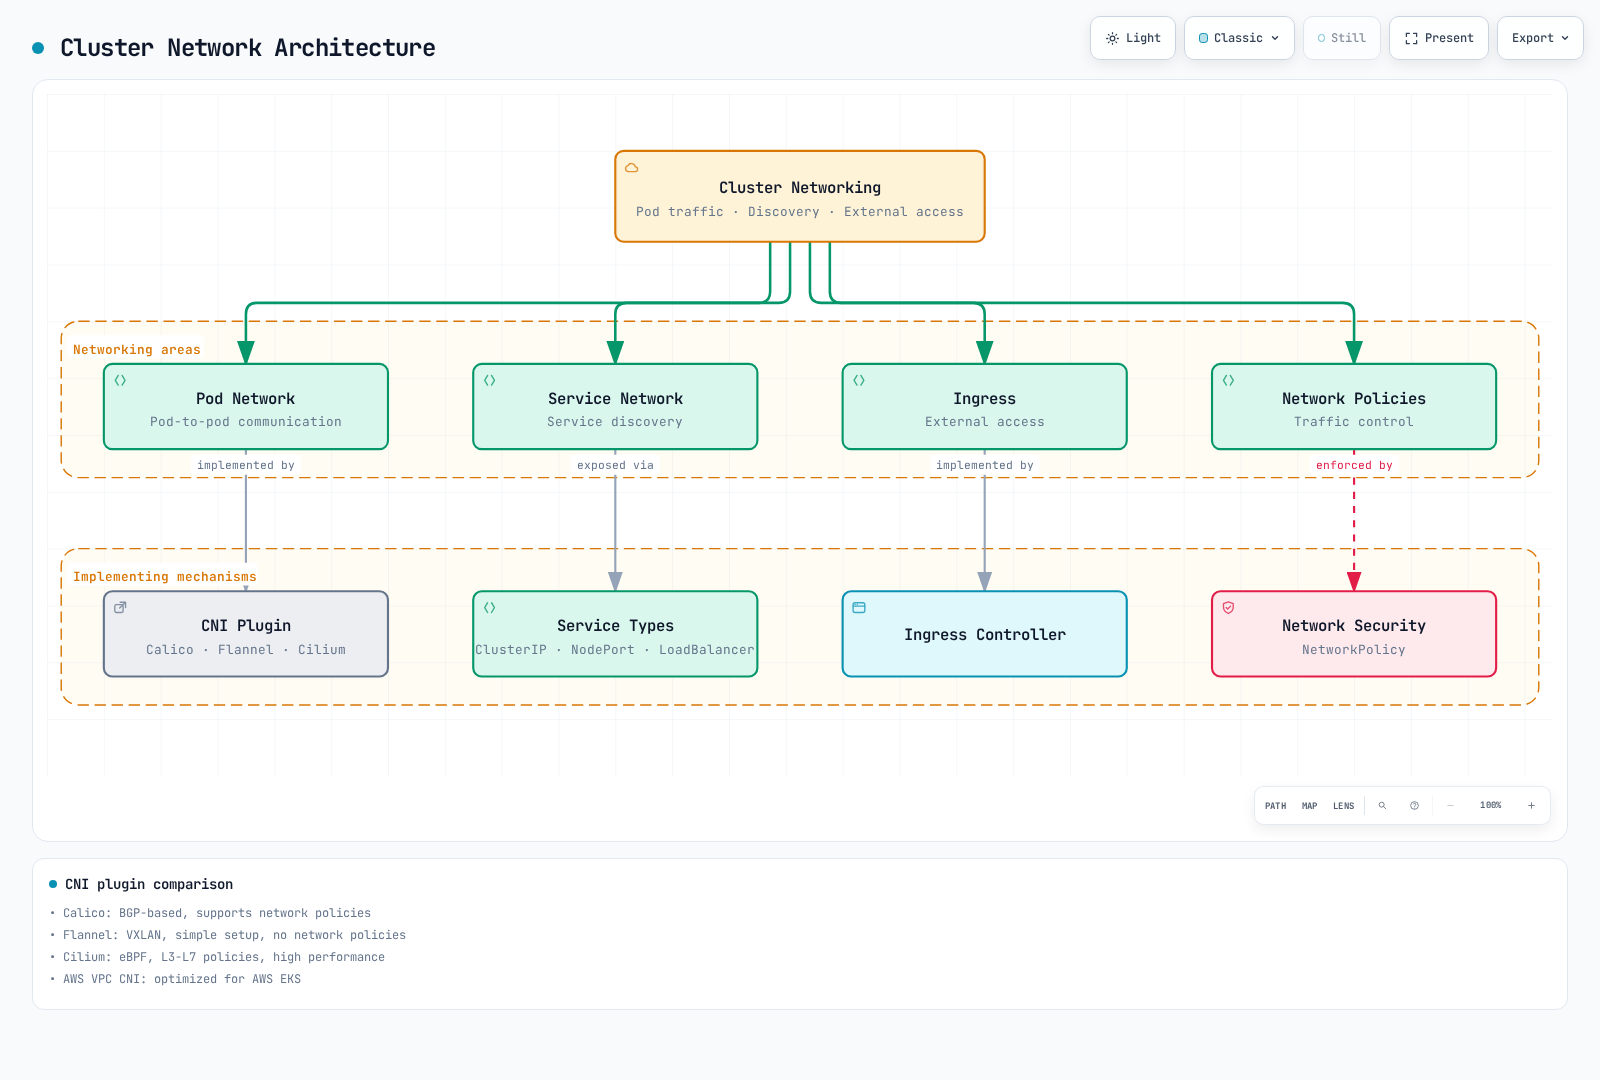
Redes del clúster
Las redes de clúster de Kubernetes gestionan la comunicación entre Pods, el descubrimiento de servicios y el acceso externo.
Arquitectura de red
Gestión de complementos CNI
Los complementos CNI (Container Network Interface) gestionan las redes de los clústeres de Kubernetes.
Elija un CNI o una configuración documentada de encadenamiento/migración. Las alternativas Calico, Flannel y Cilium no deben instalarse secuencialmente en el mismo clúster en ejecución. Use una versión compatible y fijada, y las instrucciones específicas del proveedor; en EKS, siga el procedimiento de VPC CNI o de CNI alternativo planificado en el capítulo de redes.
# Inspect the installed networking components before making changes
kubectl get daemonsets -A
kubectl get pods -A -l k8s-app=calico-nodeComparación de complementos CNI
| Complemento CNI | Modelo de red | Compatibilidad con políticas de red | Rendimiento | Características |
|---|---|---|---|---|
| Calico | BGP | Sí | Alto | Sólido en políticas de red, basado en enrutamiento |
| Flannel | VXLAN/host-gateway | No | Medio | Configuración sencilla, funciones limitadas |
| Cilium | eBPF | Sí | Muy alto | Políticas L3-L7, alto rendimiento |
| Weave Net | VXLAN | Sí | Medio | Compatibilidad con cifrado, varios clústeres |
| AWS VPC CNI | AWS VPC | Sí, con versión/configuración compatibles | Dependiente de la carga de trabajo | Integración nativa con EKS |
Resolución de problemas de red
# Test pod network connectivity
kubectl run -it --rm network-test --image=busybox -- sh
# Inside the container
ping <target-ip>
traceroute <target-ip>
wget -O- <service-name>
# DNS troubleshooting
kubectl run -it --rm dns-test --image=busybox -- sh
# Inside the container
nslookup kubernetes.default.svc.cluster.local
cat /etc/resolv.conf
# Check service endpoints
kubectl get endpointslices -l kubernetes.io/service-name=<service-name>
# Check network policies
kubectl describe networkpolicy -n <namespace>Gestión de autenticación y autorización
La gestión de autenticación y autorización de Kubernetes es un elemento central de la seguridad del clúster. RBAC (Role-Based Access Control) se usa para gestionar los permisos de usuarios y cuentas de servicio.
Métodos de autenticación
Kubernetes admite varios métodos de autenticación:
- Certificados X.509: Autenticación mediante certificados de cliente
- Tokens de Service Account: Se usan para el acceso al servidor de API dentro de Pods
- OpenID Connect (OIDC): Integración con proveedores de identidad externos
- Autenticación de tokens mediante Webhook: Integración con servicios de autenticación externos
- Proxy de autenticación: Autenticación mediante proxy
Configuración de RBAC
# role.yaml - namespace-scoped role
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
namespace: default
name: pod-reader
rules:
- apiGroups: [""]
resources: ["pods"]
verbs: ["get", "watch", "list"]# rolebinding.yaml - binding role to user
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
name: read-pods
namespace: default
subjects:
- kind: User
name: jane
apiGroup: rbac.authorization.k8s.io
roleRef:
kind: Role
name: pod-reader
apiGroup: rbac.authorization.k8s.io# clusterrole.yaml - cluster-scoped role
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
name: namespace-reader
rules:
- apiGroups: [""]
resources: ["namespaces"]
verbs: ["get", "watch", "list"]# clusterrolebinding.yaml - binding cluster role to user
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
name: read-namespaces-global
subjects:
- kind: Group
name: namespace-viewers
apiGroup: rbac.authorization.k8s.io
roleRef:
kind: ClusterRole
name: namespace-reader
apiGroup: rbac.authorization.k8s.ioCreación de certificados de usuario
Para la autenticación de certificados de cliente autogestionada, envíe un CSR y haga que un aprobador autorizado verifique la identidad/grupos solicitados. No distribuya la clave privada de CA del clúster. El acceso de usuarios de EKS debe usar entradas de IAM/acceso.
umask 077
openssl genrsa -out jane.key 2048
openssl req -new -key jane.key -out jane.csr -subj "/CN=jane/O=dev"
cat <<EOF | kubectl apply -f -
apiVersion: certificates.k8s.io/v1
kind: CertificateSigningRequest
metadata:
name: jane-csr
spec:
request: $(base64 < jane.csr | tr -d '\n')
signerName: kubernetes.io/kube-apiserver-client
expirationSeconds: 86400
usages:
- client auth
EOF
# Authorized approver only, after reviewing the CSR identity:
kubectl certificate approve jane-csr
kubectl wait --for=jsonpath='{.status.certificate}' csr/jane-csr --timeout=60s
kubectl get csr jane-csr -o jsonpath='{.status.certificate}' | base64 --decode > jane.crt
kubectl config set-credentials jane --client-certificate=jane.crt --client-key=jane.key
kubectl config set-context jane-context --cluster=kubernetes --user=janeGestión de Service Account
# Create service account
kubectl create serviceaccount app-service-account
# Bind role to service account
kubectl create rolebinding app-service-account-binding \
--role=pod-reader \
--serviceaccount=default:app-service-account
# Inspect ServiceAccount metadata (projected tokens are not listed here)
kubectl describe serviceaccount app-service-accountVerificación de permisos
# Check user permissions
kubectl auth can-i get pods --as jane
# Check permissions in a specific namespace
kubectl auth can-i create deployments --as jane --namespace productionActualizaciones de clústeres
Las actualizaciones de clústeres de Kubernetes son necesarias para aplicar características nuevas, parches de seguridad y correcciones de errores. Las actualizaciones deben planificarse y ejecutarse cuidadosamente.
Planificación de actualizaciones
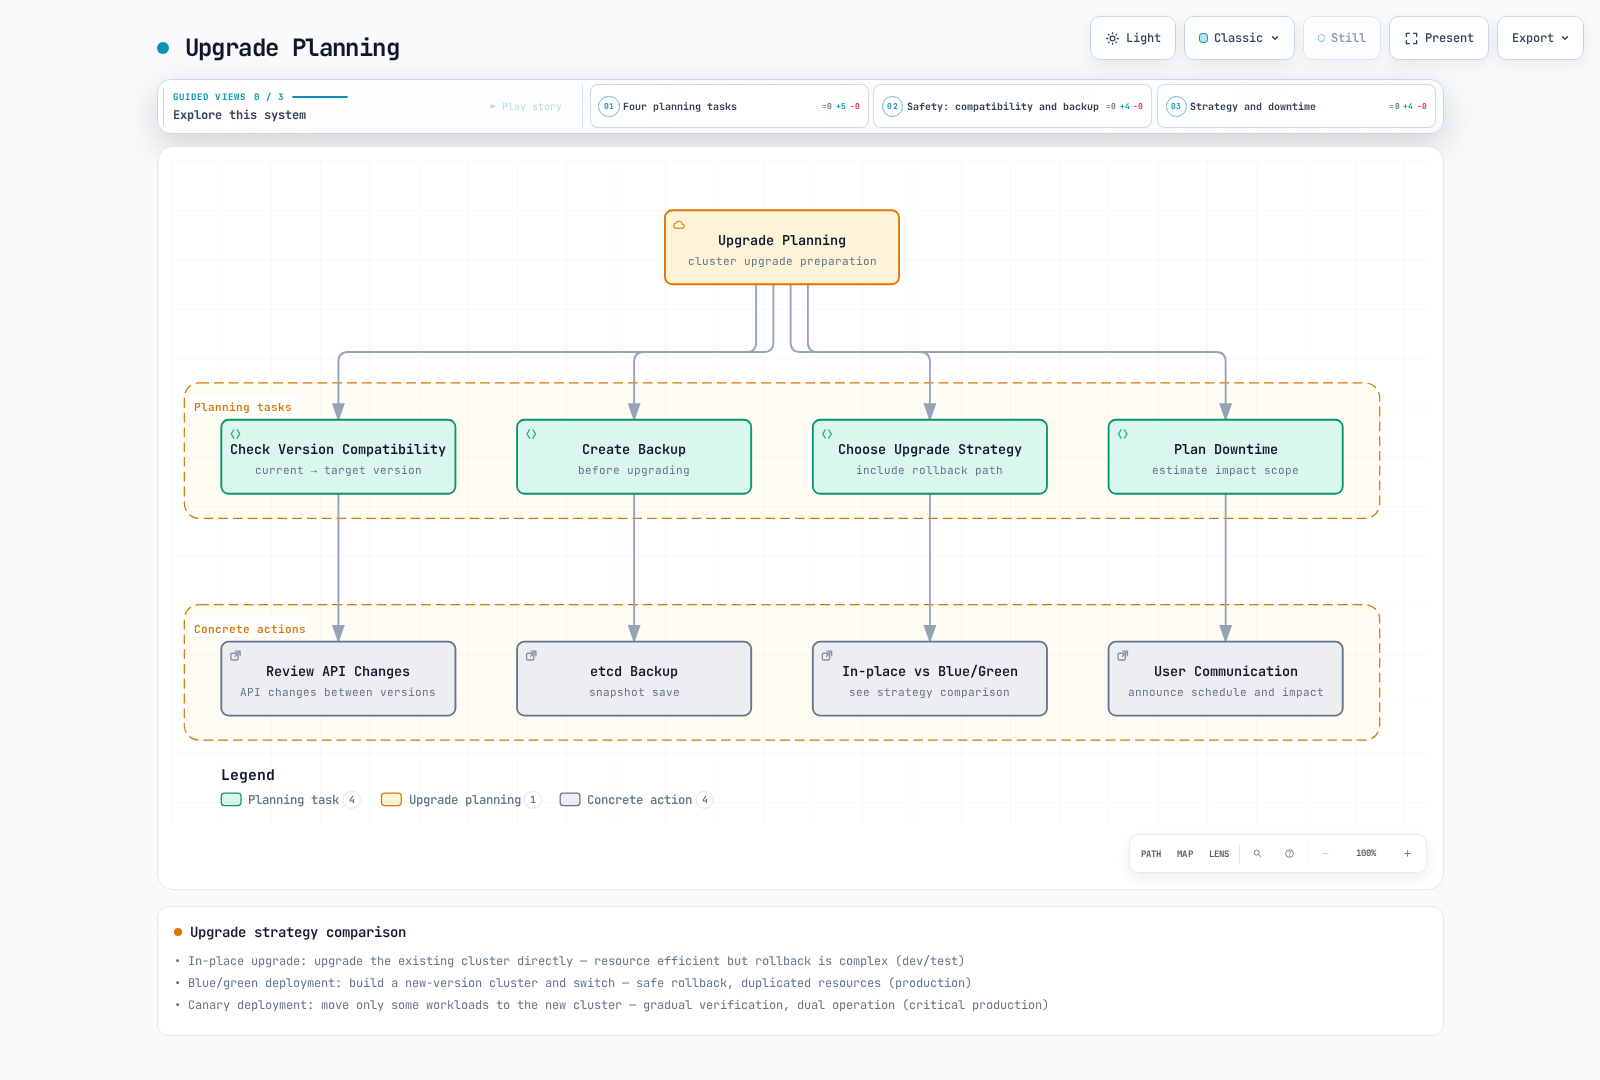
Comparación de estrategias de actualización
| Estrategia | Descripción | Ventajas | Desventajas | Entorno adecuado |
|---|---|---|---|---|
| Actualización en el lugar | Actualizar directamente el clúster existente | Eficiente en recursos, procedimiento sencillo | Reversión compleja, posible tiempo de inactividad | Entornos de desarrollo y pruebas |
| Implementación azul/verde | Crear un clúster de nueva versión y cambiar | Reversión segura, verificable | Duplicación de recursos, mayor costo | Entornos de producción |
| Implementación canaria | Mover solo algunas cargas de trabajo al clúster nuevo | Verificación gradual, riesgo reducido | Gestión compleja, operación dual | Entornos de producción críticos |
Actualización mediante kubeadm
Use el procedimiento de actualización de kubeadm específico de la versión. Habilite el repositorio pkgs.k8s.io de la versión secundaria de destino y seleccione una versión exacta de paquete publicada; actualice una versión secundaria cada vez.
- Haga una copia de seguridad de etcd y valide la compatibilidad de las cargas de trabajo y los complementos. En el primer nodo del plano de control, actualice kubeadm, ejecute
kubeadm upgrade plany, después,kubeadm upgrade apply <target-version>. - En nodos adicionales del plano de control, actualice kubeadm y ejecute
kubeadm upgrade node. - Drene cada nodo antes de actualizar su kubelet. Si el drenaje falla, detenga el procedimiento y resuelva la causa. Actualice kubelet/kubectl a versiones compatibles, recargue systemd, reinicie kubelet, verifique Ready y las cargas de trabajo, y después ejecute uncordon desde un cliente administrativo.
- En cada nodo de trabajo, actualice kubeadm y ejecute
kubeadm upgrade node; después realice la secuencia de drenaje/kubelet/verificación/uncordon. No ejecute una actualización genérica de todo el sistema como sustituto del procedimiento de Kubernetes específico de la versión.
Ejecute los comandos en el nodo identificado explícitamente o en el cliente administrativo; una secuencia de sesiones ssh anidadas no es un script de automatización multinodo.
Verificación posterior a la actualización
# Check cluster version
kubectl version
# Check node versions
kubectl get nodes
# Check component status
kubectl get --raw='/readyz?verbose'
# Check workload status
kubectl get pods -ACopia de seguridad y recuperación
La copia de seguridad y recuperación de clústeres de Kubernetes es una parte importante de la planificación de recuperación ante desastres. Los principales objetivos de copia de seguridad son la base de datos etcd, los datos de volúmenes persistentes y las definiciones de recursos de Kubernetes.
Copia de seguridad y recuperación de etcd
etcd es un componente básico que guarda toda la información de estado del clúster.
Para la recuperación ante desastres autogestionada, detenga todos los servidores de API y los procesos de etcd afectados mediante el runbook específico de la distribución. Detener solo kubelet deja en ejecución los contenedores de Pod estáticos existentes. Restaure en un directorio nuevo con un etcdutl compatible; preserve los datos originales hasta verificar la recuperación. Este comando para un solo miembro es una ilustración, no una restauración de HA con varios miembros:
etcdutl snapshot status "$SNAPSHOT_FILE" --write-out=table
etcdutl snapshot restore "$SNAPSHOT_FILE" \
--data-dir=/var/lib/etcd-restore \
--name=etcd-1 \
--initial-cluster=etcd-1=https://127.0.0.1:2380 \
--initial-cluster-token=restored-cluster \
--initial-advertise-peer-urls=https://127.0.0.1:2380 \
--bump-revision=1000000000 --mark-compactedEstablezca SNAPSHOT_FILE en la instantánea verificada. Para HA, restaure la misma instantánea en cada miembro con su nombre/URL de par único y la misma lista completa de miembros. Elija un incremento de revisión que supere los cambios desde la instantánea. Actualice el manifiesto/servicio de etcd a la ruta restaurada con la propiedad y los certificados correctos, verifique el quórum/la salud y después reinicie los servidores de API/controladores. Consulte la guía oficial de recuperación. Los usuarios de EKS no pueden restaurar directamente etcd del plano de control administrado.
Copia de seguridad de recursos de Kubernetes
# Export selected resources, not a full cluster backup
set -eu
umask 077
mkdir -p /backup/resources/$(date +%Y-%m-%d)
for ns in $(kubectl get ns -o jsonpath='{.items[*].metadata.name}'); do
kubectl -n $ns get all -o yaml > /backup/resources/$(date +%Y-%m-%d)/$ns-all.yaml
done
# Backup specific resource types
for resource in deployments services configmaps secrets; do
kubectl get $resource -A -o yaml > /backup/resources/$(date +%Y-%m-%d)/$resource.yaml
doneCopia de seguridad y recuperación mediante Velero
Seleccione versiones compatibles de Velero/complemento de AWS con la matriz oficial. El ejemplo de IRSA presupone un proveedor OIDC de clúster configurado y un rol con ámbito limitado que confía en el ServiceAccount de velero. Configure el bucket de copia de seguridad, la compatibilidad con instantáneas/copia de seguridad de archivos de volúmenes, el cifrado y los permisos de restauración antes de la instalación; no todos los PVC están protegidos automáticamente.
Velero es una herramienta para realizar copias de seguridad y recuperar recursos de clústeres de Kubernetes y volúmenes persistentes.
# Install Velero (using AWS S3 backup storage)
velero install \
--provider aws \
--plugins "${VELERO_AWS_PLUGIN_IMAGE:?Select a plugin compatible with your Velero release}" \
--bucket velero-backup \
--backup-location-config region=us-west-2 \
--snapshot-location-config region=us-west-2 \
--no-secret \
--sa-annotations "eks.amazonaws.com/role-arn=${VELERO_ROLE_ARN:?Set the preconfigured IRSA role ARN}"
# Full cluster backup
velero backup create full-cluster-backup --include-namespaces '*'
# Backup specific namespace
velero backup create production-backup --include-namespaces production
# Check backup status
velero backup describe full-cluster-backup
# Restore from backup
velero restore create --from-backup full-cluster-backupComparación de estrategias de copia de seguridad
| Método de copia de seguridad | Objetivo de copia de seguridad | Ventajas | Desventajas | Tiempo de recuperación |
|---|---|---|---|---|
| Instantánea de etcd | Estado del clúster | Función integrada, conservación completa del estado | Datos de volumen no incluidos, proceso manual | Medio |
| Copia de seguridad YAML de recursos | Objetos de Kubernetes | Implementación sencilla, restauración selectiva | Datos de volumen no incluidos, complejidad de relaciones | Lento |
| Velero | Recursos y volúmenes | Automatización, programación, instantáneas de volúmenes | Se requiere instalación de herramienta adicional | Rápido |
| Instantáneas del proveedor de nube | Discos/sistemas de archivos compatibles | Puntos de recuperación nativos del backend | No captura todo el clúster de Kubernetes/EKS | Depende de los datos/backend |
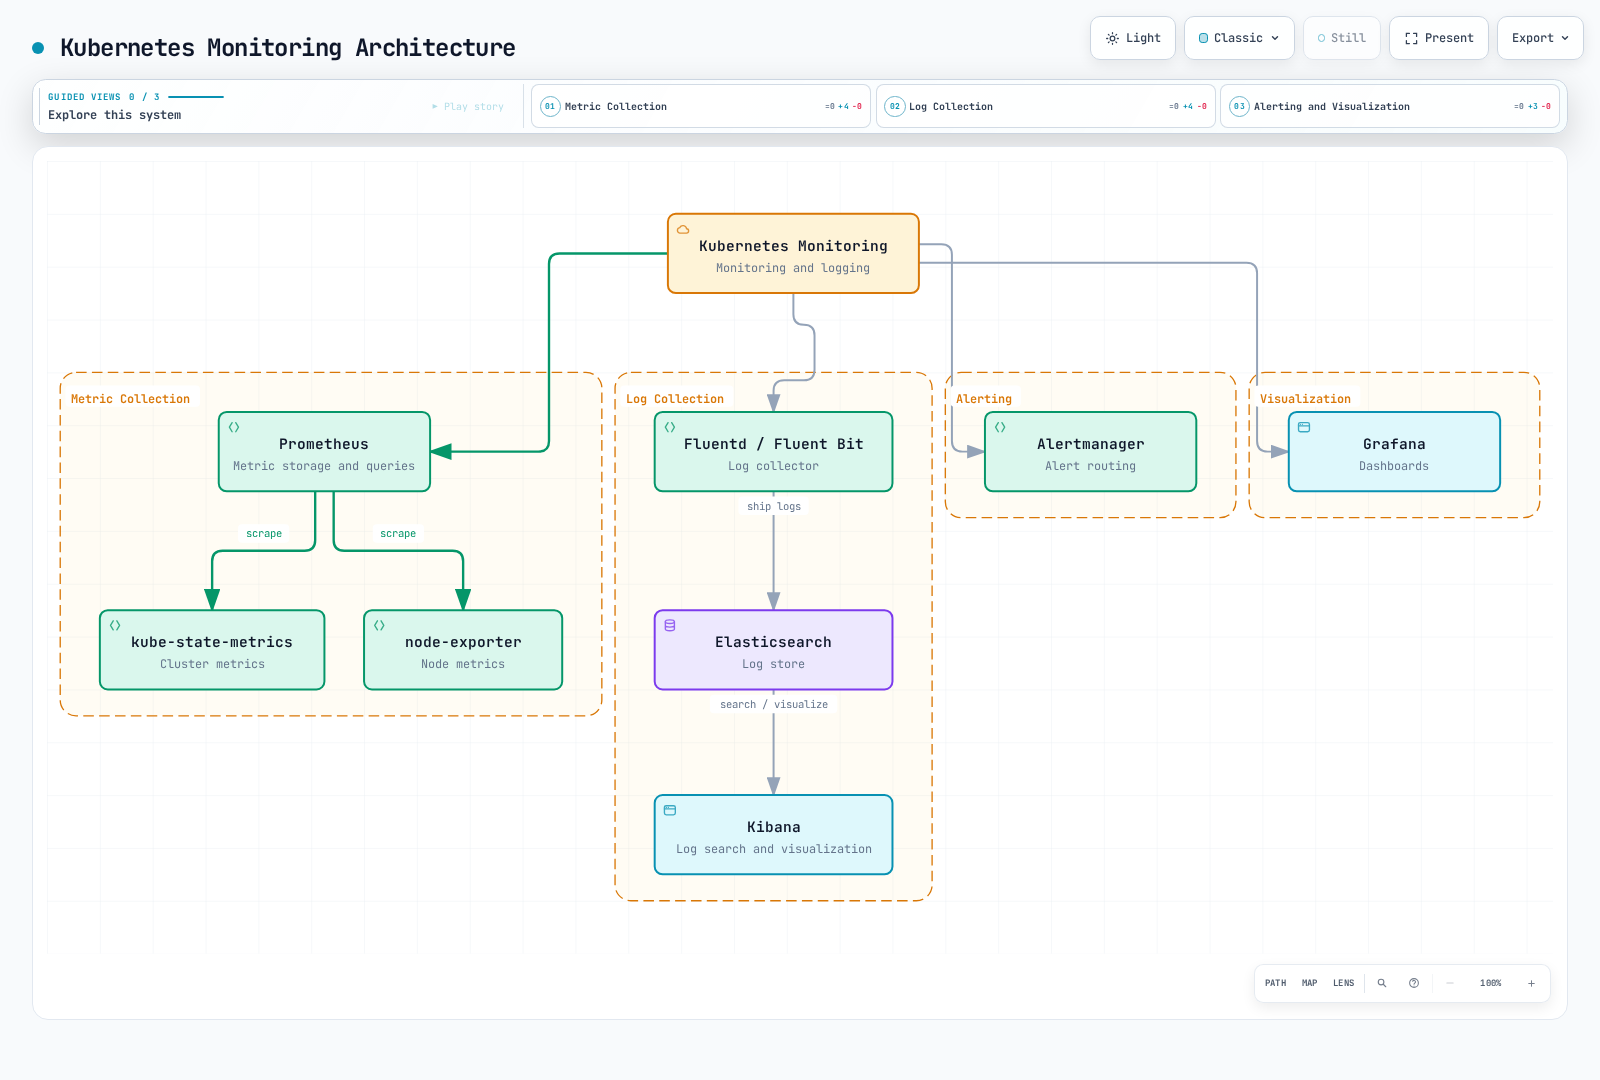
Supervisión y registro
La gestión eficaz de clústeres requiere un sistema integral de supervisión y registro. Esto permite detectar y resolver problemas de manera temprana.
Arquitectura de supervisión
Instalación de Prometheus y Grafana
# Install Prometheus and Grafana using Helm
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
helm install prometheus prometheus-community/kube-prometheus-stack \
--namespace monitoring \
--create-namespace \
--set grafana.enabled=true \
--set prometheus.service.type=ClusterIP
# Check services
kubectl get svc -n monitoring
# Access Grafana (using port forwarding)
kubectl port-forward svc/prometheus-grafana 3000:80 -n monitoring
# Obtain credentials from the configured Grafana Secret; do not assume a published default passwordInstalación de la pila EFK (Elasticsearch, Fluentd, Kibana)
El repositorio independiente de gráficos Helm de Elastic Stack está archivado. Para implementaciones mantenidas, use Elastic Cloud on Kubernetes (ECK), y después defina recursos de Elasticsearch/Kibana y un recopilador de registros compatible. La instalación del operador por sí sola no crea una pila EFK:
helm repo add elastic https://helm.elastic.co
helm upgrade --install elastic-operator elastic/eck-operator \
--namespace elastic-system --create-namespace \
--version "${ECK_CHART_VERSION:?Select a supported ECK chart version}"Mantenga los paneles detrás de acceso ClusterIP/autenticado; configure almacenamiento, TLS, credenciales, análisis del recopilador y RBAC conforme a la guía de ECK.
Métricas clave de supervisión
| Tipo de métrica | Descripción | Métricas clave | Herramientas de supervisión |
|---|---|---|---|
| Métricas de nodo | Uso de recursos a nivel de nodo | CPU, memoria, disco, red | node-exporter, Prometheus |
| Métricas de Pod | Uso de recursos de contenedor | Uso y límites de CPU y memoria | cAdvisor, Prometheus |
| Métricas de clúster | Estado y recursos del clúster | Recuento de Pods, estado de nodos/objetos, réplicas deseadas/actuales | kube-state-metrics |
| Métricas de aplicación | Métricas personalizadas de aplicaciones | Recuento de solicitudes, latencia, tasa de errores | Bibliotecas de cliente de Prometheus |
Recopilación y análisis de registros
# Check logs for a specific pod
kubectl logs <pod-name> -n <namespace>
# Check logs from previous instance
kubectl logs <pod-name> -n <namespace> --previous
# Check logs for a specific container (multi-container pod)
kubectl logs <pod-name> -c <container-name> -n <namespace>
# Stream logs
kubectl logs -f <pod-name> -n <namespace>
# Check logs for all pods (using label selector)
kubectl logs -l app=nginx -n <namespace>Configuración de alertas
Puede configurar alertas mediante Prometheus Alertmanager:
Cree un Secret slack-webhook protegido con la clave url en monitoring y después fusione estos valores de Helm en la versión existente de kube-prometheus-stack. No confirme la URL del webhook. Un ConfigMap independiente no es consumido automáticamente por el operador.
# alertmanager-values.yaml
alertmanager:
alertmanagerSpec:
secrets:
- slack-webhook
config:
global:
resolve_timeout: 5m
slack_api_url_file: /etc/alertmanager/secrets/slack-webhook/url
route:
receiver: slack-notifications
group_wait: 30s
group_interval: 5m
repeat_interval: 4h
group_by: [alertname, cluster, service]
receivers:
- name: slack-notifications
slack_configs:
- channel: '#alerts'
send_resolved: true
title: '{{ range .Alerts }}{{ .Annotations.summary }}{{ end }}'
text: '{{ range .Alerts }}{{ .Annotations.description }}{{ end }}'Mantenga la versión actual del gráfico y otros valores al actualizar; verifique la recarga/el estado de Alertmanager antes de confiar en las notificaciones.
Resolución de problemas
La resolución de problemas de clústeres de Kubernetes es una habilidad importante para administradores y operadores de sistemas. Se requiere un enfoque sistemático para resolver problemas eficazmente.
Metodología de resolución de problemas
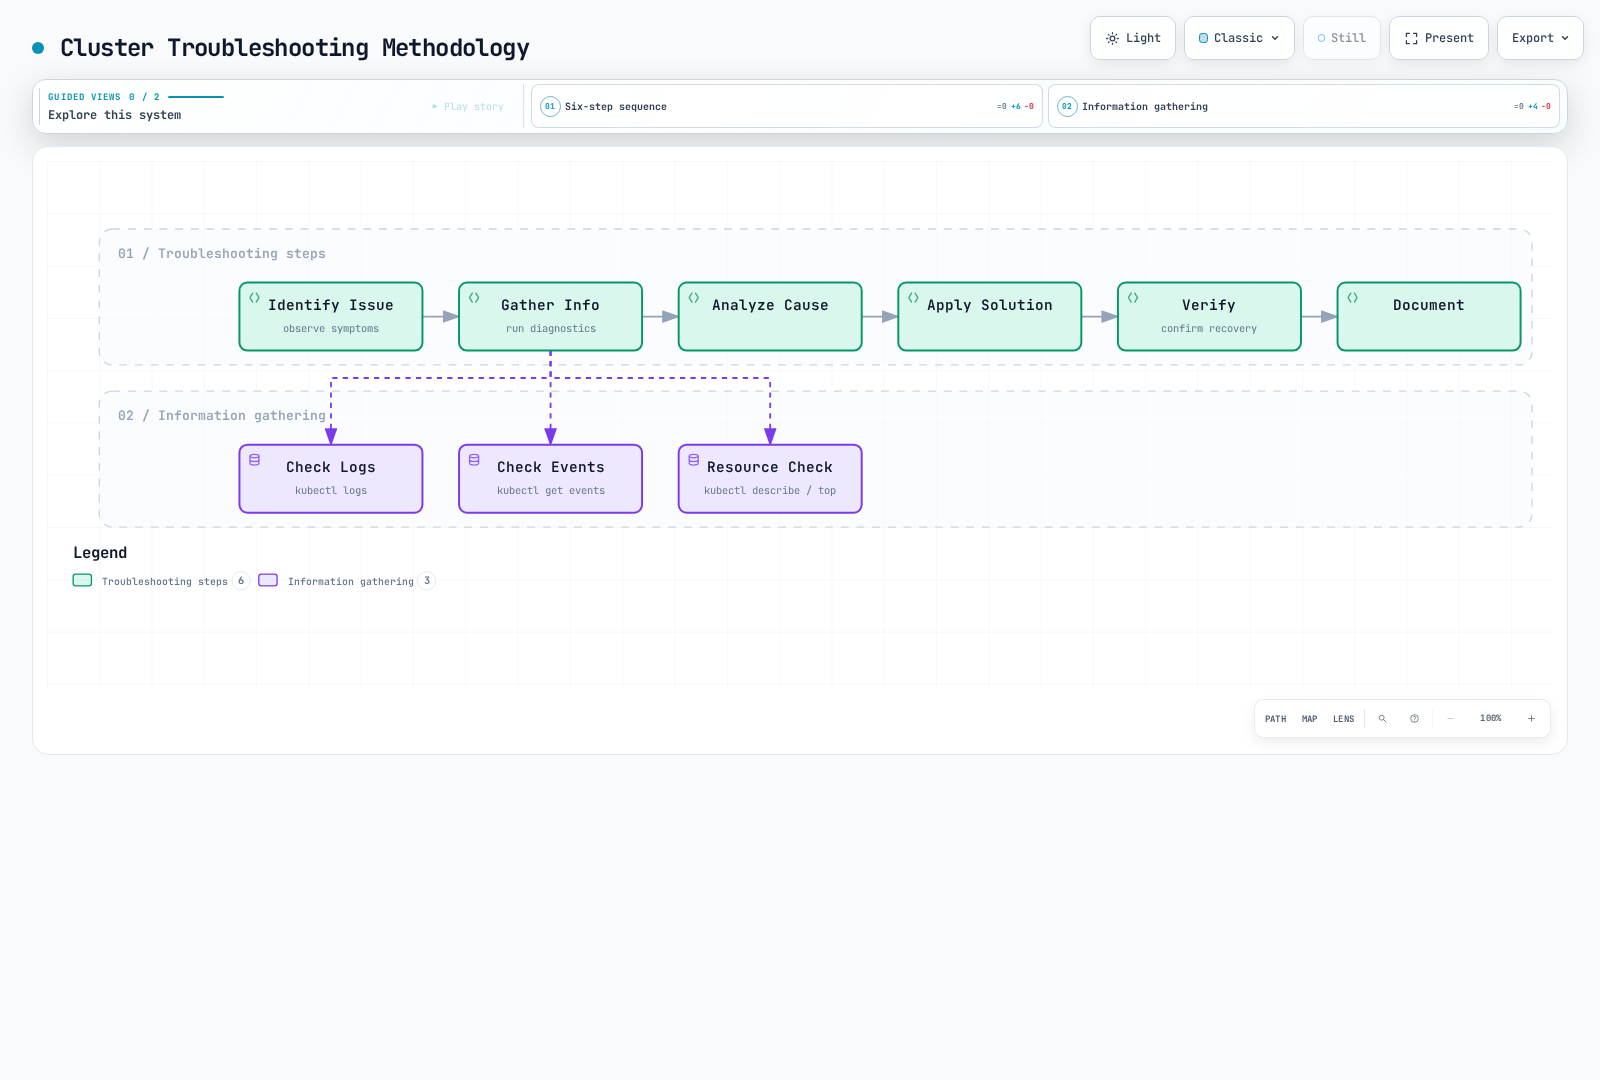
Problemas y soluciones comunes
| Tipo de problema | Síntomas | Comandos de diagnóstico | Soluciones comunes |
|---|---|---|---|
| Pod no se inicia | Pod en estado Pending o ContainerCreating | kubectl describe pod <pod-name> | Compruebe las restricciones de recursos, la disponibilidad de imágenes y los montajes de volumen |
| Problemas de conexión de Service | No se puede acceder a Pods mediante Service | kubectl describe svc <service-name>, kubectl get endpointslices -l kubernetes.io/service-name=<service-name> | Compruebe los selectores de etiquetas, el estado de Pods y las políticas de red |
| Problemas de nodo | Nodo en estado NotReady | kubectl describe node <node-name>, kubectl get events | Compruebe el estado de kubelet, recursos del sistema y conectividad de red |
| Problemas de DNS | No se puede conectar por nombre de Service | kubectl exec -it <pod-name> -- nslookup kubernetes.default | Compruebe los Pods CoreDNS, el Service kube-dns y las políticas de red |
| Problemas de autenticación/autorización | Acceso denegado al servidor de API | kubectl auth can-i <verb> <resource> | Compruebe los ajustes de RBAC, la validez del certificado y la cuenta de servicio |
Resolución de problemas de Pods
# Check pod status
kubectl get pod <pod-name> -o wide
# Check pod details
kubectl describe pod <pod-name>
# Check pod logs
kubectl logs <pod-name>
kubectl logs <pod-name> --previous # Logs from previous container
# Execute command in pod
kubectl exec -it <pod-name> -- /bin/sh
# Check pod events
kubectl get events --field-selector involvedObject.name=<pod-name>Resolución de problemas de nodos
# Check node status
kubectl get nodes
kubectl describe node <node-name>
# Check node resource usage
kubectl top node <node-name>
# Check node system logs (SSH required)
ssh <node-ip> 'sudo journalctl -u kubelet'
# Check kubelet status (SSH required)
ssh <node-ip> 'sudo systemctl status kubelet'Resolución de problemas de red
# Check service and endpoints
kubectl get svc <service-name>
kubectl get endpointslices -l kubernetes.io/service-name=<service-name>
# DNS troubleshooting
kubectl run -it --rm dns-test --image=busybox -- sh
# Inside the container
nslookup kubernetes.default.svc.cluster.local
cat /etc/resolv.conf
# Network connectivity test
kubectl run -it --rm network-test --image=nicolaka/netshoot -- sh
# Inside the container
ping <target-ip>
traceroute <target-ip>
curl <service-name>:<port>Administración de clústeres de Amazon EKS
Amazon EKS (Elastic Kubernetes Service) es un servicio de Kubernetes administrado en AWS donde AWS gestiona el plano de control. Las responsabilidades del cliente para los nodos dependen de los grupos de nodos administrados, Auto Mode, Fargate o cómputo autogestionado; la seguridad y configuración de las cargas de trabajo siguen siendo responsabilidades del cliente.
Arquitectura del clúster de EKS
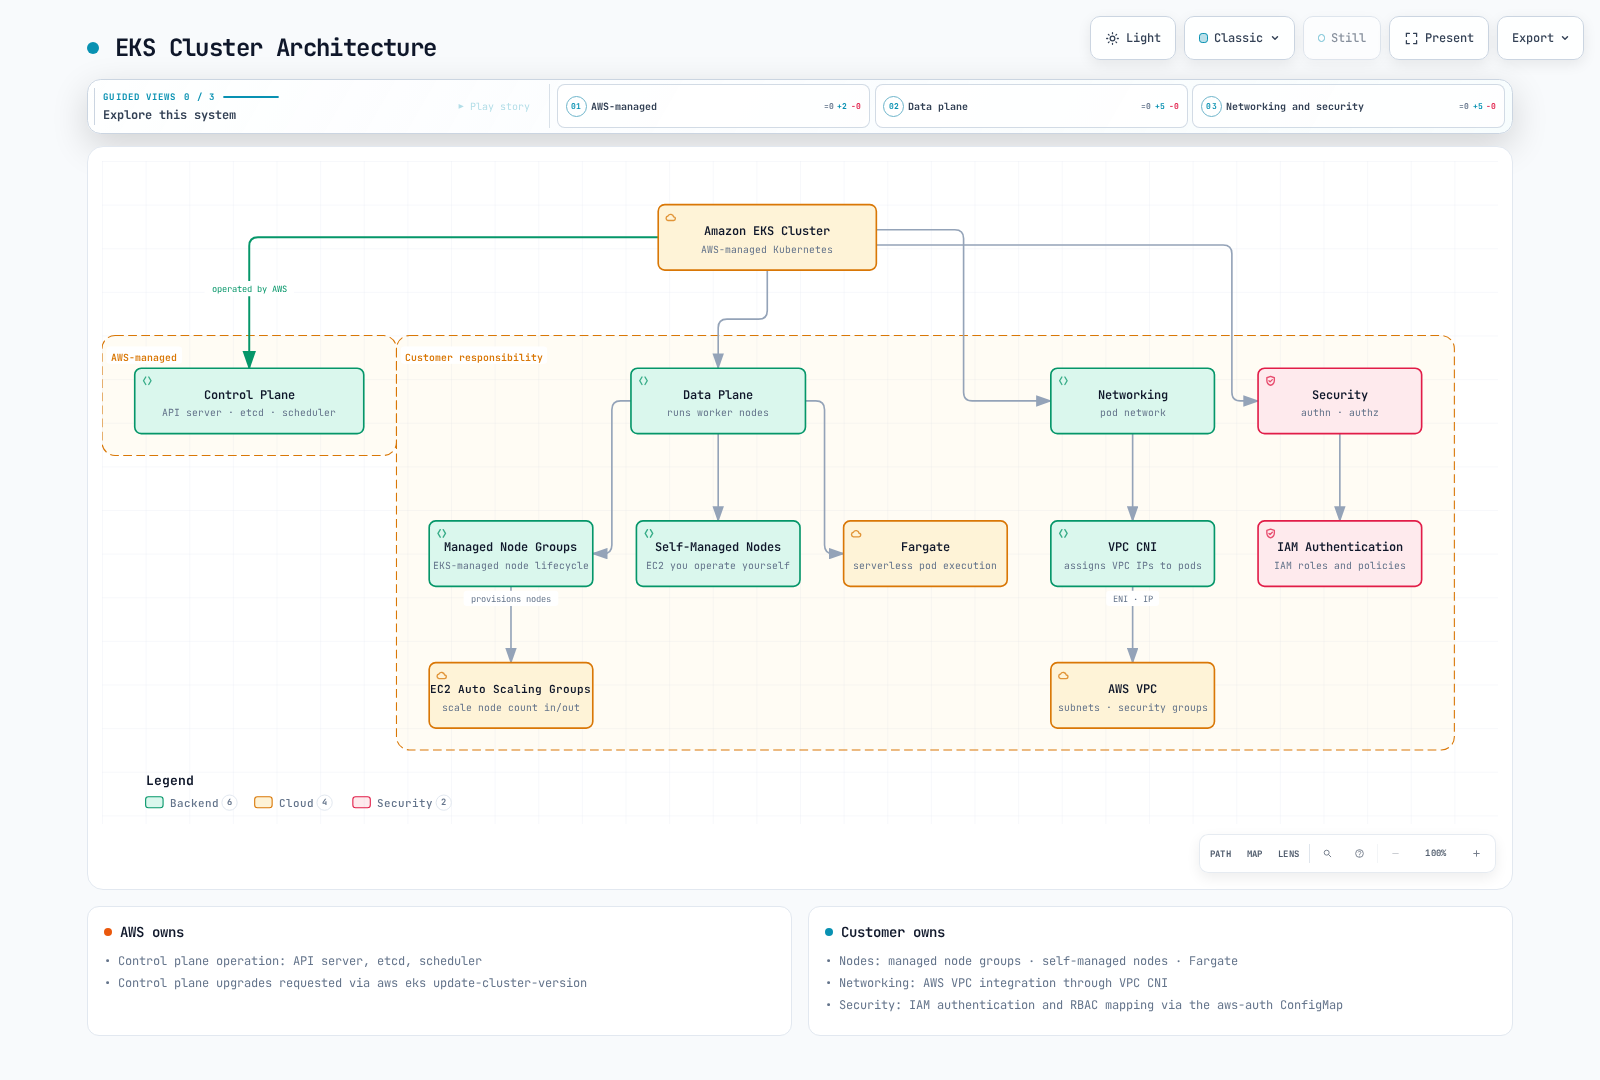
Creación de clústeres de EKS
# Create cluster using eksctl
eksctl create cluster \
--name my-cluster \
--version 1.36 \
--region us-west-2 \
--nodegroup-name standard-workers \
--node-type t3.medium \
--nodes 3 \
--nodes-min 1 \
--nodes-max 5 \
--managed
# Alternative: create control plane using AWS CLI (not after the eksctl example)
aws eks create-cluster \
--name my-cluster \
--role-arn arn:aws:iam::123456789012:role/eks-cluster-role \
--kubernetes-version 1.36 \
--resources-vpc-config "subnetIds=${EKS_SUBNET_IDS:?Set two or more appropriate subnets},securityGroupIds=${EKS_SECURITY_GROUP_ID:?Set the intended security group},endpointPrivateAccess=true,endpointPublicAccess=true,publicAccessCidrs=${ADMIN_CIDR:?Set an approved administrator public CIDR}"Gestión de grupos de nodos
# Create managed node group
eksctl create nodegroup \
--cluster my-cluster \
--region us-west-2 \
--name my-nodegroup \
--node-type t3.medium \
--nodes 3 \
--nodes-min 1 \
--nodes-max 5
# Scale node group
eksctl scale nodegroup \
--cluster my-cluster \
--name my-nodegroup \
--nodes 5 \
--region us-west-2
# Update node group
aws eks update-nodegroup-version \
--cluster-name my-cluster \
--nodegroup-name my-nodegroup \
--region us-west-2Actualización del clúster de EKS
# Check cluster version
aws eks describe-cluster --name my-cluster --query "cluster.version"
# Upgrade cluster control plane
aws eks update-cluster-version \
  --name my-cluster \
  --kubernetes-version "${TARGET_VERSION:?Select the next EKS-supported minor version}"
# Upgrade managed node group
aws eks update-nodegroup-version \
  --cluster-name my-cluster \
--nodegroup-name my-nodegroupAutenticación y autorización del clúster de EKS
El clúster debe usar el modo de autenticación API o API_AND_CONFIG_MAP. Planifique la migración desde las asignaciones heredadas de aws-auth mientras conserva el acceso existente de administrador/nodo. Este ejemplo concede a un rol de visor acceso únicamente al Namespace predeterminado:
aws eks describe-cluster --name my-cluster --query cluster.accessConfig.authenticationMode
aws eks create-access-entry --cluster-name my-cluster \
  --principal-arn arn:aws:iam::123456789012:role/cluster-viewer --type STANDARD
aws eks associate-access-policy --cluster-name my-cluster \
  --principal-arn arn:aws:iam::123456789012:role/cluster-viewer \
  --policy-arn arn:aws:eks::aws:cluster-access-policy/AmazonEKSViewPolicy \
  --access-scope type=namespace,namespaces=default
Consulte la guía de entradas de acceso de EKS. Los permisos para gestionar entradas de acceso de EKS y los permisos de cargas de trabajo de Kubernetes son independientes.
Supervisión del clúster de EKS
El registro del plano de control exporta registros de api/audit/authenticator/controllerManager/scheduler. Container Insights requiere el agente/complemento de CloudWatch y permisos IAM de telemetría con ámbito limitado; no se habilita mediante update-cluster-logging. El complemento de observabilidad de CloudWatch instala componentes de CloudWatch/Fluent Bit, no Prometheus/Grafana. Consulte la configuración oficial del complemento.
# Enable EKS control-plane logs
eksctl utils update-cluster-logging \
  --enable-types all \
  --cluster my-cluster \
  --region us-west-2

# Install CloudWatch observability (not Prometheus/Grafana)
aws eks create-addon \
  --cluster-name my-cluster \
  --addon-name amazon-cloudwatch-observability \
  --addon-version "${CLOUDWATCH_ADDON_VERSION:?Select a compatible add-on version}"
Prácticas recomendadas para la administración de clústeres
Las prácticas recomendadas para una gestión eficaz de clústeres de Kubernetes son importantes para garantizar la estabilidad, seguridad y rendimiento.
Prácticas recomendadas para la configuración del clúster
- Configuración de varias zonas de disponibilidad: Distribuya los nodos en varias zonas de disponibilidad para una alta disponibilidad
- Dimensionamiento adecuado: Seleccione tipos y cantidades de nodos adecuados para las cargas de trabajo
- Configuración de escalado automático: Habilite el escalador automático del clúster y el escalador automático horizontal de Pods
- Aplicar políticas de red: Comience con una política de denegación predeterminada y permita solo la comunicación necesaria
- Establecer cuotas de recursos: Establezca límites de recursos por Namespace
Prácticas recomendadas para operaciones
- Usar configuración declarativa: Defina todos los recursos como archivos YAML y contrólelos por versiones
- Adoptar GitOps: Use Git como la única fuente de verdad y cree canalizaciones de implementación automatizadas
- Copias de seguridad periódicas: Copia de seguridad periódica de datos de etcd y datos de volúmenes persistentes
- Supervisión y alertas: Cree sistemas integrales de supervisión y establezca alertas para métricas clave
- Registro centralizado: Recopile todos los registros en un sistema de registro central para facilitar el análisis
Prácticas recomendadas de seguridad
- Principio de mínimo privilegio: Conceda solo los permisos mínimos necesarios mediante RBAC
- Segmentación de red: Limite la comunicación entre Pods mediante políticas de red
- Análisis de imágenes: Implemente el análisis de imágenes de contenedor para detectar vulnerabilidades
- Gestión de Secrets: Use herramientas externas de gestión de Secrets (p. ej., AWS Secrets Manager, HashiCorp Vault)
- Auditorías de seguridad periódicas: Realice auditorías periódicas de la configuración y permisos del clúster
Prácticas recomendadas de actualización
- Actualizaciones graduales: Actualice gradualmente en lugar de hacerlo todo a la vez
- Primero el entorno de pruebas: Verifique las actualizaciones en entornos de prueba antes de producción
- Crear copias de seguridad: Realice copias de seguridad completas antes de las actualizaciones
- Plan de reversión: Desarrolle un plan para volver a versiones anteriores en caso de problemas
- Establecer ventanas de actualización: Realice actualizaciones durante períodos de poco uso
Prácticas recomendadas de optimización de costos
- Seleccionar tamaños de nodo adecuados: Seleccione tipos de nodo óptimos para las cargas de trabajo
- Utilizar instancias Spot: Use instancias Spot para cargas de trabajo no críticas
- Configurar el escalado automático: Configure el escalado automático hacia arriba y abajo según la demanda
- Optimizar solicitudes y límites de recursos: Establezca solicitudes y límites de recursos según el uso real
- Identificar recursos inactivos: Identifique y elimine periódicamente los recursos inactivos
Prácticas recomendadas de documentación
- Documentar la arquitectura: Documente la arquitectura del clúster, las redes y la configuración de seguridad
- Documentar procedimientos de operaciones: Documente tareas de operaciones comunes, procedimientos de resolución de problemas y planes de respuesta a emergencias
- Gestión de cambios: Registre y haga seguimiento de todos los cambios del clúster
- Crear runbooks: Proporcione guías paso a paso para escenarios comunes
- Intercambio de conocimientos: Realice sesiones periódicas de intercambio de conocimientos y formación dentro del equipo
Conclusión
La administración de clústeres de Kubernetes es una tarea compleja que incluye varios aspectos. Se requiere un enfoque sistemático desde la configuración del clúster hasta la operación, supervisión, resolución de problemas y actualizaciones.
Para una administración eficaz de clústeres, concéntrese en las siguientes áreas clave:
- Gestión de componentes del clúster: Operación estable de los componentes del plano de control y de nodo
- Gestión de recursos: Asignación y uso eficiente de recursos
- Redes: Configuración de red segura y eficiente
- Seguridad: Gestión adecuada de autenticación y autorización
- Copia de seguridad y recuperación: Prevención de pérdida de datos y planificación de recuperación ante desastres
- Supervisión y registro: Supervisión del estado y rendimiento del clúster
- Resolución de problemas: Enfoque sistemático de resolución de problemas
Al usar servicios de Kubernetes administrados como Amazon EKS, es importante comprender el modelo de responsabilidad compartida entre el proveedor de servicios y el usuario. AWS gestiona el plano de control, mientras que la responsabilidad de cómputo varía según el modo; los clientes aún gestionan la configuración y seguridad de las aplicaciones.
Al seguir las prácticas recomendadas y utilizar herramientas apropiadas, puede operar un clúster de Kubernetes estable, seguro y eficiente. Es importante el aprendizaje y la mejora continuos para potenciar las capacidades de gestión de clústeres.
Referencias:
Cuestionario
Para comprobar lo aprendido en este capítulo, pruebe el Cuestionario de administración de clústeres.