Observabilidad
Versiones compatibles: Istio 1.31 Última actualización: 11 de septiembre de 2026
Los proxies Istio generan telemetría del tráfico que observan. Deben configurarse scraping, logs de acceso, proveedores de trazas y almacenamiento. Las aplicaciones deben propagar contexto entre solicitudes entrantes y salientes para unir spans; spans internos y excepciones necesitan instrumentación/logging de aplicación.
Índice
- Descripción general
- Tres pilares
- Arquitectura
- Señales doradas
- Documentación detallada
- Buenas prácticas
- Siguientes pasos
Descripción general
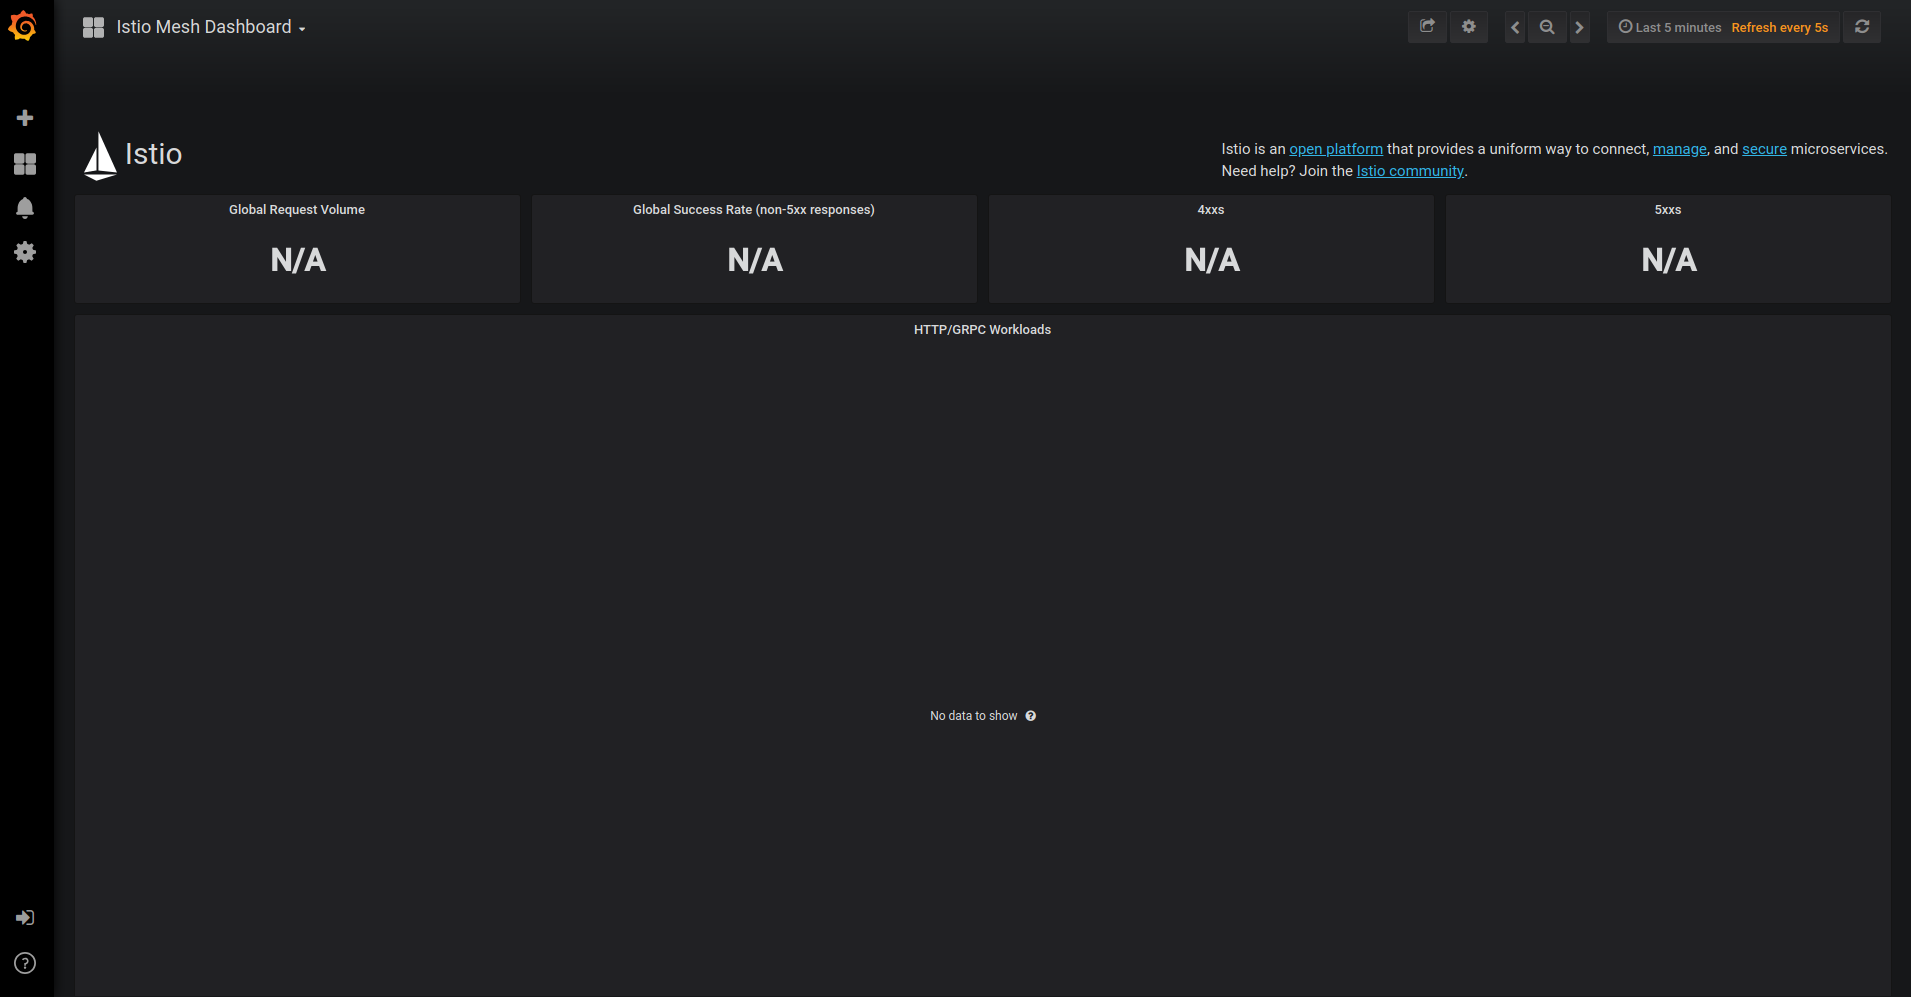
Sidecars y waypoints pueden informar HTTP, spans y accesos sin añadir instrumentación de proxy al código. ztunnel ambient proporciona L4; HTTP necesita waypoint. CPU, memoria y paquetes de host proceden de exporters Kubernetes/nodo, no de métricas de solicitudes Istio. La captura muestra un dashboard configurado, no un componente instalado automáticamente.
Tres pilares de observabilidad
Los tres elementos
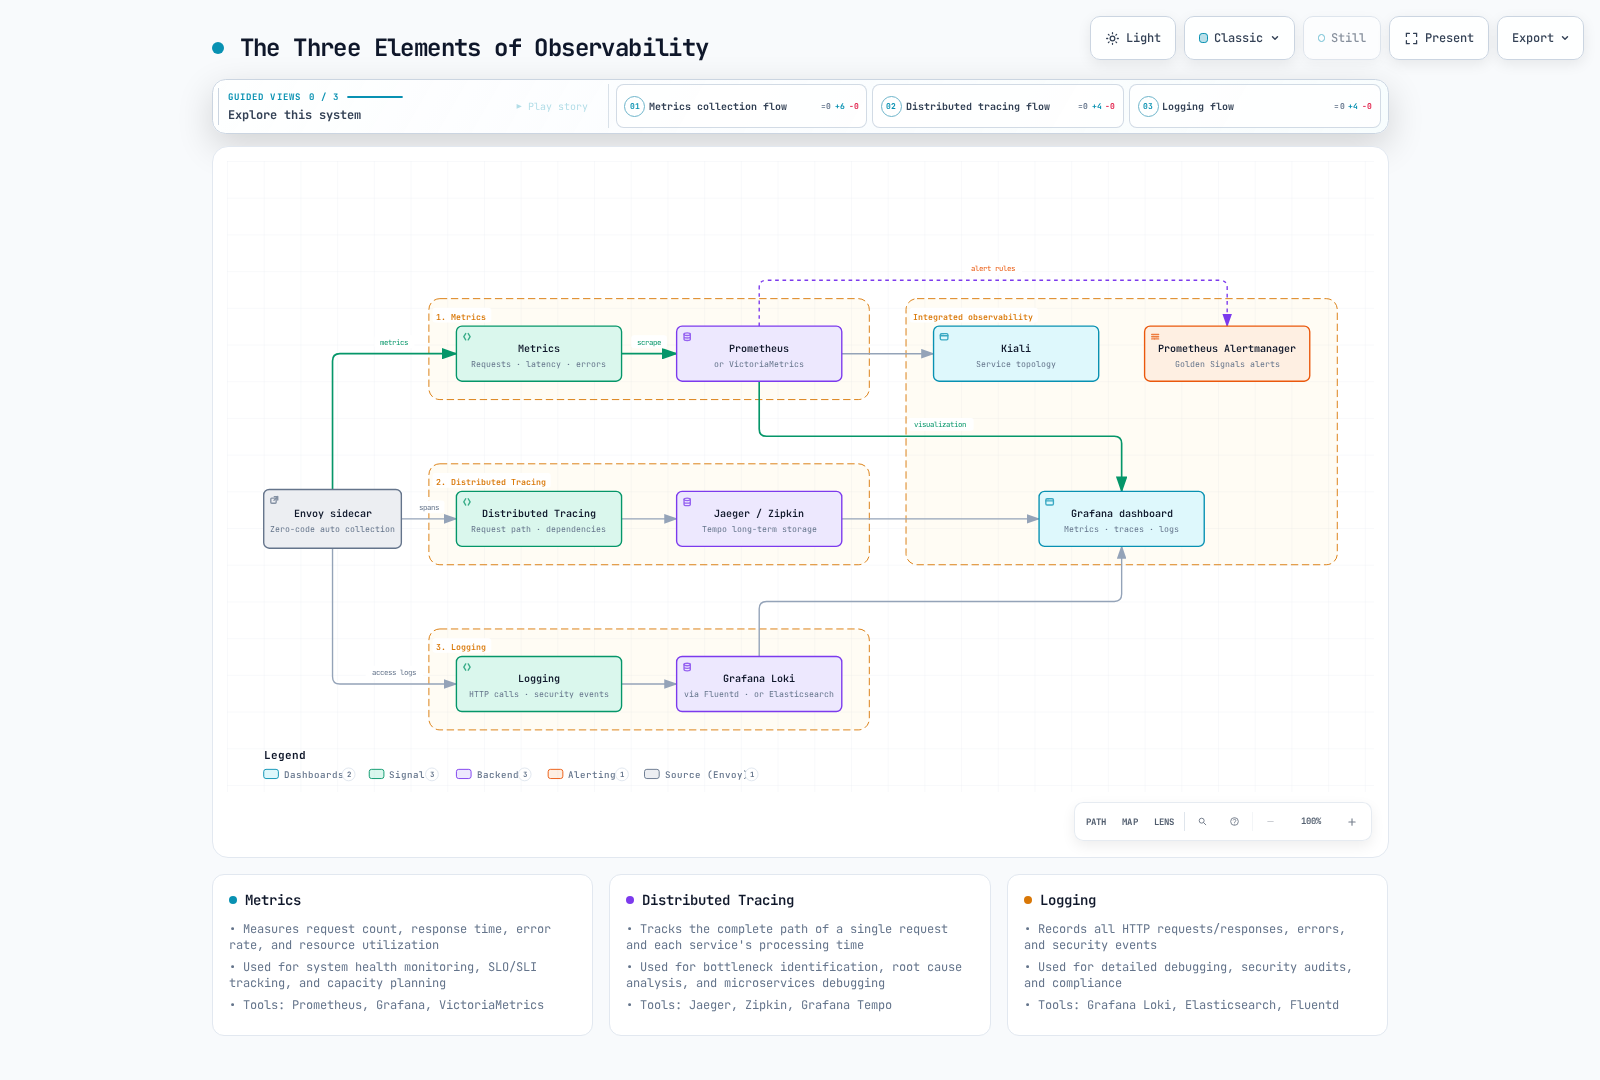
1. Métricas
¿Qué se mide?
- Solicitudes, tiempo de respuesta y tasa de errores
- Utilización de recursos CPU/memoria
- Tráfico de red en bytes y paquetes
¿Cuándo usarlas?
- Monitorizar salud del sistema
- Seguir SLO/SLI
- Planificar capacidad
Herramientas principales: Prometheus, Grafana, VictoriaMetrics
2. Trazado distribuido
¿Qué se sigue?
- Ruta completa de una solicitud
- Tiempo de procesamiento por servicio
- Dependencias entre servicios
¿Cuándo usarlo?
- Identificar cuellos de botella
- Analizar causas de fallos
- Depurar microservicios
Herramientas principales: Jaeger, Zipkin, Grafana Tempo
3. Registros
¿Qué se registra?
- Metadatos HTTP de acceso configurados, no cuerpos completos
- Errores proxy; excepciones de aplicación necesitan logs propios
- Eventos de seguridad
¿Cuándo usarlos?
- Diagnóstico detallado
- Auditorías de seguridad
- Requisitos de cumplimiento
Herramientas principales: Grafana Loki, Elasticsearch, Fluentd
Arquitectura de observabilidad
Arquitectura general
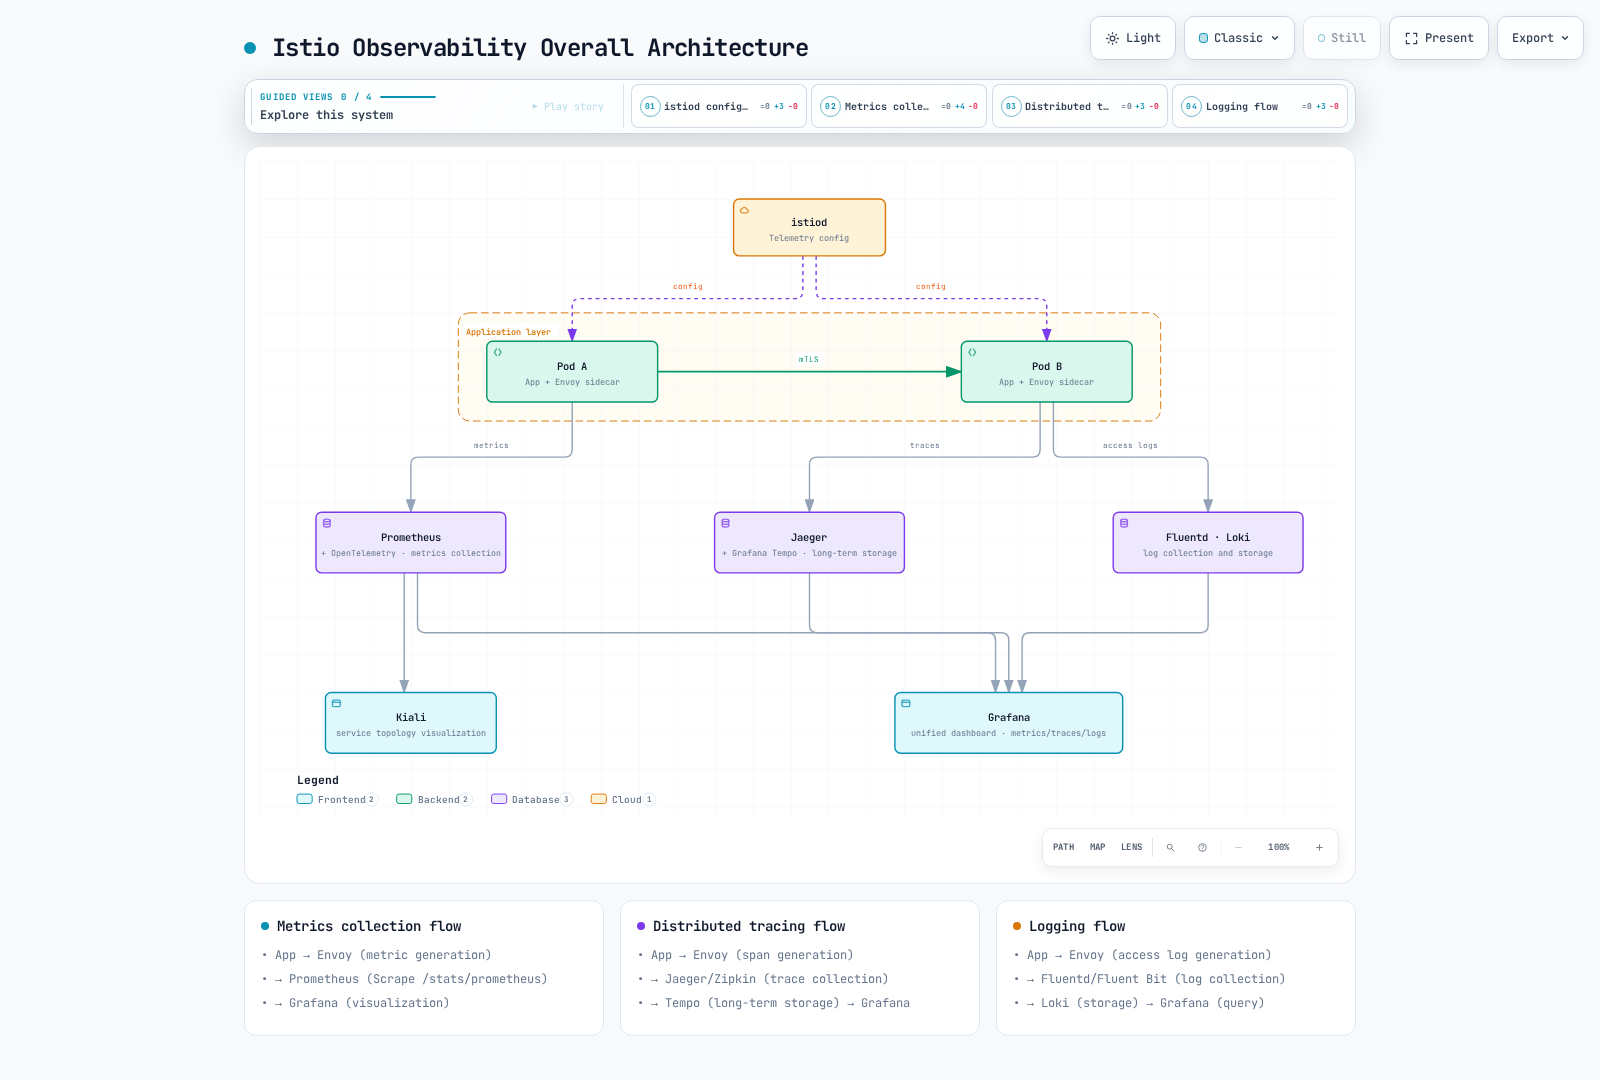
Flujo de datos
1. Recogida de métricas:
App → Envoy (metric generation)
    → Prometheus (Scrape /stats/prometheus)
    → Grafana (visualization)
2. Trazado distribuido:
App propagates context → Envoy generates spans
    → configured collector/protocol (for example OpenTelemetry/OTLP)
    → one chosen backend: Jaeger, Zipkin or Tempo
    → backend UI or configured Grafana datasource
3. Registros:
App → Envoy (Access Log generation)
    → Fluentd/Fluent Bit (log collection)
    → Loki (log storage)
    → Grafana (log query and visualization)
Señales doradas
Señales principales según Google SRE. Las consultas HTTP seleccionan reporter="destination" para no contar source y destination del mismo salto. Miden saltos de servicios, no transacciones únicas. Analice aparte tráfico externo/gateway sin destination reporter; los fallos gRPC requieren además grpc_response_status. La latencia siguiente está en milisegundos.
1. Latencia
# P50 latency
histogram_quantile(0.50,
  sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])) by (le)
)

# P95 latency
histogram_quantile(0.95,
  sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])) by (le)
)

# P99 latency
histogram_quantile(0.99,
  sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination"}[5m])) by (le)
)
2. Tráfico
# Requests per second (RPS)
sum(rate(istio_requests_total{reporter="destination"}[5m]))

# Traffic by service
sum(rate(istio_requests_total{reporter="destination"}[5m])) by (destination_service)
3. Errores
# Error rate (%)
sum(rate(istio_requests_total{reporter="destination",response_code=~"5.."}[5m]))
/
sum(rate(istio_requests_total{reporter="destination"}[5m]))
* 100

# 4xx vs 5xx errors
sum(rate(istio_requests_total{reporter="destination",response_code=~"4.."}[5m])) by (response_code)
sum(rate(istio_requests_total{reporter="destination",response_code=~"5.."}[5m])) by (response_code)
4. Saturación
# CPU consumption in cores (not percent), one series per application container.
sum by (namespace, pod, container) (
  rate(container_cpu_usage_seconds_total{container!="",container!="POD"}[5m])
)

# Memory working set / configured limit (%); containers without limits omitted.
100 * max by (namespace, pod, container) (
  container_memory_working_set_bytes{container!="",container!="POD"}
)
/ on (namespace, pod, container)
(max by (namespace, pod, container) (
  kube_pod_container_resource_limits{resource="memory",unit="byte"}
) > 0)
Requieren kubelet/cAdvisor y kube-state-metrics; no son métricas Istio. Evite targets duplicados e incluya clúster en agregaciones multiclúster. Uso relativo a un limit es solo una señal; revise también throttling, colas y trabajo pendiente.
Buenas prácticas
1. Usar métricas estándar
Recomendado:
- Priorizar métricas estándar Istio
- Añadir personalizadas solo si es necesario
- Minimizar etiquetas considerando cardinalidad
Evitar:
- Métricas personalizadas excesivas
- Etiquetas de alta cardinalidad como user_id o request_id
2. Muestreo de trazas
Configure tasas apropiadas para producción:
Debe existir un Service collector OTLP en la dirección siguiente y exportar al backend elegido. Combine el proveedor con la instalación y configure muestreo mediante Telemetry:
# istioctl install -f input, not kubectl apply
apiVersion: install.istio.io/v1alpha1
kind: IstioOperator
spec:
  meshConfig:
    enableTracing: true
    extensionProviders:
    - name: otel
      opentelemetry:
        service: otel-collector.observability.svc.cluster.local
port: 4317apiVersion: telemetry.istio.io/v1
kind: Telemetry
metadata:
name: mesh-tracing
namespace: istio-system
spec:
tracing:
- providers:
- name: otel
randomSamplingPercentage: 1.01.0 significa 1%, no 100%. Elija según tráfico, investigación y capacidad collector/backend; 100% puede servir en pruebas pequeñas, mientras tasas menores necesitan validación productiva. Sigue siendo necesaria la propagación. No añada otro Telemetry sin selector al mismo namespace; combine trazas/accesos en un recurso si usa ambos ejemplos.
3. Optimizar logs de acceso
Lo siguiente filtra solicitudes, no campos. Configure selección/ocultación de campos en el proveedor de acceso. Este filtro HTTP omite éxitos, por lo que no es auditoría completa:
apiVersion: telemetry.istio.io/v1
kind: Telemetry
metadata:
  name: mesh-default
  namespace: istio-system
spec:
  accessLogging:
  - providers:
    - name: envoy
    filter:
      expression: response.code >= 400  # Record only errors
4. Retención de métricas
Intervalos ilustrativos que adaptar a operación, coste de almacenamiento y requisitos reales, no valores regulatorios:
- Métricas en tiempo real: 1-7 días, alta resolución
- Métricas a largo plazo: 30-90 días, resolución reducida
- Trazas: 7-30 días
- Logs: Según política real; 30–365 días es solo ejemplo
TSDB local Prometheus no reduce resolución de datos antiguos automáticamente. Configure explícitamente un backend con downsampling/almacenamiento prolongado si lo necesita.
5. Configuración de alertas
Los umbrales son ejemplos; prefiera SLO de servicio y consumo sostenido de presupuesto de errores con volumen mínimo para reducir ruido.
Alertas críticas (respuesta inmediata):
- Tasa de errores > 5%
- Latencia P99 > umbral
- Servicio caído
Advertencias (monitorización):
- Tasa de errores > 1%
- Aumento de latencia P95
- Utilización > 80%
Documentación detallada
Guías por área:
1. Métricas
Aprenda en la guía de métricas:
- Métricas estándar Istio
- Integración Prometheus
- Integración OpenTelemetry
- Métricas personalizadas
- Optimización
Temas principales:
istio_requests_total: Total de solicitudesistio_request_duration_milliseconds: Latenciaistio_request_bytes/istio_response_bytes: Histogramas de tamaño de solicitud/respuesta- Métricas de circuit breaker
- Personalización Telemetry API
2. Trazado distribuido
Aprenda en la guía de trazado:
- Integración Jaeger
- Integración Zipkin
- Muestreo
- Propagación de contexto
- Análisis de rendimiento
Temas principales:
- Propagación W3C Trace Context
- Creación y gestión de spans
- Selección de backend Jaeger/Zipkin/Tempo
- Estrategias de muestreo
- Análisis de trazas
3. Registros
Aprenda en la guía de registros:
- Configurar accesos
- Personalizar formato
- Integración Grafana Loki
- Filtrar logs
- Agregar logs
Temas principales:
- Formato de acceso Envoy
- Logs JSON estructurados
- Niveles de log
- Recogida Fluentd/Fluent Bit
- Consultas LogQL
4. Dashboards
Aprenda en la guía de dashboards:
- Dashboards Grafana
- Grafo de servicios Kiali
- Crear dashboards personalizados
- Configurar alertas
Temas principales:
- Dashboards estándar Istio
- Dashboard de malla
- Dashboard de cargas
- Visualización de tráfico Kiali
- Dashboards SLO
Siguientes pasos
- Métricas: Recogida y consultas Prometheus
- Trazado distribuido: Análisis Jaeger/Zipkin
- Registros: Accesos e integración Loki
- Dashboards: Grafana y Kiali
Referencias
Documentación oficial
Proyectos relacionados
Estándares y especificaciones
Cuestionario
Pruebe sus conocimientos con el cuestionario de observabilidad Istio.