Descripción general de alertas
Última actualización: September 13, 2026
Referencia de revisión: Prometheus 3.14.0 y Alertmanager 0.34.0. Los ejemplos suponen un clúster y series sin duplicados. Verifica los jobs, las labels, los exporters y la disponibilidad de métricas reales; después, ajusta los umbrales. Solo se ejecutaron comprobaciones locales de reglas/enrutamiento; no se probó ningún clúster ni canal de notificación.
Tabla de contenido
- El papel y la importancia de las alertas
- Ciclo de vida de las alertas
- Principios de diseño de alertas
- Enrutamiento y escalamiento de alertas
- Rotación de guardias
- Estrategia de alertas para entornos EKS
- Comparación de soluciones
El papel y la importancia de las alertas
La posición de las alertas en los tres pilares de la observabilidad
Las métricas, los logs y las trazas son señales habituales de observabilidad; también existen perfiles y otras señales. Un motor de reglas no evalúa necesariamente las tres de forma directa:
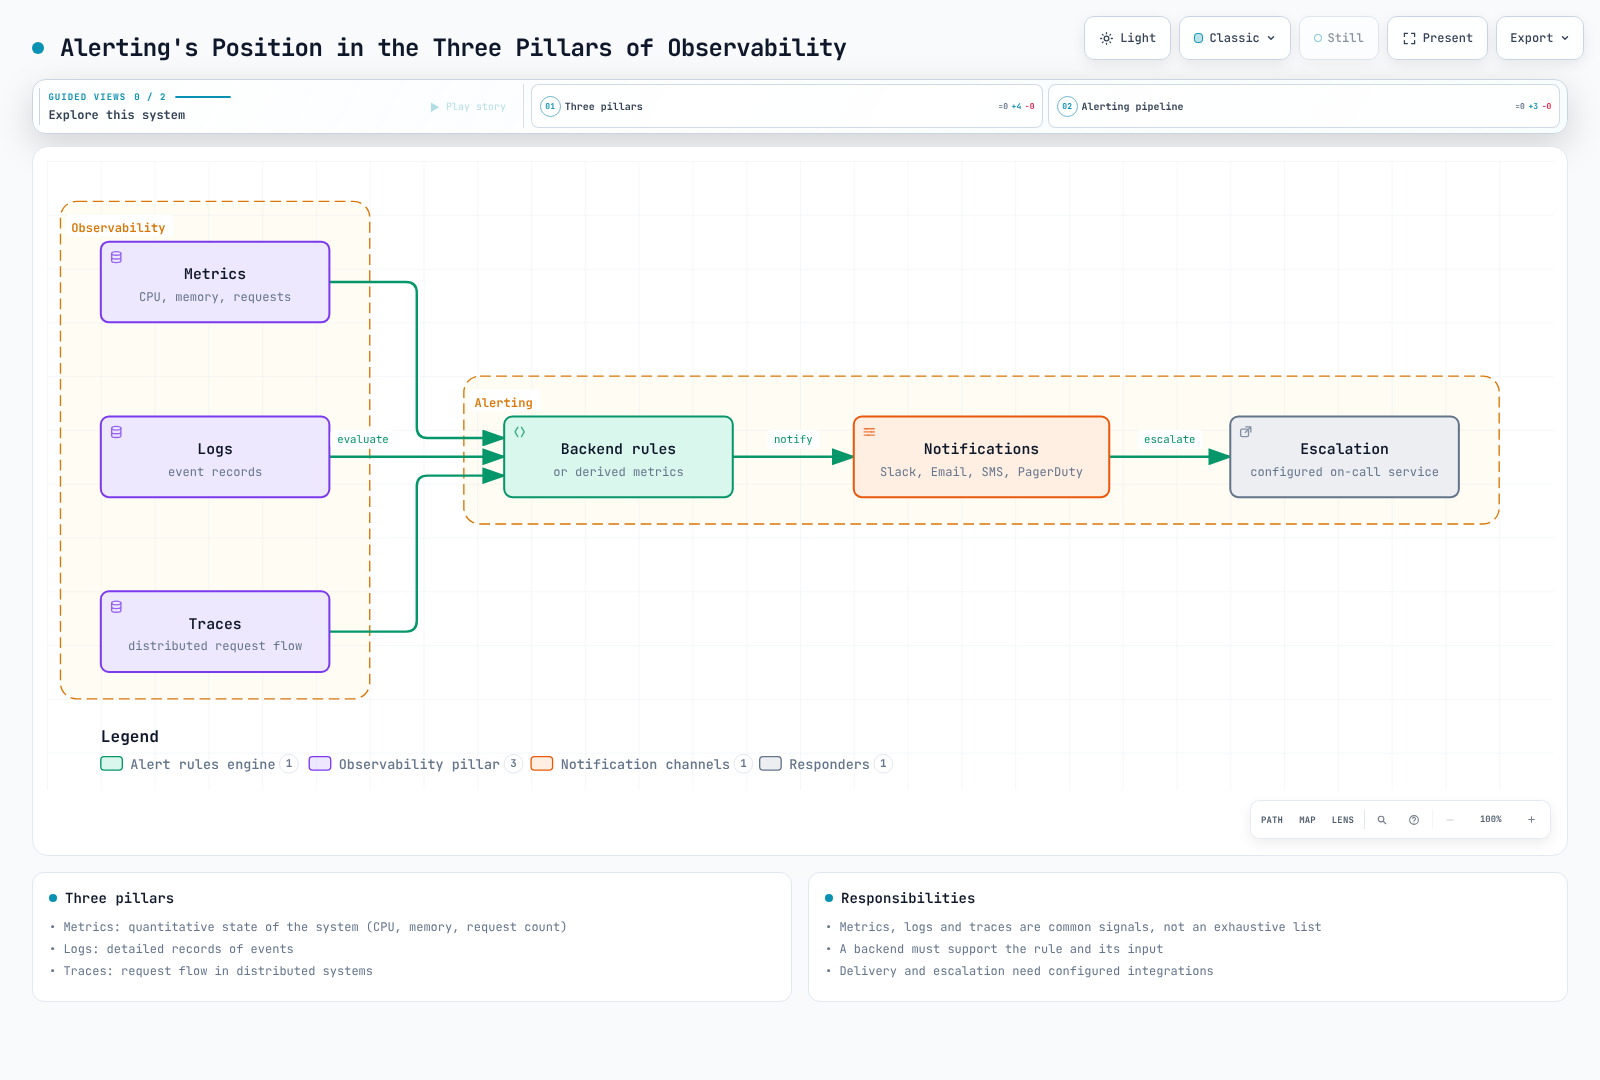
- Métricas: Estado cuantitativo del sistema (CPU, memoria, recuento de solicitudes, etc.)
- Logs: Registros detallados de eventos
- Trazas: Flujo de solicitudes en sistemas distribuidos
Las reglas de Prometheus evalúan métricas. Los logs y las trazas alimentan alertas mediante reglas específicas del backend o métricas derivadas. La detección, la notificación y el reconocimiento humano son etapas independientes, y el éxito de la entrega necesita su propia monitorización.
Por qué son necesarias las alertas
- Respuesta proactiva a problemas: Detectar problemas antes de que los usuarios los experimenten
- Minimizar el tiempo de inactividad: Mejorar la disponibilidad del servicio mediante detección y respuesta rápidas
- Reducción de costes: Reducir costes laborales mediante monitorización automatizada
- Cumplimiento de SLA/SLO: Componente esencial para alcanzar objetivos de nivel de servicio
- Registro de incidentes: Seguir y analizar el historial de ocurrencia de problemas
Alertas buenas frente a alertas malas
| Aspecto | Alertas buenas | Alertas malas |
|---|---|---|
| Capacidad de acción | Requieren acción inmediata | Solo información, no se necesita acción |
| Claridad | Está claro cuál es el problema | Vagas y poco claras |
| Urgencia | La urgencia coincide con la gravedad | Todo es urgente |
| Frecuencia | Frecuencia adecuada | Demasiado frecuentes o demasiado escasas |
| Duplicación | Las alertas relacionadas se agrupan | Decenas de alertas por el mismo problema |
Ciclo de vida de las alertas
El diagrama combina el estado de las reglas y la respuesta a incidentes. Prometheus usa inactive/pending/firing; el reconocimiento y el trabajo en curso pertenecen a una herramienta de guardia. Cerrar un incidente no elimina una regla en estado firing. Una serie temporal que desaparece también puede desactivar una regla y no debe tratarse como prueba de recuperación:
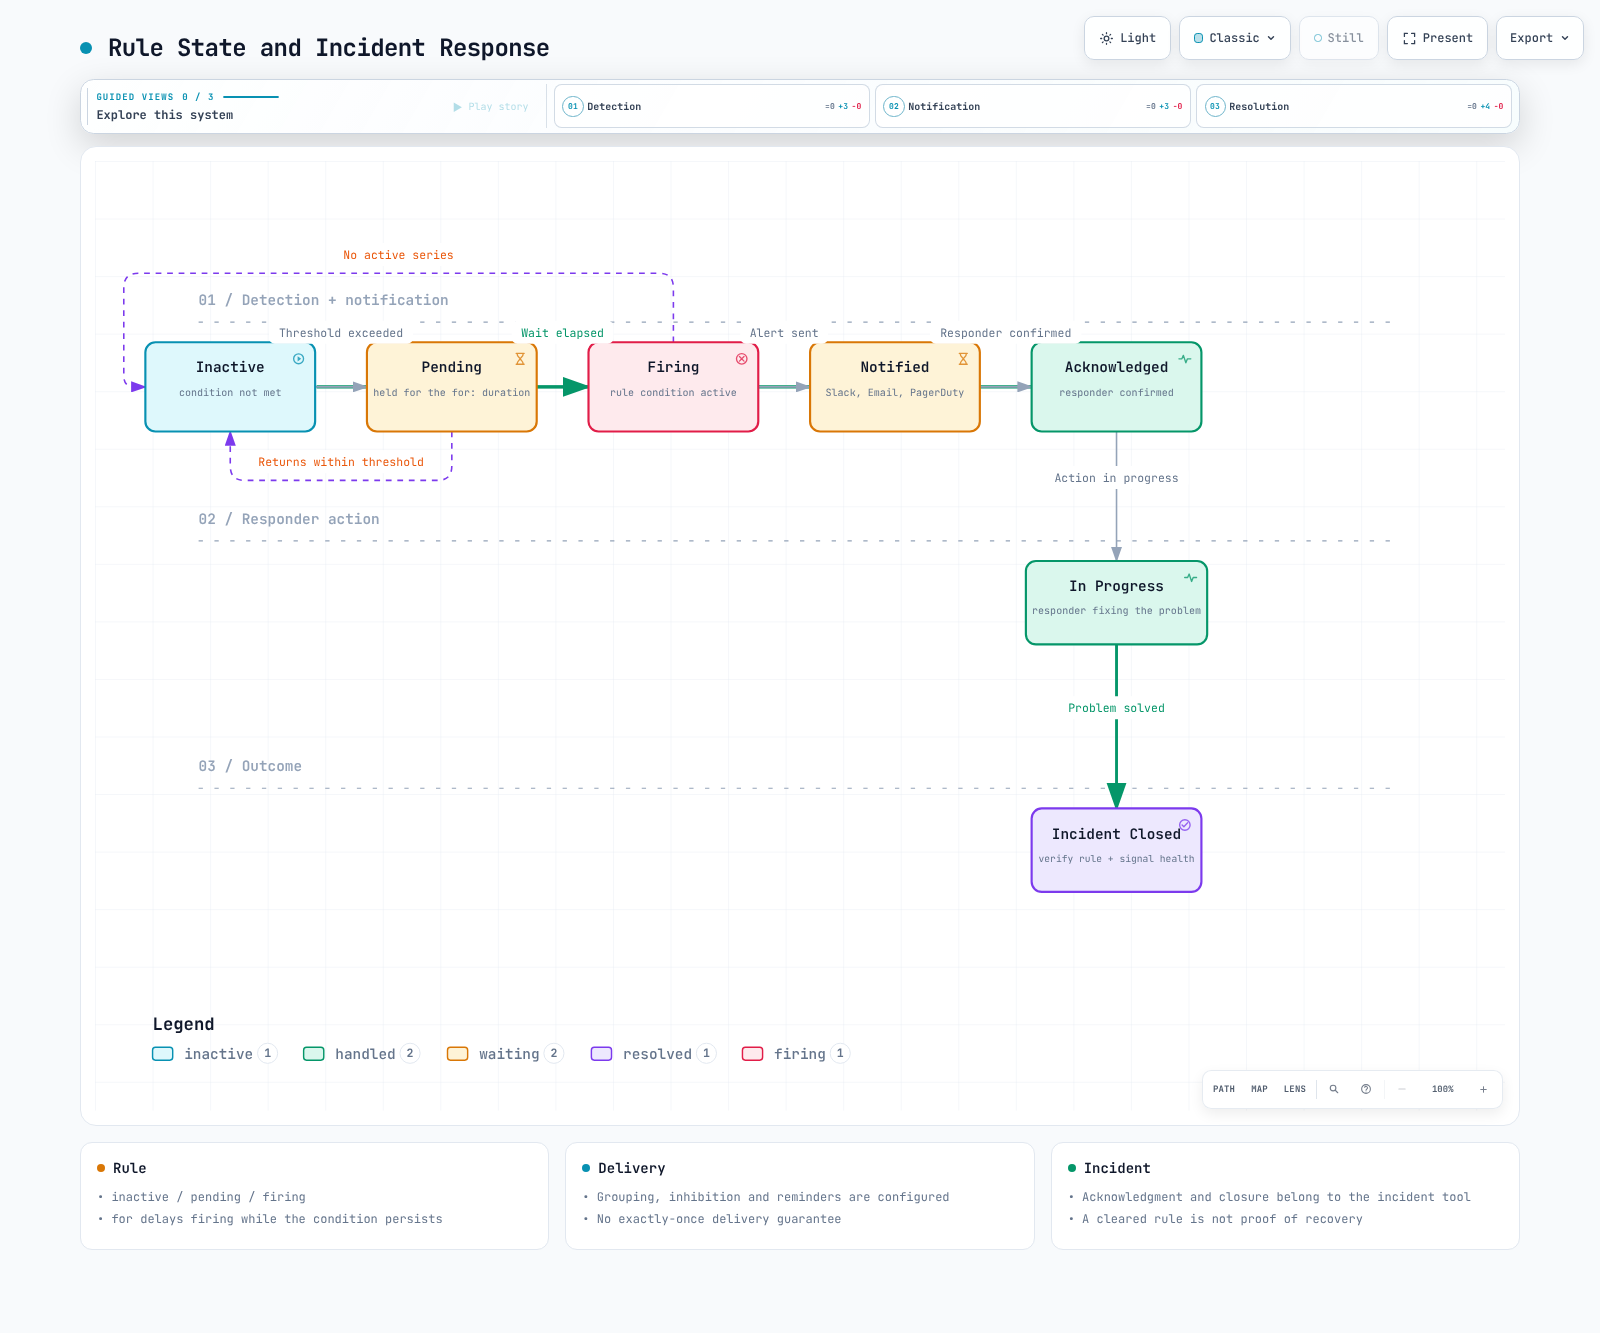
1. Detección
- Basada en umbrales: Cuando un valor específico supera un umbral configurado
- Basada en la tasa de cambio: Cuando la tasa de cambio es anómala
- Detección de anomalías: Detección de patrones anómalos basada en aprendizaje automático
- Patrones de logs: Cuando ocurren patrones de logs específicos
groups:
  - name: node-alerts
    rules:
      - alert: HighCPUUsage
        expr: 100 * (1 - avg by (cluster, instance) (rate(node_cpu_seconds_total{mode="idle"}[5m]))) > 80
        for: 5m
        labels:
          severity: warning
          team: sre
        annotations:
          summary: "High CPU usage detected"
          description: "CPU usage is above 80% for 5 minutes on {{ $labels.instance }}"
2. Notificación
- Selección de canal: Slack, Email, SMS, PagerDuty, etc.
- Enrutamiento: Entregar a receptores adecuados según el tipo de alerta
- Agrupación: Reunir alertas relacionadas
- Eliminación de duplicados: Reducir las notificaciones duplicadas; los recordatorios de repeat_interval y los reintentos siguen siendo posibles, sin una garantía de exactamente una vez
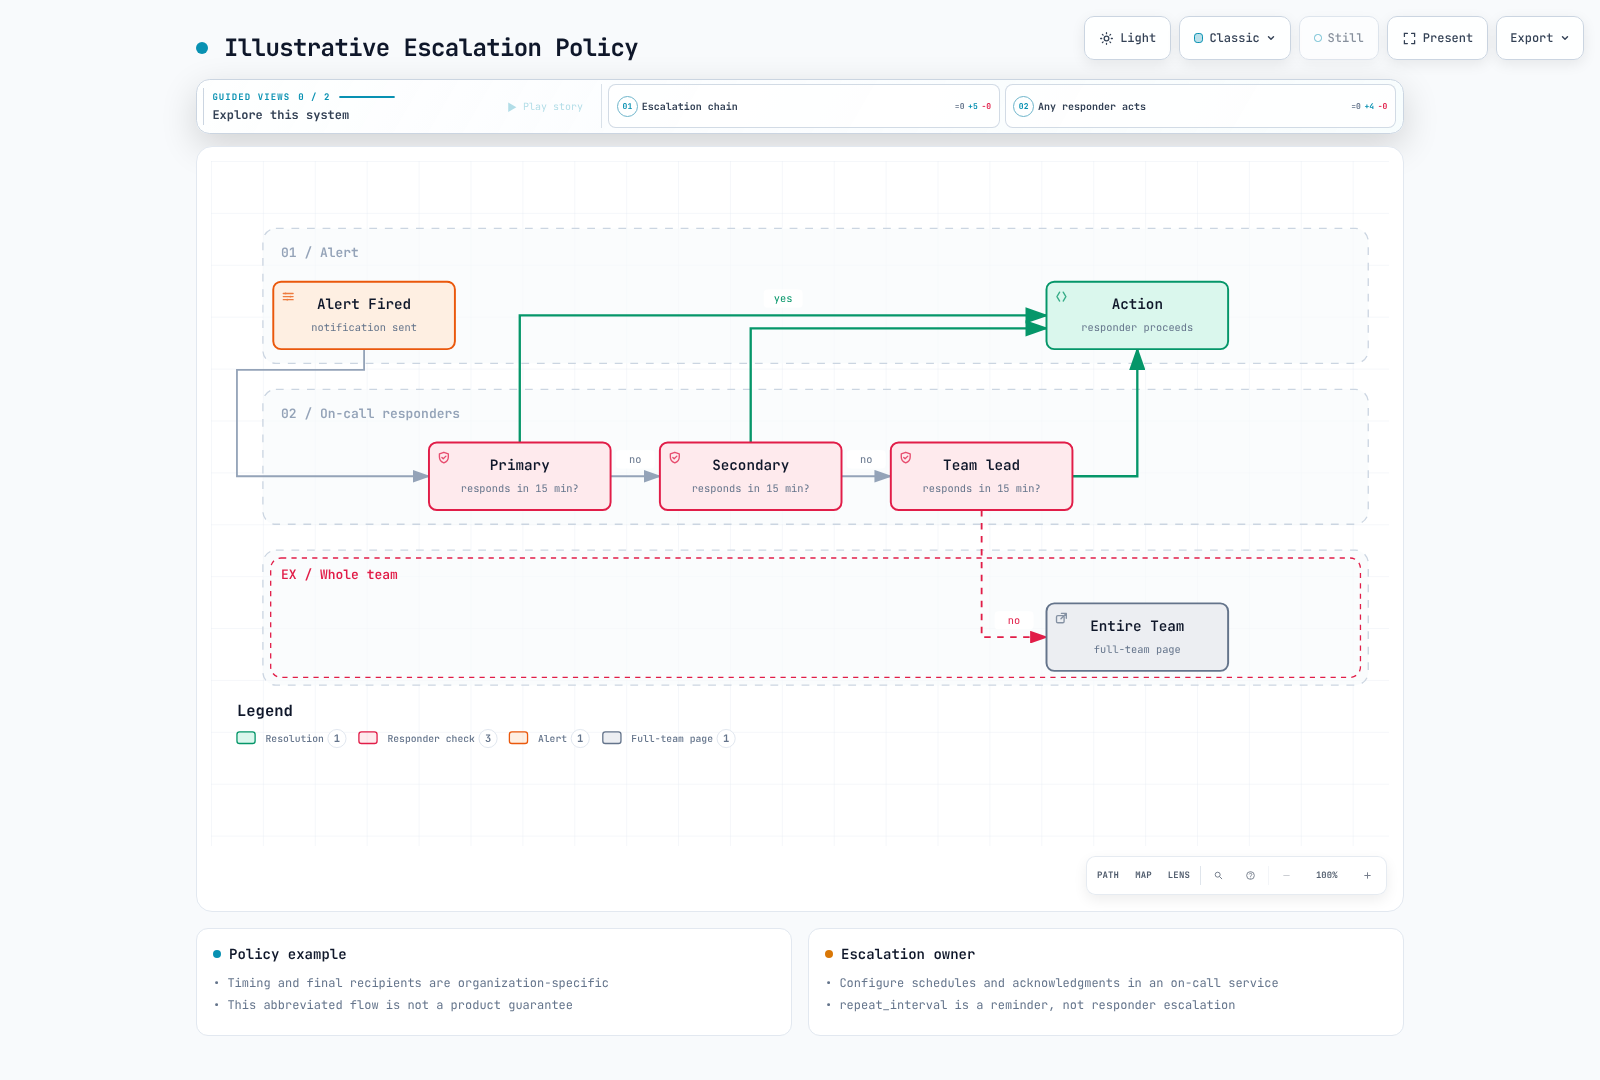
3. Escalamiento
- Basado en tiempo: Escalar al siguiente respondedor si no hay respuesta en el plazo especificado
- Basado en gravedad: Rutas de escalamiento diferentes según la gravedad
- Escalamiento automático: Configúralo en el servicio de guardia. Alertmanager repeat_interval no comprueba el reconocimiento ni rota respondedores
4. Resolución
- Resolución manual: Un respondedor cierra el incidente en la herramienta de incidentes; el estado de la regla se comprueba por separado
- Resolución automática: Actualizar el estado del incidente según la política de integración después de comprobar el estado de la regla y de la recopilación
- Notificación de resolución: Enviar una notificación de resolución cuando se solucione el problema
Principios de diseño de alertas
1. Alertas procesables
Los avisos urgentes que interrumpen a una persona necesitan una respuesta procesable inmediata. Los eventos informativos y el trabajo a más largo plazo pueden ir en su lugar a tickets o dashboards.
Ejemplo malo:
Alert: Database connection count increasedEjemplo bueno:
Alert: Database connection pool exhausted
Action Required: Confirm user impact; inspect pool saturation and connection leaks using the runbook
Runbook: https://example.com/runbooks/replace-db-runbook
2. Prevención de la fatiga por alertas
Demasiadas alertas pueden hacer que se pasen por alto alertas importantes.
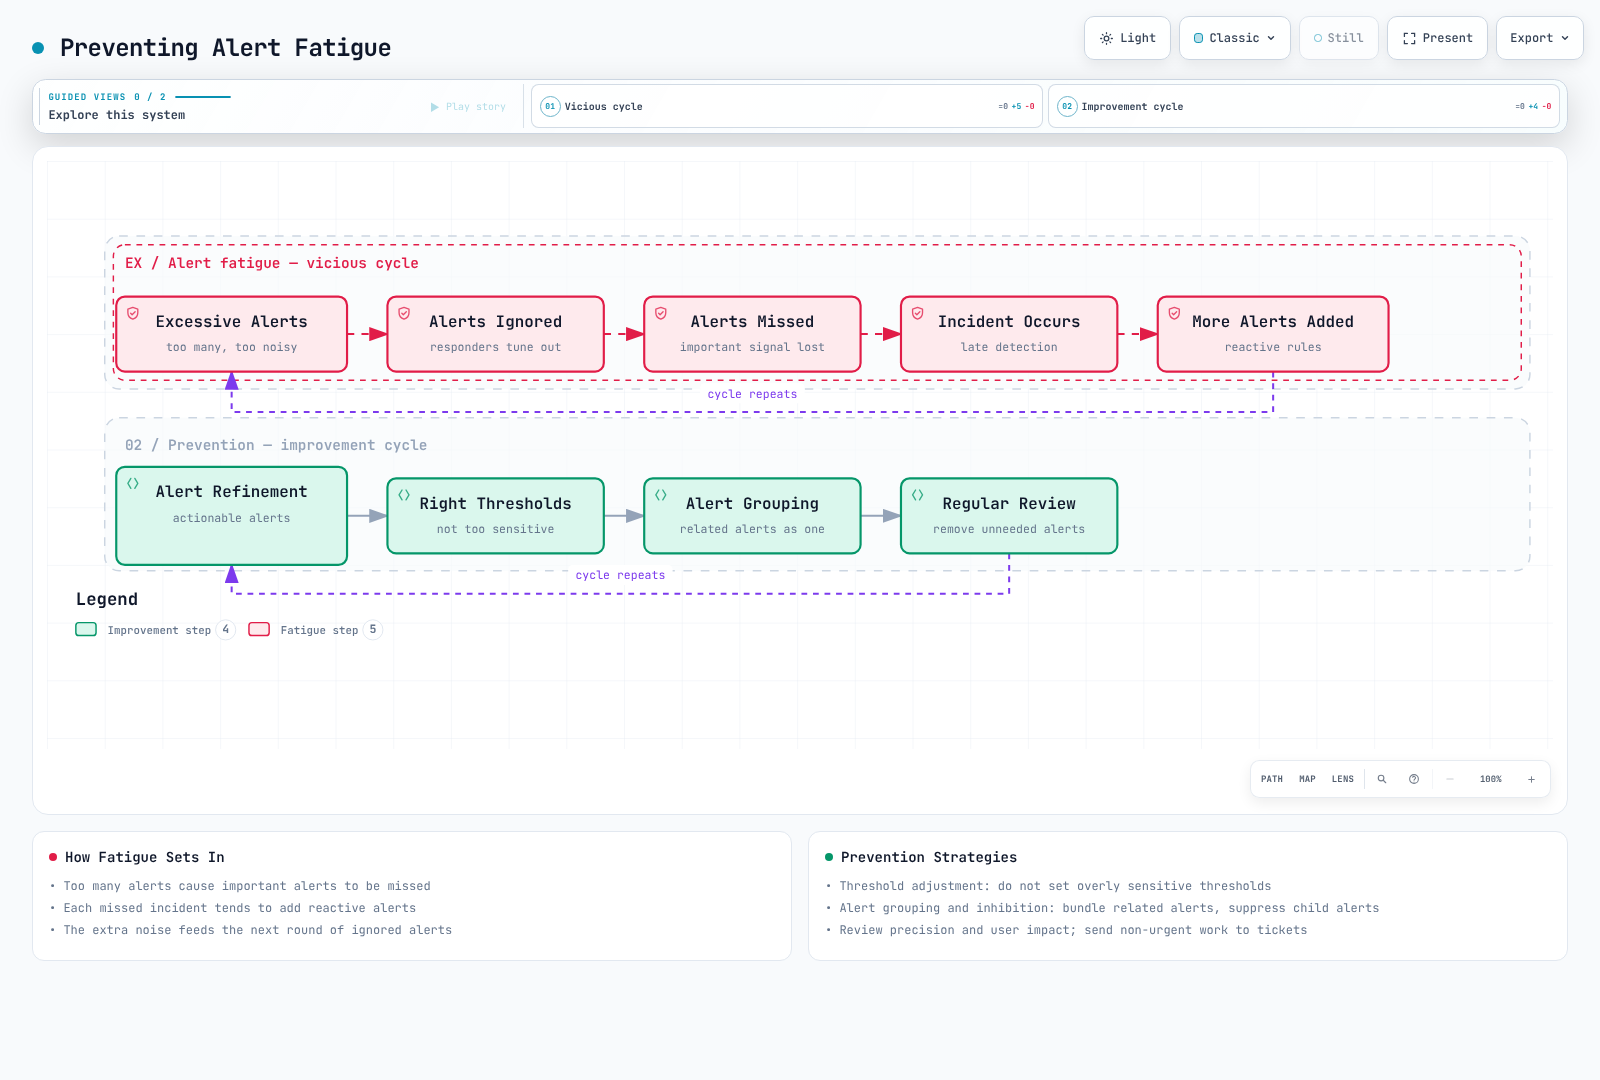
Estrategias para prevenir la fatiga por alertas:
- Ajuste de umbrales: No establezcas umbrales demasiado sensibles
- Agrupación de alertas: Reúne las alertas relacionadas en una sola
- Inhibición: Suprime las alertas secundarias cuando se activa la alerta principal
- Revisión periódica: Elimina las alertas innecesarias
- Introducción gradual: Inicia las alertas nuevas primero con gravedad baja
3. Niveles de gravedad
Estos tiempos de respuesta son una política organizativa ilustrativa, no un SLA de producto ni una recomendación universal:
| Gravedad | Descripción | Tiempo de respuesta | Ejemplos |
|---|---|---|---|
| Crítica | Interrupción total del servicio | Inmediata (en 5 min) | Servicio totalmente caído, riesgo de pérdida de datos |
| Alta | Fallo de una función principal | En 15 min | Error del sistema de pagos, fallo de inicio de sesión |
| Advertencia | Problema potencial | En 1 hora | 80 % de uso de disco, mayor latencia de respuesta |
| Info | Alerta informativa | En horario laboral | Deployment completado, copia de seguridad correcta |
groups:
  - name: disk-alerts
    rules:
      - alert: DiskSpaceCritical
        expr: |
          (100 * node_filesystem_avail_bytes{fstype!~"tmpfs|overlay|squashfs"}
            / node_filesystem_size_bytes{fstype!~"tmpfs|overlay|squashfs"} < 5)
          and node_filesystem_readonly == 0
          and node_filesystem_size_bytes > 0
        for: 5m
        labels:
          severity: critical
          team: sre
        annotations:
          summary: "Disk space critical"
      - alert: DiskSpaceWarning
        expr: |
          (100 * node_filesystem_avail_bytes{fstype!~"tmpfs|overlay|squashfs"}
            / node_filesystem_size_bytes{fstype!~"tmpfs|overlay|squashfs"} < 20)
          and node_filesystem_readonly == 0
          and node_filesystem_size_bytes > 0
        for: 10m
        labels:
          severity: warning
          team: sre
        annotations:
          summary: "Disk space low"
4. Documentación de alertas
Todas las alertas deben incluir la siguiente información:
- Descripción: Qué significa la alerta
- Impacto: Cómo afecta este problema al servicio
- Pasos de acción: Guía paso a paso para resolver el problema
- Enlace al runbook: Documento detallado del procedimiento de respuesta
annotations:
  summary: "Investigate the affected operation"
  description: "Check the rule expression, its units, labels, and collection health."
  impact: "Document the affected user operation before paging."
  action: "Use the owning team's reviewed runbook; do not scale resources blindly."
  runbook_url: "https://example.com/runbooks/replace-with-reviewed-runbook"
Enrutamiento y escalamiento de alertas
Estrategia de enrutamiento
Las alertas deben entregarse a receptores adecuados según diversos criterios:
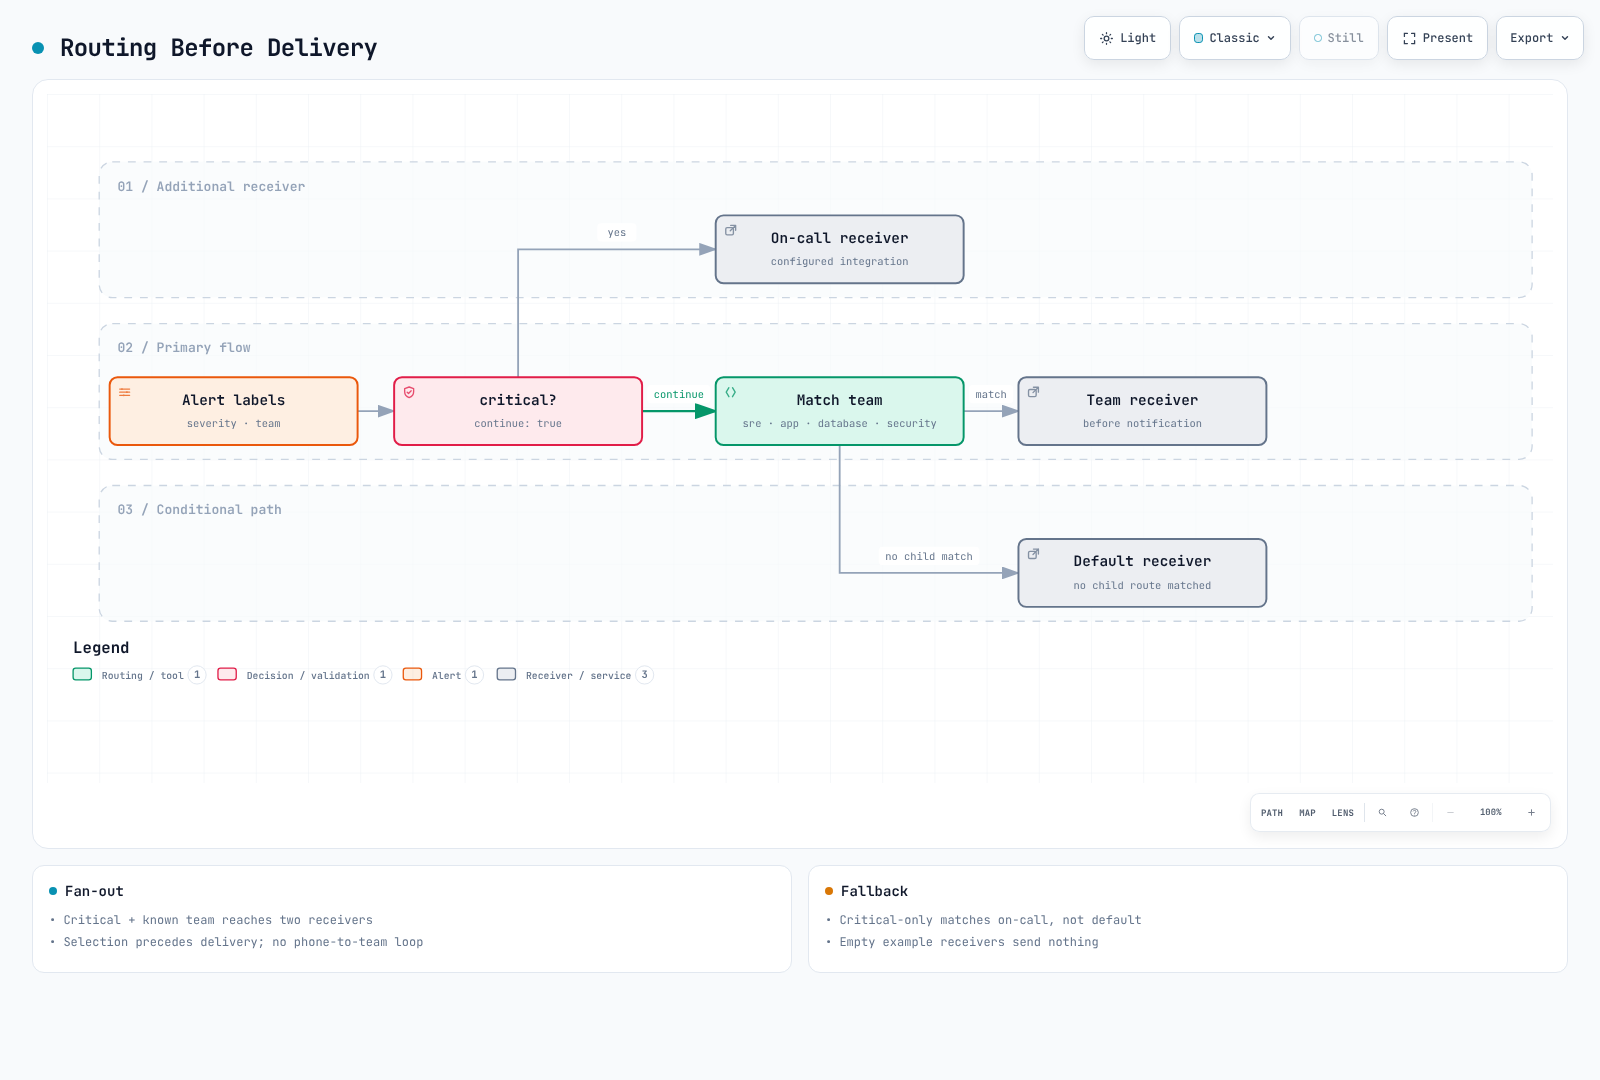
Diseño del árbol de enrutamiento
Esta es una configuración completa de validación de enrutamiento sin notificaciones. Los receptores vacíos son intencionales; configura integraciones revisadas y archivos Secret antes de usarla en producción. Las alertas críticas se distribuyen al receptor de guardia y al equipo coincidente. Las labels de equipo ausentes vuelven al predeterminado, salvo que una coincidencia exclusiva de alertas críticas no llama también al predeterminado. Los retrasos de agrupación implican que no hay garantía de llamada telefónica inmediata. El estado crítico del disco inhibe la advertencia solo para la misma instance/device/mountpoint.
route:
  receiver: default-receiver
  group_by: [alertname, cluster, namespace, service]
  group_wait: 30s
  group_interval: 5m
  repeat_interval: 4h
  routes:
    - matchers: ['severity="critical"']
      receiver: critical-oncall
      continue: true
    - matchers: ['team="sre"']
      receiver: sre-team
    - matchers: ['team="app"']
      receiver: dev-team
    - matchers: ['team="database"']
      receiver: dba-team
    - matchers: ['team="security"']
      receiver: security-team
receivers:
  - name: default-receiver
  - name: critical-oncall
  - name: sre-team
  - name: dev-team
  - name: dba-team
  - name: security-team
inhibit_rules:
  - source_matchers: ['alertname="DiskSpaceCritical"', 'instance!=""', 'device!=""', 'mountpoint!=""']
    target_matchers: ['alertname="DiskSpaceWarning"', 'instance!=""', 'device!=""', 'mountpoint!=""']
    equal: [cluster, instance, device, mountpoint]
Política de escalamiento
Lo siguiente es ilustrativo. Configura las zonas horarias, las ventanas de reconocimiento, los respaldos y el comportamiento de repetición de los avisos urgentes en el servicio de guardia, y pruébalos en un simulacro:
| Paso | Tiempo | Destino | Canal |
|---|---|---|---|
| 1 | 0 min | Guardia principal | Slack, PagerDuty |
| 2 | 15 min | Guardia secundaria | Slack, PagerDuty, SMS |
| 3 | 30 min | Responsable del equipo | Slack, PagerDuty, Teléfono |
| 4 | 45 min | Gerente de ingeniería | Teléfono |
| 5 | 60 min | CTO/VP de ingeniería | Teléfono |
Rotación de guardias
Concepto de guardia
La guardia se refiere a un respondedor designado responsable de los problemas del sistema durante un período especificado.
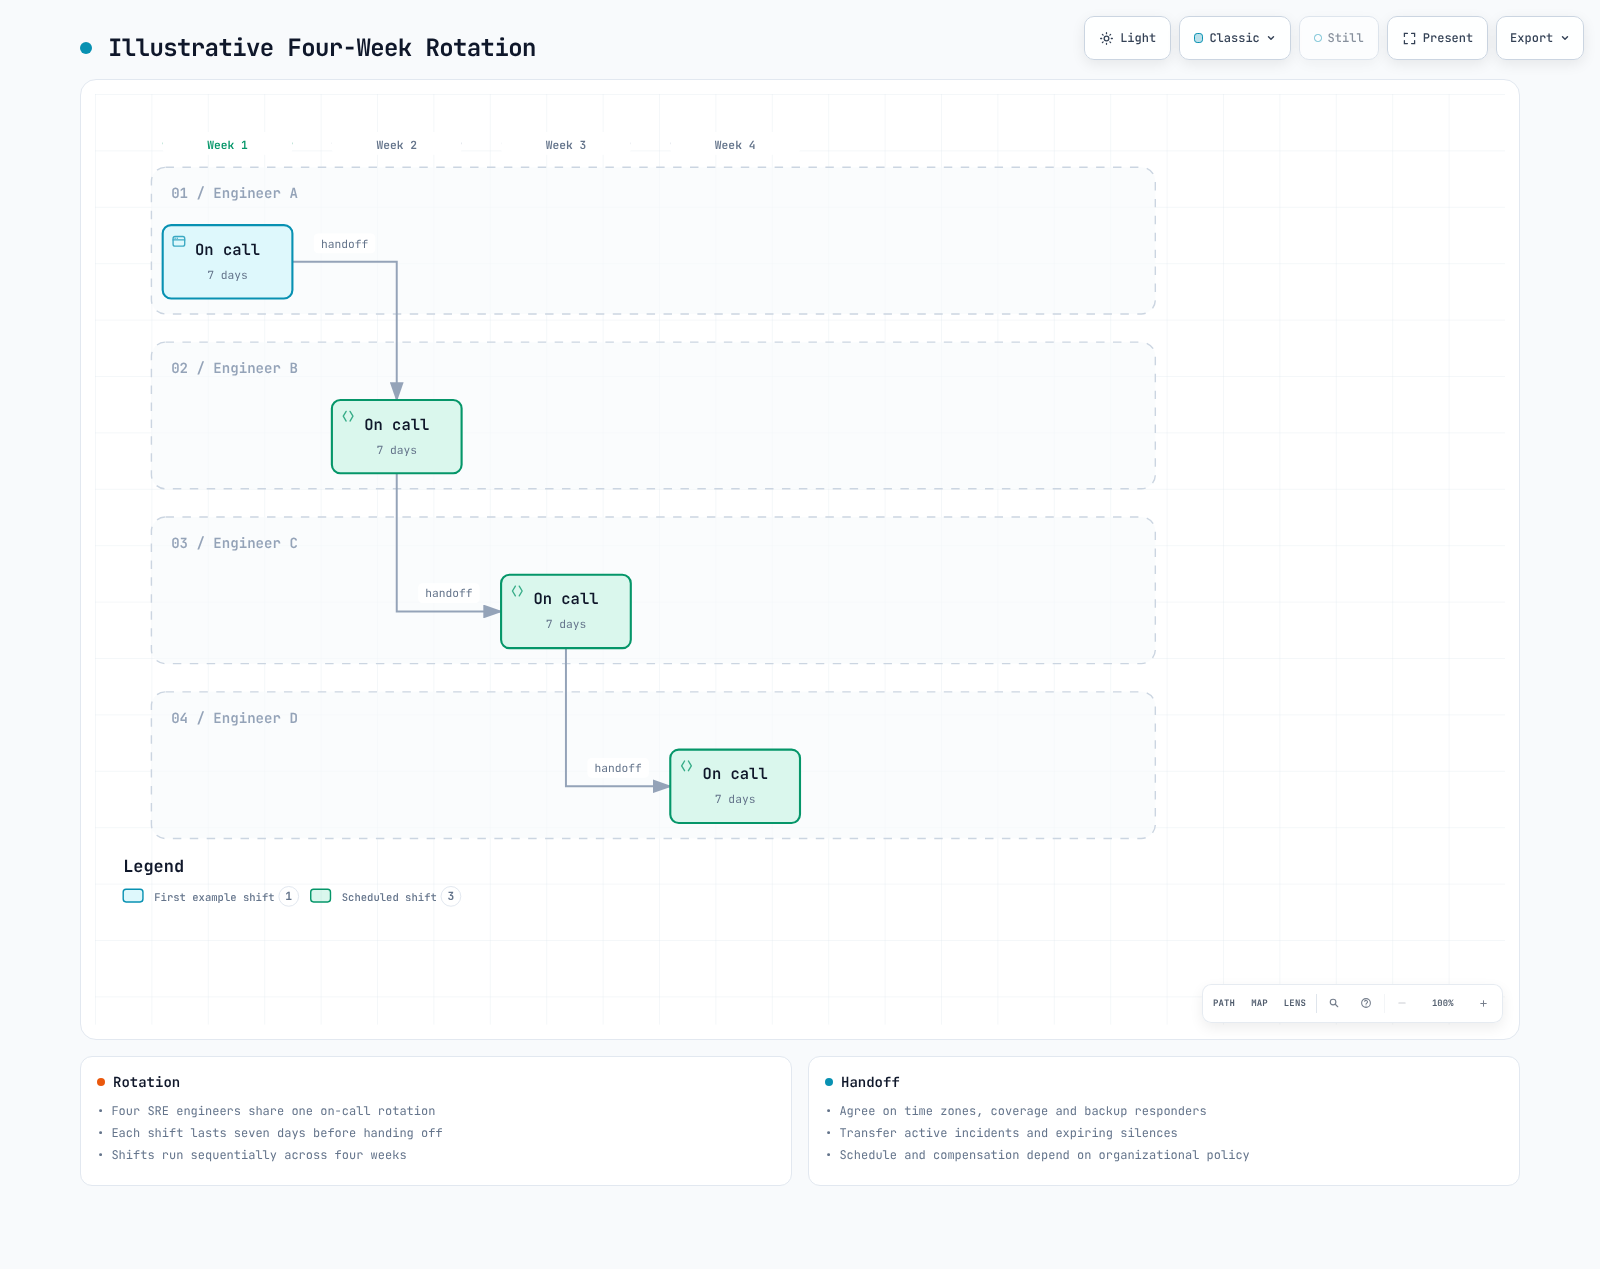
Prácticas recomendadas de guardia
- Calendario de traspasos claro: Rotación semanal o quincenal
- Proceso de traspaso: Transferir los problemas en curso durante el cambio de turno
- Respondedor de respaldo: Respaldo cuando el principal no está disponible
- Compensación adecuada: Complemento de guardia o tiempo libre compensatorio
- Prevención del agotamiento: Ciclo de rotación adecuado
Requisitos de la herramienta de guardia
- Gestión de horarios: Integración con calendario, gestión de turnos
- Sustitución: Cambios temporales de respondedores
- Escalamiento: Escalamiento automático
- Soporte móvil: Recibir alertas en cualquier momento y lugar
- Informes: Análisis de actividad de guardia
Estrategia de alertas para entornos EKS
Áreas de alertas específicas de EKS
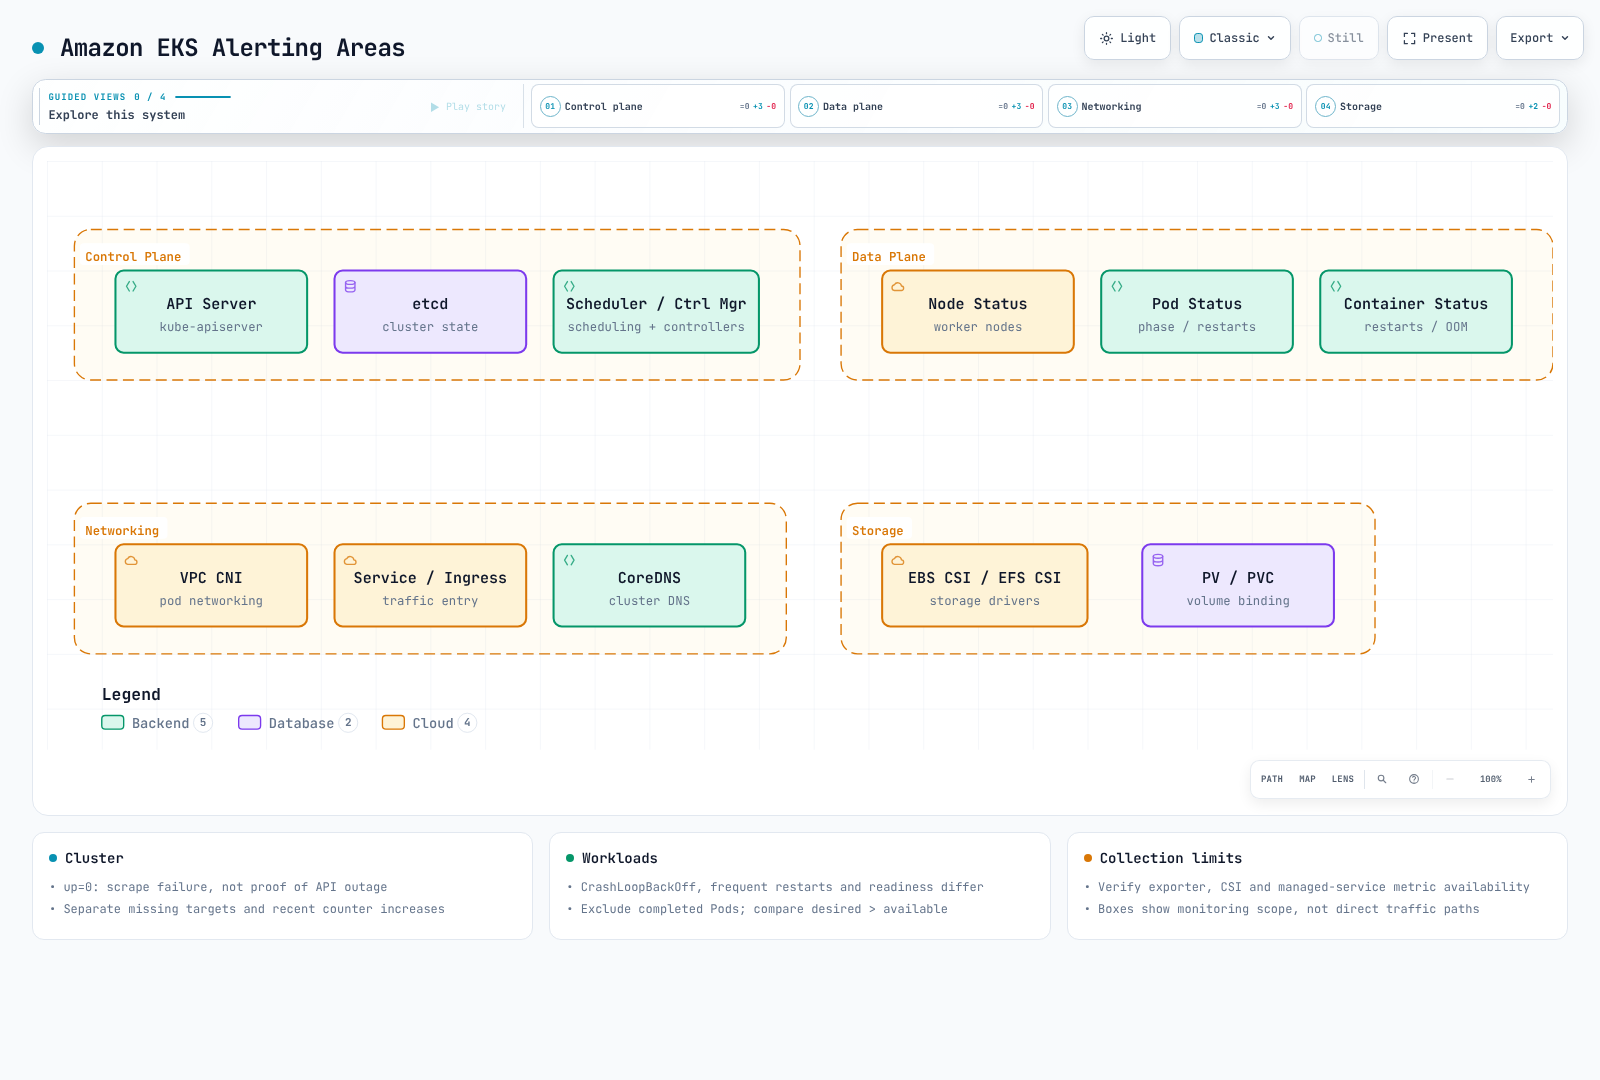
Estrategia de alertas por capa
1. Alertas de nivel de clúster
Sustituye el nombre del job por el objetivo desplegado. up=0 demuestra un fallo de scrape, no una interrupción completa de la API. La regla absent cubre un ámbito de recopilación; las configuraciones de varios clústeres necesitan un inventario de objetivos esperados y labels de clúster. Usa increase para el contador acumulativo de errores de Cluster Autoscaler. Un incremento reciente presente durante cinco minutos no significa que los errores se produjeran continuamente durante cinco minutos. Esta regla no se aplica sin cambios a Karpenter ni a EKS Auto Mode.
groups:
  - name: eks-cluster
    rules:
      - alert: EKSAPIServerScrapeFailed
        expr: up{job="kubernetes-apiservers"} == 0
        for: 1m
        labels:
          severity: critical
          team: sre
        annotations:
          summary: "Prometheus cannot scrape the configured API server target"
      - alert: EKSAPIServerTargetMissing
        expr: absent(up{job="kubernetes-apiservers"})
        for: 5m
        labels:
          severity: warning
          team: sre
        annotations:
          summary: "No API server target series in this Prometheus"
      - alert: EKSNodeNotReady
        expr: kube_node_status_condition{condition="Ready",status="true"} == 0
        for: 5m
        labels:
          severity: critical
          team: sre
        annotations:
          summary: "Node {{ $labels.node }} is not ready"
      - alert: EKSClusterAutoscalerRecentErrors
        expr: increase(cluster_autoscaler_errors_total[10m]) > 0
        for: 5m
        labels:
          severity: warning
          team: sre
        annotations:
          summary: "Cluster Autoscaler recorded failed loops in the last 10 minutes"
2. Alertas de nivel de carga de trabajo
La serie CrashLoopBackOff puede desaparecer brevemente entre reintentos. Esta regla se activa después de que una ventana reciente de observación de cinco minutos permanezca poblada durante diez minutos. Detecta observaciones recurrentes, no Waiting actual continuo, y puede permanecer activa hasta cinco minutos después de la última observación. Las pruebas de reglas nativas distinguen un transitorio corto, reintentos recurrentes y recuperación.
groups:
  - name: eks-workloads
    rules:
      - alert: PodCrashLooping
        expr: max_over_time(kube_pod_container_status_waiting_reason{reason="CrashLoopBackOff"}[5m]) >= 1
        for: 10m
        labels:
          severity: warning
          team: app
        annotations:
          summary: "Pod {{ $labels.namespace }}/{{ $labels.pod }} repeatedly observed in CrashLoopBackOff"
      - alert: PodFrequentRestarts
        expr: increase(kube_pod_container_status_restarts_total[15m]) > 3
        for: 5m
        labels:
          severity: warning
          team: app
        annotations:
          summary: "Pod {{ $labels.namespace }}/{{ $labels.pod }} has frequent restarts"
      - alert: PodNotReady
        expr: |
          (kube_pod_status_ready{condition="true"} == 0)
          and on (namespace, pod, uid)
          (kube_pod_status_phase{phase=~"Pending|Running|Unknown"} == 1)
        for: 15m
        labels:
          severity: warning
          team: app
        annotations:
          summary: "Active pod {{ $labels.namespace }}/{{ $labels.pod }} is not ready"
      - alert: DeploymentReplicasMismatch
        expr: |
          kube_deployment_spec_replicas
            > on (namespace, deployment) kube_deployment_status_replicas_available
        for: 10m
        labels:
          severity: warning
          team: app
        annotations:
          summary: "Deployment {{ $labels.namespace }}/{{ $labels.deployment }} has fewer available replicas than desired"
3. Alertas de nivel de recursos
El ejemplo de CFS mide períodos limitados / períodos totales, no una fracción del tiempo transcurrido. Verifica que cAdvisor exporte estas métricas. La memoria sin límite puede aparecer como cero o como un valor muy grande; restringe la regla de memoria a los contenedores con límites explícitos. Las estadísticas de PVC dependen del controlador CSI y del tipo de volumen. Se excluyen los denominadores cero, pero las métricas ausentes no demuestran que el estado sea saludable.
groups:
  - name: eks-resources
    rules:
      - alert: ContainerCPUThrottling
        expr: |
          (
            sum by (namespace, pod, container) (
              rate(container_cpu_cfs_throttled_periods_total{container!="",container!="POD"}[5m]))
            / sum by (namespace, pod, container) (
              rate(container_cpu_cfs_periods_total{container!="",container!="POD"}[5m]))
          ) > 0.25
          and sum by (namespace, pod, container) (
            rate(container_cpu_cfs_periods_total{container!="",container!="POD"}[5m])) > 0
        for: 5m
        labels:
          severity: warning
          team: app
        annotations:
          summary: "More than 25% of CFS periods throttled for {{ $labels.pod }}/{{ $labels.container }}"
      - alert: ContainerMemoryNearLimit
        expr: |
          (
            container_memory_working_set_bytes{container!="",container!="POD"}
            / container_spec_memory_limit_bytes{container!="",container!="POD"}
          ) > 0.9
          and container_spec_memory_limit_bytes{container!="",container!="POD"} > 0
        for: 5m
        labels:
          severity: warning
          team: app
        annotations:
          summary: "Container {{ $labels.pod }}/{{ $labels.container }} memory is near its reported limit"
      - alert: PVCAlmostFull
        expr: |
          (kubelet_volume_stats_used_bytes / kubelet_volume_stats_capacity_bytes > 0.85)
          and kubelet_volume_stats_capacity_bytes > 0
        for: 5m
        labels:
          severity: warning
          team: sre
        annotations:
          summary: "PVC {{ $labels.namespace }}/{{ $labels.persistentvolumeclaim }} is almost full"
Alertas de integración de servicios AWS
EKS 1.28+ proporciona métricas seleccionadas del plano de control en AWS/EKS; esto no expone todos los componentes internos para scrape. Habilita los logs del plano de control por separado para investigar errores de autenticación. Evalúa la disponibilidad mediante el estado de recopilación, los fallos de solicitudes a la API y sondas externas:
| Servicio AWS | Elementos de monitorización | Herramienta de alertas |
|---|---|---|
| Plano de control EKS | Disponibilidad de API Server, errores de autenticación | CloudWatch |
| EC2 (Nodes) | Estado de instancias, comprobaciones del sistema | CloudWatch |
| EBS | Estado del volumen, uso de IOPS | CloudWatch |
| EFS | Rendimiento, recuento de conexiones | CloudWatch |
| ALB / NLB | Solicitudes/errores/tiempo de respuesta HTTP de ALB; flujos/reinicios TCP/estado de objetivos de NLB | CloudWatch: usa métricas específicas del producto |
| VPC / NAT Gateway | Métricas de NAT; registros aceptados/rechazados en Flow Logs habilitados por separado | Métricas/logs de CloudWatch; Flow Logs no es un motor de alarmas |
Comparación de soluciones
Tabla comparativa de las principales soluciones de alertas
| Producto | Rol y restricciones operativas |
|---|---|
| Alertmanager | Agrupación, enrutamiento, inhibición y recordatorios de código abierto; se requiere alojamiento y operación. No incluye horarios de guardia ni escalamiento basado en reconocimiento |
| CloudWatch Alarms | Evalúa métricas de AWS/consultas compatibles, cambia de estado e invoca acciones configuradas; los horarios son independientes |
| Grafana OnCall OSS | Archivado el 2026-03-24; no es una opción predeterminada para nuevos despliegues de producción |
| Grafana Cloud IRM / PagerDuty | Candidatos para guardias/escalamiento; verifica los planes, canales, regiones y contratos actuales |
| Opsgenie | Fin de venta el 2025-06-04; fin de soporte y servicio programado para el 2027-04-05. Los usuarios existentes necesitan un plan de migración |
Guía de selección de soluciones
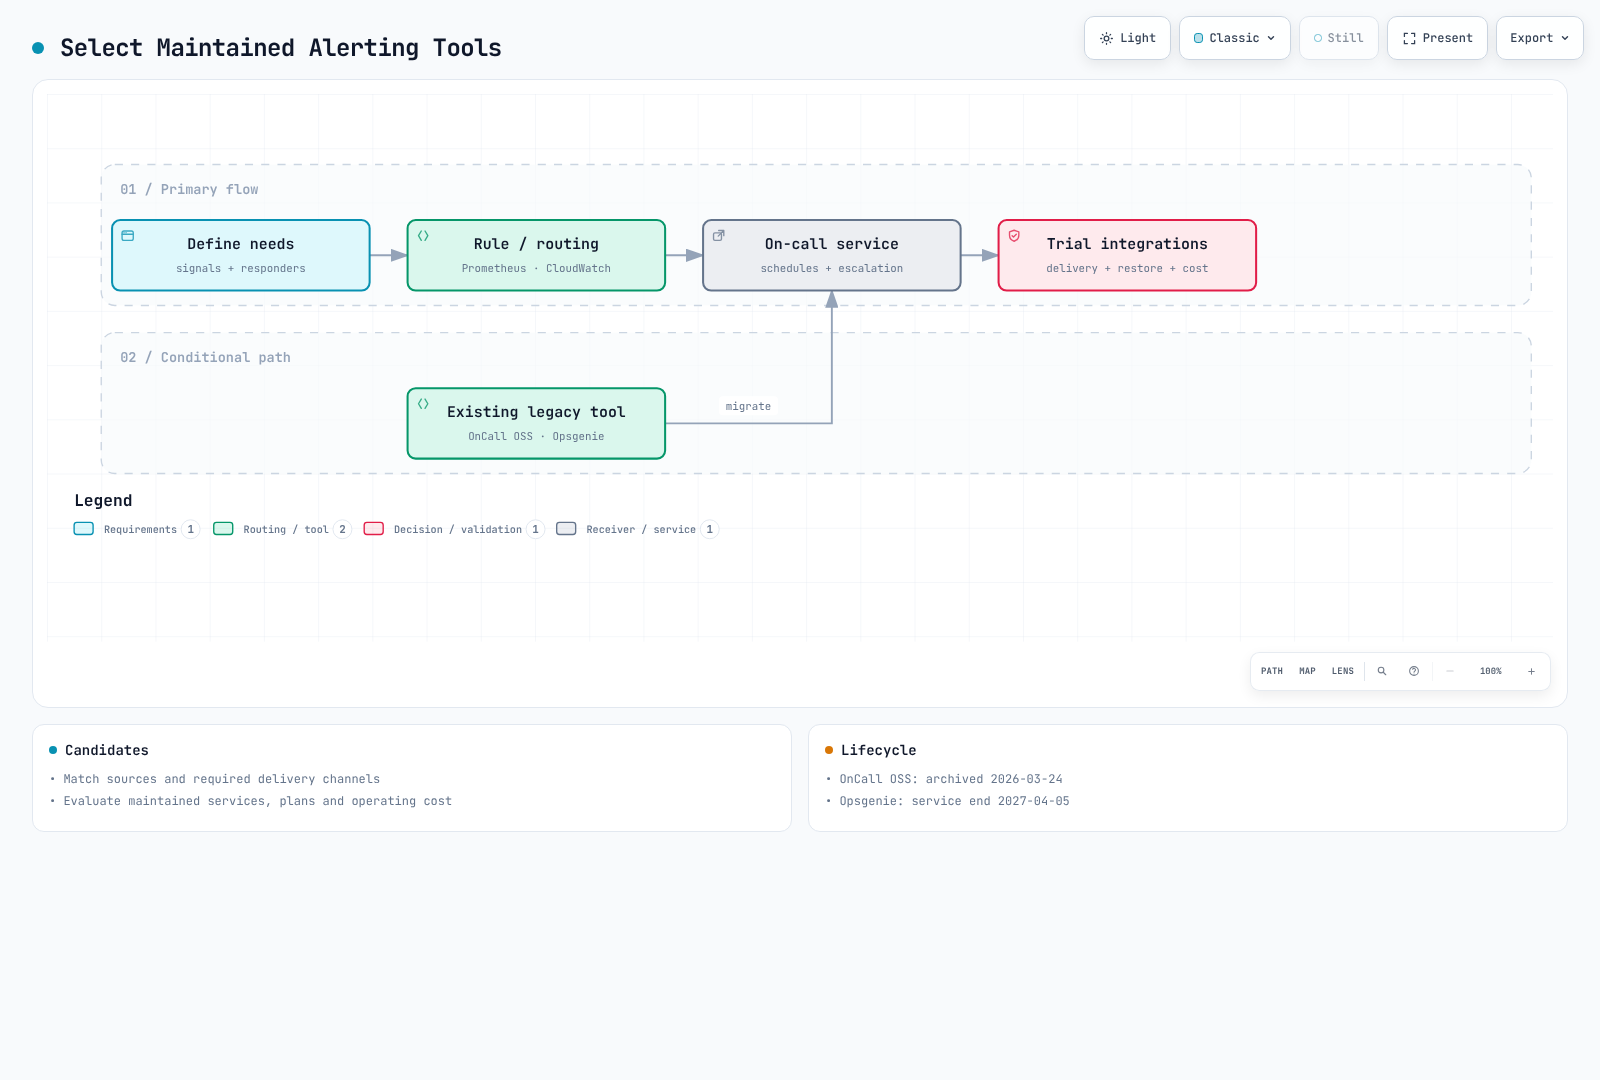
Soluciones recomendadas según la situación
- Enfocado en Prometheus: usa Alertmanager para agrupación/enrutamiento y conecta los canales necesarios.
- Enfocado en métricas de AWS: evalúa CloudWatch Alarms con SNS o integraciones de incidentes compatibles.
- Respuesta ininterrumpida: elige un servicio de guardia mantenido según la dotación de personal, los respaldos, las zonas horarias, el reconocimiento, el escalamiento y el coste.
- Grafana OnCall OSS/Opsgenie existentes: verifica la migración de funciones, historial, horarios e integraciones.
Enfoque híbrido
Las soluciones pueden combinarse. CloudWatch no envía automáticamente de forma directa a Alertmanager. Este ejemplo usa SNS/una integración compatible con el servicio de guardia; el enrutamiento a través de Alertmanager requiere un adaptador diseñado por separado, autenticación y gestión de duplicados/resoluciones:
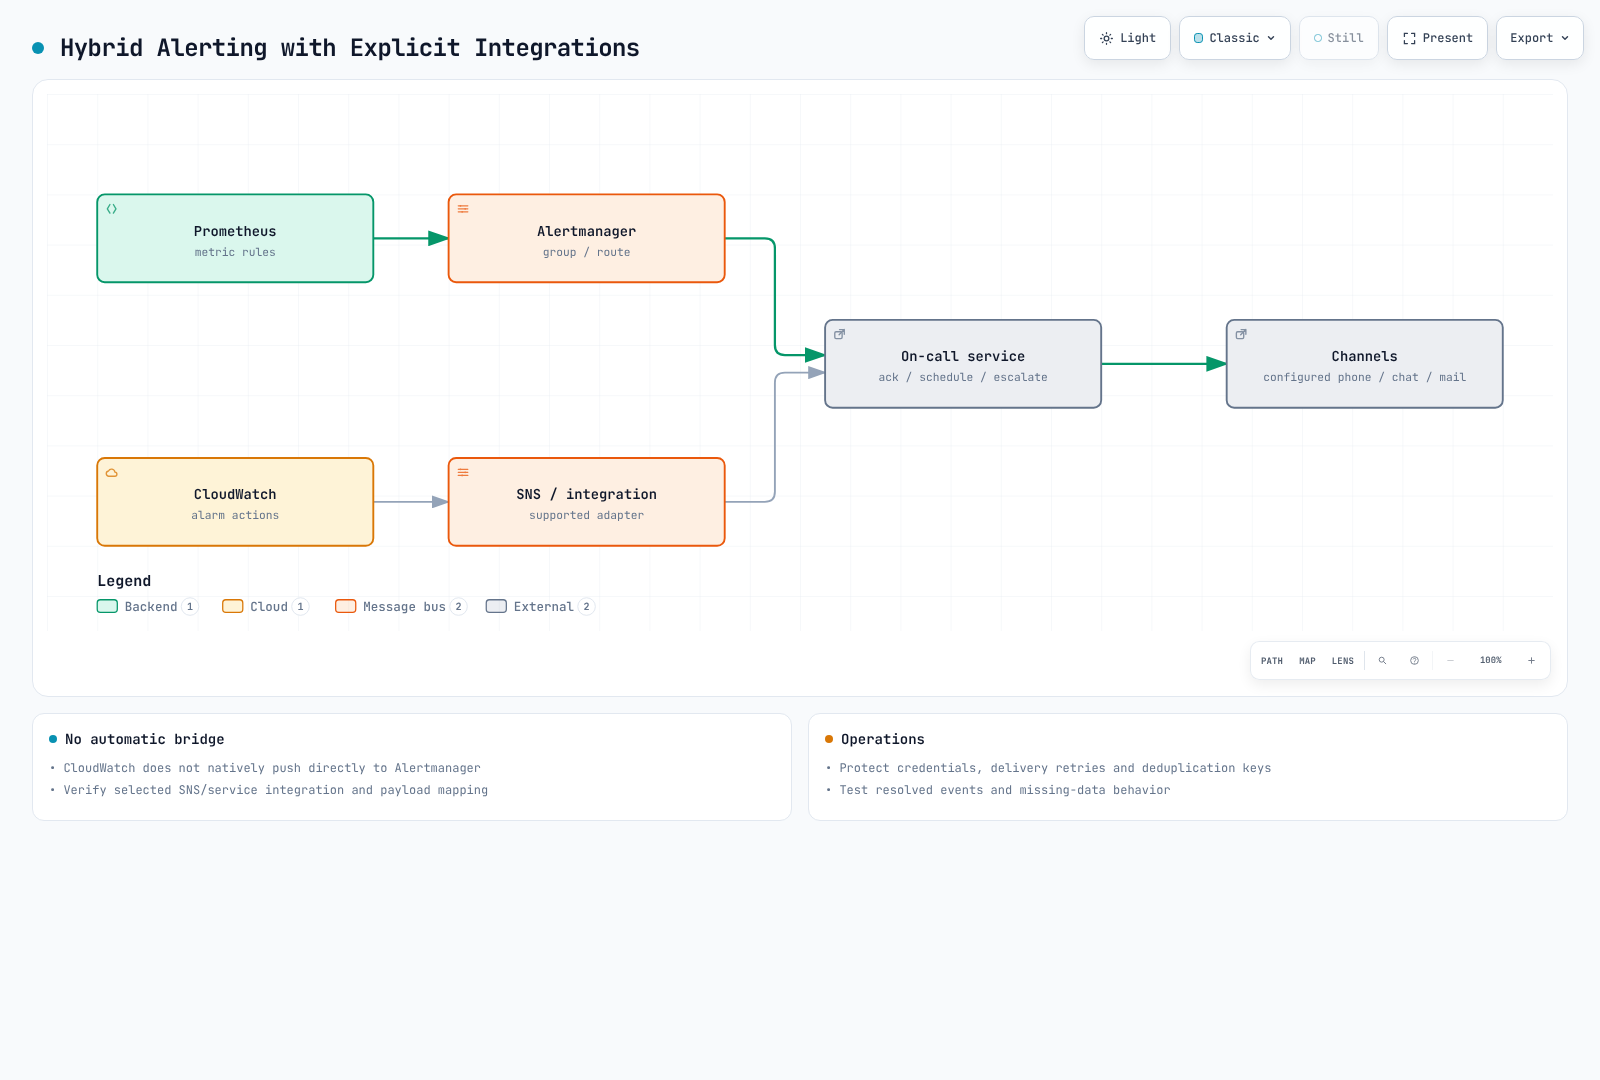
Arquitectura de ejemplo:
- Prometheus + Alertmanager: Recopilación de métricas y procesamiento principal de alertas
- CloudWatch: Recopilación de métricas de servicios AWS
- Servicio de guardia mantenido: Gestión de guardias y escalamiento
- Slack: Alertas y colaboración en tiempo real
Próximos pasos
Esta sección cubrió los conceptos básicos y las estrategias de alertas. Para conocer métodos de configuración detallados de cada solución, consulta los documentos siguientes:
- Prometheus Alertmanager: Gestión de alertas de código abierto
- CloudWatch Alarms: Alertas nativas de AWS
- Grafana OnCall: Revisión de instalaciones existentes y consideraciones de migración