Parte 5: Alerting y AIOps
Dificultad: Avanzado · Tiempo estimado: 60 minutos Última actualización: September 13, 2026
Reciba una alerta, inspeccione métricas reales y logs agregados, y luego produzca una hipótesis de diagnóstico para revisión humana. El ejemplo ejecutable es un reportero Lambda con temas SNS de entrada/salida separados. No incluye remediación automática ni webhook HTTP anónimo.
Los prerrequisitos son la ingesta de la Parte 2, los servicios de la Parte 3 y una prueba de humo exitosa de la Parte 4. El código y las plantillas se comprobaron localmente; no se ejecutó ningún despliegue de AWS, invocación de modelo ni notificación durante esta auditoría.
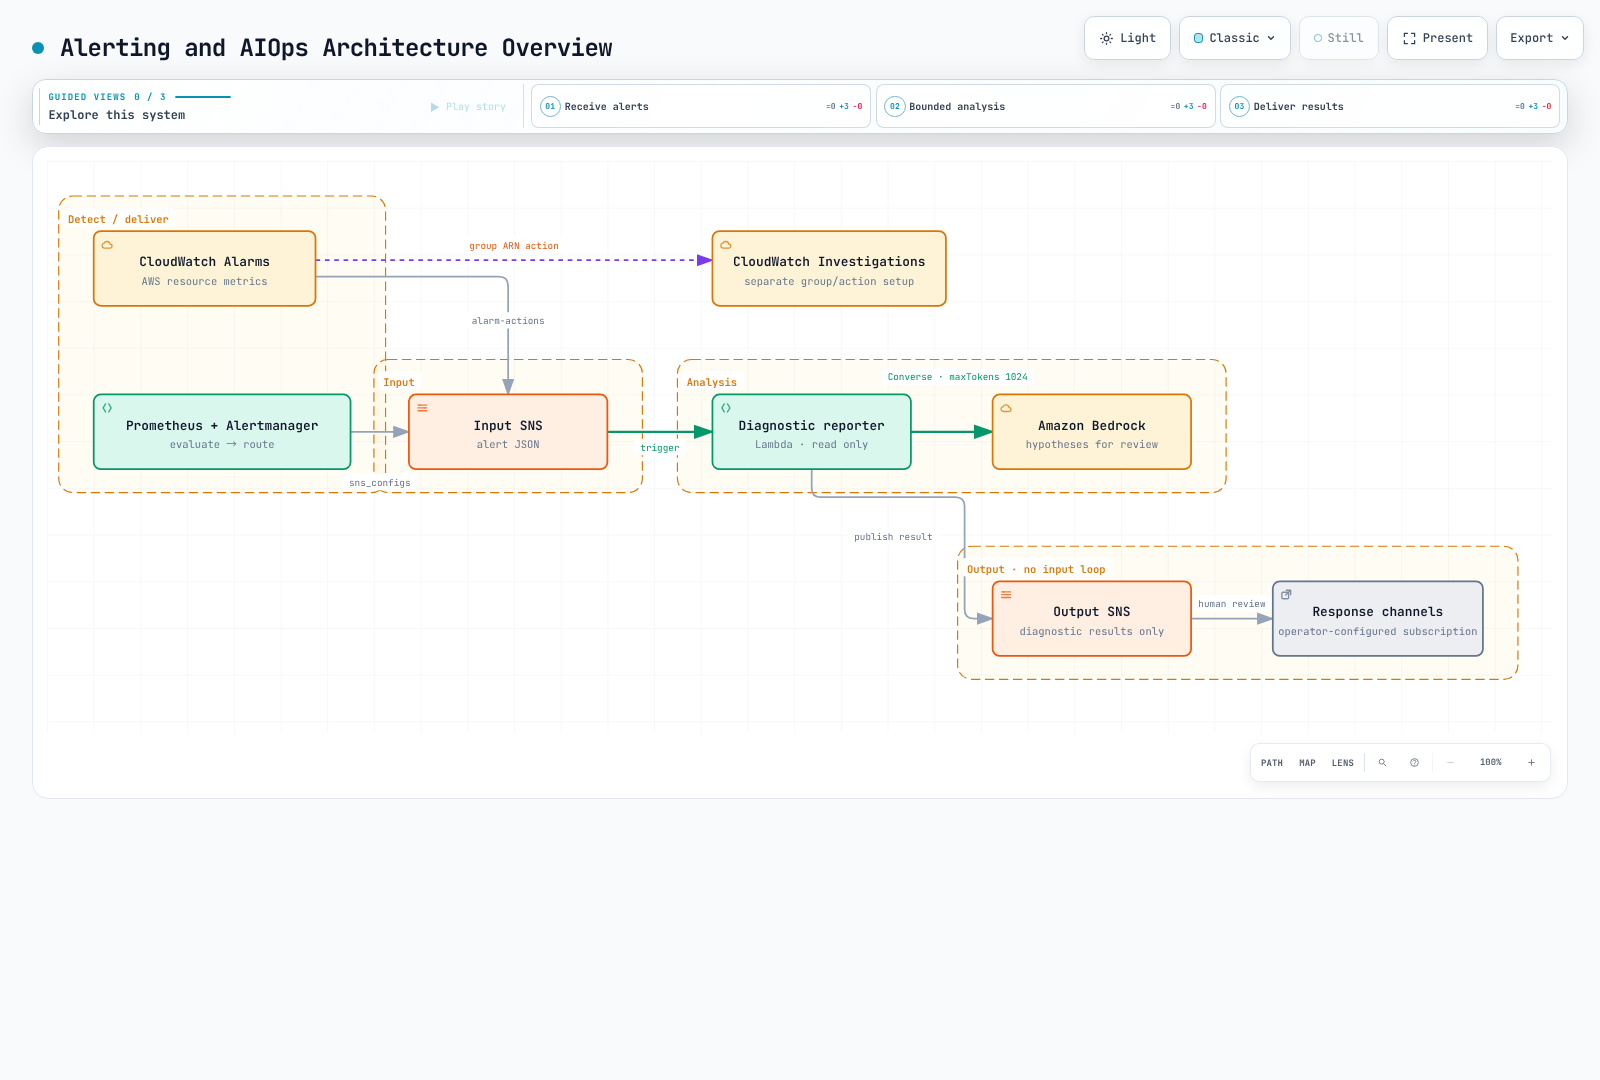
1. Separe la evaluación del enrutamiento
Prometheus evalúa las reglas de alerta; Alertmanager gestiona la agrupación, deduplicación, enrutamiento, inhibición y notificación. PrometheusRule es un CRD de Prometheus Operator, no un recurso evaluado por Alertmanager.
| Configuración | Verifique |
|---|---|
for de Prometheus | Permanece pendiente mientras la condición persiste entre evaluaciones y luego se activa |
| Selectores de reglas | Los selectores reales de namespace/label en el CR de Prometheus seleccionan la regla |
| Ruta de Alertmanager | Coinciden matchers, el orden de las rutas, las rutas hijas, continue y el receptor |
| Métricas | Nombres, unidades y labels reales del SDK; series ausentes, ausencia de tráfico y reinicios de contadores |
| Label de Service | Solo se permiten los servicios del catálogo del reportero |
up == 0 detecta el fallo de un objetivo de scraping ya conocido, no todos los objetivos no detectados. El crecimiento de reinicios difiere de CrashLoopBackOff; un estado OOMKilled antiguo difiere de un evento OOM nuevo. Un nombre de métrica SQS de PromQL no puede crear datos sin su exporter.
kubectl --context managed -n monitoring get prometheus,alertmanager,prometheusrule
kubectl --context managed -n monitoring get services
# Use the actual Prometheus Service name in the next command.
kubectl --context managed -n monitoring port-forward svc/REPLACE_WITH_PROMETHEUS_SERVICE 9090:9090curl --fail --silent http://127.0.0.1:9090/api/v1/rules
curl --fail --silent http://127.0.0.1:9090/api/v1/alertsSustituya los nombres de la versión del chart instalada. No suponga otro nombre de versión ni busque un ConfigMap inexistente. La existencia del recurso y la carga/evaluación real de Prometheus son comprobaciones separadas.
2. Semántica de las alarmas de CloudWatch
La alarma de backlog de la plantilla utiliza AWS/SQS, ApproximateNumberOfMessagesVisible, el QueueName exacto, Maximum, Period=60, EvaluationPeriods=3 y DatapointsToAlarm=2. Esto es dos de tres puntos de datos evaluados; las infracciones no tienen que ser consecutivas. Period es granularidad de agregación, no un sinónimo de frecuencia de evaluación.
Este laboratorio deja los datos ausentes como missing. No infiera un cero saludable a partir de una cola inactiva o una ingesta interrumpida. Al añadir CPU de RDS, utilice la dimensión de métrica de instancia real DBInstanceIdentifier; verifique las dimensiones admitidas antes de usar agregados de clúster u otra estadística.
Los reenvíos de Alertmanager, las transiciones de estado de CloudWatch, la entrega de SNS y los reintentos asíncronos de Lambda son capas separadas. La deduplicación en una capa no puede garantizar una entrega exactamente una vez de extremo a extremo.
3. Elija una ruta de guardia admitida
Grafana OnCall OSS fue archivado el 24 de marzo de 2026; también finalizó el soporte de SMS, teléfono y push basado en Cloud Connection. No reutilice la antigua ruta para nuevas instalaciones ni YAML de escalamiento ficticio. Seleccione una ruta actualmente admitida, como su sistema existente de incidentes/notificaciones o Grafana Cloud IRM, siguiendo el aviso oficial de mantenimiento.
Este ejemplo proporciona un tema SNS de salida. Configure respondedores, escalamiento, confirmación y resolución en el sistema elegido y verifique la entrega real. La plantilla no crea automáticamente suscripciones de email, Slack o PagerDuty.
4. Prepare el reportero de diagnóstico
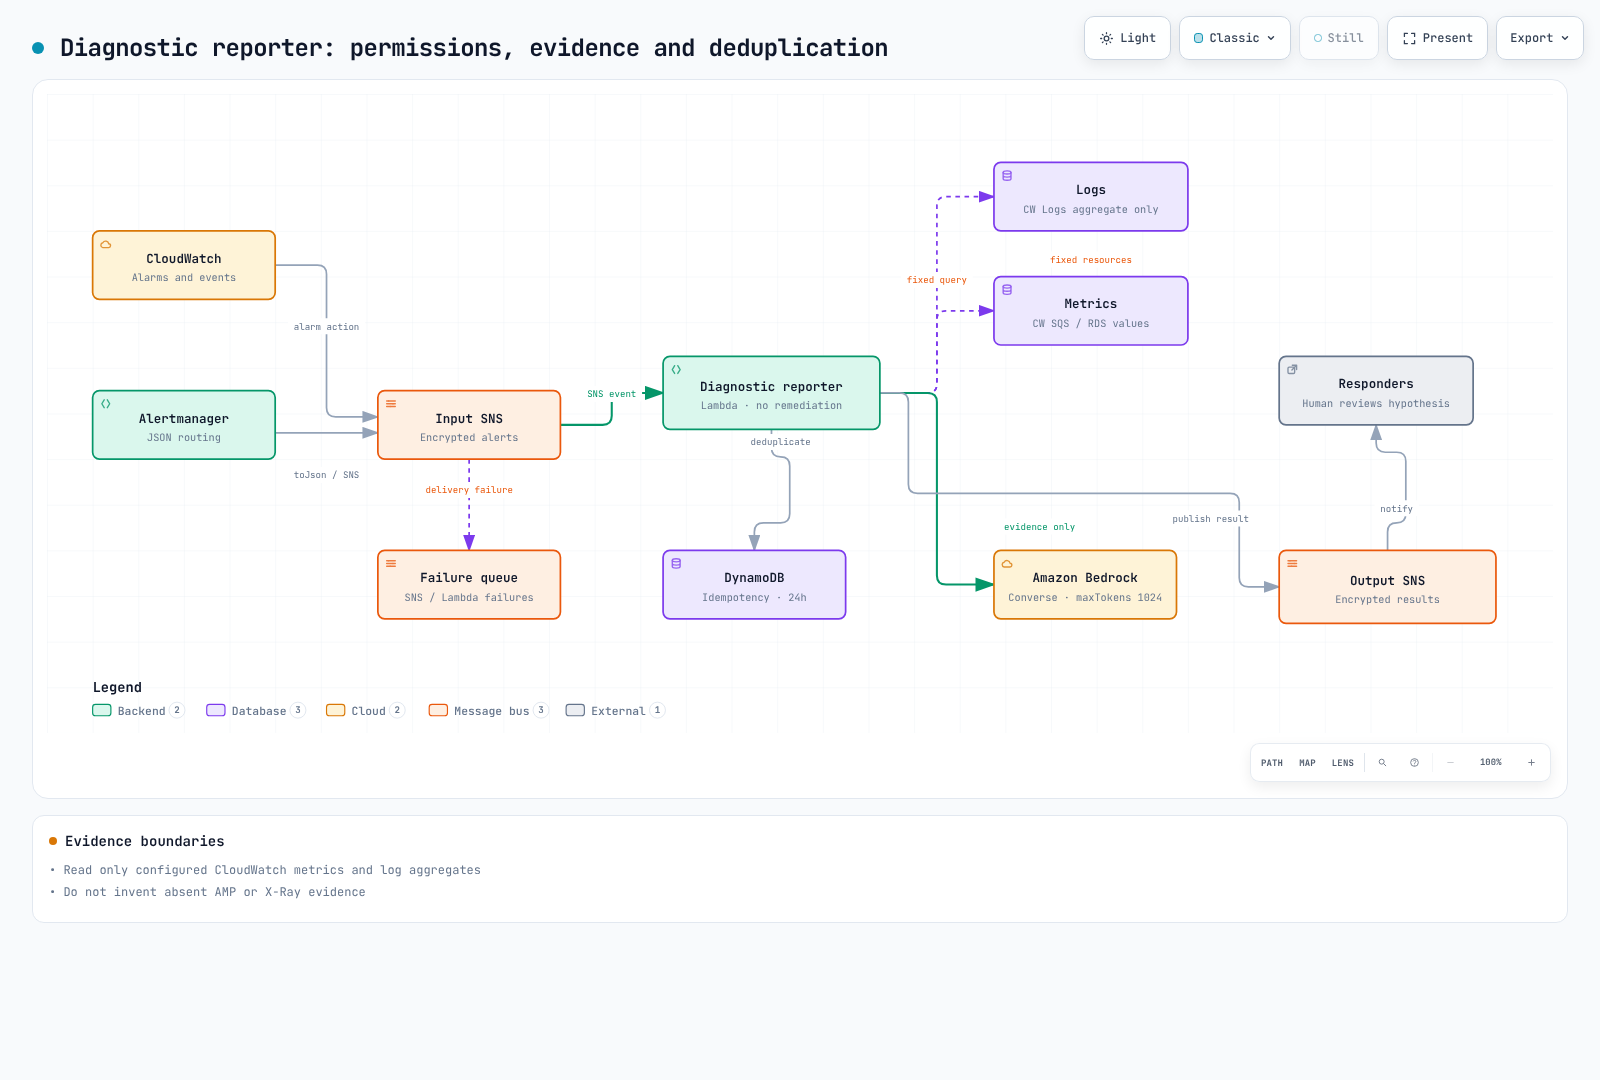
| Archivo | Responsabilidad |
|---|---|
alerts.py | Tema/formato/listas de permitidos de SNS y normalización de CloudWatch/Alertmanager |
evidence.py | Métricas configuradas de CloudWatch y lecturas de logs agregados |
analysis.py | Converse solo con evidencia utilizable, 1024 tokens de salida, comprobaciones de finalización |
handler.py | Recopilación con dos workers, idempotencia de Powertools, publicación en el tema de salida |
template.yaml | Quince recursos SAM/CloudFormation e IAM con alcance limitado |
tests/ | Éxito, fallo, duplicados, tiempo de espera y datos ausentes |
cd examples/labs/observability/aiops
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python -m unittest discover -s tests -v
El código se comprobó con boto3 1.43.93, Powertools 3.34.0 y Python 3.12. Para un despliegue real, proporcione una cola SQS/grupo de logs existentes, un nombre de Service aprobado, un ID de modelo/perfil de inferencia Converse actualmente disponible y sus ARN de modelo/perfil exactos. No codifique de forma fija un modelo Claude retirado. Los perfiles entre regiones también pueden requerir permisos para el ARN del modelo de destino.
Los logs deben contener campos estructurados service y level. El reportero consulta recuentos agregados de errores, no mensajes sin procesar, y nunca ejecuta IDs de recursos o consultas generados por el modelo. Las fuentes ausentes/con errores permanecen como no_data/error y pueden provocar que se omita el análisis. No afirma recopilar valores de AMP ni trazas de X-Ray que nunca se configuraron.
5. Despliegue y conecte Alertmanager
sam build --template-file template.yaml
sam deploy --guided --capabilities CAPABILITY_IAM
Un operador ejecuta estas acciones en la cuenta de laboratorio aprobada después de revisar el conjunto de cambios. La plantilla crea temas SNS de entrada/salida cifrados, Lambda, una tabla de idempotencia, una cola de fallos y una alarma de cola. No sobrescribe variables de entorno reservadas de Lambda como AWS_REGION.
Sustituya a continuación el InputTopicArn desplegado y la Region real. La serialización toJson se verificó con las plantillas nativas de Alertmanager 0.34.0. Fusione el receptor/la ruta con la configuración que realmente carga su instalación en vez de sobrescribirla por completo.
receivers:
- name: lab-diagnostics
  sns_configs:
  - topic_arn: REPLACE_WITH_INPUT_TOPIC_ARN
    sigv4:
      region: REPLACE_WITH_REGION
    message: '{{ . | toJson }}'
    send_resolved: true
toJson respeta las etiquetas JSON, y produce alerts, labels, status y claves camelCase como startsAt. El acceso con plantillas Go en mayúscula (.Alerts) es diferente de las claves JSON serializadas. El parser conserva compatibilidad con mayúsculas solo por compatibilidad. El mensaje SNS legible de forma predeterminada no tiene este formato JSON.
Adjunte el AlertmanagerPublishPolicyArn de la plantilla únicamente al rol de workload de Alertmanager existente. Verifique la ruta de credenciales del Pod y los permisos de KMS/SNS; no amplíe el rol compartido del nodo. Haga coincidir los labels de service y los nombres de alerta permitidos con el catálogo/reglas. Nunca suscriba el reportero a OutputTopicArn.
6. Reintentos, evidencia y finalización
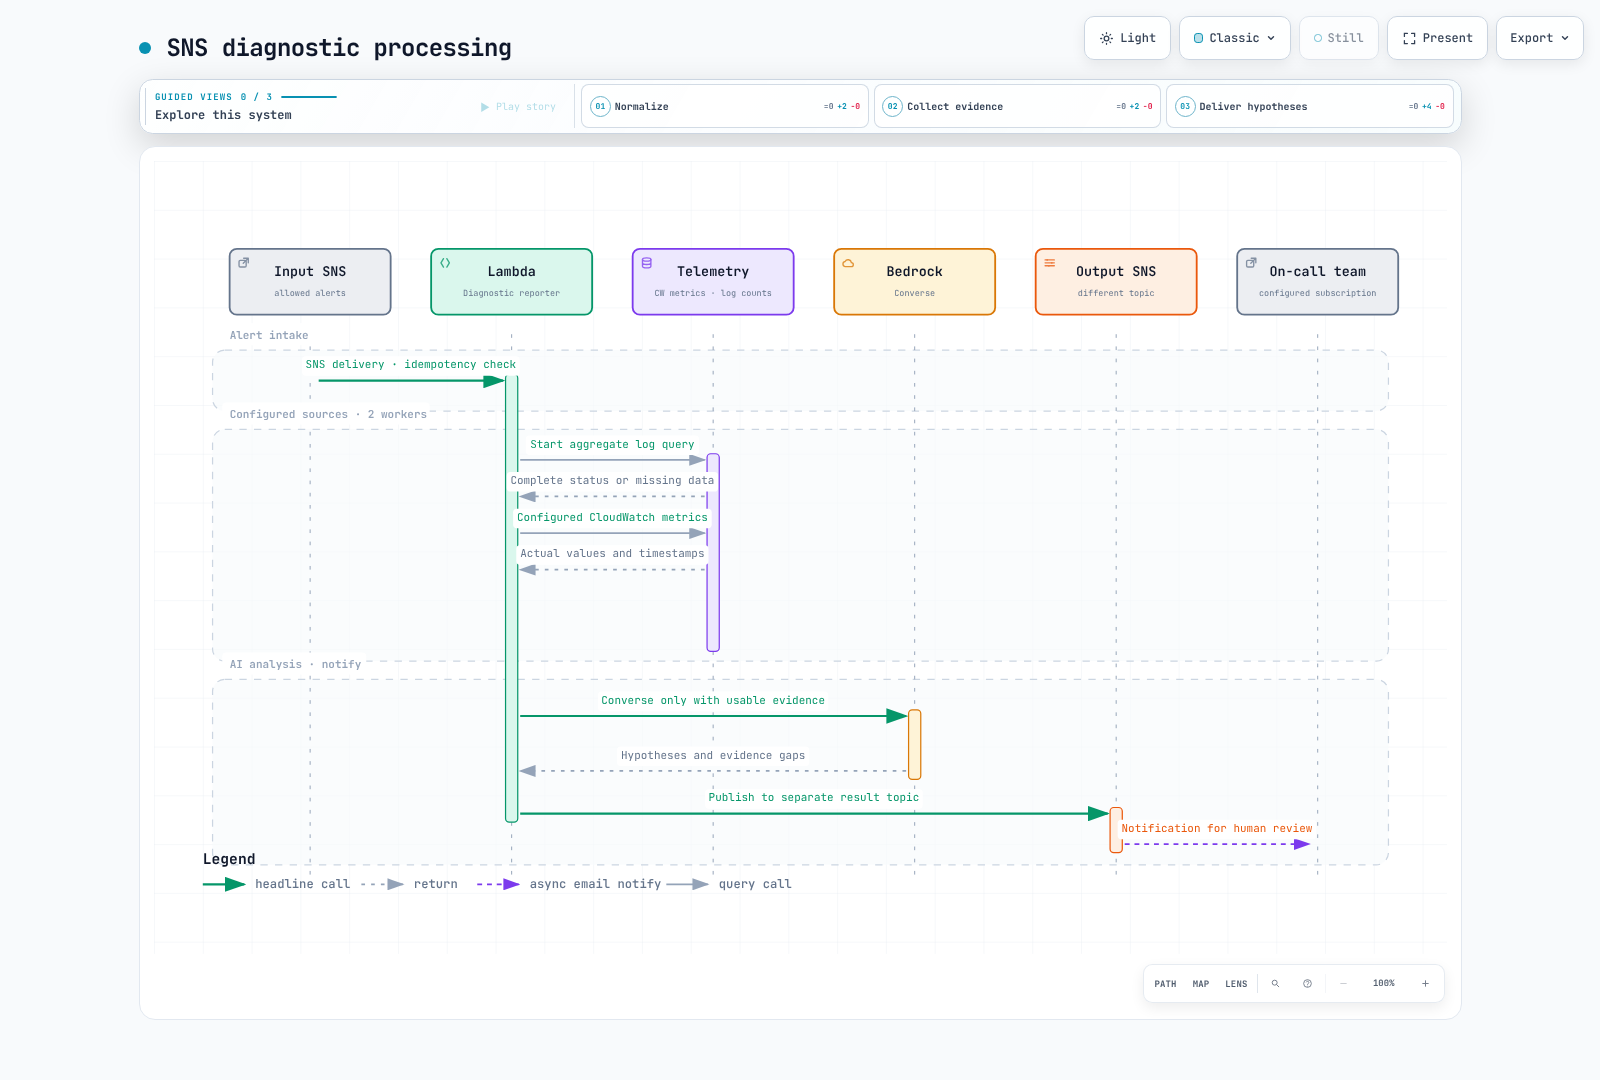
La concurrencia reservada de Lambda es dos, los reintentos asíncronos son dos y la edad máxima del evento es una hora después de que Lambda acepta el evento. Los reintentos de entrega SNS son independientes. Inspeccione los resultados, las colas de fallos y los procedimientos de repetición. No imprima eventos sin procesar ni credenciales.
Las lecturas usan como máximo 15 minutos respecto de la hora actual e informan su inicio/fin reales. No reconstruyen el período exacto de la alarma original. Logs Insights consulta con límites y cancela las consultas sin terminar. La salida del modelo truncada (max_tokens), bloqueada o vacía no se publica como diagnóstico completado.
7. Configure CloudWatch Investigations por separado
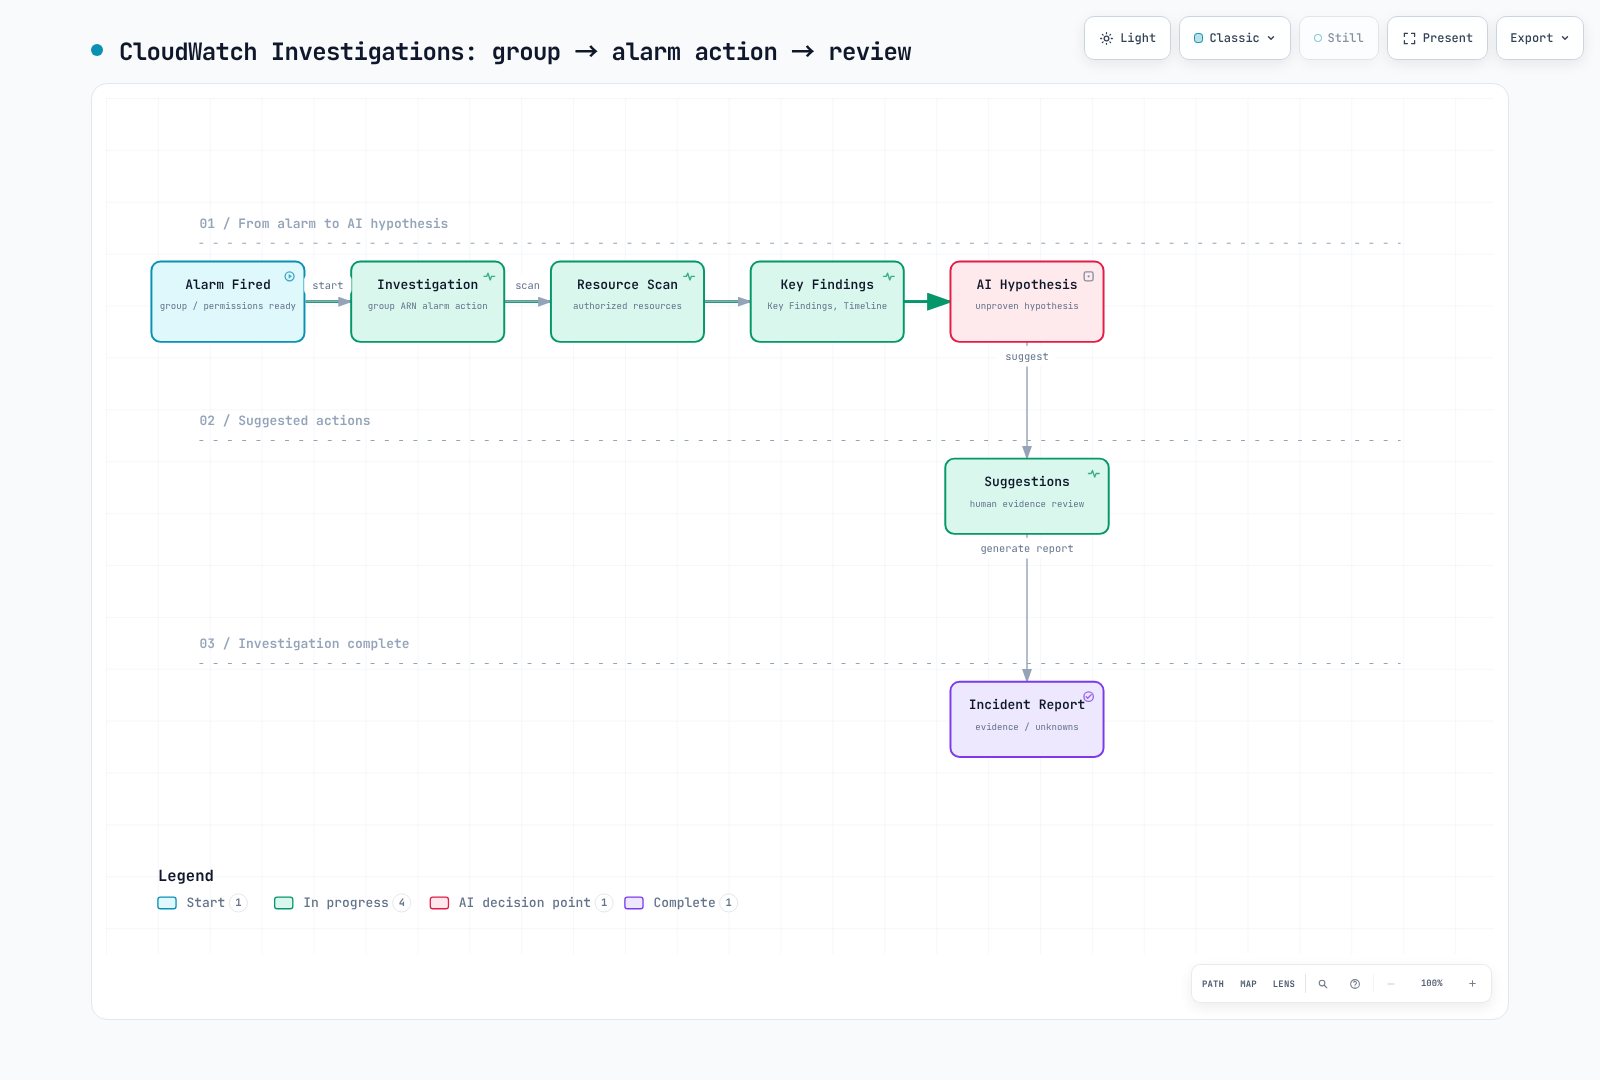
arn:aws:aiops:REGION:ACCOUNT_ID:investigation-group/GROUP_IDSiga el procedimiento oficial, preservando los ajustes de alarma existentes al agregar la acción. put-anomaly-detector, put-insight-rule y list-dashboards no son API para creación de grupos de investigación/listado de investigaciones. Habilitar únicamente el descubrimiento de Application Signals no completa esta configuración. La pila SAM de ejemplo no crea un grupo de investigación.
8. Inyección de fallos y verificación operativa
Registre primero una referencia de prueba de humo saludable y la ruta de notificación. Use solo controles de fallos que la aplicación realmente implemente, en un canary dedicado con límite de tiempo, objetivo y plan de recuperación. No llame endpoints /admin/chaos inexistentes ni flags de entorno no utilizados. Eliminar un Pod no garantiza CrashLoopBackOff.
Cambie y recupere workloads gestionados por GitOps mediante Git/el flujo de Rollouts admitido. No confunda Deployments con Rollouts ni elimine variables de entorno usando índices JSON Patch negativos.
- Confirme que Prometheus carga la regla y pasa por pendiente/activada.
- Inspeccione el receptor de Alertmanager seleccionado y el mensaje SNS de entrada.
- Compruebe la finalización/fallo de Lambda, la DLQ y los resultados de idempotencia.
- Verifique que el tema de salida es distinto y no puede volver a entrar en el reportero.
- Compare los límites de tiempo del informe, las observaciones y las incógnitas con la entrega real al respondedor.
- Restaure el cambio inyectado y confirme que las pruebas de reintentos/carga se han detenido.
9. Extensiones opcionales y limpieza
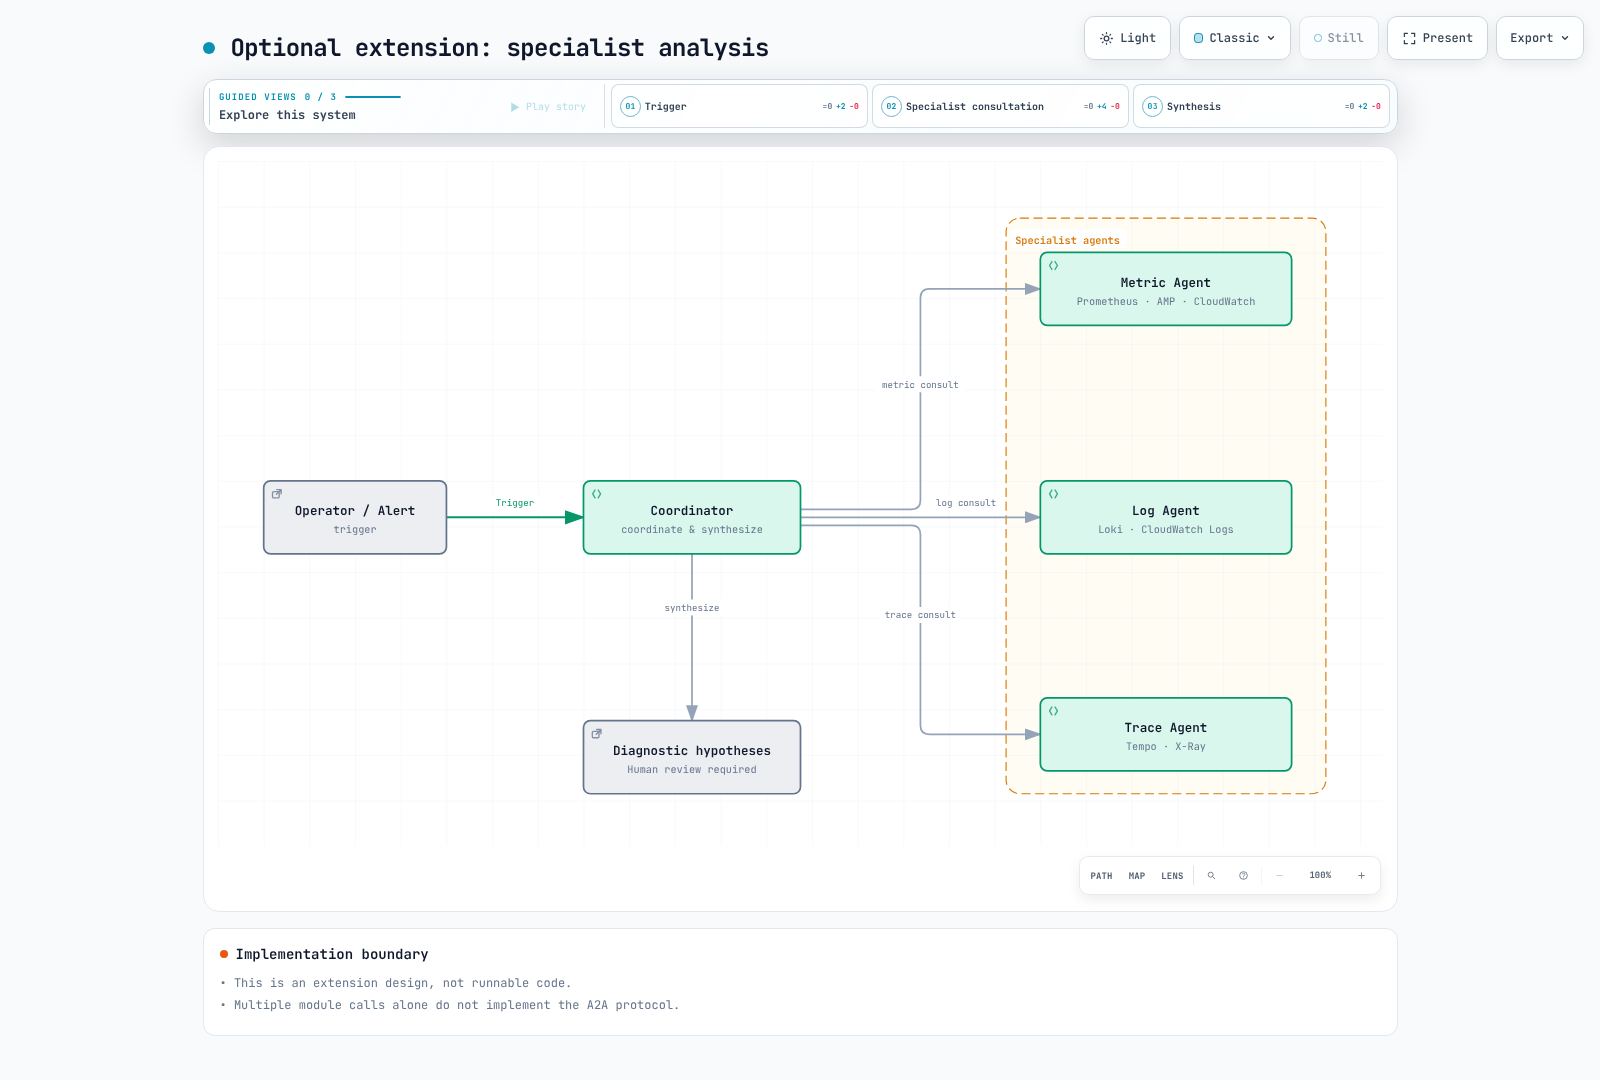
Conserve la evidencia y detenga las acciones/suscripciones de alarma de entrada antes de la limpieza. Reconcilie la pila SAM, los adjuntos externos de políticas de roles de workload y las suscripciones adicionales con los registros de propiedad. No elimine la cola/grupo de logs de aplicación existente. Siga el orden de dependencias y las comprobaciones de costos de la Parte 6.
Alcance de la validación
Las comprobaciones cubrieron 24 pruebas locales, Powertools real con un almacén en memoria, seis casos de botocore Stubber, plantillas JSON nativas de Alertmanager 0.34.0, lint de CloudFormation y quince declaraciones de política. No constituyen pruebas de autorización IAM/KMS de AWS en vivo, entrega SNS, persistencia de DynamoDB, ejecución de consultas CloudWatch, calidad de respuesta de Bedrock ni despliegue de clúster.