Anatomía de una canalización de datos moderna: cinco roles
Última actualización: 12 de septiembre de 2026
Dónde encaja este documento
Comprende los roles de Kafka, Spark, Airflow y Flink, así como los contratos entre los componentes de la canalización.
Las fuentes, la ingesta, el almacenamiento, el procesamiento y el consumo son roles conceptuales. Los productos no tienen por qué desempeñar exactamente un solo rol, y no todas las canalizaciones tienen que almacenar los datos antes de procesarlos. Los flujos pueden procesarse antes de almacenarse; las transformaciones pueden ejecutarse dentro de un almacén de datos. Define primero los contratos de esquema, frescura de los datos, retención, reproducción y duplicación de resultados.
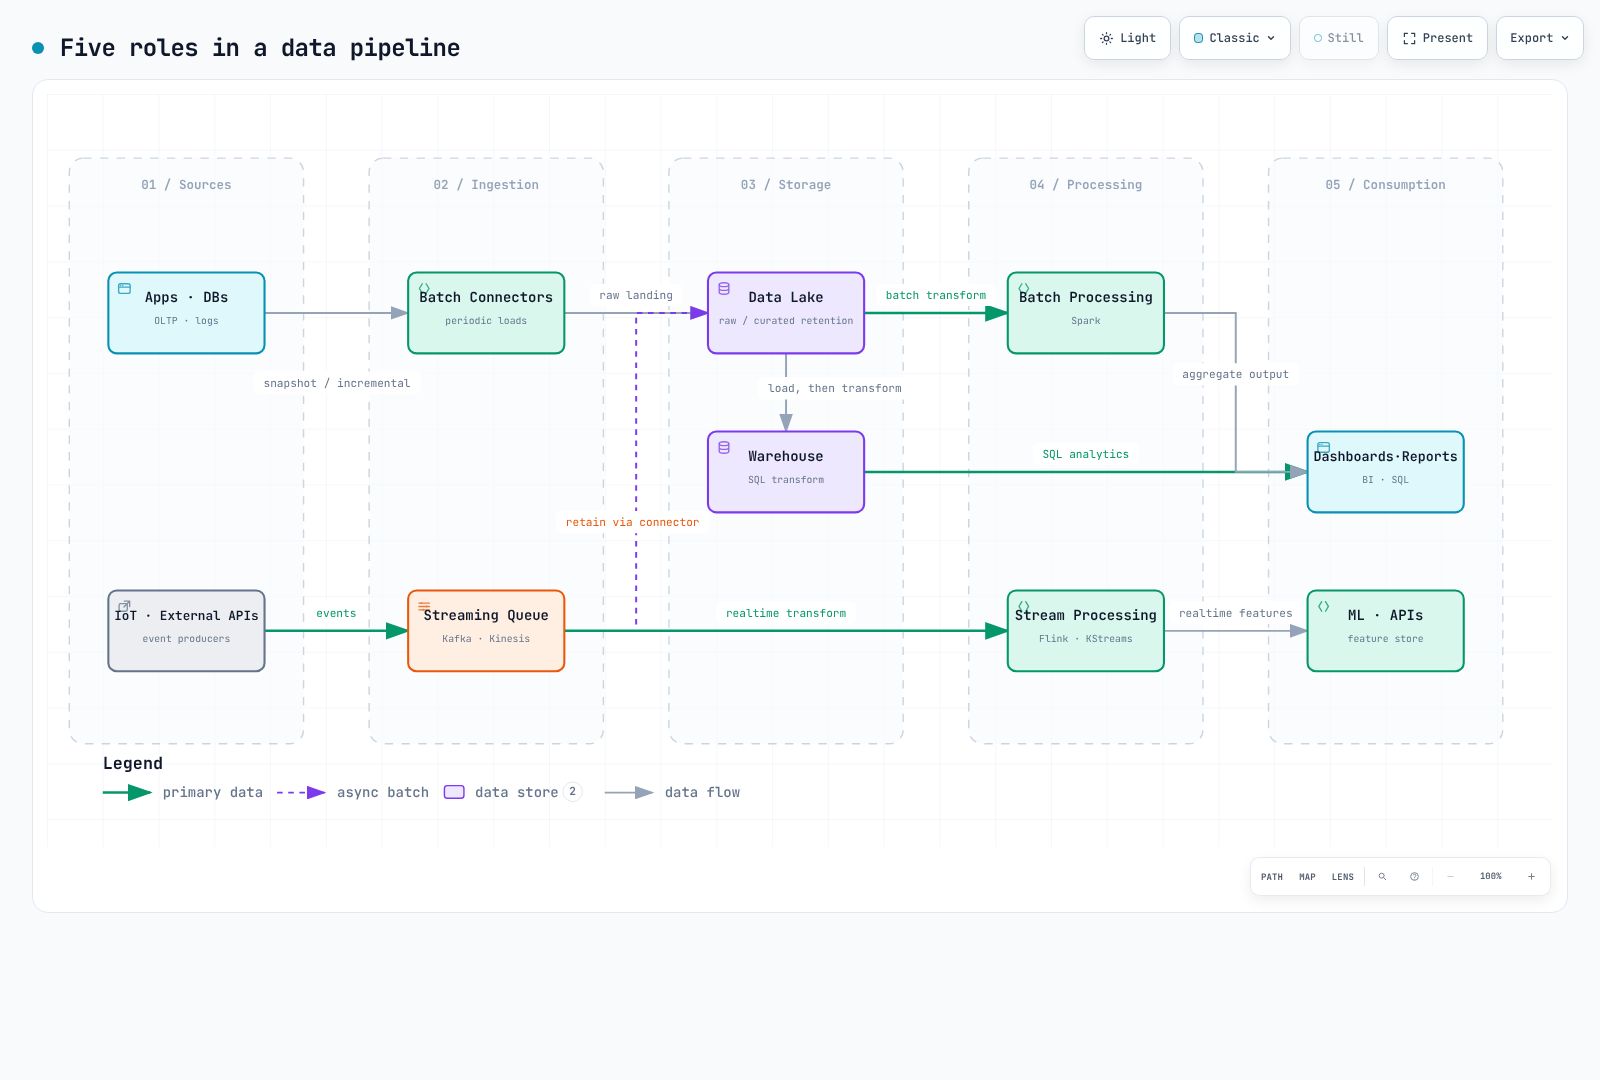
1. Fuentes: cambios y carga
Entre las fuentes se incluyen bases de datos de aplicaciones, registros, dispositivos IoT y API externas. Elige instantáneas completas, consultas incrementales o CDC basado en registros, según sea necesario. El CDC basado en registros depende de los registros de replicación de la base de datos, la retención y los permisos; la compatibilidad con los cambios de esquema varía según el conector y el formato.
Las réplicas de lectura y la extracción basada en registros pueden reducir la carga de las bases de datos de producción. No todas las combinaciones de bases de datos y conectores las admiten. Comprueba la carga inicial de la instantánea, el retraso de replicación y la recuperación después de la pérdida de registros.
2. Ingesta: lotes y eventos
| Modo | Comportamiento | Ejemplos | Factores que influyen en la latencia |
|---|---|---|---|
| Ingesta por lotes | Extrae/carga grupos según un cronograma o una condición | Airbyte, trabajos por lotes de JDBC | Cronograma, volumen de datos y destino |
| Ingesta de eventos | Publica y consume continuamente cambios/eventos | Kafka, Kinesis, Pulsar | Retrasos del productor, transporte, consumidor y destino |
Apache Sqoop se retiró en junio de 2021, por lo que no es un ejemplo de nueva adopción. La ingesta por lotes y la ingesta en flujo pueden usarse por separado o en conjunto.
Los offsets de Kafka permiten reproducir los registros que aún existen. Las políticas de retención por tiempo/tamaño, compactación de registros y tombstones pueden eliminar eventos históricos. Una configuración de duración de retención, por sí sola, no garantiza un historial completo de eventos.
La reproducción por sí sola no proporciona un comportamiento exactamente una vez de extremo a extremo. Las posiciones de origen y el estado del procesamiento deben recuperarse de forma coherente, mientras que las transacciones del destino, la idempotencia y los efectos secundarios externos deben seguir el mismo contrato. Volver a ejecutar un registro tras un fallo no es lo mismo que aplicar dos veces su efecto final.
Los ocho capítulos sobre operaciones de Kafka y la evaluación comparativa de la Parte 9 cubren las opciones para EKS.
3. Almacenamiento: originales y modelos de consulta
| Opción | Ejemplos | Consideraciones de diseño |
|---|---|---|
| Lago de datos | Archivos/objetos de S3 | Datos sin procesar y depurados, retención, acceso, calidad y costo de las consultas |
| Almacén de datos | Redshift, Snowflake, BigQuery | Carga y transformación SQL, tablas, rendimiento y gobernanza |
| Lakehouse | Iceberg, Delta Lake, Hudi | Compatibilidad de formatos/motores, concurrencia y mantenimiento |
Conservar los datos sin procesar en un lago resulta útil para reproducirlos, pero no es la única ruta habitual. El reprocesamiento sigue requiriendo que los datos se hayan conservado realmente y que se tenga acceso a ellos.
ETL significa extraer → transformar → cargar en el destino. ELT significa extraer → cargar → transformar en el destino. Trasladar resultados ya depurados a un almacén de datos no es ELT por el mero hecho de que intervenga un almacén de datos. Usar tanto un lago como un almacén de datos no determina el orden de las transformaciones.
4. Procesamiento: entradas acotadas y continuas
Spark admite el procesamiento por lotes y Structured Streaming; Flink también procesa flujos y entradas acotadas. Las clasificaciones por lotes y en flujo no asignan roles mutuamente excluyentes a los productos.
Entre los diseños posibles se incluyen resultados provisionales rápidos del flujo seguidos de correcciones por datos tardíos, o un nuevo cálculo por lotes para la liquidación. El procesamiento en flujo no es intrínsecamente aproximado, ni el procesamiento por lotes es intrínsecamente exacto. El tiempo de evento, las marcas de agua, el retraso permitido, la deduplicación, el estado y los puntos de control, así como los contratos de salida, determinan el resultado.
Consulta las guías de Spark y Flink para conocer las operaciones de los motores.
5. Consumo: contratos de resultados
La inteligencia empresarial, los informes, los almacenes de características de aprendizaje automático y las API de datos consumen resultados. Convierte requisitos como «retraso de cinco minutos en el panel», «correcciones de liquidación después del cierre» o «objetivo de un segundo para las características de recomendación» en contratos medibles. Estas cifras son ejemplos, no garantías de rendimiento de los productos.
Operaciones transversales
- Orquestación: Herramientas como Airflow gestionan dependencias, cronogramas y reintentos para trabajos orientados a lotes. No son motores que procesen cada evento de flujo, y tener dos canalizaciones no implica automáticamente que se necesite Airflow.
- Contratos de esquema: La compatibilidad de Schema Registry se aplica en las rutas de registro, serialización o CI donde se realizan las comprobaciones. No bloquea automáticamente todos los cambios de DDL en las bases de datos de origen ni los cambios semánticos del negocio. Vincula la política de compatibilidad con pruebas reales de consumidores.
- Observabilidad: Inspecciona el linaje, la actualidad, los datos faltantes/duplicados, las métricas de calidad y el historial de recuperación.
Desde la perspectiva de EKS
Kafka, Spark y Flink usan sus respectivos Operators/modelos de implementación. Airflow usa Helm, ejecutores y Operators de tareas como KubernetesPodOperator. Un «Operator» de Airflow no es el mismo concepto que un controlador de Kubernetes. El almacenamiento, la analítica y los espacios de trabajo gestionados pueden estar en servicios externos de AWS. Compara las responsabilidades con las alternativas gestionadas.
Referencias
El desglose conceptual comenzó con la infografía «Anatomy of a Modern Data Pipeline» de Abhishek Agrawal; los contratos y las directrices operativas se revisaron por separado.