Entrega progresiva con Flagger
Versión base revisada: Flagger/Chart 1.45.0, Loadtester 0.39.0, Flux 2.9.5 (actualizado al parche 2.9.6 después de revisar las notas de la versión; los ejemplos no se volvieron a ejecutar), Podinfo 6.15.0 Última actualización: October 12, 2026
Flagger administra la entrega progresiva de cargas de trabajo de Kubernetes mediante el CRD Canary. Controla el tráfico y las revisiones, no el rollback transaccional de bases de datos ni efectos secundarios externos. Estos ejemplos de laboratorio requieren redes, instrumentación, autorización y SLO de Service coincidentes.
El código incluye manifiestos completos y fragmentos de especificación/valores de Helm. Combínelos con el propietario indicado; los ejemplos de estrategia con el mismo nombre son alternativas, no una secuencia de bloques que se deba aplicar.
Tabla de contenido
- Descripción general y objetivos de aprendizaje
- Arquitectura de Flagger
- Instalación y configuración de EKS
- Estrategia de despliegue Canary
- Estrategia de despliegue Blue-Green
- Estrategia de pruebas A/B
- Métricas personalizadas y Webhooks
- Integración de GitOps (Flux + Flagger)
- Observabilidad y alertas
- Prácticas recomendadas para producción
Descripción general y objetivos de aprendizaje
El RollingUpdate de Kubernetes Deployment ya reemplaza los Pods gradualmente. Flagger agrega control explícito del tráfico de revisiones y promoción basada en métricas/pruebas. Este capítulo abarca la propiedad de recursos, tres estrategias, métricas/puertas, GitOps y observabilidad.
| Estrategia | Control | Comprobación |
|---|---|---|
| Canary | Pesos incrementales | Réplicas adicionales, tráfico mínimo, criterios de fallo |
| Blue-Green | Validar una revisión independiente y luego cambiar | Ambas cargas de trabajo más aumento, compatibilidad de base de datos |
| A/B | Coincidencia admitida de encabezados/cookies | Asignación de cohortes, estadísticas, autorización independiente |
Blue-Green no garantiza exactamente el doble de recursos, rollback instantáneo ni cero tiempo de inactividad. Flagger actualiza primary a la nueva revisión; no conserva después una reserva completa de la versión anterior.
Flagger y Argo Rollouts
| Aspecto | Flagger | Argo Rollouts |
|---|---|---|
| Recursos | Canary referencia una carga de trabajo existente | Rollout CRD, incluido Deployment workloadRef |
| GitOps | Flux y otras herramientas GitOps | Argo CD y otras herramientas GitOps |
| Análisis | MetricTemplate, umbrales, webhooks | AnalysisTemplate/AnalysisRun y proveedores Web/Job |
| Familia de proyecto | Flux graduado de CNCF | Argo graduado de CNCF |
La integración de ecosistema no es un acoplamiento exclusivo. No permita que dos controladores de entrega progresiva administren la misma carga de trabajo.
Arquitectura de Flagger
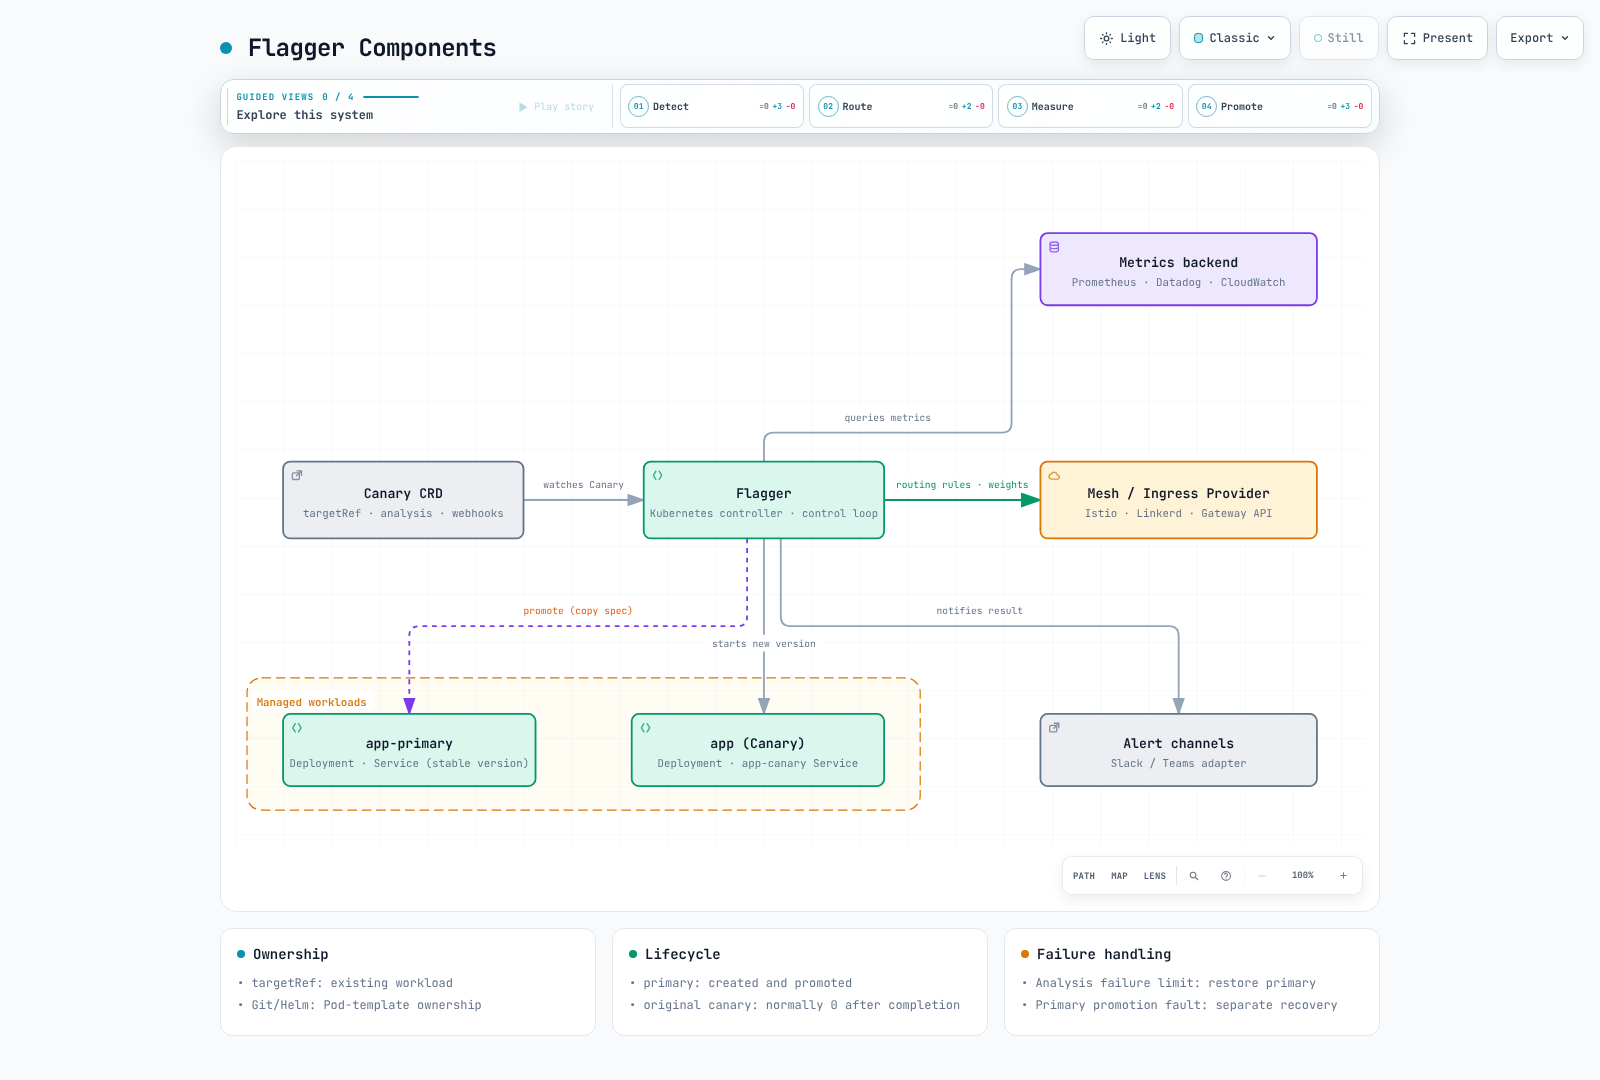
En el ejemplo de Deployment, podinfo es el recurso original y la carga de trabajo canary. La nueva carga de trabajo estable es podinfo-primary. podinfo-canary es un nombre de Service, no un Deployment o CloneSet adicional.
| Recurso | Propiedad/finalidad |
|---|---|
| podinfo Deployment | Plantilla de Pod de Git/Helm, control canary de Flagger |
| podinfo-primary Deployment | Carga de trabajo estable creada/promovida por Flagger |
| podinfo / podinfo-primary / podinfo-canary Services | Selección de entrada/destino administrada por Flagger |
| Autoscaler primary | Autoscaler correspondiente cuando se usa autoscalerRef |
| VirtualService/DestinationRule/HTTPRoute, etc. | Enrutamiento para el proveedor seleccionado |
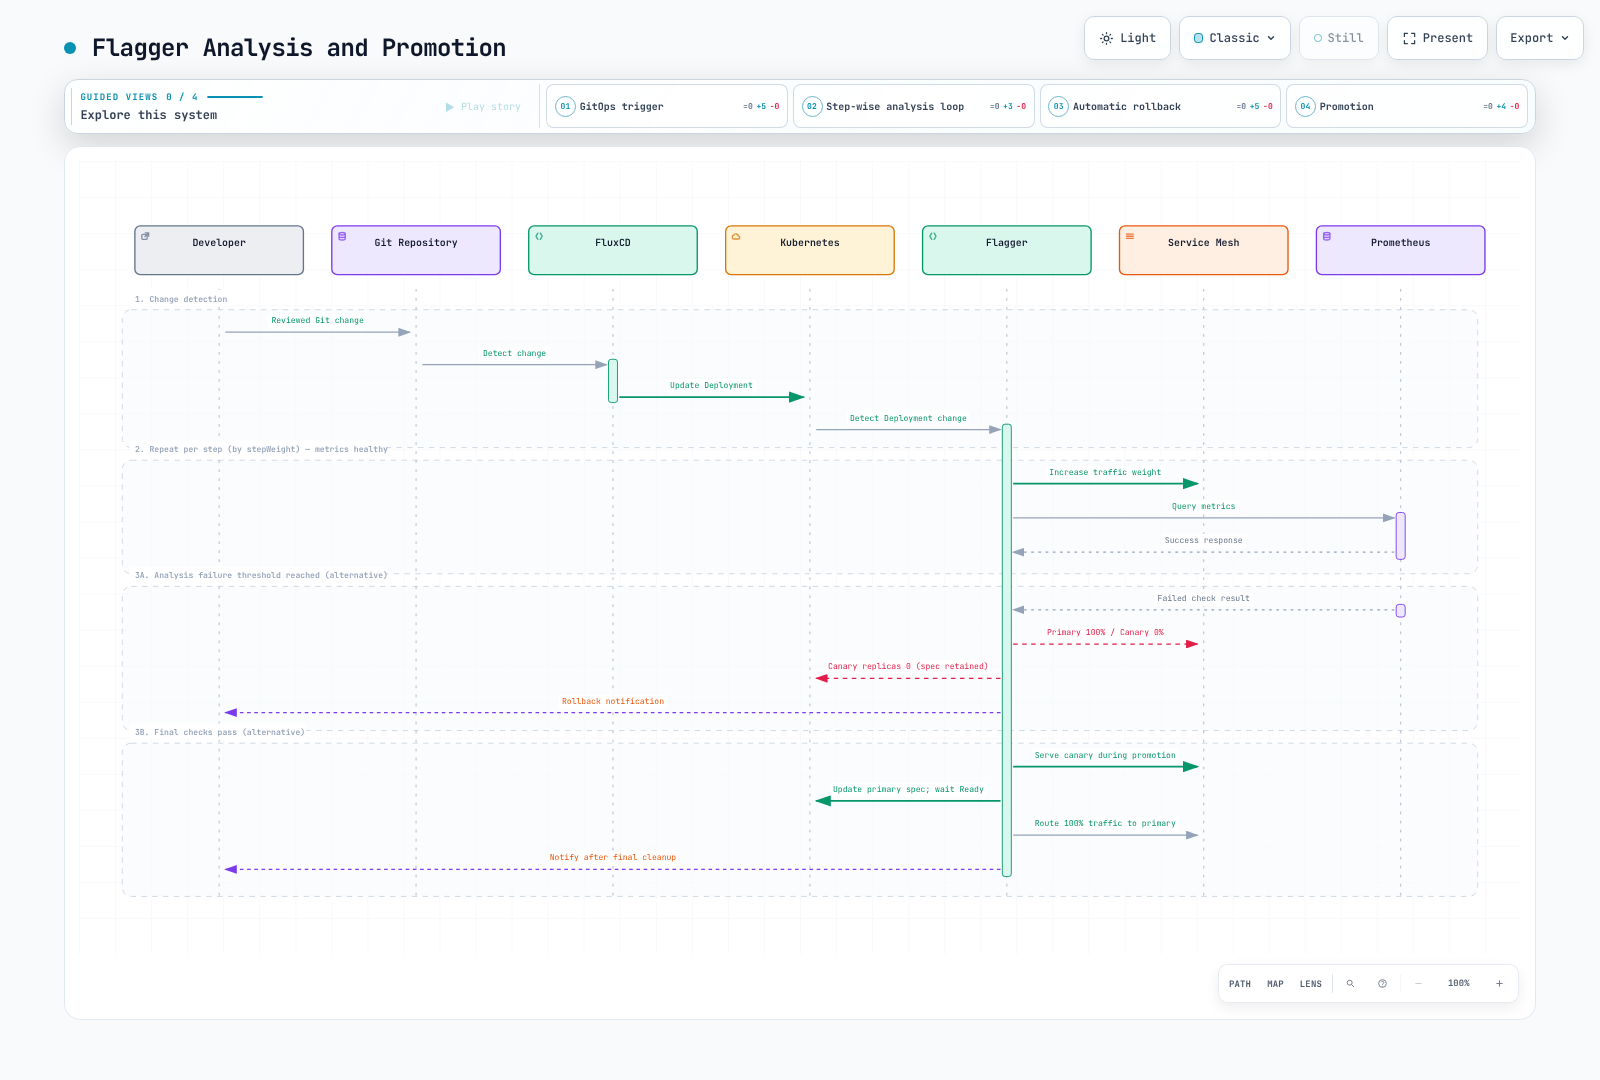
Después de la configuración inicial de primary, los cambios de plantilla de Pod o de ConfigMap/Secret rastreados preparan canary. Tras las comprobaciones previas al rollout, el análisis y el enrutamiento, la promoción sirve tráfico mediante el canary listo mientras primary adopta la nueva especificación. Después de que primary esté listo, el tráfico regresa a este y canary reduce su escala.
El fallo de análisis normalmente restaura un primary saludable. El fallo al actualizar primary es diferente: durante Promoting/Finalising, 1.45.0 puede mantener/devolver el tráfico al canary saludable mientras informa un fallo. El estado Failed por sí solo no demuestra que el primary anterior esté sirviendo tráfico.
Proveedores y ciclo de vida
| Proveedor | Comprobación |
|---|---|
| Istio | VirtualService/DestinationRule y métricas HTTP de sidecar |
| gatewayapi:v1 | Características de Gateway HTTPRoute y MetricTemplate |
| Linkerd/Contour/Gloo/Traefik/Kuma, etc. | Capacidades de la versión instalada y contrato de métricas |
| kubernetes | Blue-Green con cambio de Service, no enrutamiento L7 ponderado/A/B |
| App Mesh / ingress-nginx / OSM | Límites de ciclo de vida heredado a continuación |
El soporte de AWS App Mesh finalizó el 2026-09-30; AWS indica que su consola y sus recursos ya no son accesibles después de esa fecha. El ingress-nginx de la comunidad se retiró en marzo de 2026 y el repositorio de OSM está archivado.
La disponibilidad de un adaptador no es una garantía de mantenimiento para nuevo uso en producción. Verifique la compatibilidad de A/B, mirroring y afinidad de sesión por implementación.
Instalación y configuración de EKS
La base requiere EKS/Kubernetes admitidos, un entorno de sidecar Istio instalado y Prometheus recopilando las métricas requeridas. Reemplace su URL por el Service real. Flagger no instala Istio ni la instrumentación. La imagen de Prometheus incluida en el chart es la antigua 2.41.0, por lo que está deshabilitada.
Elija un método de lanzamiento/administración. Instalar instancias independientes de Flagger en distintos namespaces puede hacer que ambas controlen el mismo Canary. Los ejemplos usan flagger-system para controladores y flagger-demo para cargas de trabajo. Adapte las etiquetas de inyección a la revisión real de Istio.
apiVersion: v1
kind: Namespace
metadata:
  name: flagger-system
  labels:
    istio-injection: enabled
---
apiVersion: v1
kind: Namespace
metadata:
  name: flagger-demo
  labels:
    istio-injection: enabled
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: flagger-loadtester
  namespace: flagger-system
automountServiceAccountToken: false
Instalación de Flagger con Helm
fullnameOverride: flagger
meshProvider: istio
namespace: flagger-demo
noCrossNamespaceRefs: true
metricsServer: http://prometheus.monitoring.svc.cluster.local:9090
prometheus:
  install: false
leaderElection:
  enabled: true
  replicaCount: 2
resources:
  requests:
    cpu: 100m
    memory: 128Mi
  limits:
    cpu: '1'
    memory: 512Mi
podDisruptionBudget:
  enabled: true
minAvailable: 1helm repo add flagger https://flagger.app
helm repo update flagger
helm upgrade --install flagger flagger/flagger --version 1.45.0 \
--namespace flagger-system -f flagger-values.yaml --wait --timeout 5mnamespace limita la observación, no los permisos ClusterRole del chart. Restrinja el RBAC de tenants por separado. leaderElection.replicaCount es un valor real del chart. Las actualizaciones ordinarias de Helm no actualizan crds/ como sí lo hace la instalación inicial; aplique CRD revisados por separado o use la política de CRD de Flux.
kubectl apply --server-side -f https://raw.githubusercontent.com/fluxcd/flagger/v1.45.0/artifacts/flagger/crd.yamlLoadtester y ámbito de acceso
fullnameOverride: flagger-loadtester
replicaCount: 1
service:
  type: ClusterIP
  port: 80
serviceAccountName: flagger-loadtester
rbac:
  create: false
cmd:
  timeout: 2m
  namespaceRegexp: ^flagger-demo$
resources:
  requests:
    cpu: 100m
    memory: 64Mi
  limits:
    cpu: 500m
    memory: 256Mi
securityContext:
  enabled: true
  context:
    allowPrivilegeEscalation: false
    capabilities:
      drop:
      - ALL
    readOnlyRootFilesystem: true
    runAsUser: 100
    runAsGroup: 101
volumes:
- name: tmp
  emptyDir: {}
volumeMounts:
- name: tmp
mountPath: /tmphelm upgrade --install flagger-loadtester flagger/loadtester --version 0.39.0 \
--namespace flagger-system -f loadtester-values.yaml --wait --timeout 5mLoadtester ejecuta comandos de solicitudes HTTP. namespaceRegexp filtra una cadena del cuerpo; no es autenticación de quien llama. Manténgalo fuera de internet y restrinja el ingreso a los Pods del controlador mediante una política CNI. Controle exec/port-forward del operador con RBAC. Use una réplica para los laboratorios de puertas de memoria.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: flagger-loadtester-ingress
  namespace: flagger-system
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/name: loadtester
  policyTypes:
  - Ingress
  ingress:
  - from:
    - namespaceSelector:
        matchLabels:
          kubernetes.io/metadata.name: flagger-system
      podSelector:
        matchLabels:
          app.kubernetes.io/name: flagger
    ports:
    - protocol: TCP
      port: 8080
Permita las rutas de mTLS y recopilación requeridas de Istio. Este loadtester no realiza operaciones de API, por lo que el montaje automático de tokens de ServiceAccount está deshabilitado. Agregar pruebas de Helm/kubectl requiere permisos explícitos y rutas con escritura.
Alternativa de Gateway API
Esto presupone una GatewayClass de Istio existente y CRD de Gateway API compatibles. No los sobrescriba con un paquete antiguo. Otras implementaciones necesitan instrumentación/consultas coincidentes. Configure la exposición de Service/LB, DNS y TLS para el entorno.
apiVersion: gateway.networking.k8s.io/v1
kind: Gateway
metadata:
  name: podinfo-gateway
  namespace: flagger-demo
spec:
  gatewayClassName: istio
  listeners:
  - name: http
    protocol: HTTP
    port: 80
    allowedRoutes:
      namespaces:
        from: Same
Use gatewayapi:v1 y Canary service.gatewayRefs, no un valor Helm gatewayApi.gateway inventado. Prepare los tres MetricTemplates de abajo y use este Canary como una alternativa al enfoque de Istio.
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: gatewayapi:v1
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    hosts:
    - app.example.com
    gatewayRefs:
    - name: podinfo-gateway
      namespace: flagger-demo
      sectionName: http
  analysis:
    interval: 1m
    threshold: 5
    maxWeight: 50
    stepWeight: 10
    metrics:
    - name: error-rate
      templateRef:
        name: istio-error-rate
      thresholdRange:
        min: 0
        max: 1
      interval: 1m
    - name: latency-p99-ms
      templateRef:
        name: istio-latency-ms
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    - name: request-count
      templateRef:
        name: istio-request-count
      thresholdRange:
        min: 100
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/helm upgrade --install flagger flagger/flagger --version 1.45.0 \
--namespace flagger-system -f flagger-values.yaml --set meshProvider=gatewayapi:v1Estrategia de despliegue Canary
Estos son la carga de trabajo de Istio y el HPA base; Metrics Server es obligatorio. Omita las réplicas de Deployment de Git para que HPA/Flagger puedan controlar el escalado, y no cree un Service que compita. Elija estos manifiestos o la alternativa HelmRelease posterior.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  selector:
    matchLabels:
      app: podinfo
  template:
    metadata:
      labels:
        app: podinfo
    spec:
      containers:
      - name: podinfo
        image: ghcr.io/stefanprodan/podinfo:6.15.0
        ports:
        - name: http
          containerPort: 9898
        readinessProbe:
          httpGet:
            path: /readyz
            port: http
        livenessProbe:
          httpGet:
            path: /healthz
            port: http
        resources:
          requests:
            cpu: 100m
            memory: 64Mi
          limits:
            cpu: 500m
            memory: 256Mi
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  minReplicas: 2
  maxReplicas: 4
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 80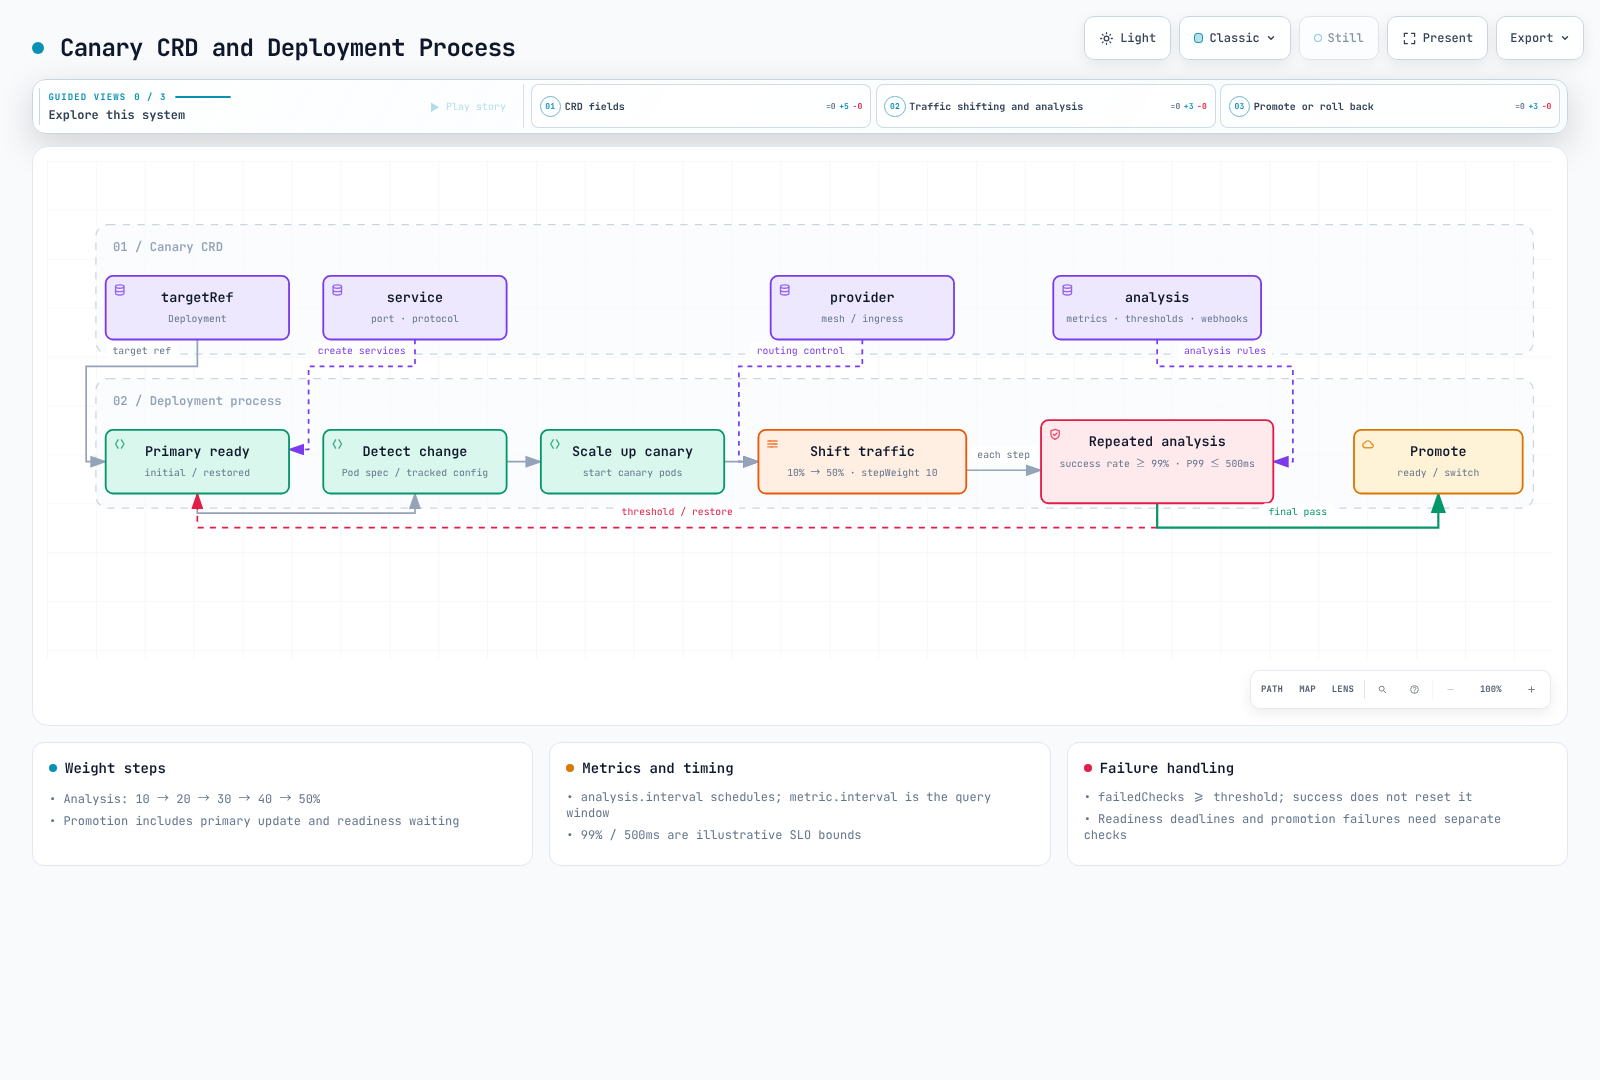
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: istio
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    portName: http
    gateways:
    - mesh
    hosts:
    - podinfo
    trafficPolicy:
      tls:
        mode: ISTIO_MUTUAL
  analysis:
    interval: 1m
    threshold: 5
    maxWeight: 50
    stepWeight: 10
    metrics:
    - name: request-success-rate
      thresholdRange:
        min: 99
        max: 100
      interval: 1m
    - name: request-duration
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
        cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/
Iterations selecciona Blue-Green, o A/B cuando match está presente; no los mezcle en un Canary ponderado. StepWeight 10 y maxWeight 50 describen el análisis en 10→20→30→40→50% antes de la promoción. El tiempo total depende de la disponibilidad, la latencia de comprobaciones, fallos/aprobaciones y el rollout de primary.
Analysis.interval programa el análisis; el intervalo de métrica proporciona su ventana de consulta/agregación. Threshold 5 se aplica a comprobaciones fallidas acumuladas para una revisión, no a un conteo consecutivo restablecido por cada éxito. Alcanzar cinco causa rollback en la reconciliación posterior. Los fallos previos al rollout y de rollout/métrica alimentan esta ruta. ProgressDeadlineSeconds limita el progreso/disponibilidad de la carga de trabajo, no el doble del tiempo total de rollout.
Para pesos no lineales, use stepWeights y elimine stepWeight/maxWeight existentes. Las conexiones y la convergencia de enrutamiento significan que los pesos configurados no garantizan una proporción exacta de solicitudes en cada instante.
spec:
  analysis:
    stepWeights:
    - 1
    - 2
    - 5
    - 10
    - 25
- 50kubectl get canary podinfo -n flagger-demo --watch
kubectl describe canary podinfo -n flagger-demo
kubectl logs -n flagger-system -l app.kubernetes.io/name=flagger -c flagger --prefix --tail=100Después de la configuración estable inicial, aplique mediante Git un cambio revisado de imagen/tag/digest o de plantilla de Pod para iniciar el análisis. Reemplazar contenido remoto tras la misma etiqueta no sustituye un cambio de Git. No edite directamente los recursos generados de primary, Service o enrutamiento.
Estrategia de despliegue Blue-Green
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: istio
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    portName: http
    gateways:
    - mesh
    hosts:
    - podinfo
    trafficPolicy:
      tls:
        mode: ISTIO_MUTUAL
  analysis:
    interval: 1m
    threshold: 5
    metrics:
    - name: request-success-rate
      thresholdRange:
        min: 99
        max: 100
      interval: 1m
    - name: request-duration
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
        cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/
    iterations: 10
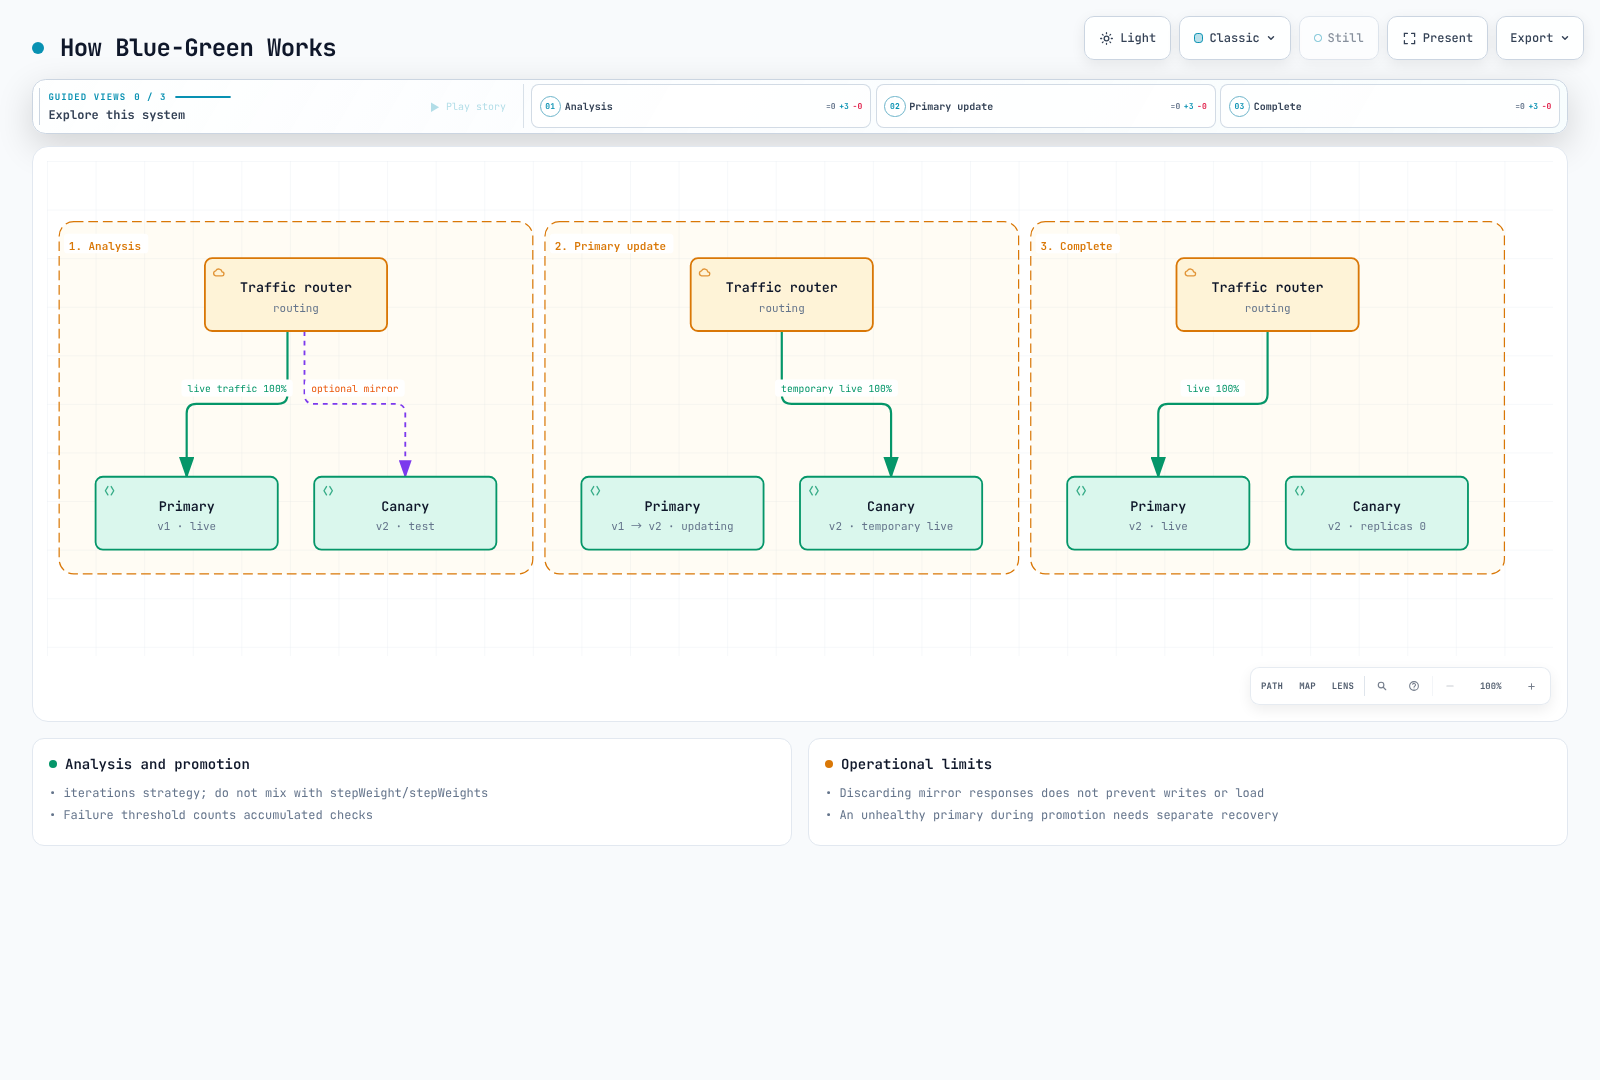
Este ejemplo analiza tráfico sintético mientras el tráfico activo permanece en primary. Después de aprobarse, el tráfico se mueve a canary mientras primary se actualiza y luego vuelve cuando primary está listo. Los umbrales de fallo aún se aplican; una medición fallida no siempre supone un rollback inmediato. Esto no es un entorno independiente que retenga una reserva completa de la versión anterior.
Mirroring de tráfico opcional
spec:
  analysis:
    mirror: true
    mirrorWeight: 10
Los proveedores compatibles pueden reflejar como una etapa previa de Canary o para Blue-Green. Verifique la compatibilidad con RequestMirror para Gateway API. Descartar respuestas no evita escrituras de base de datos, pagos, mensajes ni carga; use solicitudes verificadas de solo lectura o aislamiento. El mirroring no es replicación ni rollback de base de datos.
Estrategia de pruebas A/B
apiVersion: flagger.app/v1beta1
kind: Canary
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  provider: istio
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: podinfo
  autoscalerRef:
    apiVersion: autoscaling/v2
    kind: HorizontalPodAutoscaler
    name: podinfo
  progressDeadlineSeconds: 120
  service:
    port: 9898
    targetPort: 9898
    portName: http
    gateways:
    - mesh
    hosts:
    - podinfo
    trafficPolicy:
      tls:
        mode: ISTIO_MUTUAL
  analysis:
    interval: 1m
    threshold: 5
    metrics:
    - name: request-success-rate
      thresholdRange:
        min: 99
        max: 100
      interval: 1m
    - name: request-duration
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    webhooks:
    - name: smoke-test
      type: pre-rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 30s
      metadata:
        type: bash
        cmd: |-
          set -euo pipefail
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/healthz >/dev/null
          curl -fsS --max-time 10 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/readyz >/dev/null
    - name: load-test
      type: rollout
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/
      timeout: 5s
      metadata:
        type: cmd
        cmd: hey -z 1m -q 10 -c 2 http://podinfo-canary.flagger-demo.svc.cluster.local:9898/
    iterations: 10
    match:
    - headers:
        x-canary:
          exact: insider
    - headers:
        cookie:
          regex: (^|.*;\s*)canary=always(;.*|$)
Las entradas match son alternativas OR; las condiciones dentro de una entrada siguen las reglas del proveedor. La expresión regular de cookie maneja espacios después de puntos y coma. Istio sourceLabels describe etiquetas de carga de trabajo, no IP de origen. Verifique la compatibilidad de matchers por implementación/versión de Gateway.
El enrutamiento no es autorización ni un experimento estadístico completo. No confíe en marcadores controlados por el cliente como permisos de empleados. Asigne cohortes en un borde de confianza y autorice en el lado del servidor; las conclusiones A/B significativas también requieren muestras, diseño de asignación y pruebas estadísticas.
Verifique la ruta base de mesh desde el Pod loadtester inyectado. Pruebe las rutas externas de Gateway mediante su host/TLS/ingress real. Llamar directamente a -canary no valida las coincidencias de enrutamiento.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS http://podinfo.flagger-demo.svc.cluster.local:9898/
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -H 'x-canary: insider' http://podinfo.flagger-demo.svc.cluster.local:9898/
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -b 'canary=always' http://podinfo.flagger-demo.svc.cluster.local:9898/
Métricas personalizadas y Webhooks
Prometheus MetricTemplate
Estas consultas usan un contrato de métricas de sidecar Istio. Verifique las etiquetas de namespace/carga de trabajo, reporter y recopilación. Una serie 5xx ausente se convierte en un numerador cero; el tráfico ausente o un denominador cero no se convierte en éxito. El mínimo de 100 solicitudes y otros límites son ilustrativos; elija valores a partir de SLO y requisitos de muestra.
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: istio-error-rate
  namespace: flagger-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.monitoring.svc.cluster.local:9090
  query: |
    (sum(rate(istio_requests_total{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}", response_code=~"5.."}[{{ interval }}])) or vector(0)) / sum(rate(istio_requests_total{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}"}[{{ interval }}])) * 100
---
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: istio-latency-ms
  namespace: flagger-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.monitoring.svc.cluster.local:9090
  query: |
    histogram_quantile(0.99, sum(rate(istio_request_duration_milliseconds_bucket{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}"}[{{ interval }}])) by (le))
---
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: istio-request-count
  namespace: flagger-demo
spec:
  provider:
    type: prometheus
    address: http://prometheus.monitoring.svc.cluster.local:9090
  query: |
    sum(increase(istio_requests_total{reporter="destination", destination_workload_namespace="{{ namespace }}", destination_workload="{{ target }}"}[{{ interval }}]))
---
spec:
  analysis:
    metrics:
    - name: error-rate
      templateRef:
        name: istio-error-rate
      thresholdRange:
        min: 0
        max: 1
      interval: 1m
    - name: latency-p99-ms
      templateRef:
        name: istio-latency-ms
      thresholdRange:
        min: 0
        max: 500
      interval: 1m
    - name: request-count
      templateRef:
        name: istio-request-count
      thresholdRange:
        min: 100
      interval: 1m
MetricTemplate debe devolver un valor numérico. El proveedor Prometheus rechaza resultados vacíos/NaN. Limite los porcentajes a rangos finitos de 0–100 y alinee las unidades de latencia personalizadas. Los límites son inclusivos. Las mediciones con ventanas de consulta superpuestas no son muestras independientes.
Unidades de Datadog y punto de datos seleccionado
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: datadog-average-latency-ms
  namespace: flagger-demo
spec:
  provider:
    type: datadog
    address: https://api.datadoghq.com
    secretRef:
      name: datadog-api
  query: |
    avg:myapp.request_duration_ms{kube_deployment:{{ target }},kube_namespace:{{ namespace }}}.rollup(avg, 60)
---
apiVersion: v1
kind: Secret
metadata:
  name: datadog-api
  namespace: flagger-demo
type: Opaque
stringData:
  datadog_api_key: REPLACE_WITH_API_KEY
  datadog_application_key: REPLACE_WITH_APPLICATION_KEY
myapp.request_duration_ms es una latencia media personalizada en ms que debe publicar; no es P99. Seleccione el sitio con provider.address. El cliente lee las dos claves de Secret mostradas, no datadog_site. Consulta diez veces el intervalo de métrica y devuelve el punto más antiguo de la primera serie. No lo use por sí solo como prueba de la salud actual del canary; combínelo con mediciones recientes específicas de la revisión.
Las pruebas locales de respuesta simulada del cliente original también confirmaron que un primer punto de datos nulo se decodifica como cero. Por lo tanto, una puerta de latencia que acepta cero milisegundos puede ser engañosa. Use un puente que valide marcas de tiempo/valores ausentes o mediciones recientes de Prometheus.
Campos y límites de CloudWatch
apiVersion: flagger.app/v1beta1
kind: MetricTemplate
metadata:
  name: cloudwatch-error-percent
  namespace: flagger-demo
spec:
  provider:
    type: cloudwatch
    region: ap-northeast-2
  query: |
    [
      {
        "Id": "errorrate",
        "Expression": "IF(FILL(requests,0)>=100,100*FILL(errors,0)/FILL(requests,0),-1)",
        "Label": "CanaryErrorPercent",
        "ReturnData": true
      },
      {
        "Id": "errors",
        "MetricStat": {
          "Metric": {
            "Namespace": "MyApp",
            "MetricName": "5xxErrors",
            "Dimensions": [
              {
                "Name": "Service",
                "Value": "{{ target }}"
              },
              {
                "Name": "Namespace",
                "Value": "{{ namespace }}"
              }
            ]
          },
          "Period": 60,
          "Stat": "Sum"
        },
        "ReturnData": false
      },
      {
        "Id": "requests",
        "MetricStat": {
          "Metric": {
            "Namespace": "MyApp",
            "MetricName": "TotalRequests",
            "Dimensions": [
              {
                "Name": "Service",
                "Value": "{{ target }}"
              },
              {
                "Name": "Namespace",
                "Value": "{{ namespace }}"
              }
            ]
          },
          "Period": 60,
          "Stat": "Sum"
        },
        "ReturnData": false
      }
    ]
---
spec:
  analysis:
    metrics:
    - name: cw-error-percent
      templateRef:
        name: cloudwatch-error-percent
      thresholdRange:
        min: 0
        max: 1
      interval: 1m
Provider.region es compatible y obligatorio. Publique las métricas MyApp y las dimensiones Service/Namespace por separado. La expresión devuelve -1 para períodos sin datos/de bajo volumen, lo que falla el límite de 0–1 %. Los retrasos de ingesta pueden rechazar un rollout; verifique la publicación real y las ventanas de agregación/consulta.
El proveedor nativo consulta diez veces el intervalo de métrica y selecciona el primer valor del primer resultado sin validar por separado timestamp/StatusCode. Complételo con comprobaciones actuales de solicitudes/salud de Prometheus específicas de la revisión para que puntos antiguos o métricas ALB agregadas no se confundan con la salud actual del canary. Su permiso de API de AWS es GetMetricData.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "cloudwatch:GetMetricData",
      "Resource": "*",
      "Condition": {
        "StringEquals": {
          "aws:RequestedRegion": "ap-northeast-2"
        }
      }
    }
  ]
}
Configure la autenticación de ServiceAccount y la confianza de rol de Flagger cuando se use CloudWatch, y haga coincidir la condición de región. Esta revisión no llamó a API de AWS ni desplegó un rol.
Contrato de Webhook
| Tipo | Comportamiento de significado/rechazo |
|---|---|
| confirm-rollout | Esperar aprobación de inicio |
| pre-rollout | Comprobar antes del cambio de tráfico inicial; incrementa fallos |
| rollout | Se llama durante el análisis; incrementa fallos |
| confirm-traffic-increase | Esperar antes de aumentar el peso |
| confirm-promotion | Esperar antes de la promoción |
| post-rollout | Notificar/limpiar después de Succeeded o Failed; no revierte el resultado |
| rollback | El éxito durante la espera de análisis/aprobación solicita rollback |
| event | Reenviar eventos relacionados con el estado |
Normalmente devuelva HTTP 200. La versión 1.45.0 trata los códigos superiores a 202 como errores, por lo que no suponga que 204 tiene éxito. Los metadatos se copian literalmente; {{ .Version }} no se interpola. Use name/namespace/phase/checksum de la carga útil. Los cuerpos no exitosos pueden llegar a logs/events, así que no devuelva valores sensibles.
name: podinfo
namespace: flagger-demo
phase: Progressing
checksum: example-revision-checksum
metadata:
  gate: promotion
La configuración de Webhook no proporciona encabezados Authorization arbitrarios. Implemente la autenticación requerida mediante un límite de mTLS/proxy interno revisado; no coloque secretos en URL/metadatos públicos de Git ni deshabilite la verificación de TLS de forma predeterminada.
Las pruebas de carga cmd se aceptan de forma asíncrona; el éxito HTTP no es un veredicto sobre la calidad de la prueba de carga. Bash bloquea hasta completarse y debe caber en su timeout. La imagen 0.39.0 incluye curl/jq/hey/wrk/bash, pero no k6. k6 necesita una imagen y umbrales verificados por separado, porque check() por sí solo no establece un estado de salida fallido.
Este script es para una imagen de prueba dedicada con k6 instalado, no un comando que funcione en la imagen loadtester predeterminada.
import http from 'k6/http';
import { check, sleep } from 'k6';

export const options = {
  vus: 2,
  duration: '20s',
  thresholds: {
    checks: ['rate==1'],
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(99)<500'],
  },
};
export default function () {
  const result = http.get('http://podinfo-canary.flagger-demo.svc.cluster.local:9898/');
  check(result, { 'HTTP 200': (response) => response.status === 200 });
  sleep(0.5);
}
Puertas manuales
spec:
  analysis:
    webhooks:
    - name: promotion-approval
      type: confirm-promotion
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/gate/check
      timeout: 5s
      metadata:
        gate: promotion
Combine esta entrada con la lista existente de webhooks de Canary. /gate/approve siempre aprueba; no es una puerta manual. /gate/check lee el estado de name.namespace en memoria. Proporcione el mismo cuerpo JSON para abrir/cerrar/comprobar. El cierre mantiene la promoción, no el rollback.
# Close before starting a new revision.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/gate/close
# Approve the reviewed revision.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/gate/open
# A closed gate returns 403.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -sS -o /dev/null -w '%{http_code}\n' -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/gate/check
La puerta integrada no es específica de checksum, se restablece al reiniciar el Pod y no se comparte entre réplicas. Ciérrela antes de la siguiente revisión. La aprobación de producción necesita autenticación, auditoría, vencimiento y estado indexado por name/namespace/checksum/gate. Una puerta de memoria compartida por inicio y promoción no son dos aprobaciones independientes.
Rollback manual y suspensión
spec:
  analysis:
    webhooks:
    - name: operator-rollback
      type: rollback
      url: http://flagger-loadtester.flagger-system.svc.cluster.local/rollback/check
      timeout: 5s
El endpoint de rollback normalmente devuelve 403 si no hay señal y 200 cuando se solicita. La respuesta exitosa de un receptor de notificaciones aquí puede causar un rollback no intencionado. Las siguientes solicitudes piden rollback durante el análisis normalmente reconciliado/la espera de aprobación de promoción; no es un interruptor de recuperación instantánea para todas las fases.
kubectl get canary podinfo -n flagger-demo -o jsonpath='{.status.phase}{"\n"}'
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/rollback/open
kubectl get canary podinfo -n flagger-demo --watch
# Reset the request after observing the operation.
kubectl exec -n flagger-system deployment/flagger-loadtester -- \
  curl -fsS -X POST -H 'Content-Type: application/json' \
  -d '{"name":"podinfo","namespace":"flagger-demo"}' http://localhost:8080/rollback/close
Los fallos de controlador/disponibilidad o una puerta confirm-rollout cerrada pueden detener la reconciliación antes de este hook. Los fallos de primary durante Promoting/Finalising necesitan el manejo de recuperación independiente descrito antes. Dejar rollback abierto después de completarse puede afectar a la siguiente revisión.
No trate las anotaciones flagger.app/rollback, flagger.app/suspend o flagger.app/skipAnalysis como API de control. Suspend/skipAnalysis son campos de especificación. Suspend detiene la reconciliación, incluidos los hooks de rollback, sin devolver tráfico a primary. SkipAnalysis promociona sin análisis; no es rollback. Actualice también el propietario de Git.
spec:
  suspend: true
Integración de GitOps (Flux + Flagger)
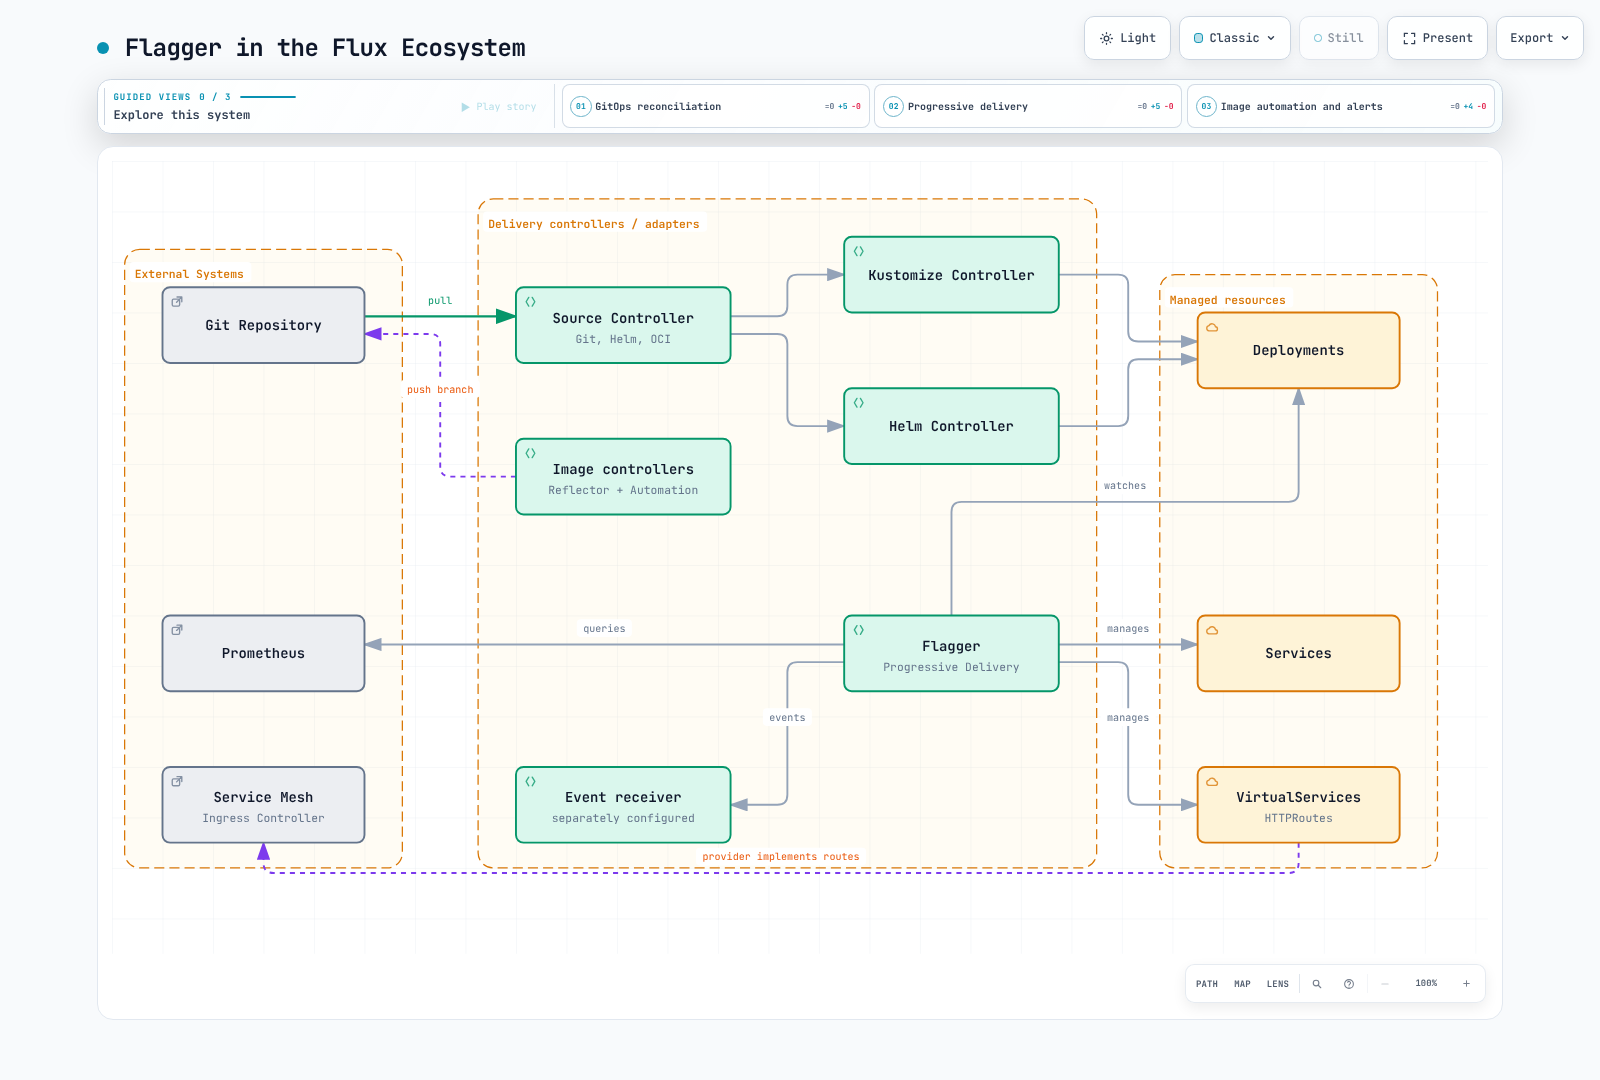
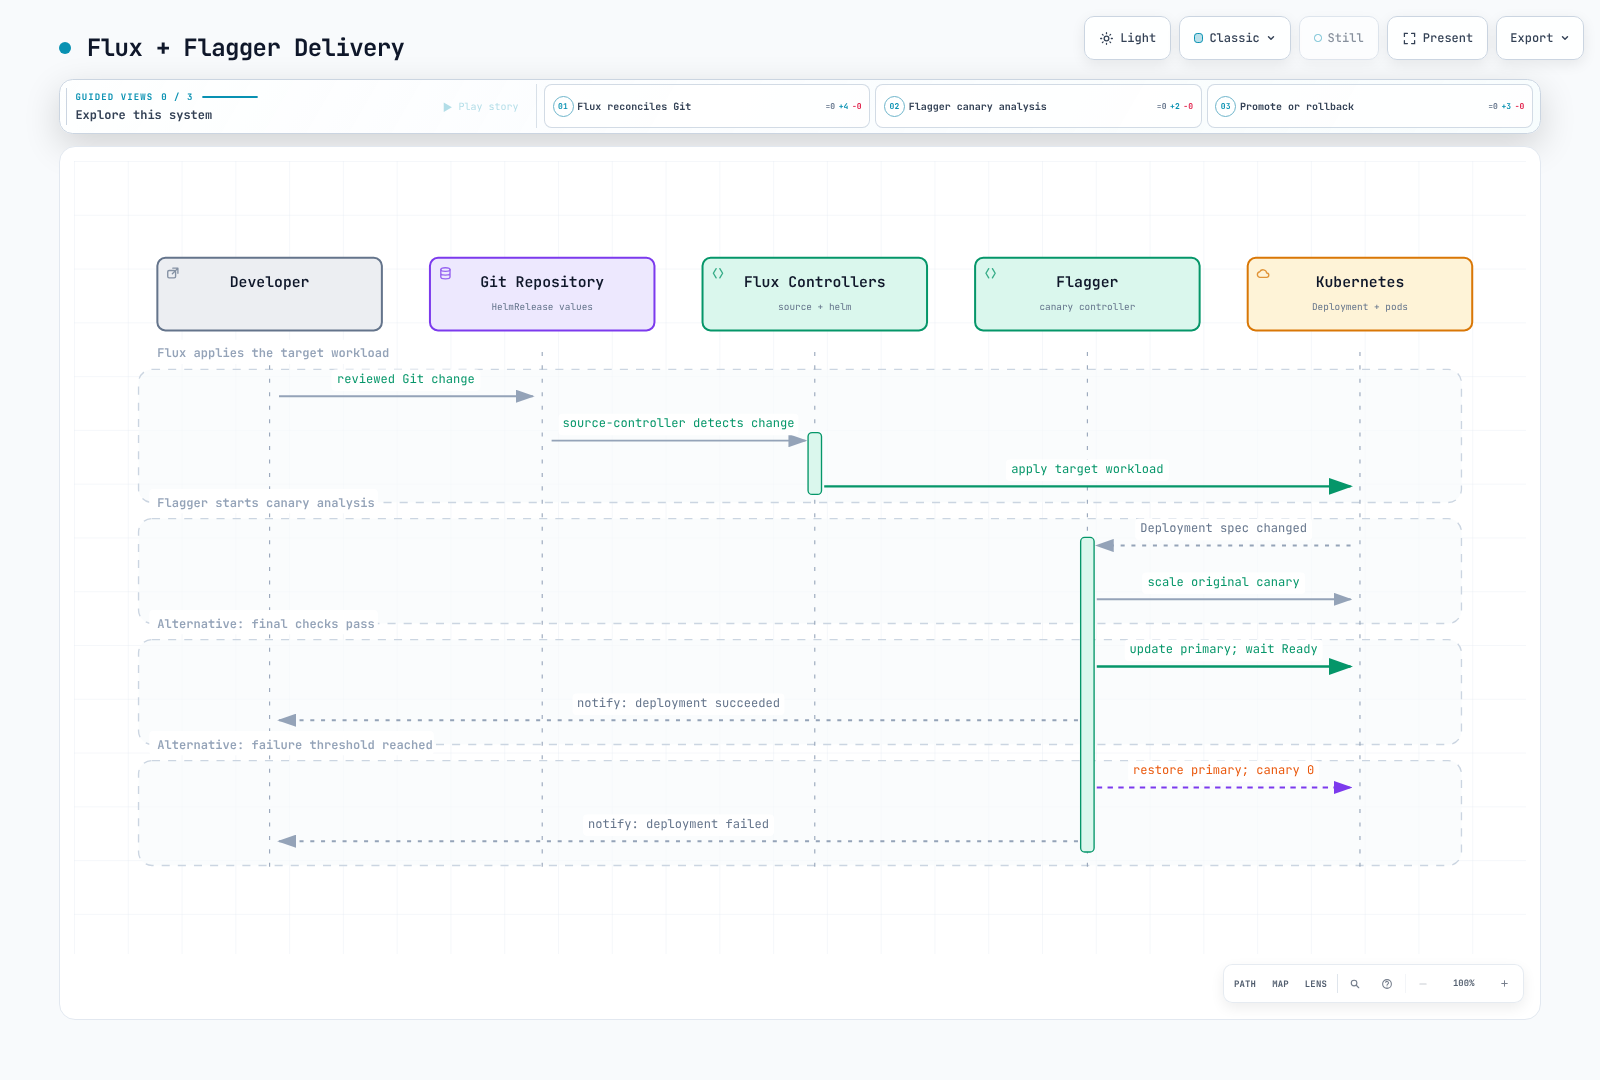
El bootstrap de Flux no instala Flagger como controlador integrado. Instálelo por separado mediante HelmRelease o Kustomization. No administre el mismo lanzamiento simultáneamente mediante Helm CLI. Administre también en Git los namespaces, ServiceAccount y NetworkPolicy anteriores.
apiVersion: source.toolkit.fluxcd.io/v1
kind: HelmRepository
metadata:
  name: flagger
  namespace: flagger-system
spec:
  interval: 1h
  url: https://flagger.app
---
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: flagger
  namespace: flagger-system
spec:
  interval: 1h
  releaseName: flagger
  chart:
    spec:
      chart: flagger
      version: 1.45.0
      sourceRef:
        kind: HelmRepository
        name: flagger
  install:
    crds: Create
  upgrade:
    crds: CreateReplace
  values:
    fullnameOverride: flagger
    meshProvider: istio
    namespace: flagger-demo
    noCrossNamespaceRefs: true
    metricsServer: http://prometheus.monitoring.svc.cluster.local:9090
    prometheus:
      install: false
    leaderElection:
      enabled: true
      replicaCount: 2
    resources:
      requests:
        cpu: 100m
        memory: 128Mi
      limits:
        cpu: '1'
        memory: 512Mi
    podDisruptionBudget:
      enabled: true
      minAvailable: 1
---
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: loadtester
  namespace: flagger-system
spec:
  interval: 1h
  releaseName: flagger-loadtester
  chart:
    spec:
      chart: loadtester
      version: 0.39.0
      sourceRef:
        kind: HelmRepository
        name: flagger
  values:
    fullnameOverride: flagger-loadtester
    replicaCount: 1
    service:
      type: ClusterIP
      port: 80
    serviceAccountName: flagger-loadtester
    rbac:
      create: false
    cmd:
      timeout: 2m
      namespaceRegexp: ^flagger-demo$
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
    securityContext:
      enabled: true
      context:
        allowPrivilegeEscalation: false
        capabilities:
          drop:
          - ALL
        readOnlyRootFilesystem: true
        runAsUser: 100
        runAsGroup: 101
    volumes:
    - name: tmp
      emptyDir: {}
    volumeMounts:
    - name: tmp
      mountPath: /tmp
El manejo CreateReplace de CRD de Flux no es una garantía de migración segura. Revise los cambios de CRD y los objetos almacenados antes de las actualizaciones. Aplique objetos Canary después de que las fuentes y la instalación del proveedor estén listas.
Alternativa HelmRelease de aplicación
apiVersion: source.toolkit.fluxcd.io/v1
kind: HelmRepository
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  interval: 1h
  url: https://stefanprodan.github.io/podinfo
---
apiVersion: helm.toolkit.fluxcd.io/v2
kind: HelmRelease
metadata:
  name: podinfo
  namespace: flagger-demo
spec:
  interval: 5m
  releaseName: podinfo
  chart:
    spec:
      chart: podinfo
      version: 6.15.0
      sourceRef:
        kind: HelmRepository
        name: podinfo
  values:
    service:
      enabled: false
    hpa:
      enabled: true
      minReplicas: 2
      maxReplicas: 4
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
Podinfo 6.15.0 service.enabled=false evita la propiedad de Service en competencia. Con hpa.enabled=true el chart no fija las réplicas de Deployment. No aplique este HelmRelease junto con los manifiestos de carga de trabajo nativos. Verifique el comportamiento equivalente renderizando otros charts, en lugar de asumir nombres de valores idénticos.
Administre el Canary anterior junto con la aplicación. La preparación de Flux/Helm se refiere a la aplicación/disponibilidad de recursos; no demuestra automáticamente que Flagger promovió la revisión actual. Establezca como puerta para el siguiente entorno el estado/checksum de Canary y la coincidencia de la versión desplegada con el cambio previsto.
Alternativa Kustomization
apiVersion: kustomize.toolkit.fluxcd.io/v1
kind: Kustomization
metadata:
  name: podinfo
  namespace: flux-system
spec:
  interval: 10m
  targetNamespace: flagger-demo
  sourceRef:
    kind: GitRepository
    name: flux-system
  path: ./apps/podinfo
  prune: true
timeout: 5mapiVersion: kustomize.config.k8s.io/v1beta1
kind: Kustomization
namespace: flagger-demo
resources:
- deployment.yaml
- hpa.yaml
- canary.yamlEl sourceRef usa el nombre predeterminado de GitRepository del bootstrap. Almacene los manifiestos nativos bajo apps/podinfo y omita los recursos de Service/primary propiedad de Flagger. El éxito de la aplicación Kustomization no es la finalización de la promoción.
Una superposición de entorno puede aplicar parches explícitos a configuraciones escalares. Estas son elecciones ilustrativas, no un estándar universal de producción. Compruebe también el comportamiento de reemplazo de arrays al aplicar parches a CRD.
apiVersion: kustomize.config.k8s.io/v1beta1
kind: Kustomization
resources:
- ../base
patches:
- target:
    group: flagger.app
    version: v1beta1
    kind: Canary
    name: podinfo
  patch: |
    - op: replace
      path: /spec/analysis/threshold
      value: 3
    - op: replace
      path: /spec/analysis/maxWeight
      value: 30
    - op: replace
      path: /spec/analysis/stepWeight
      value: 5
Automatización de imágenes y ramas de promoción
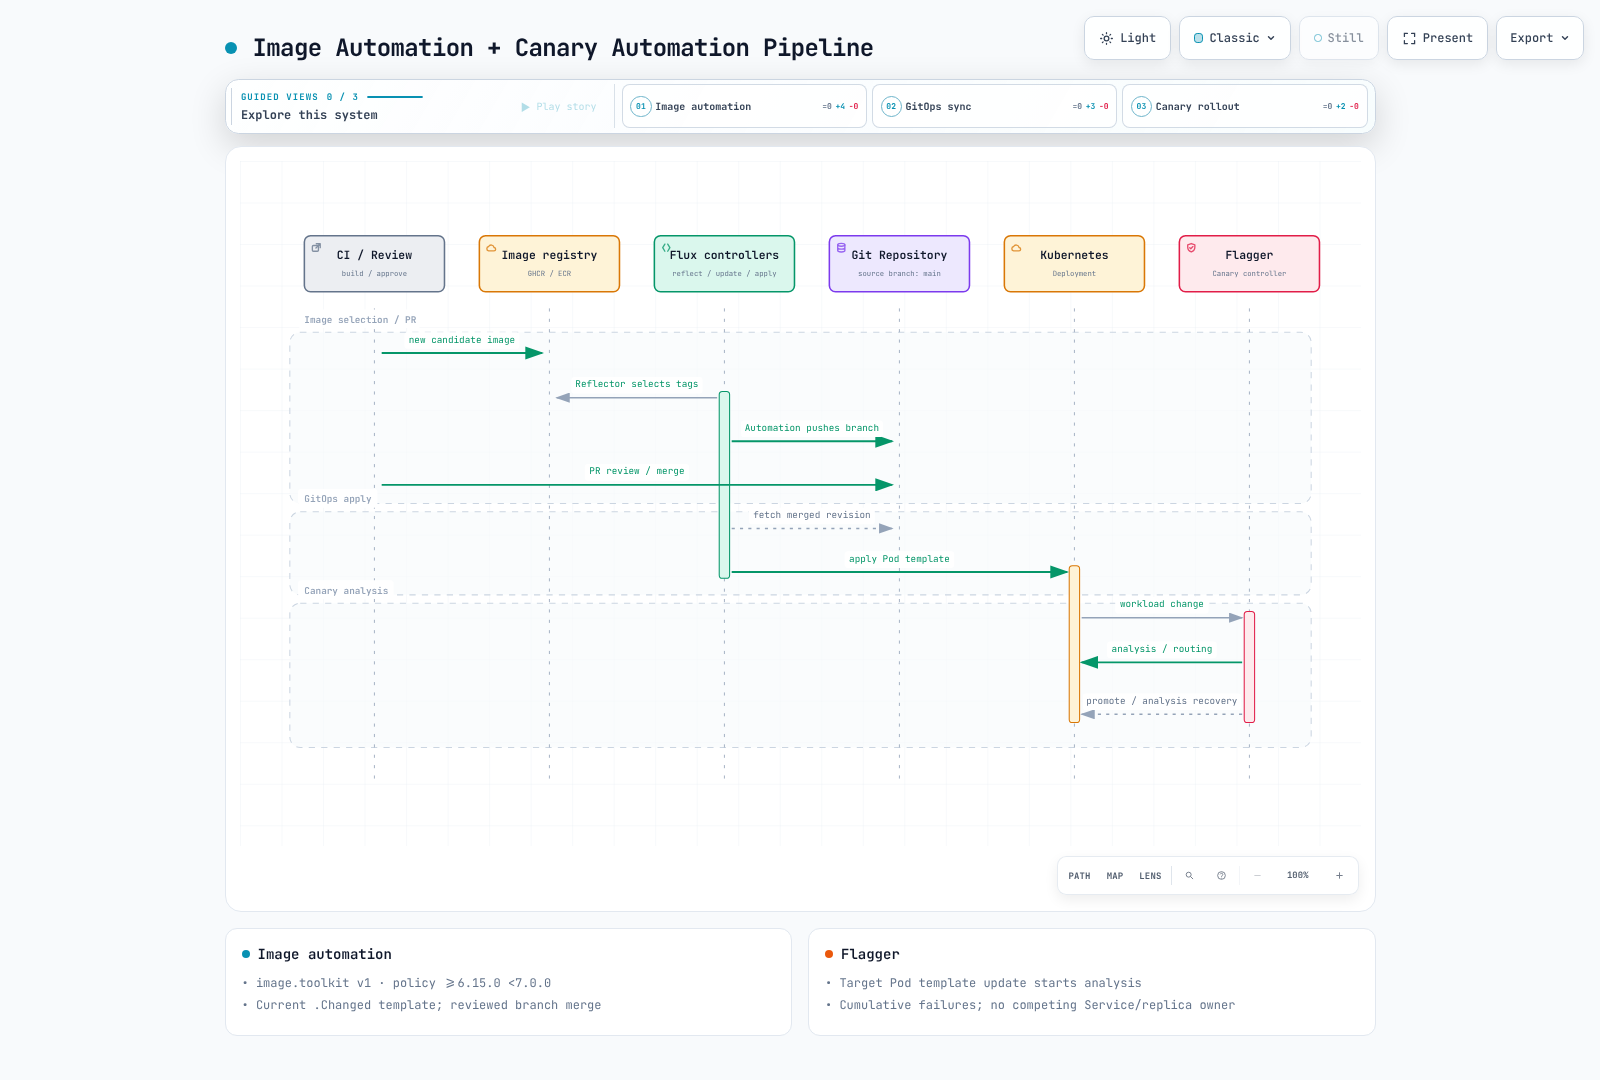
apiVersion: image.toolkit.fluxcd.io/v1
kind: ImageRepository
metadata:
  name: podinfo
  namespace: flux-system
spec:
  image: ghcr.io/stefanprodan/podinfo
  interval: 5m
---
apiVersion: image.toolkit.fluxcd.io/v1
kind: ImagePolicy
metadata:
  name: podinfo
  namespace: flux-system
  labels:
    app: podinfo
spec:
  imageRepositoryRef:
    name: podinfo
  policy:
    semver:
      range: '>=6.15.0 <7.0.0'
  digestReflectionPolicy: IfNotPresent
---
apiVersion: image.toolkit.fluxcd.io/v1
kind: ImageUpdateAutomation
metadata:
  name: podinfo
  namespace: flux-system
spec:
  interval: 5m
  sourceRef:
    kind: GitRepository
    name: flux-system
  policySelector:
    matchLabels:
      app: podinfo
  git:
    checkout:
      ref:
        branch: main
    commit:
      author:
        name: Flux
        email: flux@example.com
      messageTemplate: |-
        Update podinfo image
        {{ range .Changed.Changes }}{{ .OldValue }} -> {{ .NewValue }}
        {{ end }}
    push:
      branch: flux/podinfo-updates
  update:
    path: ./apps/podinfo
    strategy: Setters
Esto requiere controladores image-reflector/image-automation, marcadores de política y acceso de escritura a Git. Inserta cambios en una rama dedicada, por lo que la creación/comprobaciones/fusión de PR son independientes. Adapte repositorio/rutas y reserve la rama para automatización. Use el modelo actual de plantilla de commit .Changed, no un campo .NewTag inexistente.
# Native Deployment Pod-template fragment.
spec:
  template:
    spec:
      containers:
      - name: podinfo
image: ghcr.io/stefanprodan/podinfo:6.15.0 # {"$imagepolicy": "flux-system:podinfo"}# Alternative: merge into HelmRelease.spec.values.
image:
repository: ghcr.io/stefanprodan/podinfo
tag: "6.15.0" # {"$imagepolicy": "flux-system:podinfo:tag"}Un marcador solo de tag no fija un digest. Verifique la compatibilidad de digest del chart o la inmutabilidad y validación de etiquetas del registro. No sobrescriba una imagen de forma inconsistente mediante Kustomize images y un marcador de Deployment. ECR necesita autenticación AWS independiente de image-reflector y autorización real para extraer imágenes de Pod.
Observabilidad y alertas
Las métricas de Flagger y las métricas de Istio/aplicación son destinos de recopilación diferentes. Las anotaciones no hacen que cada instalación de Prometheus recopile automáticamente. Para Prometheus Operator, alinee el serviceMonitor.enabled del chart con los selectores, namespaces y acceso mTLS reales.
serviceMonitor:
  enabled: true
  labels:
    release: prometheus
La etiqueta release es ilustrativa y debe coincidir con el serviceMonitorSelector de Prometheus. Los CRD del Operator instalados son un requisito previo.
| Métrica | Tipo/significado real |
|---|---|
| flagger_info | Gauge, versión/mesh_provider |
| flagger_canary_total | Gauge, conteo de objetos Canary por namespace |
| flagger_canary_status | Gauge, 0=Progressing, 2=Failed, otras fases se asignan a 1 |
| flagger_canary_weight | Gauge, peso de tráfico por carga de trabajo/namespace |
| flagger_canary_metric_analysis | Gauge, valor de métrica real, no un booleano genérico de éxito/fallo |
| flagger_canary_duration_seconds | Histogram, tiempo de procesamiento de reconciliación de análisis, no duración total de rollout |
| flagger_canary_successes_total / failures_total | Counter, resultados con etiquetas strategy/analysis_status |
No infiera Succeeded del valor de estado 1; las fases de aprobación/promoción y otras pueden compartirlo. Compruebe Canary.status.phase y la revisión prevista. La etiqueta name es targetRef.name, no necesariamente el nombre del objeto Canary. Weight usa workload en lugar de name. Lea status.iterations en vez de asumir que existe una métrica iterations exportada.
Dashboard de Grafana
Use las siguientes consultas en paneles actuales Stat/Time series de Grafana. Filtre una etiqueta externa de cluster al agregar centralmente. Flagger clusterName afecta a las alertas; no añade automáticamente una etiqueta de cluster a las métricas de Prometheus.
flagger_canary_status{namespace="flagger-demo"}
flagger_canary_weight{namespace="flagger-demo",workload="podinfo"}
flagger_canary_metric_analysis{namespace="flagger-demo",name="podinfo",metric="request-success-rate"}
increase(flagger_canary_successes_total{namespace="flagger-demo",analysis_status="completed"}[7d])
increase(flagger_canary_failures_total{namespace="flagger-demo",analysis_status="completed"}[7d])
El JSON del dashboard oficial de Istio es una referencia; valide sus nombres de datasource y la compatibilidad de panel/esquema en Grafana actual, y luego expórtelo. El JSON de dashboard no es un manifiesto de Kubernetes. Aprovisione el modelo de dashboard exportado, no un sobre de API HTTP {"dashboard": ...}.
curl -fsSL -o flagger-istio-reference.json \
  https://raw.githubusercontent.com/fluxcd/flagger/v1.45.0/charts/grafana/dashboards/istio.json
# After reviewing/exporting flagger-dashboard.json in Grafana:
jq -e '.title and (.panels | type == "array")' flagger-dashboard.json >/dev/null
kubectl create configmap flagger-dashboard -n monitoring \
  --from-file=flagger-dashboard.json=./flagger-dashboard.json \
  --dry-run=client -o yaml > flagger-dashboard-cm.yaml
kubectl label --local -f flagger-dashboard-cm.yaml grafana_dashboard=1 \
  -o yaml > flagger-dashboard-ready.yaml
Revise el ConfigMap generado y colóquelo bajo GitOps. Configure el sidecar/provisioner de Grafana para que observe su etiqueta y namespace. No se base en un ID de dashboard no verificado como guía de instalación.
Alertas de Prometheus
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: flagger-alerts
  namespace: monitoring
spec:
  groups:
  - name: flagger
    rules:
    - alert: FlaggerAnalysisFailed
      expr: flagger_canary_status == 2
      for: 1m
      labels:
        severity: warning
      annotations:
        summary: Flagger analysis failed for {{ $labels.namespace }}/{{ $labels.name }}
        description: Inspect Canary phase, events, and actual routing before assuming the old primary is serving
          traffic.
    - alert: FlaggerAnalysisLongRunning
      expr: flagger_canary_status == 0
      for: 1h
      labels:
        severity: warning
      annotations:
        summary: Flagger analysis remains active for {{ $labels.namespace }}/{{ $labels.name }}
        description: Check approval gates, failed checks and workload readiness; this is not a measurement of rollout
          duration.
Estas reglas presuponen un Prometheus local del cluster. La condición ==0 con for:1h mide una condición Progressing observada continuamente, no cada fase activa ni una marca de tiempo de inicio de rollout. Evalúe por separado las esperas intencionales de puertas. Los buckets de Histogram representan tiempos cortos de procesamiento de reconciliación; no use una alerta de P99 de rollout con time()-duration o 600 segundos.
Slack, Teams y notificaciones externas
apiVersion: flagger.app/v1beta1
kind: AlertProvider
metadata:
  name: slack
  namespace: flagger-demo
spec:
  type: slack
  channel: C0123456789
  username: flagger
  secretRef:
    name: slack-bot
---
apiVersion: v1
kind: Secret
metadata:
  name: slack-bot
  namespace: flagger-demo
type: Opaque
stringData:
  address: https://slack.com/api/chat.postMessage
  token: REPLACE_WITH_SLACK_BOT_TOKEN
---
spec:
  analysis:
    alerts:
    - name: deployment-alerts
      severity: info
      providerRef:
        name: slack
Los valores de Secret son marcadores de posición; mantenga los tokens reales fuera de Git. AlertProvider secretRef requiere address en esta versión, más token para Slack Bot API. Configure chat:write y la pertenencia al canal, y reemplace el canal por el ID real. Para Incoming Webhooks, verifique el canal vinculado y las anulaciones permitidas.
Severity es un nivel mínimo, no enrutamiento exclusivo: info recibe todos los niveles, warn recibe warn/error y error recibe errores. Las suscripciones duplicadas pueden duplicar notificaciones.
El msteams nativo de Flagger 1.45.0 aún emite MessageCard. No suponga que basta intercambiar su URL por un endpoint de Workflows Adaptive Card. Configure un convertidor compatible o receptor de eventos con autenticación y conversión de carga útil. Esto difiere del comportamiento de Teams de Flux 2.9.6.
No suponga un AlertProvider nativo de PagerDuty Events API. Enviar type: slack directamente a una URL de PagerDuty genera una carga útil incorrecta. Use una integración de Slack establecida o un adaptador de eventos verificado.
Historial y eventos de despliegue
spec:
  analysis:
    webhooks:
    - name: deployment-events
      type: event
      url: http://deployment-events.flagger-system.svc.cluster.local/events
      timeout: 5s
      metadata:
        environment: demo
Deployment-events es un receptor interno que debe proporcionar por separado. Valide/almacene name/namespace/phase/checksum y eventMessage/eventType/timestamp. Post-rollout se ejecuta para éxito y fallo; no registre siempre como promovido. Flux Notification Alert eventSources no admite Canary ni recopila automáticamente eventos arbitrarios de Kubernetes.
kubectl get events -n flagger-demo \
  --field-selector involvedObject.kind=Canary,involvedObject.name=podinfo \
  --sort-by='.lastTimestamp'
kubectl get canaries -A -o custom-columns=\
NAME:.metadata.name,NAMESPACE:.metadata.namespace,PHASE:.status.phase,WEIGHT:.status.canaryWeight,LAST:.status.lastTransitionTime
Los eventos de Kubernetes tienen límites de retención; conserve el historial duradero externamente. changes(status[7d]) cuenta transiciones, no despliegues. Interprete los contadores de resultados considerando skipped/completed y las revisiones reales.
Prácticas recomendadas para producción
Comience con cargas de trabajo no críticas/de laboratorio y pruebe éxito, fallo, datos ausentes, espera de aprobación y fallo de promoción de primary. Un umbral de fallo mayor puede retrasar el rollback en lugar de mejorar la seguridad. Un stepWeight mayor expone a más usuarios; intervalos de análisis más largos pueden retrasar la detección.
| Decisión | Evidencia |
|---|---|
| Límites de error/latencia | SLO de Service, unidades reales y distribución normal |
| Solicitudes mínimas / ventana de consulta | Bajo tráfico, retraso de ingesta, tamaño de muestra |
| Umbral de fallo | Tiempo de exposición permitido y falsas alarmas |
| Pasos de peso | Radio de impacto y réplicas/nodos de reserva |
| Fecha límite de progreso | Inicio de Pod, disponibilidad, progreso de rolling-update |
| Aprobación / rollback | Autenticación, identidad de revisión, procedimiento de recuperación |
No derive 99.9 %, 200 ms o duraciones exactas de rollout únicamente de etiquetas de entorno/industria. Mida, ajuste y verifique regularmente el comportamiento de fallo/recuperación.
Seguimiento de configuración y escalado automático
El seguimiento de ConfigMap/Secret está habilitado de forma predeterminada y los cambios de configuración referenciada pueden activar análisis. Excluya un ConfigMap/Secret seleccionado con esta anotación en dicho recurso. También es posible configTracking.enabled=false globalmente, pero revise su efecto en la detección y las copias de configuración de primary.
metadata:
  annotations:
    flagger.app/config-tracking: disabled
Los escaladores HPA/KEDA compatibles necesitan el autoscalerRef correcto y Metrics Server/proveedor de métricas. Verifique que Flux/Helm no sobrescriba continuamente el control de escalado/Service de Flagger. Los PDB principalmente regulan desalojos voluntarios, no protección garantizada frente a reducción de escala del controlador o actualizaciones continuas de Deployment. Configure por separado la estrategia de rollout y la disponibilidad de la carga de trabajo.
Flagger multicluster
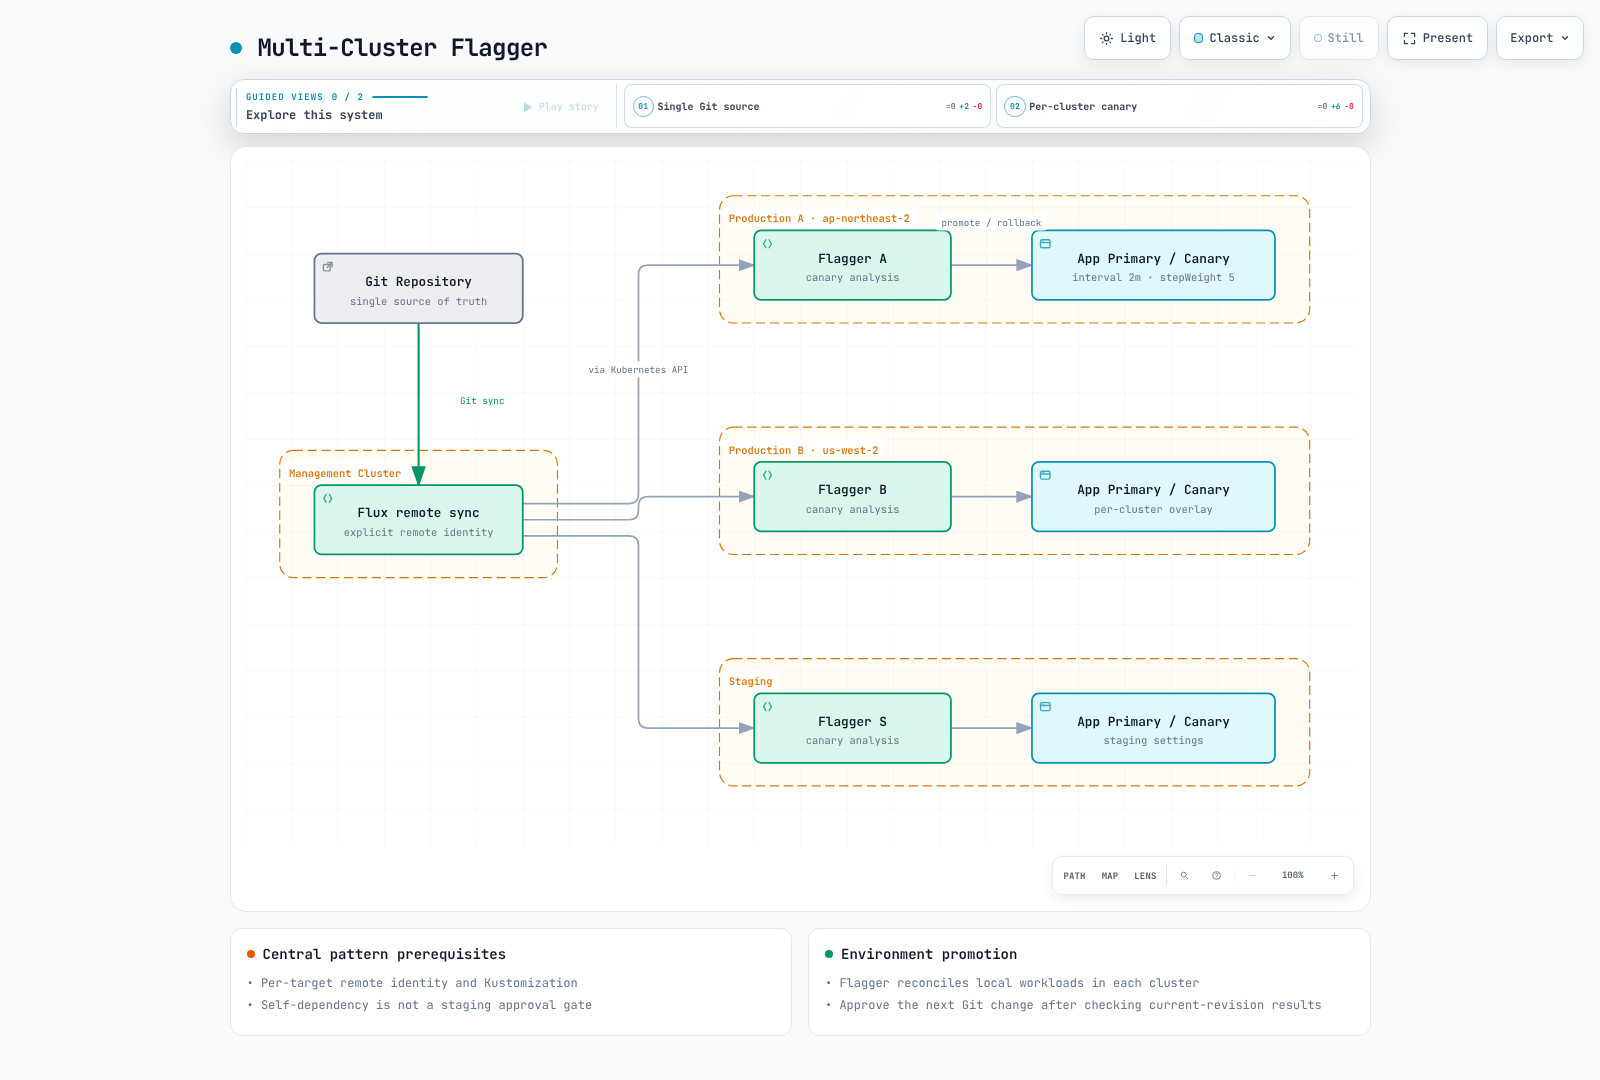
Inicie Flux por cluster con rutas de Git distintas, o configure Flux central con kubeConfig/identidad de carga de trabajo explícitos para la reconciliación remota. Compartir un repositorio Git no concede acceso remoto. Flagger controla las cargas de trabajo localmente en cada cluster.
apiVersion: kustomize.toolkit.fluxcd.io/v1
kind: Kustomization
metadata:
  name: podinfo-production-a
  namespace: flux-system
spec:
  interval: 10m
  targetNamespace: flagger-demo
  sourceRef:
    kind: GitRepository
    name: flux-system
  path: ./apps/podinfo/overlays/production-a
  prune: true
Este objeto se ejecuta en Flux del cluster de destino. No haga que dependa de sí mismo ni espere que dependsOn encuentre un objeto con el mismo nombre en un cluster independiente. Incluso Kustomizations remotas distintas en un plano de control no hacen automáticamente que Ready demuestre la promoción de la revisión actual; establezca como puerta para el cambio de Git del siguiente entorno los resultados reales del lanzamiento.
Configure etiquetas de cluster y retención para la observabilidad centralizada. Las alertas/MetricTemplates con namespace por sí solas no completan el aislamiento de tenants; restrinja también RBAC, referencias entre namespaces, redes y acceso a Secret.
Referencias
- Código fuente de Flagger 1.45.0
- Estrategias de despliegue
- Contrato de Webhook
- Registrador real de métricas
- Comportamiento de programador / rollback
- Ejemplos de Gateway API
- Fin de soporte de AWS App Mesh
- Interrupciones / PDB de Kubernetes
- FluxCD
- Gestión de tráfico de Argo Rollouts
Anterior: Comparación de GitOps · Siguiente: Feature Flags · Descripción general
Cuestionario
Compruebe sus conocimientos con el cuestionario de Flagger.