Entrenamiento de modelos en EKS
Última actualización: September 12, 2026 Líneas base: Slinky1.2.2, MPI Operator0.8.2, Volcano1.15.2, PyTorch2.14.0, Neuron SDK2.32.0
El entrenamiento distribuido requiere código de modelo compatible, particionado de datos (data sharding), lanzadores, asignación de dispositivos, comunicación y checkpoints. Un manifiesto válido o un Pod en estado Running no demuestra que el entrenamiento o la recuperación funcionen.
Para QLoRA en una sola GPU y la comparación entre SageMaker AI y EKS, consulte la guía de Qwen, incluidas sus restricciones de ejecución y el ciclo de vida de soporte de la imagen.
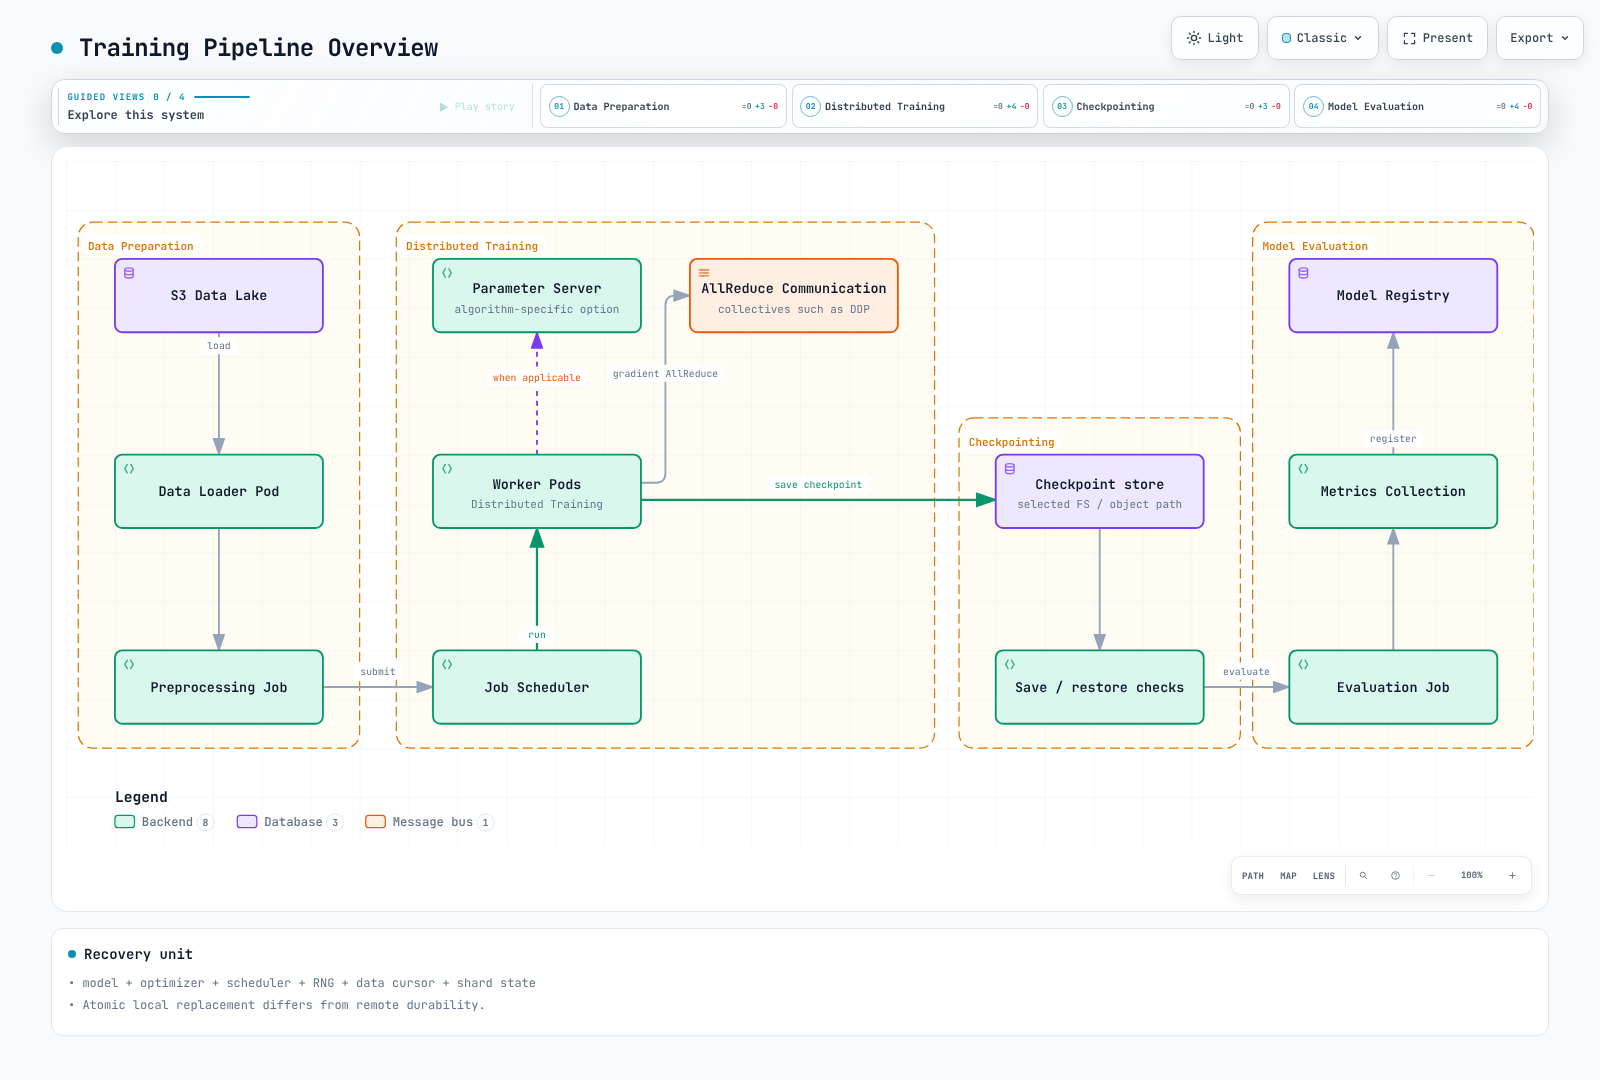
Pipeline de entrenamiento
Estrategias de entrenamiento distribuido
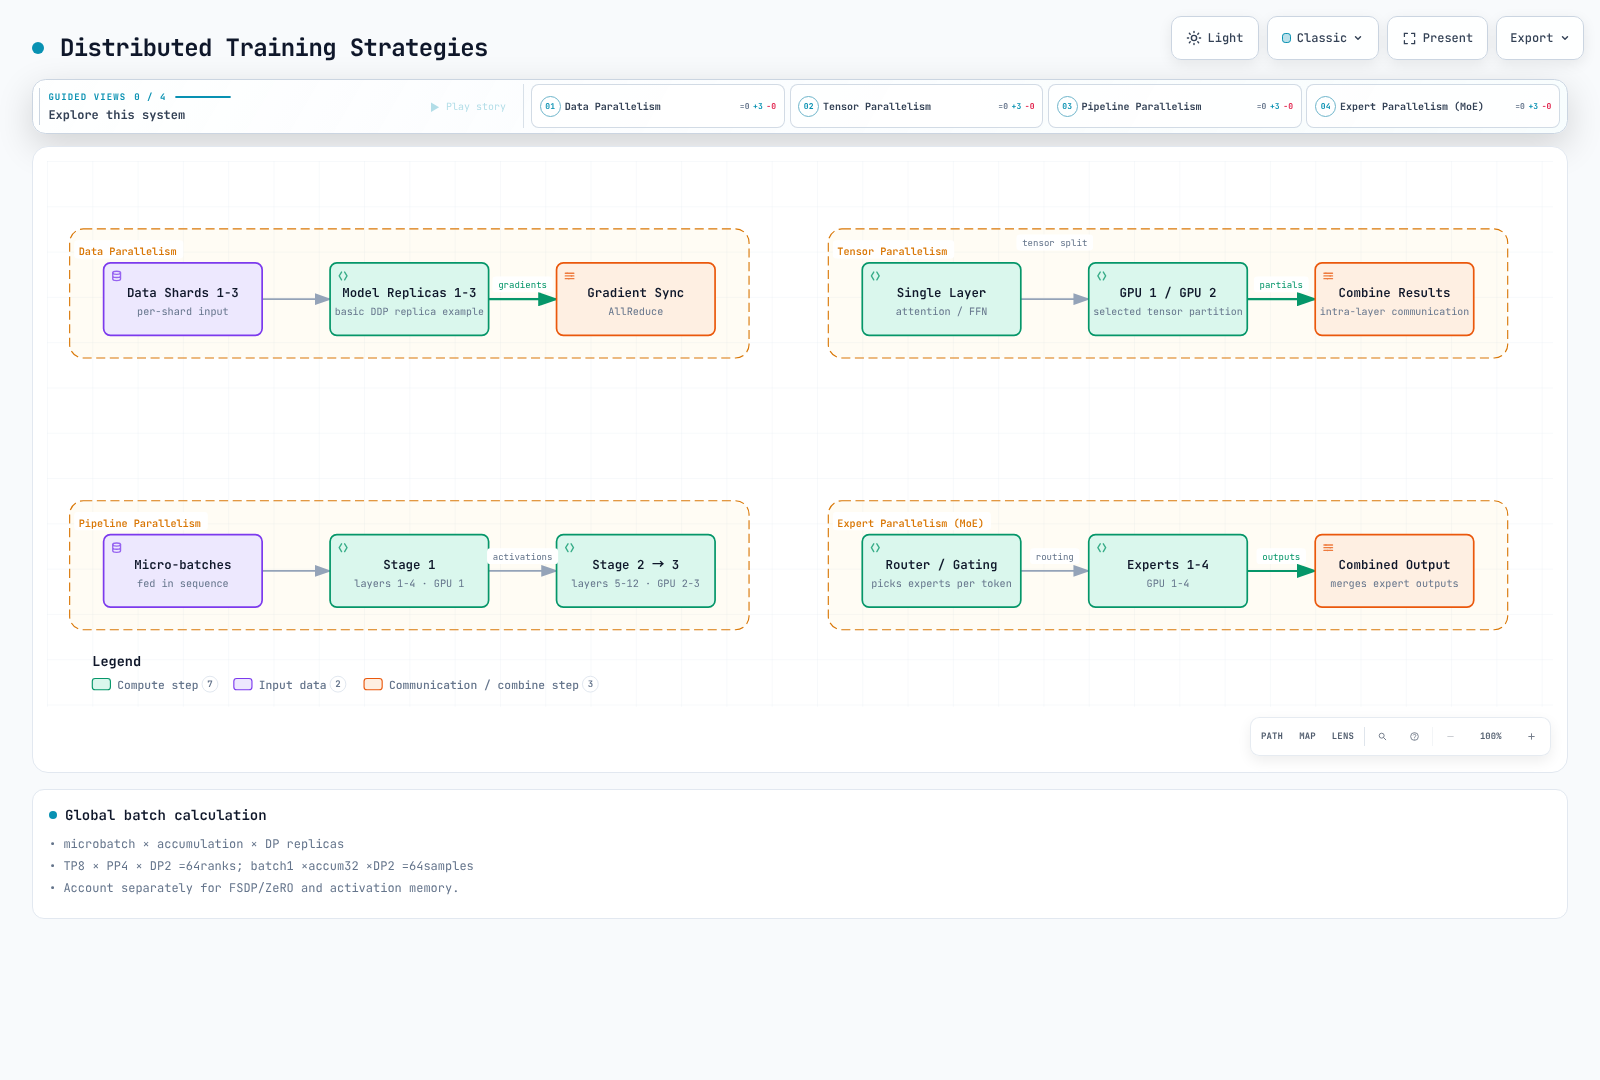
| Estrategia | Unidad particionada | Restricciones que validar |
|---|---|---|
| DDP | Distintos lotes de datos; réplicas del modelo | Memoria de estado de entrenamiento/activaciones y sincronización de gradientes |
| FSDP / ZeRO | Parámetros, gradientes y estados del optimizador | Comunicación y formatos de checkpoint específicos de cada etapa |
| TP | Operaciones tensoriales dentro de las capas | Dimensiones de heads/hidden, backend y topología |
| PP | Etapas de capas | Microlotes, burbujas de pipeline y transferencia de activaciones |
| Paralelismo de expertos | Expertos MoE y despacho de tokens | Desbalanceo, all-to-all y capacidad de enrutamiento |
| Combinaciones | Grupos DP/TP/PP/contexto/expertos | Malla de dispositivos soportada y número total de ranks |
No suponga que3D siempre es lo mejor por encima de100B parámetros. Considere la memoria del optimizador, los gradientes, las activaciones y la comunicación más allá de los pesos, y luego compare el rendimiento (throughput) y el costo de recuperación. El all-reduce de DDP no requiere un parameter server.
TP8×PP4×DP2 significa64ranks. El lote global es microlote × acumulación × réplicas DP:1×32×2=64, no2048 que resultaría de multiplicar de nuevo todos los ranks de TP/PP. Con empaquetado de longitud variable, lleve la cuenta de muestras y tokens por separado.
Slurm y Slinky
El repositorio oficial es SlinkyProject/slurm-operator. Se verificaron la etiqueta1.2.2 y sus charts OCI; GitHub releases/latest devolvió404, por lo que no se describe como la última release de GitHub. La documentación de1.2 indica como mínimo Kubernetes1.29 y Slurm25.11(data parser0.0.44). La compatibilidad mínima no es una garantía de ciclo de vida de soporte operativo.
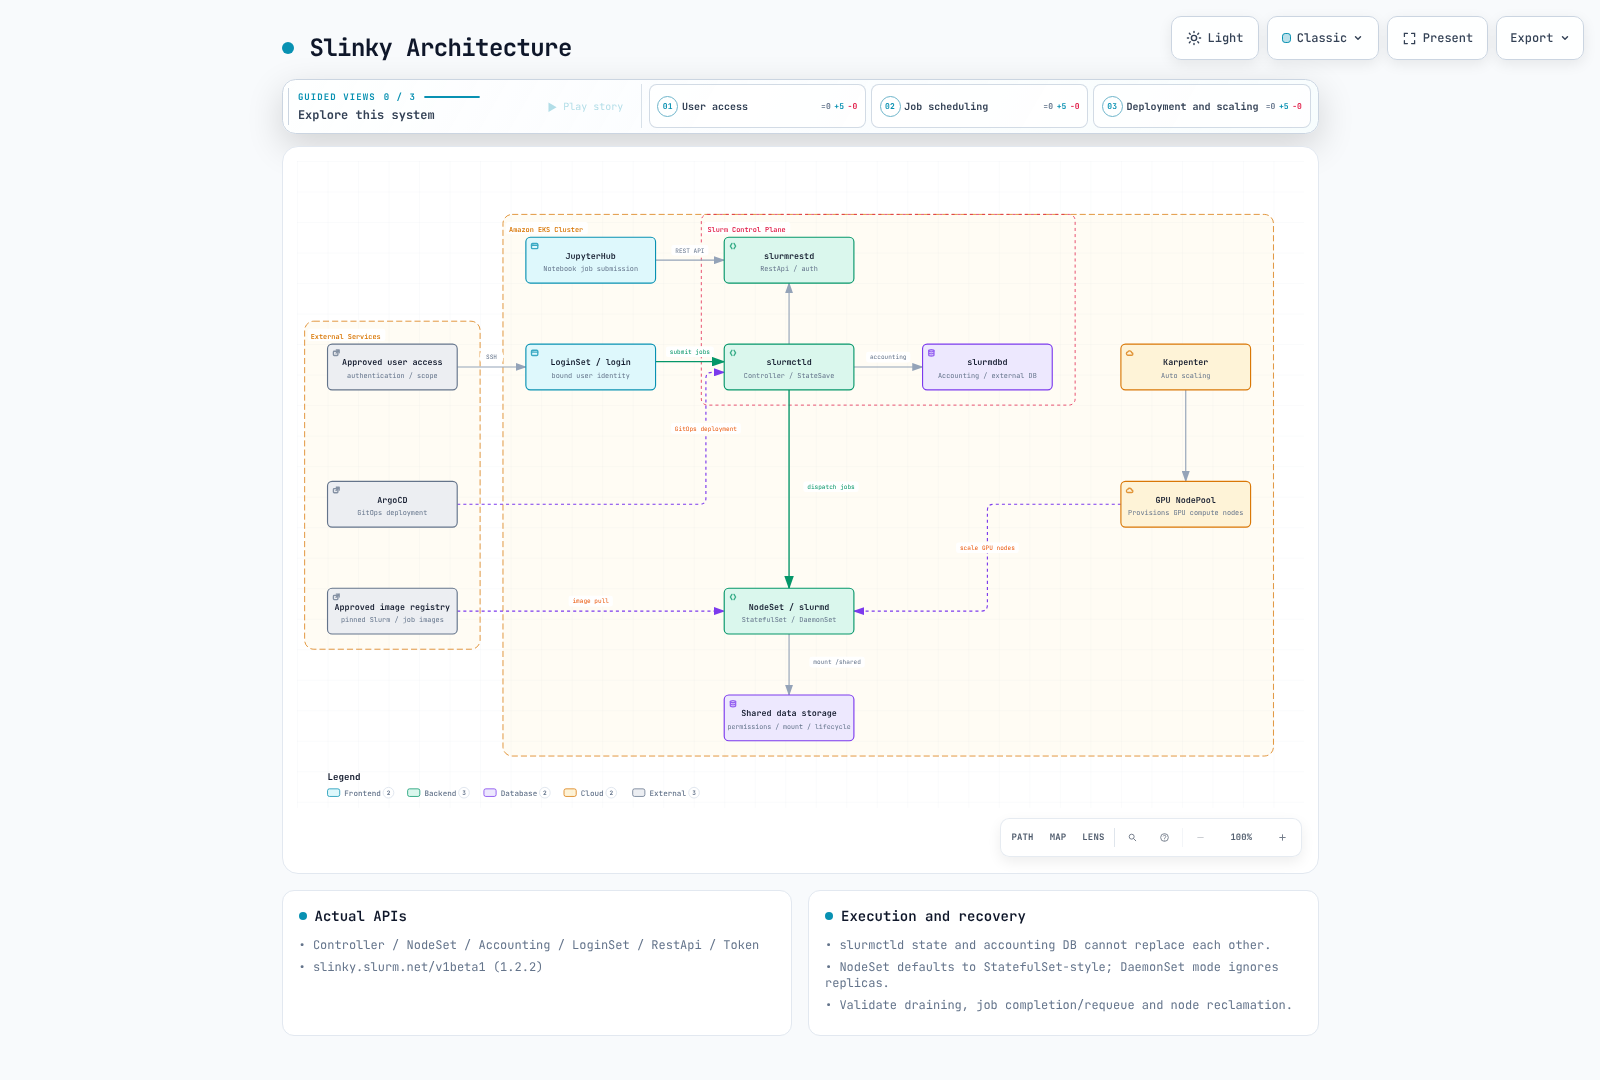
APIs reales y ciclo de vida
La versión1.2.2 define Controller, NodeSet, Accounting, LoginSet, RestApi y Token en slinky.slurm.net/v1beta1. Los antiguos ejemplos de SlurmCluster/SlurmNodeSet no corresponden a esta API. NodeSet usa un controllerRef y una plantilla de Pod. Su scalingMode predeterminado se comporta como un StatefulSet; el modo DaemonSet crea un Pod por cada nodo de Kubernetes coincidente e ignora replicas. Estos son modos del controlador NodeSet, no una prueba de que slurmd siempre se ejecute como un recurso DaemonSet de Kubernetes.
slurmctld gestiona el estado y la planificación de jobs/nodos/particiones; conserve su StateSaveLocation. slurmdbd se encarga del acceso a la base de datos de accounting y de los registros, y no sustituye el estado del controlador. Diseñe de forma conjunta las identidades de login/REST/jobs, los permisos del sistema de archivos, las claves de Slurm/JWT y la entrega/rotación de credenciales de la base de datos. La exposición pública de SSH mediante un NLB no es un prerrequisito predeterminado.
Renderice primero los charts reales. Estos comandos solo generan archivos locales. Un despliegue operativo requiere además el orden correcto de cert-manager/CRD/operator/Slurm, persistencia/base de datos, identidad de usuario e imágenes de Slurm compatibles.
helm template slurm-api oci://ghcr.io/slinkyproject/charts/slurm-operator-crds   --version 1.2.2 > slurm-crds.yaml
helm template slurm-control oci://ghcr.io/slinkyproject/charts/slurm-operator   --version 1.2.2 --namespace slinky > slurm-operator.yaml
helm template slurm-example oci://ghcr.io/slinkyproject/charts/slurm   --version 1.2.2 --namespace slurm   --set-json 'nodesets={"cpu-example":{}}'   --set partitions.all.enabled=true > slurm-example.yaml
Una Application de Argo CD debe referenciar una ruta/revisión de chart real y valores reales. Ajustes inventados como compute.partitions/efa.enabled no la configuran. Revise el pruning, la eliminación de CRD/PVC, el draining/requeue de Slurm y los timeouts de terminación de jobs. El scale-in de NodeSet y la terminación de EC2 son bucles de control independientes.
Lanzar torchrun desde Slurm
Ejecute un lanzador torchrun por nodo y deje que este cree un proceso por GPU. Las ocho tareas de Slurm anteriores lanzaban ocho procesos cada una, produciendo64procesos por nodo. Este ejemplo pretende4nodos×8procesos; en esta auditoría no se ejecutó ninguna asignación real de Slurm/GPU.
#!/bin/bash
#SBATCH --job-name=distributed-training
#SBATCH --nodes=4
#SBATCH --ntasks-per-node=1
#SBATCH --gpus-per-node=8
#SBATCH --cpus-per-task=16
#SBATCH --time=01:00:00
set -euo pipefail

: "${SLURM_NNODES:?Run within an approved Slurm allocation}"
: "${SLURM_JOB_ID:?}"
: "${SLURM_JOB_NODELIST:?}"
export MASTER_ADDR
MASTER_ADDR=$(scontrol show hostnames "$SLURM_JOB_NODELIST" | head -n 1)
export MASTER_PORT=29500

# One torchrun launcher per Slurm node, eight training processes per launcher.
# train.py, dependencies, data, credentials and checkpoints must be prepared.
srun --ntasks="$SLURM_NNODES" --ntasks-per-node=1 bash -c '
  exec torchrun \
    --nnodes="$SLURM_NNODES" \
    --nproc-per-node=8 \
    --node-rank="$SLURM_PROCID" \
    --rdzv-id="$SLURM_JOB_ID" \
    --rdzv-backend=c10d \
    --rdzv-endpoint="$MASTER_ADDR:$MASTER_PORT" \
    /workspace/train.py
'
Si Slurm restringe la visibilidad de GPU por tarea, asegúrese de que cada lanzador reciba las ocho GPU previstas. train.py debe implementar LOCAL_RANK/RANK/WORLD_SIZE, el binding de dispositivos, DDP/sampler, datos/modelos versionados y la reanudación. El fixture de shell verificó cuatro lanzadores, ranks de nodo distintos y un endpoint de rendezvous común.
Comunicación entre GPU y EFA
FI_PROVIDER=efa selecciona un proveedor de libfabric; no instala EFA, no adjunta interfaces ni realiza la integración con NCCL. Valide de forma conjunta las instancias compatibles con EFA, el driver/libfabric, aws-ofi-nccl, el device plugin y la asignación al Pod, los security groups y el transporte real. RAID0 o una etiqueta de subred no habilitan EFA.
Los nodos que se comunican deben compartir la misma AZ; se recomienda un cluster placement group por rendimiento. Asegúrese de que los Pods de entrenamiento usen realmente el NodePool restringido. El ancho de banda y el número de dispositivos EFA varían según la instancia;400Gbps no es universal. Forzar a ciegas los ajustes antiguos Ring/Simple, IB_DISABLE, SOCKET_IFNAME o FI_EFA_USE_DEVICE_RDMA puede interferir con los plugins actuales. Verifique la documentación de la release, los logs y las pruebas de colectivos.
budgets.nodes=0 en Karpenter restringe las vías de disrupción voluntaria; no evita la reclamación de Spot, el fallo de un nodo, la terminación forzada ni todos los casos de expiración. Revise la interacción de do-not-disrupt/PDB con terminationGracePeriod/expireAfter y preserve la recuperación desde checkpoints. Evite descargar instaladores de driver flotantes en cada bootstrap o fijar de forma rígida las frecuencias de GPU entre distintos tipos de dispositivo.
BioNeMo
La versión3.0.0 inspeccionada es BioNeMo Recipes, que proporciona modelos/checkpoints basados en TransformerEngine y recetas para PyTorch, Accelerate y Lightning. Compruebe el soporte específico de cada receta para ESM-2, AMPLIFY, Geneformer y otros. No ejecute un módulo MegaMolBART de BioNeMo1.5 como si fuera la API de3.0. La evaluación biológica y los permisos de modelos/datos siguen siendo requisitos aparte; la asignación de GPU por sí sola no prepara la receta.
Trainium y Neuron
Distinga entre las vías torch-neuronx del SDK2.32.0, NeuronX Distributed Training y sus implementaciones de modelos, y Optimum Neuron. El soporte de inferencia de transformers-neuronx no equivale a soporte general de entrenamiento. Compruebe las versiones de TensorFlow/JAX/PyTorch frente al hardware/SDK elegido en lugar de añadir paquetes pip arbitrarios a un DLC antiguo de2.18.
Optimum Neuron0.4.5 incluye NeuronTrainer/NeuronTrainingArguments e implementaciones de modelos de entrenamiento dedicadas para Neuron. Cargar un BertForPreTraining genérico y pasar variables de dataset/tokenizer no definidas no constituye un entrenamiento TP completo. Prepare el modelo/configuración soportados, las labels/collator, el tokenizer y sus revisiones, los formatos de optimizador/checkpoint y el lanzador. El PyTorch2.14 del ejemplo de CPU no afirma compatibilidad con el Neuron SDK.
Jobs multinodo y precompilación
Un parallelism=4 en un Job solo inicia cuatro Pods; no configura ranks ni rendezvous. Los Jobs indexados necesitan completionMode/index y un único endpoint master compartido. Fijar el MASTER_ADDR de cada Pod a su propio status.podIP hace que los workers apunten a masters distintos. Use una topología de coordinador/controlador y lanzadores soportados, y prepare train_lora.py, los datos, la caché de compilación y los dispositivos.
neuron_parallel_compile extrae/compila grafos; no sustituye al entrenamiento real. Ejecute el entrenamiento por separado después y verifique los aciertos de caché, las formas (shapes) y las revisiones del compilador/SDK. Consulte las distinciones de unidades de Neuron para cores frente a dispositivos.
Ray Train, MPI y Volcano
Use la guía de Train auditada con Ray2.58/KubeRay1.7. Haga coincidir el número de llamadas a report entre workers y reporte objetos Checkpoint reales. get_checkpoint() recupera el estado previo de recuperación; no es un context manager para un nuevo guardado. resources_per_worker con GPU8 no lanza automáticamente ocho procesos DDP dentro de un worker.
MPI Operator0.8.2 usa kubeflow.org/v2beta1. slotsPerWorker declara los slots del hostfile; no determina por sí solo el valor de mpirun -np, el mapping ni el binding de GPU. Prepare el código de Launcher/Worker, la implementación de MPI/SSH, imágenes soportadas y CRD/RBAC. Cuatro workers×ocho slots no garantiza por sí mismo32procesos GPU.
El minAvailable de Volcano1.15.2 cuenta Pods/miembros, no nodos EC2. Tres nodos suficientemente aprovisionados pueden alojar cuatro Pods. El plugin gang aplica condiciones de miembros/recursos mínimos, pero no garantiza el arranque simultáneo de los contenedores ni el éxito del entrenamiento. Revise los workers adicionales, el soporte de runtime elástico y el comportamiento de RestartJob/requeue.
Los perfiles de GPU de JupyterHub deben coincidir con las imágenes/etiquetas de dispositivo reales y con la autorización. g5.xlarge es A10G, no un perfil A100. Integre la configuración en el Hub en ejecución y configure el almacenamiento por usuario, las cuotas, la red y el idle culling.
Almacenamiento de entrenamiento y checkpoints
Use las vías CSI auditadas en la guía de GPU/almacenamiento. Montar un sistema de archivos FSx existente mediante un PV estático es distinto de crear uno nuevo con aprovisionamiento dinámico. No invente campos dataRepositoryAssociations de FileSystem ni mezcle SCRATCH_2 con ajustes de throughput exclusivos de sistemas persistentes. Verifique por separado las APIs de DRA/import/export, las políticas y su finalización.
Una solicitud de capacidad en un PVC de EFS no es una cuota de almacenamiento físico. Valide el UID/GID del access point, los permisos de directorio, la identidad CSI, la red y los mount targets. Un checkpoint local no es durable de forma remota hasta que se completa la transferencia a S3.
La recuperación necesita el modelo, el optimizador, el scheduler, el RNG, el scaler cuando se use, el cursor de datos/sampler y todos los estados particionados. Evite que varios ranks sobrescriban un mismo archivo; use el guardado distribuido propio del framework. Valide los manifiestos/checksums de finalización, la transferencia remota y la restauración antes de eliminar checkpoints válidos anteriores. Una imagen inventada de gestor de checkpoints o un ConfigMap con auto_resume=true no implementan estas funciones.
Ejemplo mínimo ejecutable en CPU
Este ejemplo sintético de16muestras y un solo hilo de CPU realiza cuatro actualizaciones del optimizador. Demuestra la acumulación, un schedule cosine acotado, el reemplazo mediante archivo temporal y la restauración del optimizador/RNG. PyTorch2.14.0+cpu produjo resultados idénticos en el entrenamiento sin interrupciones y al reanudar tras dos pasos. Esto no es una prueba de GPU, distribución ni durabilidad remota.
from pathlib import Path
import math
import os
import tempfile
import torch


def lr_factor(step, warmup_steps, total_steps, min_ratio=0.1):
    if not 0 <= warmup_steps < total_steps or not 0 <= min_ratio <= 1:
        raise ValueError("Invalid schedule bounds")
    if step < 0:
        raise ValueError("Step must be non-negative")
    if step < warmup_steps:
        return step / max(1, warmup_steps)
    progress = min(1.0, (step - warmup_steps) / (total_steps - warmup_steps))
    return min_ratio + (1 - min_ratio) * (1 + math.cos(math.pi * progress)) / 2


def save_checkpoint(path, state):
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(dir=path.parent, delete=False) as output:
            temporary = output.name
            torch.save(state, output)
            output.flush()
            os.fsync(output.fileno())
        os.replace(temporary, path)
    finally:
        if temporary is not None and os.path.exists(temporary):
            os.unlink(temporary)


def train_toy(checkpoint_path, stop_after=4, resume=False):
    # Tiny deterministic CPU example; no GPU, dataset or model download.
    torch.set_num_threads(1)
    torch.manual_seed(17)
    model = torch.nn.Linear(2, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9)
    scheduler = torch.optim.lr_scheduler.LambdaLR(
        optimizer, lambda step: lr_factor(step, 1, 4)
    )
    inputs = torch.arange(32, dtype=torch.float32).reshape(16, 2) / 32
    targets = inputs.sum(dim=1, keepdim=True)
    start = 0
    if resume:
        saved = torch.load(checkpoint_path, map_location="cpu", weights_only=True)
        model.load_state_dict(saved["model"])
        optimizer.load_state_dict(saved["optimizer"])
        scheduler.load_state_dict(saved["scheduler"])
        torch.set_rng_state(saved["torch_rng"])
        start = saved["optimizer_step"]
    if not start <= stop_after <= 4:
        raise ValueError("Invalid stopping point")
    for step in range(start, stop_after):
        optimizer.zero_grad(set_to_none=True)
        # Two equal-sized microbatches per optimizer update.
        for microbatch in range(2):
            offset = step * 4 + microbatch * 2
            prediction = model(inputs[offset:offset + 2])
            loss = torch.nn.functional.mse_loss(prediction, targets[offset:offset + 2]) / 2
            loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        scheduler.step()
        save_checkpoint(checkpoint_path, {
            "model": model.state_dict(),
            "optimizer": optimizer.state_dict(),
            "scheduler": scheduler.state_dict(),
            "optimizer_step": step + 1,
            "torch_rng": torch.get_rng_state(),
        })
    return {name: value.detach().clone() for name, value in model.state_dict().items()}


if __name__ == "__main__":
    path = Path("toy-training.pt")
    train_toy(path, stop_after=2)
    train_toy(path, stop_after=4, resume=True)
    print("Completed four CPU optimizer updates, including checkpoint resume.")
El ejemplo demuestra el reemplazo de archivos completados en un solo sistema de archivos, no la durabilidad frente a caídas del sistema de archivos o de los metadatos de directorio, ni transacciones de S3 ni protocolos de checkpoint distribuido. Su orden fijo de datos tampoco implementa una recuperación general del sampler. Elija los intervalos y la retención de checkpoints en función de la latencia de guardado, la tasa de fallos, el trabajo perdido aceptable y el costo, en lugar de una regla universal de500pasos y cinco copias.
Precisión numérica y optimización de memoria
Las APIs actuales de PyTorch usan torch.amp.autocast y torch.amp.GradScaler. BF16 comparte el número de bits de exponente de FP32, pero no su precisión de mantisa ni su valor finito máximo exacto. Habitualmente evita el loss scaling propio de FP16, pero verifique el hardware, las operaciones y la convergencia. Autocast no convierte todos los pesos ni el estado del optimizador a BF16.
El activation checkpointing recalcula las activaciones durante el backward, intercambiando cómputo por memoria. Es distinto de los checkpoints en disco y no garantiza ni un ahorro de3–4x ni una ralentización del30%. Especifique use_reentrant de forma explícita y valide los gradientes, el dropout/RNG y las capas con estado.
La selección del backend de Flash Attention/SDPA depende del dtype, el tamaño de head, el dispositivo y las máscaras. Defina el estado de entrenamiento y pase dropout_p=0 durante la evaluación. Compruebe el soporte de la API para combinaciones de máscaras explícitas/causales; use_cache=False por sí solo no instala un backend de atención.
En DeepSpeed0.19.6, ZeRO1 particiona el estado del optimizador;2 añade los gradientes;3 añade los parámetros. El offload a CPU/NVMe se configura por separado; la Stage3 no lo habilita automáticamente. Distinga las integraciones de nivel superior que reemplazan valores auto de la configuración pura de DeepSpeed. Los buffers, las activaciones y la capa más grande impiden una reducción ilimitada de memoria.
Avance los schedulers por actualizaciones del optimizador, no por micropasos de acumulación. Acote el progreso para que el cosine no vuelva a subir después del horizonte de entrenamiento, y valide los límites de warmup y de pasos totales como en el ejemplo.
Alcance de la verificación
Se revisaron toda la prosa de la guía y del quiz y76bloques de código originales únicos. Las comprobaciones abarcan los Helm/CRDs oficiales de Slinky, las APIs de MPI/Volcano y las fuentes del SDK, el entrenamiento/reanudación mínimos en CPU y un fixture de lanzador en shell. No se ejecutó ningún recurso de GPU/Neuron/EFA, cluster de Slurm/MPI, modelo preentrenado real ni recurso en la nube. La verificación local de código/esquemas es distinta de la validación de un despliegue en producción.
Referencias
- Slinky 1.2.2
- Controlador de Slurm
- Daemon de accounting de Slurm
- MPI Operator 0.8.2
- Plugin gang de Volcano 1.15.2
- Redes con EFA en EKS
- Recetas de BioNeMo 3.0.0
- Optimum Neuron 0.4.5
- Neuron SDK 2.32.0
- Lanzador de PyTorch 2.14
- Configuración de ZeRO en DeepSpeed 0.19.6