EKS でのモデル学習
最終更新: September 12, 2026 ベースライン: Slinky1.2.2, MPI Operator0.8.2, Volcano1.15.2, PyTorch2.14.0, Neuron SDK2.32.0
分散学習には、互換性のあるモデルコード、データシャーディング、ランチャー、デバイス割り当て、通信、チェックポイントが必要です。有効なマニフェストまたは Running Pod は、学習やリカバリーが機能する証明にはなりません。
単一 GPU QLoRA と SageMaker AI/EKS の比較については、イメージのサポートライフサイクルと実行上の制約を含む Qwen ガイドを参照してください。
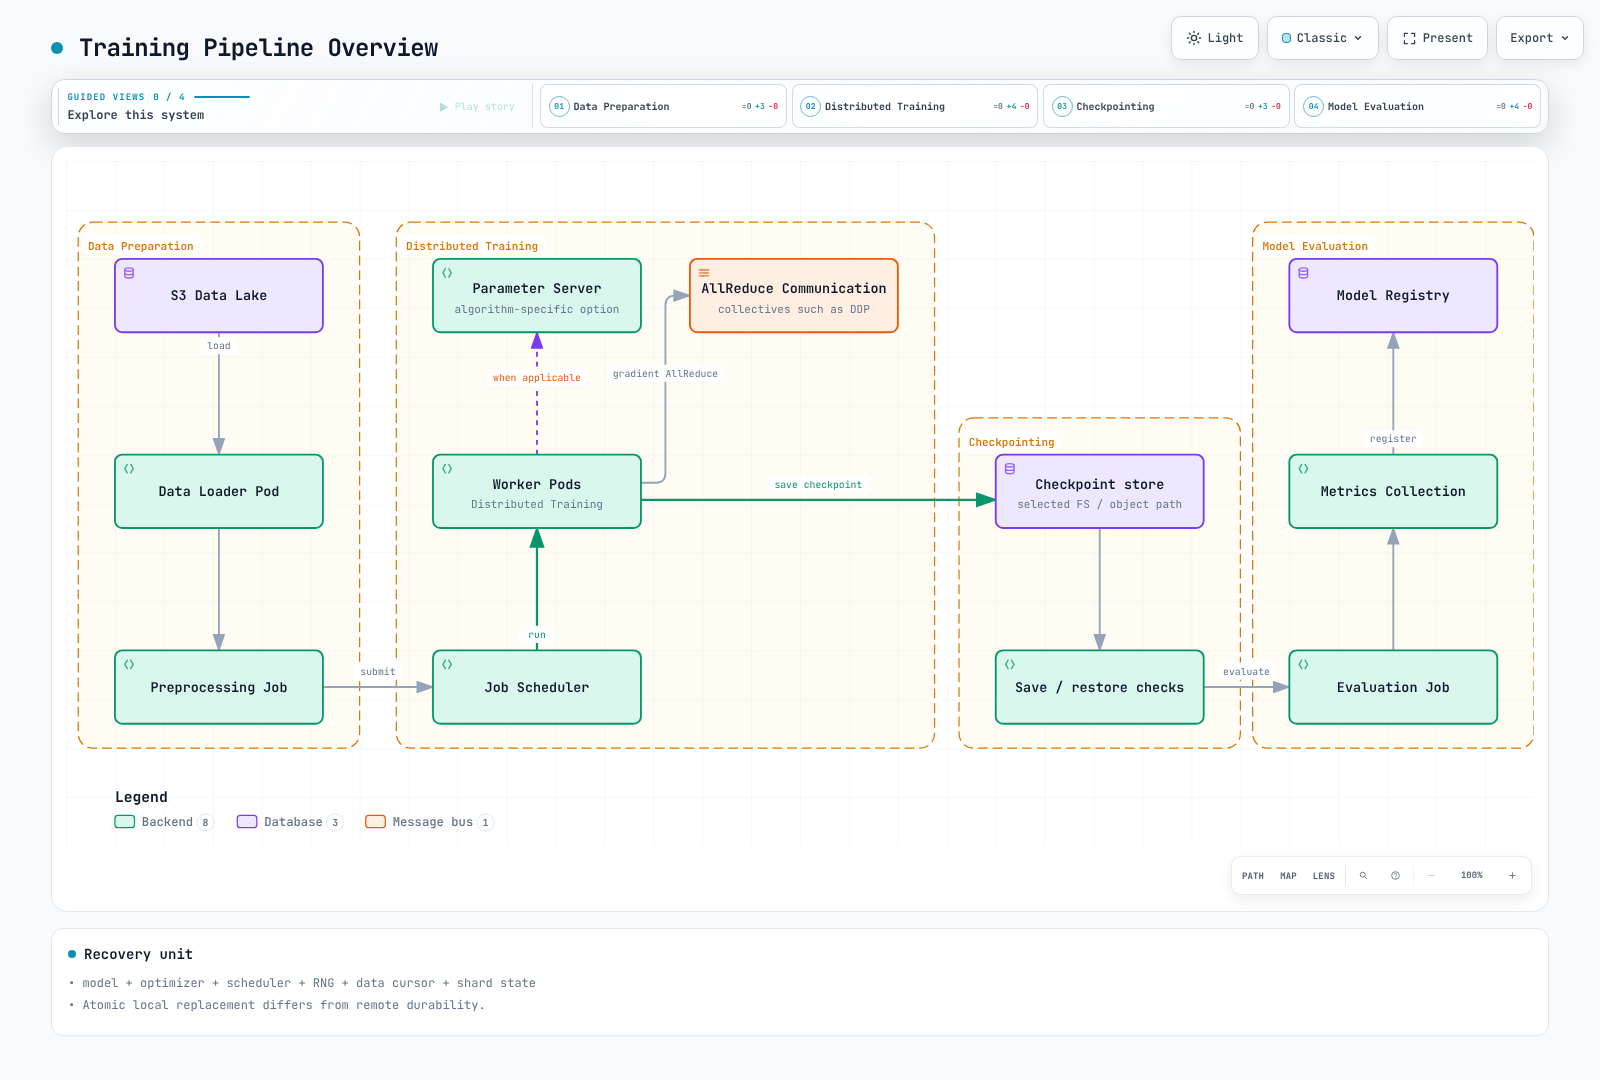
学習パイプライン
分散学習戦略
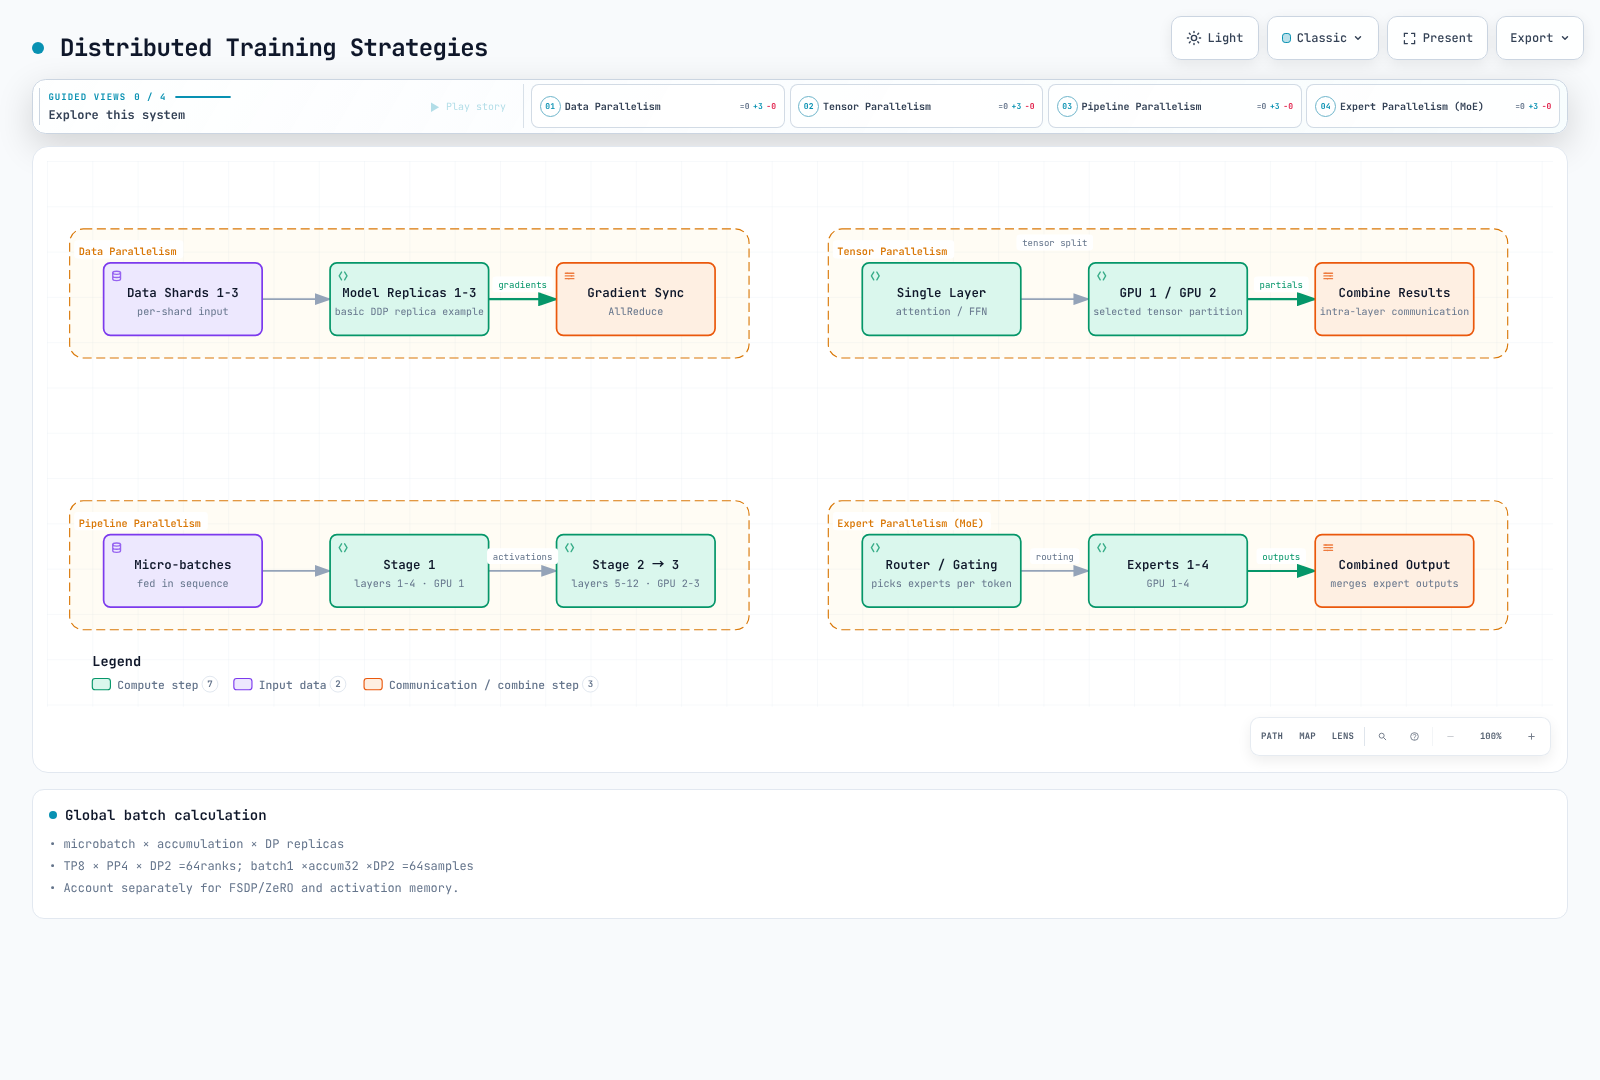
| 戦略 | 分割単位 | 検証すべき制約 |
|---|---|---|
| DDP | 異なるデータバッチ、モデルレプリカ | 学習状態/activation メモリと勾配同期 |
| FSDP / ZeRO | パラメータ、勾配、optimizer 状態 | ステージ固有の通信およびチェックポイント形式 |
| TP | レイヤー内のテンソル演算 | head/hidden 次元、backend、トポロジー |
| PP | レイヤーステージ | Microbatch、pipeline bubble、activation 転送 |
| Expert parallel | MoE expert とトークンディスパッチ | 不均衡、all-to-all、routing 容量 |
| 組み合わせ | DP/TP/PP/context/expert グループ | サポート対象のデバイスメッシュと総 rank 数 |
100B パラメータを超える場合に3Dが常に最適だと仮定しないでください。重み以外の optimizer、勾配、activation、通信のメモリを考慮してから、スループットとリカバリーコストを比較します。DDP all-reduce に parameter server は不要です。
TP8×PP4×DP2 は64rank を意味します。グローバルバッチは microbatch × accumulation × DP レプリカ、すなわち1×32×2=64です。すべての TP/PP rank を再度乗算して2048にはなりません。可変長パッキングでは、サンプル数とトークン数を別々に追跡してください。
Slurm と Slinky
公式リポジトリは SlinkyProject/slurm-operator です。Tag1.2.2 とその OCI chart は検証済みです。GitHub releases/latest は404を返したため、最新の GitHub リリースとは記載していません。1.2 ドキュメントには最小 Kubernetes1.29 および Slurm25.11(data parser0.0.44)が記載されています。最小互換性は、運用サポートライフサイクルの保証ではありません。
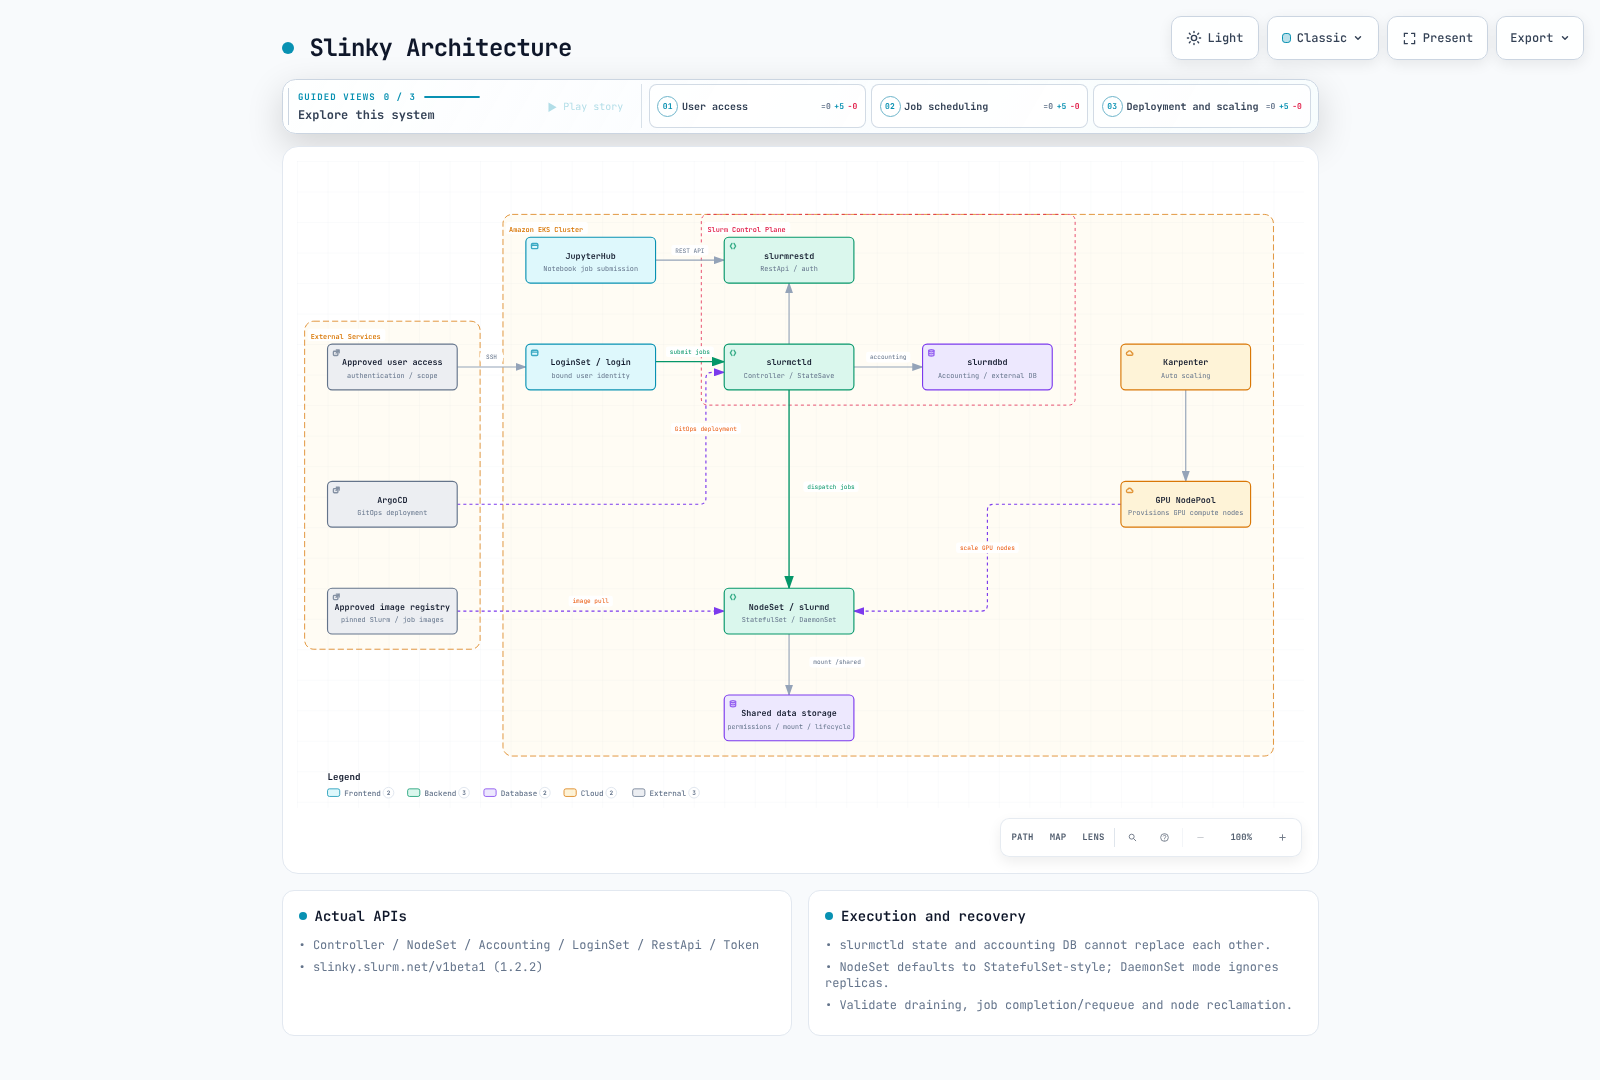
実際の API とライフサイクル
Version1.2.2 では、slinky.slurm.net/v1beta1 に Controller、NodeSet、Accounting、LoginSet、RestApi、Token が定義されています。以前の SlurmCluster/SlurmNodeSet の例はこの API ではありません。NodeSet は controllerRef と Pod template を使用します。デフォルトの scalingMode は StatefulSet のように動作します。DaemonSet モードは一致する Kubernetes node ごとに1つの Pod を作成し、replicas を無視します。これらは NodeSet-controller モードであり、slurmd が常に Kubernetes DaemonSet リソースとして実行される証拠ではありません。
slurmctld は job/node/partition 状態とスケジューリングを管理します。その StateSaveLocation を保持してください。slurmdbd は accounting database へのアクセスとレコードを処理するもので、controller 状態の代替ではありません。login/REST/job の ID、ファイルシステム権限、Slurm key/JWT、DB 認証情報の配信/ローテーションをまとめて設計してください。パブリック NLB SSH 公開はデフォルトの前提条件ではありません。
まず実際の chart をレンダリングしてください。これらのコマンドはローカルファイルを生成するだけです。運用デプロイには別途、cert-manager/CRD/operator/Slurm の順序、永続化/database、ユーザー ID、互換性のある Slurm image が必要です。
helm template slurm-api oci://ghcr.io/slinkyproject/charts/slurm-operator-crds   --version 1.2.2 > slurm-crds.yaml
helm template slurm-control oci://ghcr.io/slinkyproject/charts/slurm-operator   --version 1.2.2 --namespace slinky > slurm-operator.yaml
helm template slurm-example oci://ghcr.io/slinkyproject/charts/slurm   --version 1.2.2 --namespace slurm   --set-json 'nodesets={"cpu-example":{}}'   --set partitions.all.enabled=true > slurm-example.yaml
Argo CD Application は実在する chart path/revision と実際の values を参照する必要があります。架空の compute.partitions/efa.enabled 設定は構成されません。pruning、CRD/PVC 削除、Slurm draining/requeue、job 終了タイムアウトを確認してください。NodeSet の scale-in と EC2 終了は別個の制御ループです。
Slurm からの torchrun 起動
ノードごとに1つの torchrun launcher を実行し、それぞれに GPU ごとのプロセスを作成させます。以前の8つの Slurm task はそれぞれ8プロセスを起動していたため、ノードあたり64プロセスになっていました。この例は4nodes×8processes を意図しています。この監査では実際の Slurm/GPU 割り当ては実行していません。
#!/bin/bash
#SBATCH --job-name=distributed-training
#SBATCH --nodes=4
#SBATCH --ntasks-per-node=1
#SBATCH --gpus-per-node=8
#SBATCH --cpus-per-task=16
#SBATCH --time=01:00:00
set -euo pipefail

: "${SLURM_NNODES:?Run within an approved Slurm allocation}"
: "${SLURM_JOB_ID:?}"
: "${SLURM_JOB_NODELIST:?}"
export MASTER_ADDR
MASTER_ADDR=$(scontrol show hostnames "$SLURM_JOB_NODELIST" | head -n 1)
export MASTER_PORT=29500

# One torchrun launcher per Slurm node, eight training processes per launcher.
# train.py, dependencies, data, credentials and checkpoints must be prepared.
srun --ntasks="$SLURM_NNODES" --ntasks-per-node=1 bash -c '
  exec torchrun \
    --nnodes="$SLURM_NNODES" \
    --nproc-per-node=8 \
    --node-rank="$SLURM_PROCID" \
    --rdzv-id="$SLURM_JOB_ID" \
    --rdzv-backend=c10d \
    --rdzv-endpoint="$MASTER_ADDR:$MASTER_PORT" \
    /workspace/train.py
'
Slurm が task ごとの GPU 可視性を制限する場合、各 launcher が意図した8つすべての GPU を受け取ることを確認してください。train.py は LOCAL_RANK/RANK/WORLD_SIZE、デバイスバインディング、DDP/sampler、バージョン管理されたデータ/モデル、resume を実装する必要があります。shell fixture では、4つの launcher、異なる node rank、共通の rendezvous endpoint を検証しました。
GPU 通信と EFA
FI_PROVIDER=efa は libfabric provider を選択します。EFA のインストール、interface のアタッチ、NCCL との統合は行いません。サポート対象の EFA 有効 instance、driver/libfabric、aws-ofi-nccl、device plugin/Pod 割り当て、security group、実際の transport をまとめて検証してください。RAID0 または subnet tag では EFA は有効になりません。
通信する node は同一の AZ を共有する必要があります。パフォーマンスのためには cluster placement group が推奨されます。学習 Pod が制限された NodePool を実際に使用することを確認してください。帯域幅と EFA-device 数は instance によって異なり、400Gbps が普遍的に利用できるわけではありません。古い Ring/Simple、IB_DISABLE、SOCKET_IFNAME、FI_EFA_USE_DEVICE_RDMA 設定を無批判に強制すると、現在の plugin に干渉する可能性があります。リリースドキュメント、ログ、collective test を確認してください。
Karpenter budgets.nodes=0 は任意の disruption 経路を制限します。Spot reclamation、node 障害、強制終了、あらゆる expiration を防ぐものではありません。do-not-disrupt/PDB と terminationGracePeriod/expireAfter の相互作用を確認し、checkpoint recovery を維持してください。各 bootstrap で浮動バージョンの driver installer を取得したり、デバイスタイプをまたいで GPU clock をハードコードしたりしないでください。
BioNeMo
検査した3.0.0 は BioNeMo Recipes であり、TransformerEngine ベースのモデル/チェックポイントと、PyTorch、Accelerate、Lightning 用の recipe を提供します。ESM-2、AMPLIFY、Geneformer などについて、recipe 固有のサポートを確認してください。BioNeMo1.5 MegaMolBART module を3.0 API であるかのように実行しないでください。生物学的評価およびモデル/データの権限は別の要件です。GPU 割り当てだけでは recipe の準備にはなりません。
Trainium と Neuron
SDK2.32.0 の torch-neuronx、NeuronX Distributed Training/model implementation、Optimum Neuron の経路を区別してください。transformers-neuronx の inference サポートは、一般的な学習サポートではありません。古い2.18 DLC に任意の pip package を追加するのではなく、選択した hardware/SDK に対して TensorFlow/JAX/PyTorch のバージョンを確認してください。
Optimum Neuron0.4.5 には NeuronTrainer/NeuronTrainingArguments と専用の Neuron training-model implementation が含まれます。汎用の BertForPreTraining をロードし、未定義の dataset/tokenizer 変数を渡すだけでは完全な TP 学習にはなりません。サポート対象の model/config、labels/collator、tokenizer/revision、optimizer/checkpoint 形式、launcher を準備してください。CPU 例の PyTorch2.14 は Neuron SDK 互換性の主張ではありません。
マルチノード Job と事前コンパイル
Job parallelism=4 は4つの Pod を起動するだけで、rank や rendezvous を構成するものではありません。Indexed Job には completionMode/index と1つの共有 master endpoint が必要です。各 Pod の MASTER_ADDR を自身の status.podIP に設定すると、worker は異なる master を指すことになります。coordinator/controller topology とサポート対象の launcher を使用し、train_lora.py、データ、compile cache、device を準備してください。
neuron_parallel_compile は graph を抽出/コンパイルするものであり、実際の学習の代替ではありません。その後に学習を別途実行し、cache hit、shape、compiler/SDK revision を検証してください。core と device の違いについては、Neuron unit distinctionsを参照してください。
Ray Train、MPI、Volcano
監査済みの Ray2.58/KubeRay1.7 Train ガイドを使用してください。worker 間で report-call 数を一致させ、実際の Checkpoint object を report してください。get_checkpoint() は以前の recovery state を取得するものであり、新規保存用の context manager ではありません。resources_per_worker GPU8 では、1つの worker 内で8つの DDP process は自動起動されません。
MPI Operator0.8.2 は kubeflow.org/v2beta1 を使用します。slotsPerWorker は hostfile slot を宣言するものであり、mpirun -np、mapping、GPU binding を独立して決定するものではありません。Launcher/Worker code、MPI/SSH implementation、サポート対象 image、CRD/RBAC を準備してください。4 workers×8 slots だけでは32GPU process は保証されません。
Volcano1.15.2 の minAvailable は EC2 node ではなく Pod/member を数えます。十分にプロビジョニングされた3つの node に4つの Pod を収められる場合があります。gang plugin は最小 member/resource 条件を適用しますが、同時の container 起動や学習の成功は保証しません。追加 worker、elastic-runtime サポート、RestartJob/requeue の動作を確認してください。
JupyterHub GPU profile は実際の image/device label および認可と一致している必要があります。g5.xlarge は A10G であり、A100 profile ではありません。構成を実行中の Hub に組み込み、ユーザーごとのストレージ、quota、networking、idle culling を構成してください。
学習ストレージとチェックポイント
監査済みの CSI path は GPU/storage ガイドを使用してください。static PV 経由で既存の FSx filesystem を mount することは、dynamic provisioning により新規作成することとは異なります。FileSystem dataRepositoryAssociations field を創作したり、SCRATCH_2 と persistent 専用の throughput 設定を混在させたりしないでください。DRA/import/export API、policy、完了を個別に検証してください。
EFS PVC の容量要求は物理ストレージの quota ではありません。access-point UID/GID、directory 権限、CSI identity、networking、mount target を検証してください。ローカル checkpoint は、S3 転送が完了するまでリモートで永続的ではありません。
リカバリーには、model、optimizer、scheduler、RNG、使用時の scaler、data/sampler cursor、およびすべての sharded state が必要です。複数の rank が1つの file を上書きしないようにし、framework 対応の distributed saving を使用してください。以前の有効な checkpoint を削除する前に、完了 manifest/checksum、リモート転送、restore を検証してください。架空の checkpoint-manager image や auto_resume=true ConfigMap はこれらの機能を実装しません。
実行可能な小規模 CPU 例
この合成16sample・1 CPU thread の例は、4回の optimizer update を実行します。accumulation、有界な cosine schedule、一時 file の置換、optimizer/RNG の復元を実演します。PyTorch2.14.0+cpu では、中断なしの学習と2 step 後の resume で同一の結果が得られました。これは GPU、分散、リモート永続性のテストではありません。
from pathlib import Path
import math
import os
import tempfile
import torch


def lr_factor(step, warmup_steps, total_steps, min_ratio=0.1):
    if not 0 <= warmup_steps < total_steps or not 0 <= min_ratio <= 1:
        raise ValueError("Invalid schedule bounds")
    if step < 0:
        raise ValueError("Step must be non-negative")
    if step < warmup_steps:
        return step / max(1, warmup_steps)
    progress = min(1.0, (step - warmup_steps) / (total_steps - warmup_steps))
    return min_ratio + (1 - min_ratio) * (1 + math.cos(math.pi * progress)) / 2


def save_checkpoint(path, state):
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(dir=path.parent, delete=False) as output:
            temporary = output.name
            torch.save(state, output)
            output.flush()
            os.fsync(output.fileno())
        os.replace(temporary, path)
    finally:
        if temporary is not None and os.path.exists(temporary):
            os.unlink(temporary)


def train_toy(checkpoint_path, stop_after=4, resume=False):
    # Tiny deterministic CPU example; no GPU, dataset or model download.
    torch.set_num_threads(1)
    torch.manual_seed(17)
    model = torch.nn.Linear(2, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9)
    scheduler = torch.optim.lr_scheduler.LambdaLR(
        optimizer, lambda step: lr_factor(step, 1, 4)
    )
    inputs = torch.arange(32, dtype=torch.float32).reshape(16, 2) / 32
    targets = inputs.sum(dim=1, keepdim=True)
    start = 0
    if resume:
        saved = torch.load(checkpoint_path, map_location="cpu", weights_only=True)
        model.load_state_dict(saved["model"])
        optimizer.load_state_dict(saved["optimizer"])
        scheduler.load_state_dict(saved["scheduler"])
        torch.set_rng_state(saved["torch_rng"])
        start = saved["optimizer_step"]
    if not start <= stop_after <= 4:
        raise ValueError("Invalid stopping point")
    for step in range(start, stop_after):
        optimizer.zero_grad(set_to_none=True)
        # Two equal-sized microbatches per optimizer update.
        for microbatch in range(2):
            offset = step * 4 + microbatch * 2
            prediction = model(inputs[offset:offset + 2])
            loss = torch.nn.functional.mse_loss(prediction, targets[offset:offset + 2]) / 2
            loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        scheduler.step()
        save_checkpoint(checkpoint_path, {
            "model": model.state_dict(),
            "optimizer": optimizer.state_dict(),
            "scheduler": scheduler.state_dict(),
            "optimizer_step": step + 1,
            "torch_rng": torch.get_rng_state(),
        })
    return {name: value.detach().clone() for name, value in model.state_dict().items()}


if __name__ == "__main__":
    path = Path("toy-training.pt")
    train_toy(path, stop_after=2)
    train_toy(path, stop_after=4, resume=True)
    print("Completed four CPU optimizer updates, including checkpoint resume.")
この例が実演するのは、1つの filesystem 上での完了 file 置換であり、filesystem crash/directory metadata の永続性、S3 transaction、distributed checkpoint protocol ではありません。固定されたデータ順序も、汎用的な sampler recovery を実装していません。普遍的な500step/5 copy ルールではなく、保存レイテンシー、障害率、許容可能な作業損失、コストに基づいて checkpoint interval/retention を選択してください。
数値精度とメモリ最適化
現在の PyTorch API は torch.amp.autocast と torch.amp.GradScaler を使用します。BF16 は FP32 と exponent bit 数を共有しますが、mantissa 精度や正確な最大有限値は共有しません。一般に FP16 型の loss scaling を回避できますが、hardware、operation、収束を検証してください。Autocast はすべての weight/optimizer state を BF16 に変換するものではありません。
Activation checkpointing は backward 中に activation を再計算し、計算量とメモリをトレードオフします。disk checkpoint とは異なり、3–4x の削減も30%の slowdown も保証しません。use_reentrant を明示的に指定し、gradient、dropout/RNG、stateful layer を検証してください。
Flash Attention/SDPA backend の選択は dtype、head size、device、mask に依存します。学習状態を定義し、評価中は dropout_p=0 を渡してください。明示的/causal mask の組み合わせについて API サポートを確認してください。use_cache=False だけでは attention backend は導入されません。
DeepSpeed0.19.6 ZeRO1 は optimizer state を分割します。2は gradient を追加し、3は parameter を追加します。CPU/NVMe offload は別途構成するものであり、Stage3 によって自動有効化されません。auto value を置き換える上位レベルの integration と、純粋な DeepSpeed configuration を区別してください。buffer、activation、最大 layer は無制限のメモリ削減を妨げます。
scheduler は accumulation microstep ではなく optimizer update に従って進めてください。学習期間後に cosine が再び上昇しないよう progress を clamp し、例のように warmup/total-step の境界を検証してください。
検証範囲
すべてのガイド/quiz の prose と76の一意な元の code block をレビューしました。チェックは公式の Slinky Helm/CRD、MPI/Volcano API と SDK source、小規模 CPU training/resume、shell-launcher fixture を対象としています。GPU/Neuron/EFA、Slurm/MPI cluster、実際の pretrained model、cloud resource は実行していません。ローカルの code/schema 検証は、本番デプロイの検証とは異なります。
参考資料
- Slinky 1.2.2
- Slurm controller
- Slurm accounting daemon
- MPI Operator 0.8.2
- Volcano 1.15.2 gang plugin
- EKS EFA networking
- BioNeMo 3.0.0 recipes
- Optimum Neuron 0.4.5
- Neuron SDK 2.32.0
- PyTorch 2.14 launcher
- DeepSpeed 0.19.6 ZeRO configuration