ClickHouse
最終更新: September 13, 2026
ClickHouse はカラム型の分析データベースです。インジェストスキーマ、保持期間、運用モデルがワークロードに適合する場合、SQL フィルタリング、集計、結合を必要とするログワークロードに適しています。
目次
- 概要
- アーキテクチャ
- Kubernetes デプロイ
- ログインジェストパイプライン
- SQL クエリ
- Grafana 統合
- HyperDX (English)
- パフォーマンス最適化
- S3 アーカイブ (English)
概要
ClickHouse の機能
| 機能 | 実際上の意味 |
|---|---|
| カラム型ストレージ | 各レコードのすべてのフィールドではなく、選択したカラムを読み取る |
| 圧縮とコーデック | 繰り返し値と適切な順序付けによりストレージを削減できる場合がある。自身のデータで測定する |
| SQL 分析 | ClickHouse SQL 関数、集計、結合を使用する。すべての SQL 方言をそのまま実装したものではない |
| シャーディング | 行をサーバー間に分散する。ホットシャードを避けるキーを選択する |
| レプリケーション | ReplicatedMergeTree は Keeper/ZooKeeper を通じてレプリカを調整する |
| バッチインジェスト | 固定の rows/second レートを仮定するのではなく、insert 頻度とパート作成を制御する |
ログ分析に ClickHouse を選択する理由
ログが構造化され、繰り返し行う分析クエリが中心の場合に ClickHouse を評価してください。代表的なフィルタ、テキスト検索、保持期間、同時リーダー、インジェストバーストをベンチマークします。10:1 を超える圧縮、数十億行を数秒でスキャンする性能、特定のコスト削減は、ワークロードに依存する結果であり、この構成での保証ではありません。
このガイドでは、明示的なレビュー基準として ClickHouse 26.3.33.24 LTS、Altinity Operator 0.27.3、Vector 0.58.0、Grafana ClickHouse datasource 4.21.2 を使用します。リリースが公開されていることは、任意の Kubernetes/EKS バージョン、StorageClass、またはその組み合わせが本番互換であることを証明しません。クラスタとアップグレードパスを別途検証してください。
他のソリューションとの比較
| システム | クエリとストレージモデル | 評価対象 |
|---|---|---|
| ClickHouse | カラム型テーブルに対する SQL | ソートキー、projection/index、集計、insert/merge の動作 |
| OpenSearch / Elasticsearch | ドキュメント検索と分析 | テキスト分析、mapping、インデックス作成コスト、検索要件 |
| Loki | ラベルインデックス付きログストリーム/chunk に対する LogQL | ラベルカーディナリティ、クエリスキャン、保持期間、運用モード |
圧縮率、クエリ速度、運用の複雑性について、普遍的な順位付けは避けてください。各システムには複数のデプロイモードとインデックス/クエリオプションがあります。同じデータ、クエリ、レプリカ、保持期間を比較してください。
アーキテクチャ
ClickHouse クラスタアーキテクチャ
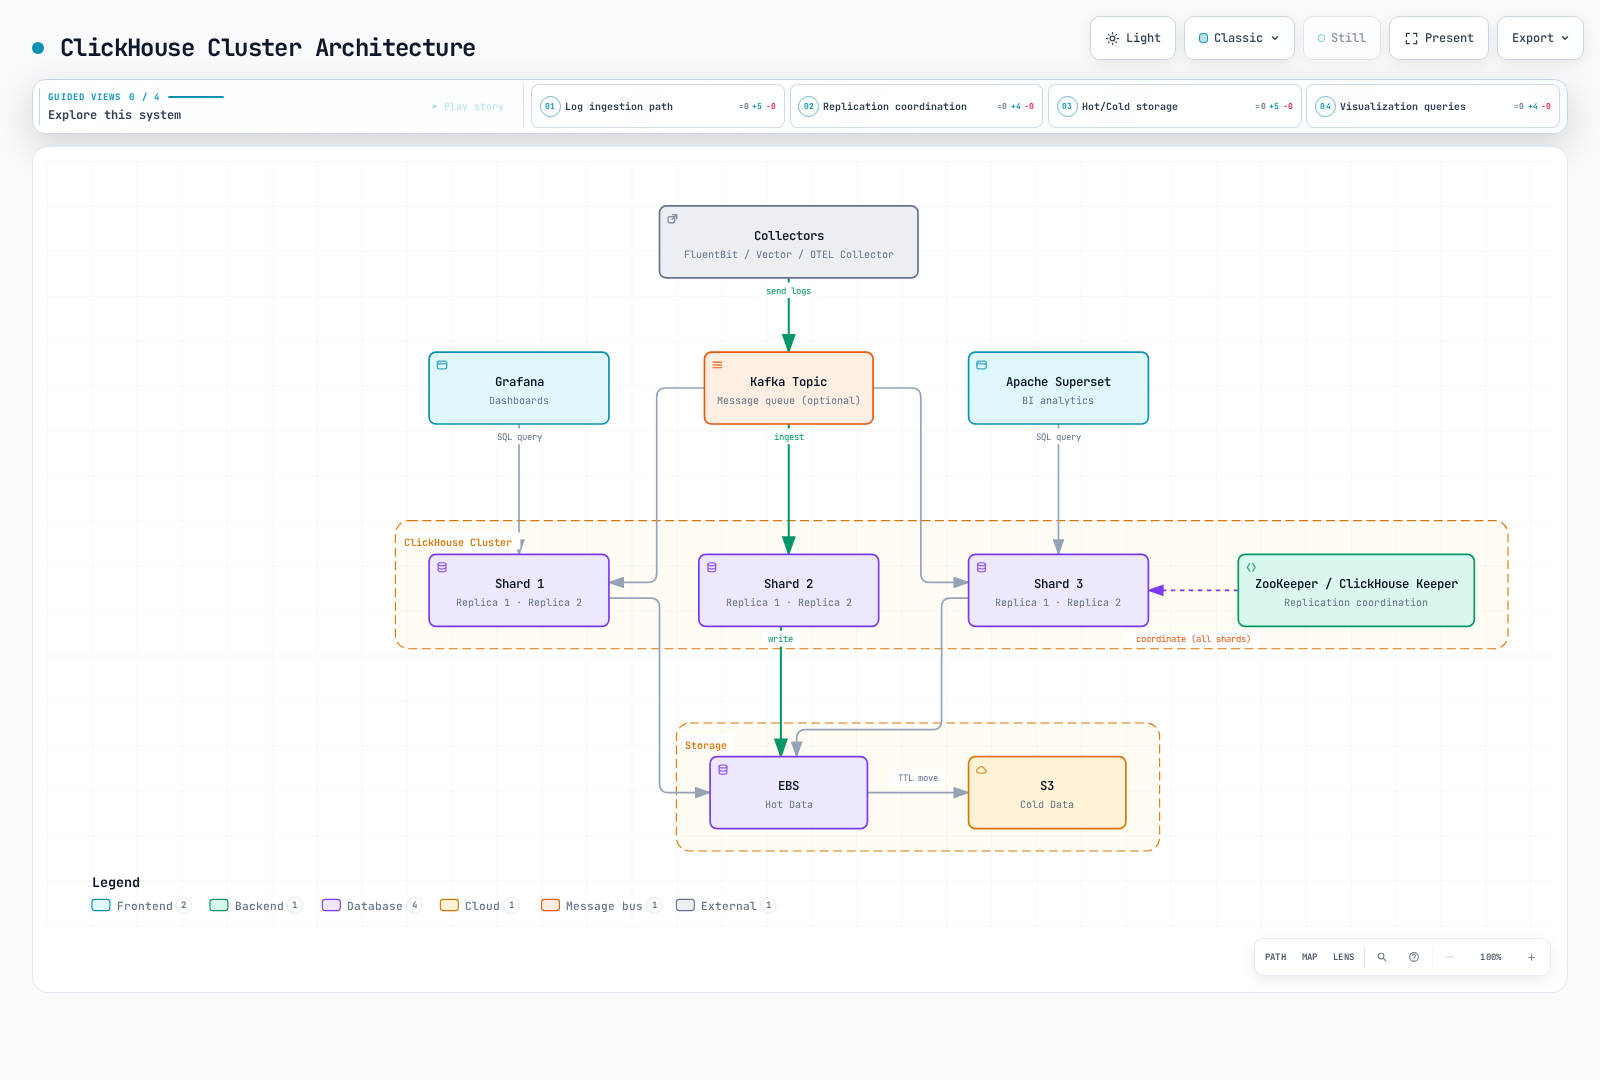
この図は、検証済みのキャパシティ計画ではなく、トポロジーを要約したものです。各 ClickHouse レプリカには独自のデータボリュームが必要です。EBS の記号は、6 つのレプリカが 1 つの書き込み可能な EBS ファイルシステムを共有することを意味しません。Keeper/ZooKeeper はレプリケーションと分散 DDL を調整します。ClickHouse クエリイニシエータと Distributed engine が分散クエリを実行します。Keeper はクエリルーターではありません。
データフロー
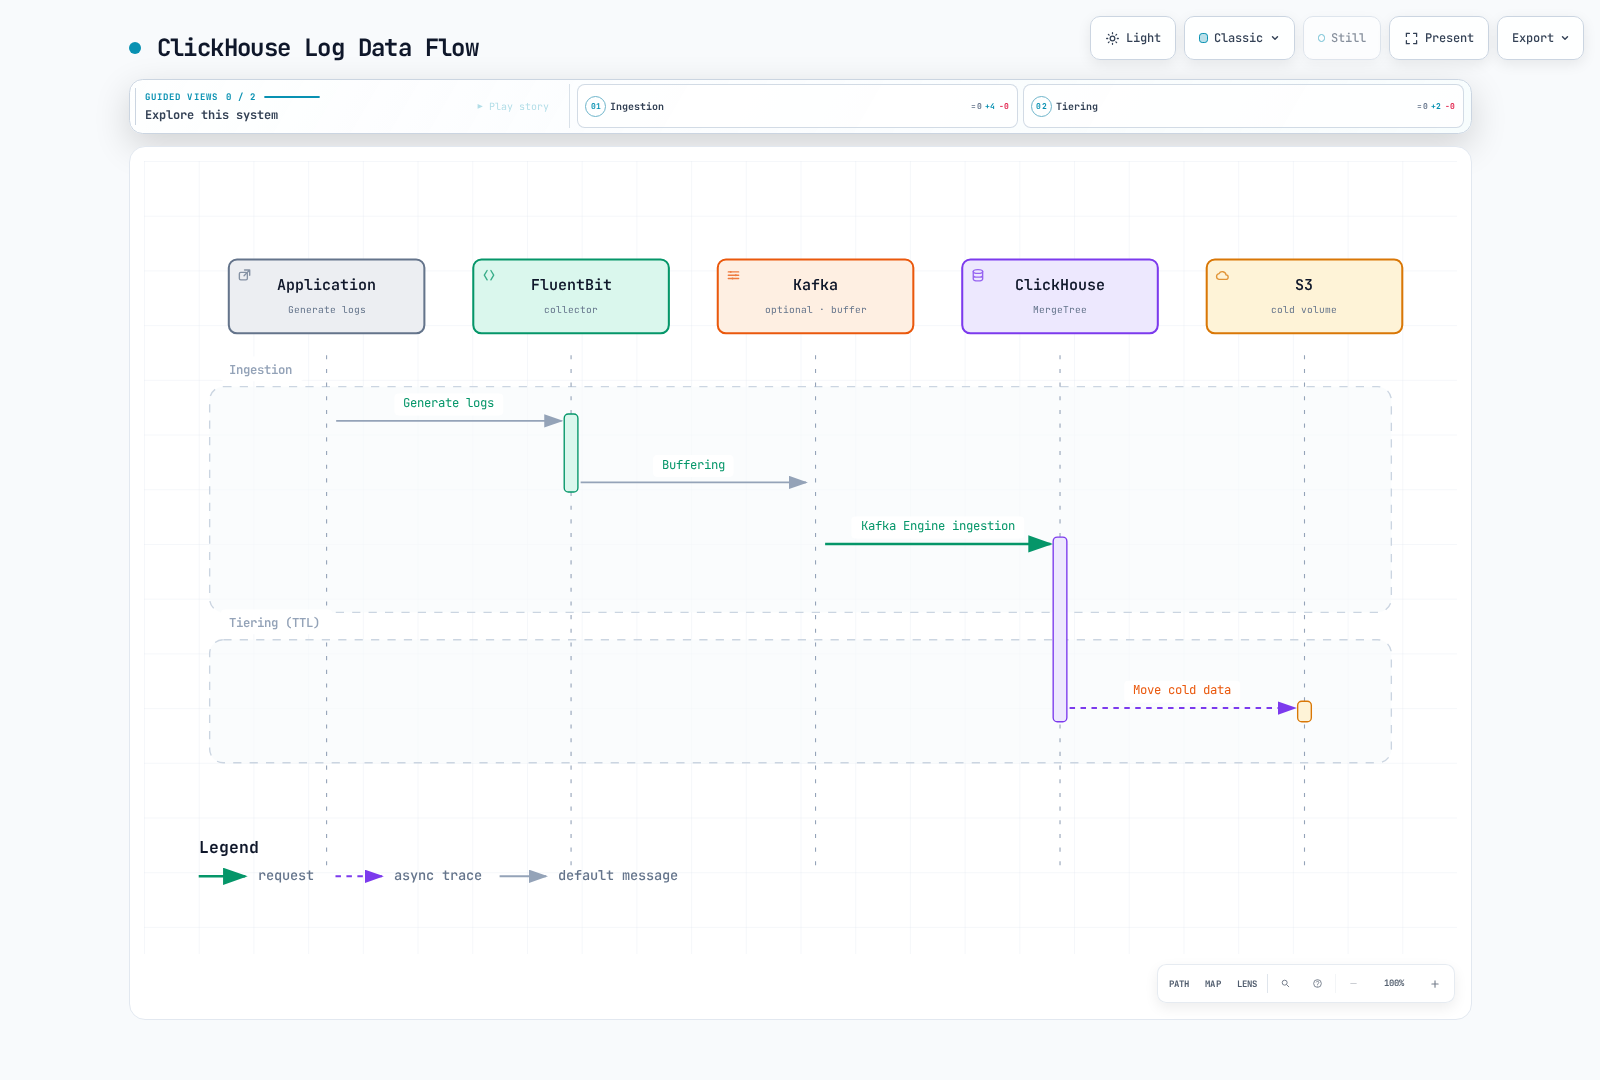
矢印はデータの移動を示します。Kafka-engine バリアントでは、ClickHouse consumer が Kafka をポーリングします。この図は、Kafka が insert を push することや、exactly-once 配信を保証することを意味しません。S3 の cold table part と独立した Parquet archive は異なる仕組みです。
Kubernetes デプロイ
ClickHouse Operator のインストール
変動する master bundle を適用するのではなく、バージョン指定された公式 chart を使用します。
helm upgrade --install clickhouse-operator \
  https://github.com/Altinity/clickhouse-operator/releases/download/release-0.27.3/altinity-clickhouse-operator-0.27.3.tgz \
  --namespace clickhouse-operator --create-namespace

kubectl -n clickhouse-operator get deployments,pods
kubectl get crd clickhouseinstallations.clickhouse.altinity.com \
  clickhousekeeperinstallations.clickhouse-keeper.altinity.com
適用前に、render された RBAC、監視対象 namespace、CRD のインストール/アップグレード動作を検査してください。ローカルレビューではこの chart を render し、公式リリース checksum を確認しました。Operator のインストールやクラスタに対する reconciliation の検証は行っていません。
ClickHouse クラスタ定義
以下は、完全で安全なインストールではなく、既存の必須依存関係を持つトポロジー例です。
- Namespace
clickhouse、ServiceAccountclickhouse-server、適切な CSI-backedgp3StorageClass が存在している必要があります。StorageClass 名はローカルな選択です。EKS Auto Mode ストレージと従来の EBS CSI には、対応する provisioner と topology 設定が必要です。 log-securityという名前のサイト所有 ClickHouseInstallationTemplate が、mount された Secret ファイル、account、TLS、probe、認証済み内部通信を構成する必要があります。その settings/mount が、以下のlogs-serverPod template にも適用されることを確認してください。- 健全な
logs-keeperClickHouseKeeperInstallation が、意図した TLS endpoint と quorum をすでに提供している必要があります。 - namespace
clickhouseに、HTTPS 8443 を公開するlogs-clickhouseという名前の内部 TLS Service を提供してください。その certificate は client DNS 名と一致する必要があります。実際に Operator が生成した selector と endpoint を確認してください。CHI 名だけでは、この特定の Service 名は作成されません。 - 測定済みの要件から failure domain、disruption budget、resource を割り当ててください。以下の 3×2 レイアウトとレプリカごとの 100Gi/8Gi limit は例示であり、スループットまたは可用性の約束ではありません。
apiVersion: clickhouse.altinity.com/v1
kind: ClickHouseInstallation
metadata:
  name: logs-demo
  namespace: clickhouse
spec:
  # Required site-owned template: users, TLS, probes and internal authentication.
  useTemplates:
    - name: log-security
  defaults:
    templates:
      podTemplate: logs-server
      dataVolumeClaimTemplate: logs-data
  configuration:
    zookeeper:
      keeper:
        name: logs-keeper
        serviceType: replicas
    clusters:
      - name: logscluster
        secure: "yes"
        insecure: "no"
        layout:
          shardsCount: 3
          replicasCount: 2
  templates:
    podTemplates:
      - name: logs-server
        spec:
          serviceAccountName: clickhouse-server
          containers:
            - name: clickhouse
              image: clickhouse/clickhouse-server:26.3.33.24
              resources:
                requests:
                  cpu: "2"
                  memory: 4Gi
                limits:
                  memory: 8Gi
    volumeClaimTemplates:
      - name: logs-data
        spec:
          accessModes: [ReadWriteOnce]
          storageClassName: gp3
          resources:
            requests:
storage: 100Gilog_writer、log_reader、管理用の identity を分離して使用します。Secret から credential/configuration ファイルを mount してください。password を ConfigMap、source code、shell command 引数、または広範な environment dump に置かないでください。account network と NetworkPolicy を、実際の collector/query/replica パスに制限してください。寛容な ::/0 user、期限切れの例示 certificate、または certificate verification の bypass をコピーしないでください。
TLS port の公開だけでは不十分です。certificate のロード、hostname/CA チェック、replica traffic、readiness probe を検証してください。security template、volume、依存関係をまとめてレビューするまで、このトポロジーを適用しないでください。ローカル CRD 検証は shape を確認しますが、admission、scheduling、TLS、Operator の動作は確認しません。
ZooKeeper(または ClickHouse Keeper)のデプロイ
新規デプロイでは、ClickHouse Keeper と Operator の ClickHouseKeeperInstallation サポートを検討してください。固定した Operator は zookeeper.keeper.name を使用して CHK reference を解決でき、secure Keeper Service port は reconciliation 中に検出されます。構成の参照として、公式の Keeper reference と TLS configuration example を使用し、再利用前にその例の image/settings をレビューしてください。
投票メンバー 3 台には、2 台の過半数が必要です。Persistent state、peer connectivity、certificate、failure domain をまたぐ scheduling には、引き続き検証が必要です。zookeeper-0 のような Pod 名を、ZooKeeper image の数値 ZOO_MY_ID に渡さないでください。
kubectl -n clickhouse get chk logs-keeper
kubectl -n clickhouse get chi logs-demo
kubectl -n clickhouse get pods,pvc,services,endpointslices
kubectl -n clickhouse get events --sort-by=.metadata.creationTimestamp
ログインジェストパイプライン
Buffer → Store → Distributed の 3 層設計
これらは 3 つの独立した永続コピーではなく、engine の責務です。MergeTree は part を保存し、ReplicatedMergeTree はレプリケーションを追加し、Distributed は shard 間の read/insert をルーティングします。オプションの Buffer engine は、宛先 table に転送する前に process memory にデータを保持します。
一貫した宛先を使用します。各 shard では logs.application_logs、クラスタ全体の access には logs.application_logs_distributed を使用します。IF NOT EXISTS を付けて同じ Distributed table を 2 回作成しても、既存の table の宛先は変更されません。SHOW CREATE TABLE を検査し、慎重に migrate してください。
まず collector 側の batching を優先してください。ClickHouse asynchronous insert も別の選択肢です。有効な場合、wait_for_async_insert=1 は buffer された insert が処理されるまで待機します。flush 前に acknowledge する mode では、配信/error feedback が弱まります。選択した engine、user settings、retry をまとめてテストしてください。以下の Vector 例では、synchronous batched insert と foreground Distributed forwarding を備えた writer profile を使用します。
比較のみを目的として、このオプションの Buffer table は同じ local storage table を対象にします。
CREATE TABLE logs.application_logs_buffer ON CLUSTER logscluster
AS logs.application_logs
ENGINE = Buffer(
    logs, application_logs, 4,
    1, 10,
    1000, 10000,
    1000000, 10000000);
Buffer は、すべての最小 threshold に達したとき、またはいずれかの最大 threshold に達したときに flush します。limit は buffer layer ごとに適用されます。4 layer × 10,000,000 bytes は大まかな threshold budget であり、process-memory cap ではありません。source block、copy、query、cache により memory が追加されます。crash によって unflushed row が失われる可能性があり、並べ替えられた block により replicated insert deduplication が機能しなくなる場合があります。default pipeline をこの例にルーティングしたり、durable Kafka replay protection と説明したりしないでください。
ログテーブルスキーマ
クラスタ名 logscluster、Keeper、{shard}/{replica} macro を確認した後、管理用 identity で cluster DDL を実行します。
CREATE DATABASE IF NOT EXISTS logs ON CLUSTER logscluster;

CREATE TABLE IF NOT EXISTS logs.application_logs ON CLUSTER logscluster
(
    timestamp DateTime64(3, 'UTC') CODEC(Delta, ZSTD(1)),
    date Date MATERIALIZED toDate(timestamp),
    level LowCardinality(String),
    namespace LowCardinality(String),
    service LowCardinality(String),
    pod_name String,
    container_name LowCardinality(String),
    node_name LowCardinality(String),
    message String CODEC(ZSTD(1)),
    trace_id String,
    raw_json String CODEC(ZSTD(1)),
    response_time_ms Nullable(Float64)
        MATERIALIZED if(
            JSONType(raw_json, 'response_time_ms') IN ('Int64', 'UInt64', 'Double'),
            JSONExtract(raw_json, 'response_time_ms', 'Nullable(Float64)'),
            NULL)
)
ENGINE = ReplicatedMergeTree(
    '/clickhouse/logs-demo/tables/{shard}/application_logs', '{replica}')
PARTITION BY date
ORDER BY (namespace, service, timestamp)
TTL toDateTime(timestamp) + INTERVAL 90 DAY DELETE;

CREATE TABLE IF NOT EXISTS logs.application_logs_distributed ON CLUSTER logscluster
AS logs.application_logs
ENGINE = Distributed(
    'logscluster', 'logs', 'application_logs',
    cityHash64(namespace, service, pod_name));
collector は通常の 10 カラムを送信し、ClickHouse が date と nullable の response_time_ms を計算します。response time が欠落しているか数値以外の場合は NULL のままなので、request 以外の log がゼロ遅延 request としてカウントされません。raw_json は有効な application JSON であり、信頼できる Kubernetes metadata とは分離されています。application が secret や personal data を出力する可能性がある場合、インジェスト前に redaction を適用してください。
日次 partition はこの例の保持期間管理に適していますが、常に最適であるとは限りません。Keeper path はこの installation 固有です。無関係な installation 間で再利用すると、replication identity が混在する可能性があります。IF NOT EXISTS は schema migration ではありません。
Secret process を通じてすでに provision 済みの SQL-managed accountについては、参加するすべての server で grant/profile を構成してください。file-managed user には、ALTER USER が変更できると仮定するのではなく、同等の file-managed permission が必要です。
-- Users and credentials already exist through the site-owned secret configuration.
GRANT INSERT ON logs.application_logs TO log_writer;
GRANT INSERT ON logs.application_logs_distributed TO log_writer;
GRANT SELECT ON logs.application_logs TO log_reader;
GRANT SELECT ON logs.application_logs_distributed TO log_reader;

CREATE SETTINGS PROFILE logs_readonly
SETTINGS readonly = 1, max_execution_time = 60 CHANGEABLE_IN_READONLY;
ALTER USER log_reader SETTINGS PROFILE logs_readonly;

CREATE SETTINGS PROFILE logs_writer
SETTINGS distributed_foreground_insert = 1, async_insert = 0;
ALTER USER log_writer SETTINGS PROFILE logs_writer;
writer の foreground Distributed insert は shard forwarding を待ちますが、選択した replica quorum、普遍的な retry deduplication、またはあらゆる storage failure からの保護を意味するものではありません。quorum、failure/retry semantics、permission を個別にレビューしてください。Grafana reader は必要な query timeout setting を許可しつつ read-only に保ってください。
Vector によるインジェスト
これは Vector 0.58.0 configuration file です。DaemonSet、ServiceAccount/RBAC、read-only の /var/log/pods access、writable な /var/lib/vector は別途用意する必要があります。Downward API を使用して、Pod の spec.nodeName から非 secret の VECTOR_SELF_NODE_NAME を設定してください。この source は変数を自ら読み取るため、global environment interpolation は不要です。
Secret key password を /etc/vector/clickhouse-auth に、trusted CA を /etc/vector/clickhouse-tls/ca.crt に mount します。Vector 0.58 では、以下の明示的な SECRET[backend.key] backend を使用します。古い ${CLICKHOUSE_PASSWORD} interpolation が default で有効だと仮定しないでください。
data_dir: /var/lib/vector

secret:
  clickhouse_auth:
    type: directory
    path: /etc/vector/clickhouse-auth
    remove_trailing_whitespace: true

sources:
  kubernetes:
    type: kubernetes_logs
    auto_partial_merge: true

transforms:
  project:
    type: remap
    inputs: [kubernetes]
    source: |
      raw = string(.message) ?? ""
      parsed, err = parse_json(raw)
      app = if err == null && is_object(parsed) { object!(parsed) } else { {} }
      namespace = string(.kubernetes.pod_namespace) ?? "unknown"
      service = string(.kubernetes.pod_labels."app.kubernetes.io/name") ??
        string(.kubernetes.pod_labels.app) ?? "unknown"
      pod = string(.kubernetes.pod_name) ?? "unknown"
      container = string(.kubernetes.container_name) ?? "unknown"
      node = string(.kubernetes.pod_node_name) ?? "unknown"
      event_time = if is_timestamp(.timestamp) { timestamp!(.timestamp) } else {
        parse_timestamp(string(.timestamp) ?? "", format: "%+") ?? now()
      }
      . = {
        "timestamp": event_time,
        "level": downcase(string(app.level) ?? "unknown"),
        "namespace": namespace,
        "service": service,
        "pod_name": pod,
        "container_name": container,
        "node_name": node,
        "message": string(app.message) ?? raw,
        "trace_id": string(app.trace_id) ?? "",
        "raw_json": encode_json(app)
      }

sinks:
  clickhouse:
    type: clickhouse
    inputs: [project]
    endpoint: https://logs-clickhouse.clickhouse.svc.cluster.local:8443
    database: logs
    table: application_logs_distributed
    format: json_each_row
    date_time_best_effort: true
    skip_unknown_fields: false
    auth:
      strategy: basic
      user: log_writer
      password: "SECRET[clickhouse_auth.password]"
    tls:
      ca_file: /etc/vector/clickhouse-tls/ca.crt
      verify_certificate: true
      verify_hostname: true
    batch:
      max_events: 10000
      timeout_secs: 2
    buffer:
      type: disk
      max_size: 536870912
      when_full: block
    query_settings:
      async_insert_settings:
        enabled: false
transform は任意の application JSON を event root に merge するのではなく、固定 schema に project します。application 提供の kubernetes/namespace field が Kubernetes metadata を上書きすることはできません。不正な JSON でも message は読み取り可能なままで、parse 済み application object は {} になります。timestamp は collector event timestamp であり、信頼できない application が主張する event time ではありません。
512MiB disk buffer には、実際に書き込み可能な persistent storage と capacity policy が必要です。backpressure は kubelet log rotation を無期限に止めることはありません。kubernetes_logs は end-to-end acknowledgement support を持たない best-effort file source です。sink に disk buffer があるからといって、exactly-once または guaranteed lossless delivery を主張しないでください。この host-log collection model は EKS Fargate node も対象にしません。
このレビューでは、environment/health check を行わずにこの configuration を compile し、10 件の synthetic VRL case を実行しました。実際の Kubernetes access、Secret mount、TLS handshake、ClickHouse delivery には、引き続き deployment validation が必要です。
FluentBit によるインジェスト
Fluent Bit の HTTP output は、改行区切り JSON を ClickHouse の HTTP insert interface に送信できます。CRI/Docker framing、Kubernetes metadata、RBAC、writable な tail database/buffer を備えた、正しくインストール済みの collector を再利用してください。外側の CRI record は application JSON ではありません。
HTTP output を使用する前に、各 record を上記の同じ 10 カラム contract に transform し、timestamp input parsing を一貫して構成してください。ネストされた kubernetes、任意の application key、間違った timestamp field を含む raw Kubernetes record は table schema ではありません。unknown column を無差別に drop して不一致を隠さないでください。
certificate verification を伴う HTTPS と、別途管理する writer credential を使用してください。選択した Fluent Bit version で HTTP output configuration に password string が必要な場合は、保護された Secret-backed configuration file を render してください。静的な Base64 admin:password header を公開しないでください。Vector path はここでの完全な normalization 例です。この節では、提供されていない Fluent Bit transform/DaemonSet がテスト済みであるとは主張しません。
Kafka によるバッファリング(大規模環境)
Kafka は burst を吸収し、構成済みの retention 内で replay を提供できます。必要な outage window に対して authentication/TLS、replication、acknowledgement、disk capacity を provision してください。Kafka は、すべての loss または duplicate を自動的に防ぐものではありません。
ClickHouse Kafka engine は consumer group を通じて topic を消費し、materialized view が parse 済み row を同じ storage table に転送します。consumer 間で意図的な 1 つの group/partition assignment を維持し、すべての message をすべての shard に insert することを避け、lag、parser failure、reject された message を監視してください。credential は SQL 例ではなく、管理された server configuration に属します。
Kafka-engine table は、上記で使用した通常の default column をサポートしません。そこでは incoming field だけを定義し、destination/view で default/materialized value を計算してください。offset commit、downstream insert acknowledgement、retry behavior はまとめてテストする必要があります。durable processing の acknowledge が必要な場合は memory Buffer destination を避け、experimental Keeper-backed offset storage を無条件の production default として有効にしないでください。
SQL クエリ
基本クエリ
直近の error は、日付をまたいでも機能する相対 timestamp range を使用します。
SELECT timestamp, namespace, service, pod_name, message
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
  AND namespace = 'production' AND level = 'error'
ORDER BY timestamp DESC LIMIT 100;
log event と正確に重複を除いた Pod 名をカウントします。
SELECT toStartOfMinute(timestamp) AS minute, service,
       count() AS log_events, countIf(level = 'error') AS error_events,
       round(100.0 * error_events / nullIf(log_events, 0), 2) AS error_log_percent
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
  AND namespace = 'production'
GROUP BY minute, service ORDER BY minute, service;

SELECT namespace, service, uniqExact(pod_name) AS distinct_pods_with_logs
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
GROUP BY namespace, service ORDER BY distinct_pods_with_logs DESC;
error_log_percent は error とマークされたlog eventの割合です。logging contract が request ごとに関連する record が 1 件であることを保証しない限り、HTTP request failure ratio ではありません。uniqExact は正確で、uniq は近似です。どちらの query も、現在稼働中の Pod 数ではなく、観測された log を示します。
高度な分析クエリ
SELECT service, count(response_time_ms) AS measured_events,
       quantileExact(0.95)(response_time_ms) AS p95_ms
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 HOUR
  AND namespace = 'production' AND isNotNull(response_time_ms)
GROUP BY service;

SELECT extract(message, '(TimeoutException|ConnectionError|OutOfMemoryError)') AS error_type,
       count() AS log_events
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY AND level = 'error'
GROUP BY error_type ORDER BY log_events DESC;

SELECT timestamp, service, pod_name, message
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY
  AND trace_id = '0123456789abcdef0123456789abcdef'
ORDER BY timestamp;
latency aggregate には、数値の response time を持つ event だけが含まれます。quantileExact はこの限定された例の説明には有用ですが、大きな workload では大量の memory を消費する可能性があります。より大規模な workload には近似 aggregate を評価してください。extract は pattern に一致しない場合に空文字列を返し、明示的な unmatched group を残します。
trace ID は 32 桁の 16 進文字の例であり、実際の trace ではありません。service 間での正しい propagation と matching field が前提条件です。機密性の高い query text、credential、customer identifier が無制限の log field にならないようにしてください。
リアルタイムダッシュボードクエリ
SELECT toStartOfHour(timestamp) AS hour, namespace,
       count() AS log_events, sum(length(message)) AS message_bytes
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY
GROUP BY hour, namespace ORDER BY hour;

SELECT namespace, pod_name, count() AS backoff_log_events
FROM logs.application_logs_distributed
WHERE timestamp >= now() - INTERVAL 1 DAY
  AND positionCaseInsensitive(message, 'Back-off restarting failed container') > 0
GROUP BY namespace, pod_name;
message_bytes は圧縮済み table storage や network billing ではなく、message text byte をカウントします。“Back-off” message の一致は log event をカウントするものであり、信頼できる container restart count ではありません。そのためには Kubernetes state metrics を使用してください。SQL の SELECT は snapshot query です。dashboard が定期的に refresh されるのは refresh interval によるもので、この query の特別な live-stream property によるものではありません。
Grafana 統合
ClickHouse Datasource のセットアップ
Grafana の deployment mechanism を使用して grafana-clickhouse-datasource 4.21.2 を install/pin し、その plugin の Grafana 要件を確認してください。provisioning template は scheme なしの hostname、数値の port、TLS を伴う HTTP protocol、secureJsonData 配下の credential を使用します。
apiVersion: 1
datasources:
  - name: ClickHouse
    uid: clickhouse-logs
    type: grafana-clickhouse-datasource
    access: proxy
    jsonData:
      host: logs-clickhouse.clickhouse.svc.cluster.local
      port: 8443
      protocol: http
      secure: true
      tlsSkipVerify: false
      tlsAuthWithCACert: true
      username: log_reader
      defaultDatabase: logs
      logs:
        defaultDatabase: logs
        defaultTable: application_logs_distributed
        timeColumn: timestamp
        levelColumn: level
        messageColumn: message
    # Filled by the file-to-file renderer before provisioning.
    secureJsonData: {}
provisioning 前に空の credential map を設定してください。たとえば、次の file-to-file renderer は mount された password と CA を読み取ります。Python と PyYAML が必要です。secret を stdout に出力せず、Grafana provisioning 用にリテラルの $ 文字を escape します。結果のファイル全体は ConfigMap や Git-tracked artifact ではなく、Secret として扱ってください。
"""Render a complete Secret-backed provisioning file; requires PyYAML."""
import os
from pathlib import Path
import sys
import tempfile
import yaml

template, password_path, ca_path, output = map(Path, sys.argv[1:])
config = yaml.safe_load(template.read_text())
password = password_path.read_text().rstrip("\r\n")
ca = ca_path.read_text()
if not password or "-----BEGIN CERTIFICATE-----" not in ca:
    raise ValueError("A nonempty password and PEM CA file are required")
# Grafana provisioning expands $ variables even in quoted YAML scalars.
# Escape literal dollars; do not interpolate secrets through process environment.
config["datasources"][0]["secureJsonData"] = {
    "password": password.replace("$", "$$"),
    "tlsCACert": ca.replace("$", "$$"),
}
fd, temporary = tempfile.mkstemp(prefix=".clickhouse-", dir=output.parent)
try:
    with os.fdopen(fd, "w") as stream:
        yaml.safe_dump(config, stream, sort_keys=False)
    os.replace(temporary, output)
finally:
    if os.path.exists(temporary):
os.unlink(temporary)python3 render-grafana.py grafana-template.yaml \
/run/secrets/clickhouse/password /run/secrets/clickhouse/ca.crt \
/run/grafana-provisioning/clickhouse.yamltarget directory は保護された writable volume 上に存在する必要があります。Grafana process 用に file ownership/read permission を設定し、完成した file をその datasource provisioning directory に mount してください。Secret update だけでは Grafana が datasource を reload したことを証明しません。read-only account、CA validation、実際の query をテストしてください。“Save & test” だけでは、すべての query setting が許可されていることを証明できません。
Grafana ダッシュボードパネル
time-plus-number query には Time series を選択してください。
SELECT $__timeInterval(timestamp) AS time, count() AS log_events
FROM logs.application_logs_distributed
WHERE $__timeFilter(timestamp) AND namespace = 'production'
GROUP BY time ORDER BY time;
個々の record には、構成済みの timestamp、level、message column を持つ Logs/Explore を使用します。Grafana は SQL を送信する前に macro を展開します。$__timeFilter はそれ自体では実行可能な ClickHouse SQL ではありません。
アラートルール
clickhouse_custom_query{query="..."} という Prometheus metric を作り出すのではなく、この datasource と Grafana Alerting を使用してください。
SELECT countIf(level = 'error') AS value
FROM logs.application_logs_distributed
WHERE $__timeFilter(timestamp) AND namespace = 'production';
単一の数値 row には Table format を選択し、次に Reduce/Last と「10 より上」のような threshold を設定します。evaluation interval、time range、pending period、contact policy を明示的に定義してください。10 は演習用の threshold であり、本番向けの推奨ではありません。Prometheus の groups/rules/expr を Grafana の alerting schema と混在させるのではなく、構成済み Grafana version から provisioning を export してください。
row がインジェストされていない場合、countIf はゼロを返すことがあります。たとえば scheduled synthetic heartbeat を使用して、インジェストを別途監視してください。
SELECT $__timeInterval(timestamp) AS time, count() AS value
FROM logs.application_logs_distributed
WHERE $__timeFilter(timestamp) AND service = 'log-heartbeat'
GROUP BY time ORDER BY time;
heartbeat が存在しない場合、この query は time-series row を返しません。No Data と execution error を意図的に構成し、ingestion lag を考慮して notification delivery をテストしてください。
HyperDX(ClickHouse ネイティブビューア)
主な利点
HyperDX は ClickStack で使用される observability UI です。既存の ClickHouse table を使用して source を構成することをサポートしており、custom schema の使用は本質的に非サポートではありません。timestamp、message/body、severity、service、trace field を schema に明示的に map し、connection と制限された user を設定して、代表的な record に対して検索を検証してください。
Buffer/Store/Distributed の naming convention を自動 source discovery と見なしたり、普遍的な 20× の速度向上を主張したりしないでください。HyperDX application/API release 2.38.0 と別バージョンの CLI は異なる artifact です。このガイドでは、custom cluster 上での新規 ClickStack deployment を規定せず、統合を実行したとは主張しません。
ログビューアの比較
| ビューア | 評価すべき適合性 |
|---|---|
| Grafana + ClickHouse plugin | SQL、既存 dashboard、alerting、cross-datasource workflow |
| HyperDX / ClickStack | 明示的に構成された source/schema による observability 検索と correlation |
| SigNoz | 独自の observability ingestion/model と UI。ClickHouse も使用する |
各 component の実際の ingestion schema、authentication、query workflow、対応 release、license を比較してください。既存の ClickHouse database があるからといって、すべての observability UI がそのまま交換可能な frontend になるわけではありません。
パフォーマンス最適化
テーブル設計の最適化
頻繁に使用する選択的 filter と locality に合わせて ORDER BY を選択してください。頻繁に query されるすべての column を先頭に置くという普遍的なルールではありません。LowCardinality(String) は、繰り返される namespace/service/level 値に役立つ場合があります。固定の普遍的な distinct-value cutoff を強制するのではなく、dictionary size と query behavior を評価してください。
可能な限り細かく partition するのではなく、管理可能な retention と merge のために partition してください。90 日間の hourly partitioning では、24~48 だけでなく、およそ 2,160 個の hourly partition が保持される可能性があります。late event が古い partition に書き込まれる場合もあります。
パートの最適化
SELECT partition, count() AS active_parts,
       sum(rows) AS rows, sum(bytes_on_disk) AS bytes_on_disk
FROM system.parts
WHERE active AND database = 'logs' AND table = 'application_logs'
GROUP BY partition ORDER BY partition;

SELECT database, table, is_readonly, is_session_expired,
       queue_size, absolute_delay
FROM system.replicas
WHERE database = 'logs';

SELECT database, table, is_blocked, error_count, last_exception
FROM system.distribution_queue WHERE database = 'logs';
これらの system-table query は、接続先 server を表します。クラスタ全体の operation では、関連するすべての replica/shard を検査してください。part の作成/merge、replication lag、Distributed queue を追跡します。小さな insert を batch 化してください。特定の part count や target part size は普遍的な threshold ではありません。過剰な小規模 insert の修正の代わりに、定期的な OPTIMIZE FINAL を避けてください。
クエリの最適化
適切な場合は timestamp と先頭の sort-key column で filter し、必要な column だけを選択して、EXPLAIN/query-log の read row と byte を検査してください。低い cardinality の label が常に最適な先頭 key であるとは限りません。実際の query mix をテストしてください。
メインの log table には sampling expression が定義されていないため、そこに SAMPLE 0.1 を追加するのは無効です。別の demonstration table では、primary/sort key に含まれる決定論的な unsigned sampling key を定義できます。
CREATE TABLE logs.sample_demo
(
    event_id UInt64,
    message String
)
ENGINE = MergeTree
ORDER BY cityHash64(event_id)
SAMPLE BY cityHash64(event_id);

SELECT count() * 10 AS estimated_events
FROM logs.sample_demo SAMPLE 0.1;
fraction は sampling-key interval であり、有限の row set の厳密に 10% を約束するものではありません。加算的な count は適切に scale してください。average や percentile を 10 倍してはいけません。sampling は、問うべき内容に対しても代表的である必要があります。
システム構成の最適化
max_threads と max_memory_usage は query/user-profile setting です。任意の top-level server XML ではなく、profile または per-query setting に置いてください。server cache と background pool は、単一 query limit の外で追加 resource を消費します。Pod memory limit を設定する前に、同時 query、merge、ingest buffer を考慮してください。
setting を変更する前に、境界を定めた test workload を使用し、CPU throttling、memory、I/O、merge backlog、failure recovery を観察してください。低い query limit は process 全体を制限するものではありません。
リソースガイドライン
日次インジェスト byte、測定済み compression、保持日数、replication、query concurrency、ピーク時の merge/ingest overhead からサイズを決定します。例として、1TB/day を 5:1 に削減できた場合、圧縮データは約 200GB/day になり、90 日で replication と運用 headroom の前に約 18TB です。2 replica は保存コピーをおよそ 2 倍にします。この計算は測定済み capacity result や AWS bill ではありません。
EKS では、EBS provisioned performance/capacity、cross-AZ traffic、node architecture、failure-domain placement、replacement capacity を含めてください。Fargate は node-based collector/ClickHouse deployment と同じ host-log/volume topology を提供しません。
S3 アーカイブと長期保持
アーカイブパイプライン
2 つの設計を分けてください。
- Cold table storage: ClickHouse が、構成済みの S3 disk/volume 上の自身の part と metadata を管理します。local metadata を保持し、選択した disk design で必要な場合は replica ごとに異なる object namespace を使用してください。live ClickHouse table が引き続き所有する object を、手動で lifecycle-delete しないでください。
- 独立した archive: 選択した row を versioned かつ inventoried な Parquet object に export します。completeness、late-arrival handling、access control、restore/query test を個別に定義してください。
cold storage では、cold volume を持つ server の storage policy を構成し、その policy を table 上で明示的に選択します。
-- Separate example: the server must already define the logs_tiered policy.
CREATE TABLE logs.tiered_example
(
    timestamp DateTime,
    message String
)
ENGINE = MergeTree
ORDER BY timestamp
TTL timestamp + INTERVAL 7 DAY TO VOLUME 'cold',
    timestamp + INTERVAL 90 DAY DELETE
SETTINGS storage_policy = 'logs_tiered';この例を作成する前に、logs_tiered が存在している必要があります。TTL work は asynchronous であり、正確な row ごとの deletion deadline ではありません。TTL clause で S3 permission や storage policy を作成することはできません。このレビューでは、S3 deployment ではなく policy の local-disk analogue を実行しました。
server workload の AWS identity と bucket/prefix-scoped permission、private bucket control、encryption、適用される KMS permission を使用してください。単に use_environment_credentials を設定しても、ServiceAccount identity association が作成されるわけでも、使用する ClickHouse build が credential provider をサポートすることを証明するわけでもありません。
S3 への直接アーカイブ
以下の過去の 2025 年 1 月の範囲は syntax を示すものであり、benchmark でも、それらの record が 90 日 TTL 下に現在も存在するという主張でもありません。bucket、range、RUN_ID を、所有する archive job の値に置き換えてください。
-- Historical January 2025 example; replace range and the unique owned export prefix.
INSERT INTO FUNCTION s3(
    'https://EXAMPLE-ARCHIVE.s3.ap-northeast-2.amazonaws.com/logs/export-RUN_ID/{_partition_id}.parquet',
    'Parquet'
)
PARTITION BY toYYYYMMDD(timestamp)
SELECT timestamp, level, namespace, service, pod_name, container_name,
       node_name, message, trace_id, raw_json
FROM logs.application_logs_distributed
WHERE timestamp >= toDateTime64('2025-01-01 00:00:00', 3, 'UTC')
  AND timestamp < toDateTime64('2025-02-01 00:00:00', 3, 'UTC')
SETTINGS s3_truncate_on_insert = 0,
         s3_create_new_file_on_insert = 0,
         output_format_parquet_compression_method = 'zstd';
PARTITION BY は {_partition_id} の置換を提供します。Distributed source は意図した shard を対象にします。1 つの local replica だけを export しても、sharded cluster 全体を対象にすることはできません。実行ごとに新しい予約済み prefix を使用し、制御されていない共有 filename は決して使用しないでください。setting は overwrite/automatic extra file を拒否しますが、distributed lock を実装したり partial export を atomic にしたりするものではありません。
意図した Distributed topology を通じて、shard ごとに 1 つの authoritative copy を選択してください。すべての replica を union して二重カウントしないでください。成功を宣言したり source retention を変更したりする前に、export された row count、timestamp bound、schema、代表的な aggregate、読み取り可能な object を検証してください。
Watermark ベースの進捗追跡
watermark は progress record であり、completeness の証明ではありません。単純な MergeTree table は unique job key や compare-and-swap lock を強制しません。同時 job には、single owner または外部の transactional lease/state store を使用してください。
job ID、source cluster/table/schema version、排他的な time range、shard coverage、output prefix/object manifest、validation result を記録してください。すべての期待する output が確認されてから completion をマークします。明示的な ownership policy の下で partial export を retry し、読み取り時には重複する range の重複を除去してください。
actual data に基づいて late-arrival delay を選択してください。固定の「3 日後に merge する」という仮定では、古い partition への write が閉じることも、すべての遅延 event が到着することも保証されません。correction/replay を明示的に処理し、export が失敗した後は直前に成功した watermark を保持してください。
アーカイブ済みデータを直接クエリする
SELECT namespace, service, count() AS log_events
FROM s3(
    'https://EXAMPLE-ARCHIVE.s3.ap-northeast-2.amazonaws.com/logs/export-RUN_ID/*.parquet',
    'Parquet'
)
WHERE timestamp >= toDateTime64('2025-01-01 00:00:00', 3, 'UTC')
  AND timestamp < toDateTime64('2025-02-01 00:00:00', 3, 'UTC')
GROUP BY namespace, service;
完了し、検証済みの export prefix だけを query してください。restore が必要な archive class は、通常の S3 read の前に restore する必要があります。選択した Region、保存 byte、storage class、request/retrieval charge、replication、retention を使用してコストを見積もってください。普遍的な「90% compression」や「raw TB-month あたり $2.3」という数値は、これらの仮定を隠してしまいます。
参照資料と検証範囲
- ClickHouse LTS リリース
- Altinity Operator リリース
- Buffer engine と制限事項
- Kafka engine
- Sampling
- S3 table function
- Vector ClickHouse sink
- Vector Kubernetes source
- Vector secret backend
- Grafana ClickHouse configuration
- Grafana ClickHouse alerting
- HyperDX source
ネイティブのローカルチェックは、SQL parsing、synthetic schema/query behavior、Vector transform、Operator chart rendering、schema/configuration contract を対象にします。これらは cluster compatibility、HA/failover、実際の Kafka/S3 ingestion、IAM、TLS、本番 capacity を確立するものではありません。この設計を使用する前に、デプロイ済み環境に対してそれらを検証してください。
クイズ
ClickHouse クイズで理解度を確認してください。