パート 2: observability スタックのデプロイ
難易度: 上級 最終更新: September 13, 2026 service クラスターのアプリケーションを、management クラスターのメトリクス、ログ、トレースに接続します。スタック例にある、バージョン固定された chart/TLS/identity のファイルを使用してください。パート1 で context、gp3/EBS CSI、LBC、DNS/route、IRSA、
helm-inputs/collector-identity.yamlが用意されている必要があります。
1. バージョンとベースラインの経路
| コンポーネント | Chart | アプリケーション |
|---|---|---|
| kube-prometheus-stack | 90.0.0 | Operator0.93.1; コンポーネントイメージを確認 |
| Tempo | 3.0.0 | 3.0.3 |
| Loki | 18.13.0 | 3.7.7 |
| OTel Collector | 0.173.1 | contrib0.160.0 |
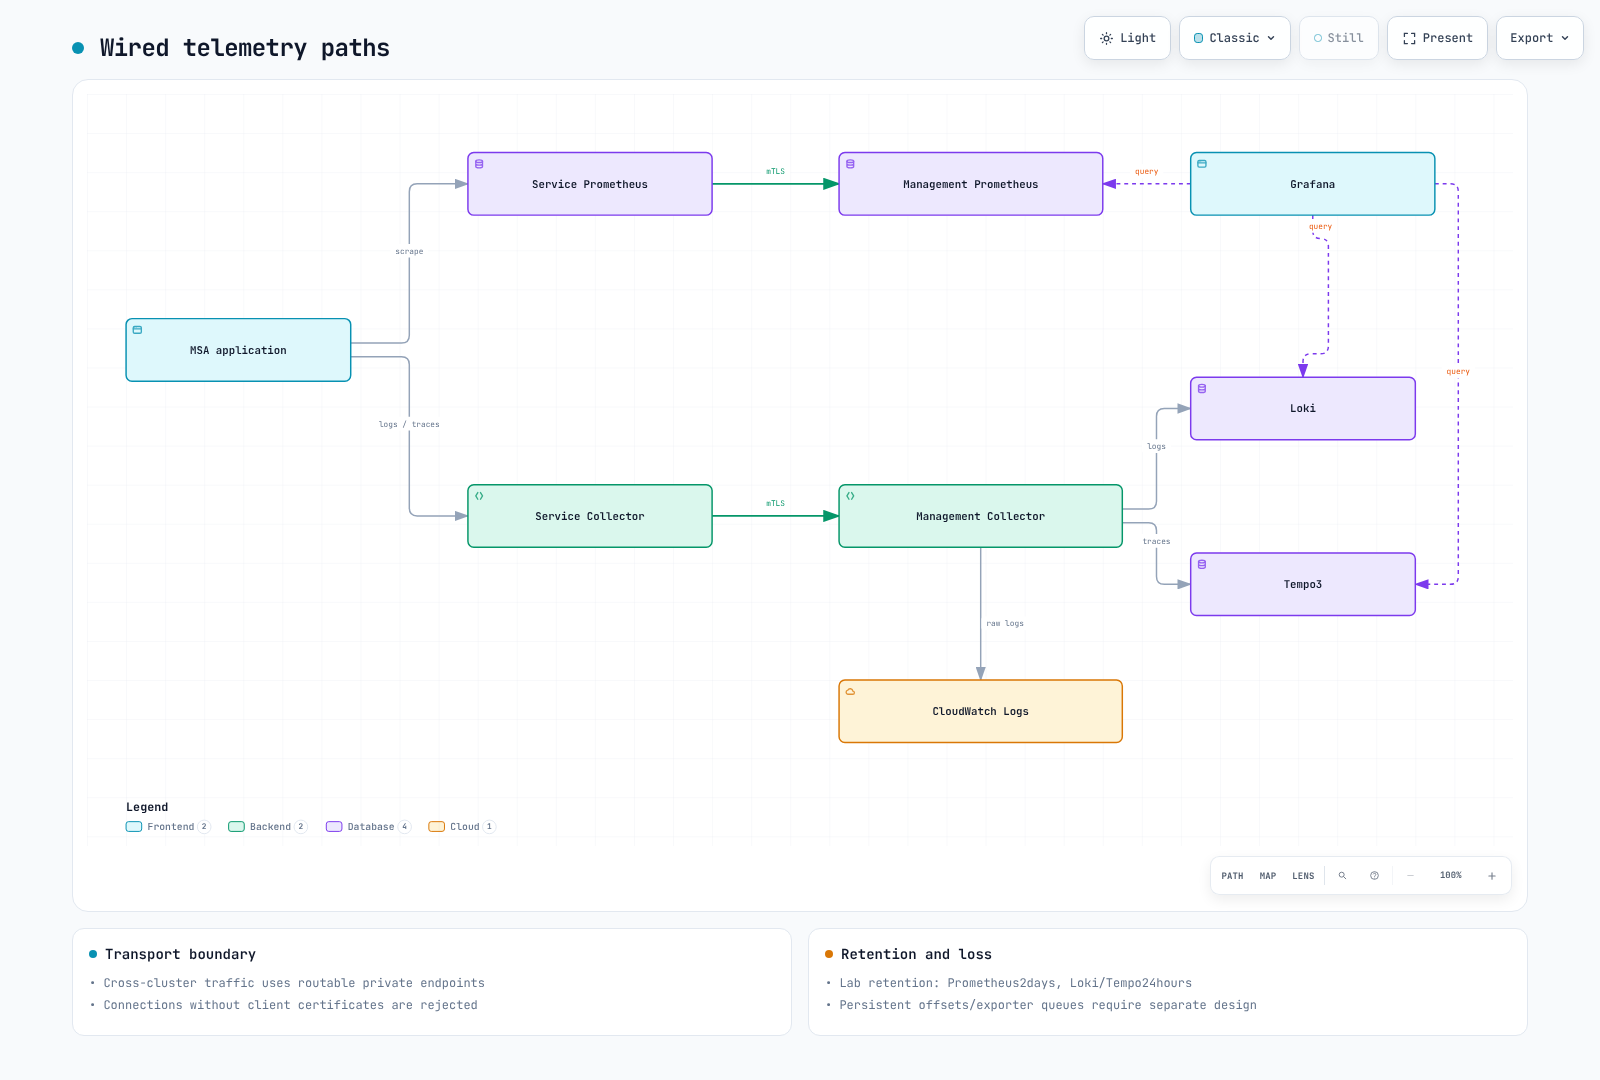
service 側の Prometheus はメトリクスをスクレイプし、mTLS の remote-write で management 側の Prometheus に送信します。Collector は CRI/JSON のログと OTLP のトレースを受け取り、認証済みの management エンドポイントに転送します。management の Collector は Loki/Tempo へ送信し、CloudWatch アドオンは AIOps 向けに構造化ログを提供します。Grafana の UID は一貫して prometheus、loki、tempo を使用します。
バックエンドは単一の永続的なラボインスタンスであり、HA でも実測されたキャパシティでもありません。Prometheus の 2 日間、Loki/Tempo の24 時間という保持期間は、30 日間の SLO を成立させるものではありません。
2. プライベート TLS とネットワークの入力
cd examples/labs/observability/stack
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python prepare_tls.py   --collector-dns "$COLLECTOR_DNS" --prometheus-dns "$PROMETHEUS_DNS"   --output-directory "$LAB_STATE/tls"
.venv/bin/python render_network.py --service-source-cidr "$SERVICE_SOURCE_CIDR"   --nlb-security-group "$NLB_SECURITY_GROUP"   --nlb-source-cidr "$NLB_SUBNET_CIDR_A" --nlb-source-cidr "$NLB_SUBNET_CIDR_B"   --output-directory "$LAB_STATE/network"
7 日間有効なラボ用 CA と、server/client の用途ごとに区別した証明書を生成します。CA の秘密鍵はクラスターの Secret に一切入りません。組織の PKI を使う場合は、一致する Secret のキー、SAN、EKU を提供する必要があります。このヘルパーは DNS、route、SG を作成しません。実際のサービス送信元と NLB ヘルスチェックのサブネット CIDR を使用してください。
kubectl --context managed create namespace monitoring --dry-run=client -o yaml | kubectl --context managed apply -f -
kubectl --context service create namespace monitoring --dry-run=client -o yaml | kubectl --context service apply -f -
kubectl --context service create namespace observability --dry-run=client -o yaml | kubectl --context service apply -f -
kubectl --context managed apply -f "$LAB_STATE/tls/management-secrets.yaml"
kubectl --context service apply -f "$LAB_STATE/tls/service-monitoring-secrets.yaml"
kubectl --context service apply -f "$LAB_STATE/tls/service-observability-secrets.yaml"
3. management バックエンドのインストール
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo add grafana-community https://grafana-community.github.io/helm-charts
helm repo add open-telemetry https://open-telemetry.github.io/opentelemetry-helm-charts
kubectl --context managed apply -f prometheus-probe.yaml
helm upgrade --install lab-monitoring prometheus-community/kube-prometheus-stack   --version 90.0.0 --kube-context managed -n monitoring -f monitoring-management-values.yaml
helm upgrade --install lab-loki grafana-community/loki --version 18.13.0   --kube-context managed -n monitoring -f loki-values.yaml
helm upgrade --install lab-tempo grafana-community/tempo --version 3.0.0   --kube-context managed -n monitoring -f tempo-values.yaml
Prometheus の web は mTLS を要求するため、デフォルトの kubelet HTTPS probe ではクライアント証明書を提示できません。promtool check ready/healthy --http.config.file=... の exec probe とクライアント Secret を使用してください。Operator による probe のマージは検証済みです。Grafana と Tempo の metrics-generator もクライアント証明書を使用します。
Loki は Monolithic/TSDB-v13/filesystem-PVC を使用します。Tempo3 は live-store/backend scheduler/worker を使用し、Tempo2 の ingester/compactor 設定を混在させることはありません。Grafana はレプリカ 1、PVC、および既知の共有パスワードではなく非公開の管理者 Secret を使用します。Grafana では使用しない dashboard sidecar、API token、RBAC を無効化しています。datasource ファイルは指定された Secret からマウントされたままです。
4. Collector、エンドポイント、service 側の収集
helm upgrade --install lab-collector open-telemetry/opentelemetry-collector   --version 0.173.1 --kube-context managed -n monitoring   -f collector-management-values.yaml -f collector-cloudwatch-values.yaml   -f "$LAB_STATE/helm-inputs/collector-identity.yaml"
kubectl --context managed apply -f backend-network-policies.yaml
kubectl --context managed apply -f "$LAB_STATE/network/endpoints.yaml"
kubectl --context managed -n monitoring get svc lab-collector-ingest lab-prometheus-ingest
プライベート DNS を実際の内部 NLB のホスト名にマッピングし、先に進む前に Service から Pod へのルーティング、SG/NACL、クライアント IP の挙動を確認してください。別のクラスターの .svc.cluster.local アドレスは使用しないでください。TLS は Collector/Prometheus で終端され、TCP NLB を通してクライアント認証が保持されます。
helm upgrade --install lab-service-monitoring prometheus-community/kube-prometheus-stack   --version 90.0.0 --kube-context service -n monitoring   -f monitoring-service-values.yaml -f "$LAB_STATE/tls/prometheus-endpoint-values.yaml"
helm upgrade --install lab-agent open-telemetry/opentelemetry-collector   --version 0.173.1 --kube-context service -n observability   -f collector-service-values.yaml -f "$LAB_STATE/tls/collector-endpoint-values.yaml"
service 側の DaemonSet は、読み取り専用マウントを通じて msa の Pod ログを読み取ります。ノードのログにアクセスするため、root UID、capability の削除、権限昇格の禁止を明示しています。namespace の admission policy では、この collector のみを許可してください。CRI のパースが JSON のパースより先に行われ、Kubernetes のメタデータは送信元クラスターで付与されます。management の Collector が他クラスターの Pod を魔法のように参照できるわけではありません。
このラボはファイルの offset や exporter の queue を永続化しません。再起動や障害の際に発生しうる欠損/重複を記録し、永続的なバッファリングは別途設計してください。CloudWatch の raw_log: true は service/level/trace_id を保持します。実際の IRSA と Logs の権限を確認してください。
5. データを検証し、意図的に拡張する
kubectl --context managed -n monitoring get pods,pvc
kubectl --context service -n observability get pods
kubectl --context managed -n monitoring port-forward svc/lab-grafana 3000:80
非公開の管理者 Secret でサインインします。パート3 のアプリケーションをデプロイした後、実際のスクレイプ、exporter のエラー、CloudWatch の JSON フィールド、Tempo のトレース ID、Loki の trace_id、exemplar を比較してください。datasource があること、UI のオプションが有効になっていることだけでは、取り込みの証拠にはなりません。
VictoriaMetrics/Mimir/AMP、ClickHouse/OpenSearch、X-Ray、AMG、MWAA はオプションの拡張です。追加する前に、メトリクス、ロギング、トレーシングの各ガイドを使って、認証/ストレージ/転送/コストを確認してください。このベースラインは、すべてのバックエンドを同時にデプロイすると主張するものではありません。パート3に進んでください。
検証範囲
検証は chart/CRD/ネイティブ設定、実際のローカル Collector による mTLS/CRI/JSON 転送、Prometheus の mTLS probe、合成 PKI、NetworkPolicy のスキーマを対象としました。実際の EKS/LBC/DNS、policy の適用、IRSA、Grafana の live datasource の実行は行っていません。
DaemonSet のプロファイルは lab-agent.observability.svc.cluster.local:4318 の Service を明示的に作成します。デフォルトの internalTrafficPolicy: Local では、各アプリケーションノードで Collector が Ready である必要があります。taint、toleration、DaemonSet の Ready 状態を確認してください。