パート 6: KServe — Kubernetes 上のモデルサービング
レビューのベースライン: KServe 0.18.0 / Models Web Application 0.18.0 / Community Distribution 26.03.1 最終更新: October 12, 2026
ラボ環境のセットアップ
互換性のある Kubernetes、KServe controller/CRD、ServingRuntime、ストレージアクセス、および認証済みのネットワーク経路を使用してください。完全な Kubeflow は必須ではなく、Web アプリは任意です。Knative モードには Knative Serving/networking が必要です。Standard の KEDA 経路には KEDA とメトリクスプロバイダーが必要です。GPU はワークロードに依存します。
KServe と Kubeflow
KServe は KFServing から発展し、独立したサービングプロジェクトになりました。この章では、Community Distribution 26.03.1 にバンドルされた KServe および Models Web Application 0.18.0 を確認します。
2026年10月12日時点で確認した最新の公開 KServe リリースは 0.21.0 (September 25, 2026) です。Version 0.20.0 (August 6, 2026) はそれより前にリリースされました。いずれのリリースもディストリビューションの 0.18.0 ベースラインではありません。
Controller、CRD、Web アプリはそれぞれ別のアーティファクトであり、互換性チェックが必要です。それらのバージョン番号は常に一致する必要も、常に異なる必要もありません。実際のイメージ、CRD スキーマ、および Web アプリのリビジョンを記録してください。
InferenceService はここで扱うサービング API であり、KServe アーキテクチャ全体ではありません。ServingRuntime/ClusterServingRuntime、ModelMesh、および別個の LLMInferenceService API には、異なる依存関係と運用モデルがあります。
InferenceService: Predictor、Transformer、Explainer
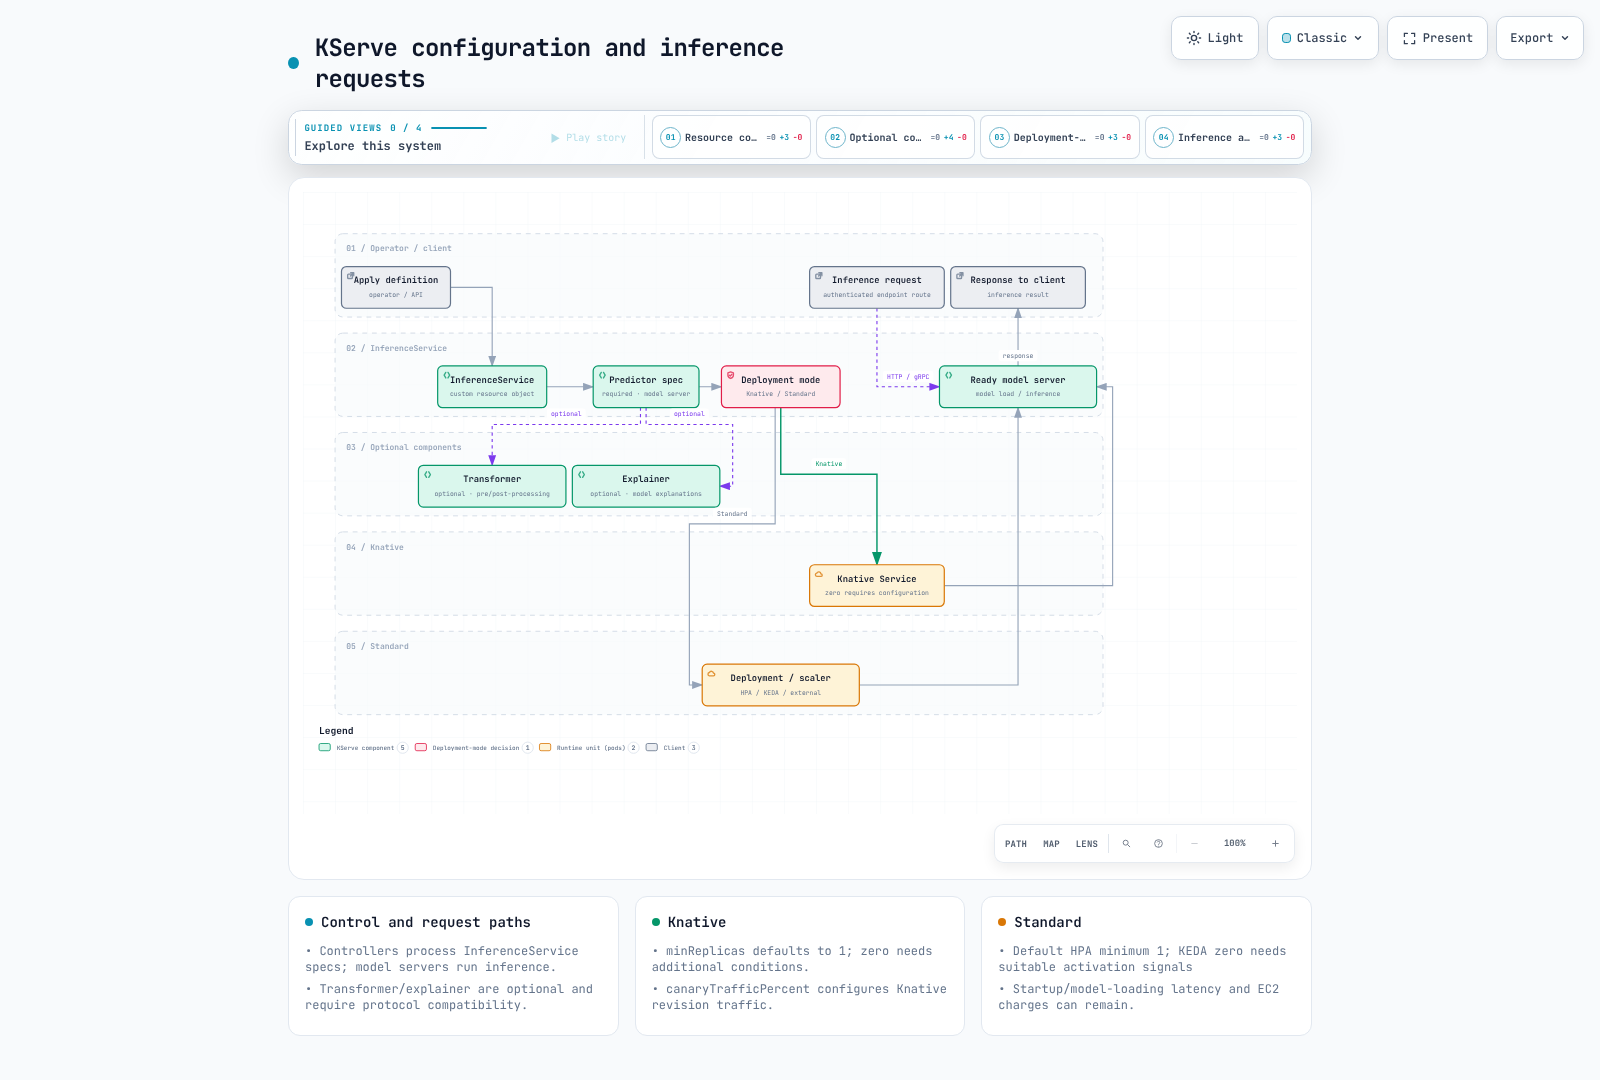
InferenceService には必須の predictor と任意の transformer/explainer があります。Predictor はモデルサーバーを構成し、transformer は前処理/後処理を提供し、explainer は説明リクエストを処理します。説明がすべての予測に自動的に付加されるわけではなく、ランタイム/プロトコルのサポートが重要です。
modelFormat、ServingRuntime、ファイルレイアウト/ライブラリバージョン、URI/認証情報、ポート/probe、およびリクエストプロトコルを一致させてください。URI だけでは、すべてのモデルをサービング可能にすることはできません。カスタムコンテナも、クライアント契約および KServe のルーティング/ヘルスチェック要件を満たす必要があります。
公式の runtime-config chart は、デフォルトではリソースを出力しません。kserve.servingruntime.enabled=true でレンダリングすると、12 個の ClusterServingRuntime が生成されます。カタログに存在することは、イメージの最新性、セキュリティサポート、またはモデル互換性を保証するものではありません。
TorchServe の プロジェクト告知では、新機能、バグ修正、セキュリティパッチの予定はないと述べられています。古いランタイムカタログに含まれていても、新規の本番利用における保守済みのデフォルトになるわけではありません。モデル形式と GPU 要件に対応する、保守済みランタイムを検証してください。
Deployment モード: Knative と Standard
0.18.0 の名前は Knative と Standard です。Serverless および RawDeployment の annotation 値は、これらの名前に正規化される非推奨のエイリアスです。serving.kserve.io/deploymentMode と、インストールされている inferenceservice-config を確認してください。コードのフォールバックは Standard ですが、ダウンロードした OCI resource chart のデフォルトは Knative です。用語だけからインストールのデフォルトを推測しないでください。
| 項目 | Knative | Standard |
|---|---|---|
| ワークロードリソース | Knative Service/Revision 経路 | Deployment/Service と選択した autoscaler |
| スケールダウン | KPA/ポリシーのサポートと minReplicas=0 があればゼロにできます | デフォルトの HPA 経路では少なくとも 1 つを維持します。KEDA は適切な外部アクティベーションシグナルでゼロをサポートできます |
| デフォルトの minReplicas | KServe のデフォルトは 1 です。Knative を選択するだけではゼロは有効になりません | HPA はリクエストされたゼロを少なくとも 1 に制限します |
| 依存関係 | Knative Serving/networking と選択した autoscaler | 選択した ingress/gateway、HPA メトリクスまたは KEDA など |
| 起動レイテンシー | ゼロから開始する際のスケジューリング/イメージ/モデルのロード | ウォームレプリカがあっても、再起動、rollout、スケールアウトには起動レイテンシーが発生します |
どちらのモードも、利用可能なレプリカやレイテンシー SLA を保証しません。モデルロード、readiness、容量、timeout、および復旧を検証してください。KEDA のゼロからのスケールには、実行中の Pod なしで観測可能なシグナルと、再アクティベーション経路が必要です。CPU/メモリメトリクスだけでは、リクエスト駆動のアクティベーションを意味しません。
Autoscaling とメトリクス
Knative KPA は concurrency/RPS をサポートし、Knative の HPA class は別の経路です。Standard は serving.kserve.io/autoscalerClass を通じて hpa、keda、または external/none を選択します。すべての Standard Deployment が HPA を作成するわけではありません。
CPU、external、またはサポートされる Pod メトリクスには、実際の metrics-server/adapter/provider の依存関係が必要です。GPU リクエストは GPU メトリクスを自動的に作成しません。レスポンス速度は観測間隔、安定化、モデルの動作に依存します。concurrency メトリクスが常に高速であるとは限りません。
段階的な更新と Canary トラフィック
このバージョンの canaryTrafficPercent は、Knative Revision のトラフィック分割経路で検証されました。KServe は、以前に rollout された revision と新しい revision を Knative Service のトラフィックターゲットとして設定し、Knative networking がリクエストを分散します。KServe controller は、すべての inference 呼び出しの proxy ではありません。
Standard Deployment の rolling update を、その revision パーセンテージルーティングと同一視しないでください。Standard での重み付きルーティングには、別途設計された service/gateway/mesh または rollout ツールと、明確な所有権が必要です。Istio traffic management または Argo Rollouts を使用する場合は、KServe 管理オブジェクトの所有権が競合しないようにしてください。
パーセンテージだけでは、品質の検証や promotion/rollback の自動化はできません。比較メトリクス、エラー/レイテンシー、保持された revision/モデルアーティファクト、およびルートの readiness を確認してください。
EKS 上の GPU Inference
Pod の nvidia.com/gpu リクエストにより、スケジューリング/デバイス割り当てが有効になります。実際の GPU inference には、互換性のある CUDA/driver、サーバーイメージ、モデルバックエンド、およびデバイス構成が必要です。Triton モデル構成またはフレームワークのデバイス選択を確認してください。GPU リクエストを行っても、CPU モデルが自動的に GPU に移行するわけではありません。
Karpenter は、適格な Pending Pod、NodePool、quota、および利用可能な容量に対してプロビジョニングを行います。KServe/Knative/HPA/KEDA の Pod スケーリングと EC2 のプロビジョニング/回収は、別個のループです。モデル Pod がゼロであっても、他のワークロードや中断ポリシーによりノードとコストが稼働し続ける可能性があります。
検証とソース
公式の 0.18.0 OCI CRD/resource/runtime-config chart をローカルで取得およびレンダリングし、スキーマ/構成を確認しました。モードのエイリアス化、HPA の最小値、KEDA ScaledObject、および Knative トラフィックのコードを確認しました。モデルのダウンロード/サービング、GPU、クラスター autoscaling、またはライブ canary リクエストは実行していません。
- 0.18.0 のモード名とデフォルト
- HPA の最小レプリカ処理
- KEDA ScaledObject の処理
- Knative トラフィックの処理
- 0.20.0 リリース
- 0.21.0 リリース(確認時点で最新)
次のステップ
モデルアーティファクトのデプロイと検証を別のステップとして扱いつつ、このサービング経路を Kubeflow シリーズのアーキテクチャ、Pipelines、Notebooks、Katib、および Trainer の章に接続してください。
クイズ
この章で学んだ内容を確認するには、トピッククイズに挑戦してください。