Part 1: Ray アーキテクチャ
レビュー基準: Ray 2.58.0 · 2026-09-12
ラボ環境のセットアップ
ローカルの例は、Python 3.12、ray==2.58.0、および numpy==2.2.6 で確認しました。タスク、actor、ObjectRef の確認には、GPU、学習済みモデル、Kubernetes は不要です。ダッシュボードなどの機能を有効にする場合は、関連する追加依存関係を別途確認してください。
この例では、2 個の論理 CPU と 80 MiB の object store を明示的に設定した後、Ray をシャットダウンします。Ray のリソース設定は、CPU/RAM 全体に対するオペレーティングシステムの制限ではありません。control プロセスと worker プロセスには追加のメモリが必要です。
Ray とは?
Ray Core は、リモート関数(task)、状態を持つリモートインスタンス(actor)、ObjectRef、ノードごとの object store を提供します。Train、Tune、Serve はこの基盤の上に構築されます。Core を共有していても、各ライブラリ独自の controller、retry、checkpoint、フレームワークの通信ロジックが不要になるわけではありません。
Core プリミティブ
Task
@ray.remote を適用した後は、f.remote(...) を使用して送信します。通常の f(...) として呼び出すのは誤りです。単一の戻り値を返す例では ObjectRef が生成され、ray.get() で読み取れます。
task をステートレスに呼び出しても、副作用のない純粋関数であることは保証されません。ファイルやデータベースの変更には、retry に備えた冪等性戦略が必要です。worker は再利用される可能性があります。偶発的に存続するモジュールグローバルの cache は、明示的な状態管理とは異なります。
Ray は依存関係を追跡します。upstream の ObjectRef を別の task にトップレベル引数として渡すと、その値の準備完了に対する依存関係が作成されます。task が必ずしも互いに独立しているとは限りません。
Actor
Actor.remote() はリモートインスタンスへの handle を作成し、handle.method.remote() はそのメソッドを送信します。そのインスタンスのメモリ内にある counter、connection、model は、複数の呼び出しで再利用できます。
これは自動的な永続ストレージではありません。2.58.0 では、max_restarts のデフォルト値は 0 です。restart を設定すると constructor は再実行されますが、アプリケーションの状態が自動的に復元されるわけではありません。checkpoint と recovery は個別に設計し、同期、async、threaded の actor における concurrency と順序付けを区別してください。
Object Store
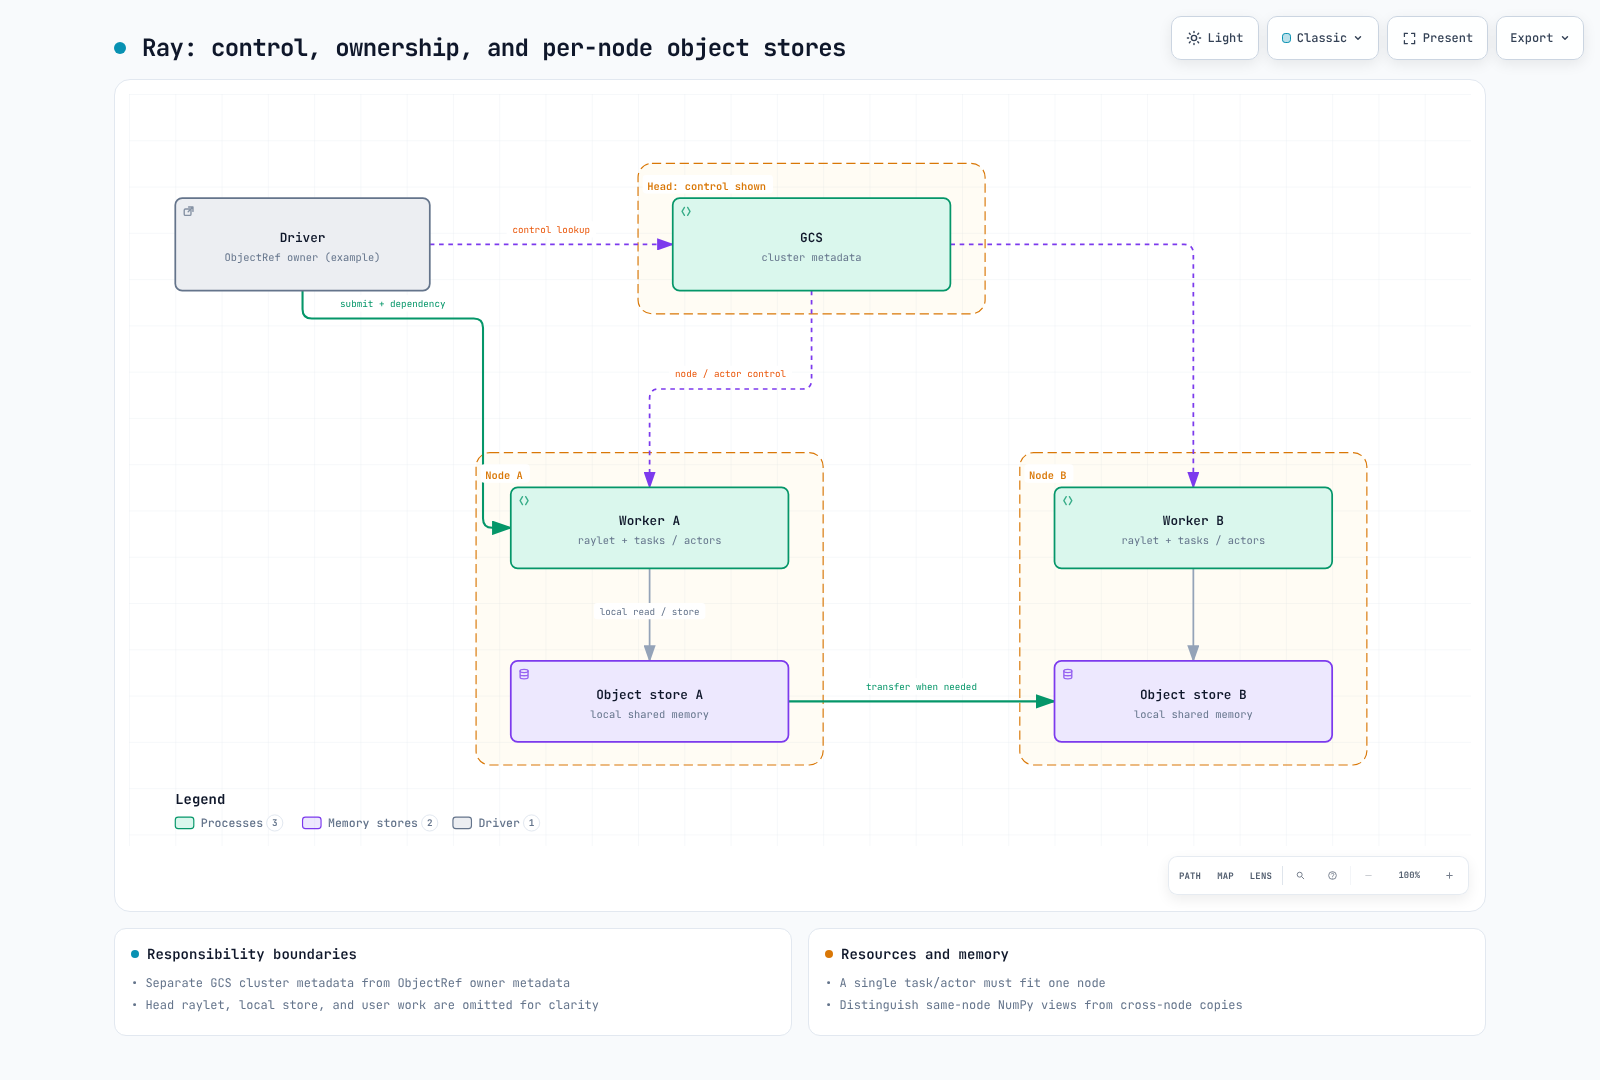
リモート値は不変であり、ノードローカルの object store に保存または複製できます。1 つの値への参照があっても、すべてのノードが 1 つの物理メモリ領域を共有するわけではありません。ノード間アクセスには、転送とシリアライズのコストが発生する場合があります。
同じノード上の NumPy array は、読み取り専用の共有メモリ view を通じて読み取れます。変更前にコピーしてください。これは、すべての Python object、ノード間転送、GPU tensor/model weight に対する zero-copy 動作を意味するものではありません。小さい値と大きい値では、異なる転送パスが使用されることもあります。
小規模なローカル例
これは API の動作を確認するものであり、学習パフォーマンスやベンチマークを確認するものではありません。
import ray
import numpy as np

try:
    ray.init(address="local", num_cpus=2, include_dashboard=False,
             object_store_memory=80 * 1024 * 1024)

    @ray.remote(num_cpus=1)
    def twice(value):
        return value * 2

    first = twice.remote(2)
    second = twice.remote(first)  # ObjectRef dependency
    assert ray.get(second, timeout=15) == 8

    @ray.remote(num_cpus=1)
    class Counter:
        def __init__(self):
            self.value = 0
        def increment(self):
            self.value += 1
            return self.value

    counter = Counter.remote()
    assert ray.get([counter.increment.remote(),
                    counter.increment.remote()], timeout=15) == [1, 2]
    ref = ray.put(np.arange(256_000, dtype=np.int64))
    array = ray.get(ref, timeout=15)
    assert not array.flags.writeable
finally:
    ray.shutdown()
小規模な単一ノードの演習だけでは、複数ノードでの障害回復、GPU メモリ共有、ネットワークパフォーマンスを確立できません。
クラスターアーキテクチャ: Head Node と Worker Node
head は、Global Control Service (GCS) を含むクラスター制御コンポーネントを実行します。Raylet、worker プロセス、ローカル object store は、head と worker 上の実行およびデータ移動に関与します。head は、ユーザー task の配置を制限するために 0 個の論理 CPU を公開できます。worker と同じコンピューティングリソースを提供する必要はありません。
Driver はトップレベルのアプリケーションを実行します。必ずしも head 上で実行する必要はなく、配置は送信方法に依存します。autoscaler も構成されたデプロイメントコンポーネントであり、すべてのローカル ray.init() が自動的に worker を追加プロビジョニングすることを保証するものではありません。
GCS は、actor、node、placement group などのクラスター metadata を管理します。これをすべての object metadata の集中管理者として説明してはいけません。 元の ObjectRef を作成したプロセスが object owner であり、値を計算する worker とは異なる場合があります。
リソース配置
Ray は候補を選択する際にクラスターの状態を考慮しますが、各 task/actor は実行可能な 1 つの node に収まる必要があります。それぞれ空き CPU が 1 つある 2 つの node で、単一の 2 CPU task を共同実行することはできません。実行可能性、可用性、データローカリティ、配置/label/affinity の制約がすべて重要です。
論理 CPU/GPU リソースは、admission と scheduling の指針になります。num_cpus=1 を指定しても、プロセス内のすべての OS thread が 1 つの物理 core に強制的に固定されるわけではありません。container の request/limit とライブラリの thread 数は個別に設定してください。
障害回復と上位レベルのライブラリ
GCS はデフォルトではメモリ内にあります。head 障害後の recovery には、追加の durable-backend 設定が必要です。2.58.0 のドキュメントでは、サポート対象の外部 Redis と、組み込み RocksDB alpha が区別されています。GCS metadata を回復しても、すべての actor のアプリケーション状態や object 値が復元されるわけではありません。
object recovery は、ownership、lineage、retry/reconstruction の適格性に依存します。ray.put() の値を再計算可能な task 出力と同一視したり、object spilling を長期バックアップと同一視したりしないでください。
Train、Tune、Serve は Core を再利用しつつ、training checkpoint、trial scheduling、serving controller などのポリシーを追加します。フレームワークの collective やその他の training 通信を、すべて 1 つの object-store パスを経由するトラフィックとして説明することはできません。
Kubernetes でこれが重要な理由
KubeRay は、RayCluster、RayJob、RayService などの CR を Ray Pod および関連リソースに reconcile します。Ray の task/actor scheduling、Kubernetes Pod 配置、Karpenter などのツールによる実際の EC2 プロビジョニングは、別々のレイヤーです。KubeRay は、アプリケーション向けに Train、Tune、Serve を自動的に選択する dispatcher ではありません。
主な情報源
次へ: KubeRay · メインページ · クイズ