パート1: Kubernetes 上の Spark の基礎
レビュー基準: Spark 4.2.0、Kubernetes 1.34以降。例の image は Java 21 を使用
最終確認: 2026年9月12日
Cluster mode と client mode
Kubernetes では Spark の両方のデプロイモードを利用できます。Client mode は Spark 2.4 からサポートされており、Notebook 専用ではありません。
| Mode | Driver の配置場所 | 運用上の影響 |
|---|---|---|
| Cluster | submission のために作成される driver Pod | submitter には API access が必要。driver 用に専用のサービスアカウント/RBAC が必要 |
| Client | Pod 内または host 上で動作する submitter application | Executor が driver の通知する RPC/block-manager endpoint に接続できる必要があり、driver を稼働させ続ける |
Kubernetes API に到達できても、executor から driver への接続が成立するとは限りません。Client-mode の network では、安定した Service/hostname と固定 port が必要になる場合があります。Driver が Pod 内で稼働する場合は、executor の owner-reference garbage collection に実際の driver Pod 名を設定してください。Kubernetes 外で稼働する driver に Pod owner をでっち上げないでください。
何が何をスケジュールするか
API server は認証と admission を処理し、API object を保存します。Kubernetes scheduler は Pod を配置し、node kubelet が container を起動します。Spark driver は executor Pod を要求し、登録済み executor 上で stage/task を調整する自身の scheduler を動かします。これらは別のレイヤーです。
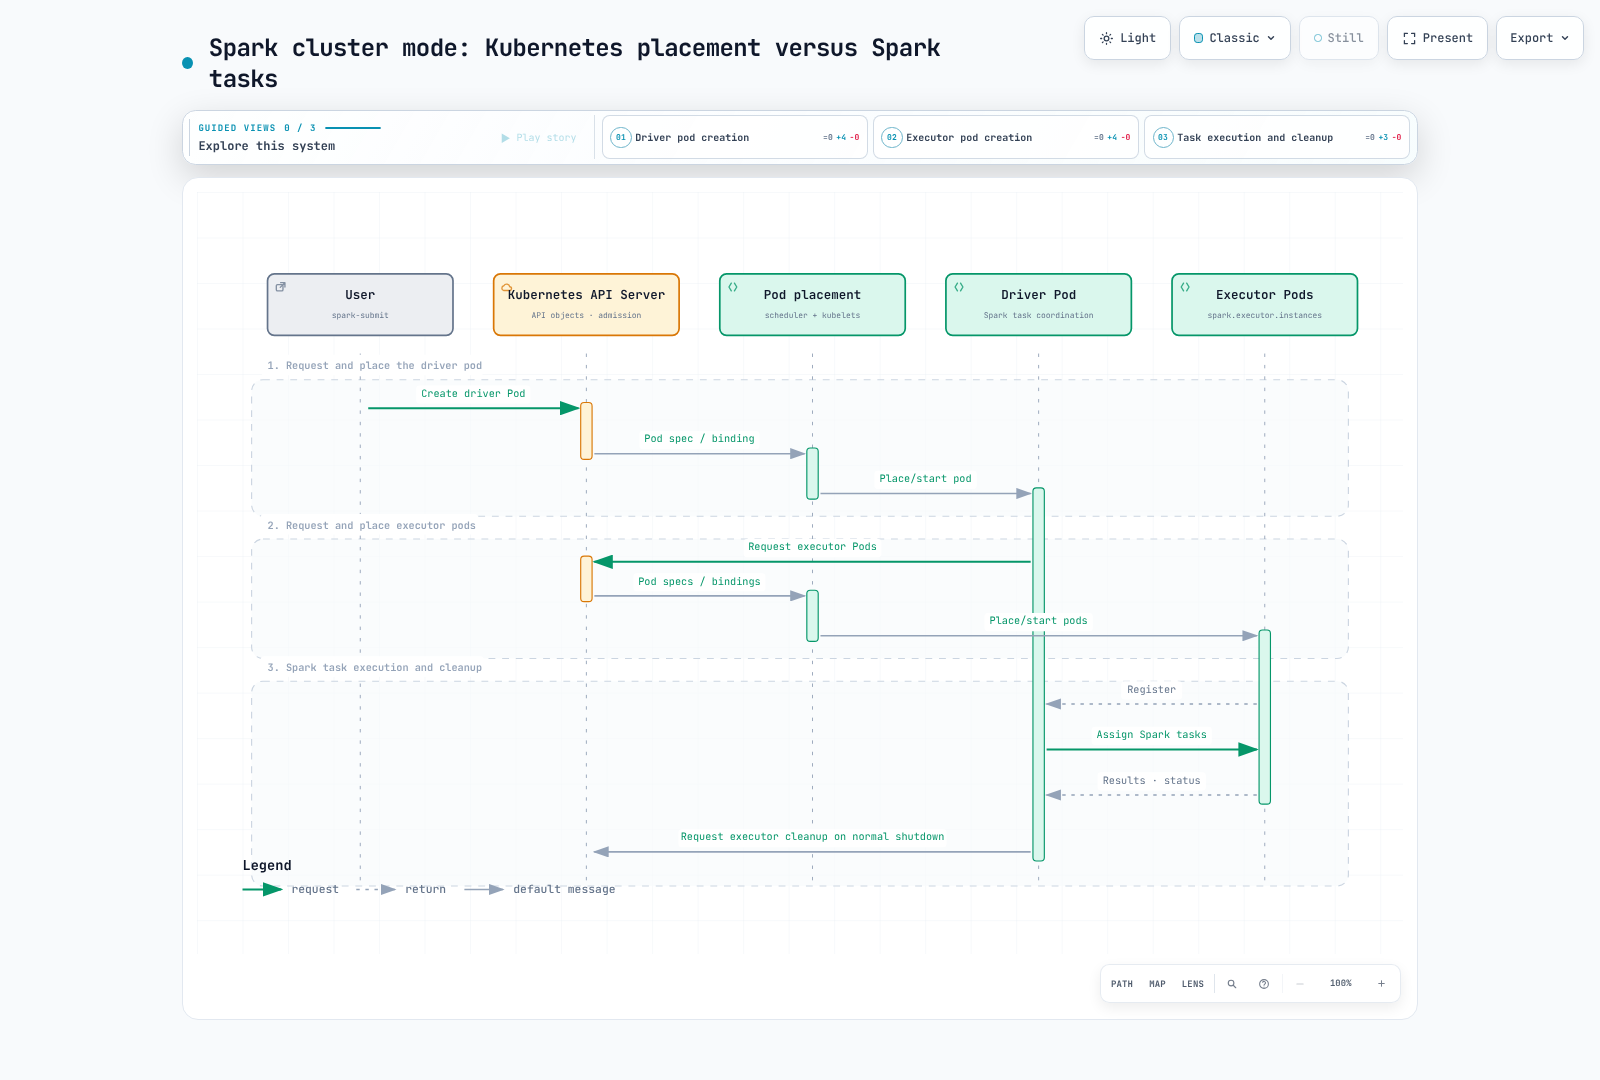
- Submitter が driver Pod と関連リソースを要求します。
- Kubernetes が driver を配置して起動し、driver が executor Pod を要求します。
- Kubernetes が executor を配置して起動し、executor は driver に登録します。
- Driver が Spark task を割り当て、executor が実行して結果/状態を報告します。
- 正常終了時、Spark は設定に応じて executor を cleanup します。完了/失敗した driver Pod が log のために残る場合があります。すべてが直ちに削除されると考えず、失敗時の挙動と owner reference を確認してください。
YARN や Spark Standalone の独立した control layer は不要になりますが、Kubernetes capacity、node、storage、network、image の運用は引き続き必要です。
Cluster mode の具体例
前提条件: ローカルに Spark 4.2.0、互換性のある kubectl と最新の kubeconfig context、Kubernetes 1.34以降、namespace の capacity と image access。Submitter の API credential と、クラスター内 driver の RBAC は別です。SparkPi の例に AWS data permission は不要です。S3 workload には、選択した workload identity と互換性のある Hadoop/AWS library も必要です。
Namespace administrator が rbac.yaml をレビューして適用します。
apiVersion: v1
kind: Namespace
metadata:
  name: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-driver
  namespace: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-executor
  namespace: spark-jobs
automountServiceAccountToken: false
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: spark-driver
  namespace: spark-jobs
rules:
- apiGroups:
  - ''
  resources:
  - pods
  - services
  - configmaps
  verbs:
  - create
  - get
  - list
  - watch
  - delete
  - patch
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: spark-driver
  namespace: spark-jobs
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: spark-driver
subjects:
- kind: ServiceAccount
  name: spark-driver
  namespace: spark-jobs
この role は、動的に PVC を作成しない基本例に対応します。追加の volume/resource 管理機能には、その機能に応じた範囲限定 permission が必要な場合があります。Executor Pod は API token の automount を無効にした別のサービスアカウントを使います。driver が Pod を作成できる namespace では、信頼できる job code/submitter だけを実行してください。RBAC だけでは、信頼できない application code を sandbox 化できません。
以下は kubectl apply で適用する単独 Pod ではなく、Pod template として保存します。Spark が image、command などの field を設定します。
Driver template、driver-template.yaml:
apiVersion: v1
kind: Pod
metadata:
  name: spark-driver-template
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    runAsGroup: 185
    seccompProfile:
      type: RuntimeDefault
  containers:
  - name: spark-kubernetes-driver
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
Executor template、executor-template.yaml:
apiVersion: v1
kind: Pod
metadata:
  name: spark-executor-template
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    runAsGroup: 185
    seccompProfile:
      type: RuntimeDefault
  containers:
  - name: spark-kubernetes-executor
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
  automountServiceAccountToken: false
terminationGracePeriodSeconds: 60ファイルは送信側の processからアクセス可能である必要があります。Cluster mode では Spark が executor template を driver 内に mount します。Spark が template の field の一部を上書きするため、template、operator webhook、Spark 設定を組み合わせる場合は、生成された Pod を調べてください。
#!/bin/bash
set -euo pipefail
# Run in the directory containing driver-template.yaml and executor-template.yaml.
KUBE_CONTEXT="$(kubectl config current-context)"
KUBE_API_URL="$(kubectl --context "$KUBE_CONTEXT" config view --minify -o jsonpath='{.clusters[0].cluster.server}')"
case "$KUBE_API_URL" in https://*) ;; *) echo "Expected an HTTPS Kubernetes API URL" >&2; exit 1;; esac
SPARK_APP_NAME="spark-pi-$(date -u +%Y%m%d%H%M%S)"
spark-submit \
  --master "k8s://${KUBE_API_URL}" \
  --deploy-mode cluster \
  --name "$SPARK_APP_NAME" \
  --class org.apache.spark.examples.SparkPi \
  --conf "spark.kubernetes.context=$KUBE_CONTEXT" \
  --conf spark.kubernetes.namespace=spark-jobs \
  --conf spark.kubernetes.container.image=spark:4.2.0-scala2.13-java21-ubuntu \
  --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark-driver \
  --conf spark.kubernetes.authenticate.executor.serviceAccountName=spark-executor \
  --conf "spark.kubernetes.driver.pod.name=$SPARK_APP_NAME-driver" \
  --conf spark.kubernetes.driver.podTemplateFile=driver-template.yaml \
  --conf spark.kubernetes.executor.podTemplateFile=executor-template.yaml \
  --conf spark.kubernetes.executor.terminationGracePeriodSeconds=60s \
  --conf spark.driver.cores=1 \
  --conf spark.driver.memory=1g \
  --conf spark.kubernetes.driver.limit.cores=1 \
  --conf spark.executor.cores=1 \
  --conf spark.executor.memory=1g \
  --conf spark.kubernetes.executor.limit.cores=1 \
  --conf spark.executor.instances=3 \
  local:///opt/spark/examples/jars/spark-examples.jar 10
kubectl -n spark-jobs logs "$SPARK_APP_NAME-driver"
kubectl -n spark-jobs get pod "$SPARK_APP_NAME-driver" -o jsonpath='{.status.phase}{"\n"}'
Submission script を実行する前に rbac.yaml を適用してください。version が固定された公式 image には spark-examples.jar の symlink が含まれます。local:/// は artifact が container 内にすでにあるという意味で、ローカル laptop 上の file を upload する意味ではありません。必要に応じて通常の software supply-chain 手順に従い image を mirror/pin してください。helper script は新しい driver 名と、選択された kubeconfig context を使います。障害調査に備えて、これらの値を記録してください。
3つの executor を固定で要求していますが、quota、admission、scheduling、image pull、node capacity によって Pod が Pending のままになることがあります。driver/executor の event と log を確認してください。spark-submit の実行だけでは task 成功の証拠になりません。
Resource は request、limit、task slot
| Spark 設定 | Kubernetes/default profile への影響 |
|---|---|
spark.driver.cores | 上書きしない限り driver CPU request |
spark.executor.cores | Executor の task capacity と既定 CPU request |
spark.kubernetes.{driver,executor}.request.cores | Kubernetes CPU request を上書きするが、executor の Spark task-slot 設定は変えない |
spark.kubernetes.{driver,executor}.limit.cores | CPU limit を明示する。cores を設定しても CPU limit が自動的に設定されるわけではない |
| Driver memory | request/limit には heap と、設定/計算された overhead を含む |
| Executor memory | request/limit には heap、overhead、該当する off-heap/PySpark memory を含む |
この JVM の例では、heap 1 GiB に既定の最小 overhead 384 MiB を加え、memory request/limit は 1,408 MiB になります。これは確認済みの既定値に基づく計算であり、あらゆる job に共通のサイズではありません。Python/native memory と独自 ResourceProfile は別途確認が必要です。Task capacity より低い CPU request では競合が起きる可能性があります。request の変更は、Spark executor が実行できる task 数を変えることとは異なります。
Dynamic Resource Allocation
Spark DRA は、task の backlog/idle 状態に応じてexecutor 数を変更します。デバイス向けの Kubernetes DRA や、Pending Pod に対応する node autoscaler とは別の機能です。
Kubernetes 上の標準 Spark は、YARN 形式の external shuffle service をサポートしません。Shuffle tracking はサポートされる選択肢ですが、Spark にある唯一の方法ではありません。decommission による shuffle 保持や、条件に合う信頼性の高い ShuffleDataIO 実装も代替手段で、それぞれ固有の条件があります。
Shuffle-tracking profile の例:
spark.dynamicAllocation.enabled=true
spark.dynamicAllocation.shuffleTracking.enabled=true
spark.dynamicAllocation.minExecutors=2
spark.dynamicAllocation.initialExecutors=3
spark.dynamicAllocation.maxExecutors=20
spark.kubernetes.allocation.batch.size=5
これらの property は --conf または properties file で渡します。Shuffle tracking は Spark 3.0 で導入され、4.2ではすでに既定で有効です。明示するのは選択を記録するためです。2つの flag を常に明示しなければならないという古い説明は正しくありません。
Tracking は、稼働中の shuffle data を保持している executor を残そうとします。設定した tracking/cached-executor の idle timeout、強制終了、node 障害によって再計算が必要になることがあります。永続的な共有ストレージではありません。複数の保持機能を重ねて有効にすると executor の解放が遅れる場合があるため、相互作用をテストしてください。
初期 executor 数は minExecutors、initialExecutors、既存の spark.executor.instances の値を考慮して決まります。この例では固定数3と初期数3が一致しています。min=2 だから最初に2つ起動する、という意味ではありません。
spark.kubernetes.allocation.batch.size は Pod request の batch 数を制御します。EC2 の scale policy を直接設定するものではありません。API throttling、Pod allocation のタイミング、ResourceQuota、scheduling 制約、node の provision はそれぞれ別の要素です。
Graceful decommission は best effort
これらの設定により、executor/block-manager の decommission と、対象となる RDD/shuffle block の移行を有効にします。
spark.decommission.enabled=true
spark.storage.decommission.enabled=true
spark.storage.decommission.rddBlocks.enabled=true
spark.storage.decommission.shuffleBlocks.enabled=true
spark.kubernetes.executor.terminationGracePeriodSeconds=60s
選択した Spark 4.2 Kubernetes 経路では、decommission を有効にすると spark.kubernetes.decommission.script を実行する preStop hook(既定値は /opt/decom.sh)が挿入されます。公式 image にはこの script が含まれます。Script は executor JVM を見つけて SIGPWR を送信し、待機します。Spark の既定 decommission signal は PWR です。したがって通常の Pod 終了はこの hook を介します。通常の SIGTERM だけで必ずデータ移行が行われると想定しないでください。
Custom image には正常に動作する script と必要な tool が含まれている必要があります。signal を変更する場合は script 側も合わせます。Spark が template の lifecycle 設定を上書きすることがあります。実際の hook を調べ、計画的な scale-down と interruption の両方をテストしてください。
Submission では spark.kubernetes.executor.terminationGracePeriodSeconds=60s を明示します。Spark 4.2 は Pod template の値をこの設定で上書きします。既定値は30秒です。そのため、template に terminationGracePeriodSeconds: 60 だけ設定しても不十分です。Grace period には preStop の実行時間も含まれます。これは最大の猶予時間であり、移行完了を保証したり、元の Spot termination deadline を遅らせたりするものではありません。正常な移行先 executor、disk/network capacity、時間、設定済み fallback storage が必要です。Node が突然失われたり、強制削除されたりすると、この機会自体が失われる可能性があります。Spark の dynamic-allocation delete 経路を含む明示的な deletion-grace 設定によって、利用できる猶予時間が変わる場合もあります。
これらの flag は、失敗した driver を再起動したり、application checkpoint を置き換えたり、end-to-end の exactly-once output を保証したりするものではありません。再計算可能な中間 block と永続的な入力/出力を区別し、適切な復旧を計画してください。
参考資料と検証
Driver を loopback に bind し、UI を無効にしたローカル SparkPi job は成功しました。Native Spark 4.2 の feature-step test で、memory の対応付け、CPU limit の既定動作、Kubernetes client を作成せずに decommission hook が自動挿入されることを確認しました。これらの確認は、EKS での送信、RBAC/CNI の適用、実際の data 移行完了、AWS data access を証明するものではありません。
- Spark 4.2.0 on Kubernetes
- Spark 4.2.0 の設定
- Spark 4.2.0 の dynamic allocation の代替方式
- Driver resource の対応実装
- Executor resource と decommission hook
- 公式 decommission script
- 公式 Spark image tag