パート 1: Kafka の基礎
最終更新: September 12, 2026. Apache Kafka 4.3.1、Strimzi 1.2.0 でサポート。 検証: 19 項目のチェックで、Kafka 4.3.1 の実際の設定クラスを用いて有効性・デフォルト値・競合を確認しました。broker や EKS クラスターは起動していません。
1. Broker、Topic、Partition
Kafka はイベントを partition ログに保存し、producer と consumer がそれぞれ独立して進行できるようにします。1 つの broker は複数の topic の partition replica を保存できます。topic 全体を保持する必要はありません。
| 用語 | 意味 |
|---|---|
| Broker | データの replica を保存し、リクエストを処理するサーバーの役割 |
| Topic | 論理的なイベントのカテゴリ |
| Partition | 順序付きの追記ログ。retention と compaction によってレコードが削除されることがある |
| Offset | グローバル ID ではなく、1 つの partition 内での位置。削除やトランザクションによって見かけ上の欠番が生じることがある |
| Replication factor | partition の replica 数。作成/再割り当てのメタデータを通じて管理される |
| Leader / follower | leader が書き込みを処理し、follower が複製する。follower fetching を設定すれば consumer の読み取りを担うこともできる |
| ISR | leader と十分に同期している replica。leader 自身も含まれる |
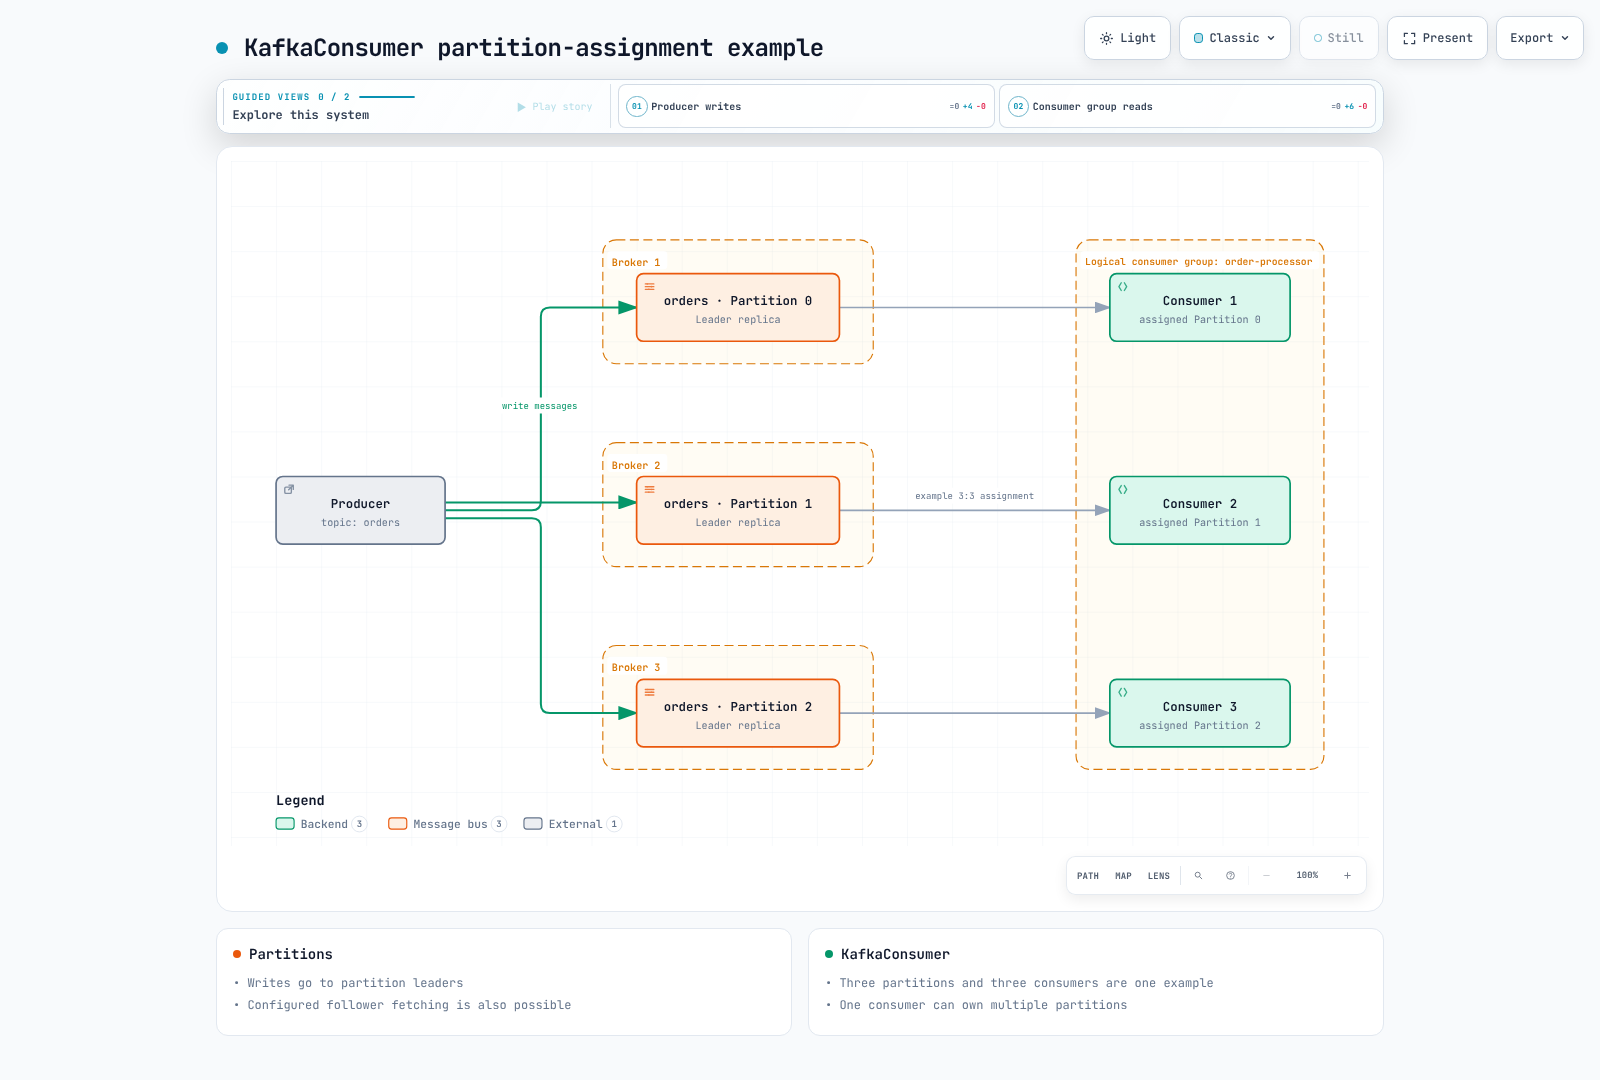
3:3 の図はあくまで一例です。KafkaConsumer の subscribe() による自動グループ割り当てでは、1 つの partition は同時に 1 つのグループメンバーにのみ割り当てられ、1 つのメンバーが複数の partition を保持することがあります。手動の assign() の利用は別に管理されます。複数のグループが同じ topic を独立して消費できます。Kafka 4.x の Share Groups/KafkaShareConsumer は、異なる共有および確認応答モデルを使用します。
2. 順序と Partition Key
Kafka はpartition 内でのログ順序を定義します。topic 全体のグローバルな順序や、ビジネスイベントのタイムスタンプ順を自動的に保証するものではありません。
同一 key を一貫して同じルーティング先に振り分けるには、シリアライズ、パーティショニング、partition 数の一貫性が必要です。partition 数を増やすと、ハッシュベースのマッピングが変わることがあります。カスタム partitioner や明示的に指定した partition もルーティングに影響します。複数の producer、リトライ、アプリケーション側の並列処理には、それぞれ独自の順序保証の取り決めが必要です。
key が null の場合のルーティングは、クライアント/partitioner に依存します。key のカーディナリティが高いだけでは負荷の均等化は保証されません。ごく一部の極端に頻出する key があれば、依然として hot partition が発生し得ます。
次のコマンドは、すでに到達可能で broker が 3 台以上あるクラスターに topic を作成します。認証付き listener の場合は --command-config client.properties を追加してください。後述する単一ノードの学習用構成にそのまま適用しないでください。
: "${DOCS_BOOTSTRAP:?Set the existing Kafka bootstrap host:port}"
kafka-topics.sh --create --bootstrap-server "$DOCS_BOOTSTRAP" \
  --topic orders --partitions 6 --replication-factor 3 \
  --config min.insync.replicas=2
3. Consumer Group と Offset
partition ベースのグループでは、consumer の数が partition 数を上回るとアイドル状態のメンバーが生じます。producer のスループット、ディスク、ネットワーク、アプリケーション処理も並列度に影響するため、partition 数だけでスループットを予測することはできません。
グループプロトコルを区別する
Kafka 4.3 の Java consumer では、group.protocol のデフォルトは classic です。
| 選択肢 | 割り当てとタイムアウト |
|---|---|
classic | クライアント側 assignor と session.timeout.ms / heartbeat.interval.ms |
consumer | サーバー側 assignor と broker の group.consumer.session.timeout.ms / group.consumer.heartbeat.interval.ms |
classic の eager rebalance は、広い範囲の割り当てを一度に取り消します。CooperativeStickyAssignor は、再割り当てが必要な partition を段階的に移動します。新しい consumer プロトコルもサーバー側で段階的な調整(reconciliation)を行います。すべての rebalance が必ずグループ全体を停止させるわけではありません。classic のクライアント assignor やタイムアウトの前提を、新しいプロトコルに持ち込まないでください。
max.poll.interval.ms のデフォルトは 300000 ms です。static membership(group.instance.id)を使用している場合、これを超えても即座に partition が再割り当てされるわけではありません。consumer は heartbeat を停止し、適用される session timeout も再割り当てに影響します。
Offset とビジネス処理の完了
コミットされた offset は、一般に次に読み取る位置を示します。クライアントの fetch 位置と、外部で完了した処理は別の事実です。非同期/並列処理では、処理が未完了のレコードを越えて offset をコミットしないでください。
| 方式 | 意味と考慮点 |
|---|---|
| 自動コミット | enable.auto.commit=true、デフォルト間隔 5000 ms。ビジネス処理の完了を判断するものではない |
commitSync() | 呼び出しの完了を待つ。レイテンシへの影響はバッチングと頻度に依存する |
commitAsync() | コールバックで失敗/進捗を追跡する。古い offset を無闇にリトライして、コミット済みの進捗を巻き戻さないこと |
処理前にコミットすると障害時に処理が失われる可能性があり、処理後にコミットすると復旧時に副作用が繰り返される可能性があります。障害、再起動、rebalance を、アプリケーションの出力と合わせてテストしてください。
4. Exactly-Once の適用範囲
enable.idempotence は、リトライ時に同一 producer の同一送信がログに重複して書き込まれることを防ぎます。アプリケーションが同じビジネスイベントを新たな送信として投入する場合の、汎用的な重複排除キーではありません。
Kafka から Kafka への処理では、出力レコードと次の入力 offset を同一トランザクションでコミットし、consumer は read_committed で読み取るようにします。transactional.id の文字列を設定するだけで、その処理ロジックが実装されるわけではありません。外部のデータベースや API には、sink 側のトランザクション、冪等性、復旧に関する別個の取り決めが必要です。
producer.properties
bootstrap.servers=127.0.0.1:19092
key.serializer=org.apache.kafka.common.serialization.StringSerializer
value.serializer=org.apache.kafka.common.serialization.StringSerializer
acks=all
enable.idempotence=true
transactional.id=orders-writer-1
max.in.flight.requests.per.connection=5
delivery.timeout.ms=120000
consumer.properties
bootstrap.servers=127.0.0.1:19092
key.deserializer=org.apache.kafka.common.serialization.StringDeserializer
value.deserializer=org.apache.kafka.common.serialization.StringDeserializer
group.id=order-processor
group.protocol=consumer
enable.auto.commit=false
isolation.level=read_committed
max.poll.interval.ms=300000トランザクション処理には、initTransactions()、beginTransaction()、出力の送信、sendOffsetsToTransaction(...)、commitTransaction()、および abort/復旧の処理が含まれます。同時に動作する producer には異なる transactional ID が必要です。論理的な writer の安定した再起動と fencing の挙動を設計してください。
明示的な冪等性には acks=all、retries>0、max.in.flight.requests.per.connection<=5 が必要です。競合すると ConfigException が発生します。暗黙のデフォルト冪等性は、競合する設定によって無効化されることがあります。retries の値を大きくしても、delivery.timeout.ms などの期限を上書きすることはできません。
5. KRaft メタデータ
KRaft は Kafka 2.8 で early access として登場し、3.3 で production ready となり、Kafka 4.0 で ZooKeeper が削除された後は唯一のモードとなりました。専用の controller プロセスは broker のデータトラフィックを処理する必要がないため、controller は必ずしもデータ broker の部分集合ではありません。
controller の voter がメタデータ Raft ログを複製し、そのうち 1 つが active controller になります。本番環境では一般に 3 台または 5 台の voter が使われます。偶数構成でも過半数は計算可能ですが、同じ障害耐性であれば奇数構成のほうがリソースを効率的に使えます。
__cluster_metadata は内部のメタデータログの名前であり、KafkaProducer/KafkaConsumer で管理する通常のアプリケーション topic ではありません。ZooKeeper がなくなっても、controller quorum、ストレージ、アップグレード、モニタリングに関する責任がなくなるわけではありません。
動的 quorum と静的 quorum
動的 quorum では controller.quorum.bootstrap.servers を検出用のシードとして使用し、これは voter のメンバーシップではありません。初期のストレージフォーマットと quorum のブートストラップでは、クラスター ID、ディレクトリ ID、初期 voter を一致させる必要があります。変更にはサポートされている controller の追加/削除手順を使用してください。
静的な controller.quorum.voters は Kafka 4.3.1 でも引き続きサポートされています。動的 quorum ではこれを設定しないでください。シードアドレスを変更するだけでは、静的 quorum が自動的に移行されることはありません。
このファイルは HA ではなく、単一ノードのローカル学習用です。loopback の PLAINTEXT listener を使用します。起動前に、新しいデータディレクトリには適切なストレージフォーマット/ブートストラップ手順が必要です。既存の Kafka データを不用意にフォーマットしないでください。
combined-lab.properties
# Local, single-node configuration for learning; not an HA deployment.
process.roles=broker,controller
node.id=1
controller.quorum.bootstrap.servers=127.0.0.1:19093
listeners=BROKER://127.0.0.1:19092,CONTROLLER://127.0.0.1:19093
advertised.listeners=BROKER://127.0.0.1:19092,CONTROLLER://127.0.0.1:19093
listener.security.protocol.map=BROKER:PLAINTEXT,CONTROLLER:PLAINTEXT
controller.listener.names=CONTROLLER
inter.broker.listener.name=BROKER
log.dirs=./kafka-lab-data
# Single-node internal-topic settings are for this lab only.
offsets.topic.replication.factor=1
transaction.state.log.replication.factor=1
transaction.state.log.min.isr=1
share.coordinator.state.topic.replication.factor=1
share.coordinator.state.topic.min.isr=1
カスタムの BROKER listener には、明示的なプロトコルマッピングが必要です。Kafka 4.3.1 は、該当する構成において controller 専用のデフォルト CONTROLLER listener に PLAINTEXT マッピングを補うことができます。マッピング行がないからといって、すべての controller 構成が無効になるわけではありません。
EKS では、パート 2 で Strimzi が生成する設定、証明書、ストレージを使用してください。Operator が管理する Pod の server.properties を直接編集しないでください。本番の listener には、必要な TLS、認証、認可を設定してください。
6. レプリケーション、書き込み可用性、耐久性
RF=3 だけでは、任意の 2 台の broker 障害に対してすべてのデータが残ることは保証されません。実際のレプリケーションの進捗、確認応答時点の ISR、leader 選出の対象条件、ストレージ/ネットワーク障害、controller quorum を考慮してください。
3 つの replica すべてが最初は健全な ISR に属している場合、min.insync.replicas=2 と acks=all を使用する partition は、他の条件が満たされている限り、broker 1 台の障害後も 2 つの ISR メンバーで動作を継続できます。それでも leader の切り替えによってエラーやリトライが発生することはあります。最小 ISR を下回ると書き込みは失敗または拒否され、エラーの詳細はタイミングによって異なります。
| acks | 確認応答 | 解釈 |
|---|---|---|
0 | broker の応答を待たない | 保存は未確認。返される offset は -1 |
1 | leader が記録後に応答 | follower のレプリケーション前に leader を失うリスクがある |
all / -1 | 現在の ISR 全体を待つ | 最小 ISR、レプリケーション、leader 選出ポリシーと合わせて評価する |
acks=all は、すべてのレコードについて全ディスクで fsync が完了したことを意味しません。また、acks だけでスループットや p99 の優劣が決まるわけでもありません。同等の負荷、バッチング、ネットワーク条件で確認応答のコストを測定してください。
最小 ISR は次のように変更できます。replication factor 自体の変更には replica の再割り当てが必要で、replication.factor を通常の topic 設定として追加するものではありません。
kafka-configs.sh --bootstrap-server "$DOCS_BOOTSTRAP" \
  --alter --entity-type topics --entity-name orders \
  --add-config min.insync.replicas=2