EKS上のClickHouse: 計測済みベンチマーク
記録されたテスト環境: ClickHouse 24.8(計測時。24.x系列はサポート終了。テスト環境のバージョン注記を参照)、Kubernetes 1.36(Amazon EKS) 最終更新日: October 12, 2026
ベンチマーク記事では「ClickHouseは高速」とよく言われますが、デフォルトのgp3ボリュームを使う一般的なEKSノードで測定した数値を見つけるのは意外に困難です。このドキュメントでは、意図的に控えめな環境(4 vCPUノードと、初期設定のgp3 100 GiBボリューム)にKubernetesログ1億行を読み込ませ、動作を測定します。ここに示すのは過去に記録した結果です。このページには元のquery_log全体、すべての正確なクエリ、キャッシュ状態は含まれていないため、同じ数値になる保証はありません。以下の再実行例では、正確なSQL、設定、バージョン、生の結果を保存してください。
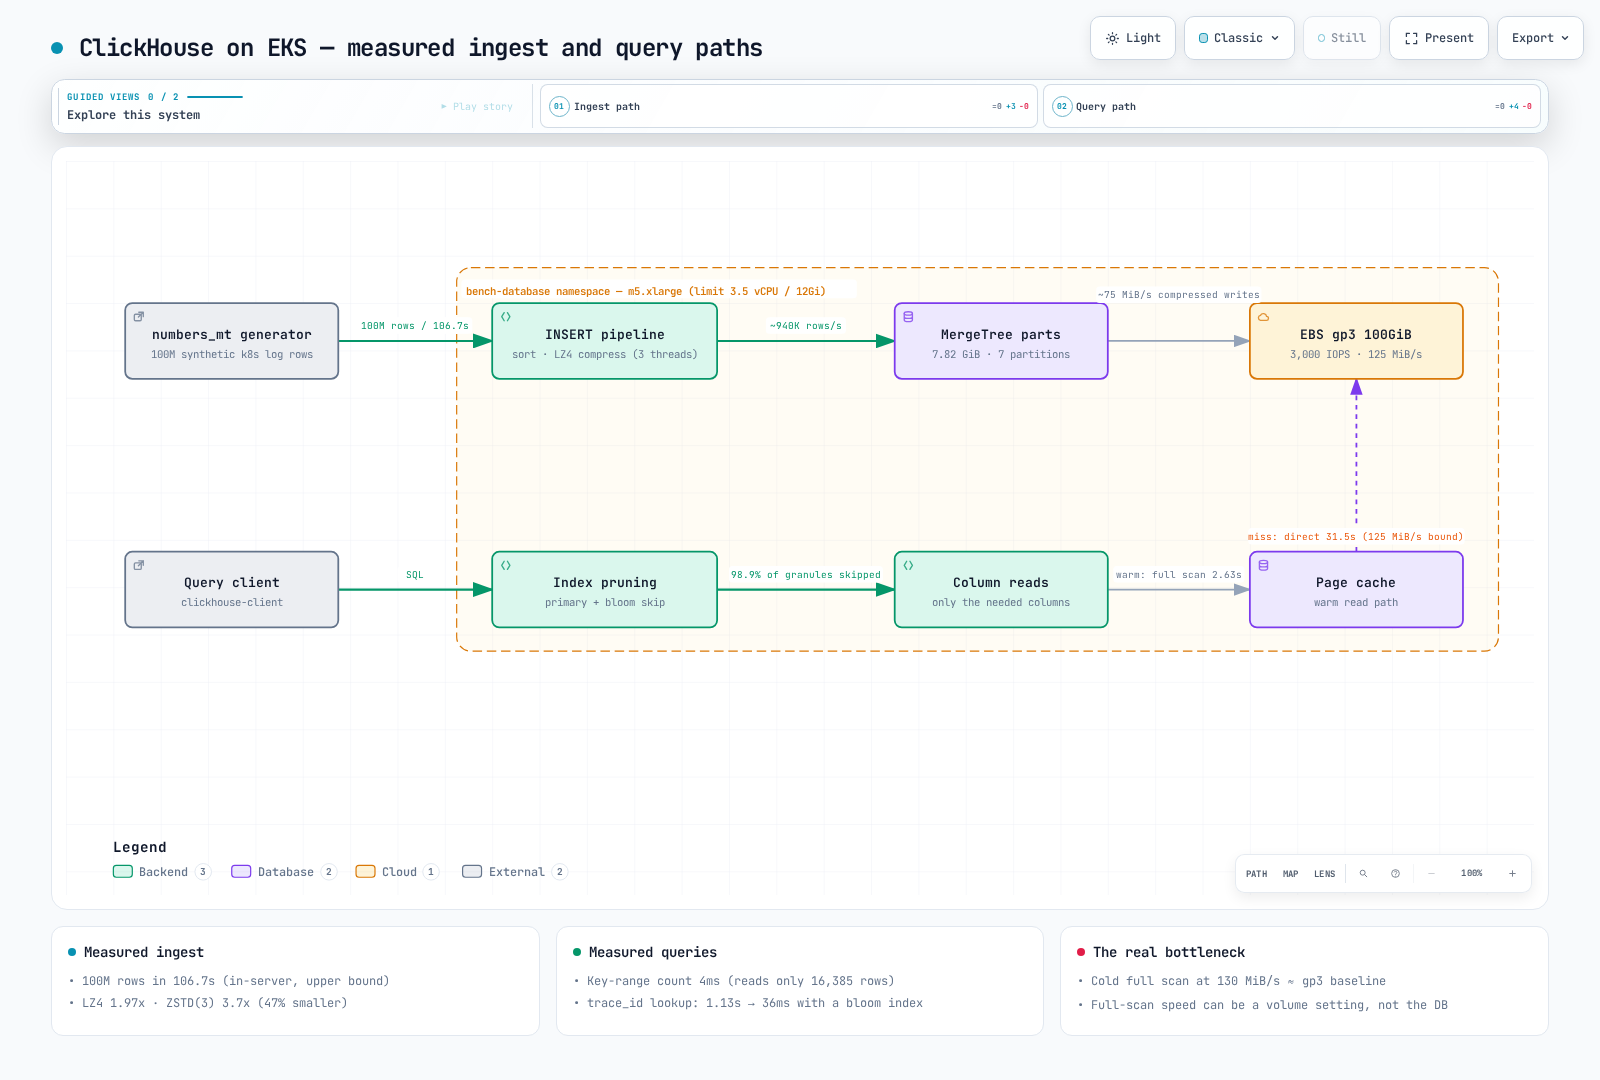
要約: 計測結果
| 測定項目 | 結果 |
|---|---|
| 取り込み(サーバー内生成+挿入) | 1億行 / 106.7秒 = 約94万行/秒 |
| ストレージ容量(既定のLZ4) | 15.37 GiB → 7.82 GiB(1.97倍) |
| ストレージ容量(ZSTD(3)) | 15.37 GiB → 4.16 GiB(3.7倍)、LZ4より47%小さい |
| ORDER BYキー範囲件数(1時間のウィンドウ) | 4 ms(59,916行を数え、1億行中16,385行だけを読み取り) |
| PodごとのERROR件数をGROUP BY(2日間) | 0.36秒(2,800万行をスキャン) |
LIKE '%timeout%'の全件スキャン | キャッシュが温まった状態 2.63秒 / Direct I/Oを要求 31.5秒(12倍) |
| trace_idのポイント検索 | 全件スキャン1.13秒 → bloom filterインデックスで0.036秒(31倍) |
テスト環境
| 項目 | 値 |
|---|---|
| クラスター | Amazon EKS、Kubernetes 1.36、ap-northeast-2 |
| ノード | m5.xlarge(4 vCPU、16 GiB)。Karpenterでプロビジョニングした専用ノード1台(ベンチマークPodだけを配置) |
| Podリソース | requests: 2.5 vCPU/9 Gi、limits: 3.5 vCPU/12 Gi |
| ストレージ | EBS gp3 100 GiB、既定設定(ベースラインは3,000 IOPS/125 MiB/s)、EBS CSIドライバー |
| ClickHouse | 公式イメージclickhouse/clickhouse-server:24.8(24.8.14.39)、既定設定 |
| 1時間あたりのコスト | m5.xlargeのオンデマンド$0.236/h+gp3 100 GiBが$0.0912/GB-month(ソウルリージョン、Pricing APIから取得、2026-09) |
バージョン注記。 計測時は24.8がLTSリリースでしたが、ClickHouseのセキュリティポリシーでは、24.xのリリースはすべてサポート対象外になっています(2026年10月12日時点のサポート対象系列は26.9、26.8 LTS、26.7、26.3 LTS)。新規構築では現在のLTSタグを使用してください。以下で測定した仕組み(プライマリキーによる絞り込み、LZ4/ZSTDコーデック、bloom filterスキップインデックス)は現在のリリースにもありますが、サイジングに使う前に、デプロイするバージョンで再測定してください。
この環境は意図的に飾り気のないものにしています。このベンチマークの問いは「専用のiファミリーNVMeマシンでClickHouseはどれほど速いか」ではなく、「クラスターがすでに使っている一般的なノードとデフォルトのgp3ボリュームで、どこまでできるか」です。
デプロイマニフェスト
次の再実行例では、サポート対象LTSの26.3.33.24を使います。過去の24.8の測定値はそのままです。通常のEC2 EBS CSI/IAMとPVCのプロビジョニングが必要です。デフォルトユーザーのネットワーク制限を維持し、kubectl exec内のlocalhostクライアントからベンチマークを実行してください。イメージダイジェスト、EBS設定、実際のCPU/メモリ使用量を記録します。
apiVersion: v1
kind: Namespace
metadata:
  name: bench-database
---
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: bench-clickhouse-gp3
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  encrypted: "true"
  iops: "3000"
  throughput: "125"
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Delete
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: clickhouse-data
  namespace: bench-database
spec:
  accessModes: ["ReadWriteOnce"]
  storageClassName: bench-clickhouse-gp3
  resources:
    requests:
      storage: 100Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: clickhouse
  namespace: bench-database
  annotations:
    karpenter.sh/do-not-disrupt: "true"
spec:
  nodeSelector:
    node.kubernetes.io/instance-type: m5.xlarge
  containers:
    - name: clickhouse
      image: clickhouse/clickhouse-server:26.3.33.24
      resources:
        requests: { cpu: "2500m", memory: 9Gi }
        limits: { cpu: "3500m", memory: 12Gi }
      readinessProbe:
        exec:
          command: ["clickhouse-client", "--host", "127.0.0.1", "--query", "SELECT 1"]
        initialDelaySeconds: 5
        periodSeconds: 5
      volumeMounts:
        - name: data
          mountPath: /var/lib/clickhouse
  volumes:
    - name: data
      persistentVolumeClaim:
claimName: clickhouse-data本番のライフサイクル/復旧自動化には、単独PodではなくAltinity clickhouse-operatorが管理する
ClickHouseInstallationを使う方法があります。ここでは測定対象を単純にするため単独Podを使います。
データセット: 現実的なKubernetesログ1億行
一様な乱数データ(generateRandom)では圧縮率が実態と異なります。そこで現実のログに近い形、つまり繰り返しのテンプレートと変化するフィールドを使って行を生成します。10個のnamespaceがあり、各namespaceにつきPod名は1種類です(Podサフィックスはnamespaceを選んだものと同じバケットをハッシュ化するため、異なるPod値は10種類しかありません。この単純化は圧縮値に影響するため、測定2で説明します)。ERROR率は0.8%、タイムスタンプの範囲は7日間です。
CREATE TABLE logs
(
  timestamp   DateTime64(3),
  namespace   LowCardinality(String),
  pod         String,
  container   LowCardinality(String),
  level       LowCardinality(String),
  message     String,
  trace_id    String,
  duration_ms Float32
)
ENGINE = MergeTree
PARTITION BY toDate(timestamp)
ORDER BY (namespace, timestamp);INSERT INTO logs (timestamp, namespace, pod, container, level, trace_id, duration_ms, message)
WITH
['payment','order','user','search','catalog','cart','shipping','auth','gateway','recommend'] AS nss,
['GET /api/v1/orders','POST /api/v1/payments','GET /api/v1/users','GET /api/v1/search',
'POST /api/v1/cart/items','GET /api/v1/products','POST /api/v1/shipments','POST /oauth/token',
'GET /healthz','GET /api/v1/recommendations'] AS eps
SELECT
toDateTime64('2026-08-25 00:00:00', 3) + toIntervalMillisecond(number * 6) AS timestamp,
nss[(cityHash64(number) % 10) + 1] AS namespace,
concat(namespace, '-7c7dd4f9c-', substring(lower(hex(sipHash64(cityHash64(number) % 10))), 1, 5)) AS pod,
if(cityHash64(number + 2) % 10 < 8, 'app', 'istio-proxy') AS container,
multiIf(cityHash64(number + 3) % 1000 < 8, 'ERROR',
cityHash64(number + 3) % 1000 < 50, 'WARN',
cityHash64(number + 3) % 1000 < 300, 'DEBUG', 'INFO') AS level,
lower(hex(sipHash128(number))) AS trace_id,
round(if(level = 'ERROR', 2000 + (cityHash64(number + 4) % 30000) / 10,
(cityHash64(number + 4) % 20000) / 100), 1) AS duration_ms,
multiIf(
level = 'ERROR', concat('upstream request timeout after ', toString(round(duration_ms)),
'ms endpoint=', eps[(cityHash64(number + 5) % 10) + 1],
' status=503 trace_id=', trace_id),
concat(eps[(cityHash64(number + 5) % 10) + 1], ' completed status=200 in ',
toString(duration_ms), 'ms trace_id=', trace_id)
) AS message
FROM numbers_mt(100000000)
SETTINGS max_threads = 3, max_insert_threads = 2, max_memory_usage = 9000000000;測定1. 取り込み: 106.7秒で1億行
Elapsed: 106.747 sec → ~936,800 rows/s, 7 daily partitions, 36 active partsこの数値が示す内容を正しく捉えてください。 行はサーバー内で生成して直接挿入したため(INSERT…SELECT)、ネットワーク転送とテキスト解析のコストは含まれず、サーバー内の処理経路を測定しています。データ生成のCPU処理も含まれるため、外部からの取り込み速度の理論上限ではありません。クライアント、形式、ネットワーク、バッチサイズ、並列度によって、外部取り込みのスループットは上下します。それでも中心となる数値は実測値です。3.5 vCPUの制限内で、デフォルトgp3の125 MiB/sボリュームにClickHouseは1秒あたり約94万行をソート、圧縮、書き込みしました。最終圧縮サイズを経過時間で割った値は約75 MiB/sであり、EBSの物理書き込み速度を測定した値ではありません。ページキャッシュ/書き戻し、マージ、耐久性のあるフラッシュ条件は別に確認してください。
測定2. 圧縮: どのカラムがコストを占めるか
全体では15.37 GiB → 7.82 GiB(1.97倍、既定のLZ4)でした。カラムごとの内訳はさらに興味深い結果です。
| カラム | 圧縮後 | 非圧縮 | 比率 |
|---|---|---|---|
| message | 3.97 GiB | 8.75 GiB | 2.2倍 |
| trace_id | 3.08 GiB | 3.07 GiB | 1.0倍(圧縮しにくい) |
| timestamp | 404.07 MiB | 762.94 MiB | 1.89倍 |
| duration_ms | 289.17 MiB | 381.47 MiB | 1.32倍 |
| level | 45.88 MiB | 95.72 MiB | 2.09倍 |
| container | 39.27 MiB | 95.72 MiB | 2.44倍 |
| pod | 9.32 MiB | 2.15 GiB | 236倍 |
| namespace | 488.63 KiB | 95.72 MiB | 201倍 |
サイズと比率はsystem.parts_columnsの報告値(圧縮/非圧縮バイト数の合計にformatReadableSizeを適用)と一致します。比率は丸めたサイズではなく、生のバイト数から計算しています。
重要な点は2つあります。
- LowCardinalityとORDER BYによる局所性は非常に大きな効果があります。namespaceはORDER BYの最初のキーであり、同じ値が長く連続します。そのため95.7 MiBが489 KiBまで縮小しました。同じ理由でpodは236倍圧縮されていますが、注意が必要です。このジェネレーターはnamespaceごとにPod名を1つだけ生成する(異なる名前は10個だけ)ため、podがnamespaceの2つ目のコピーのように振る舞います。namespaceごとに数十のPodがあり、再起動のたびに名前が変わる実クラスターでは、podの圧縮率はかなり低くなります。
- エントロピーの高いIDがストレージの約40%を占めます。この実行では32文字の16進trace_idはLZ4でほぼ圧縮されず(1.0倍)、合計7.82 GiBのうち3.08 GiB(39.4%)を占めます。ログスキーマの設計では、「IDを文字列として保存するか」がストレージコストを左右する最大の要因です。16進表現では1 byteあたり4 bitの情報しか使わず、別のコーデックで圧縮する余地があります。UUID/
FixedString(16)のバイナリー表現は生データ幅を小さくしますが、最終的なストレージ量、コーデック/インデックスへの影響、クエリとの互換性を測定してください。
LZ4とZSTD(3): ストレージ47%減、全件スキャンは1.9倍遅い
同じデータをCODEC(ZSTD(3))のテーブルにも再挿入しました。
| LZ4(既定) | ZSTD(3) | |
|---|---|---|
| 圧縮後サイズ | 7.82 GiB(1.97倍) | 4.16 GiB(3.7倍) |
| 再圧縮を伴う挿入(1億行) | - | 120.0秒 |
LIKE '%timeout%'全件スキャン(キャッシュが温まった状態) | 2.63秒 | 4.9秒 |
ストレージは47%減りますが、CPU負荷の高い全件スキャンは1.9倍遅くなります。頻繁に読むデータにはLZ4を使い、TTLによってZSTDで再圧縮する方法も評価候補の1つです。最適なコーデックは、実際のデータ、CPU、IOの制約に依存します。
測定3. クエリ: 速いもの、遅いもの、その理由
各クエリはマーク/非圧縮キャッシュを破棄した後、①min_bytes_to_use_direct_io=1を指定してページキャッシュを迂回するよう要求した実行を1回、②キャッシュが温まった状態で3回実行しました(表には最小値を記載)。
| # | クエリのパターン | ディスクから直接 | 温まった状態 | 読み取った行数(read_rows) |
|---|---|---|---|---|
| Q1 | WHERE namespace='payment' AND timestamp BETWEEN …(1時間の件数) | 13 ms | 4 ms | 16,385(0.016%)、結果59,916 |
| Q2 | PodごとのERROR件数を2日間でGROUP BY(データセット内のPodは10種類だけなのでLIMIT 10は単純) | 0.57秒 | 0.36秒 | 2,800万 |
| Q3 | message LIKE '%timeout%'の全範囲スキャン | 31.5秒 | 2.63秒 | 1億 |
| Q4 | namespaceごとのduration p50/p99、全範囲 | 1.34秒 | 1.03秒 | 1億(フィルターなし) |
| Q5 | trace_id = '…'のポイント検索(インデックスなし) | 24.3秒 | 1.13秒 | 1億 |
読み方:
- Q1が4 msで済む理由: PARTITION BY(日単位)とORDER BY(namespace、timestamp)が整合しているため、1時間分の
paymentは連続したキー範囲になります。59,916行を数えるクエリですが、system.query_logでは16,385行だけを読み取っています。ClickHouse 24.6以降では、プライマリキー範囲に完全に収まるgranule数をインデックスだけから数え、範囲の端にある部分granule(8,192行のものが約2つ)だけを伸長するためです。この最適化が適用されたかはEXPLAIN indexes = 1と実際のread_rowsで確認してください。あらゆるcountクエリで無条件に使えるわけではありません。 - Q3の31.5秒(直接読み取り)と2.63秒(キャッシュが温まった状態)の差: 圧縮後のmessageカラム約4 GiBをディスクから読む速度は、4 GiB ÷ 31.5秒 ≈ 130 MiB/sです。gp3の上限(125 MiB/s)と、このm5.xlarge自身のEBSベースライン(1,150 Mbps ≈ 137 MiB/s)が近い範囲にあり、どちらが先に上限になったかはこの実行だけでは分かりません。同じクエリをページキャッシュから読むとCPU負荷が上限となり、約3,800万行/秒です。全件スキャン性能がデータベース固有の性質ではなく、ボリュームのスループット設定で決まる場合があることを実測しています(EBS gp2とgp3のベンチマークを参照)。インデックスなしのQ5も同様で、trace_idの3.08 GiBを24.3秒で読み、約130 MiB/sです。
- Q4が約1秒で1億行を全件スキャンする理由: カラム指向の利点がよく表れています。カラムサイズで見るとduration_ms(289 MiB)とnamespace(0.5 MiB)だけを読み取り、7.8 GiBは読みません。温まった状態の実行は1億件のFloat32分位点を処理するCPUが上限になります。
- Q2/Q4の短い測定値では、物理ディスクのスループットを切り分けられません。 最終サイズを時間で割った値が125 MiB/sを超えたからといって、それだけでページキャッシュが使われた証拠にはなりません。マーク/非圧縮キャッシュを破棄しても、OSページキャッシュは破棄されません。元の実行では、キャッシュ/読み取り方式/短い実行時間の影響を調べる前に終了しました。再実行では、node/EBS IOメトリクスと一緒に
query_logのProfileEventsを保存してください。
測定4. bloom filterスキップインデックス: 1.13秒から0.036秒へ
trace_idのポイント検索はORDER BYキーに含まれないため、既定では全件をスキャンします(1.13秒)。スキップインデックスを追加します。
ALTER TABLE logs ADD INDEX trace_bf trace_id TYPE bloom_filter(0.01) GRANULARITY 4;
ALTER TABLE logs MATERIALIZE INDEX trace_bf; -- asynchronous; wait for system.mutations.is_done| インデックスなし | bloom_filter(0.01) | |
|---|---|---|
| 温まった状態での検索時間 | 1.13秒 | 0.036秒(31倍) |
| 読み取った行数 | 1億 | 108万(98.9%をスキップ) |
| 読み取ったデータ | 3.82 GiB | 42.6 MiB |
| インデックスサイズ | - | 119.7 MiB(テーブルの1.5%) |
可観測性ログストアでは「trace IDで検索する」クエリが最もよく使われます。このインデックスにより、ストレージを1.5%追加し、マテリアライズに20秒かけることで31倍速くなります。ClickHouseをGrafanaのログバックエンドとして使う場合は、実際の選択性、偽陽性、書き込み/マージコスト、クエリプランに照らして評価してください。
コストで見る
2026-09-11のPricing API照会では、ソウルリージョンのLinux m5.xlargeオンデマンドが$0.236/h、gp3が$0.0912/GB-monthと確認できました。EBSはプロビジョニングした容量に課金されます。データセットが7.82 GiBでも4.16 GiBでも、この例の100 GiBボリュームの費用は月額$9.12です。使用量から計算した$0.71/$0.38は実際のボリューム料金ではありません。
1日あたり1億行、30日分を保存すると、この合成データにおけるLZ4圧縮率ではデータだけで約235 GiBになります。例の100 GiBボリュームには収まりません。サイジングではマージ用作業領域、インデックス、レプリカ、バックアップ、余裕容量を追加してください。235 GiBだけを確保すると約$21.43/monthです。ノード、EKS、ネットワーク、運用費用は含みません。EBSストレージだけをCloudWatch Logsの取り込み費用と比較しても、総コストの優位性は示せません。
再現方法
以下はパターン比較のための新しい実行例です。過去のQ1/Q2の正確な時間範囲とQ5のIDはこの資料に残されていないため、元の行数/実行時間を再現するとは主張しません。正確なSQL、バージョン、タイムゾーン、読み取り設定、生の結果をまとめて保存してください。
-- Q1: explicit example window for a new run, not recovered historical SQL.
SELECT count() FROM logs
WHERE namespace = 'payment'
  AND timestamp >= toDateTime64('2026-08-26 00:00:00', 3)
  AND timestamp < toDateTime64('2026-08-26 01:00:00', 3);

-- Q2: a two-day example window.
SELECT namespace, pod, count() AS errors FROM logs
WHERE level = 'ERROR'
  AND timestamp >= toDateTime64('2026-08-26 00:00:00', 3)
  AND timestamp < toDateTime64('2026-08-28 00:00:00', 3)
GROUP BY namespace, pod ORDER BY errors DESC LIMIT 10;

-- Q3: full-range message scan.
SELECT count() FROM logs WHERE message LIKE '%timeout%';

-- Q4: approximate quantiles; all candidate rows are still processed.
SELECT namespace, quantiles(0.5, 0.99)(duration_ms) AS p50_p99
FROM logs GROUP BY namespace;

-- Q5: a trace ID that the generator creates for number=42.
SELECT * FROM logs
WHERE trace_id = lower(hex(sipHash128(toUInt64(42))));kubectl apply -f clickhouse.yaml
kubectl wait -n bench-database pod/clickhouse --for=condition=Ready --timeout=300s
kubectl exec -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --query 'SELECT version(), timezone()'
# Save the CREATE TABLE block as schema.sql and INSERT block as insert.sql.
kubectl exec -i -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --multiquery < schema.sql
kubectl exec -i -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --time --multiquery < insert.sql
# Run the selected query with a unique ID; store its exact SQL with the results.
kubectl exec -i -n bench-database clickhouse -- \
clickhouse-client --host 127.0.0.1 --query_id benchmark-q3-run1 \
--time --multiquery < q3.sqlDirect I/Oを要求する実行では、そのSELECTの末尾にSETTINGS min_bytes_to_use_direct_io=1を追加します。既定の読み取り設定でも繰り返し、最小値だけではなく全サンプルと中央値を保存してください。SYSTEM FLUSH LOGSの後、一致するquery_logの行をエクスポートします。比較前にsystem.mutationsでインデックスのマテリアライズが完了したことを待ちます。クエリ、ファイルシステム、OSキャッシュ、バックグラウンドマージの状態も記録してください。
専用のbench-database名前空間とbench-clickhouse-gp3 StorageClassを削除する前に、結果をクラスター外へエクスポートしてください。この例のDelete reclaimPolicyでは、PVCと一緒にベンチマークデータも削除されます。
注意点
- ノードは1台で、実行環境も1回だけです。 レプリケーション/シャーディングや別のインスタンスタイプでは絶対値が変わります。ほかの環境にも参考になるのは、絞り込み、カラム指向、キャッシュ効果、インデックス効果という相対的な傾向です。
- 取り込みの数値はサーバー内で生成/挿入した結果であり、外部からの収集スループットではありません(測定1を参照)。
- 合成データの圧縮率はフィールド構成に左右されます。高エントロピーのtrace_idがmessage内に含まれているため、この値は保守的です。一方、podカラムの圧縮率(異なる名前は10個だけ。測定2を参照)は楽観的です。実際のログはスキーマ次第で、より圧縮される場合も圧縮率が下がる場合もあります。
- 最初の温まった状態の実行は、キャッシュが埋まる間は遅くなります(Q3は初回8.7秒、その後2.6秒)。表の温まった状態の値は、3回の実行の最小値です。
関連資料
- ログバックエンドとしてのClickHouse: 収集パイプライン(Fluent Bit/Vector)との統合
- EBS gp2とgp3の計測済みベンチマーク: Q3の解釈に関わるボリューム/インスタンスのスループット上限
- Kubernetes上のデータベース概要: Operatorの選択肢、マネージド/セルフホストの判断枠組み