パート4: 運用、高可用性、Managed Flink
最終更新: 2026年9月12日。自己管理の例は Flink 2.2.1/Operator 1.15.0 を使用。マネージドサービスとの比較には AWS の Flink 2.3 ドキュメントを使用。
パート3で扱った stateful deployment に可観測性と HA を接続し、障害、復旧、capacity を検証します。Karpenter は必須ではありません。運用する node-capacity model に応じて確認してください。以下の例は Prometheus Operator と、対象 monitor を選択する Prometheus 設定を前提とします。
1. Reporter、Pod port、PodMonitor を関連付ける
Reporter の設定だけでは Prometheus へのデータ取り込みは完了しません。JAR、listen port、名前付き container port、selector/namespace、Prometheus 独自の PodMonitor 選択条件を合わせてください。
以下は、パート3の完全な CR spec にマージするフィールドです。Prometheus plugin を有効にしながら、S3 plugin/volume の設定も保持してください。通常、Pod IP が異なるため JM/TM は同じ9249 port を使えます。Host networking や1つの Pod 内で複数 reporter を使う場合は、port 衝突と discovery を別途計画します。
flinkConfiguration:
  metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory
  metrics.reporter.prom.port: '9249'
  state.backend.rocksdb.metrics.block-cache-usage: 'true'
  state.backend.rocksdb.metrics.block-cache-capacity: 'true'
  state.backend.rocksdb.metrics.num-running-compactions: 'true'
  state.backend.rocksdb.metrics.compaction-pending: 'true'
podTemplate:
  spec:
    securityContext:
      fsGroup: 9999
    containers:
    - name: flink-main-container
      env:
      - name: ENABLE_BUILT_IN_PLUGINS
        value: flink-s3-fs-hadoop-2.2.1.jar;flink-metrics-prometheus-2.2.1.jar
      volumeMounts:
      - name: rocksdb-local
        mountPath: /opt/flink/state
      ports:
      - name: flink-metrics
        containerPort: 9249
        protocol: TCP
    volumes:
    - name: rocksdb-local
      emptyDir: {}
  metadata:
    labels:
metrics-group: flink-state-demoapiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
name: flink-state-metrics
namespace: monitoring
labels:
release: monitoring
spec:
selector:
matchLabels:
metrics-group: flink-state-demo
namespaceSelector:
matchNames:
- data-processing
podMetricsEndpoints:
- port: flink-metrics
path: /metrics
interval: 30sこの PodMonitor は monitoring namespace にあり、data-processing 内の workload を選択します。metadata.labels.release=monitoring は一例です。実際の Prometheus podMonitorSelector と podMonitorNamespaceSelector に合わせてください。PodMonitor 自身の namespaceSelector は、target Pod の namespace を別途選択します。
Pod に metrics-group label と flink-metrics という名前付き port が実際に存在するか確認してください。仮定した app.kubernetes.io/managed-by label や宣言されていない port 名を使うと target が検出されない場合があります。Prometheus target の health、実際の /metrics response、network policy、discovery RBAC も調べてください。
Operator 自身の metric には別途設定が必要
Dropwizard reporter を bundle に含めても、Prometheus の HTTP endpoint が有効になるわけではありません。Operator image には reporter plugin が含まれますが、chart の既定値は Slf4j を選び、metrics.port は未設定です。この例ではパート2の values を拡張し、Prometheus の設定と名前付き port を追加します。
watchNamespaces:
- data-processing
image:
  repository: ghcr.io/apache/flink-kubernetes-operator
  tag: 1.15.0
  digest: sha256:5372e4461b433ee37391b0ee3fc3e4029980d14e9b64576b0cb78493d1cafe3a
webhook:
  create: true
metrics:
  port: 9249
defaultConfiguration:
  flink-conf.yaml: 'kubernetes.operator.metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory

    kubernetes.operator.metrics.reporter.prom.port: 9249

'apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
name: flink-operator-metrics
namespace: monitoring
labels:
release: monitoring
spec:
selector:
matchLabels:
app.kubernetes.io/name: flink-kubernetes-operator
namespaceSelector:
matchNames:
- flink-operator
podMetricsEndpoints:
- port: metrics
path: /metrics
interval: 30sこの chart が実際に生成する Operator Pod には app.kubernetes.io/name はありますが、既定で app.kubernetes.io/instance label はありません。Deployment metadata の label が自動的に Pod label になるわけではありません。values を変更した後、render された Pod と target を再確認してください。このレビューで検証したのは2つの monitor の selector/port の一致であり、Prometheus に実データが取り込まれることではありません。
RocksDB metric の単位とコスト
block-cache-usage と block-cache-capacity の単位は byte です。usage 自体は比率ではありません。比較するときは capacity がゼロ/欠損の場合を処理してください。cache が満杯であるだけでは障害の証拠になりません。hit/miss、read latency、I/O、compaction を確認します。num-running-compactions は count、compaction-pending は状態の signal です。column-family/subtask の series 数と overhead を考慮し、metric を選択して有効化してください。
この Prometheus reporter は Flink Counter を Gauge に、Histogram を Summary に対応付けます。counter/histogram query を選ぶ前に、export された TYPE、name、label を確認してください。Checkpoint の成功/失敗/restore 時間、throughput/lag/backpressure、JVM/native memory/GC/disk、Pod scheduling の health をまとめた dashboard を用意します。
2. Managed memory と network memory は別の領域
TaskManager の memory model は、区別のない4領域より細かく分かれています。
| 領域 | 例 |
|---|---|
| Framework heap/task heap | Framework の構造体、user object、heap state |
| Framework off-heap/task off-heap | Framework と user の direct/native allocation |
| Managed memory | RocksDB、sort/hash operator、Python UDF 用の予算 |
| Network memory | 独立した shuffle/network buffer の予算 |
| JVM metaspace | Class metadata |
| JVM overhead | Thread stack、code cache、その他 JVM の費用 |
RocksDB と network buffer は、managed memory の単一 pool を直接共有しません。それでも、process 全体の予算による制約は受けます。Managed size を明示すると fraction より優先されます。矛盾する合計/component 設定を避け、consumer の weight を考慮してください。
以下は Flink 2.2.1 の実際の計算結果であり、total process memory 4 GiB、その他の設定は既定値です。ここに示すのは設定上の予算であり、測定した RSS ではありません。
| Managed fraction | JVM heap (MiB) | Managed (MiB) | Network (MiB) |
|---|---|---|---|
| 0.4 | 1587.20 | 1372.16 | 343.04 |
| 0.5 | 1244.16 | 1715.20 | 343.04 |
この例では、managed fraction を増やしても network memory は変わらず、task heap が減ります。別の設定の組み合わせでは動作が異なる場合があります。Pod の request/limit、sidecar、native allocation/page cache、peak RSS/GC を確認してください。process.size がすべての Pod memory 使用者を含む保証はありません。
3. Kubernetes HA: 調整と永続 state
Kubernetes HA を使うと、外部 ZooKeeper ensemble を自分で運用せずに済みます。ZooKeeper HA も引き続きサポートされます。確認した Flink 実装は、独立した Kubernetes leader-election server/API や常に Lease object を使うのではなく、Fabric8 の ConfigMapLock を使います。Kubernetes control plane の可用性が前提です。
| 保存場所 | 役割 |
|---|---|
| ConfigMap | Leader 情報と recovery state の handle/参照 |
high-availability.storageDir | JM 復旧用の永続 metadata/job graph file |
execution.checkpointing.dir | 実際の checkpoint state を保存 |
パート3の plugin、credential、storage に関する前提条件も引き続き適用されます。HA directory を設定しても、checkpoint data のすべてがそこに置かれるわけではありません。以下の field を Operator 管理の CR にマージできます。
# Merge into the existing FlinkDeployment spec.
jobManager:
  replicas: 2
flinkConfiguration:
  high-availability.type: org.apache.flink.kubernetes.highavailability.KubernetesHaServicesFactory
  high-availability.storageDir: s3://replace-with-your-bucket/flink-state-demo/ha
Operator CR 内で kubernetes.cluster-id、kubernetes.namespace、high-availability.cluster-id を設定しないでください。 1.15 validator はこれらを禁止します。Operator が CR の name/namespace から identity を管理します。これは低レベルの Flink CLI guide とは異なります。
JM のサービスアカウントには ConfigMap 調整の permission が必要です。Native resource management を使う場合は、Pod/Service permission も必要です。HA 用の ConfigMap Role だけでは、Native deployment のすべての permission を満たしません。問題は API error、log、restart として現れる場合があり、正常な Pod のまま常に無言で失敗するわけではありません。
JM replica が2つあると起動時の待ち時間は短くなる場合がありますが、即時かつ無停止の failover は保証しません。Node/AZ の配置、選出 timeout、storage access、restore/replay 時間、外部への重複書き込みをテストしてください。HA ConfigMap/file を安易に削除しないでください。また、Operator CR の削除が child Deployment の削除と同じだと考えないでください。
4. Autoscaling と node capacity の相互作用
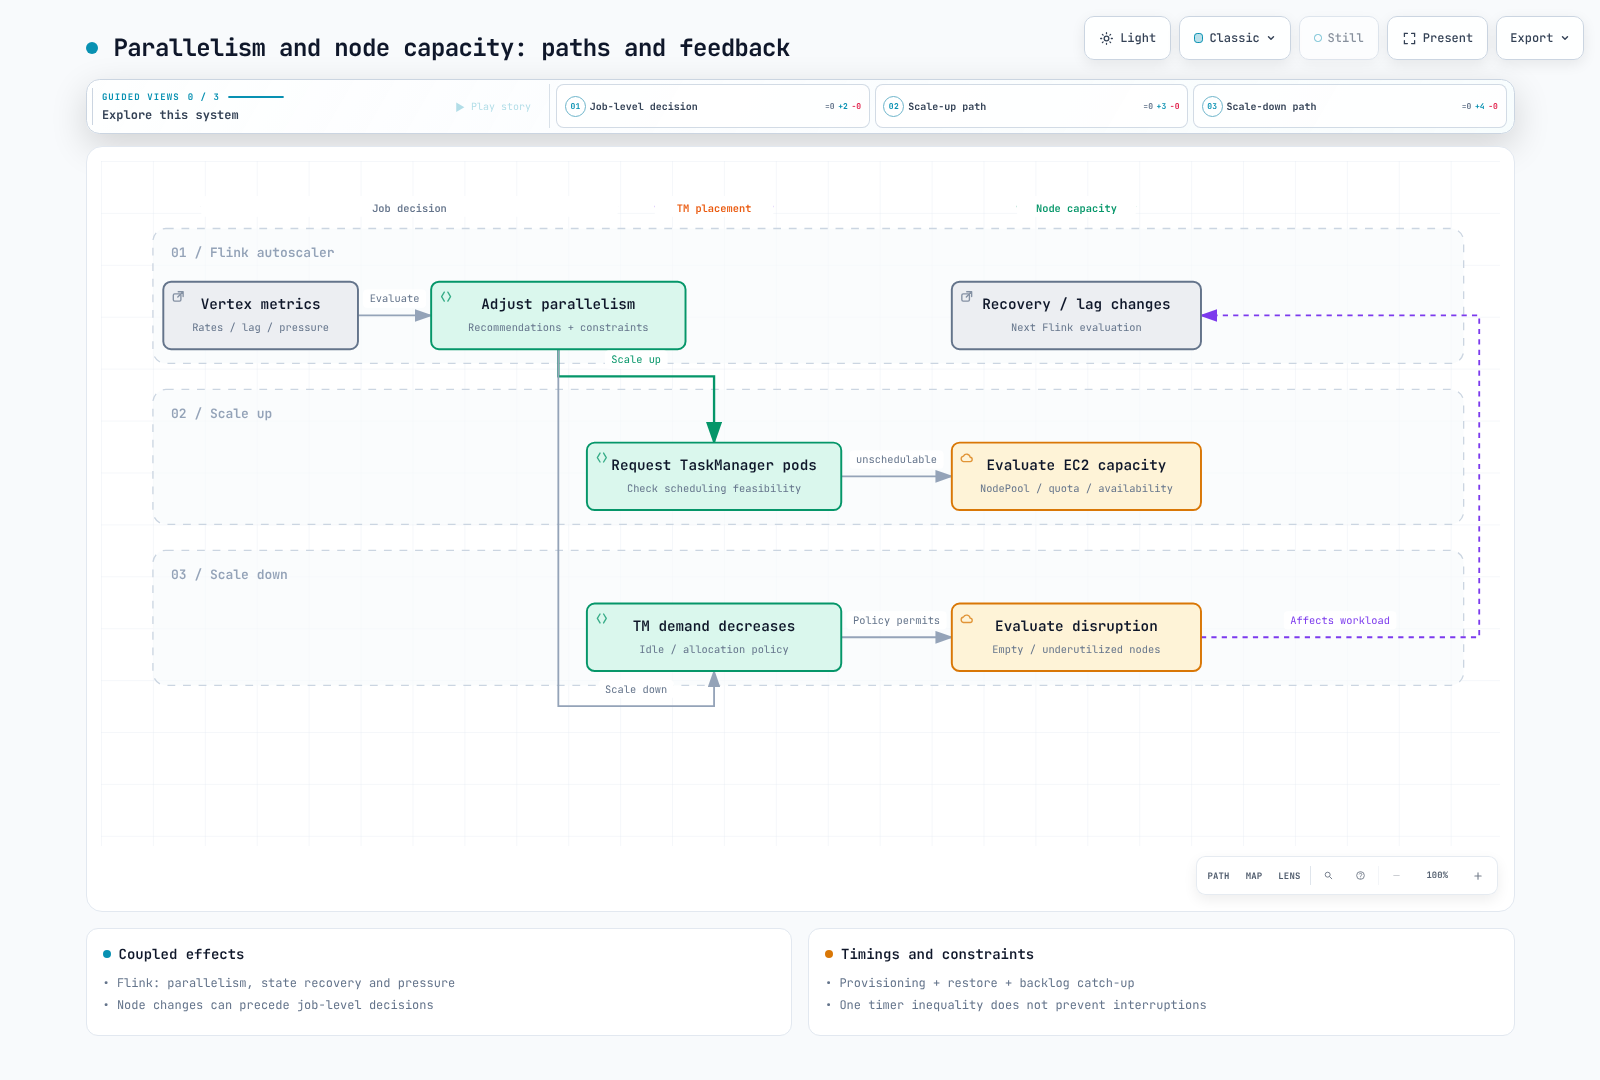
Flink autoscaler は主に vertex parallelism を調整し、node autoscaler はスケジュール可能な capacity を調整します。パート2の pressure/quota と stateful/in-place の制約も適用されます。「必ず Flink が先に動き、Karpenter が後から追従する」という一律の順序はありません。Node 障害、Spot 回収、drift、consolidation が先に job の復旧や lag に影響する場合があります。
Pending Pod がすべて追加 node を必要とするわけではありません。Scheduling failure と image pull、PVC、admission などの原因を区別してください。NodePool の requirement/taint、resource request、利用可能な instance、quota、PDB、disruption policy も関係します。Consolidation は空の node だけでなく、条件を満たす低利用率の node も対象にできます。
Consolidation の遅延が Flink の stabilization より長くても、capacity の維持や実行中断がないことは保証されません。Provisioning、state restore、backlog の解消時間を測定し、余剰 capacity、retry/checkpoint の目標、disruption policy を一緒に調整してください。
5. Amazon Managed Service for Apache Flink との比較
AWS は現在、Flink 2.3.0 のサポート、推奨 Java 17、Python 3.12 を案内しています。サービスでのサポートと、自己管理 runtime/connector の例を区別してください。2.3 のサービスドキュメントでは Java 21、ForSt、Native S3 filesystem、独自 telemetry/reporter、Materialized Tables、Studio に制限があります。自己管理 Flink の Prometheus 設定や experimental feature を、そのまま移植しないでください。
| 項目 | Managed Service | EKS + Operator |
|---|---|---|
| Infrastructure | AWS がサービス基盤と host/AZ の復旧を管理 | Node、Operator、HA、upgrade を運用 |
| 利用者の責任 | Application、IAM/networking、connector/state、capacity の選択、復旧検証 | 同じ application 責任に加え、Kubernetes 運用 |
| Scaling | 既定では CPU に基づいて application parallelism を変更。設定、上限、custom scaling を確認 | Vertex scaling、node capacity、disruption を調整 |
| 可観測性 | 対応する CloudWatch/telemetry 経路 | Reporter、Prometheus、その他の collection を設定 |
| Cost | Application KPU、storage、orchestration、関連 service | EC2/EBS/control plane、storage/networking、observability、engineering |
Managed HA/migration を使っても、application error や互換性のない state/connector が自動的に解決するわけではありません。Checkpoint/snapshot と復元を検証してください。サービスの resilience ドキュメントには、内部で multi-AZ ZooKeeper ベースの HA を使うと説明されています。利用者がその ensemble や内部 EKS cluster を管理する必要はありません。
既定の automatic scaling は CPU を基準に application parallelism を変更します。upstream の vertex ごとの autoscaling とは異なります。Parallelism、ParallelismPerKPU、AutoScalingEnabled、quota を確認してください。Scaling/restart により処理が中断し、backlog の回復が必要になる場合があります。
KPU は1 vCPU、4 GB memory、実行時 storage を提供します。ドキュメントには追加の orchestration KPU 料金も記載されています。稼働中 KPU の単価だけで比較しないでください。同様に、Spot による節約は interruption/復旧の費用とあわせて評価します。同等の throughput、latency、recovery 目標で比較してください。既定値を変更すること自体は目標ではありません。
6. 運用上の受け入れ確認
- [ ] Runtime/connector/state-format の互換性と Application/Session を選んだ理由を記録する。
- [ ] 実際の Prometheus target/CloudWatch metric、service/task log、alert 配信を検証する。
- [ ] Peak load 時の heap/managed/network/native memory、disk、GC を測定する。
- [ ] HA 調整、checkpoint storage、credential、restore、外部書き込み結果をテストする。
- [ ] Node/AZ 障害、capacity の遅延、Spot/disruption、backlog の回復を測定する。
- [ ] Upgrade/rollback、snapshot の保持/削除、cost、対応担当を記録する。
要件を満たすなら、既定値を維持して構いません。Checkbox をすべて埋めれば本番利用が保証されると考えず、測定結果と残る制約を受け入れてください。
検証の範囲
検証では Flink 2.2.1 の native memory 計算2件、workload/PodMonitor CRD、Operator Helm render、selector/名前付き port の一致を確認しました。Live Prometheus scrape、クラスターへの deployment、HA failover、マネージド application の実行、cost 測定は行っていません。