Ciliumサービスメッシュの可観測性
最終更新: September 11, 2026 · Cilium/chart 1.20.1 · Hubble CLI 1.19.4 · Collector Contrib 0.160.0 · Loki 3.7.7。Kubernetes/EKSとプラットフォーム要件は概要を参照してください。
概要
HubbleはCiliumが扱う通信の観測を公開します。L3/L4イベントはデータパス由来で、HTTP可視性にはさらに対応L7プロキシ/ポリシー経路が必要です。Hubble有効化だけでは任意のアプリTLSを復号せず、全依存を検出せず、分散アプリトレースも生成しません。
例はproductionの準備済みワークロードと、正しくインストールされたCiliumを前提とします。観測可能範囲の解釈にはセキュリティ章の暗号化/ztunnel制限を適用してください。
Hubbleアーキテクチャ
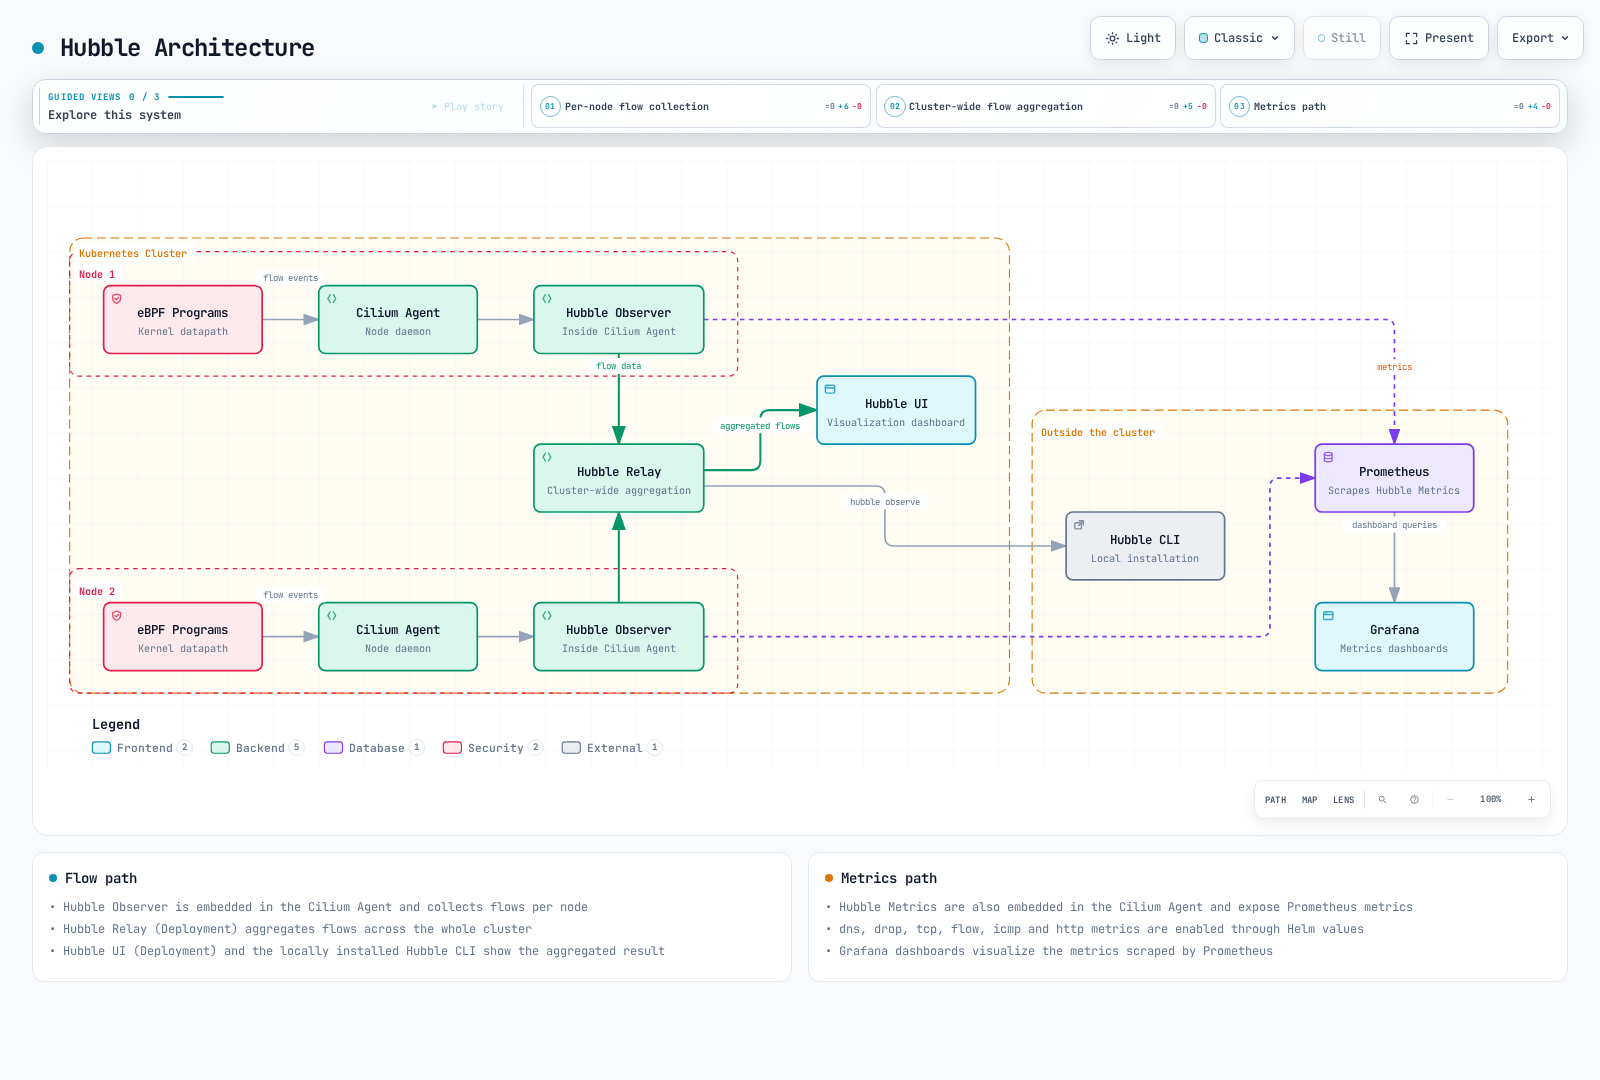
図はコンポーネントをまとめています。設定時はEnvoyもL7イベントを供給し、HTTP観測の入力はeBPFだけではありません。PrometheusはRelayフローAPIと別にメトリクスをスクレイプします。
| コンポーネント | 役割 |
|---|---|
| Cilium Agent内Observer | 上限付きノード別フロー履歴を保存・提供 |
| Hubble Relay | 接続Hubbleサーバーの観測を集約 |
| Hubble UI | 観測された関係とフロー詳細を表示 |
| Hubble CLI | API照会またはエクスポート済みJSONの読み取り |
| Hubbleメトリクスハンドラー | 対象観測をPrometheusメトリクスに変換 |
観測バッファは長期ログストアではありません。バッファ満杯、ノード欠落、エクスポーター失敗、イベント喪失はアプリ健全性と分けて解釈します。
Hubbleのインストールと設定
Helmによるインストール
このオーバーレイをCilium 1.20.1のレビュー済みvaluesにマージします。メトリクスを公開し、port-forwardアクセスのRelay/UIを有効にします。Prometheus、Grafana、Collector、Lokiはインストールしません。
prometheus:
  enabled: true
hubble:
  enabled: true
  relay:
    enabled: true
    replicas: 1
    resources:
      requests:
        cpu: 100m
        memory: 128Mi
      limits:
        cpu: 1000m
        memory: 1024Mi
  ui:
    enabled: true
    replicas: 1
    ingress:
      enabled: false
  metrics:
    enabled:
    - dns
    - drop
    - tcp
    - flow
    - icmp
    - port-distribution
    - httpV2:labelsContext=source_namespace,source_workload,destination_namespace,destination_workload
  tls:
    enabled: true
    auto:
      enabled: true
      method: cronJob
      certValidityDuration: 365
      schedule: 0 0 1 */4 *
リソース量は例で、サイジング結果ではありません。一部エージェント設定変更には管理されたロールアウトが必要です。適用前にレンダリングされたワークロードと手順を確認します。
Hubbleサーバー→RelayのmTLSは観測転送を保護します。UI Ingress、クライアント向けRelay API、メトリクス、アプリ通信には別のTLS/認証設定があります。公開到達可能UIには適切なアクセス制御境界が必要で、TLS Secretだけではユーザー認証になりません。
オーバーレイはcronJob証明書更新を選びます。選択チャートのデフォルト有効期間は365日で、TLSガイドには明示設定した1,095日例もあります。method: helmは証明書生成が可能ですが更新はスケジュールしません。証明書Job、期限、信頼を確認してください。Hubbleは再読み込みをサポートしますが、更新処理の運用の代わりではありません。
Hubble CLIのインストール
このUnix例は版を固定し、Linux/macOSとamd64/arm64を選び、ダウンロード/チェックサム失敗で停止します。
set -eu
HUBBLE_VERSION=v1.19.4
case "$(uname -s)" in
  Linux) HUBBLE_RELEASE_OS=linux ;;
  Darwin) HUBBLE_RELEASE_OS=darwin ;;
  *) echo "Use the matching release archive for this operating system." >&2; exit 1 ;;
esac
case "$(uname -m)" in
  x86_64|amd64) HUBBLE_RELEASE_ARCH=amd64 ;;
  aarch64|arm64) HUBBLE_RELEASE_ARCH=arm64 ;;
  *) echo "Unsupported architecture for this example." >&2; exit 1 ;;
esac
HUBBLE_ARCHIVE="hubble-${HUBBLE_RELEASE_OS}-${HUBBLE_RELEASE_ARCH}.tar.gz"
HUBBLE_RELEASE_BASE="https://github.com/cilium/hubble/releases/download/${HUBBLE_VERSION}"
curl -fSLO "${HUBBLE_RELEASE_BASE}/${HUBBLE_ARCHIVE}"
curl -fSLO "${HUBBLE_RELEASE_BASE}/${HUBBLE_ARCHIVE}.sha256sum"
if command -v sha256sum >/dev/null 2>&1; then
  sha256sum --check "${HUBBLE_ARCHIVE}.sha256sum"
else
  shasum -a 256 -c "${HUBBLE_ARCHIVE}.sha256sum"
fi
tar -xzf "$HUBBLE_ARCHIVE" hubble
sudo install -m 0755 hubble /usr/local/bin/hubble
hubble version
ダウンロードに適した作業ディレクトリを使います。公式にはWindows amd64/arm64アーカイブもあり、公開SHA-256を確認してプラットフォームの手順に従います。CLIが利用可能でも、そのOSでCilium Linuxデータパスを実行できる意味ではありません。
Relayへの接続
# Terminal 1
cilium hubble port-forward --port-forward 4245
# Terminal 2
hubble status --server localhost:4245
hubble observe --server localhost:4245 --namespace production --last 100
hubble observe --server localhost:4245 --namespace production --follow
全状態/エラーを保持します。「Hubble」のgrep成功や3ノード接続というサンプル出力は、このインストールの健全性を証明しません。
Hubble CLI
基本操作とフィルタリング
hubble observeは通常、最近のバッファ内観測を返します。--followなしでは継続ストリームではありません。--lastは履歴を制限し、Relayは接続Hubbleインスタンスごとにその上限を返す場合があります。
hubble observe --pod production/frontend --last 100
hubble observe --from-ip 10.0.1.5 --to-ip 10.0.2.10
hubble observe --to-port 8080
hubble observe --protocol http --http-status '5+'
hubble observe --protocol http --http-status '2+'
hubble observe --http-method POST --http-method PUT
hubble observe --http-path '^/api/v1/users/.*$'
hubble observe --to-label 'k8s:app=backend,k8s:version=v2'
hubble observe --from-namespace production --to-namespace production --from-workload frontend --to-workload backend
hubble observe --to-service production/backend
hubble observe --namespace production --verdict DROPPED --drop-reason-desc POLICY_DENIED
重要な一致規則:
- Pod名とService名はプレフィックスで、名前空間省略時は
defaultです。 --from-ipと--to-ipを使います。旧--ip-source/--ip-destinationは無効です。- HTTP状態は正確なコードと
5+などのプレフィックスに対応し、500-599は受理しません。 - HTTPメソッド値は正確な選択肢です。POSTまたはPUTにはフラグを繰り返します。
"POST|PUT"は文字どおりのメソッド値で正規表現ではありません。 - カンマ区切り要件を持つ1つのラベルセレクター文字列はAND、繰り返したラベルセレクターは選択肢です。
- ServiceフィルターはService/ClusterIP由来メタデータを使います。
--from-service frontendはfrontend Service所属Podの汎用フィルターではありません。呼び出し元にはワークロード/Pod/ラベルフィルターを使います。 - 名前空間付き
--to-service production/backendは単独使用し、CLIは--to-serviceと--namespaceの併用を拒否します。
出力形式と保持データ
jsonとjsonpbは同じprotobuf JSON対応の別名です。dict、compact、table表示もサポートします。
hubble observe --namespace production --last 100 -o json
hubble observe --input-file flows.jsonl --last 100 -o json
hubble observe --since 5m絶対RFC3339の--since/--until時刻は利用可能データだけを照会します。メモリ内バッファで何年もの履歴が利用可能になるわけではありません。過去調査が必要ならエクスポートを保持します。
Hubble UI
サービスマップ
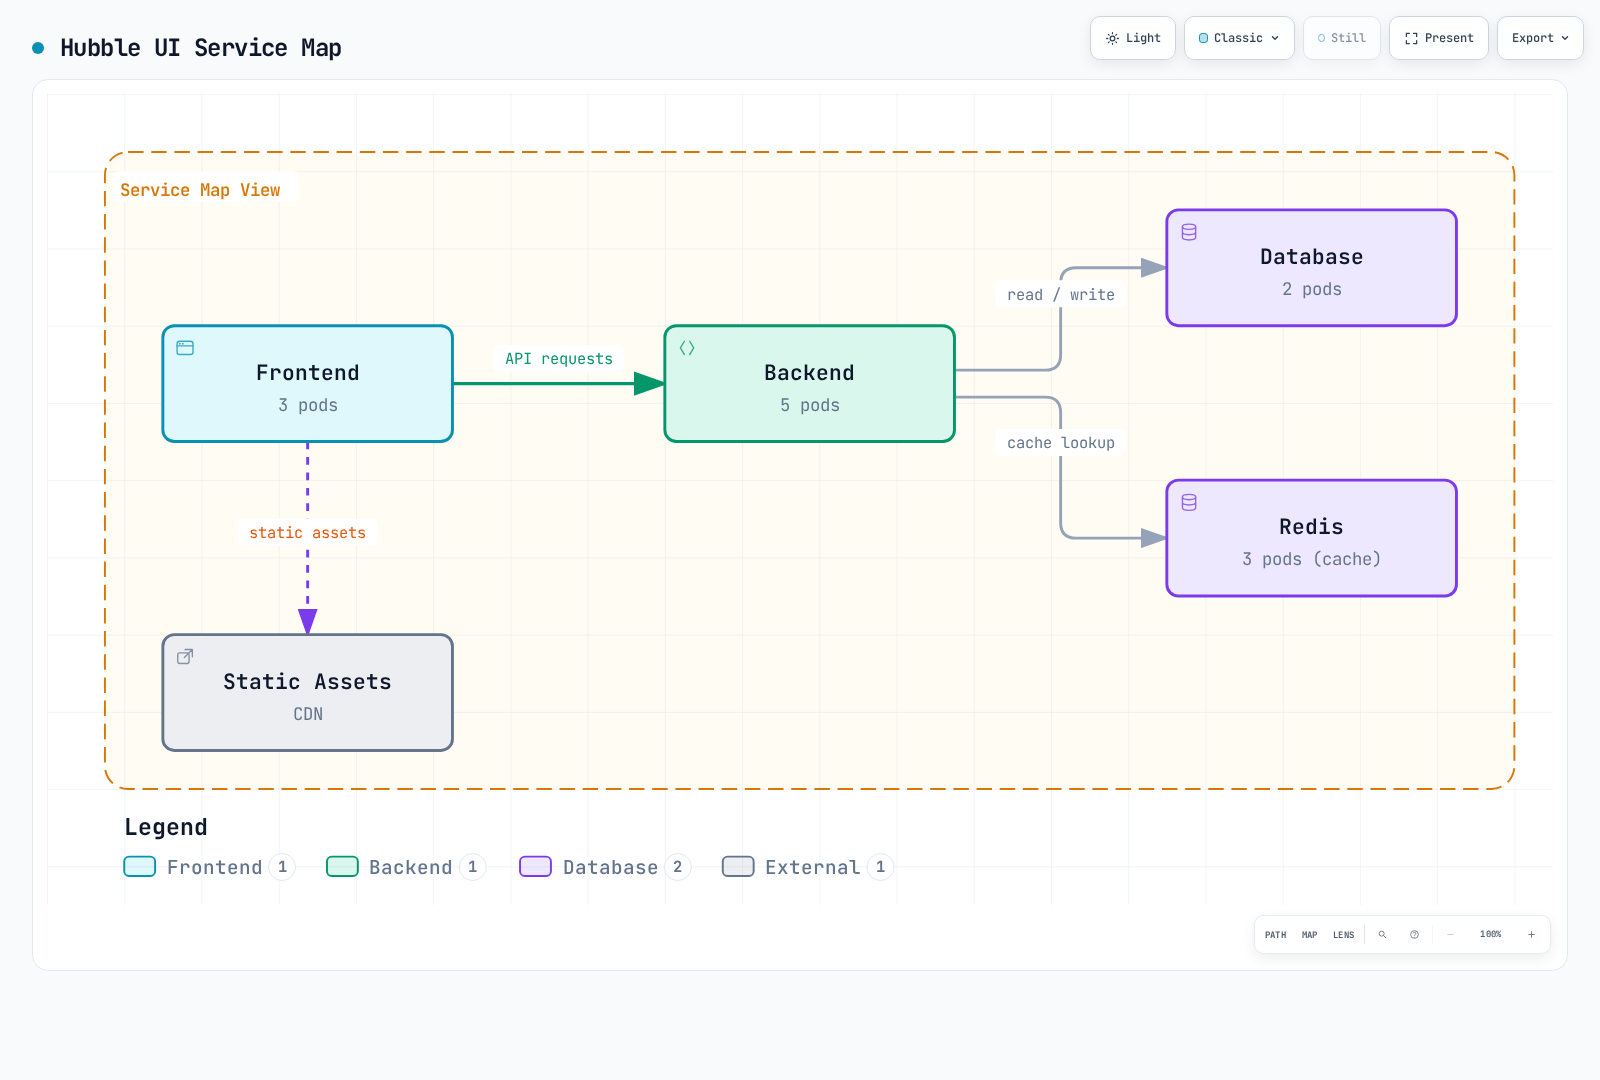
UIの関係は観測通信から得られます。静かなワークロード、非対応経路、外部ブラウザー/CDN通信、エンドポイントメタデータ欠損は表示されない場合があります。辺がないことは依存がない証明ではありません。
UIの機能とアクセス
UIは名前空間/判定フィルター、最近のフロー詳細、観測サービスマップを提供します。L7詳細にはL7可視性が必要です。
kubectl -n kube-system port-forward --address 127.0.0.1 service/hubble-ui 12000:80
# Open http://localhost:12000
L7フロー可視性
HTTP、gRPC、DNS
hubble observe --protocol http --last 100 -o json |
  jq 'select(.flow.l7.type == "RESPONSE") | .flow.l7.http'
hubble observe --protocol http --last 100 -o json |
  jq 'select(.flow.l7.type == "RESPONSE") |
      select((.flow.l7.latency_ns // "0" | tonumber) > 1000000000)'
hubble observe --protocol dns --last 100 -o json |
  jq 'select(.flow.l7.dns.rcode == 3)'
hubble observe --protocol http --http-path '^/myapp[.]UserService/GetUser$'
hubble observe --port 9092JSON対応は64ビットlatency_nsを文字列としてエンコードします。数値比較前にtonumberで変換してください。文字列をJSON数値と直接比較すると遅い要求の結果が誤ります。
HTTP応答レコードは状態を持ちますが、要求レコードにはまだない場合があります。gRPCメソッドはHTTPパスで選べますが、HTTP 200はアプリレベルgRPC成功を意味しません。必要ならRPC結果を別収集します。
選択CLIに--dns-rcodeはありません。JSONの数値DNS応答コードを確認し、3はNXDOMAINです。CLIのkafkaフィルターは互換過去データを読めますが、Cilium 1.20.1で削除したKafka L7処理を復活させません。9092フィルターはL4観測で、トピック/操作検査ではありません。
Prometheusメトリクス
収集の有効化
各ハンドラーを1度ずつ有効にします。例えばdnsはDNSメトリクス群を出し、dns:queryは別クエリカウンターを有効にせずクエリ名コンテキストを追加します。query/response/durationの別エントリとしてdnsやhttpを繰り返すと重複メトリクス群の登録を試みます。
httpV2は非推奨httpを置き換え、同時には有効化できません。hubble_http_requests_totalカウンターは応答イベントを使い、statusを含み、要求方向のsource/destinationコンテキストを示します。旧hubble_http_responses_total群は出しません。
基本オーバーレイはnamespace/workloadコンテキストラベルを明示要求します。destination_serviceは対応labelsContext名ではありません。Prometheus Operator CRD/コントローラー導入とセレクター確認後にだけ実収集を追加します。
prometheus:
  serviceMonitor:
    enabled: true
    labels:
      release: prometheus
    relabelings:
    - sourceLabels:
      - __meta_kubernetes_pod_node_name
      targetLabel: node
      action: replace
      replacement: ${1}
    - targetLabel: cluster
      replacement: example-cluster
      action: replace
hubble:
  metrics:
    serviceMonitor:
      enabled: true
      labels:
        release: prometheus
      relabelings:
      - sourceLabels:
        - __meta_kubernetes_pod_node_name
        targetLabel: node
        action: replace
        replacement: ${1}
      - targetLabel: cluster
        replacement: example-cluster
action: replaceexample-clusterを意図した一意メトリクスラベル、release: prometheusを実Prometheusセレクターに合うラベルへ置き換えます。リストのカスタマイズ時はノードrelabelを保持します。以下ルールも対応ruleSelector/名前空間選択が必要です。
このrelabelはスクレイプ対象とサンプルにclusterを加えます。Prometheusのexternal_labelsだけではローカルクエリサンプルに追加されません。実ターゲットラベルを確認します。job="hubble-metrics"やjob="cilium-agent"例は通常のService由来job名を前提とします。
記録ルールとアラートルール
Prometheusがルールを評価し、Alertmanagerが通知ルーティングを扱います。依存クエリ/ダッシュボードの前に記録ルールを読み込む必要があります。
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: cilium-hubble-observation
  namespace: monitoring
  labels:
    release: prometheus
spec:
  groups:
  - name: cilium.hubble.httpv2
    rules:
    - record: cilium_hubble:http_responses:rate5m
      expr: sum by (cluster, destination_namespace, destination_workload) (rate(hubble_http_requests_total{reporter="server",cluster!="",destination_namespace!="",destination_workload!=""}[5m]))
    - record: cilium_hubble:http_5xx:rate5m
      expr: 'sum by (cluster, destination_namespace, destination_workload) (rate(hubble_http_requests_total{reporter="server",cluster!="",destination_namespace!="",destination_workload!="",status=~"5.."}[5m]))

        or on (cluster, destination_namespace, destination_workload) (0 * cilium_hubble:http_responses:rate5m)'
    - record: cilium_hubble:http_5xx_percent:rate5m
      expr: '(100 * cilium_hubble:http_5xx:rate5m / cilium_hubble:http_responses:rate5m)

        and on (cluster, destination_namespace, destination_workload) (cilium_hubble:http_responses:rate5m
        > 0)'
    - record: cilium_hubble:http_latency_bucket:rate5m
      expr: sum by (le, cluster, destination_namespace, destination_workload) (rate(hubble_http_request_duration_seconds_bucket{reporter="server",cluster!="",destination_namespace!="",destination_workload!=""}[5m]))
    - alert: HighObservedHTTP5xx
      expr: (cilium_hubble:http_5xx_percent:rate5m > 5) and on (cluster, destination_namespace,
        destination_workload) (cilium_hubble:http_responses:rate5m > 1)
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: High observed HTTP 5xx ratio
        description: '{{ $labels.cluster }}/{{ $labels.destination_namespace }}/{{
          $labels.destination_workload }}: {{ $value }}%'
    - alert: HighObservedHTTPP99
      expr: (histogram_quantile(0.99, cilium_hubble:http_latency_bucket:rate5m) >
        1) and on (cluster, destination_namespace, destination_workload) (cilium_hubble:http_responses:rate5m
        > 1)
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: High observed HTTP latency
        description: '{{ $labels.cluster }}/{{ $labels.destination_namespace }}/{{
          $labels.destination_workload }}: {{ $value }}s'
    - alert: HubbleMetricsScrapeFailed
      expr: up{job="hubble-metrics"} == 0
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: Known Hubble metrics target cannot be scraped
    - alert: CiliumBPFMapPressure
      expr: cilium_bpf_map_pressure > 0.9
      for: 5m
      labels:
        severity: warning
      annotations:
        summary: High pressure in an instrumented BPF map
        description: '{{ $labels.cluster }}/{{ $labels.node }} {{ $labels.map_name
}}: {{ $value }}'例はサーバー/Ingress観測境界を選びます。クライアント/Egress観測が同じ交換を表す場合があり、境界混在は二重計上になり得ます。複数GatewayやL7ポリシーがある場合は実プロキシ経路を確認します。
欠けた5xx系列を0にするのは対応する観測合計がある場合だけです。アイドル合計を割って偽の正常割合にせず、観測欠損は欠損のままです。これらの比率は全TCP失敗、拒否要求、応答欠損、アプリレベル失敗をカバーしません。
しきい値、毎秒1応答の下限、5分期間はワークロードのエラーバジェットに合わせる例です。up == 0は既知のスクレイプ対象失敗を検出し、対象自体の欠損は別の一覧/準備確認が必要です。マップ圧力メトリクスは計装マップだけが対象で、policy-map圧力は報告しきい値未満で存在しない場合があります。
主なクエリ
最初の3クエリは上の記録ルールを使います。単位と観測範囲もメトリクスの意味の一部です。
観測したサーバーHTTP応答数/秒
cilium_hubble:http_responses:rate5m観測したHTTP5xx割合
cilium_hubble:http_5xx_percent:rate5m観測したHTTP P99秒
histogram_quantile(0.99, cilium_hubble:http_latency_bucket:rate5m)Hubbleフロー破棄イベント数/秒
sum by (cluster, reason) (rate(hubble_drop_total[5m]))観測したDNSクエリ数/秒
sum by (cluster) (rate(hubble_dns_queries_total[5m]))観測したSYNフラグ出現数/秒
sum by (cluster) (rate(hubble_tcp_flags_total{flag="SYN"}[5m]))観測したフローイベント数/秒
sum by (cluster) (rate(hubble_flows_processed_total[5m]))Cilium転送バイト数/秒
sum by (cluster, node, direction) (rate(cilium_forward_bytes_total[5m]))Prometheusスクレイプ成功
up{job=~"cilium-agent|hubble-metrics"}管理エンドポイント数
cilium_endpoint読み込み済みポリシー数
cilium_policy計装されたBPFマップ圧力
cilium_bpf_map_pressure最後のGC時のCTエントリ
cilium_datapath_conntrack_gc_entries設定済みエンドポイントプロキシリダイレクト
cilium_proxy_redirectshubble_flows_processed_totalはバイトでなくフローイベントを数えます。Hubble破棄イベントとエージェントのパケットカウンターは違います。SYN出現には再送も含み、アクティブ接続ゲージではありません。
エージェントは旧*_countでなくcilium_endpointとcilium_policyを公開します。cilium_datapath_conntrack_gc_entriesはGC実行時の観測エントリです。旧cilium_datapath_conntrack_active/max比率は文書化された現行メトリクス対ではありません。cilium_proxy_redirectsは設定済みリダイレクトを数え、要求数ではありません。BPF圧力/容量には独自mapラベルと報告動作があります。無関係な使用率分母を作らないでください。
Grafanaダッシュボード
リリースされたダッシュボード
Ciliumは選択リリースにダッシュボードJSONを含みます。有効メトリクスと対象ラベルに照らして各ダッシュボードを確認します。一般Hubbleダッシュボードには旧HTTP応答クエリがまだあり、HTTPワークロード用はHTTPv2型データとcluster/workload変数を使います。成功系列がない場合は成功率パネルにも注意が必要です。
旧v1.12ダッシュボードID一覧は、このガイドに版が一致する導入手順ではありません。以下のカスタムは修正済み記録ルール、明示データソース入力、配置、単位を使います。既存Grafanaへインポートし、一致Prometheusデータソースを選びます。
カスタムダッシュボード例
{
  "__inputs": [
    {
      "name": "DS_PROMETHEUS",
      "label": "Prometheus",
      "type": "datasource",
      "pluginId": "prometheus",
      "pluginName": "Prometheus"
    }
  ],
  "id": null,
  "uid": "cilium-hubble-observed",
  "title": "Cilium Hubble Observations",
  "tags": [
    "cilium",
    "hubble"
  ],
  "schemaVersion": 38,
  "version": 1,
  "timezone": "browser",
  "time": {
    "from": "now-1h",
    "to": "now"
  },
  "refresh": "30s",
  "panels": [
    {
      "id": 1,
      "title": "Observed HTTP responses/s",
      "type": "timeseries",
      "gridPos": {
        "x": 0,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "cilium_hubble:http_responses:rate5m",
          "legendFormat": "{{cluster}} / {{destination_namespace}} / {{destination_workload}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "reqps"
        },
        "overrides": []
      }
    },
    {
      "id": 2,
      "title": "Observed HTTP5xx (%)",
      "type": "timeseries",
      "gridPos": {
        "x": 12,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "cilium_hubble:http_5xx_percent:rate5m",
          "legendFormat": "{{cluster}} / {{destination_namespace}} / {{destination_workload}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "percent"
        },
        "overrides": []
      }
    },
    {
      "id": 3,
      "title": "Observed HTTP P99",
      "type": "timeseries",
      "gridPos": {
        "x": 0,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "histogram_quantile(0.99, cilium_hubble:http_latency_bucket:rate5m)",
          "legendFormat": "{{cluster}} / {{destination_namespace}} / {{destination_workload}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "s"
        },
        "overrides": []
      }
    },
    {
      "id": 4,
      "title": "Observed flow drops/s",
      "type": "timeseries",
      "gridPos": {
        "x": 12,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "datasource": {
        "type": "prometheus",
        "uid": "${DS_PROMETHEUS}"
      },
      "targets": [
        {
          "refId": "A",
          "expr": "sum by (cluster, reason) (rate(hubble_drop_total[5m]))",
          "legendFormat": "{{cluster}} / {{reason}}"
        }
      ],
      "fieldConfig": {
        "defaults": {
          "unit": "ops"
        },
        "overrides": []
      }
    }
  ]
}
報告するのは観測で、保証されたエンドツーエンドアプリSLIではありません。欠損データは通信、L7可視性、スクレイプを調べる契機にします。
サービス依存マップ
依存関係の抽出
例は方向を維持し、ワークロードメタデータ欠損でのエラーを避け、Ingress境界で観測したHTTP要求をグループ化します。
hubble observe --namespace production --protocol http --traffic-direction ingress --last 1000 -o json |
  jq -r 'select(.flow.l7.type == "REQUEST") |
    [.flow.source.namespace,
     (.flow.source.workloads[0].name // .flow.source.pod_name // "unknown"),
     .flow.destination.namespace,
     (.flow.destination.workloads[0].name // .flow.destination.pod_name // "unknown")] |
    @tsv' |
  sort | uniq -c | sort -rn
数は選択観測の数で、自動的に要求レートや完全な依存一覧にはなりません。不明エンドポイントと観測経路外の依存には他の証拠が必要です。
サービスマップ例
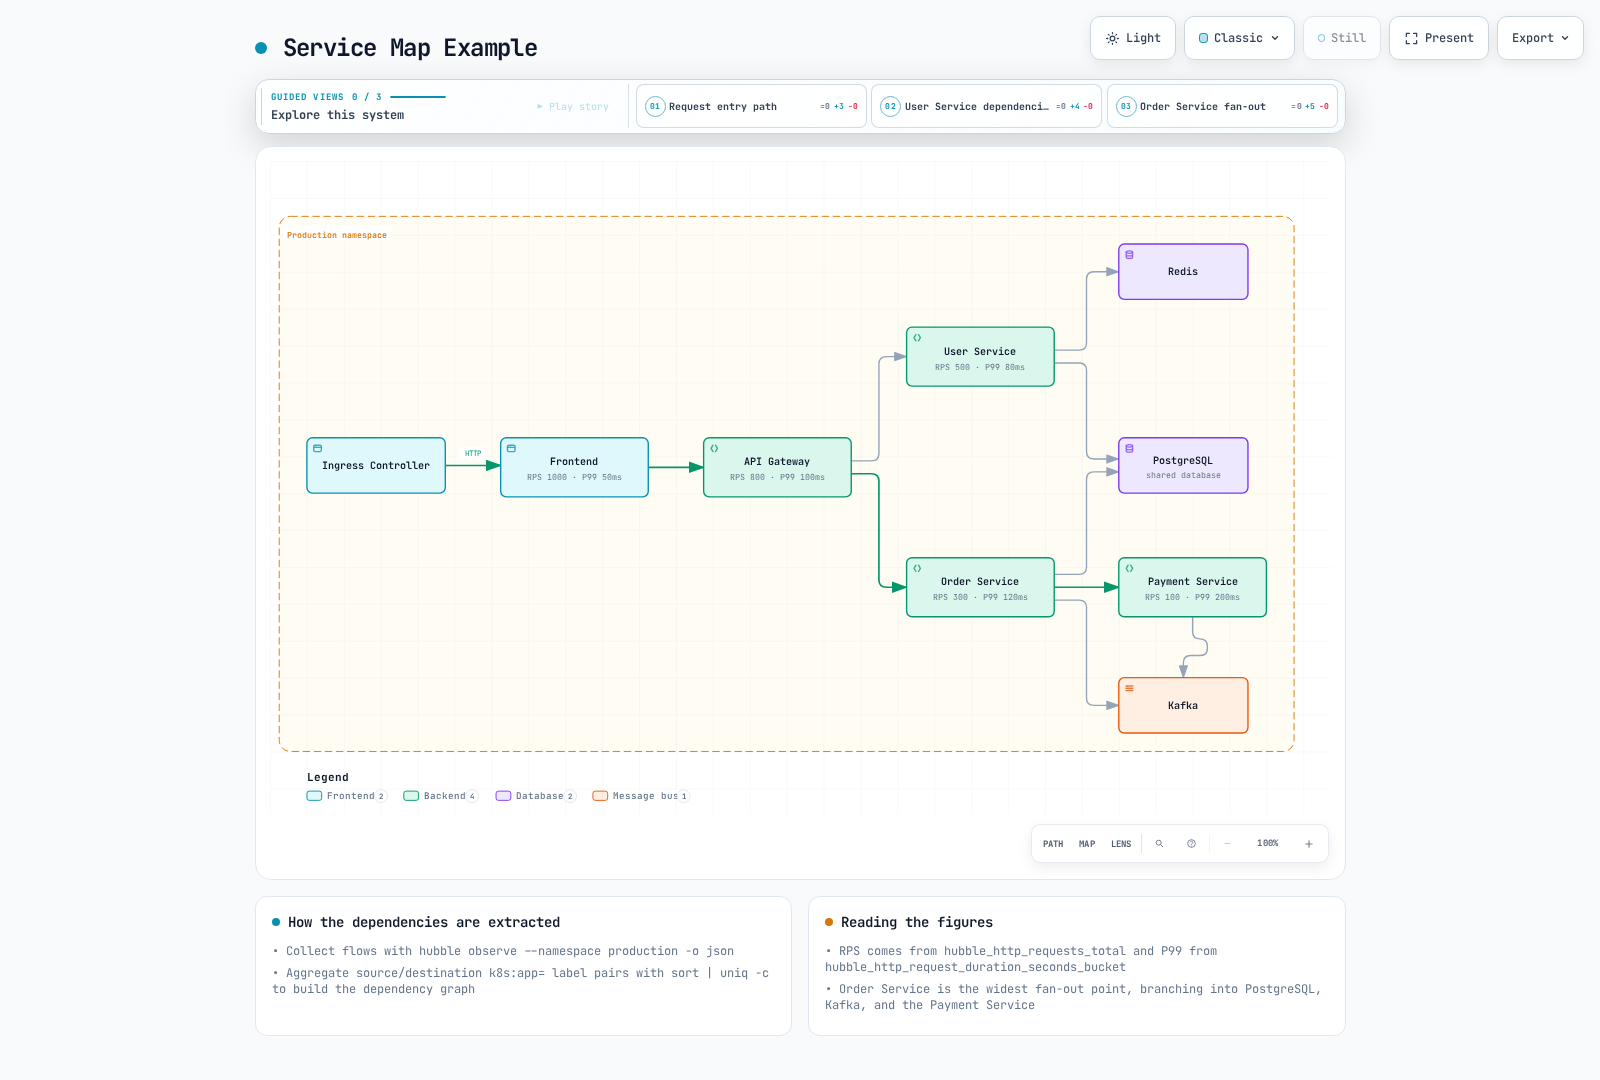
図の数値にはここでは測定根拠がありません。容量やSLOしきい値の選択でなく関係の説明に使います。CiliumはKafkaのトピックレベル可視性なしでもKafkaへのL4通信を観測できます。
ゴールデンシグナル監視
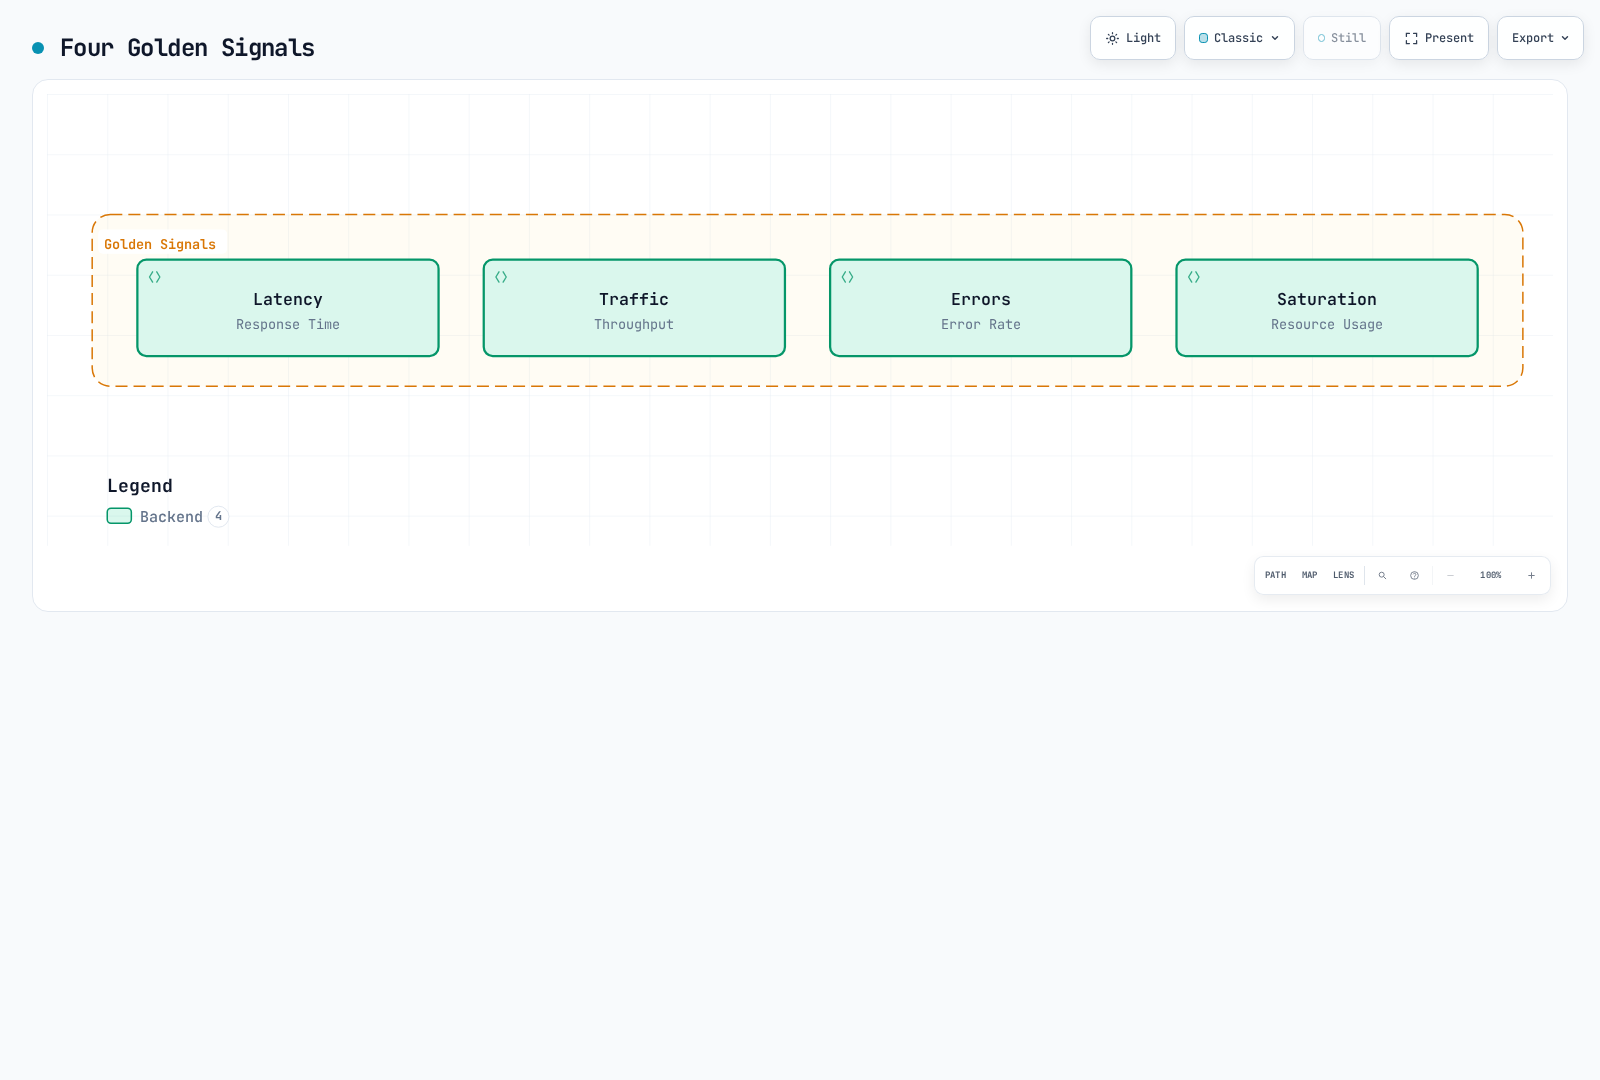
サービスに合う定義で使います。可用性は4つの名前にはありませんが明示SLIが必要で、観測HTTP 5xx比率は完全な可用性測定ではありません。ヒストグラム分位数はインスタンス別パーセンタイルを平均せず、leを保持して互換バケットを集約します。
OpenTelemetry統合
Hubbleフローのエクスポート
選択チャートは静的/動的なファイルエクスポートをサポートします。旧hubble.export.opentelemetryとfileOutputはOTLP送信を設定しません。
例はファイルローテーションを制限し、フィールドを選択して、productionが関係する観測の動的エクスポーターを有効にします。
hubble:
  export:
    static:
      enabled: false
    dynamic:
      enabled: true
      config:
        createConfigMap: true
        configMapName: cilium-flowlog-config
        content:
        - name: production
          filePath: /var/run/cilium/hubble/events.log
          fileMaxSizeMb: 10
          fileMaxBackups: 5
          fileCompress: false
          includeFilters:
          - source_pod:
            - production/
          - destination_pod:
            - production/
          excludeFilters: []
          fieldMask:
          - time
          - node_name
          - source.namespace
          - source.pod_name
          - source.workloads
          - destination.namespace
          - destination.pod_name
          - destination.workloads
          - IP
          - l4
          - verdict
          - drop_reason_desc
          - l7.type
          - l7.latency_ns
          - l7.http.code
          - l7.http.method
          - l7.http.protocol
          - l7.dns.rcode
2つのincludeフィルターは選択肢で、送信元か宛先がその名前空間です。このマスクはHTTP URL/ヘッダーとワークロードラベルを省き、追加フィールドは意図的に選びます。エクスポーター有効化後の動的設定更新はエージェント再起動なしで適用できますが、初回有効化/導入変更には適切なロールアウトが必要です。
ローテーションはローカルファイル保持で、耐久性のある中央ストレージではありません。期待ノードへの書き込みを確認し、適切なログ読み取りを用意します。
Collector設定
以下はCollector Contrib 0.160.0の設定で、Deploymentではありません。ノードローカルCollector DaemonSetに、対応ホストログディレクトリの読み取り権限、書き込み可能な永続チェックポイントストレージ、downward APIのK8S_NODE_NAMEを用意する必要があります。
extensions:
  file_storage:
    directory: /var/lib/otelcol/file_storage
    create_directory: true
receivers:
  filelog/hubble:
    include:
    - /var/run/cilium/hubble/events*.log
    start_at: end
    storage: file_storage
    operators:
    - type: json_parser
      parse_from: body
      parse_to: body
      timestamp:
        parse_from: body.time
        layout_type: gotime
        layout: 2006-01-02T15:04:05.999999999Z07:00
processors:
  memory_limiter:
    check_interval: 1s
    limit_mib: 128
    spike_limit_mib: 32
  resource/hubble:
    attributes:
    - key: service.name
      value: hubble-flow-logs
      action: upsert
    - key: k8s.node.name
      value: ${env:K8S_NODE_NAME}
      action: upsert
  batch:
    timeout: 5s
exporters:
  otlphttp/loki:
    endpoint: https://logs.example.com/otlp
    headers:
      X-Scope-OrgID: example-tenant
    tls:
      ca_file: /etc/otel/tls/backend-ca.crt
service:
  extensions:
  - file_storage
  pipelines:
    logs:
      receivers:
      - filelog/hubble
      processors:
      - memory_limiter
      - resource/hubble
      - batch
      exporters:
      - otlphttp/loki
例示バックエンドアドレス、テナント、CAパスを実Loki OTLPエンドポイントと信頼設定に置き換えます。選択Gatewayに必要な認証を提供してください。X-Scope-OrgIDはテナント識別で認証ではありません。
filelog receiverはJSON本文と時刻を解析します。永続file_storageチェックポイントは読み取りオフセットを保持します。一時チェックポイントボリュームは再起動動作を変え得ます。start_at: endは保存位置がないと既存内容を飛ばし、再生/インポート設定ではありません。
Loki 3.7.7は/otlp/v1/logsでOTLP/HTTPログを受け入れます。エクスポーターが/otlp基本エンドポイントに/v1/logsを追加します。Lokiは構造化メタデータと互換ストレージ設定に対応し、有効にする必要があります。削除されたCollector lokiエクスポーターを使わないでください。リソース属性service.nameはLokiラベルservice_nameとなり、構造化本文はログ内容に残ります。
フローログ、Prometheusメトリクス、アプリトレースは異なるシグナルです。
| シグナル | このガイドの経路 |
|---|---|
| Hubbleフロー記録 | ファイルエクスポーター → ノードfilelog receiver → OTLP/HTTPログバックエンド |
| Hubble/エージェントメトリクス | メトリクスエンドポイント → Prometheus収集 |
| アプリ/Envoyトレース | 別の計装と適切なトレースパイプライン/バックエンド |
旧Collector jaegerエクスポーターも選択ディストリビューションにはありません。現Jaegerは正しく設定したトレースパイプラインでOTLPトレースを受け取れますが、フローログをトレースエクスポーターへ向けても分散トレースにはなりません。この章のCollectorはログだけを出力します。
トラブルシューティング
状態と設定
cilium status
hubble status --server localhost:4245
kubectl -n kube-system get daemonset cilium
kubectl -n kube-system get deployment hubble-relay hubble-ui
kubectl -n kube-system get configmap cilium-config -o yaml
kubectl -n kube-system get pods -l k8s-app=cilium -o wide
CILIUM_POD='<agent-on-the-node-being-inspected>'
kubectl -n kube-system exec "$CILIUM_POD" -c cilium-agent -- cilium-dbg status --verbose
kubectl -n kube-system exec "$CILIUM_POD" -c cilium-agent -- cilium-dbg bpf ct list global
kubectl -n kube-system logs deployment/hubble-relay --since=10m関連ノードのAgentを使います。クライアント側cilium CLIとAgent内cilium-dbgは別です。エラーと全状態を保持してください。grep出力は準備完了の証明ではありません。
フローなし/メトリクス欠損
データパスが壊れたと結論する前に通信生成、保持期間、フィルターを確認します。接続HubbleインスタンスとTLS/証明書更新を検証し、次を区別します。
- 名前空間、プレフィックス、方向、プロトコルの誤フィルターで一致観測がない。
- 対応L7可視性が未設定、またはペイロードが暗号化のままでHTTP観測がない。
- Relay/サーバーが利用不能、またはメトリクス対象にアクセス不能。
- ServiceMonitor/PrometheusRuleが実Prometheusに選択されていない。
- context/clusterラベル不足、または異なるハンドラー用クエリ。
- エクスポート/readerエラー、ローテーション/保持の欠損、観測喪失。
グラフを埋めるためだけに無制限の接続テストを回さないでください。準備ワークロードに管理された通信を使い、各観測の意味を検証します。