Kubernetes Pods と Workloads
対応バージョン: Kubernetes 1.35, 1.36, 1.37 最終更新: October 12, 2026
このドキュメントでは、Kubernetes の基本的な実行単位である Pod と、それらを管理するさまざまな workload resource について詳しく説明します。Pod の概念から始めて、Deployment、StatefulSet、DaemonSet など、さまざまな workload resource の特徴とユースケースを取り上げます。
Lab 環境のセットアップ
このドキュメントの例を実行するには、以下のツールと環境が必要です。
必要なツール
- API server と 1 つのマイナーバージョン以内の kubectl
- 稼働中の Kubernetes cluster(EKS、minikube、kind など)
サンプルアプリケーションのデプロイ
# Create namespace
kubectl create namespace workloads-demo

# Create a simple deployment
kubectl -n workloads-demo apply -f - <<EOF
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
  labels:
    app: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
        resources:
          requests:
            memory: "64Mi"
            cpu: "100m"
          limits:
            memory: "128Mi"
            cpu: "200m"
EOF

# Check deployment status
kubectl -n workloads-demo get deployments,pods
目次
- Pod の概念
- Pod のライフサイクル
- Pod の設計パターン
- Workload Resources の概要
- ReplicaSet
- Deployment
- StatefulSet
- DaemonSet
- Job と CronJob
Pod の概念
重要な概念: Pod は Kubernetes における最小のデプロイ可能なコンピューティング単位であり、storage と network を共有する 1 つ以上の container group から構成されます。
Pod は Kubernetes における最小のデプロイ可能なコンピューティング単位です。Pod は、storage と network を共有し、まとめてスケジューリングされる 1 つ以上の container のグループです。
Pod の特徴
- 共有コンテキスト: Container は Pod network と通常は IPC を共有します。process namespace の共有には
shareProcessNamespace: trueが必要です。Container の root filesystem は引き続き分離されています。 - 同一 Node: Pod 内のすべての container は常に同じ node で実行されます。
- 一意の IP アドレス: 各 Pod には cluster 内で一意の IP アドレスが割り当てられます。
- 一時的: Pod は本質的に一時的であり、障害時には新しい Pod に置き換えられることがあります。
- アトミックな単位: Pod は deployment、scheduling、replication のアトミックな単位です。
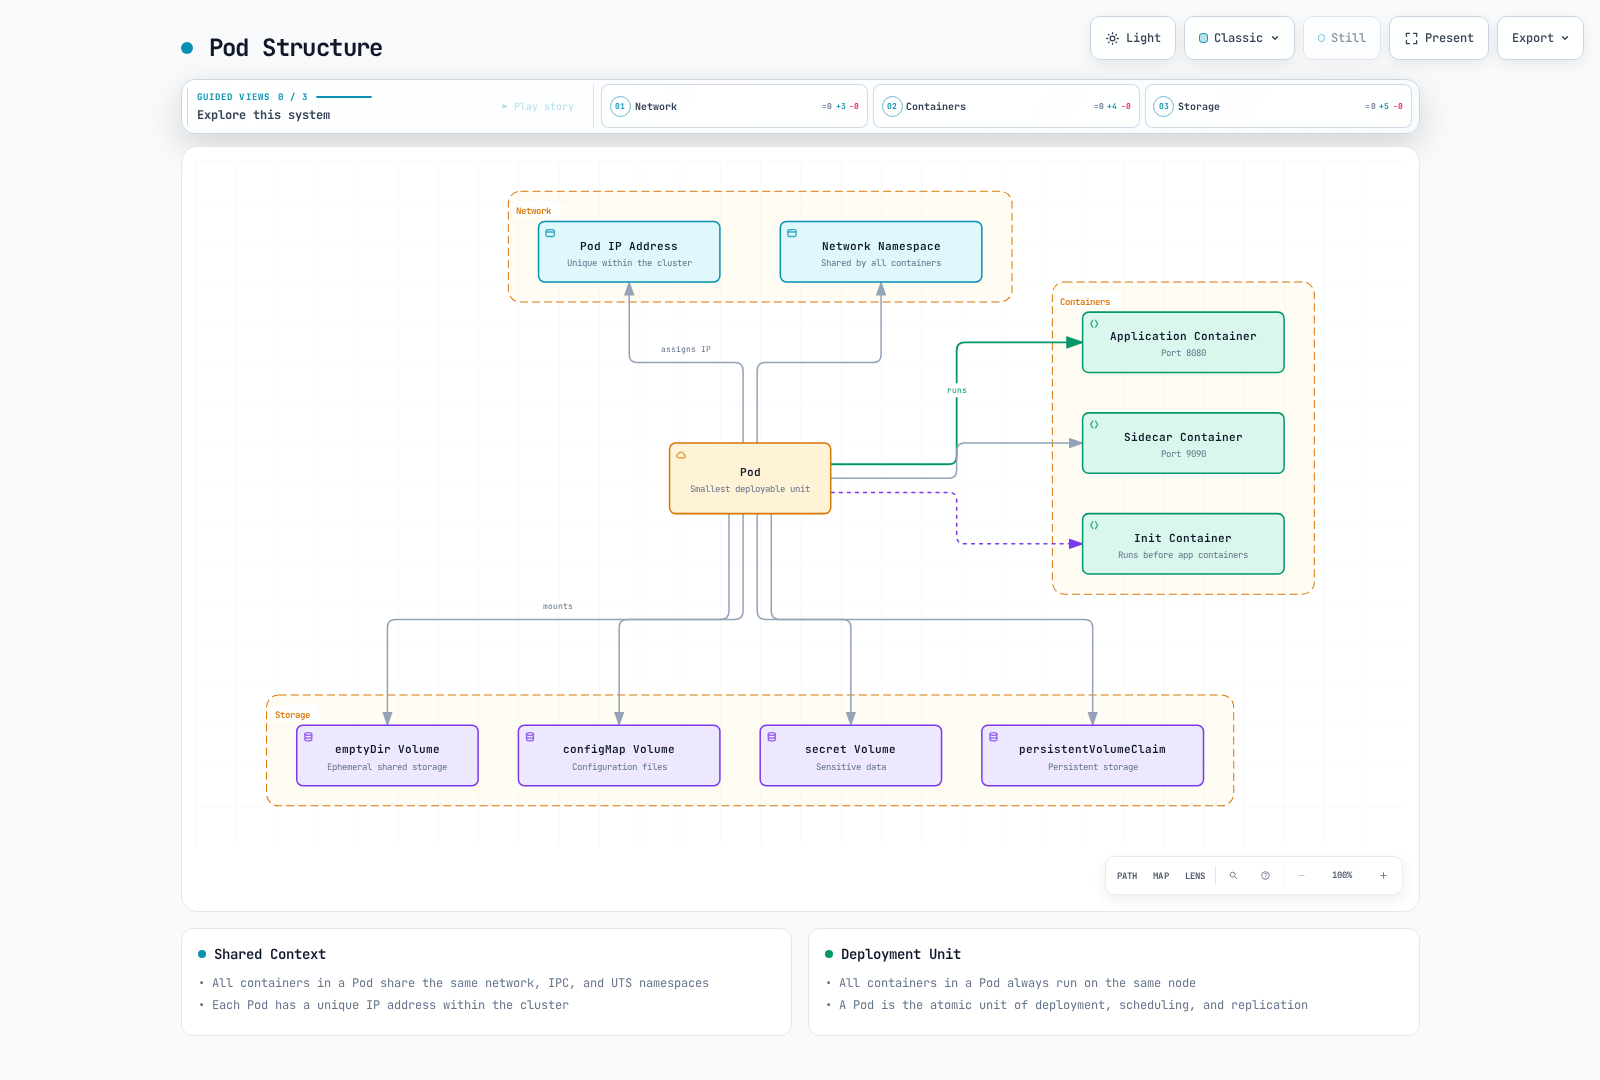
Pod の構造
Pod は次のコンポーネントで構成されます。
- Containers: Pod 内で実行される 1 つ以上の container
- Volumes: Pod 内の container が共有する storage
- Network: Pod に割り当てられる IP アドレスと port
- Container Spec: Container image、環境変数、resource requirements など
Pod の例
apiVersion: v1
kind: Pod
metadata:
  name: multi-container-pod
  labels:
    app: web
spec:
  containers:
  - name: web
    image: nginx:1.30.4
    ports:
    - containerPort: 80
    volumeMounts:
    - name: shared-data
      mountPath: /usr/share/nginx/html
  - name: content-updater
    image: alpine
    command: ["/bin/sh", "-c"]
    args:
    - |
      while true; do
        echo "Current time: $(date)" > /content/index.html;
        sleep 10;
      done
    volumeMounts:
    - name: shared-data
      mountPath: /content
  volumes:
  - name: shared-data
    emptyDir: {}
実践例: Web Application Pod
以下は、web application と sidecar container を含む Pod の例です。
apiVersion: v1
kind: Pod
metadata:
  name: web-app
  labels:
    app: web
    environment: production
spec:
  containers:
  - name: web-application
    image: nginx:1.30.4
    volumeMounts:
    - name: log-volume
      mountPath: /var/log/nginx
    ports:
    - containerPort: 80
    resources:
      requests:
        memory: "128Mi"
        cpu: "100m"
      limits:
        memory: "256Mi"
        cpu: "500m"
  - name: log-collector
    image: fluentd:v1.19-debian-1
    volumeMounts:
    - name: log-volume
      mountPath: /var/log/nginx
    resources:
      requests:
        memory: "64Mi"
        cpu: "50m"
      limits:
        memory: "128Mi"
        cpu: "100m"
  volumes:
  - name: log-volume
    emptyDir: {}
この例は、次の実際のシナリオを示しています。
- Nginx web server をメイン container として実行する
- Fluentd log collector を sidecar container として実行する
- 2 つの container 間で log volume を共有する
- 各 container に resource request と limit を設定する
この構成は、microservice architecture において logging、monitoring、proxying などの機能を分離しつつ、密接に接続された container を実行するのに適しています。
これらの logging manifest は volume の接続方法を示しています。Fluentd には明示的な tail source と output configuration も必要です。directory をマウントするだけでは log は収集されません。Image と application configuration は例示であり、production 向けの version 推奨ではありません。Native sidecar は restartPolicy: Always を指定した initContainers を使用します(v1.33 以降で stable)。通常の multi-container Pod では、startup または shutdown の順序は保証されません。
Pod の定義
Pod は YAML または JSON 形式の manifest file を使用して定義します。以下は基本的な Pod 定義の例です。
apiVersion: v1
kind: Pod
metadata:
  name: nginx-pod
  labels:
    app: nginx
spec:
  containers:
  - name: nginx
    image: nginx:1.30.4
    ports:
    - containerPort: 80
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
Single Container Pod と Multi-Container Pod
Single Container Pod:
- 最も一般的なユースケース
- 1 つの application container のみを含む
- シンプルで直感的な構造
Multi-Container Pod:
- 密接に結合された複数の container を含む
- Container 間でローカル通信が可能(localhost)
- 共有 volume を介したデータ共有
- まとめてスケーリングおよび配置される
Multi-Container Pod パターン
- Sidecar Pattern: メイン container の機能を拡張する補助 container
- 例: log collector、file synchronization、proxy
apiVersion: v1
kind: Pod
metadata:
  name: web-with-sidecar
spec:
  containers:
  - name: web
    image: nginx:1.30.4
    volumeMounts:
    - name: logs
      mountPath: /var/log/nginx
  - name: log-collector
    image: fluentd:v1.19-debian-1
    volumeMounts:
    - name: logs
      mountPath: /var/log/nginx
  volumes:
  - name: logs
emptyDir: {}- Ambassador Pattern: 外部 service への proxy として機能する container
- 例: database proxy、service mesh sidecar
apiVersion: v1
kind: Pod
metadata:
  name: app-with-ambassador
spec:
  containers:
  - name: app
    image: myapp:1.0
  - name: ambassador
    image: envoyproxy/envoy:v1.20.0
    ports:
- containerPort: 9901- Adapter Pattern: メイン container の出力を標準化する container
- 例: log format conversion、metrics conversion
apiVersion: v1
kind: Pod
metadata:
  name: app-with-adapter
spec:
  containers:
  - name: app
    image: myapp:1.0
    volumeMounts:
    - name: app-logs
      mountPath: /var/log/app
  - name: adapter
    image: adapter:1.0
    volumeMounts:
    - name: app-logs
      mountPath: /var/log/app
  volumes:
  - name: app-logs
emptyDir: {}- Init Container Pattern: メイン container の起動前に実行される container
- 例: configuration file の作成、database migration、permission setup
apiVersion: v1
kind: Pod
metadata:
  name: app-with-init
spec:
  initContainers:
  - name: init-db
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup db; do echo waiting for db; sleep 2; done;']
  containers:
  - name: app
    image: myapp:1.0
Pod Networking
Pod 内の container には次の networking 特性があります。
- 同じ IP アドレス: Pod 内のすべての container は同じ IP アドレスを共有します。
- Port の共有: Pod 内の container は port space を共有するため、通常、同じ IP/protocol/port の組み合わせには bind できません。
- Localhost 通信: Pod 内の container は localhost 経由で相互に通信できます。
- Pod 間通信: 各 Pod は一意の IP アドレスを持ち、他の Pod と直接通信できます。
Pod Storage
Pod はさまざまな種類の volume を使用して、データを保存および共有できます。
- emptyDir: Pod の作成時に作成され、Pod の削除時に削除される一時 volume
- hostPath: Host node の file system から Pod にマウントされる volume
- persistentVolumeClaim: Persistent storage を要求する volume
- configMap: Volume としてマウントされる ConfigMap
- secret: Volume としてマウントされる Secret
- projected: 同じ directory にマッピングされる複数の volume source
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-volumes
spec:
  containers:
  - name: app
    image: myapp:1.0
    volumeMounts:
    - name: data
      mountPath: /data
    - name: config
      mountPath: /etc/config
  volumes:
  - name: data
    emptyDir: {}
  - name: config
    configMap:
      name: app-config
Pod のライフサイクル
Pod は作成から終了まで、さまざまな lifecycle stage を経ます。この lifecycle を理解することは、application の安定性と可用性を確保するうえで重要です。
Pod Phase
Pod は次の phase を経ます。
- Pending: Pod は cluster に受け入れられましたが、1 つ以上の container がまだセットアップされていません
- Running: Pod は node に割り当てられ、すべての container が作成され、少なくとも 1 つの container が実行中または起動中/再起動中です
- Succeeded: Pod 内のすべての container が正常に終了し、再起動されません
- Failed: Pod 内のすべての container が終了し、少なくとも 1 つの container が失敗により終了しました
- Unknown: 何らかの理由で Pod の状態を取得できませんでした
Container State
Pod 内の各 container は次の state を持つことができます。
- Waiting: Container の実行前の状態(image のダウンロード、dependency の待機など)
- Running: Process が実行中です。これだけでは application の健全性または readiness は確立されません
- Terminated: Container が実行を完了したか、何らかの理由で失敗しました
Pod Condition
Pod は次の condition を通じて、より具体的に状態を示します。
- PodScheduled: Pod が node にスケジューリングされたかどうか
- ContainersReady: Pod 内のすべての container が ready かどうか
- Initialized: 通常の init container が完了し、restartable init container(native sidecar)が起動したかどうか
- Ready: Pod が request を処理でき、service の load balancing pool に追加できるかどうか
Container Probe
Kubernetes は container の状態を確認するために、次の probe を提供します。
- livenessProbe: Container が生存しているかを確認します。失敗時には container を再起動します
- readinessProbe: Container が request を処理する準備ができているかを確認します。失敗時には service traffic から除外します
- startupProbe: Container 内の application が起動したかを確認します。成功するまで他の probe を無効にします
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-probes
spec:
  containers:
  - name: app
    image: myapp:1.0
    ports:
    - containerPort: 8080
    livenessProbe:
      httpGet:
        path: /healthz
        port: 8080
      initialDelaySeconds: 30
      periodSeconds: 10
      timeoutSeconds: 5
      failureThreshold: 3
    readinessProbe:
      httpGet:
        path: /ready
        port: 8080
      initialDelaySeconds: 5
      periodSeconds: 5
    startupProbe:
      httpGet:
        path: /startup
        port: 8080
      failureThreshold: 30
      periodSeconds: 10
Pod 終了プロセス
Pod が終了されると、次のプロセスが発生します。
- API Server への削除リクエスト: User または controller が Pod の削除をリクエストします
- Termination Period の開始: Default の termination period(30 秒)が設定されます
- API Update: API server が Pod の deletion timestamp を更新します
- Endpoint update: EndpointSlice は endpoint を terminating かつ not ready としてマークします。Node shutdown と同時に propagation が発生します
- Stop signal: kubelet は grace period 内に preStop hook を実行し、その後 runtime に stop signal を送信するよう求めます(通常は SIGTERM。ただし image/container による override を除く)
- Graceful Shutdown の待機: Application が graceful に shutdown するための時間が提供されます
- SIGKILL Signal: Termination period 後も container が終了しない場合、SIGKILL signal が送信されます
- Resource Cleanup: kubelet が Pod resource を cleanup します
Init Container
Init container は、Pod 内の app container が起動する前に実行される特別な container です。
- 順次実行: Init container は定義された順序で 1 つずつ実行されます
- 前提条件: 各 init container は、前の container が正常に完了した後にのみ起動します
- 失敗時の再起動: Init container が失敗した場合、Pod の restart policy に従って再起動されます
- 目的: App container 起動前の setup、dependency の検証、permission setup など
apiVersion: v1
kind: Pod
metadata:
  name: init-pod
spec:
  initContainers:
  - name: init-myservice
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup myservice; do echo waiting for myservice; sleep 2; done;']
  - name: init-mydb
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup mydb; do echo waiting for mydb; sleep 2; done;']
  containers:
  - name: app
    image: myapp:1.0
Pod Disruption
Pod の disruption は、voluntary disruption と involuntary disruption に分けられます。
Voluntary Disruption: Cluster administrator または automation tool による disruption
- Node draining
- Deployment update
- Pod deletion
Involuntary Disruption: Hardware failure、kernel panic、network partition などによる disruption
PodDisruptionBudget は Eviction API(たとえば drain)を通じて voluntary eviction を制限します。直接的な Pod deletion と Deployment rolling update はこれを回避するため、rollout の可用性は別途設定してください。Involuntary failure は防止できません。
Pod の設計パターン
Pod を設計する際に考慮すべきパターンと best practice がいくつかあります。これらのパターンを理解して適用すると、application の安定性、scalability、maintainability を向上できます。
Single Responsibility Principle
Pod は Single Responsibility Principle に従うべきです。
- 1 つの主要機能: 各 Pod は 1 つの主要な機能または process を担当する必要があります
- 独立したスケーリング: 各機能を独立して scale できるように設計します
- 個別のライフサイクル: 各機能が独自の lifecycle を持てるように設計します
Pod Template
Pod template は、workload resource(Deployment、StatefulSet など)で Pod を作成するために使用される specification です。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:  # Pod template starts
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
  # Pod template ends
Pod Affinity と Anti-Affinity
Pod affinity と anti-affinity は、Pod をどの node にスケジューリングするかを制御する rule です。
- Pod Affinity: 特定の Pod と同じ node または topology domain にスケジューリングする
- Pod Anti-Affinity: 特定の Pod とは異なる node または topology domain にスケジューリングする
apiVersion: v1
kind: Pod
metadata:
  name: web-pod
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: "kubernetes.io/hostname"
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 100
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values:
              - web
          topologyKey: "kubernetes.io/hostname"
  containers:
  - name: web
    image: nginx:1.30.4
Node Affinity
Node affinity は、Pod を特定の node にスケジューリングするよう制限する rule です。
apiVersion: v1
kind: Pod
metadata:
  name: gpu-pod
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: gpu
            operator: In
            values:
            - "true"
  containers:
  - name: gpu-container
    image: gpu-app:1.0
Taint と Toleration
Taint は特定の Pod がスケジューリングされないよう node に適用され、toleration は taint を持つ node へのスケジューリングを許可するために Pod に適用されます。
# Apply taint to node
kubectl taint nodes node1 key=value:NoSchedule# Apply toleration to Pod
apiVersion: v1
kind: Pod
metadata:
name: tolerant-pod
spec:
tolerations:
- key: "key"
operator: "Equal"
value: "value"
effect: "NoSchedule"
containers:
- name: app
image: myapp:1.0Resource Request と Limit
Pod 内の container に resource request と limit を設定することは、cluster resource を効率的に使用し、安定性を確保するために重要です。
apiVersion: v1
kind: Pod
metadata:
  name: resource-pod
spec:
  containers:
  - name: app
    image: myapp:1.0
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
Pod Security Context
Security context は、Pod または container level の security setting を定義します。
apiVersion: v1
kind: Pod
metadata:
  name: security-pod
spec:
  securityContext:
    runAsUser: 1000
    runAsGroup: 3000
    fsGroup: 2000
  containers:
  - name: app
    image: myapp:1.0
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
Pod Priority と Preemption
Pod priority と preemption は、cluster resource が不足した場合に、どの Pod をスケジューリングし、どの Pod を preempt するかを決定します。
# Priority class definition
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical pods only."
---
# Pod using priority class
apiVersion: v1
kind: Pod
metadata:
  name: high-priority-pod
spec:
  priorityClassName: high-priority
  containers:
  - name: app
    image: myapp:1.0
Workload Resources の概要
Kubernetes は Pod を管理するためのさまざまな workload resource を提供します。各 workload resource は、特定のユースケースと要件向けに設計されています。
Workload Resource の種類
Kubernetes の主な workload resource は次のとおりです。
- ReplicaSet: 指定した数の Pod replica を維持する
- Deployment: ReplicaSet を管理して declarative update を提供する
- StatefulSet: State persistence が必要な application 向けの resource
- DaemonSet: すべての node で Pod の copy を実行する
- Job: 完了後に終了する one-time task
- CronJob: Schedule に従って定期的に Job を実行する
Workload Resource の選択基準
適切な workload resource を選択するための基準は次のとおりです。
- State Persistence: Application が state を維持する必要があるか
- Execution Pattern: 継続的、one-time、定期的のいずれで実行されるか
- Deployment Requirements: Rolling update、blue/green deployment などの要件
- Node Coverage: すべての node で実行する必要があるか
- Scalability Requirements: Horizontal scaling が必要か
ReplicaSet
ReplicaSet は、指定した数の Pod replica が常に実行されることを保証します。Pod が失敗または削除されると、ReplicaSet は自動的に代替 Pod を作成します。
ReplicaSet の主な機能
- Pod Replica の維持: 指定した数の Pod replica を維持する
- Pod Selection: Label selector を通じて管理対象の Pod を識別する
- Pod Creation: 必要に応じて新しい Pod を作成する
- Pod Deletion: 余分な Pod を削除する
ReplicaSet の定義
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: frontend
  labels:
    app: guestbook
    tier: frontend
spec:
  replicas: 3
  selector:
    matchLabels:
      tier: frontend
  template:
    metadata:
      labels:
        tier: frontend
    spec:
      containers:
      - name: php-redis
        image: gcr.io/google_samples/gb-frontend:v3
        resources:
          requests:
            cpu: 100m
            memory: 100Mi
        ports:
        - containerPort: 80
ReplicaSet の動作
- Label Selector の照合: ReplicaSet は label selector に一致する Pod を識別します
- 現在の状態の確認: 現在実行中の Pod の数を確認します
- 望ましい状態との比較: 現在の Pod 数と望ましい replica 数を比較します
- 調整アクション: 必要に応じて Pod を作成または削除します
ReplicaSet と Replication Controller の比較
ReplicaSet は Replication Controller の後継であり、より強力な label selector を提供します。
- Replication Controller: Equality-based selector(例: app=nginx)のみをサポートします
- ReplicaSet: Set-based selector(例: app in (nginx, apache))をサポートします
ReplicaSet のユースケース
ReplicaSet は通常、直接ではなく Deployment を通じて間接的に使用されます。ただし、次の場合は直接使用できます。
- 単純な Replication: Pod replica を単純に維持する場合
- Custom Update: Custom update mechanism が必要な場合
- Legacy Support: Legacy application をサポートする場合
Deployment
Deployment は ReplicaSet を管理し、Pod に対する declarative update を提供します。Deployment は application の rolling update、rollback、scaling などを管理します。
Deployment の主な機能
- Declarative Update: Desired state を宣言すると、Deployment が current state を desired state に変更する
- Rolling Update: Downtime なしで application を更新する
- Rollback: Previous version への簡単な rollback
- Scaling: Application replica 数を調整する
- Deployment History: 以前の deployment version の記録を維持する
Deployment の定義
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
  labels:
    app: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
        resources:
          requests:
            cpu: 100m
            memory: 100Mi
          limits:
            cpu: 200m
            memory: 200Mi
        livenessProbe:
          httpGet:
            path: /
            port: 80
          initialDelaySeconds: 30
          periodSeconds: 10
        readinessProbe:
          httpGet:
            path: /
            port: 80
          initialDelaySeconds: 5
          periodSeconds: 5
Deployment Update Strategy
Deployment には 2 つの update strategy があります。
RollingUpdate: Downtime なしで deployment するために Pod を段階的に更新します(default)
- maxSurge: Desired Pod 数を超えて作成できる Pod の最大数
- maxUnavailable: Update 中に利用不可にできる Pod の最大数
Recreate: 新しい Pod を作成する前に既存のすべての Pod を削除します(一時的な downtime が発生します)
Deployment Rollback
Deployment は previous version への rollback をサポートします。
# Check deployment history
kubectl -n workloads-demo rollout history deployment/nginx-deployment

# Check details of specific version
kubectl -n workloads-demo rollout history deployment/nginx-deployment --revision=2

# Rollback to previous version
kubectl -n workloads-demo rollout undo deployment/nginx-deployment

# Rollback to specific version
kubectl -n workloads-demo rollout undo deployment/nginx-deployment --to-revision=2
Deployment Scaling
Deployment は簡単に scale できます。
# Imperative scaling
kubectl -n workloads-demo scale deployment/nginx-deployment --replicas=5

# Declarative scaling (after modifying YAML file)
kubectl apply -f deployment.yaml
Deployment Pause と Resume
Deployment rollout は pause と resume が可能です。
# Pause rollout
kubectl -n workloads-demo rollout pause deployment/nginx-deployment

# Apply multiple changes
kubectl -n workloads-demo set image deployment/nginx-deployment nginx=nginx:1.30.4-alpine
kubectl -n workloads-demo set resources deployment/nginx-deployment -c=nginx --limits=cpu=200m,memory=256Mi

# Resume rollout
kubectl -n workloads-demo rollout resume deployment/nginx-deployment
Deployment Status
Deployment condition には Progressing、Available、ReplicaFailure があります。Stalled rollout は reason ProgressDeadlineExceeded で Progressing=False を報告することがあります。Kubernetes は自動的に rollback しません。「Complete」は condition type ではなく rollout の完了を表します。
StatefulSet
StatefulSet は state persistence を必要とする application 向けの workload resource です。各 Pod に一意の identifier を割り当て、安定した network identifier と persistent storage を提供します。
StatefulSet の主な機能
- 安定した一意の Network Identifier: Pod name と hostname は restart 後も維持されます
- 安定した Persistent Storage: Pod が reschedule されても同じ storage にアクセスできます
- 順次 Deployment と Scaling: Pod は順番に作成、更新、削除されます
- 順次 Automatic Rolling Update: Pod は順番に更新されます
StatefulSet の定義
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: web
spec:
  selector:
    matchLabels:
      app: nginx
  serviceName: "nginx"
  replicas: 3
  updateStrategy:
    type: RollingUpdate
  podManagementPolicy: OrderedReady
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.4
        ports:
        - containerPort: 80
          name: web
        volumeMounts:
        - name: www
          mountPath: /usr/share/nginx/html
  volumeClaimTemplates:
  - metadata:
      name: www
    spec:
      accessModes: [ "ReadWriteOnce" ]
      storageClassName: "standard"
      resources:
        requests:
          storage: 1Gi
StatefulSet Pod Identifier
StatefulSet は、次の形式で Pod に一意の identifier を割り当てます。
<StatefulSet name>-<ordinal index>たとえば、web StatefulSet は web-0、web-1、web-2 のような Pod を作成します。
StatefulSet Headless Service
StatefulSet は通常、headless service(clusterIP: None)とともに使用されます。これにより、各 Pod の DNS record が作成されます。
apiVersion: v1
kind: Service
metadata:
  name: nginx
  labels:
    app: nginx
spec:
  ports:
  - port: 80
    name: web
  clusterIP: None
  selector:
    app: nginx
これにより、各 Pod は次の形式の DNS name を持ちます。
<Pod name>.<service name>.<namespace>.svc.cluster.local例: web-0.nginx.default.svc.cluster.local
StatefulSet Storage
StatefulSet は volumeClaimTemplates を使用して、各 Pod 用の Persistent Volume Claim(PVC)を自動的に作成します。これらの PVC は、Pod が reschedule されても維持されます。
StatefulSet Update Strategy
StatefulSet には 2 つの update strategy があります。
- RollingUpdate: Pod を順番に更新します(default)
- OnDelete: Pod が削除された場合にのみ更新します
Pod Management Policy
StatefulSet には 2 つの Pod management policy があります。
- OrderedReady: Pod を順番に作成および終了します(default)
- Parallel: Pod を並列に作成および終了します
StatefulSet のユースケース
StatefulSet は次の application に適しています。
- Database: MySQL、PostgreSQL、MongoDB など
- Distributed System: Kafka、ZooKeeper、Elasticsearch など
- Message Queue: RabbitMQ など
- その他の Stateful Application: File server、session store など
StatefulSet の例: Persistent MySQL Instance
この例は、1 つの MySQL instance に対する stable identity と PVC を示します。Replication または automatic database failover は構成していません。replicas を増やすと、独立した database が作成されます。同じ namespace に password key を持つ mysql-secret を作成し、default StorageClass を提供してください(または適切な class を明示的に設定してください)。テスト済みの MySQL 8.4 patch/digest を使用してください。Credential の変更には、単に Secret を更新するのではなく、database level の rotation が必要です。
apiVersion: v1
kind: Service
metadata:
  name: mysql
spec:
  clusterIP: None
  selector:
    app: mysql
  ports:
  - name: mysql
    port: 3306
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: mysql
spec:
  serviceName: mysql
  replicas: 1
  selector:
    matchLabels:
      app: mysql
  podManagementPolicy: OrderedReady
  template:
    metadata:
      labels:
        app: mysql
    spec:
      containers:
      - name: mysql
        image: mysql:8.4
        env:
        - name: MYSQL_ROOT_PASSWORD
          valueFrom:
            secretKeyRef:
              name: mysql-secret
              key: password
        ports:
        - name: mysql
          containerPort: 3306
        startupProbe:
          tcpSocket:
            port: mysql
          periodSeconds: 10
          failureThreshold: 60
        readinessProbe:
          exec:
            command:
            - sh
            - -c
            - 'MYSQL_PWD="$MYSQL_ROOT_PASSWORD" mysql -h 127.0.0.1 -u root -e "SELECT 1"'
          periodSeconds: 10
          timeoutSeconds: 5
        resources:
          requests:
            cpu: 500m
            memory: 1Gi
          limits:
            memory: 2Gi
        volumeMounts:
        - name: data
          mountPath: /var/lib/mysql
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes: [ReadWriteOnce]
      resources:
        requests:
          storage: 10Gi
Replication と leader promotion には database operator または個別にテストした replication runbook を使用してください。StatefulSet 単体では、どちらも提供されません。upstream replication tutorial は、安全でない学習用 default を明示的に使用しており、production configuration ではありません。
DaemonSet
DaemonSet は、Pod の copy がすべての node(または特定の node)で実行されることを保証します。Node が cluster に追加されると Pod は自動的に追加され、node が削除されると Pod も削除されます。
DaemonSet の主な機能
- すべての Node で実行: Cluster 内のすべての node で Pod を実行する
- Node Selection: Node selector を通じて特定の node でのみ実行できる
- Automatic Deployment: 新しい node が追加されると Pod を自動的に deploy する
- Automatic Cleanup: Node が削除されると Pod を自動的に cleanup する
DaemonSet の定義
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluentd-elasticsearch
  namespace: kube-system
  labels:
    k8s-app: fluentd-logging
spec:
  selector:
    matchLabels:
      name: fluentd-elasticsearch
  updateStrategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 1
  template:
    metadata:
      labels:
        name: fluentd-elasticsearch
    spec:
      tolerations:
      - key: node-role.kubernetes.io/control-plane
        effect: NoSchedule
      containers:
      - name: fluentd-elasticsearch
        image: quay.io/fluentd_elasticsearch/fluentd:v2.5.2
        resources:
          limits:
            memory: 200Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
          readOnly: true
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
CRI runtime では、collector が Docker JSON log ではなく、/var/log/pods 配下の CRI log(通常は /var/log/containers から link される)を parse するよう構成してください。Collector には独自の source/output configuration と RBAC が必要です。
DaemonSet Update Strategy
DaemonSet には 2 つの update strategy があります。
RollingUpdate: Pod を順次更新します(default)
- maxUnavailable: Update 中に利用不可にできる Pod の最大数
OnDelete: Pod が削除された場合にのみ更新します
DaemonSet Node Selection
DaemonSet は、特定の node でのみ実行するように構成できます。
spec:
  template:
    spec:
      nodeSelector:
        disk: ssd
DaemonSet Taint Toleration
DaemonSet は、taint を持つ node で実行するために toleration を設定できます。
spec:
  template:
    spec:
      tolerations:
      - key: node-role.kubernetes.io/control-plane
        effect: NoSchedule
DaemonSet のユースケース
DaemonSet は次の目的で使用されます。
- Log Collector: Fluentd、Logstash など
- Monitoring Agent: Prometheus Node Exporter、Datadog Agent など
- Network Plugin: Calico、Cilium など
- Storage Daemon: Ceph、GlusterFS など
- Security Agent: Falco、Sysdig など
DaemonSet の例: Prometheus Node Exporter
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
  namespace: monitoring
  labels:
    app: node-exporter
spec:
  selector:
    matchLabels:
      app: node-exporter
  template:
    metadata:
      labels:
        app: node-exporter
    spec:
      hostNetwork: true
      hostPID: true
      containers:
      - name: node-exporter
        image: prom/node-exporter:v1.3.1
        args:
        - --path.procfs=/host/proc
        - --path.sysfs=/host/sys
        - --path.rootfs=/host/root
        - --web.listen-address=:9100
        ports:
        - containerPort: 9100
          protocol: TCP
          name: http
        resources:
          limits:
            cpu: 250m
            memory: 180Mi
          requests:
            cpu: 102m
            memory: 180Mi
        volumeMounts:
        - name: proc
          mountPath: /host/proc
          readOnly: true
        - name: sys
          mountPath: /host/sys
          readOnly: true
        - name: root
          mountPath: /host/root
          readOnly: true
      tolerations:
      - operator: "Exists"
      volumes:
      - name: proc
        hostPath:
          path: /proc
      - name: sys
        hostPath:
          path: /sys
      - name: root
        hostPath:
          path: /
Job と CronJob
Job と CronJob は、one-time task または定期 task を実行するための workload resource です。
Job
Job は 1 つ以上の Pod を作成し、指定数の Pod が正常に終了するまで実行を継続します。
Job の主な機能
- Completion Tracking: Successful Pod を追跡します。Retry limit または deadline により Job が失敗することがあります
- Parallel Execution: 複数の Pod を並列に実行できます
- Retry: Failed Pod を自動的に retry します
- 完了後の Cleanup: Job 完了後の Pod の optional cleanup
Job の定義
apiVersion: batch/v1
kind: Job
metadata:
  name: pi
spec:
  completions: 5      # Number of Pods that must successfully complete
  parallelism: 2      # Number of Pods to run in parallel
  backoffLimit: 4     # Number of retries on failure
  activeDeadlineSeconds: 100  # Job time limit (seconds)
  ttlSecondsAfterFinished: 100  # Deletion time after completion (seconds)
  template:
    spec:
      containers:
      - name: pi
        image: perl:5.34
        command: ["perl", "-Mbignum=bpi", "-wle", "print bpi(2000)"]
        resources:
          requests:
            cpu: 100m
            memory: 50Mi
          limits:
            cpu: 100m
            memory: 100Mi
      restartPolicy: Never  # or OnFailure
Job Completion Mode
Job には 2 つの completion mode があります。
- NonIndexed: 指定数の Pod が正常に完了すると Job が完了する標準 Job mode
- Indexed: 各 Pod に 0 から始まる index が割り当てられ、特定の index range の task を実行する
apiVersion: batch/v1
kind: Job
metadata:
  name: indexed-job
spec:
  completions: 5
  parallelism: 3
  completionMode: Indexed  # Enable Indexed mode
  template:
    spec:
      containers:
      - name: worker
        image: busybox:1.34
        command: ["sh", "-c", "echo Processing item ${JOB_COMPLETION_INDEX}"]
      restartPolicy: Never
Job のユースケース
Job は次の目的で使用されます。
- Batch Processing: Data processing、ETL task
- Computation Task: Scientific calculation、rendering
- Database Migration: Schema update
- One-time Administrative Task: Backup、cleanup task
CronJob
CronJob は、指定された schedule に従って Job を定期的に実行します。Linux cron job と同様に動作します。
CronJob の主な機能
- Scheduled Execution: Cron expression を使用して execution schedule を指定する
- Job Management: Schedule に従って Job を作成する
- Concurrency Policy: Previous job がまだ実行中の場合の動作を定義する
- History Limit: Completed job の history を制限する
CronJob の定義
apiVersion: batch/v1
kind: CronJob
metadata:
  name: hello
spec:
  schedule: "*/1 * * * *"  # Run every minute
  timeZone: "America/New_York"  # Timezone (stable since Kubernetes 1.27)
  concurrencyPolicy: Forbid  # Allow, Forbid, Replace
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 1
  startingDeadlineSeconds: 60
  jobTemplate:
    spec:
      template:
        spec:
          containers:
          - name: hello
            image: busybox:1.34
            command:
            - /bin/sh
            - -c
            - date; echo Hello from the Kubernetes cluster
          restartPolicy: OnFailure
Cron Expression
Cron expression は次の形式です。
+------------------- minute (0 - 59)
| +----------------- hour (0 - 23)
| | +--------------- day of month (1 - 31)
| | | +------------- month (1 - 12)
| | | | +----------- day of week (0 - 6) (Sunday to Saturday; use 0 for Sunday)
| | | | |
| | | | |
* * * * *
一般的な cron expression の例:
*/5 * * * *: 5 分ごと0 * * * *: 毎時 0 分0 0 * * *: 毎日午前 0 時0 0 * * 0: 毎週日曜日の午前 0 時0 0 1 * *: 毎月 1 日の午前 0 時0 0 1 1 *: 毎年 1 月 1 日の午前 0 時
Concurrency Policy
CronJob には 3 つの concurrency policy があります。
- Allow: 複数の Job を同時に実行できます(default)
- Forbid: Previous Job がまだ実行中の場合は、新しい Job を skip します
- Replace: Previous Job がまだ実行中の場合は、新しい Job に置き換えます
CronJob のユースケース
CronJob は次の目的で使用されます。
- 定期 Backup: Database backup、snapshot creation
- Data Synchronization: 定期的な data synchronization
- Report Generation: Daily/weekly/monthly report generation
- Cleanup Task: Temporary file cleanup、log rotation
- Notification と Monitoring: Status check、alert の送信
CronJob の例: Database Backup
apiVersion: batch/v1
kind: CronJob
metadata:
  name: database-backup
spec:
  schedule: "0 2 * * *"
  timeZone: "Etc/UTC"
  concurrencyPolicy: Forbid
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 1
  jobTemplate:
    spec:
      template:
        spec:
          containers:
          - name: backup
            image: postgres:14
            env:
            - name: PGHOST
              value: postgres-service
            - name: PGUSER
              valueFrom:
                secretKeyRef:
                  name: postgres-secret
                  key: username
            - name: PGPASSWORD
              valueFrom:
                secretKeyRef:
                  name: postgres-secret
                  key: password
            command:
            - /bin/sh
            - -c
            - |
              set -eu
              backup_file="/backup/db-$(date +%Y%m%d-%H%M%S).dump"
              trap 'rm -f "$backup_file.partial"' EXIT
              pg_dump -Fc > "$backup_file.partial"
              pg_restore --list "$backup_file.partial" > /dev/null
              mv "$backup_file.partial" "$backup_file"
              find /backup -maxdepth 1 -type f -name 'db-*.dump' -mtime +7 -delete
            volumeMounts:
            - name: backup-volume
              mountPath: /backup
          restartPolicy: OnFailure
          volumes:
          - name: backup-volume
            persistentVolumeClaim:
              claimName: backup-pvc
CronJob scheduling はおおよそのものであり、job は重複実行に耐えられなければなりません。Forbid は同じ CronJob からの Job にのみ適用されます。History limit は backup file ではなく Job/Pod object を削除します。Backup の例は UTC の 02:00 に実行され、backup-pvc、postgres-secret、および到達可能な database が必要です。pg_dump は server major version と同じかそれより新しい必要があります。PGDATABASE が PGUSER と異なる場合は指定してください。実際の restore は別途テストしてください。
まとめ
このドキュメントでは、Kubernetes の基本的な構成要素である Pod と、さまざまな workload resource を取り上げました。Pod の概念から始めて、Deployment、StatefulSet、DaemonSet、Job、CronJob など、さまざまな workload resource の特徴とユースケースを確認しました。これらの resource にはそれぞれ固有の目的と機能があり、適切に使用することで、効率的な application deployment と management が可能になります。
クイズ
この章で学んだ内容を確認するには、Pods と Workloads のクイズに挑戦してください。