Kubernetes Pod 和工作负载
支持的版本:Kubernetes 1.35、1.36、1.37 最近更新:October 12, 2026
本文详细介绍 Pod(Kubernetes 中的基本执行单元)以及用于管理 Pod 的各种工作负载资源。我们将从 Pod 的概念入手,介绍包括 Deployment、StatefulSet、DaemonSet 等在内的各种工作负载资源的特征和用例。
实验环境设置
要跟着本文中的示例进行操作,你需要准备以下工具和环境:
必需工具
- 与 API 服务器版本相差不超过一个次要版本的 kubectl
- 一个可正常运行的 Kubernetes 集群(EKS、minikube、kind 等)
部署示例应用
# Create namespace
kubectl create namespace workloads-demo

# Create a simple deployment
kubectl -n workloads-demo apply -f - <<EOF
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
  labels:
    app: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.6
        ports:
        - containerPort: 80
        resources:
          requests:
            memory: "64Mi"
            cpu: "100m"
          limits:
            memory: "128Mi"
            cpu: "200m"
EOF

# Check deployment status
kubectl -n workloads-demo get deployments,pods
目录
Pod 概念
核心概念:Pod 是 Kubernetes 中最小的可部署计算单元,由一个或多个共享存储和网络的容器组构成。
Pod 是 Kubernetes 中最小的可部署计算单元。Pod 是由一个或多个共享存储和网络、并作为整体进行调度的容器组成的组。
Pod 特征
- 共享上下文:容器共享 Pod 网络,通常也共享 IPC;进程命名空间共享需要设置
shareProcessNamespace: true。容器根文件系统仍然彼此隔离。 - 位于同一节点:Pod 中的所有容器始终运行在同一节点上。
- 唯一 IP 地址:每个 Pod 在集群中都有唯一的 IP 地址。
- 临时性:Pod 本质上是临时的,发生故障时可以由新的 Pod 替代。
- 原子单元:Pod 是部署、调度和副本管理的原子单元。
Pod 结构
Pod 由以下组件构成:
- 容器:在 Pod 中运行的一个或多个容器
- 卷:Pod 中的容器共享的存储
- 网络:分配给 Pod 的 IP 地址和端口
- 容器规格:容器镜像、环境变量、资源需求等
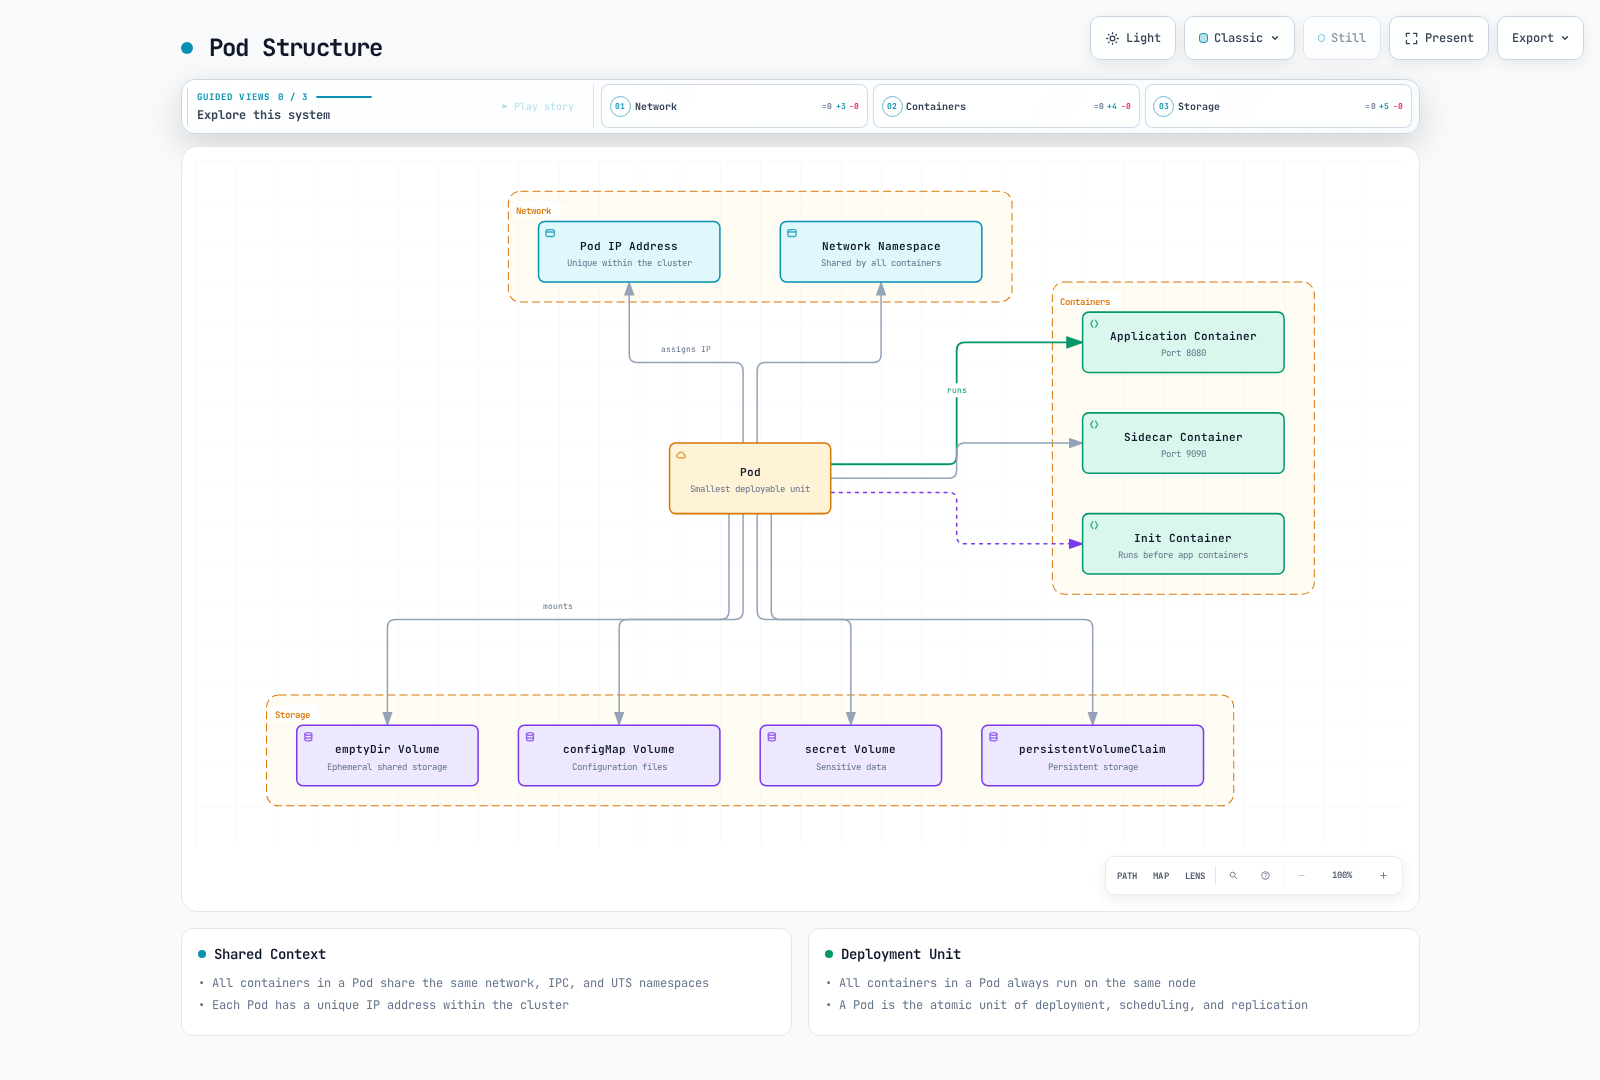
Pod 示例
apiVersion: v1
kind: Pod
metadata:
  name: multi-container-pod
  labels:
    app: web
spec:
  containers:
  - name: web
    image: nginx:1.30.6
    ports:
    - containerPort: 80
    volumeMounts:
    - name: shared-data
      mountPath: /usr/share/nginx/html
  - name: content-updater
    image: alpine
    command: ["/bin/sh", "-c"]
    args:
    - |
      while true; do
        echo "Current time: $(date)" > /content/index.html;
        sleep 10;
      done
    volumeMounts:
    - name: shared-data
      mountPath: /content
  volumes:
  - name: shared-data
    emptyDir: {}
实践示例:Web 应用 Pod
以下示例展示了一个包含 Web 应用和 sidecar 容器的 Pod:
apiVersion: v1
kind: Pod
metadata:
  name: web-app
  labels:
    app: web
    environment: production
spec:
  containers:
  - name: web-application
    image: nginx:1.30.6
    volumeMounts:
    - name: log-volume
      mountPath: /var/log/nginx
    ports:
    - containerPort: 80
    resources:
      requests:
        memory: "128Mi"
        cpu: "100m"
      limits:
        memory: "256Mi"
        cpu: "500m"
  - name: log-collector
    image: fluentd:v1.19-debian-1
    volumeMounts:
    - name: log-volume
      mountPath: /var/log/nginx
    resources:
      requests:
        memory: "64Mi"
        cpu: "50m"
      limits:
        memory: "128Mi"
        cpu: "100m"
  volumes:
  - name: log-volume
    emptyDir: {}
此示例展示了以下真实场景:
- 将 Nginx Web 服务器作为主容器运行
- 将 Fluentd 日志收集器作为 sidecar 容器运行
- 在两个容器之间共享日志卷
- 为每个容器设置资源请求和限制
此配置适用于在微服务架构中运行紧密关联的容器,同时将日志记录、监控和代理等功能分离。
这些日志清单展示了卷的配置方式。Fluentd 还需要明确配置 tail 源和输出;仅挂载目录并不会收集其中的日志。镜像和应用配置仅用于说明,并非生产环境的版本建议。原生 sidecar 使用带有 restartPolicy: Always 的 initContainers(自 v1.33 起稳定);普通的多容器 Pod 不保证启动或关闭顺序。
Pod 定义
Pod 使用 YAML 或 JSON 格式的清单文件定义。下面是一个基本的 Pod 定义示例:
apiVersion: v1
kind: Pod
metadata:
  name: nginx-pod
  labels:
    app: nginx
spec:
  containers:
  - name: nginx
    image: nginx:1.30.6
    ports:
    - containerPort: 80
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
单容器 Pod 与多容器 Pod
单容器 Pod:
- 最常见的用例
- 仅包含一个应用容器
- 结构简单直观
多容器 Pod:
- 包含多个紧密耦合的容器
- 容器之间可以进行本地通信(localhost)
- 通过共享卷共享数据
- 一起扩缩容和调度
多容器 Pod 模式
- Sidecar 模式:扩展主容器功能的辅助容器
- 示例:日志收集器、文件同步、代理
apiVersion: v1
kind: Pod
metadata:
  name: web-with-sidecar
spec:
  containers:
  - name: web
    image: nginx:1.30.6
    volumeMounts:
    - name: logs
      mountPath: /var/log/nginx
  - name: log-collector
    image: fluentd:v1.19-debian-1
    volumeMounts:
    - name: logs
      mountPath: /var/log/nginx
  volumes:
  - name: logs
emptyDir: {}- Ambassador 模式:充当外部服务代理的容器
- 示例:数据库代理、服务网格 sidecar
apiVersion: v1
kind: Pod
metadata:
  name: app-with-ambassador
spec:
  containers:
  - name: app
    image: myapp:1.0
  - name: ambassador
    image: envoyproxy/envoy:v1.20.0
    ports:
- containerPort: 9901- Adapter 模式:对主容器的输出进行标准化的容器
- 示例:日志格式转换、指标转换
apiVersion: v1
kind: Pod
metadata:
  name: app-with-adapter
spec:
  containers:
  - name: app
    image: myapp:1.0
    volumeMounts:
    - name: app-logs
      mountPath: /var/log/app
  - name: adapter
    image: adapter:1.0
    volumeMounts:
    - name: app-logs
      mountPath: /var/log/app
  volumes:
  - name: app-logs
emptyDir: {}- Init 容器模式:在主容器启动之前运行的容器
- 示例:创建配置文件、数据库迁移、设置权限
apiVersion: v1
kind: Pod
metadata:
  name: app-with-init
spec:
  initContainers:
  - name: init-db
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup db; do echo waiting for db; sleep 2; done;']
  containers:
  - name: app
    image: myapp:1.0
Pod 网络
Pod 中的容器具有以下网络特征:
- 相同的 IP 地址:Pod 中的所有容器共享同一个 IP 地址。
- 共享端口:Pod 中的容器共享端口空间,因此通常不能绑定相同的 IP/协议/端口组合。
- Localhost 通信:Pod 中的容器可以通过 localhost 相互通信。
- Pod 间通信:每个 Pod 都有唯一的 IP 地址,可以直接与其他 Pod 通信。
Pod 存储
Pod 可以使用多种卷类型来存储和共享数据:
- emptyDir:创建 Pod 时创建、删除 Pod 时删除的临时卷
- hostPath:从宿主节点文件系统挂载到 Pod 的卷
- persistentVolumeClaim:请求持久存储的卷
- configMap:作为卷挂载的 ConfigMap
- secret:作为卷挂载的 Secret
- projected:映射到同一目录的多个卷来源
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-volumes
spec:
  containers:
  - name: app
    image: myapp:1.0
    volumeMounts:
    - name: data
      mountPath: /data
    - name: config
      mountPath: /etc/config
  volumes:
  - name: data
    emptyDir: {}
  - name: config
    configMap:
      name: app-config
Pod 生命周期
Pod 从创建到终止会经历多个生命周期阶段。了解这一生命周期对于确保应用的稳定性和可用性十分重要。
Pod 阶段
Pod 会经历以下阶段:
- Pending:集群已接受该 Pod,但一个或多个容器尚未完成设置
- Running:Pod 已绑定到某个节点,所有容器均已创建,且至少有一个容器正在运行或正在启动/重启
- Succeeded:Pod 中的所有容器均已成功终止,且不会重新启动
- Failed:Pod 中的所有容器均已终止,且至少有一个容器因故障而终止
- Unknown:由于某种原因,无法获取 Pod 的状态
容器状态
Pod 中的每个容器都可能处于以下状态:
- Waiting:容器尚未运行的状态(下载镜像、等待依赖项等)
- Running:进程正在执行;仅凭此状态无法确定应用是否健康或已就绪
- Terminated:容器已完成执行或因某种原因失败
Pod 条件
Pod 通过以下条件更具体地表明其状态:
- PodScheduled:Pod 是否已调度到某个节点
- ContainersReady:Pod 中的所有容器是否均已就绪
- Initialized:常规 init 容器已完成,且可重启的 init 容器(原生 sidecar)已启动
- Ready:Pod 是否可以处理请求,并加入 Service 的负载均衡池
容器探针
Kubernetes 提供以下探针来检查容器状态:
- livenessProbe:检查容器是否存活;失败时重启容器
- readinessProbe:检查容器是否已准备好处理请求;失败时将其从 Service 流量中排除
- startupProbe:检查容器中的应用是否已启动;成功之前会禁用其他探针
apiVersion: v1
kind: Pod
metadata:
  name: pod-with-probes
spec:
  containers:
  - name: app
    image: myapp:1.0
    ports:
    - containerPort: 8080
    livenessProbe:
      httpGet:
        path: /healthz
        port: 8080
      initialDelaySeconds: 30
      periodSeconds: 10
      timeoutSeconds: 5
      failureThreshold: 3
    readinessProbe:
      httpGet:
        path: /ready
        port: 8080
      initialDelaySeconds: 5
      periodSeconds: 5
    startupProbe:
      httpGet:
        path: /startup
        port: 8080
      failureThreshold: 30
      periodSeconds: 10
Pod 终止流程
Pod 终止时会发生以下流程:
- 向 API 服务器发送删除请求:用户或控制器请求删除 Pod
- 开始终止宽限期:设置默认终止宽限期(30 秒)
- API 更新:API 服务器更新 Pod 的删除时间戳
- 更新端点:EndpointSlice 将端点标记为正在终止且未就绪;这一过程与节点关闭同时进行
- 停止信号:kubelet 在宽限期内运行任何 preStop hook,然后要求运行时发送停止信号(通常是 SIGTERM,除非镜像/容器另有设置)
- 等待优雅关闭:为应用预留时间以便其优雅关闭
- SIGKILL 信号:如果容器在终止宽限期结束后仍未终止,则发送 SIGKILL 信号
- 资源清理:kubelet 清理 Pod 资源
Init 容器
Init 容器是一类特殊容器,会在 Pod 中的应用容器启动之前运行:
- 顺序执行:Init 容器按照定义的顺序逐个运行
- 前置条件:每个 Init 容器只有在上一个容器成功完成后才会启动
- 失败后重启:如果 Init 容器失败,会按照 Pod 的重启策略重新启动
- 用途:在应用容器启动前进行设置、验证依赖项、设置权限等
apiVersion: v1
kind: Pod
metadata:
  name: init-pod
spec:
  initContainers:
  - name: init-myservice
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup myservice; do echo waiting for myservice; sleep 2; done;']
  - name: init-mydb
    image: busybox:1.34
    command: ['sh', '-c', 'until nslookup mydb; do echo waiting for mydb; sleep 2; done;']
  containers:
  - name: app
    image: myapp:1.0
Pod 中断
Pod 中断可分为自愿中断和非自愿中断:
自愿中断:由集群管理员或自动化工具造成的中断
- 排空节点
- 更新 Deployment
- 删除 Pod
非自愿中断:由硬件故障、内核崩溃、网络分区等引起的中断
PodDisruptionBudget 通过 Eviction API 限制自愿驱逐(例如 drain)。直接删除 Pod 和 Deployment 滚动更新会绕过它;需要单独配置滚动更新的可用性。它无法阻止非自愿故障。
Pod 设计模式
设计 Pod 时,有几种模式和最佳实践值得考虑。了解并应用这些模式可以提高应用的稳定性、可扩展性和可维护性。
单一职责原则
Pod 应遵循单一职责原则:
- 一个主要功能:每个 Pod 应负责一个主要功能或进程
- 独立扩缩容:设计时应确保每项功能都能独立扩缩容
- 独立生命周期:设计时应确保每项功能都能拥有自己的生命周期
Pod 模板
Pod 模板是用于在工作负载资源(Deployment、StatefulSet 等)中创建 Pod 的规格:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  template:  # Pod template starts
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.6
        ports:
        - containerPort: 80
  # Pod template ends
Pod 亲和性与反亲和性
Pod 亲和性和反亲和性是控制 Pod 调度到哪些节点的规则:
- Pod 亲和性:将 Pod 调度到与指定 Pod 相同的节点或拓扑域
- Pod 反亲和性:将 Pod 调度到与指定 Pod 不同的节点或拓扑域
apiVersion: v1
kind: Pod
metadata:
  name: web-pod
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
      - labelSelector:
          matchExpressions:
          - key: app
            operator: In
            values:
            - cache
        topologyKey: "kubernetes.io/hostname"
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 100
        podAffinityTerm:
          labelSelector:
            matchExpressions:
            - key: app
              operator: In
              values:
              - web
          topologyKey: "kubernetes.io/hostname"
  containers:
  - name: web
    image: nginx:1.30.6
节点亲和性
节点亲和性是一种限制 Pod 只能调度到特定节点的规则:
apiVersion: v1
kind: Pod
metadata:
  name: gpu-pod
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: gpu
            operator: In
            values:
            - "true"
  containers:
  - name: gpu-container
    image: gpu-app:1.0
污点与容忍度
在节点上设置污点可以阻止某些 Pod 被调度到该节点;在 Pod 上设置容忍度则可以允许其调度到带有污点的节点:
# Apply taint to node
kubectl taint nodes node1 key=value:NoSchedule# Apply toleration to Pod
apiVersion: v1
kind: Pod
metadata:
name: tolerant-pod
spec:
tolerations:
- key: "key"
operator: "Equal"
value: "value"
effect: "NoSchedule"
containers:
- name: app
image: myapp:1.0资源请求和限制
为 Pod 中的容器设置资源请求和限制,对于高效使用集群资源并确保稳定性十分重要:
apiVersion: v1
kind: Pod
metadata:
  name: resource-pod
spec:
  containers:
  - name: app
    image: myapp:1.0
    resources:
      requests:
        memory: "64Mi"
        cpu: "250m"
      limits:
        memory: "128Mi"
        cpu: "500m"
Pod 安全上下文
安全上下文定义 Pod 或容器级别的安全设置:
apiVersion: v1
kind: Pod
metadata:
  name: security-pod
spec:
  securityContext:
    runAsUser: 1000
    runAsGroup: 3000
    fsGroup: 2000
  containers:
  - name: app
    image: myapp:1.0
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
Pod 优先级与抢占
当集群资源不足时,Pod 优先级和抢占机制决定哪些 Pod 会被调度,以及哪些 Pod 会被抢占:
# Priority class definition
apiVersion: scheduling.k8s.io/v1
kind: PriorityClass
metadata:
  name: high-priority
value: 1000000
globalDefault: false
description: "This priority class should be used for critical pods only."
---
# Pod using priority class
apiVersion: v1
kind: Pod
metadata:
  name: high-priority-pod
spec:
  priorityClassName: high-priority
  containers:
  - name: app
    image: myapp:1.0
工作负载资源概览
Kubernetes 提供了多种用于管理 Pod 的工作负载资源。每种工作负载资源都针对特定的用例和需求而设计。
工作负载资源类型
Kubernetes 中的主要工作负载资源有:
- ReplicaSet:维持指定数量的 Pod 副本
- Deployment:管理 ReplicaSet 以实现声明式更新
- StatefulSet:面向需要持久化状态的应用的资源
- DaemonSet:在所有节点上运行一个 Pod 副本
- Job:完成后终止的一次性任务
- CronJob:按计划定期运行 Job
工作负载资源选择标准
选择合适工作负载资源时的标准:
- 状态持久化:应用是否需要保持状态
- 执行模式:应用是持续运行、运行一次还是定期运行
- 部署要求:滚动更新、蓝绿部署等要求
- 节点覆盖范围:是否需要在所有节点上运行
- 可扩展性要求:是否需要水平扩缩容
ReplicaSet
ReplicaSet 可确保始终运行指定数量的 Pod 副本。如果 Pod 发生故障或被删除,ReplicaSet 会自动创建替代 Pod。
ReplicaSet 的主要功能
- 维持 Pod 副本数:维持指定数量的 Pod 副本
- 选择 Pod:通过标签选择器识别要管理的 Pod
- 创建 Pod:在需要时创建新的 Pod
- 删除 Pod:删除多余的 Pod
ReplicaSet 定义
apiVersion: apps/v1
kind: ReplicaSet
metadata:
  name: frontend
  labels:
    app: guestbook
    tier: frontend
spec:
  replicas: 3
  selector:
    matchLabels:
      tier: frontend
  template:
    metadata:
      labels:
        tier: frontend
    spec:
      containers:
      - name: php-redis
        image: gcr.io/google_samples/gb-frontend:v3
        resources:
          requests:
            cpu: 100m
            memory: 100Mi
        ports:
        - containerPort: 80
ReplicaSet 的运行方式
- 匹配标签选择器:ReplicaSet 识别与标签选择器匹配的 Pod
- 检查当前状态:验证当前运行的 Pod 数量
- 与期望状态比较:将当前 Pod 数量与期望副本数进行比较
- 执行调整操作:根据需要创建或删除 Pod
ReplicaSet 与 Replication Controller 的比较
ReplicaSet 是 Replication Controller 的后继资源,支持功能更强大的标签选择器:
- Replication Controller:仅支持基于相等性的选择器(例如 app=nginx)
- ReplicaSet:支持基于集合的选择器(例如 app in (nginx, apache))
ReplicaSet 用例
通常通过 Deployment 间接使用 ReplicaSet,而不是直接使用。不过,在以下情况下也可以直接使用:
- 简单副本管理:只需维持 Pod 副本时
- 自定义更新:需要自定义更新机制时
- 旧版应用支持:支持旧版应用时
Deployment
Deployment 管理 ReplicaSet,以便对 Pod 进行声明式更新。Deployment 可管理应用的滚动更新、回滚、扩缩容等操作。
Deployment 的主要功能
- 声明式更新:声明期望状态,由 Deployment 将当前状态调整为期望状态
- 滚动更新:在不中断服务的情况下更新应用
- 回滚:轻松回滚到先前版本
- 扩缩容:调整应用副本数
- 部署历史记录:保留先前部署版本的记录
Deployment 定义
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
  labels:
    app: nginx
spec:
  replicas: 3
  selector:
    matchLabels:
      app: nginx
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1
      maxUnavailable: 0
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.6
        ports:
        - containerPort: 80
        resources:
          requests:
            cpu: 100m
            memory: 100Mi
          limits:
            cpu: 200m
            memory: 200Mi
        livenessProbe:
          httpGet:
            path: /
            port: 80
          initialDelaySeconds: 30
          periodSeconds: 10
        readinessProbe:
          httpGet:
            path: /
            port: 80
          initialDelaySeconds: 5
          periodSeconds: 5
Deployment 更新策略
Deployment 提供两种更新策略:
RollingUpdate:逐步更新 Pod,实现无停机部署(默认策略)
- maxSurge:超出期望 Pod 数量时允许创建的 Pod 最大数量
- maxUnavailable:更新期间不可用的 Pod 最大数量
Recreate:先删除所有现有 Pod,再创建新的 Pod(会造成短暂停机)
Deployment 回滚
Deployment 支持回滚到先前版本:
# Check deployment history
kubectl -n workloads-demo rollout history deployment/nginx-deployment

# Check details of specific version
kubectl -n workloads-demo rollout history deployment/nginx-deployment --revision=2

# Rollback to previous version
kubectl -n workloads-demo rollout undo deployment/nginx-deployment

# Rollback to specific version
kubectl -n workloads-demo rollout undo deployment/nginx-deployment --to-revision=2
Deployment 扩缩容
Deployment 可以轻松扩缩容:
# Imperative scaling
kubectl -n workloads-demo scale deployment/nginx-deployment --replicas=5

# Declarative scaling (after modifying YAML file)
kubectl apply -f deployment.yaml
暂停和恢复 Deployment
可以暂停和恢复 Deployment 滚动更新:
# Pause rollout
kubectl -n workloads-demo rollout pause deployment/nginx-deployment

# Apply multiple changes
kubectl -n workloads-demo set image deployment/nginx-deployment nginx=nginx:1.30.6-alpine
kubectl -n workloads-demo set resources deployment/nginx-deployment -c=nginx --limits=cpu=200m,memory=256Mi

# Resume rollout
kubectl -n workloads-demo rollout resume deployment/nginx-deployment
Deployment 状态
Deployment 条件包括 Progressing、Available 和 ReplicaFailure。滚动更新停滞时,可能会报告 Progressing=False,原因是 ProgressDeadlineExceeded;Kubernetes 不会自动回滚。“Complete”描述的是滚动更新已完成,而不是一种条件类型。
StatefulSet
StatefulSet 是面向需要状态持久化的应用的工作负载资源。它为每个 Pod 分配唯一标识,并提供稳定的网络标识和持久存储。
StatefulSet 的主要功能
- 稳定且唯一的网络标识:即使重启,也会保留 Pod 名称和主机名
- 稳定且持久的存储:即使 Pod 重新调度,也能访问相同存储
- 按顺序部署和扩缩容:按顺序创建、更新和删除 Pod
- 按顺序自动滚动更新:按顺序更新 Pod
StatefulSet 定义
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: web
spec:
  selector:
    matchLabels:
      app: nginx
  serviceName: "nginx"
  replicas: 3
  updateStrategy:
    type: RollingUpdate
  podManagementPolicy: OrderedReady
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:1.30.6
        ports:
        - containerPort: 80
          name: web
        volumeMounts:
        - name: www
          mountPath: /usr/share/nginx/html
  volumeClaimTemplates:
  - metadata:
      name: www
    spec:
      accessModes: [ "ReadWriteOnce" ]
      storageClassName: "standard"
      resources:
        requests:
          storage: 1Gi
StatefulSet Pod 标识符
StatefulSet 按照以下格式为 Pod 分配唯一标识符:
<StatefulSet name>-<ordinal index>例如,名为 web 的 StatefulSet 会创建 web-0、web-1、web-2 这样的 Pod。
StatefulSet 无头 Service
StatefulSet 通常与无头 Service(clusterIP: None)搭配使用。这会为每个 Pod 创建 DNS 记录:
apiVersion: v1
kind: Service
metadata:
  name: nginx
  labels:
    app: nginx
spec:
  ports:
  - port: 80
    name: web
  clusterIP: None
  selector:
    app: nginx
这样,每个 Pod 都会获得以下格式的 DNS 名称:
<Pod name>.<service name>.<namespace>.svc.cluster.local示例:web-0.nginx.default.svc.cluster.local
StatefulSet 存储
StatefulSet 使用 volumeClaimTemplates 自动为每个 Pod 创建 Persistent Volume Claim(PVC)。即使 Pod 重新调度,这些 PVC 仍会保留。
StatefulSet 更新策略
StatefulSet 提供两种更新策略:
- RollingUpdate:按顺序更新 Pod(默认策略)
- OnDelete:只有删除 Pod 时才更新
Pod 管理策略
StatefulSet 提供两种 Pod 管理策略:
- OrderedReady:按顺序创建和终止 Pod(默认策略)
- Parallel:并行创建和终止 Pod
StatefulSet 用例
StatefulSet 适用于以下应用:
- 数据库:MySQL、PostgreSQL、MongoDB 等
- 分布式系统:Kafka、ZooKeeper、Elasticsearch 等
- 消息队列:RabbitMQ 等
- 其他有状态应用:文件服务器、会话存储等
StatefulSet 示例:持久化 MySQL 实例
此示例展示了单个 MySQL 实例的稳定标识和 PVC。它不会配置复制或数据库自动故障转移。增加 replicas 会创建彼此独立的数据库。请在同一命名空间中创建带有 password 键的 mysql-secret,并提供默认 StorageClass(或明确设置合适的 StorageClass)。请使用经过测试的 MySQL 8.4 补丁版本或摘要;凭据变更需要在数据库层面进行轮换,而不能只更新 Secret。
apiVersion: v1
kind: Service
metadata:
  name: mysql
spec:
  clusterIP: None
  selector:
    app: mysql
  ports:
  - name: mysql
    port: 3306
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: mysql
spec:
  serviceName: mysql
  replicas: 1
  selector:
    matchLabels:
      app: mysql
  podManagementPolicy: OrderedReady
  template:
    metadata:
      labels:
        app: mysql
    spec:
      containers:
      - name: mysql
        image: mysql:8.4
        env:
        - name: MYSQL_ROOT_PASSWORD
          valueFrom:
            secretKeyRef:
              name: mysql-secret
              key: password
        ports:
        - name: mysql
          containerPort: 3306
        startupProbe:
          tcpSocket:
            port: mysql
          periodSeconds: 10
          failureThreshold: 60
        readinessProbe:
          exec:
            command:
            - sh
            - -c
            - 'MYSQL_PWD="$MYSQL_ROOT_PASSWORD" mysql -h 127.0.0.1 -u root -e "SELECT 1"'
          periodSeconds: 10
          timeoutSeconds: 5
        resources:
          requests:
            cpu: 500m
            memory: 1Gi
          limits:
            memory: 2Gi
        volumeMounts:
        - name: data
          mountPath: /var/lib/mysql
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes: [ReadWriteOnce]
      resources:
        requests:
          storage: 10Gi
如需复制和主节点提升,请使用数据库 Operator 或经过单独测试的复制操作手册。StatefulSet 本身不提供这些功能。上游复制教程明确使用了不安全的教学默认设置,不能作为生产配置。
DaemonSet
DaemonSet 可确保在所有节点(或特定节点)上运行一个 Pod 副本。向集群添加节点时会自动添加 Pod;移除节点时,也会移除 Pod。
DaemonSet 的主要功能
- 在所有节点上运行:在集群中的所有节点上运行 Pod
- 选择节点:可以通过节点选择器,仅在特定节点上运行
- 自动部署:添加新节点时自动部署 Pod
- 自动清理:移除节点时自动清理 Pod
DaemonSet 定义
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: fluentd-elasticsearch
  namespace: kube-system
  labels:
    k8s-app: fluentd-logging
spec:
  selector:
    matchLabels:
      name: fluentd-elasticsearch
  updateStrategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 1
  template:
    metadata:
      labels:
        name: fluentd-elasticsearch
    spec:
      tolerations:
      - key: node-role.kubernetes.io/control-plane
        effect: NoSchedule
      containers:
      - name: fluentd-elasticsearch
        image: quay.io/fluentd_elasticsearch/fluentd:v2.5.2
        resources:
          limits:
            memory: 200Mi
          requests:
            cpu: 100m
            memory: 200Mi
        volumeMounts:
        - name: varlog
          mountPath: /var/log
          readOnly: true
      terminationGracePeriodSeconds: 30
      volumes:
      - name: varlog
        hostPath:
          path: /var/log
对于 CRI 运行时,请将收集器配置为解析 /var/log/pods 下的 CRI 日志(通常会从 /var/log/containers 链接到此目录),而不是 Docker JSON 日志。收集器需要自己的源和输出配置以及 RBAC。
DaemonSet 更新策略
DaemonSet 提供两种更新策略:
RollingUpdate:按顺序更新 Pod(默认策略)
- maxUnavailable:更新期间不可用的 Pod 最大数量
OnDelete:只有删除 Pod 时才更新
DaemonSet 节点选择
可以将 DaemonSet 配置为仅在特定节点上运行:
spec:
  template:
    spec:
      nodeSelector:
        disk: ssd
DaemonSet 污点容忍度
DaemonSet 可以设置容忍度,以便在带有污点的节点上运行:
spec:
  template:
    spec:
      tolerations:
      - key: node-role.kubernetes.io/control-plane
        effect: NoSchedule
DaemonSet 用例
DaemonSet 可用于以下用途:
- 日志收集器:Fluentd、Logstash 等
- 监控代理:Prometheus Node Exporter、Datadog Agent 等
- 网络插件:Calico、Cilium 等
- 存储守护进程:Ceph、GlusterFS 等
- 安全代理:Falco、Sysdig 等
DaemonSet 示例:Prometheus Node Exporter
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: node-exporter
  namespace: monitoring
  labels:
    app: node-exporter
spec:
  selector:
    matchLabels:
      app: node-exporter
  template:
    metadata:
      labels:
        app: node-exporter
    spec:
      hostNetwork: true
      hostPID: true
      containers:
      - name: node-exporter
        image: prom/node-exporter:v1.3.1
        args:
        - --path.procfs=/host/proc
        - --path.sysfs=/host/sys
        - --path.rootfs=/host/root
        - --web.listen-address=:9100
        ports:
        - containerPort: 9100
          protocol: TCP
          name: http
        resources:
          limits:
            cpu: 250m
            memory: 180Mi
          requests:
            cpu: 102m
            memory: 180Mi
        volumeMounts:
        - name: proc
          mountPath: /host/proc
          readOnly: true
        - name: sys
          mountPath: /host/sys
          readOnly: true
        - name: root
          mountPath: /host/root
          readOnly: true
      tolerations:
      - operator: "Exists"
      volumes:
      - name: proc
        hostPath:
          path: /proc
      - name: sys
        hostPath:
          path: /sys
      - name: root
        hostPath:
          path: /
Job 和 CronJob
Job 和 CronJob 是用于运行一次性任务或定期任务的工作负载资源。
Job
Job 会创建一个或多个 Pod,并持续执行,直到指定数量的 Pod 成功终止。
Job 的主要功能
- 跟踪完成情况:跟踪成功的 Pod;重试次数限制或截止时间可能导致 Job 失败
- 并行执行:可以并行运行多个 Pod
- 重试:自动重试失败的 Pod
- 完成后清理:可以选择在 Job 完成后清理 Pod
Job 定义
apiVersion: batch/v1
kind: Job
metadata:
  name: pi
spec:
  completions: 5      # Number of Pods that must successfully complete
  parallelism: 2      # Number of Pods to run in parallel
  backoffLimit: 4     # Number of retries on failure
  activeDeadlineSeconds: 100  # Job time limit (seconds)
  ttlSecondsAfterFinished: 100  # Deletion time after completion (seconds)
  template:
    spec:
      containers:
      - name: pi
        image: perl:5.34
        command: ["perl", "-Mbignum=bpi", "-wle", "print bpi(2000)"]
        resources:
          requests:
            cpu: 100m
            memory: 50Mi
          limits:
            cpu: 100m
            memory: 100Mi
      restartPolicy: Never  # or OnFailure
Job 完成模式
Job 提供两种完成模式:
- NonIndexed:标准 Job 模式;指定数量的 Pod 成功完成后,Job 即完成
- Indexed:为每个 Pod 分配一个从 0 开始的索引,以便处理特定索引范围内的任务
apiVersion: batch/v1
kind: Job
metadata:
  name: indexed-job
spec:
  completions: 5
  parallelism: 3
  completionMode: Indexed  # Enable Indexed mode
  template:
    spec:
      containers:
      - name: worker
        image: busybox:1.34
        command: ["sh", "-c", "echo Processing item ${JOB_COMPLETION_INDEX}"]
      restartPolicy: Never
Job 用例
Job 可用于以下用途:
- 批处理:数据处理、ETL 任务
- 计算任务:科学计算、渲染
- 数据库迁移:架构更新
- 一次性管理任务:备份、清理任务
CronJob
CronJob 按照指定的计划定期运行 Job,运行方式与 Linux cron 任务类似。
CronJob 的主要功能
- 定时执行:使用 cron 表达式指定执行计划
- Job 管理:按照计划创建 Job
- 并发策略:定义前一个 Job 仍在运行时的处理方式
- 历史记录限制:限制已完成 Job 的历史记录数量
CronJob 定义
apiVersion: batch/v1
kind: CronJob
metadata:
  name: hello
spec:
  schedule: "*/1 * * * *"  # Run every minute
  timeZone: "America/New_York"  # Timezone (stable since Kubernetes 1.27)
  concurrencyPolicy: Forbid  # Allow, Forbid, Replace
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 1
  startingDeadlineSeconds: 60
  jobTemplate:
    spec:
      template:
        spec:
          containers:
          - name: hello
            image: busybox:1.34
            command:
            - /bin/sh
            - -c
            - date; echo Hello from the Kubernetes cluster
          restartPolicy: OnFailure
Cron 表达式
Cron 表达式格式如下:
+------------------- minute (0 - 59)
| +----------------- hour (0 - 23)
| | +--------------- day of month (1 - 31)
| | | +------------- month (1 - 12)
| | | | +----------- day of week (0 - 6) (Sunday to Saturday; use 0 for Sunday)
| | | | |
| | | | |
* * * * *
常见的 cron 表达式示例:
*/5 * * * *:每 5 分钟0 * * * *:每小时整点0 0 * * *:每天午夜0 0 * * 0:每周日午夜0 0 1 * *:每月 1 日午夜0 0 1 1 *:每年 1 月 1 日午夜
并发策略
CronJob 提供三种并发策略:
- Allow:允许多个 Job 同时运行(默认策略)
- Forbid:如果前一个 Job 仍在运行,则跳过新 Job
- Replace:如果前一个 Job 仍在运行,则用新 Job 替换它
CronJob 用例
CronJob 可用于以下用途:
- 定期备份:数据库备份、创建快照
- 数据同步:定期同步数据
- 生成报告:生成每日/每周/每月报告
- 清理任务:清理临时文件、轮换日志
- 通知和监控:状态检查、发送警报
CronJob 示例:数据库备份
apiVersion: batch/v1
kind: CronJob
metadata:
  name: database-backup
spec:
  schedule: "0 2 * * *"
  timeZone: "Etc/UTC"
  concurrencyPolicy: Forbid
  successfulJobsHistoryLimit: 3
  failedJobsHistoryLimit: 1
  jobTemplate:
    spec:
      template:
        spec:
          containers:
          - name: backup
            image: postgres:14
            env:
            - name: PGHOST
              value: postgres-service
            - name: PGUSER
              valueFrom:
                secretKeyRef:
                  name: postgres-secret
                  key: username
            - name: PGPASSWORD
              valueFrom:
                secretKeyRef:
                  name: postgres-secret
                  key: password
            command:
            - /bin/sh
            - -c
            - |
              set -eu
              backup_file="/backup/db-$(date +%Y%m%d-%H%M%S).dump"
              trap 'rm -f "$backup_file.partial"' EXIT
              pg_dump -Fc > "$backup_file.partial"
              pg_restore --list "$backup_file.partial" > /dev/null
              mv "$backup_file.partial" "$backup_file"
              find /backup -maxdepth 1 -type f -name 'db-*.dump' -mtime +7 -delete
            volumeMounts:
            - name: backup-volume
              mountPath: /backup
          restartPolicy: OnFailure
          volumes:
          - name: backup-volume
            persistentVolumeClaim:
              claimName: backup-pvc
CronJob 的调度时间是近似值:Job 必须能够容忍重复执行。Forbid 仅适用于同一 CronJob 创建的 Job。历史记录限制会删除 Job/Pod 对象,不会删除备份文件。备份示例在 UTC 时间 02:00 运行,并且需要 backup-pvc、postgres-secret 和可访问的数据库;pg_dump 的主版本必须不低于服务器主版本。如果 PGDATABASE 与 PGUSER 不同,请指定 PGDATABASE。请单独测试实际恢复流程。
总结
本文介绍了 Kubernetes 的基本构建单元 Pod,以及各种工作负载资源。我们从 Pod 的概念出发,探讨了包括 Deployment、StatefulSet、DaemonSet、Job 和 CronJob 在内的各种工作负载资源的特征和用例。每种资源都有其独特用途和功能,合理使用它们有助于高效部署和管理应用。
测验
想要检验你对本章内容的掌握情况,请尝试Pod 和工作负载测验。