EKS Hybrid Nodes Gateway
< 上一页:裸机操作系统设置 | 目录 >
验证基线:Gateway/chart 1.0.2;使用 EKS 支持的 Kubernetes 版本,以及满足 Gateway 前提条件的 AWS 维护版 Cilium。 最后更新:October 18, 2026
概述
EKS Hybrid Nodes Gateway 是一个开源网络组件,可自动实现 Amazon VPC 与在本地或边缘环境中的 Hybrid Nodes 上运行的 Kubernetes Pod 之间的连接。该 Gateway 于 2026 年 4 月 21 日正式推出(Generally Available),可自动管理其负责的 Pod 路由和 VXLAN 转发状态。底层网络可达性、路由所有权、防火墙/MTU 规划、发布和清理仍需要明确配置。
Gateway 通过在 VPC 中专用的 EC2 Gateway 实例与本地由 Cilium 管理的 Hybrid Nodes 之间建立 VXLAN 隧道来工作。它会自动配置 VPC 路由表、管理转发数据库(FDB)条目,并配置 Cilium VTEP(VXLAN 隧道端点)集成,使 VPC 中的 Pod 可以直接与 Hybrid Nodes 上的 Pod 通信。要成功转发流量,仍取决于经过审核的底层网络、CNI、IAM、安全规则和应用路径。
主要特征:
- 开源:可在 github.com/aws/eks-hybrid-nodes-gateway 完整获取
- 不收取 Gateway 软件费用:EC2、存储、Auto Mode 费用(仅当 Gateway 节点在 Auto Mode 上运行时;托管或自行管理的节点组也可使用)、跨 AZ 流量、连接和可观测性仍会产生费用
- 自动管理路由:leader 会配置已设置的聚合 VPC Pod 路由;每个副本分别协调每个 CiliumNode 的本地隧道状态
- 高可用性:支持采用基于 Lease 的 leader 选举进行故障转移的 2 副本 Deployment
- Cilium 集成:利用 Cilium 的 VTEP 功能,通过 VXLAN 隧道实现透明的 Pod 到 Pod 路由
学习目标
完成本文档后,你将能够:
- 说明 EKS Hybrid Nodes Gateway 的架构,包括 VXLAN 隧道、leader 选举和 VPC 路由管理
- 使用 Helm 部署和配置 Gateway,包括 IAM 角色、安全组和 Cilium VTEP 集成
- 跟踪 VPC Pod 与 Hybrid Node Pod 之间的流量,包括两个方向
- 通过多副本 Gateway 部署实现高可用性,并了解故障转移行为
- 运维和排查 Gateway 部署问题,包括监控、扩缩容和常见故障情形
- 比较 Hybrid Nodes 网络方案,并决定何时使用 Gateway,何时使用手动路由
- 在生产 Gateway 部署中应用安全、性能和成本优化最佳实践
问题:Hybrid 环境中的手动 Pod 路由
在 Gateway 可用之前,要实现 VPC 与 Hybrid Nodes 之间的 Pod 级通信,需要投入大量手动工作:
Before Gateway (Manual Approach):
=================================

1. Configure BGP peering between on-prem routers and VPC (or use static routes)
2. Manually manage VPC route table entries for every hybrid Pod CIDR
3. Set up and maintain VPN tunnels or Direct Connect with proper route propagation
4. Handle route updates when nodes join/leave the cluster
5. Troubleshoot routing asymmetries and MTU issues across multiple hops
6. Maintain custom scripts or controllers to keep routes in sync

After Gateway (Automated Approach):
====================================

1. Deploy gateway via Helm chart
2. Gateway automatically:
   - Creates VXLAN tunnels to hybrid nodes
   - Programs VPC route table entries
   - Configures Cilium VTEP for transparent routing
   - Handles failover via leader election
   - Updates routes as nodes come and go
Gateway 将原本复杂、容易出错、需要多个团队协作的网络挑战,转变为只需一次 Helm 安装和少量配置值。
深入了解架构
高层架构
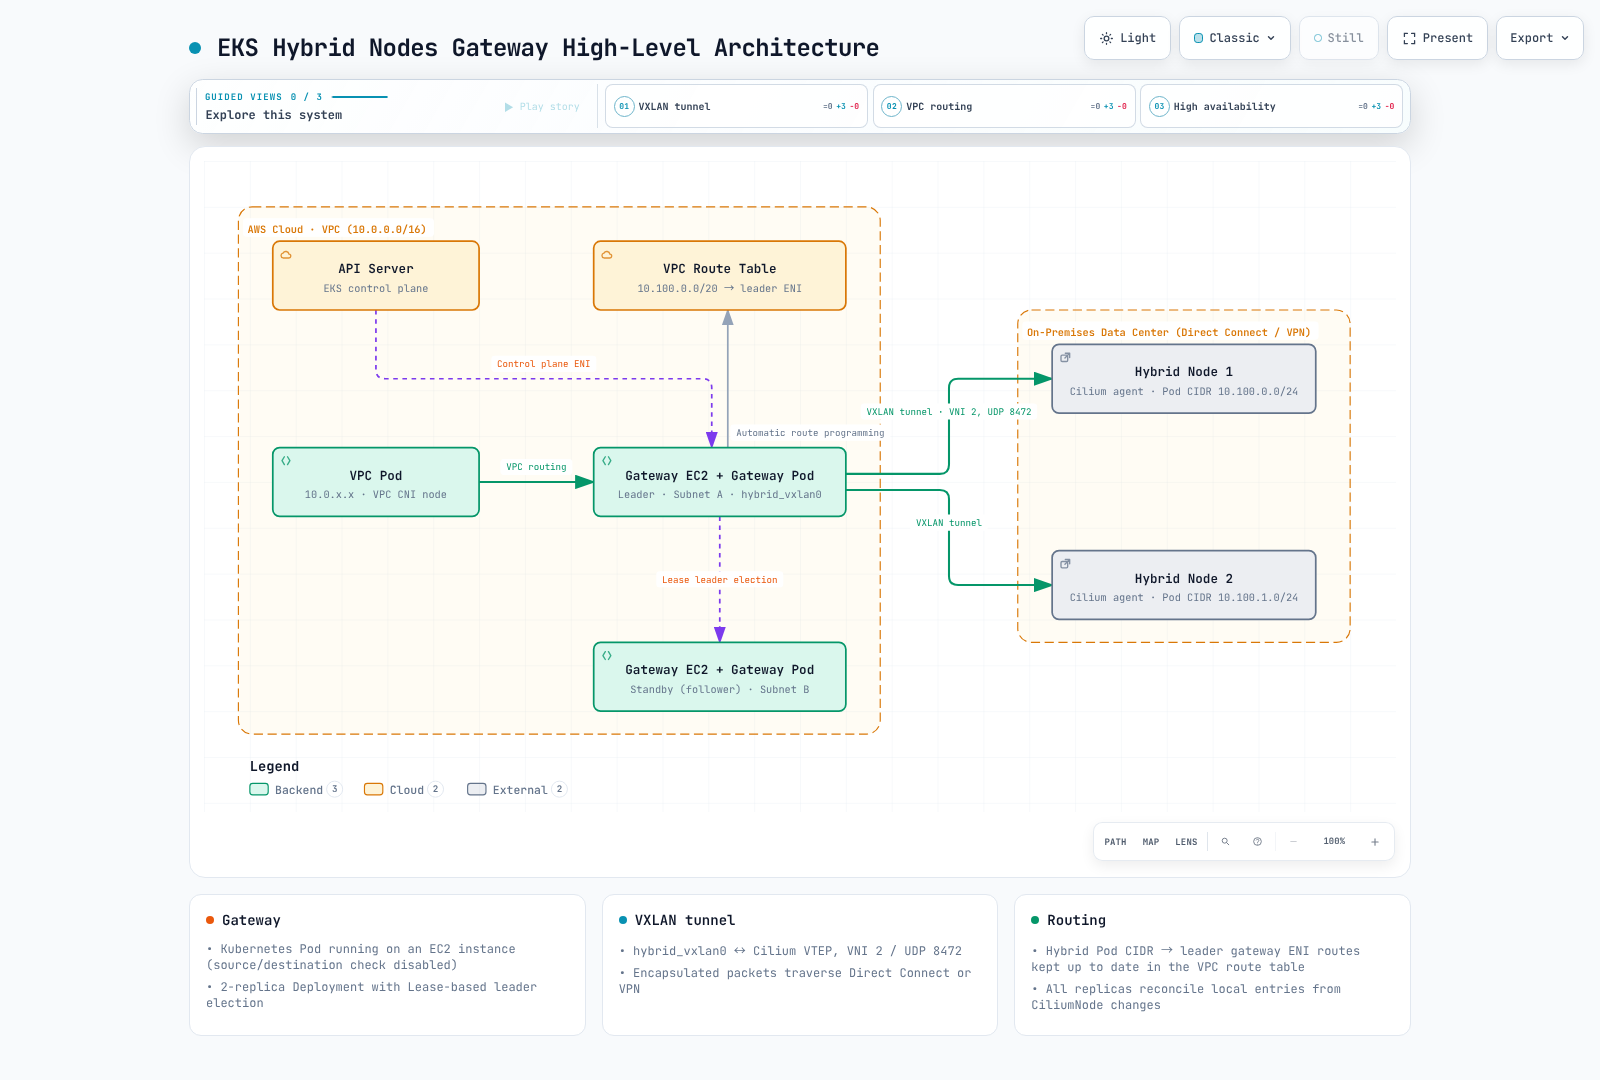
EKS Hybrid Nodes Gateway 位于 VPC 与本地网络的边界,充当基于 VXLAN 的 Pod 流量桥接。下图展示了整体架构:
VXLAN 隧道机制
Gateway 使用 VXLAN(可扩展虚拟局域网)在 VPC 和本地环境之间封装 Pod 流量。以下说明了如何建立和维护隧道:
Gateway 端的 VXLAN 接口
Gateway Pod 在 EC2 实例上启动时,会使用以下参数创建一个 hybrid_vxlan0 网络接口:
| 参数 | 值 | 说明 |
|---|---|---|
| 接口名称 | hybrid_vxlan0 | Gateway 上的 VXLAN 隧道接口 |
| VNI(VXLAN 网络标识符) | 2 | 与 Cilium VTEP 路径兼容的 Gateway 默认值;不是 CiliumVTEPConfig 字段 |
| UDP 端口 | 8472 | Gateway/Cilium VXLAN 端口;VXLAN 的 IANA 分配端口为 4789 |
| 本地 IP | Gateway EC2 实例私有 IP | VXLAN 封装数据包的源 IP |
| 学习功能 | 已禁用 | FDB 条目由 Gateway 静态配置 |
Gateway 使用 netlink 创建此接口。以下是概念性说明,不应作为命令与控制器并行运行。1.0.2 版本不会为此接口分配 IP 地址;外层隧道使用 Gateway 节点的私有 IP。
# Conceptual equivalent of what the gateway does programmatically
ip link add hybrid_vxlan0 type vxlan \
    id 2 \
    local <gateway-private-ip> \
    dstport 8472 \
    nolearning

ip link set hybrid_vxlan0 up
FDB、ARP 和路由配置
节点协调器会监视带有 eks.amazonaws.com/compute-type: hybrid 标签的 CiliumNode 对象。每个 Gateway 副本都会运行该协调器,并根据节点的内部 IP 和已分配的 Pod CIDR 配置三类本地条目:
Per Hybrid Node, the gateway programs:
=======================================

1. FDB (Forwarding Database) Entry:
   deterministic node MAC → hybrid node's internal IP
   → Tells the VXLAN interface where to send encapsulated frames for this node

2. ARP Entry:
   hybrid node's internal IP → deterministic node MAC
   → Pre-populates ARP so the gateway can immediately forward packets without ARP discovery

3. Route Entry:
   hybrid node's Pod CIDR via its internal IP, dev hybrid_vxlan0, onlink
   → Directs Pod traffic for this node's CIDR through the VXLAN tunnel
控制器根据节点的 IPv4 地址推导远程 MAC,而不是发现 Cilium 接口 MAC。静态邻居/FDB 条目可避免此路径依赖动态学习。但协调错误、过期条目和底层网络故障仍可能中断转发。这些本地路由与 VPC 路由表条目不同。
Hybrid Node 端(Cilium VTEP)
在 Hybrid Node 端,Cilium 的 VTEP(VXLAN 隧道端点)功能负责处理隧道终止。Gateway 通过 CiliumVTEPConfig 自定义资源将自身注册为远程 VTEP。这会告知 Hybrid Nodes 上的每个 Cilium agent:
- 发往 VPC CIDR 的流量应通过 VXLAN 封装
- 封装后的流量应发送到 Gateway 的 IP 地址
- VXLAN 隧道在 UDP 端口 8472 上使用 VNI 2
# CiliumVTEPConfig created and managed by the gateway
apiVersion: cilium.io/v2
kind: CiliumVTEPConfig
metadata:
  name: hybrid-gateway
spec:
  endpoints:
    - name: vpc-gateway
      tunnelEndpoint: "10.0.1.5"      # Actual leader node IP
      cidr: "10.0.0.0/16"            # One VPC prefix per endpoint
      mac: "82:36:6c:89:e6:ad"       # Illustrative; read the leader's actual VXLAN MAC
当 Hybrid Node 上的 Pod 向 VPC IP 地址(例如云端 Pod 或 AWS 服务端点)发送流量时,Cilium agent 会:
- 根据 CiliumVTEPConfig 中某个端点的
cidr匹配目标地址 - 使用 VNI 2 封装数据包
- 将外层 UDP 数据包发送到 Gateway 的 IP 和端口 8472
- Gateway 解封装数据包,并将内层数据包转发到 VPC
Leader 选举和高可用性
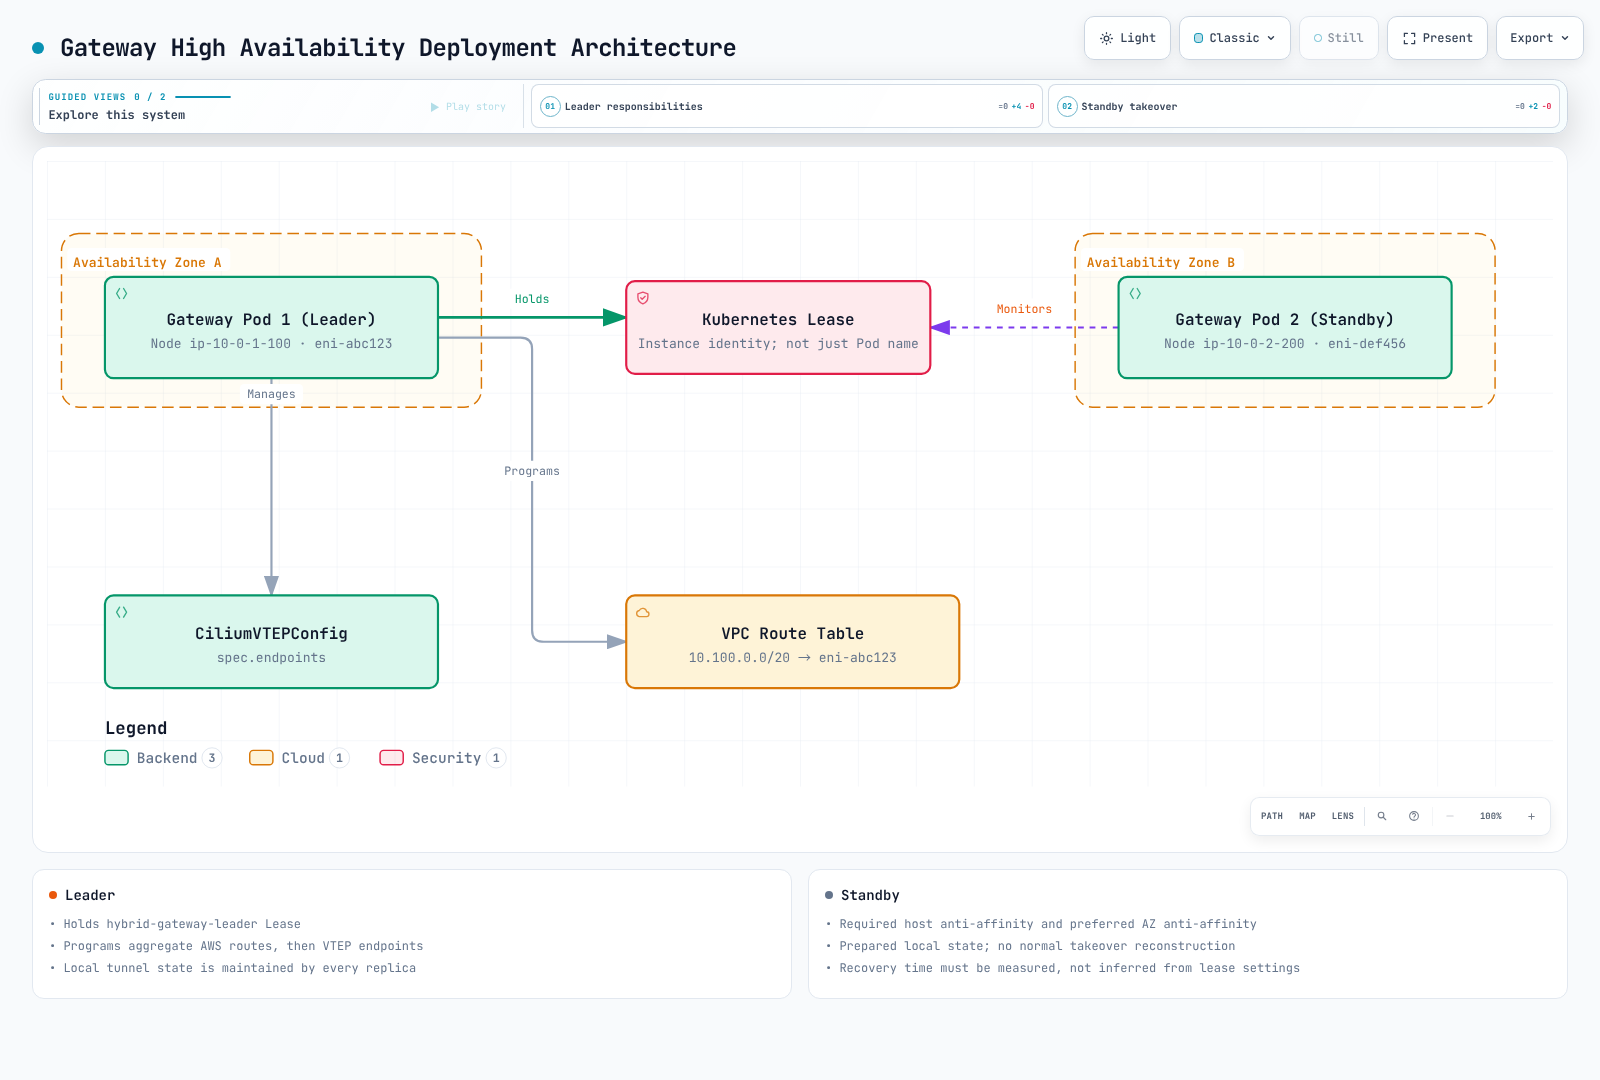
Chart 默认使用双副本 Deployment。两个副本都会维护本地 VXLAN/FDB/邻居/路由。只有 leader 会更新 AWS VPC 路由和控制器管理的 CiliumVTEPConfig(名称为 hybrid-gateway)。
基于 Lease 的 Leader 选举
Leader 选举使用标准 Kubernetes Lease 资源:
apiVersion: coordination.k8s.io/v1
kind: Lease
metadata:
  name: hybrid-gateway-leader
  namespace: eks-hybrid-nodes-gateway
spec:
  holderIdentity: "gateway-node-hostname_example-uuid"
  leaseDurationSeconds: 3
  acquireTime: "2026-06-28T10:00:00Z"
  renewTime: "2026-06-28T10:00:10Z"
  leaseTransitions: 3
此 Lease 是示例性观察结果,并非要应用的清单。holder identity 不一定是 Pod 名称;执行任何运维操作前,请先找出对应的节点/Pod。以下二进制标志控制选举时序;chart 1.0.2 不提供 leaderElection values 对象:
| 参数 | 默认值 | 说明 |
|---|---|---|
--leader-election-lease-duration | 3s | 选举 Lease 时长 |
--leader-election-renew-deadline | 2s | Leader 续租截止时间 |
--leader-election-retry-period | 1s | 选举重试间隔 |
Leader 的职责
Leader Pod 负责:
- VPC 路由表管理:在指定 VPC 路由表中创建和更新路由,将 Hybrid Pod CIDR 指向 leader 的 EC2 实例 ENI
- CiliumVTEPConfig 管理:创建和更新 CiliumVTEPConfig 资源,将 Hybrid Nodes 的 VTEP 流量指向 leader 的 EC2 实例 IP
- FDB/ARP/路由配置:在本地 VXLAN 接口中为所有 Hybrid Nodes 配置条目
- 监视节点:与备用副本一样,监视 CiliumNode 对象并更新本地隧道条目。它不会针对每个节点事件创建/删除 AWS 路由。
备用副本的职责
备用 Pod:
- 维护 VXLAN 隧道:保持其
hybrid_vxlan0接口处于活动状态,并配置 FDB/ARP/路由条目 - 不会配置 VPC 路由:只有 leader 会修改 VPC 路由表
- 不会更新 CiliumVTEPConfig:只有 leader 会更新 VTEP 配置
- 监视 Lease:持续尝试获取 Lease,以便在 leader 发生故障时接管
VPC 路由表自动管理
获取领导权后,Gateway 会在每个已配置的路由表中为已配置的聚合 podCIDRs 创建或替换路由。它会先更新 AWS 路由,再更新 CiliumVTEPConfig。CiliumNode 协调会在每个副本上独立维护各节点的本地隧道条目。
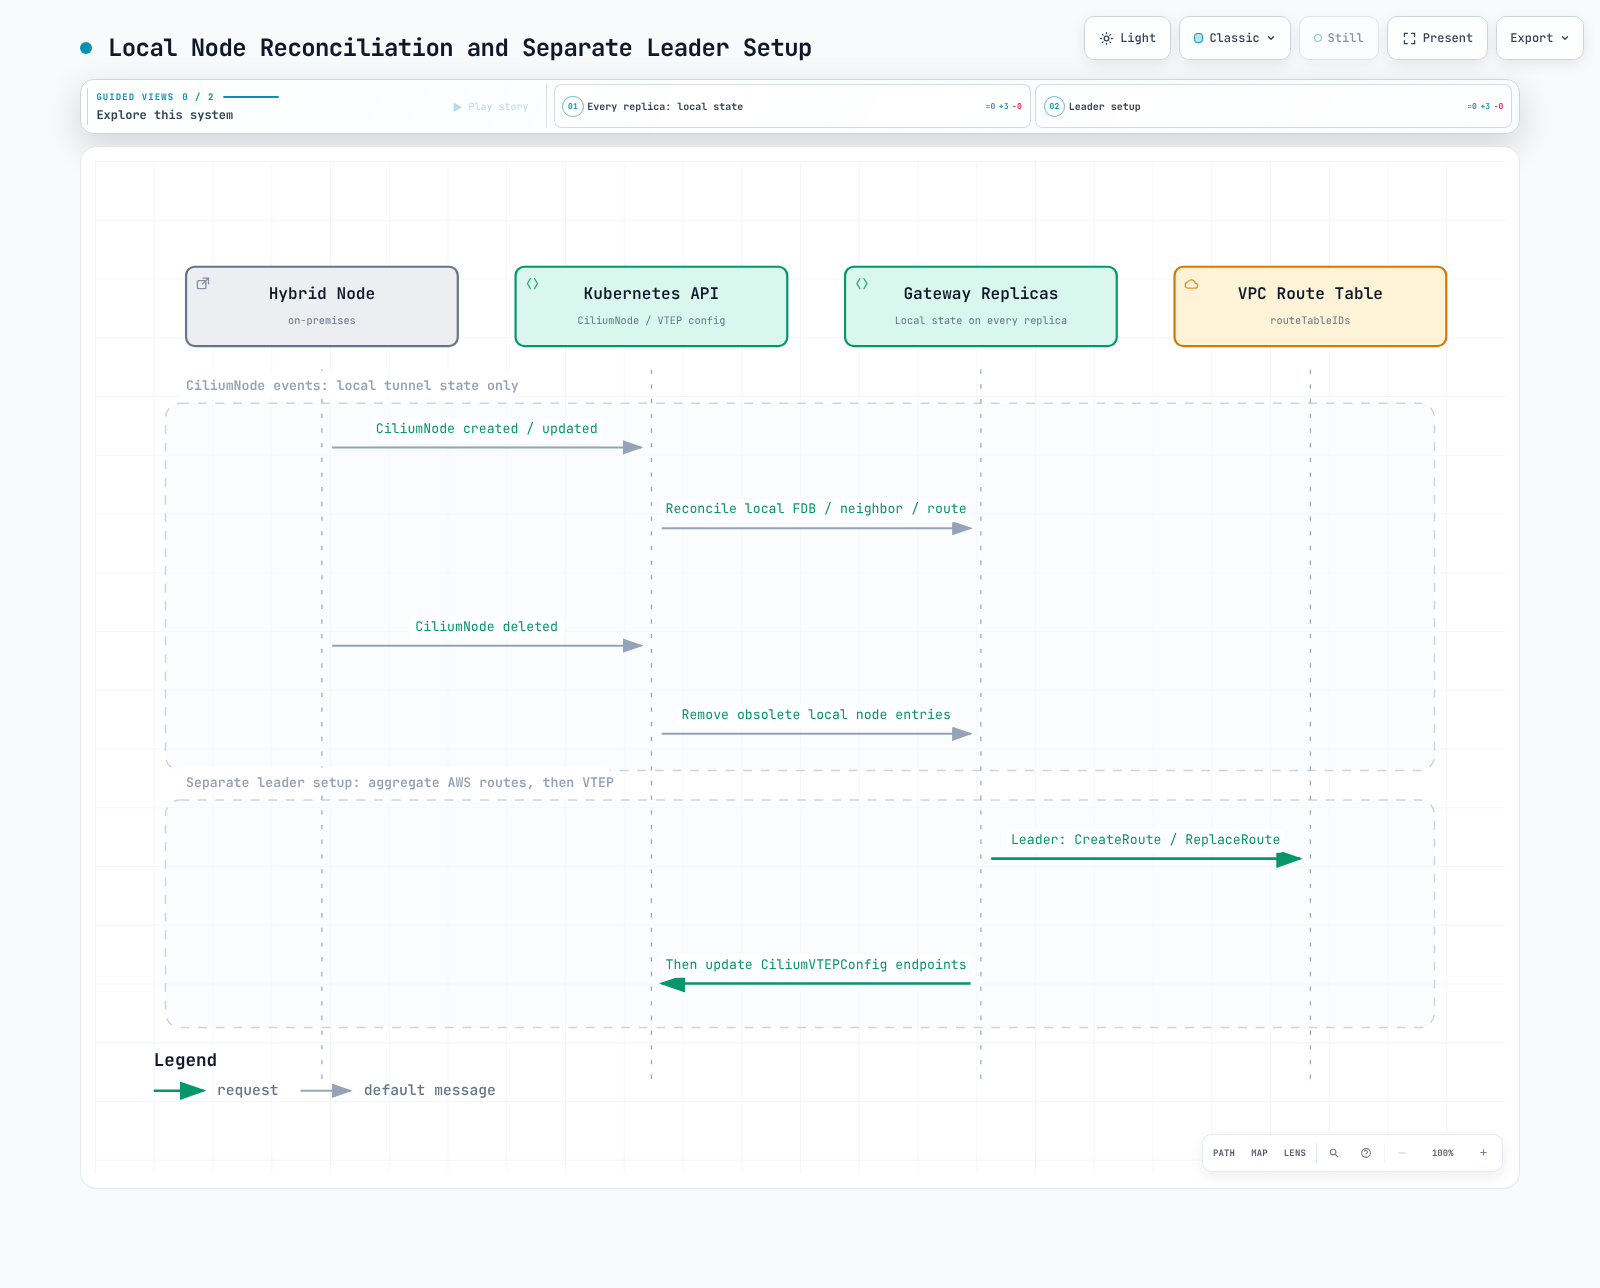
Gateway 使用 EC2 API 管理路由:
| API 调用 | 使用时机 | 用途 |
|---|---|---|
ec2:DescribeRouteTables | 访问检查和 leader 设置 | 读取明确配置的路由表 |
ec2:CreateRoute | Leader 设置时,已配置的 CIDR 路由不存在 | 添加聚合 Pod CIDR 路由 |
ec2:ReplaceRoute | Leader 设置时,目标与当前目标不同时 | 将已配置路由重定向到当前 leader 的主 ENI |
ec2:DescribeInstances | 启动、故障转移 | 查找 Gateway EC2 实例的 ENI ID |
Gateway 运行时不会调用 DeleteRoute。卸载 Helm 不会清理 AWS 路由。即使同一 CIDR 的现有路由由其他系统创建,也可能被替换:安装前请审核路由所有权以及切换/回滚计划。
这些约定已根据 1.0.2 实现 和 AWS 运维指南 进行核对。API 读取、就绪状态或 leader 指标本身都不能证明端到端转发正常。
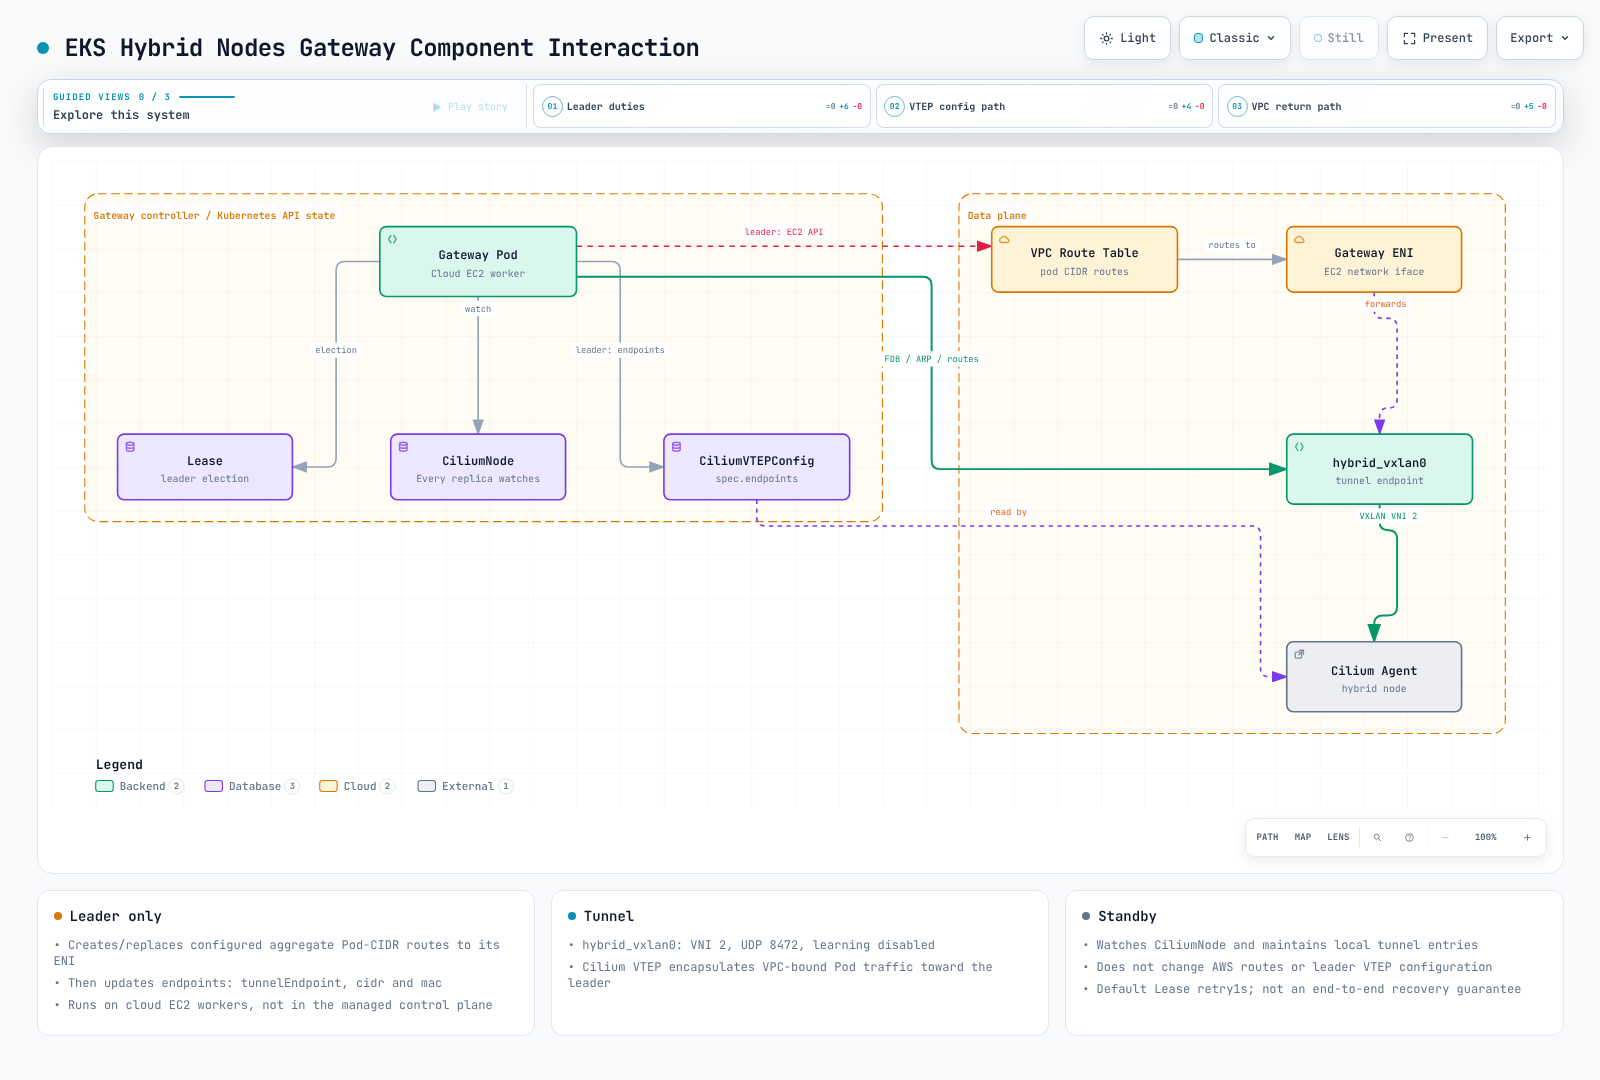
组件交互摘要
下图展示了所有组件之间的交互方式:
前提条件
部署 EKS Hybrid Nodes Gateway 之前,请确保满足以下所有前提条件。
EKS 集群配置
| 要求 | 详细信息 |
|---|---|
| EKS 版本 | EKS 和所选附加组件当前支持的版本 |
| 地址族 | IPv4;VPC、Service、远程节点和远程 Pod 网络不得重叠 |
| Hybrid Nodes | 至少配置一个 Hybrid Node 并将其加入集群 |
| 身份验证模式 | API 或 API_AND_CONFIG_MAP |
| 端点访问 | 仅公开访问或仅私有访问(不能同时选择“公开和私有”) |
| 远程 Pod 网络 | 集群中已为 Hybrid Nodes 配置 Pod CIDR |
CNI 要求
Gateway 需要特定的 CNI 配置:
| 位置 | CNI | 版本 | VTEP 支持 |
|---|---|---|---|
| 托管/自行管理的云节点 | Amazon VPC CNI | 受支持的附加组件版本;配置 Hybrid ClusterIP SNAT 排除项 | 不需要 |
| Auto Mode 云节点 | 内置网络 | 使用 Auto Mode 支持的配置 | 不需要 |
| Hybrid Nodes | AWS 维护的 Cilium | 满足 CNI 配置中的分支版本最低要求 | 启用 VTEP,禁用 L7 proxy |
此 Gateway 实现需要 AWS Cilium VTEP 集成;它不是兼容 Calico 的控制器。如果其 CNI/L7 要求不适用,请使用单独受支持的可路由 Pod 设计。Hybrid 集群创建要求规定,Hybrid Nodes 必须使用 API/API_AND_CONFIG_MAP 身份验证、IPv4,以及仅公开或仅私有的端点连接方式。
网络连接
VPC 与本地环境之间必须已经建立私有连接:
| 连接类型 | 使用场景 | 备注 |
|---|---|---|
| AWS Direct Connect | 需要持续稳定低延迟的生产工作负载 | 专用连接;弹性和延迟取决于实际冗余设计 |
| AWS Site-to-Site VPN | 标准 Hybrid 连接 | IPsec 连接;吞吐量取决于所选隧道方案、数据包类型和路由 |
| Transit Gateway + VPN | 多 VPC 环境 | 集中式 VPN 终止;支持 ECMP 以提高吞吐量 |
| 自定义 VPN(例如 WireGuard) | 特殊需求 | 自行管理的隧道;当 AWS VPN 限制成为问题时可考虑使用 |
注意:Gateway 不会在 VPC 与本地环境之间建立基础连接。它是在现有连接之上添加 VXLAN overlay,以便进行 Pod 级路由。
EC2 Gateway 实例
你至少需要在 VPC 中运行 Gateway Pod 的两台 EC2 实例:
# Recommended EC2 instance configuration for gateway nodes
Instance type: c6i.large (2 vCPU, 4 GiB RAM) or larger
AMI: Amazon Linux 2023 (EKS optimized)
Placement: Spread across at least 2 Availability Zones
EBS: 20 GiB gp3 (minimal storage needed)
Gateway 实例必须:
- 注册为云端 EC2 节点;区分使用 Amazon VPC CNI 的托管/自行管理节点与使用内置网络的 Auto Mode 节点
- 具有适当的节点角色和单独限定范围的 Gateway 工作负载角色(参见 IAM 配置)
- 带有用于 Gateway Pod 调度的标签(参见安装)
安全组配置
使用实际的节点/Pod CIDR 和经过审核的端口。仅开放 UDP8472 并不能建立所有应用或控制面路径。请分别处理以下流量:
| 流量 | 必要审核 |
|---|---|
| Gateway 主 IP ↔ Hybrid Node IP | 双向外层 VXLAN UDP8472 |
| 云端工作负载 ↔ Hybrid Pod | 预期的内层应用协议/端口及其返回流量 |
| 节点 → Kubernetes API、AWS API/registry 和 DNS | 实际端点/解析器、TCP443 和所需 DNS 路径 |
| 控制面 → kubelet | 到目标节点的 TCP10250;与节点出站 API443 流量分开处理 |
| Prometheus → Gateway | 将 TCP10080 限制为指定的抓取源 |
请分别考虑安全组、无状态 NACL 和本地防火墙。不要将整个 VPC 的入站流量一概放行,作为所需应用流量规则的替代方案。保护所有可能成为 leader 的节点 IP,包括替换节点容量。
Terraform 安全组示例
在现有节点/网络 Terraform 堆栈中管理已批准的规则矩阵。仅包含 Gateway UDP 规则的代码片段并不是完整的节点安全组。请保留集群启动、DNS、API 和应用要求,并检查最终计划;避免创建不受限制的重复 SG,并假定添加 VXLAN 规则就意味着安全。
本地防火墙配置
使用可通过私有底层网络访问的 Gateway 私有节点 IP,而不是 Elastic IP。为每个可能成为 leader/备用节点的节点开放所需的 UDP8472 路径,并单独审核 Kubernetes API/kubelet、DNS 和应用流量。Auto Mode 或其他节点管理器替换 Gateway 实例时,应同步更新防火墙规则。本章和静态 SG 表都不能证明实际防火墙路径正常。
请验证目标主 ENI 上的源/目标检查设置。Auto Mode 使用 NodeClass 转发设置;托管/自行管理节点的资源配置流程负责所需的 ENI 修改。以下命令仅读取当前值:
: "${AWS_REGION:?Set the reviewed Region}"
: "${GATEWAY_PRIMARY_ENI_ID:?Set the verified gateway primary ENI}"
aws ec2 describe-network-interface-attribute --region "$AWS_REGION" \
  --network-interface-id "$GATEWAY_PRIMARY_ENI_ID" --attribute sourceDestCheck
MTU 注意事项
IPv4 VXLAN 通常会增加 50 字节开销,其中包括内层 Ethernet 标头。请使用端到端实际有效的底层网络 MTU,而不是 EC2 接口的最大值。以下原始 MTU 数值仅供规划参考,并非实测路径结果或通用的 DX/VPN 设置:
| 组件 | 建议 MTU | 备注 |
|---|---|---|
| Gateway EC2 实例 | 9001(巨型帧) | 大多数 EC2 实例类型在 VPC 中的默认值 |
| 本地 Hybrid Nodes | 1500 或更高 | 取决于网络基础设施 |
| VXLAN 接口(有效值) | 路径 MTU - 50 | 例如路径 MTU 为 1500 时,值为 1450 |
| Direct Connect | 9001(巨型帧) | DX 连接支持时使用 |
| VPN 隧道 | 1399-1500 | 取决于 VPN 配置 |
如果 VPC 与本地环境之间的网络路径使用标准 1500 MTU:
Effective Pod MTU calculation:
Physical MTU:        1500 bytes
VXLAN overhead:      - 50 bytes (outer IP + outer UDP + VXLAN header)
VPN overhead (IPsec): - 57-73 bytes (if applicable)
Effective Pod MTU:   ~1377-1450 bytes
可以在 Hybrid Nodes 上配置 Cilium 使用适当的 MTU:
# Cilium Helm values for hybrid nodes
mtu: 1400  # Illustrative only; replace using validated path MTU and chosen Cilium datapath.
IAM 配置
所需 IAM 权限
请将 Gateway 工作负载角色与 EC2 节点角色以及运维人员的资源配置/清理权限分开。AWS 入门指南建议使用 EKS Pod Identity。符合条件的托管/自行管理节点上必须有 Pod Identity agent;Auto Mode 提供 Pod Identity 支持。不要在已有安装之上盲目创建附加组件。
Gateway 运行时所需操作为 ec2:DescribeRouteTables、ec2:DescribeInstances、ec2:CreateRoute 和 ec2:ReplaceRoute。Describe 操作需要设置 Resource: "*";请限制 Region。路由写入可以使用精确的路由表 ARN 和 VPC 条件。删除已停用路由属于运维人员操作,而不是运行时权限。
限定范围的 IAM policy(生产环境建议)
将以下内容保存为 gateway-permissions.json,并替换为经过审核的账户、Region、VPC 和路由表 ID。这些标识符仅供说明,本次审核不会创建这些资源。此 policy 不会限制该角色在这些路由表中可修改的目标 CIDR:应将其视为路由安全边界,并控制哪些人可以编辑 Gateway values 或使用其 ServiceAccount。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "ReadGatewayRoutingMetadata",
      "Effect": "Allow",
      "Action": [
        "ec2:DescribeRouteTables",
        "ec2:DescribeInstances"
      ],
      "Resource": "*",
      "Condition": {
        "StringEquals": {
          "aws:RequestedRegion": "ap-northeast-2"
        }
      }
    },
    {
      "Sid": "ManageOnlyOwnedRouteTables",
      "Effect": "Allow",
      "Action": [
        "ec2:CreateRoute",
        "ec2:ReplaceRoute"
      ],
      "Resource": [
        "arn:aws:ec2:ap-northeast-2:111122223333:route-table/rtb-0abc123456789def0",
        "arn:aws:ec2:ap-northeast-2:111122223333:route-table/rtb-0def456789abc1230"
      ],
      "Condition": {
        "StringEquals": {
          "ec2:Vpc": "arn:aws:ec2:ap-northeast-2:111122223333:vpc/vpc-0123456789abcdef0"
        }
      }
    }
  ]
}
路由表 ARN 和 ec2:Vpc 范围限定遵循 EC2 路由表 policy 示例。Describe 请求成功不能证明具有 CreateRoute/ReplaceRoute 授权。切换前,请在已批准的环境中测试授权和路由所有权。
Terraform IAM 配置
使用 Pod Identity 时,将此信任 policy 保存为 gateway-trust.json,并替换为准确的集群 ARN。必须保持启用会话标签,因为这些条件会绑定集群、namespace 和 ServiceAccount。除 IAM 权限外,还要限制 Pod/ServiceAccount 创建权限和 Pod Identity association 管理权限。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Service": "pods.eks.amazonaws.com"
      },
      "Action": [
        "sts:AssumeRole",
        "sts:TagSession"
      ],
      "Condition": {
        "StringEquals": {
          "aws:RequestTag/eks-cluster-arn": "arn:aws:eks:ap-northeast-2:111122223333:cluster/hybrid-production",
          "aws:RequestTag/kubernetes-namespace": "eks-hybrid-nodes-gateway",
          "aws:RequestTag/kubernetes-service-account": "eks-hybrid-nodes-gateway"
        }
      }
    }
  ]
}
Pod Identity 信任 policy 和会话标签定义了这些条件。以下 HCL 是集成代码片段,并非完整的 provider/cluster 堆栈;对于每个资源,请选择由 Terraform 或 CLI 路径管理,不要两者同时管理。
# Fragment in the existing reviewed AWS provider/cluster stack.
# Declare and validate these variables; do not create duplicate CLI-managed resources.
resource "aws_iam_role" "gateway" {
  name               = var.gateway_role_name
  assume_role_policy = file("${path.module}/gateway-trust.json")
}
resource "aws_iam_role_policy" "gateway_routes" {
  name   = "GatewayOwnedRoutes"
  role   = aws_iam_role.gateway.id
  policy = file("${path.module}/gateway-permissions.json")
}
resource "aws_eks_pod_identity_association" "gateway" {
  cluster_name    = var.cluster_name
  namespace       = "eks-hybrid-nodes-gateway"
  service_account = "eks-hybrid-nodes-gateway"
  role_arn        = aws_iam_role.gateway.arn
}
AWS CLI IAM 设置
由 IAM 管理员使用经过审核的信任/权限 JSON 准备角色。association 的 ServiceAccount 名称必须与渲染后的 chart 一致。更改 Helm release/name overrides 可能会改变名称。Association 配置与 chart values 分开设置:chart 1.0.2 会忽略 serviceAccount.annotations。
: "${AWS_REGION:?Set the reviewed Region}"
: "${CLUSTER_NAME:?Set the reviewed cluster}"
: "${GATEWAY_ROLE_ARN:?Set the prepared, scoped Pod Identity role ARN}"
# Inspect existing associations; do not create a duplicate or replace another owner.
aws eks list-pod-identity-associations --region "$AWS_REGION" \
  --cluster-name "$CLUSTER_NAME" --namespace eks-hybrid-nodes-gateway \
  --service-account eks-hybrid-nodes-gateway
# Run only for the reviewed new association; keep session tags enabled:
aws eks create-pod-identity-association --region "$AWS_REGION" \
  --cluster-name "$CLUSTER_NAME" --namespace eks-hybrid-nodes-gateway \
  --service-account eks-hybrid-nodes-gateway --role-arn "$GATEWAY_ROLE_ARN" \
  --no-disable-session-tags
IRSA 仍可作为替代方案,但需要实际的 OIDC 信任 policy 以及渲染后 ServiceAccount 上的注释,应通过经过审核的 patch/overlay 管理;Helm 忽略的 value 无法建立 IRSA。避免将路由写入权限广泛授予所有节点工作负载。二进制通过 EC2 metadata 查找节点身份,以及其 SDK 凭证链,是两个独立问题;不要盲目禁用 metadata,除非已提供并验证所需的节点身份输入。
Auto Mode 转发使用 NodeClass.spec.advancedNetworking.sourceDestCheck: DisabledPrimaryENI。托管/自行管理节点的启动流程必须使用单独限定范围的节点/运维权限,禁用目标主 ENI 上的源/目标检查。ModifyNetworkInterfaceAttribute 和集群/角色/附加组件创建均不属于上述 Gateway 工作负载 policy。
安装和配置
步骤 1:为 Gateway 节点添加标签
先配置符合条件的云端 EC2 节点。托管/自行管理节点使用 autoMode.enabled=false;Auto Mode 需要预先准备 NodeClass/NodePool,并设置 autoMode.enabled=true。只有在转发、安全组和 IAM 前提条件均已验证后,才为节点添加标签。不要伪造由 provider 管理的实例类型或 AZ 标签。最好在不同 AZ 中选择两个符合条件的节点。
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
: "${GW_NODE_A:?Set the first eligible gateway node}"
: "${GW_NODE_B:?Set the second eligible gateway node}"
kubectl --context "$KUBE_CONTEXT" get node "$GW_NODE_A" "$GW_NODE_B" \
  -L topology.kubernetes.io/zone,eks.amazonaws.com/compute-type
# Apply only after source/destination check, IAM and network prerequisites are met:
kubectl --context "$KUBE_CONTEXT" label node "$GW_NODE_A" "$GW_NODE_B"   hybrid-gateway-node=true
步骤 2:收集配置值
确认 AWS 账户、集群 VPC、远程 Pod CIDR、实际 Gateway ENI,以及受影响的子网/控制面路由表。仅选择由此路由设计拥有的路由表;列出 VPC 中的所有路由表,并不代表有权修改所有路由表。remoteNetworkConfig 位于 cluster 之下,而不是 kubernetesNetworkConfig 之下。
: "${AWS_REGION:?Set the reviewed AWS Region}"
: "${CLUSTER_NAME:?Set the reviewed EKS cluster}"
: "${VPC_ID:?Set the cluster VPC ID}"
aws sts get-caller-identity --query Account --output text
aws eks describe-cluster --region "$AWS_REGION" --name "$CLUSTER_NAME" \
  --query 'cluster.{VpcId:resourcesVpcConfig.vpcId,RemotePodCIDRs:remoteNetworkConfig.remotePodNetworks[].cidrs[]}' \
  --output json
aws ec2 describe-vpcs --region "$AWS_REGION" --vpc-ids "$VPC_ID" \
  --query 'Vpcs[].CidrBlockAssociationSet[].{CIDR:CidrBlock,State:CidrBlockState.State}' \
  --output json
aws ec2 describe-route-tables --region "$AWS_REGION" \
  --filters "Name=vpc-id,Values=$VPC_ID" \
  --query 'RouteTables[].{ID:RouteTableId,Associations:Associations,Routes:Routes}' \
  --output json
步骤 3:通过 Helm 安装
安装前完成 CNI、节点和工作负载 IAM 步骤。Leader 可能会立即替换已配置 CIDR 对应的现有路由。检查路由所有权、返回路由和回滚方案后,使用以下 values 文件。本章仅对本地配置进行验证,不代表实际部署状态。
完整 Helm Values 参考
已发布的 1.0.2 chart 要求 podCIDRs 和 routeTableIDs 使用 CSV 字符串,而不是 YAML 数组。请使用 values 文件,以免 Helm --set 的逗号/列表解析改变其类型。
# values.yaml: replace CIDRs/table IDs from the reviewed network inventory.
vpcCIDR: "10.0.0.0/16"
podCIDRs: "10.85.0.0/16"
routeTableIDs: "rtb-0abc123456789def0,rtb-0def456789abc1230"
replicas: 2
nodeLabel: hybrid-gateway-node
autoMode:
  enabled: false  # MNG/self-managed. Set true only for prepared Auto Mode nodes.
该 chart 还支持 image.repository、image.tag、image.pullPolicy 和命名 helper。其模板不会接入 replicaCount、nodeSelector、resources、affinity、topologySpreadConstraints、serviceAccount.annotations、leaderElection、logLevel、metrics、extraEnv 或自定义 volume values。不要将可接受的 YAML 误认为已应用的设置。请单独配置工作负载身份;如果其他设置需要受维护的 post-renderer,请明确审核渲染后的 Deployment 及其升级行为。
两种模式都使用 host networking、NET_ADMIN、必需的 host 反亲和性和首选的 AZ 反亲和性。该 chart 不会创建 Service、ServiceMonitor 或 PDB。Auto Mode 使用 maxSurge=1/maxUnavailable=0;其他节点使用 0/1。这两种策略都不感知 leader,也不能保证转发不间断。Auto Mode 的 surge 需要另一个符合条件的节点,因为配置了 host 反亲和性。
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
# Local rendering first; it does not prove API admission, IAM or network readiness.
helm template eks-hybrid-nodes-gateway \
  oci://public.ecr.aws/eks/eks-hybrid-nodes-gateway \
  --version 1.0.2 --namespace eks-hybrid-nodes-gateway \
  --values values.yaml > gateway-rendered.yaml
# Creates/changes cluster resources and can redirect existing VPC routes:
helm upgrade --install eks-hybrid-nodes-gateway \
  oci://public.ecr.aws/eks/eks-hybrid-nodes-gateway \
  --version 1.0.2 --namespace eks-hybrid-nodes-gateway --create-namespace \
  --kube-context "$KUBE_CONTEXT" --values values.yaml
步骤 4:验证安装
读取实际 Lease holder、Gateway Pod 所在节点/IP、VTEP 端点/MAC 和路由 ENI,并确认它们指向同一个 leader。holderIdentity 可能是节点主机名加 UUID,因此不要直接将它传给 kubectl logs 或 kubectl delete pod。
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
: "${AWS_REGION:?Set the reviewed AWS Region}"
: "${ROUTE_TABLE_ID:?Set one reviewed route table ID}"
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway \
  rollout status deployment/eks-hybrid-nodes-gateway --timeout=180s
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway get pods -o wide
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway   get lease hybrid-gateway-leader -o yaml
kubectl --context "$KUBE_CONTEXT" get ciliumvtepconfig hybrid-gateway -o yaml
aws ec2 describe-route-tables --region "$AWS_REGION" \
  --route-table-ids "$ROUTE_TABLE_ID" --query 'RouteTables[].Routes' --output json
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway logs \
  -l app.kubernetes.io/name=eks-hybrid-nodes-gateway --all-containers=true --tail=50
Pod 处于 Running 状态、就绪响应和 leader gauge 均不能证明转发成功。请从明确选择的云端和 Hybrid 工作负载测试两个方向、直接 Pod IP、包含 Hybrid 端点的 ClusterIP Service、实际 webhook 调用,以及返回流量。服务器必须确实在被测端口上监听。请妥善保管日志,并在分享前遮蔽敏感工作负载数据。
CNI 配置
在 Hybrid Nodes 上配置 Cilium VTEP
请使用 AWS 维护的 Cilium build。Gateway CNI 前提条件规定了分支版本最低要求:1.17.13-1、1.18.8-1 或 1.19.2-1;这些是功能最低版本,不代表建议降级或忽略分支支持。保留现有节点选择器、IPAM 范围和其他经过审核的 release values。
所需更改为 vtep.enabled=true 和 l7Proxy=false。运维中的 Cilium Ingress/Gateway API L7 配置不能在同一 Cilium 安装上启用。这并不禁止普通 HTTP 应用使用已路由的路径。不要认为 VXLAN 提供了加密,也不要仅因不相关的示例提到 WireGuard 就启用它;请验证具体受支持的数据路径/加密组合。
在 Hybrid Nodes 上验证 Cilium VTEP
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
: "${CILIUM_VERSION:?Choose an AWS-maintained Cilium version meeting the gateway minimum}"
# Apply to the existing reviewed Hybrid Cilium release during a maintenance window.
helm upgrade cilium oci://public.ecr.aws/eks/cilium/cilium \
  --version "$CILIUM_VERSION" --namespace kube-system \
  --kube-context "$KUBE_CONTEXT" --reuse-values \
  --set vtep.enabled=true --set l7Proxy=false
kubectl --context "$KUBE_CONTEXT" -n kube-system rollout restart daemonset/cilium
kubectl --context "$KUBE_CONTEXT" -n kube-system   rollout status daemonset/cilium --timeout=300s
kubectl --context "$KUBE_CONTEXT" -n kube-system get configmap cilium-config \
  -o jsonpath='{.data.enable-vtep}{"\n"}{.data.enable-l7-proxy}{"\n"}'
输出的两个 ConfigMap 值必须依次为 true 和 false。还要检查每个 Hybrid Node 上的 Cilium 健康状态以及控制器管理的 VTEP 对象。请使用所选 Cilium image 中附带的 CLI,并先查看其帮助,再依赖特定的 bpf vtep 命令;通过 DaemonSet 选择的单个 Pod 无法覆盖每个节点。
在云端节点上配置 VPC CNI
对于运行 AWS VPC CNI 的云端节点,必须将 Hybrid Pod CIDR 配置为 ClusterIP 流向 Hybrid 端点时的 SNAT 排除项。缺少此设置时,直接 Pod-IP 流量可能仍然正常,因此仅测试直接 IP 并不足够。保留其他排除项,并与附加组件配置所有者协调更改。
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
# MNG/self-managed cloud nodes using the aws-node DaemonSet:
kubectl --context "$KUBE_CONTEXT" -n kube-system get daemonset aws-node
# Preserve existing exclusions; use the complete reviewed CSV union, not just a new CIDR.
: "${SNAT_EXCLUDE_CIDRS:?Set existing exclusions plus all Hybrid Pod CIDRs}"
kubectl --context "$KUBE_CONTEXT" -n kube-system set env daemonset/aws-node \
  AWS_VPC_K8S_CNI_EXCLUDE_SNAT_CIDRS="$SNAT_EXCLUDE_CIDRS"
Auto Mode 使用内置网络,不需要配置 aws-node DaemonSet。不要安装或使用此 DaemonSet 方案替代其网络。请单独验证其受支持的 Hybrid Service 路径;在混合集群中,将 aws-node 设置应用于由该组件实际管理的云端节点。前缀委派/自定义网络是独立的设计选择,并非 Gateway 的前提条件。
CiliumVTEPConfig CRD 详情
控制器的 1.0.2 upsert 代码使用以下 API 结构。Gateway 拥有名为 hybrid-gateway 的对象;这并不意味着 Kubernetes 只允许集群中存在一个 CiliumVTEPConfig 对象。
# Illustrative controller-owned observation; do not apply over the running controller.
apiVersion: cilium.io/v2
kind: CiliumVTEPConfig
metadata:
  name: hybrid-gateway
spec:
  endpoints:
  - name: vpc-gateway
    tunnelEndpoint: "10.0.1.5"
    cidr: "10.0.0.0/16"
    mac: "82:36:6c:89:e6:ad"  # Read the actual leader VXLAN MAC.
Leader 发生变化时,会更新 tunnelEndpoint 和 mac。每个端点只有一个 cidr;配置多个 VPC 前缀时会生成多个条目。MAC 必须是实际 leader 的 VXLAN 接口 MAC,而不能是任意虚构的常量。请观察 Cilium 收敛和应用恢复情况,不要假设存在通用的 1–5 秒传播保证。该时间范围只是未经验证的旧示例,并非实测结果。
流量模式
了解流量如何经过 Gateway,对于排查问题和容量规划至关重要。本节跟踪了各主要通信模式下数据包在系统中的传输路径。历史图示使用单独的示例 Pod 范围 10.100.0.0/20;与安装示例合并使用前,请先核对所有实际 CIDR。
模式 1:VPC Pod 到 Hybrid Pod
这是最常见的模式——VPC 中的云端节点上运行的 Pod 需要与本地 Hybrid Node 上运行的 Pod 通信。
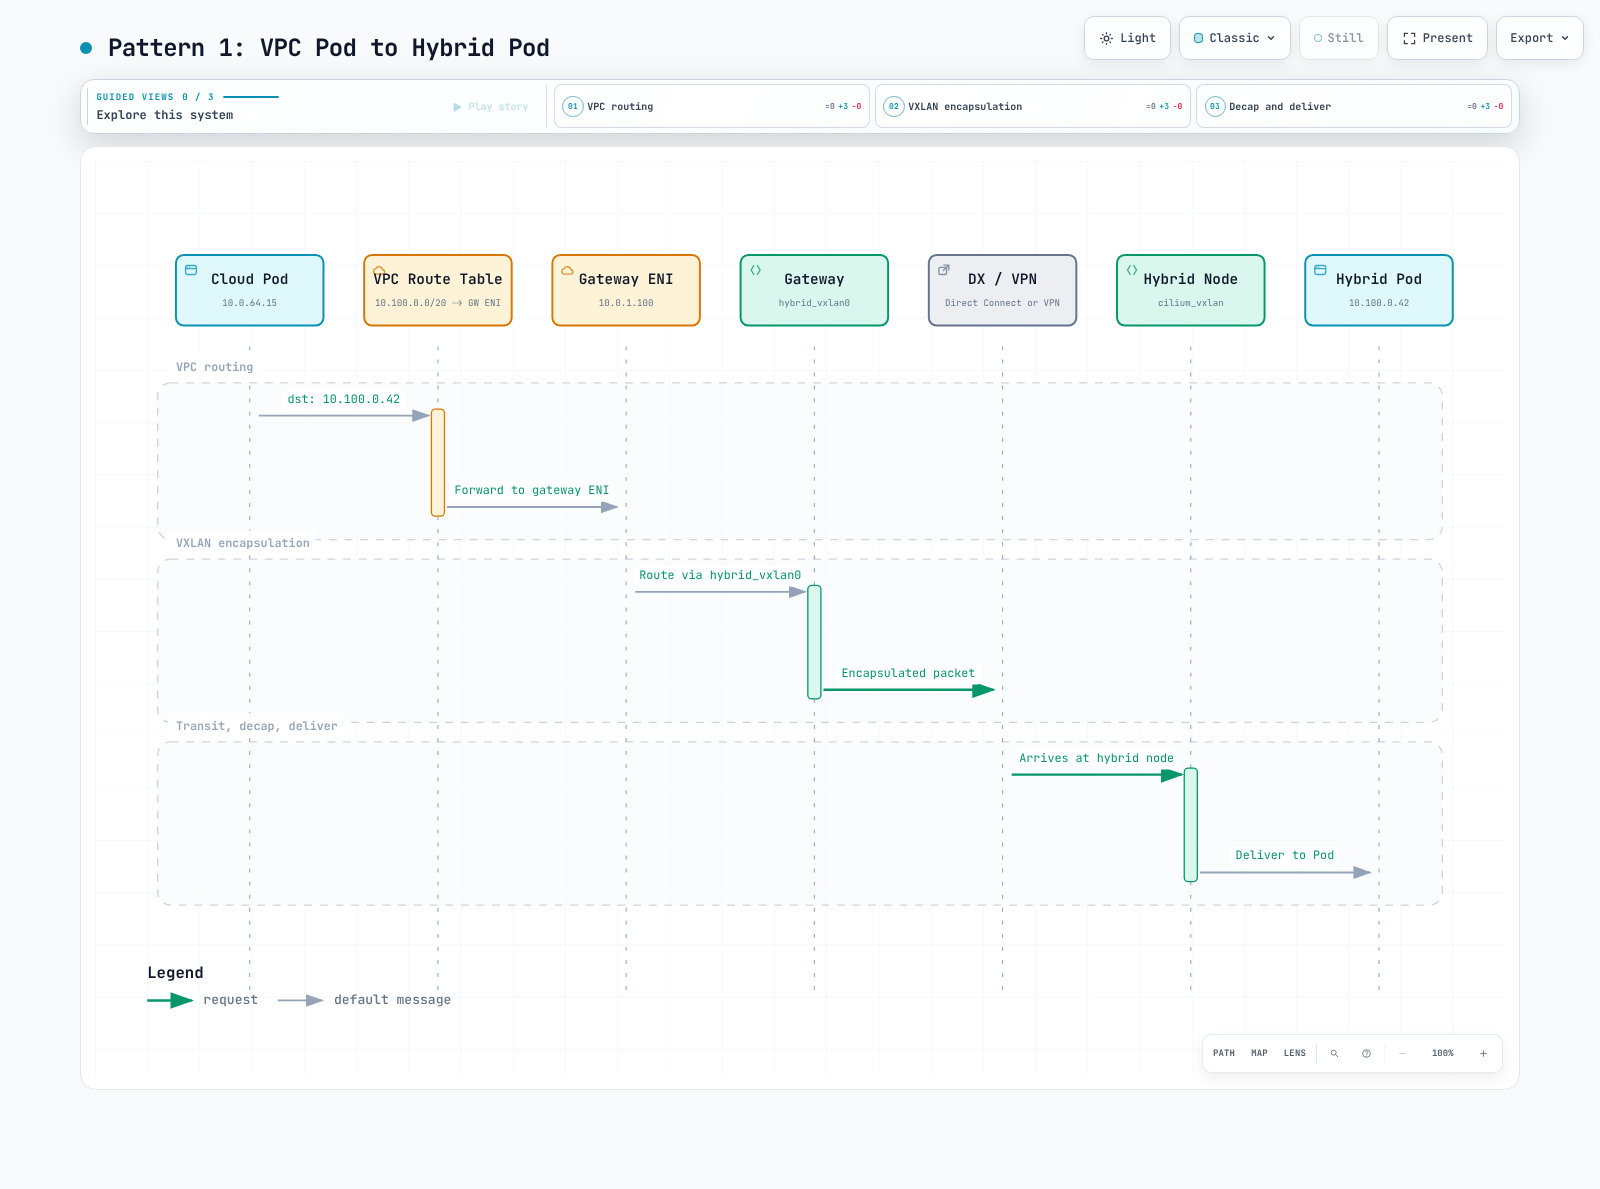
数据包流转步骤:
- 云端 Pod(
10.0.64.15)向 Hybrid Pod(10.100.0.42)发送数据包 - 数据包进入 VPC 网络;VPC 路由表将已配置的聚合路由匹配为
10.100.0.0/20 -> gateway ENI - 数据包到达 Gateway EC2 实例的主 ENI
- Gateway 的 Linux 路由表匹配路由:
10.100.0.0/24 via <hybrid-node-internal-ip> dev hybrid_vxlan0 onlink - Gateway 使用 VXLAN 封装数据包(外层源地址:Gateway IP,外层目标地址:Hybrid Node IP,VNI:2,外层 UDP 目标端口:8472)
- 封装后的数据包通过 Direct Connect/VPN 传输到本地网络
- Hybrid Node 上的 Cilium agent 在端口 8472 接收 UDP 数据包
- Cilium 解封装 VXLAN 数据包,并将内层数据包交付给目标 Pod
模式 2:Hybrid Pod 到 VPC Pod
当 Hybrid Node 上的 Pod 需要访问 VPC 中的 Pod(或任何 IP)时:
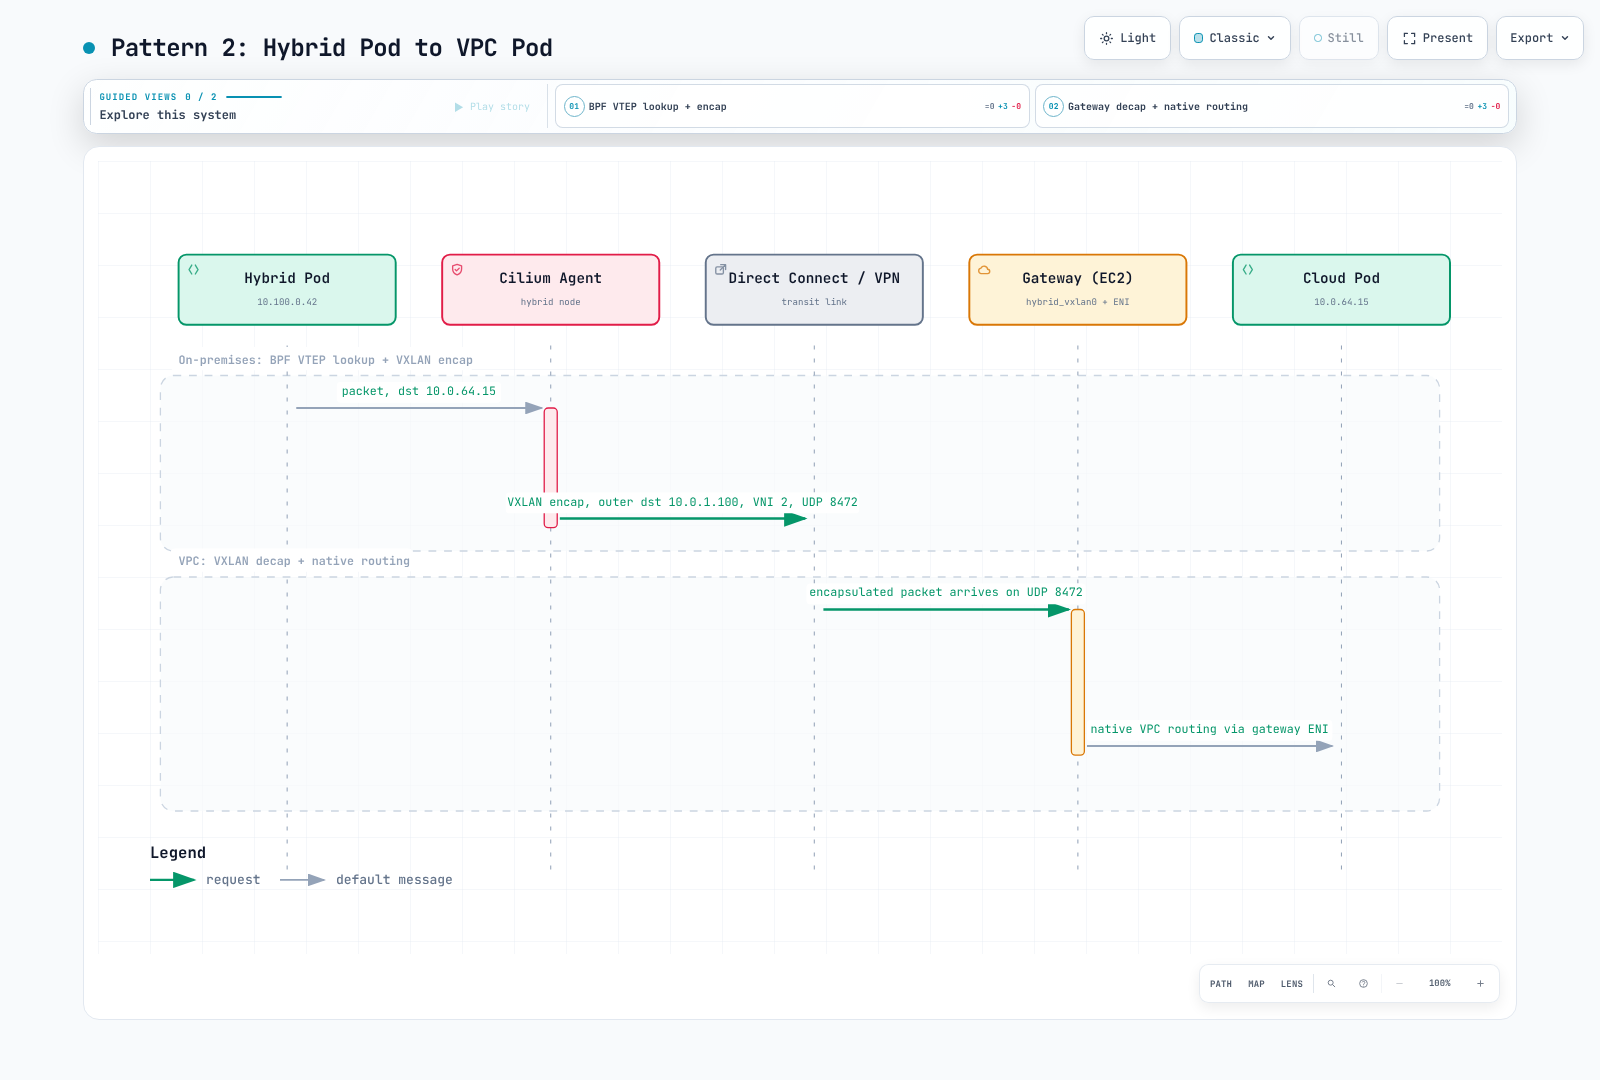
数据包流转步骤:
- Hybrid Pod(
10.100.0.42)向云端 Pod(10.0.64.15)发送数据包 - Hybrid Node 上的 Cilium agent 执行 BPF 查找,并发现
10.0.64.15与10.0.0.0/16的 VTEP 端点cidr匹配 - Cilium 使用 VXLAN 封装数据包(外层目标地址:Gateway IP
10.0.1.100,VNI:2,外层 UDP 目标端口:8472) - 封装后的数据包通过 Direct Connect/VPN 传输到 VPC
- Gateway 的 EC2 实例在端口 8472 接收 UDP 数据包
- Gateway 解封装 VXLAN 数据包,提取内层数据包(目标地址:
10.0.64.15) - 内层数据包通过 Gateway EC2 实例的 ENI 转发到 VPC
- 标准 VPC 路由将数据包交付给云端 Pod
必须由节点资源配置所有者禁用 Gateway 主 ENI 上的源/目标检查。请参见上文 Auto Mode 与托管/自行管理节点的不同要求;仅查看路由不能验证此设置。
模式 3:控制面到 Hybrid Node 上的 Webhook
当变更或验证 webhook 在 Hybrid Node 上运行时,EKS 控制面需要能够访问它。
Webhook invocation → resolved remote Pod endpoint
  → control-plane VPC network path / matching route table
  → gateway primary ENI → VXLAN → Hybrid node → webhook listener
  → verified reverse path for the response
已配置的远程 Pod 网络、控制面子网路由、webhook Service/endpoint/TLS、安全规则和返回路径都必须匹配。不要假设托管控制面内部采用 kube-proxy/iptables 实现。可路由的原生 Pod 设计也可支持 Hybrid webhook;此功能并非 Gateway 独有。
模式 4:AWS 服务到 Hybrid Pod
| 路径 | 所需配置 |
|---|---|
| ALB/NLB IP target | 通过指定的控制器注册符合条件的 Pod IP;验证 LB 子网路由、运行状况检查、应用端口、源身份和返回流量 |
| AMP 托管采集器 | Scraper 通过 VPC/远程 Pod 路由和开放的防火墙端口访问指标端点;Hybrid 附加组件指南还要求私有集群端点访问 |
| Prometheus remote_write | Prometheus/ADOT collector 将样本推送到 AMP workspace 的摄取端点;workspace 本身并不是入站 scraper |
| CloudWatch/trace 导出 | 正确配置的 agent/collector 将数据发送到其服务端点;所需 IAM/API/DNS/出站路径与入站 Pod 路由分开处理 |
| PrivateLink | Consumer endpoint → provider service/LB → targets,具体取决于服务设计;一般 AWS 服务不会通过 endpoint 向 Hybrid Pod 发起任意连接 |
Hybrid 附加组件指南明确支持在满足这些端点和网络前提条件时使用 AMP 托管采集。请区分该 scraper 与自行管理的 remote_write;仅安装 Gateway 不会自动提供这两种功能。
实测:Hybrid Pod 上的 ALB IP target(2026-10-18)
在模拟环境中测得(以另一个 VPC 中的 TGW 替代本地环境,Gateway 1.0.2、AWS Load Balancer Controller chart 3.6.0、内部 ALB)。这不是受支持的生产设置,数据也不构成保证。
| 检查项 | 结果 |
|---|---|
| Target 注册 | LBC 将 Hybrid Pod IP(172.17.0.202、172.17.0.48)注册为 ip target。它们位于 VPC 之外,因此 AvailabilityZone 为 all;运行状况检查通过 Gateway 路径 |
| 请求 | VPC client → 内部 ALB → VPC 路由 172.17.0.0/16(leader ENI)→ VXLAN → Hybrid Pod,20/20 |
| Pod 替换 | 在负载下执行 rollout restart;新 Pod IP 的 targets 在 54 秒内完成收敛,276 个请求中有 0 个失败(preStop 15 秒,注销延迟 10 秒) |
| Leader 切换 | 在负载下删除 Leader Pod;切换用时 4 秒,191 个请求中有 1 个失败(client 未启用重试) |
当 Pod IP 变化时,更新 target 的是 AWS Load Balancer Controller,而不是 Gateway。Gateway 只提供通往 VPC 外 Pod IP 的路径,因此 Pod CIDR 必须可从 VPC 路由到。安装期间,LBC 3.6.0 chart 的 kind: List 对象(IngressClassParams 和 IngressClass)未通过客户端 OpenAPI 验证,并报错 the server is currently unable to handle the request;使用 --disable-openapi-validation 可绕过此问题。如果将运行状况检查间隔降低到 5 秒,也应将超时时间设置为小于 5 秒,否则 target group 创建会失败。
模式 5:本地客户端访问 Region Pod(反向方向)
本地客户端通过负载均衡器进入,并访问 Region(VPC)节点上的 Pod。此方向的默认路径是 VPC 自身的路由,而不是 Gateway。
| 路径 | 行为 | 实测(2026-10-18) |
|---|---|---|
| 本地 → 内部 ALB → VPC CNI Pod | 本地 DNS 将 ALB 名称解析为私有 IP(Route 53 Resolver 入站端点);流量经 DX/VPN/TGW 进入 VPC,ALB 再转发到 VPC CNI Pod IP。不经过 Gateway | 20/20 |
| 本地 → 内部 ALB → Hybrid Pod | 路径相同,但增加了经 Gateway 返回本地环境的 hairpin 流量;两次经过 DX,增加延迟和传输成本 | 20/20 |
| 本地 → Hybrid NodePort → VPC CNI Pod | kube-proxy 将源地址 SNAT 为节点 IP,主机路由通过底层网络发送,因此不使用 Gateway(VTEP)。Region 节点安全组必须允许远程节点 CIDR 访问应用端口 | 失败(集群 SG 仅允许远程节点 CIDR 通过 443) |
AWS Ingress 指南建议,对于源自 Region 和本地环境的流量使用 Load Balancer Controller 提供的 ALB;对于源自本地环境的流量,则使用本地 Ingress。由于 Gateway 要求 Cilium 设置 l7Proxy=false,同一安装中不能使用 Cilium Ingress 和 Gateway API;对于本地入口流量,可以考虑使用 L4 LoadBalancer Service(Cilium LB IPAM/BGP)或现有硬件 LB 配合 NodePort。
模式 6:对比——使用和不使用 Gateway
原生/BGP/静态路由与此 Gateway 使用不同的路由数据路径和所有权机制。Gateway 增加了主动-备用 VXLAN 跳点和聚合路由自动化,同时仍需处理底层网络、CIDR、防火墙、IAM 和应用责任。下文的对比和迁移部分介绍了各自的边界;两种方案都不会自动保证 webhook/LB 可用性。
高可用性和故障转移
Deployment 架构
建议生产环境使用两个 Gateway 副本,并将其分布在不同的可用区:
故障转移流程
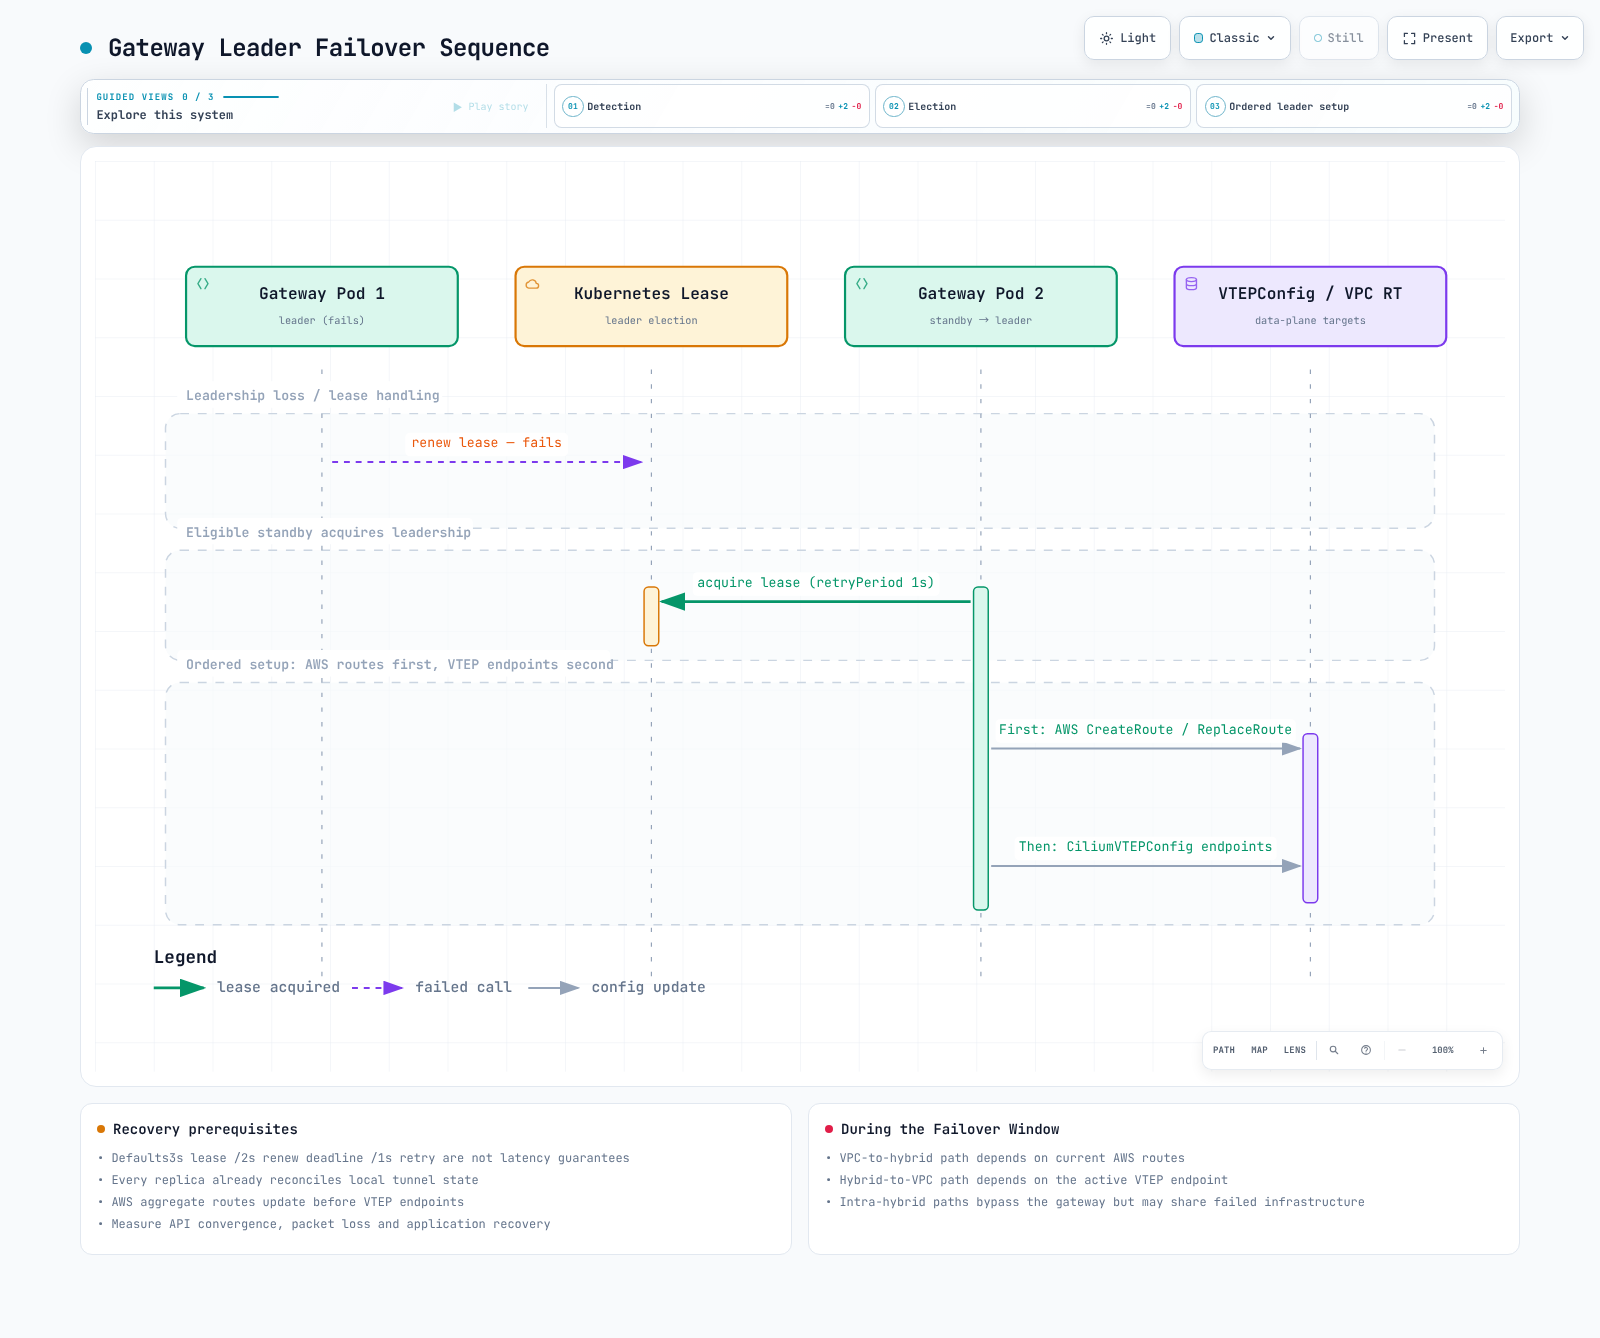
当 Gateway leader Pod 不可用时(节点故障、Pod 崩溃、网络分区),会发生以下故障转移流程:
故障转移时间线
**历史示例,并非实测证据:**下表原始数据没有可复现的测试跟踪记录。请将其视为背景信息,而不是 SLO。当前 AWS 指南估计约为 3–5 秒,而带标签的项目 README 中给出了不同的估算;实际恢复时间取决于路由/API/Cilium/应用收敛情况,必须经过测试。Leader 设置会先更新 VPC 路由,然后更新 VTEP 对象,而不是并行执行。节点、AZ 或控制面故障时,这些时间都不能保证恢复。
| 阶段 | 时长 | 说明 |
|---|---|---|
| 检测 | 0-3s | 当前 leader 续租失败;Lease 在 leaseDuration 后到期 |
| 选举 | 0-1s | 备用副本在下一个 retryPeriod 时钟周期获取 Lease |
| 路由更新 | 1-3s | 新 leader 调用 ec2:ReplaceRoute 更新 VPC 路由 |
| VTEP 更新 | 1-5s | 新 leader 更新 CiliumVTEPConfig;Cilium agent 重新加载 BPF map |
| 总计 | 约 5-10s | 端到端故障转移时间 |
在故障转移期间:
- VPC 到 Hybrid 流量:在 VPC 路由更新前丢失(数据包仍会发往故障 Gateway 的 ENI)
- Hybrid 到 VPC 流量:在 CiliumVTEPConfig 更新前丢失(Cilium 仍会将流量发送到旧 Gateway IP)
- Hybrid 内部以及节点/控制面路径:不经过 Gateway 的路径,只有在其自身的底层网络、CNI、DNS 和依赖项均正常时才能继续工作;共享 AZ/网络故障也可能影响这些路径。
单个 Gateway 故障和多个数据中心
Gateway(1.0.2)在每个集群中部署一组,且只有一个活动 leader。Leader 会在每个已配置路由表中为每个 CIDR 创建路由(podCIDRs 为 CSV);隧道条目则按 Hybrid CiliumNode 管理。只要每个 CIDR 都同时列在集群 remotePodNetworks 和 Gateway podCIDRs 中,不同 Pod CIDR 的数据中心(例如 DC A 10.85.0.0/16,DC B 10.86.0.0/16)就都可以由一个 Gateway 服务。这些范围不必连续。
| 项目 | 详情 |
|---|---|
| CIDR 数量 | 最多 15 个远程 Pod 网络 CIDR(EKS 限制)。每个 CIDR 会在每个路由表中增加一条路由,因此还需检查每个路由表的路由配额(默认 50) |
| 吞吐量 | 所有数据中心与 Hybrid Pod 之间的 VPC 流量都会经过一个 leader。主动/备用模式不会横向扩展;应按实例及其网络性能进行规划 |
| 防火墙 | 每个数据中心的 Hybrid Nodes 都必须能通过 UDP 8472 访问 leader 和备用节点 IP |
| 按数据中心拆分 | 文档未说明如何在一个集群中为每个数据中心运行单独的 Gateway。1.0.2 中 Lease(hybrid-gateway-leader)和 CiliumVTEPConfig(hybrid-gateway)名称固定,因此多个 release 可能发生冲突(尚未验证) |
如果只有一个 Gateway Pod,或两个 Pod 都发生故障,VPC 与所有数据中心 Hybrid Pod CIDR 之间的 Pod 流量都会同时中断。运行时不会调用 DeleteRoute,因此 VPC 路由会继续指向故障 ENI。
| 中断的路径 | 仍可运行的路径(前提是自身网络和 DNS 正常) |
|---|---|
| 双向 VPC Pod ↔ Hybrid Pod、Hybrid Pod 上的 webhook、Hybrid Pod 上的 ALB/NLB target、AMP scraper → Hybrid 端点 | 控制面 ↔ kubelet(节点 CIDR 路径)、单个数据中心内部的 Hybrid-to-Hybrid 流量、通过本地网络路由的数据中心间 Hybrid 流量、节点 IP 路径(NodePort、hostNetwork) |
因此,实际上必须有两个副本运行在不同 AZ 的合格节点上。如果同一个 Service 也有 VPC 中的 Pod,target group 中也会包含云端 target;Hybrid target 被运行状况检查剔除后,负载均衡器仍可能通过云端 target 响应请求(此组合未经实测)。
多 AZ 部署建议
Chart 1.0.2 要求副本位于不同主机上,但只优先考虑不同 AZ。应在不同 AZ 中选择/配置符合条件的节点,并检查实际放置情况;不要设置虚假的拓扑标签。此 chart 不会接入旧示例中的 affinity 和 topologySpreadConstraints values。如果需要严格的 AZ 限制,请维护经过审核的 Deployment overlay,并考虑在 AZ/容量不可用时 Pod 可能处于 Pending 状态。
Pod Disruption Budget
此可选 PDB 会通过 eviction API 限制自愿驱逐。它不会阻止直接删除 Pod、Deployment rollout 或意外故障,也不会根据身份保留活动 leader:
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: eks-hybrid-nodes-gateway
  namespace: eks-hybrid-nodes-gateway
spec:
  minAvailable: 1
  selector:
    matchLabels:
      app.kubernetes.io/name: eks-hybrid-nodes-gateway
Gateway 完全故障后的恢复
检查两个 Gateway Pod、符合条件的云端节点、Lease、路由目标和 VTEP 状态。区分 Gateway 故障与更广泛的底层网络/API/Cilium 中断。节点 IP 与控制面之间的现有连接是单独的路径;不要假设所有工作负载都能继续使用 DNS 或云依赖项。
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway get pods -o wide
kubectl --context "$KUBE_CONTEXT" get nodes -l hybrid-gateway-node=true -o wide
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway   get lease hybrid-gateway-leader -o yaml
kubectl --context "$KUBE_CONTEXT" get ciliumvtepconfig hybrid-gateway -o yaml
替换节点必须满足 IAM、主 ENI 转发、网络和 chart 放置要求后,才能添加标签。恢复领导权后,应重新检查 VPC 路由 ENI 和双向应用探测。Readiness/leader 指标本身不能作为验收标准。在已批准的维护窗口中执行破坏性故障转移演练,并确认 Pod/节点身份、流量探测和恢复负责人;不要根据 holderIdentity 盲目推断要删除哪个 Pod。
运维
监控
需要关注的关键指标
1.0.2 版本在端口 10080 上提供 /metrics,并在 8088 上提供 /healthz 和 /readyz。带标签的指标定义和采集器定义了以下名称/类型:
| 指标 | 类型 | 说明 |
|---|---|---|
hybrid_gateway_leader_is_active | Gauge | 此副本的 leader 状态;不能证明路由设置成功 |
hybrid_gateway_hybrid_nodes_configured | Gauge | 此副本本地配置的节点数 |
hybrid_gateway_vxlan_tx_bytes_total、hybrid_gateway_vxlan_rx_bytes_total | Counter | 内核接口字节计数器;应使用 rate,并考虑计数器重置 |
hybrid_gateway_vxlan_tx_packets_total、hybrid_gateway_vxlan_rx_packets_total | Counter | 数据包计数器,不代表应用成功 |
hybrid_gateway_vxlan_interface_up | Gauge | 接口状态,不代表端到端可达性 |
hybrid_gateway_vxlan_fdb_entries、hybrid_gateway_vxlan_route_count | Gauge | 本地观察到的表项计数 |
hybrid_gateway_aws_route_table_update_total、hybrid_gateway_aws_route_table_update_errors_total | Counter | 路由操作成功/错误事件 |
hybrid_gateway_aws_route_table_update_duration_seconds、hybrid_gateway_leader_setup_duration_seconds | Histogram | 时长观测值;没有事件时无法得出有用的延迟估算 |
即使某些文字说明表格将网络 _total 指标标记为 gauge,代码实际上也会将其作为 counter 输出。LeaderIsActive 会在路由/VTEP 设置完成前设为活动状态;readiness 也不是应用探测。应结合抓取健康状态和 API 错误,调查 leader 持续缺失/多重活动的情况;单个瞬时样本不能证明发生了 split-brain。
Prometheus ServiceMonitor
Chart 不会创建 Service。以下单独示例会创建 Service,并将 ServiceMonitor 绑定到其命名 Service 端口。Prometheus Operator/CRD、namespace 选择和实际的 serviceMonitorSelector 必须已配置。请将示例 release 标签替换为符合当前堆栈的值。使用节点/网络控制限制对 host-network 指标端口的访问。
apiVersion: v1
kind: Service
metadata:
  name: hybrid-gateway-metrics
  namespace: eks-hybrid-nodes-gateway
  labels:
    app.kubernetes.io/name: eks-hybrid-nodes-gateway
    app.kubernetes.io/instance: eks-hybrid-nodes-gateway
spec:
  selector:
    app.kubernetes.io/name: eks-hybrid-nodes-gateway
    app.kubernetes.io/instance: eks-hybrid-nodes-gateway
  ports:
  - name: metrics
    port: 10080
    targetPort: metrics
---
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: hybrid-gateway-metrics
  namespace: eks-hybrid-nodes-gateway
  labels:
    release: kube-prom  # Must match the existing Prometheus serviceMonitorSelector.
spec:
  namespaceSelector:
    matchNames: [eks-hybrid-nodes-gateway]
  selector:
    matchLabels:
      app.kubernetes.io/name: eks-hybrid-nodes-gateway
      app.kubernetes.io/instance: eks-hybrid-nodes-gateway
  endpoints:
  - port: metrics
    interval: 30s
    scrapeTimeout: 10s
    path: /metrics
Grafana Dashboard 查询示例
# Expected steady-state leader count, scoped to this one Service scrape job.
sum(hybrid_gateway_leader_is_active{namespace="eks-hybrid-nodes-gateway",service="hybrid-gateway-metrics"})

# Per-target VXLAN TX/RX byte rates; do not sum duplicate scrape jobs.
rate(hybrid_gateway_vxlan_tx_bytes_total{namespace="eks-hybrid-nodes-gateway",service="hybrid-gateway-metrics"}[5m])
rate(hybrid_gateway_vxlan_rx_bytes_total{namespace="eks-hybrid-nodes-gateway",service="hybrid-gateway-metrics"}[5m])

# Failures in the observation window, not a cumulative nonzero counter alert.
increase(hybrid_gateway_aws_route_table_update_errors_total{namespace="eks-hybrid-nodes-gateway",service="hybrid-gateway-metrics"}[5m])

# Per-replica local configuration counts; summing leader and standby double-counts nodes.
hybrid_gateway_hybrid_nodes_configured{namespace="eks-hybrid-nodes-gateway",service="hybrid-gateway-metrics"}

# Target scrape health is separate from leader/traffic metrics.
up{namespace="eks-hybrid-nodes-gateway",service="hybrid-gateway-metrics"}
缺少时间序列时,需要设置目标缺失/抓取告警;对空序列求和不会自动返回零。应根据实际部署确定告警窗口和预期节点数。流量下降可能意味着应用空闲,而非发生故障;发生过旧故障后,累计错误值仍会保持非零。
CloudWatch 集成
EC2 NetworkIn/NetworkOut 是实例级计数器,而不是仅针对 VXLAN 的 ENI 指标。若要在 CloudWatch 中使用自定义 Gateway 指标,首先要配置采集器,明确 namespace、维度、单位和累计计数器处理方式,然后验证已发布的样本。put-metric-alarm 命令不会创建其指标,也不能证明流量发生故障。设计告警时,应考虑导出器缺失、空闲时段和计数器重置。
日志记录
在内部收集有数量限制的日志,并将 API/权限错误保留为错误。标签选择器会选择两个副本,而不只是 leader。holderIdentity 不一定是 Pod 名称。1.0.2 中有用的消息包括 Processing CiliumNode、Adding hybrid node to gateway、Remote VTEP added 和 Reconciling CiliumVTEPConfig;对于运行时不会执行的 AWS DeleteRoute 操作,请查看实际结构化日志,而不要假定存在特定措辞。
启用调试日志
Chart 1.0.2 不会接入 logLevel=debug;该 Helm value 无法启用调试。请检查所选二进制支持的日志标志,并明确维护所需的 Deployment overlay。提高日志详细程度时,避免暴露凭证或工作负载负载数据。
故障排查
问题:Pod 无法通过 Gateway 通信
以下收集脚本在 API/日志查询失败时会停止运行。它不会将身份验证/传输错误标记为资源不存在。分享前,请检查并遮蔽私有数据。
#!/usr/bin/env bash
set -euo pipefail
umask 077
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
: "${AWS_REGION:?Set the reviewed AWS Region}"
: "${ROUTE_TABLE_ID:?Set one reviewed route table ID}"
OUT_DIR=$(mktemp -d "${TMPDIR:-/tmp}/gateway-diagnose.XXXXXX")
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway get pods -o json > "$OUT_DIR/pods.json"
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway \
  get lease hybrid-gateway-leader -o json > "$OUT_DIR/lease.json"
kubectl --context "$KUBE_CONTEXT" get ciliumvtepconfig hybrid-gateway -o json > "$OUT_DIR/vtep.json"
kubectl --context "$KUBE_CONTEXT" get ciliumnodes -o json > "$OUT_DIR/ciliumnodes.json"
aws ec2 describe-route-tables --region "$AWS_REGION" \
  --route-table-ids "$ROUTE_TABLE_ID" --output json > "$OUT_DIR/routes.json"
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway logs \
  -l app.kubernetes.io/name=eks-hybrid-nodes-gateway \
  --all-containers=true --prefix=true --tail=100 > "$OUT_DIR/gateway.log"
printf 'Private diagnostic files: %s\n' "$OUT_DIR"
对比实际 leader 的 Pod 节点/IP、VTEP IP/MAC、主 ENI 路由和 CiliumNode CIDR。检查完整的返回路径,以及 VTEP=true/L7=false 配置是否正确。若 map 缺失,不要盲目重启 Cilium;应先检查版本、配置和协调错误。
问题:安全组配置错误
UDP 没有连接握手。nc -uz 报告成功并不能证明 VXLAN 流量已到达或完成解封装。请使用范围受限且经过批准的抓包/计数器检查安全组、无状态 NACL、本地防火墙和底层网络两个方向。物理接口上的抓包过滤器可以看到外层 UDP8472;hybrid_vxlan0 上的抓包可以看到内层流量,因此在该接口上按外层 UDP8472 过滤可能会漏掉正在排查的流量。
问题:缺少 VPC 路由
确认已配置的路由表 ID、准确的 Pod 前缀、Gateway 主 ENI 和工作负载 IAM 身份。运维人员运行的 sts get-caller-identity 不能证明 Gateway SDK 使用的是哪个角色。DryRun 测试可能分别返回 DryRunOperation/UnauthorizedOperation,必须使用目标主体/参数;它并不代表路由更改成功。应检查实际主 ENI 上的源/目标检查,而不要只查看假定的节点属性。
问题:Leader 频繁切换
检查指定的 Lease、API 延迟/可达性、Gateway 节点健康状况和资源压力。失去领导权不代表另一个副本已经完成路由设置。Readiness handler 只是本地布尔状态检查。对 API server 执行未经身份验证的 wget 可能因 TLS/身份验证失败;这不能证明网络中断。
问题:MTU 问题
请使用确实包含 iproute2/iputils 的诊断 image/环境。BusyBox ping 并不一定支持 iputils 的 -M do 选项。请限制数据包数量和超时时间,并明确选择两个端点;还要记住,IPv4 ICMP 负载在封装前还需要 28 字节的 IP/ICMP 标头。ICMP 回复被阻止,不能作为 MTU 的确凿测量结果。比起仅从 EC2 NIC MTU 中减去 50,更重要的是包含 VPN/DX 封装开销在内的端到端最小底层网络 MTU。
故障排查决策树
- 确认两个控制面对象以及实际的云端/Hybrid 节点身份;保留 API 错误信息。
- 分别验证聚合路由所有权/目标和每个节点的本地 FDB/邻居/路由。
- 验证外层 UDP 可达性和主 ENI 上的源/目标检查。
- 验证 AWS Cilium 版本、VTEP/L7 设置和当前 VTEP 端点。
- 分别测试直接 Pod IP 和 ClusterIP,然后测试实际 webhook/LB 路径。
- 使用有限范围的诊断检查 MTU、丢包、应用监听器/TLS 和返回路由。
扩缩容
添加更多 Hybrid Nodes
每个 Gateway 副本都会将带标签的 CiliumNode 对象协调为本地隧道条目。Leader 获取领导权时会管理已配置的聚合 Pod CIDR 路由;它不会为每个新节点添加 AWS 路由。请验证新节点地址/CIDR,以及两个副本上的本地计数。吞吐量不能单凭节点数决定;增加副本只会提供备用容量,而不会实现主动-主动负载分配。
Gateway 实例规格选择
根据峰值字节速率、每秒数据包数、并发连接/隧道数、CPU、内存和故障冗余进行规格选择。Gateway 管理的流量在同一时间只会由一个副本转发。
**历史规格示例:**下表保留的是原始估算,并非经过测试的节点数限制或经过验证的吞吐量。请检查当前 EC2 规格;尤其是表中 c6in.2xlarge 的 50 Gbps 数据并非经过验证的持续性能规格。
| 实例类型 | vCPU | 内存 | 网络带宽 | 建议用途 |
|---|---|---|---|---|
| c6i.large | 2 | 4 GiB | 最高 12.5 Gbps | 开发/测试,少于 10 个 Hybrid Nodes |
| c6i.xlarge | 4 | 8 GiB | 最高 12.5 Gbps | 小型生产环境,10-50 个节点 |
| c6i.2xlarge | 8 | 16 GiB | 最高 12.5 Gbps | 中型生产环境,50-100 个节点 |
| c6i.4xlarge | 16 | 32 GiB | 最高 12.5 Gbps | 大型生产环境,100 个以上节点 |
| c6in.2xlarge | 8 | 16 GiB | 最高 50 Gbps | 高吞吐量工作负载 |
| c6in.4xlarge | 16 | 32 GiB | 最高 50 Gbps | 极高吞吐量 |
此表不保证容量。VXLAN 处理会消耗 CPU 和内存,EC2 突发/基准带宽、PPS 和流量路径限制也仍然适用。应根据实际实例和数据包类型进行验证,不要只依据公布的网络最大值进行选择。
Gateway 容量规划
以下原始计算保留为未实测的规划示例。其中 800 Mbps 使用十进制 KB/MB,并假设每个请求的两个方向各为 10 KB。如果 10 KB 已包含请求和响应,那么乘以 2 就重复计算了。数据包大小、标头、峰值并发和重试都需要单独考虑。此计算不能证明指定实例有足够的持续余量:
Throughput estimation:
======================
Number of hybrid Pods with cross-boundary traffic:   100
Average request/response size:                        10 KB
Average requests per second per Pod:                  50
VXLAN overhead per packet:                            ~3% (50 bytes / ~1500 bytes)

Required throughput:
  100 Pods × 50 req/s × 10 KB × 2 (bidirectional) = ~100 MB/s = ~800 Mbps

Recommendation: c6i.xlarge (12.5 Gbps) with comfortable headroom
升级 Gateway
请检查实际已发布的版本及其 chart/应用约定。本次审核验证了 1.0.2;此前的 1.1.0 命令只是未经验证的示例,并未执行升级。请私下备份自有 values/清单和路由清单,检查 Helm 历史,并选择准确的回滚修订版本,而不要假定修订版本 1 一定适用。
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
: "${GATEWAY_VERSION:?Set an existing, reviewed release version}"
helm history eks-hybrid-nodes-gateway -n eks-hybrid-nodes-gateway   --kube-context "$KUBE_CONTEXT"
# OCI charts are inspected/pulled by an explicit version, not helm search repo.
helm show chart oci://public.ecr.aws/eks/eks-hybrid-nodes-gateway   --version "$GATEWAY_VERSION"
helm template eks-hybrid-nodes-gateway \
  oci://public.ecr.aws/eks/eks-hybrid-nodes-gateway \
  --version "$GATEWAY_VERSION" --namespace eks-hybrid-nodes-gateway \
  --values values.yaml > gateway-upgrade-rendered.yaml
# Run only after reviewing the rendered diff, IAM, routes and rollback plan:
helm upgrade eks-hybrid-nodes-gateway \
  oci://public.ecr.aws/eks/eks-hybrid-nodes-gateway \
  --version "$GATEWAY_VERSION" --namespace eks-hybrid-nodes-gateway \
  --kube-context "$KUBE_CONTEXT" --values values.yaml
kubectl --context "$KUBE_CONTEXT" -n eks-hybrid-nodes-gateway \
  rollout status deployment/eks-hybrid-nodes-gateway --timeout=300s
Deployment 滚动更新不感知 leader:不能保证先替换备用副本。Chart 1.0.2 不会接入自定义 strategy value。Host 反亲和性/容量、Lease 变更以及路由/VTEP 收敛都可能导致流量中断。历史上的 5–10 秒和 40–55 秒示例并非升级 SLO。Helm 回滚还需要兼容 CRD/配置,并需验证应用/路由;它不会自动恢复所有外部 AWS 路由。
清理
**Helm 卸载后 AWS 路由仍会保留。**安装和删除前,请记录路由表、CIDR、先前目标和当前 Gateway ENI。先迁移/排空依赖 Gateway 的流量。修改控制器拥有的 VTEP 对象前,应先停止控制器,以免它重新创建该对象。
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
: "${AWS_REGION:?Set the reviewed AWS Region}"
: "${ROUTE_TABLE_ID:?Set one route table whose ownership was confirmed}"
# Snapshot/read current targets before deciding which routes to restore or delete.
aws ec2 describe-route-tables --region "$AWS_REGION"   --route-table-ids "$ROUTE_TABLE_ID" --output json
kubectl --context "$KUBE_CONTEXT" get ciliumvtepconfig hybrid-gateway -o yaml
# Disruptive: retire/migrate traffic and record the current leader/ENI before running.
helm uninstall eks-hybrid-nodes-gateway -n eks-hybrid-nodes-gateway   --kube-context "$KUBE_CONTEXT" --wait --timeout=180s
Gateway Pod 删除后,如果迁移计划要求恢复之前的路由目标,请予以恢复;只有路由表/CIDR/当前目标的所有权均符合退役计划时,才能删除路由。不要盲目删除所有已配置的 CIDR:其他所有者可能已经修改目标。每次已批准的更改后都要重新查询 AWS 状态,并区分访问/传输错误与资源不存在。
只有在确认没有其他使用者/控制器拥有该资源后,才能删除控制器管理的 ciliumvtepconfig/hybrid-gateway。通过记录在案的基础设施所有者移除此 release 的 Pod Identity association/role、指标资源和专用容量;Helm release 已卸载并不能证明这些计费资源已被删除。仅当 namespace 或节点标签由此部署独占,且其中没有其他工作负载时,才能删除。请验证最终的应用路径、路由、associations 和容量。
对比:使用和不使用 Gateway
功能对比
| 关注点 | 不使用此 Gateway 的可路由 Pod | Hybrid Nodes Gateway |
|---|---|---|
| 路由 | BGP/静态路由或其他自有自动化路径 | 聚合 VPC 路由以及 Cilium VTEP/本地隧道协调 |
| 设置 | 底层网络/路由器/CNI/地址规划 | 同样需要规划底层网络,此外还需要合格的 Gateway 节点、IAM、AWS Cilium VTEP/L7 配置和路由所有权 |
| Webhook 和 ALB/NLB IP target | 在路由、远程 Pod 网络、返回路径和安全规则均有效时可用 | 还需要这些应用/控制面前提条件;仅安装 Helm 无法实现这些条件 |
| CNI | 选择受支持的可路由 Pod 设计 | 需要禁用 L7 proxy 的 AWS 维护版 Cilium VTEP 集成 |
| 容量 | 实际路由器/链路/CNI/主机限制 | 一个活动 Gateway 的容量以及所有底层链路/路径限制 |
| 高可用性 | 自有网络/收敛设计 | 主动-备用 Lease 和路由/VTEP 收敛;可能暂时中断 |
| 成本 | 集群/Hybrid Nodes、连接、基础设施和运维费用 | 除上述费用外,还包括 Gateway EC2/存储、Gateway 节点使用 Auto Mode 时产生的 Auto Mode 费用,以及可能增加的跨 AZ 流量 |
| 移除 | 协调自有路由/资源 | Helm 不会删除外部 AWS 路由、IAM associations 或专用容量 |
何时使用 Gateway
如果 AWS Cilium/VTEP 配置和主动-备用跳点符合工作负载需求,并且能简化 Pod 路由所有权,则可以使用此 Gateway。它不会免除网络团队对私有节点可达性、MTU、CIDR、安全规则和故障恢复的责任。现有原生路由、不兼容的 CNI/L7 要求或不同的容量/故障域需求,可能更适合其他设计。没有任何一种方案能在延迟、可用性或成本方面普遍占优。
性能特征
**以下原始估算只是未实测的示例,并非当前基准测试结果。**原生路由也存在处理/排队延迟;VXLAN 的开销取决于数据包大小、CPU、链路限制和卸载行为。即使使用巨型帧,额外的跳点也可能产生影响。
| 指标 | 原始原生/BGP 示例 | 原始 VXLAN 示例 |
|---|---|---|
| 延迟开销 | 约 0 ms | 约 0.1–0.5 ms |
| 吞吐量 | DX/VPN 的完整带宽 | Min(Gateway 实例带宽,DX/VPN 带宽) |
| 数据包开销 | 此 overlay 为 0 字节 | IPv4 VXLAN 约 50 字节 |
| 抖动 | 取决于 DX/VPN | DX/VPN 加 VXLAN 处理 |
| PPS | 受网络限制 | 可能受 Gateway CPU 限制 |
吞吐量计算未考虑突发/基准性能、PPS、CPU 和应用限制;不要将其视为保证值。此前的 5–10 秒故障转移以及“低复杂度/一次安装”说法也需要结合上文的运维限制理解。
从手动路由迁移到 Gateway
- 私下记录准确的路由表/CIDR/当前目标所有权以及现有 BGP/静态路由/NAT/CNI 状态。规划回滚,并验证底层网络、防火墙和网络地址不重叠。
- 准备符合条件的 Gateway 节点、工作负载 IAM 和经过审核的 AWS Cilium VTEP/L7 配置。CNI 更改本身可能中断流量。
- 将控制器安装视为会更改路由的切换操作:其 leader 可能替换相同 CIDR 的现有路由。不要假设 CreateRoute 会简单失败并保留旧目标。
- 验证云端/Hybrid 直接 IP、ClusterIP、真实 webhook/LB 流量和两个方向的返回路径。协调其他路由控制器,避免它们相互覆盖。
- 仅退役所有权已确认的过时资源。Gateway 复用同一路由表/CIDR 后,不要删除所有手动/BGP 路由。
回滚需要停止 Gateway 控制器、恢复记录的先前目标,并恢复兼容的 Cilium/网络配置,然后重新验证流量。单靠 Helm 回滚/卸载不会撤销外部路由更改。更具体的路由是有意设计的路由,最长前缀会产生影响,不能作为通用冲突解决方案。
最佳实践
安全性
最小权限 IAM
使用上述四种运行时操作和精确限定范围的自有路由表 policy;将 DeleteRoute 留给经过批准的清理管理员。控制 Gateway values、ServiceAccount、节点标签和 Pod Identity associations 的访问权限。即使容器未标记为 privileged: true,host-network NET_ADMIN 仍属于特权基础设施访问权限。
安全组最佳实践
使用实际 Hybrid Node 私有 CIDR、预期应用端口以及具体的 API/DNS/指标路径。NACL 是无状态的:仅添加一条入站 UDP8472 允许规则并不能构成可正常工作的双向策略。请审核替换节点地址和所需的所有返回流量。
网络分段
Gateway 使用 host networking。普通 Pod NetworkPolicy 对 hostNetwork 流量的处理方式取决于具体实现,不能替代节点/ENI/防火墙控制。在实际工作负载端点应用受支持的 L3/L4 policy,并验证 NAT/封装后的源身份。CIDR 选择器无法识别 Kubernetes namespace。Cilium L7 规则与此 Gateway 所要求的 l7Proxy=false 配置冲突。
性能
Gateway 实例规格选择
根据持续带宽/突发配额、PPS、数据包大小、CPU/内存和故障余量选择规格。原先的“使用率超过 60% 时升级、低于 20% 时降配、高于 25 Gbps/最高 100 Gbps 时选择 c6in”等规则只是未经测量的经验法则,不是容量保证或当前实例系列规格。AWS 当前 Gateway 运维表列出的 c6in.2xlarge 为最高 40 Gbps;此前规格表中的 50 Gbps 仅作为未经验证的历史数据保留。
在一定时间间隔内对 EC2 NetworkIn/NetworkOut 使用 Sum 可得字节数;除以时间间隔可得字节/秒。这些实例指标包含其他流量,不能单独用于测量 VXLAN/应用吞吐量。不要将 Average/Maximum 数据点视为持续比特率保证。
延迟监控
请使用已批准且已安装 curl 的现有客户端工作负载;不要在探测启动时安装软件包,也不要假设 compute-type=ec2 会选择云端节点。目标必须确实在监听。请从每个明确选择的位置执行以下有界检查:先测试直接 Pod IP,再单独测试 ClusterIP/实际应用端点。time_total 包括 DNS、连接/TLS 和服务器处理时间;它并非单独的网络 RTT,也不是开销基准测试。
#!/usr/bin/env bash
set -euo pipefail
: "${KUBE_CONTEXT:?Set the reviewed Kubernetes context}"
: "${PROBE_NAMESPACE:?Set the approved probe namespace}"
: "${PROBE_CLIENT_POD:?Set an existing client Pod with curl installed}"
: "${PROBE_URL:?Set the actual listening application URL}"
# Select and inspect the client node first; run separately from cloud and Hybrid clients.
kubectl --context "$KUBE_CONTEXT" -n "$PROBE_NAMESPACE" get pod "$PROBE_CLIENT_POD" -o wide
for attempt in 1 2 3; do
  kubectl --context "$KUBE_CONTEXT" -n "$PROBE_NAMESPACE" exec "$PROBE_CLIENT_POD" -- \
  curl --fail --show-error --silent --connect-timeout 3 --max-time 10 \
  --output /dev/null --write-out 'http_code=%{http_code} total_seconds=%{time_total}\n' \
  "$PROBE_URL"
done
成本
Gateway 成本
Gateway 软件不收费。除常规集群/Hybrid Nodes 成本外,还应计算 EC2、存储、Auto Mode 管理费(仅限在 Auto Mode 上运行的 Gateway 节点)、跨 AZ 数据传输、私有连接和可观测性成本。“位于同一 VPC 内”并不意味着跨 AZ 传输免费。通过另一个 AZ 路由可能产生额外流量费用。虽然 Gateway 节点位于多个 AZ,但只有一个活动 leader,因此来自其他 AZ 的 Pod、ALB 或 scraper 的 Hybrid 流量会进入 leader 所在 AZ(AWS 运维指南)。对于高流量路径,可使用 Cilium BGP 直接路由 Pod CIDR,使流量从 Pod 所在 AZ 经 TGW/VGW 离开,并将 Gateway 用于 webhook 和低流量的 Pod-to-Pod 通信。
**历史估算,不是当前报价或实测节省金额:**以下原始价格/折扣没有可追溯的验证来源。这里只为提供背景信息;作出承诺前,请根据实际使用情况,使用定价页面、EC2 条款和数据传输路径,重新生成注明日期和区域的估算。
| 组件 | 原始的未经验证月度估算(us-west-2) | 备注 |
|---|---|---|
| 2x c6i.large(Gateway 实例) | 约 $124(每台 $0.085/小时) | 按需定价 |
| 2x c6i.large(1 年预留) | 约 $78 | RI 无预付费用 |
| 2x c6i.large(1 年 Savings Plan) | 约 $81 | Compute Savings Plan |
| EBS(20 GiB gp3 x 2) | 约 $3.20 | 最低存储量 |
| 数据传输(原始假设) | $0 | 作为通用规则并不正确;可能产生跨 AZ 费用 |
| 总计(按需) | 约 $127/月 | 适用于 2 个 Gateway 实例 |
成本优化提示
根据实测数据和备用/故障要求选择合适规格。应根据稳定使用情况和实际条款评估承诺折扣,而不是假设固定节省金额。根据明确的中断预算选择容量类型;不要因为有两个副本就认为 Spot 一定安全,也不要假设所有 Gateway 部署的中断容忍度相同。
与现有 Hybrid Nodes 功能集成
| 功能 | 必须满足的条件 |
|---|---|
| GPU 工作负载 | 网络可达性与驱动程序、设备插件和 GPU 工作负载支持是两个不同的问题 |
| 放置 | 为符合条件的节点应用标签/污点;选择器不会配置容量 |
| 受限网络 | 提供所需的私有/API/registry/DNS 路径;Hybrid Nodes 并未与 AWS/控制面依赖完全断开 |
| SSM/IAM Roles Anywhere | Hybrid 节点凭证与云端 Gateway 的工作负载角色相互独立 |
| nodeadm 生命周期 | 节点加入集群与 Gateway 隧道协调是不同的职责 |
| 网络策略 | 验证受支持的 L3/L4 行为和 host-network 例外;不支持笼统的 L7 功能 |
| Service 和 webhook | 验证 ClusterIP SNAT、路由、端点可达性和实际请求路径 |
| DNS | 混合节点类型需要适当的 DNS 配置;安装 Gateway 不会建立 DNS 可用性 |
每个 Gateway 部署仅属于一个 EKS 集群。若需从其他 VPC 访问,需要采用单独受支持的路由/安全/地址设计;不要认为单次 Helm release 会创建多集群或 Transit Gateway 路由。已配置的 VPC 前缀决定 VTEP 匹配范围,并不会自动创建 Internet 默认路由。即使 Gateway 不会创建底层连接,现有 DX/VPN 设置也可能需要调整 MTU、路由和防火墙。
参考资料
AWS 文档
- EKS Hybrid Nodes 概述
- EKS Hybrid Nodes 网络
- EKS Hybrid Nodes CNI 配置
- EKS Hybrid Nodes 故障排查
- VPC 路由表
- Gateway CNI 要求
开源项目
相关内部文档
< 上一页:裸机操作系统设置 | 目录 >