第 2 部分:存储类
本文档是 Amazon EKS 存储系列的第二部分,涵盖 FSx for Lustre、Amazon S3、快照、卷扩展和性能优化。
目录
Amazon FSx for Lustre
Amazon FSx for Lustre 是一种高性能文件系统,适用于高性能计算(HPC)、机器学习和大数据处理等计算密集型工作负载。Lustre 是一种并行分布式文件系统,可从数千个客户端同时访问,并提供高吞吐量和低延迟。
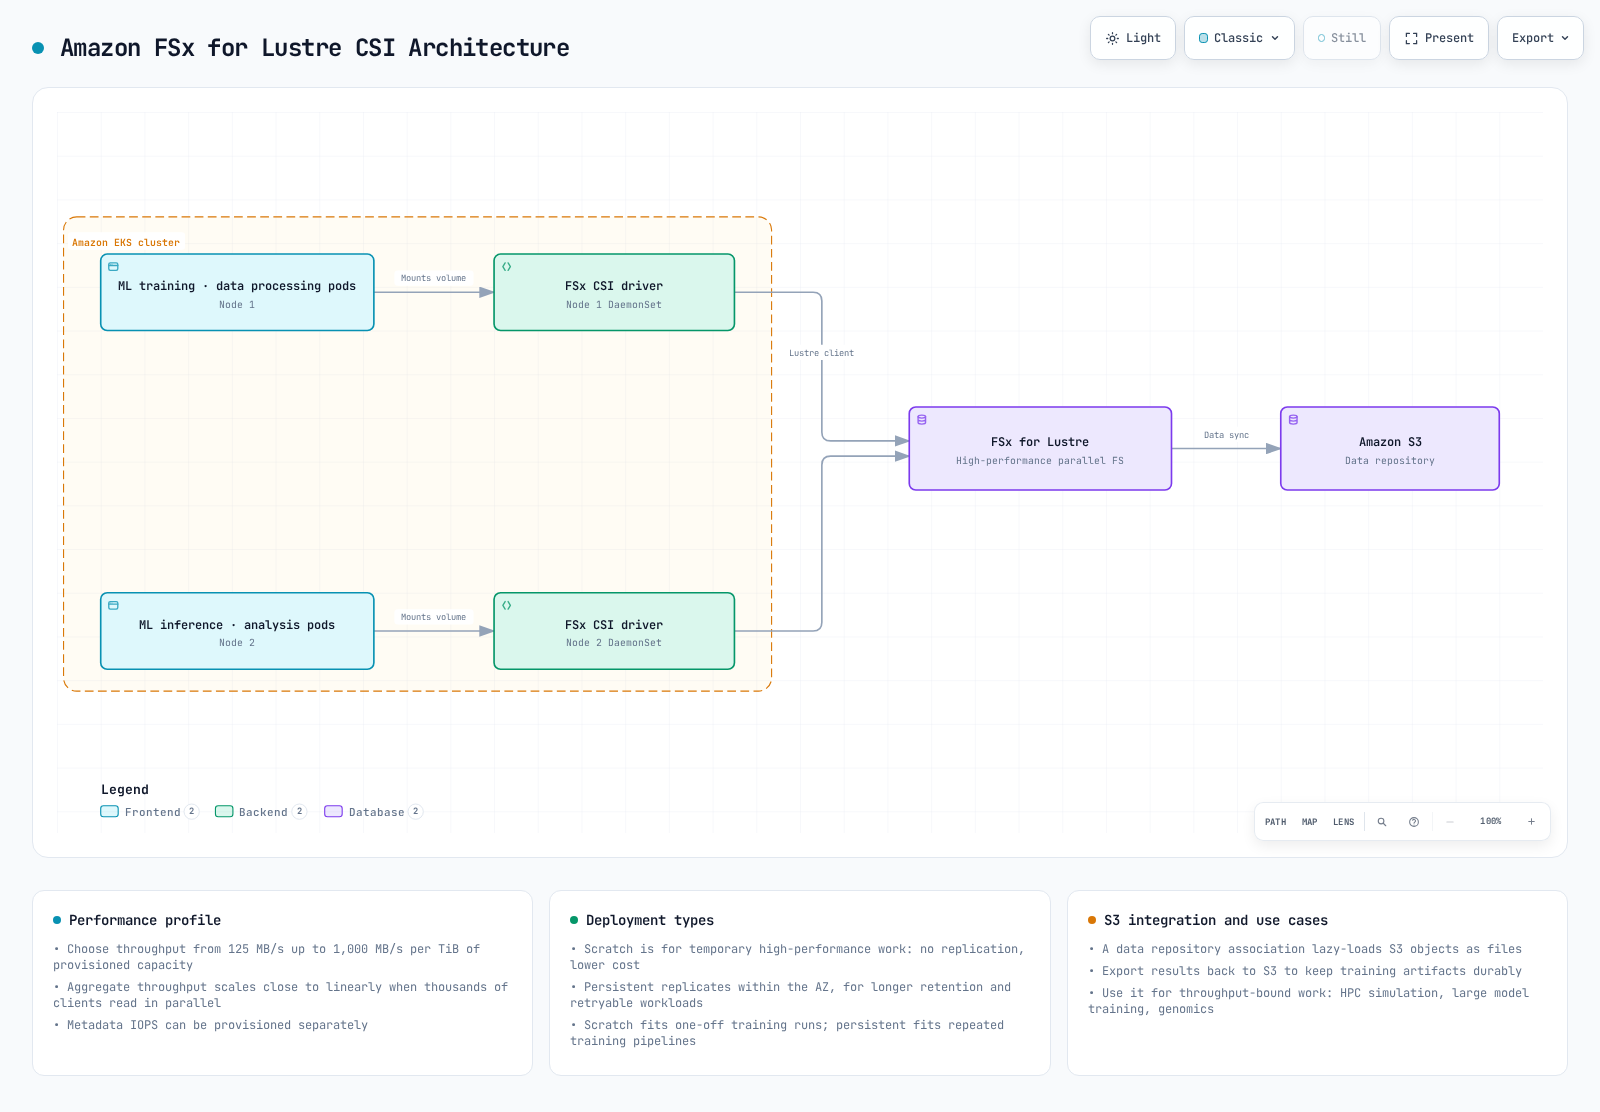
安装 FSx for Lustre CSI Driver
按照以下步骤安装 FSx for Lustre CSI driver:
- 创建 IAM role:
eksctl create iamserviceaccount \
  --name fsx-csi-controller-sa \
  --namespace kube-system \
  --cluster my-cluster \
  --attach-policy-arn arn:aws:iam::aws:policy/AmazonFSxFullAccess \
  --approve \
  --role-only \
--role-name AmazonEKS_FSx_Lustre_CSI_DriverRole- 使用 Helm 安装 driver:
helm repo add aws-fsx-csi-driver https://kubernetes-sigs.github.io/aws-fsx-csi-driver/
helm repo update
helm upgrade -i aws-fsx-csi-driver aws-fsx-csi-driver/aws-fsx-csi-driver \
  --namespace kube-system \
  --set controller.serviceAccount.create=false \
  --set controller.serviceAccount.name=fsx-csi-controller-sa
创建 FSx for Lustre 文件系统
您可以使用 AWS CLI 创建 FSx for Lustre 文件系统:
# Get VPC ID and subnet ID of EKS cluster
VPC_ID=$(aws eks describe-cluster \
  --name my-cluster \
  --query "cluster.resourcesVpcConfig.vpcId" \
  --output text)

SUBNET_ID=$(aws ec2 describe-subnets \
  --filters "Name=vpc-id,Values=$VPC_ID" \
  --query "Subnets[0].SubnetId" \
  --output text)

# Create security group
SECURITY_GROUP_ID=$(aws ec2 create-security-group \
  --group-name FsxLustreSecurityGroup \
  --description "Security group for FSx Lustre file system" \
  --vpc-id $VPC_ID \
  --output text)

# Allow Lustre traffic
aws ec2 authorize-security-group-ingress \
  --group-id $SECURITY_GROUP_ID \
  --protocol tcp \
  --port 988 \
  --cidr $VPC_CIDR

# Create FSx for Lustre file system
FILE_SYSTEM_ID=$(aws fsx create-file-system \
  --file-system-type LUSTRE \
  --storage-capacity 1200 \
  --subnet-ids $SUBNET_ID \
  --lustre-configuration DeploymentType=SCRATCH_2,PerUnitStorageThroughput=125 \
  --security-group-ids $SECURITY_GROUP_ID \
  --tags Key=Name,Value=MyLustreFileSystem \
  --query "FileSystem.FileSystemId" \
  --output text)
创建 FSx for Lustre StorageClass
创建使用 FSx for Lustre 的存储类:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fsx-lustre-sc
provisioner: fsx.csi.aws.com
parameters:
  deploymentType: SCRATCH_2
  storageCapacity: "1200"
  perUnitStorageThroughput: "125"
  automaticBackupRetentionDays: "0"
  dailyAutomaticBackupStartTime: "00:00"
  copyTagsToBackups: "false"
  dataCompressionType: "NONE"
  driveCacheType: "NONE"
  storageType: "SSD"
  mountName: "fsx-lustre-fs"
创建 PVC 并挂载到 Pod
- 创建 PVC:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: fsx-claim
spec:
  accessModes:
    - ReadWriteMany
  storageClassName: fsx-lustre-sc
  resources:
    requests:
storage: 1200Gi- 将 PVC 挂载到 Pod:
apiVersion: v1
kind: Pod
metadata:
  name: app-with-fsx
spec:
  containers:
  - name: app
    image: nvidia/cuda:11.6.0-base-ubuntu20.04
    command: ["sleep", "infinity"]
    volumeMounts:
    - mountPath: "/data"
      name: fsx-volume
  volumes:
  - name: fsx-volume
    persistentVolumeClaim:
      claimName: fsx-claim
FSx for Lustre 挂载的静态配置
您也可以静态挂载已创建的 FSx for Lustre 文件系统:
apiVersion: v1
kind: PersistentVolume
metadata:
  name: fsx-lustre-pv
spec:
  capacity:
    storage: 1200Gi
  volumeMode: Filesystem
  accessModes:
    - ReadWriteMany
  persistentVolumeReclaimPolicy: Retain
  storageClassName: fsx-lustre-sc
  csi:
    driver: fsx.csi.aws.com
    volumeHandle: fs-0123456789abcdef0
    volumeAttributes:
      dnsname: fs-0123456789abcdef0.fsx.us-west-2.amazonaws.com
      mountname: fsx
FSx for Lustre 部署类型
FSx for Lustre 提供多种部署类型,以满足不同工作负载的需求:
- Scratch 文件系统:
- Scratch 1:针对短期存储和处理进行成本优化的文件系统
- Scratch 2:比 Scratch 1 提供更高的突发吞吐量和更好的数据持久性
- Persistent 文件系统:
- Persistent 1:适用于长期存储和吞吐量关键型工作负载的文件系统
- Persistent 2:比 Persistent 1 提供更高的吞吐量
vLLM 的 FSx for Lustre 配置
考虑以下配置,以针对 vLLM(Vector Language Model)等大规模 AI 工作负载优化 FSx for Lustre:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fsx-lustre-vllm
provisioner: fsx.csi.aws.com
parameters:
  deploymentType: PERSISTENT_2
  storageCapacity: "4800"  # 4.8TB
  perUnitStorageThroughput: "1000"  # 1000 MB/s per TiB
  dataCompressionType: "LZ4"  # Enable data compression
  mountName: "vllm-models"
此配置具有以下优势:
- 高吞吐量可缩短模型加载时间
- 数据压缩可提高存储效率
- 多个节点可同时访问相同的模型文件
Amazon S3 存储集成
Amazon S3 是一种对象存储服务,可存储和检索无限量的数据。在 Kubernetes 中,S3 无法直接挂载为卷,但可通过多种方式与 S3 集成。
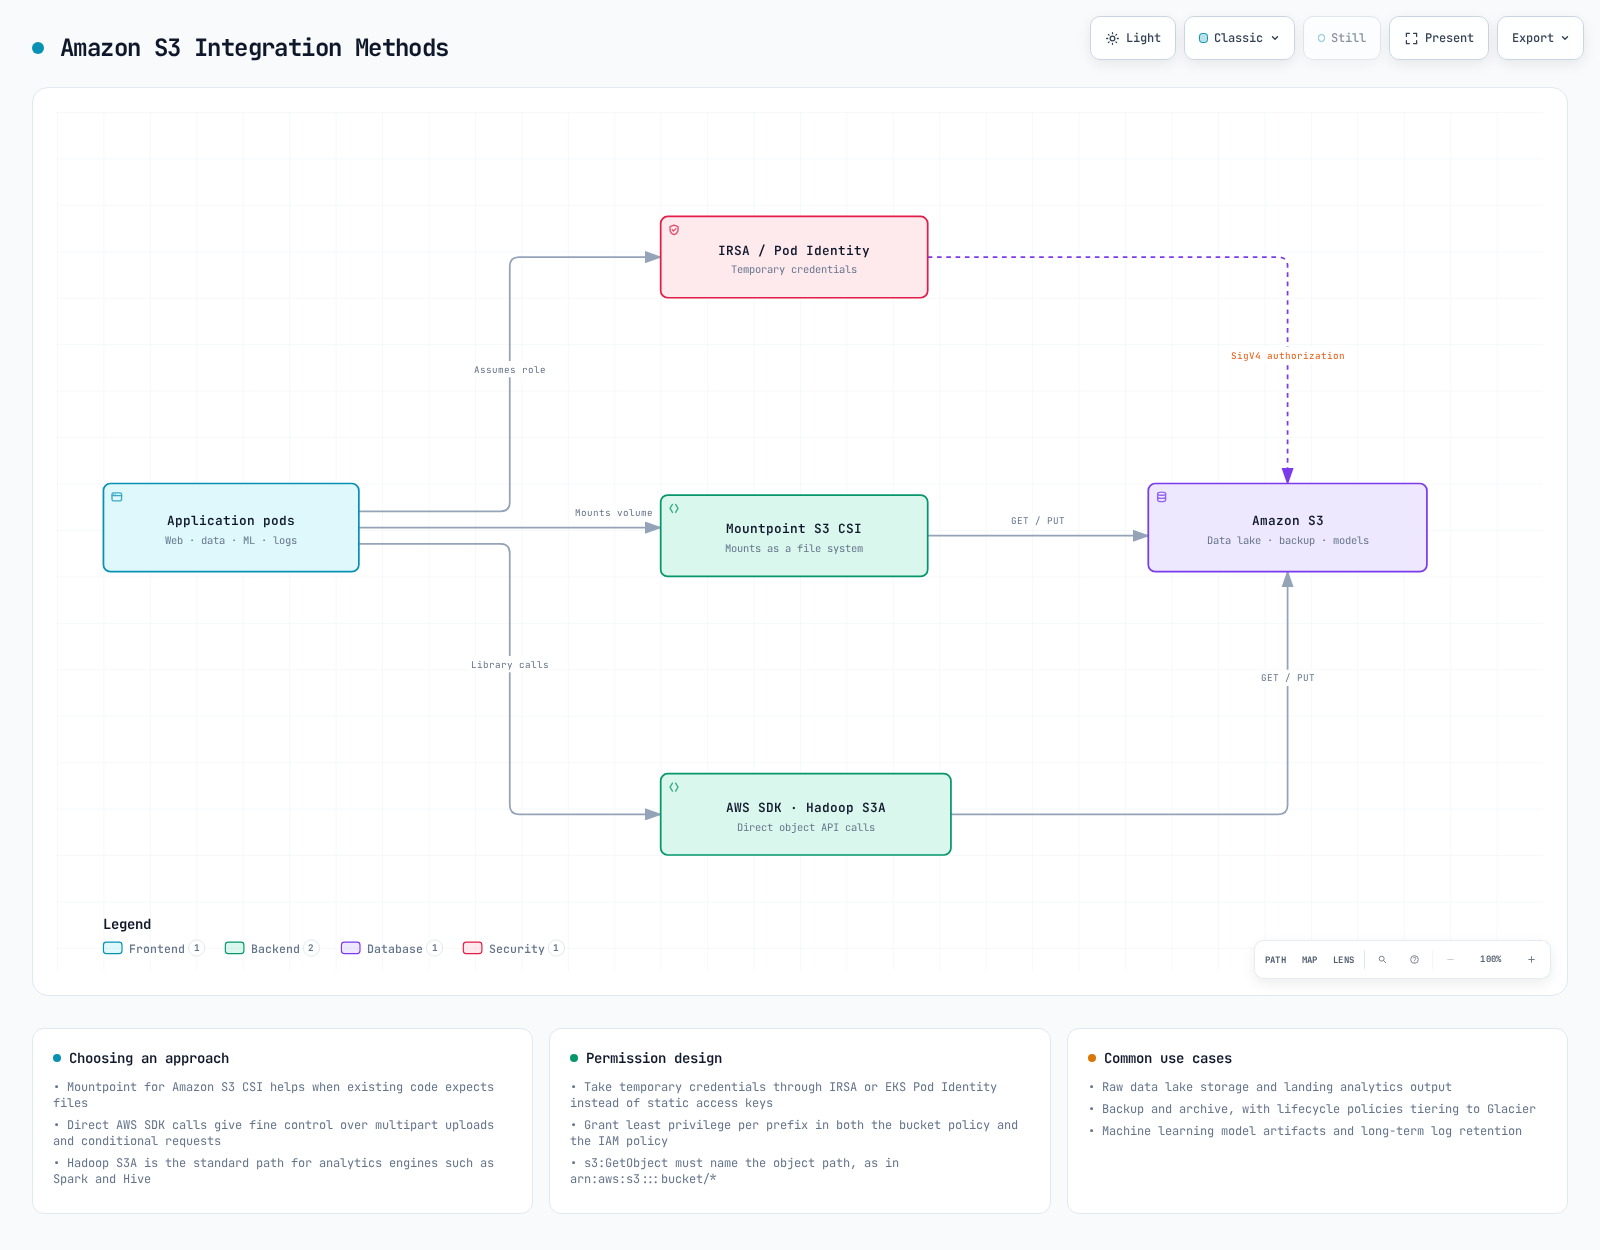
为 S3 访问设置 IRSA
设置 IAM Roles for Service Accounts(IRSA),让 Pod 可以访问 S3:
eksctl create iamserviceaccount \
  --name s3-access-sa \
  --namespace default \
  --cluster my-cluster \
  --attach-policy-arn arn:aws:iam::aws:policy/AmazonS3ReadOnlyAccess \
  --approve
用于 S3 访问的 Pod 配置
使用 Service Account 访问 S3 的 Pod:
apiVersion: v1
kind: Pod
metadata:
  name: s3-access-pod
spec:
  serviceAccountName: s3-access-sa
  containers:
  - name: app
    image: amazon/aws-cli:latest
    command: ["sleep", "infinity"]
S3A 文件系统挂载
您可以使用 Hadoop S3A 文件系统,以类似 HDFS 的方式访问 S3:
apiVersion: v1
kind: Pod
metadata:
  name: hadoop-s3a-pod
spec:
  serviceAccountName: s3-access-sa
  containers:
  - name: hadoop
    image: apache/hadoop:3.3.1
    env:
    - name: HADOOP_HOME
      value: /opt/hadoop
    - name: HADOOP_CONF_DIR
      value: /opt/hadoop/etc/hadoop
    - name: AWS_REGION
      value: us-west-2
    command: ["sleep", "infinity"]
    volumeMounts:
    - name: hadoop-config
      mountPath: /opt/hadoop/etc/hadoop
  volumes:
  - name: hadoop-config
    configMap:
      name: hadoop-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: hadoop-config
data:
  core-site.xml: |
    <?xml version="1.0" encoding="UTF-8"?>
    <configuration>
      <property>
        <name>fs.s3a.aws.credentials.provider</name>
        <value>com.amazonaws.auth.WebIdentityTokenCredentialsProvider</value>
      </property>
      <property>
        <name>fs.s3a.endpoint</name>
        <value>s3.us-west-2.amazonaws.com</value>
      </property>
    </configuration>
使用 CSI Driver 挂载 S3 Bucket
您可以使用 AWS S3 CSI driver 将 S3 bucket 挂载为 Kubernetes 卷:
- 安装 driver:
helm repo add aws-mountpoint-s3-csi-driver https://awslabs.github.io/mountpoint-s3-csi-driver
helm repo update
helm upgrade --install aws-mountpoint-s3-csi-driver aws-mountpoint-s3-csi-driver/aws-mountpoint-s3-csi-driver \
  --namespace kube-system \
  --set controller.serviceAccount.create=false \
--set controller.serviceAccount.name=s3-csi-controller-sa- 创建存储类:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: s3-sc
provisioner: s3.csi.aws.com
parameters:
  bucketName: my-eks-bucket
mountOptions: "--cache-control-max-ttl 0"- 创建 PVC 和 Pod:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: s3-claim
spec:
  accessModes:
    - ReadWriteMany
  storageClassName: s3-sc
  resources:
    requests:
      storage: 1Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: app-with-s3
spec:
  serviceAccountName: s3-access-sa
  containers:
  - name: app
    image: nginx
    volumeMounts:
    - mountPath: "/data"
      name: s3-volume
  volumes:
  - name: s3-volume
    persistentVolumeClaim:
      claimName: s3-claim
S3 使用场景
Amazon S3 适用于以下使用场景:
- 数据湖:用于大规模数据分析的中央存储库
- 备份和归档:长期数据保留
- 静态 Web 内容:提供图片、视频、文档等静态内容
- ML 模型存储库:存储已训练的模型文件
- 日志和审计数据:存储日志文件和审计数据
快照和备份
在 Kubernetes 中,您可以使用卷快照备份和恢复 PV 数据。
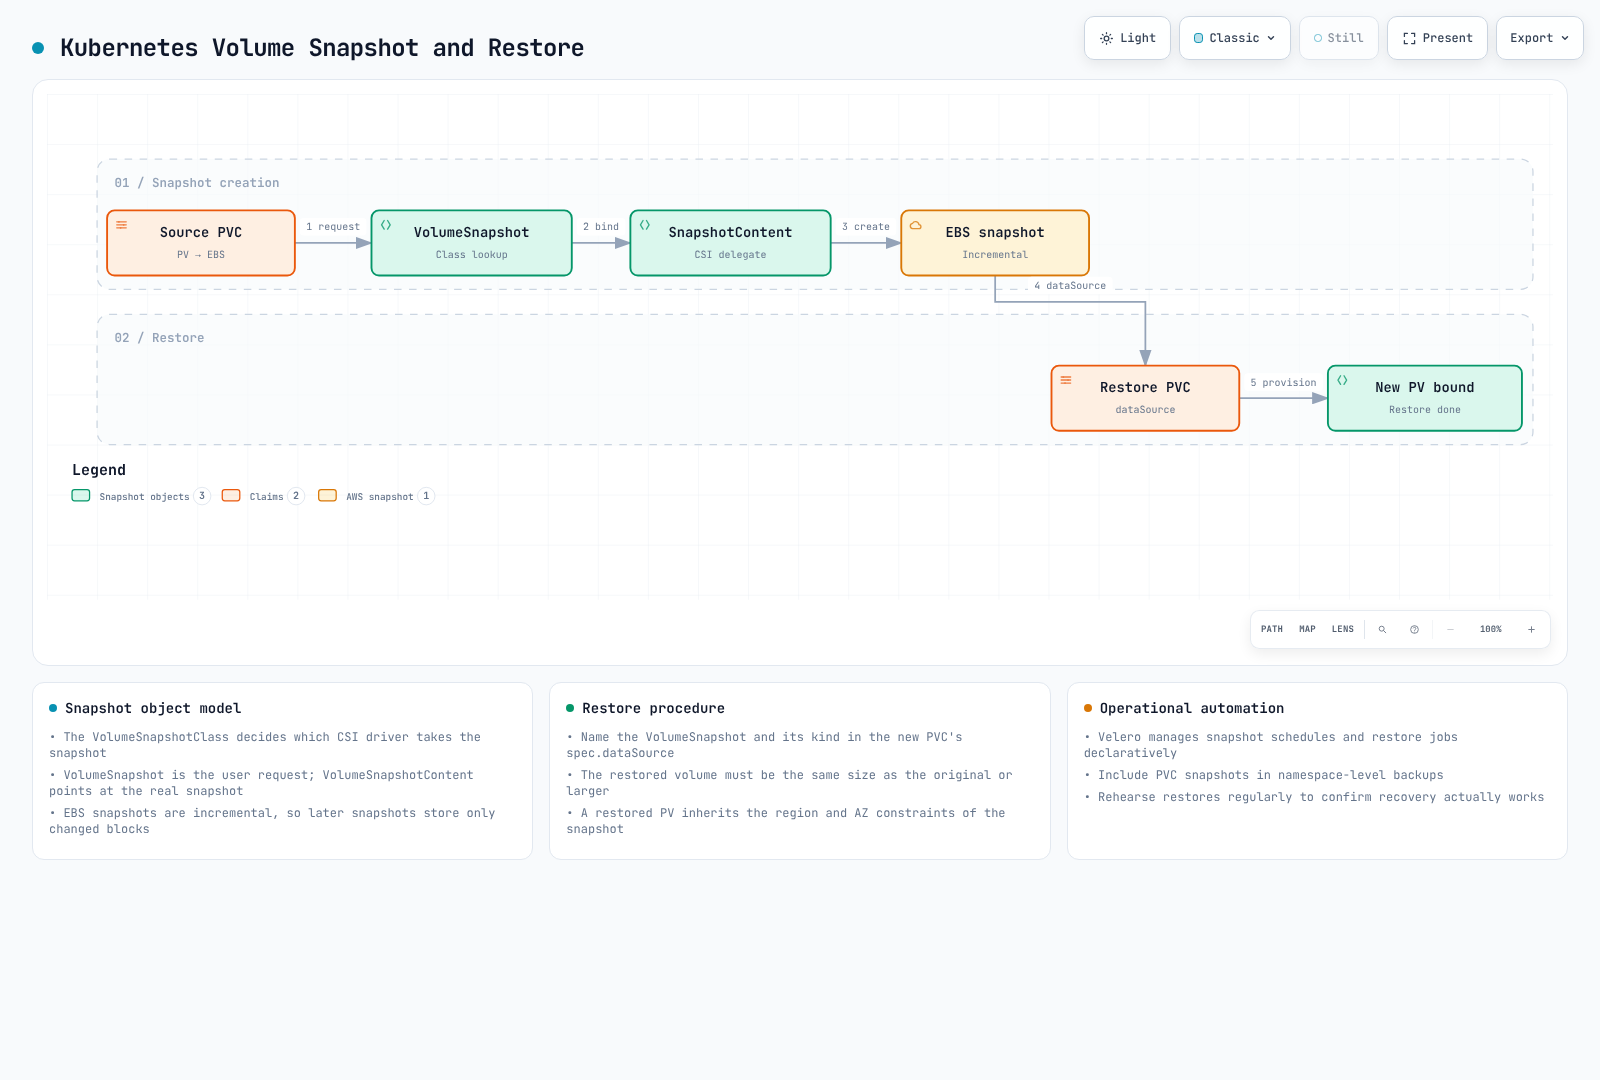
安装 Volume Snapshot Controller
安装 snapshot controller 以使用卷快照功能:
kubectl apply -f https://raw.githubusercontent.com/kubernetes-csi/external-snapshotter/master/client/config/crd/snapshot.storage.k8s.io_volumesnapshotclasses.yaml
kubectl apply -f https://raw.githubusercontent.com/kubernetes-csi/external-snapshotter/master/client/config/crd/snapshot.storage.k8s.io_volumesnapshotcontents.yaml
kubectl apply -f https://raw.githubusercontent.com/kubernetes-csi/external-snapshotter/master/client/config/crd/snapshot.storage.k8s.io_volumesnapshots.yaml

kubectl apply -f https://raw.githubusercontent.com/kubernetes-csi/external-snapshotter/master/deploy/kubernetes/snapshot-controller/rbac-snapshot-controller.yaml
kubectl apply -f https://raw.githubusercontent.com/kubernetes-csi/external-snapshotter/master/deploy/kubernetes/snapshot-controller/setup-snapshot-controller.yaml
创建 Volume Snapshot Class
为 EBS 卷创建 snapshot class:
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshotClass
metadata:
  name: ebs-snapshot-class
driver: ebs.csi.aws.com
deletionPolicy: Delete
parameters:
  csi.storage.k8s.io/snapshotter-secret-name: ""
  csi.storage.k8s.io/snapshotter-secret-namespace: ""
创建 Volume Snapshot
创建 PVC 的快照:
apiVersion: snapshot.storage.k8s.io/v1
kind: VolumeSnapshot
metadata:
  name: ebs-volume-snapshot
spec:
  volumeSnapshotClassName: ebs-snapshot-class
  source:
    persistentVolumeClaimName: ebs-claim
从快照恢复 PVC
从快照创建新的 PVC:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: ebs-claim-restored
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3
  resources:
    requests:
      storage: 10Gi
  dataSource:
    name: ebs-volume-snapshot
    kind: VolumeSnapshot
    apiGroup: snapshot.storage.k8s.io
自动创建定期快照
您可以使用 Velero 自动执行定期备份和恢复:
- 安装 Velero:
# Install Velero CLI
brew install velero

# Install Velero server
velero install \
  --provider aws \
  --plugins velero/velero-plugin-for-aws:v1.5.0 \
  --bucket velero-backup-bucket \
  --backup-location-config region=us-west-2 \
  --snapshot-location-config region=us-west-2 \
--secret-file ./credentials-velero- 创建备份计划:
velero schedule create daily-backup \
  --schedule="0 1 * * *" \
--include-namespaces=default,app-namespace- 恢复到特定时间点:
velero restore create --from-backup daily-backup-20250710010000卷扩展和调整大小
在 Kubernetes 中,您可以扩展 PVC 大小以增加存储容量。
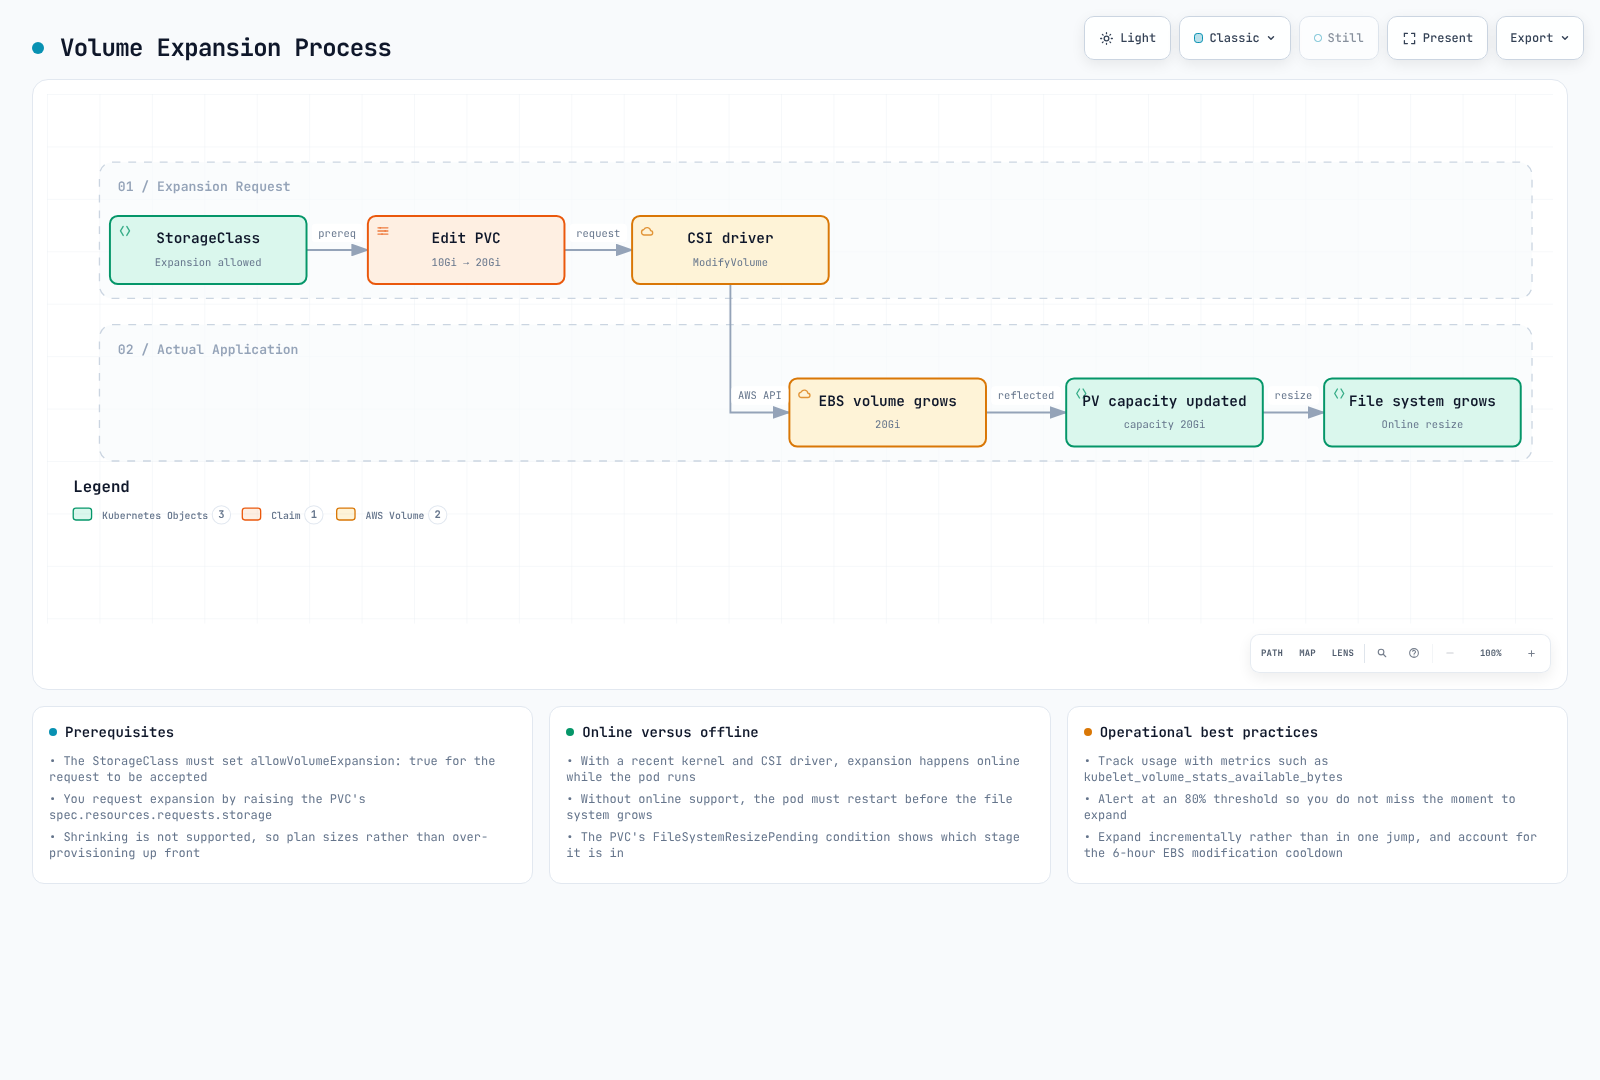
启用卷扩展
在存储类中启用卷扩展:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-gp3-expandable
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
allowVolumeExpansion: true
扩展 PVC 大小
扩展 PVC 大小:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: ebs-claim
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3-expandable
  resources:
    requests:
      storage: 20Gi  # Expanded from original 10Gi to 20Gi
文件系统扩展
卷扩展后,您可能需要扩展文件系统:
- 在线扩展(Pod 运行时):
- EBS CSI driver 会自动扩展文件系统。
- 离线扩展(需要手动扩展时):
- 连接到 Pod 并运行文件系统扩展命令:
# For ext4 file system
resize2fs /dev/xvdf

# For xfs file system
xfs_growfs /data
卷调整大小最佳实践
- 设置合适的初始大小:将初始卷大小设置得略大于所需容量
- 设置监控:监控卷使用情况并设置告警
- 逐步扩展:根据需要逐步扩展卷大小
- 规划停机时间:某些文件系统扩展可能需要停机时间
- 考虑自动化:实施自动扩展策略
卷克隆
卷克隆允许您从现有 PVC 创建新的 PVC,而无需经过快照流程。这对于创建测试环境、调试生产数据问题,或使用现有数据快速配置新工作负载非常有用。
EBS CSI 卷克隆概念
EBS CSI driver 支持使用 dataSource 字段进行 PVC 克隆。克隆卷时,CSI driver 会从源卷的快照创建新的 EBS 卷,但这一过程对用户是抽象的。
卷克隆的主要特性:
- 克隆独立于源 PVC
- 对克隆所做的更改不会影响源
- 除非另有指定,否则克隆会继承源的存储类
- 源和克隆必须位于同一 namespace
使用 dataSource 字段
要创建克隆,请在 dataSource 字段中指定源 PVC:
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: ebs-clone
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3
  resources:
    requests:
      storage: 10Gi
  dataSource:
    kind: PersistentVolumeClaim
    name: ebs-source-pvc
克隆与快照对比
| 功能 | 卷克隆 | 卷快照 |
|---|---|---|
| 创建速度 | 快速(单一步骤) | 两个步骤(创建快照,然后恢复) |
| 存储开销 | 立即完整复制 | 增量存储 |
| 跨 Namespace | 否 | 是(通过 VolumeSnapshotContent) |
| 时间点 | 克隆创建时 | 任意已保存的快照 |
| 使用场景 | 快速复制 | 备份和恢复 |
卷克隆 YAML 示例
克隆数据库卷的完整示例:
# Source PVC (existing)
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: postgres-data
  namespace: production
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3
  resources:
    requests:
      storage: 100Gi
---
# Clone for testing
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: postgres-data-test
  namespace: production
spec:
  accessModes:
    - ReadWriteOnce
  storageClassName: ebs-gp3
  resources:
    requests:
      storage: 100Gi
  dataSource:
    kind: PersistentVolumeClaim
    name: postgres-data
---
# Pod using the cloned volume
apiVersion: v1
kind: Pod
metadata:
  name: postgres-test
  namespace: production
spec:
  containers:
  - name: postgres
    image: postgres:15
    volumeMounts:
    - mountPath: /var/lib/postgresql/data
      name: postgres-storage
    env:
    - name: POSTGRES_PASSWORD
      value: testpassword
  volumes:
  - name: postgres-storage
    persistentVolumeClaim:
      claimName: postgres-data-test
Multi-Attach EBS
Multi-Attach 允许将单个 EBS 卷同时挂载到多个 EC2 实例。此功能适用于 io1 和 io2 Block Express 卷,适合需要高性能共享存储的集群应用程序。
io1/io2 Block Express 多重挂载
Multi-Attach 仅支持 Provisioned IOPS SSD 卷:
- io1:最多 16 个同时挂载
- io2 Block Express:最多 16 个同时挂载,且性能更高
要求:
- 实例必须与卷位于同一 Availability Zone
- 实例必须是基于 Nitro 的 EC2 实例
- 卷必须使用 Block 设备模式(而非 Filesystem 模式)
为什么不使用 ReadWriteMany?
EBS Multi-Attach 不以传统意义支持 ReadWriteMany 访问模式,原因如下:
- 必须使用 Block 模式:Multi-Attach 仅适用于原始块设备,不适用于已挂载的文件系统
- 没有文件系统协调机制:EBS 不提供文件系统级协调
- 应用程序责任:应用程序必须处理并发访问和数据完整性
Multi-Attach EBS 的 Kubernetes 访问模式是 ReadWriteOncePod,或者通过具有应用程序级协调机制的 Block volumeMode(如集群数据库或 OCFS2/GFS2)。
限制
- 仅限同一 AZ:所有已挂载的实例必须位于同一 Availability Zone
- 仅限 Block 模式:没有集群感知型文件系统时,不能作为共享文件系统使用
- Nitro 实例:仅支持基于 Nitro 的实例类型
- 不支持在线调整大小:挂载到多个实例时无法调整大小
- 应用程序协调:应用程序必须实现自己的锁定/协调机制
Multi-Attach 使用场景和 YAML 示例
常见使用场景:
- 集群数据库(Oracle RAC、SQL Server FCI)
- 具有共享状态的高可用应用程序
- 分布式存储系统
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-io2-multi-attach
provisioner: ebs.csi.aws.com
parameters:
  type: io2
  iops: "64000"
  multiAttachEnabled: "true"
volumeBindingMode: WaitForFirstConsumer
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: shared-block-pvc
spec:
  accessModes:
    - ReadWriteMany
  volumeMode: Block
  storageClassName: ebs-io2-multi-attach
  resources:
    requests:
      storage: 100Gi
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: clustered-app
spec:
  serviceName: clustered-app
  replicas: 2
  selector:
    matchLabels:
      app: clustered-app
  template:
    metadata:
      labels:
        app: clustered-app
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchLabels:
                app: clustered-app
            topologyKey: kubernetes.io/hostname
      containers:
      - name: app
        image: my-clustered-app:latest
        volumeDevices:
        - name: shared-block
          devicePath: /dev/xvda
      volumes:
      - name: shared-block
        persistentVolumeClaim:
          claimName: shared-block-pvc
Mountpoint for S3 CSI 深入解析
Mountpoint for Amazon S3 是一种文件客户端,可将文件系统操作转换为 S3 对象 API 调用,使应用程序能够通过类似 POSIX 的接口访问 S3 bucket。Mountpoint for S3 CSI driver 将此功能与 Kubernetes 集成。
性能特征
Mountpoint for S3 针对特定访问模式进行了优化:
顺序读取优化:
- 对大型顺序读取具有出色性能
- 针对可预测的访问模式自动预取
- 吞吐量随对象大小扩展
- 非常适合数据分析和 ML 训练工作负载
随机写入限制:
- S3 是对象存储,而不是块存储
- 随机写入需要重写整个对象
- 追加操作会创建新的对象版本
- 不适合数据库工作负载或需要随机 I/O 的应用程序
性能基准(近似值):
| 操作 | 性能 |
|---|---|
| 顺序读取(大文件) | 聚合最高可达 100 Gbps |
| 顺序写入(新文件) | 聚合最高可达 50 Gbps |
| 随机读取(小文件) | 更高延迟,更低吞吐量 |
| 随机写入 | 不推荐 |
限制
Mountpoint for S3 存在多项 POSIX 兼容性限制:
- 不支持硬链接:不支持硬链接
- 不支持符号链接:不支持符号链接
- 不支持 chmod/chown:文件创建后无法更改文件权限
- 不支持文件锁定:不提供建议锁和强制锁
- 不支持稀疏文件:不支持稀疏文件操作
- 不支持扩展属性:不支持 xattr 操作
- 最终一致性:列表操作可能不会立即反映最近的写入
- 不支持跨目录重命名:仅支持在同一目录内重命名
- 不支持追加到现有文件:必须重写整个对象
缓存设置
Mountpoint for S3 提供可提高性能的缓存选项:
元数据缓存:
parameters:
mountOptions: "--metadata-ttl 60" # Cache metadata for 60 seconds数据缓存(适用于读取密集型工作负载):
parameters:
  mountOptions: "--cache /tmp/s3-cache --max-cache-size 10737418240"  # 10GB cache
完整缓存配置示例:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: s3-cached
provisioner: s3.csi.aws.com
parameters:
  bucketName: my-ml-data-bucket
  mountOptions: |
    --metadata-ttl 300
    --cache /tmp/mountpoint-cache
    --max-cache-size 53687091200
    --read-part-size 8388608
    --prefetch-bytes 20971520
大型数据集训练场景示例
Mountpoint for S3 非常适合读取大型数据集的 ML 训练工作负载:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: s3-ml-training
provisioner: s3.csi.aws.com
parameters:
  bucketName: ml-training-datasets
  mountOptions: |
    --read-part-size 8388608
    --prefetch-bytes 52428800
    --metadata-ttl 3600
    --cache /tmp/s3-cache
    --max-cache-size 107374182400
---
apiVersion: v1
kind: PersistentVolumeClaim
metadata:
  name: training-data
spec:
  accessModes:
    - ReadOnlyMany
  storageClassName: s3-ml-training
  resources:
    requests:
      storage: 1Ti
---
apiVersion: batch/v1
kind: Job
metadata:
  name: ml-training-job
spec:
  parallelism: 4
  template:
    spec:
      serviceAccountName: ml-training-sa
      containers:
      - name: trainer
        image: pytorch/pytorch:2.0.1-cuda11.7-cudnn8-runtime
        resources:
          limits:
            nvidia.com/gpu: 1
            memory: 64Gi
          requests:
            memory: 32Gi
        command:
        - python
        - /app/train.py
        - --data-dir=/data
        - --epochs=100
        volumeMounts:
        - name: training-data
          mountPath: /data
          readOnly: true
        - name: model-output
          mountPath: /models
      volumes:
      - name: training-data
        persistentVolumeClaim:
          claimName: training-data
      - name: model-output
        persistentVolumeClaim:
          claimName: model-output-pvc
      restartPolicy: Never
      nodeSelector:
        node.kubernetes.io/instance-type: p4d.24xlarge
本示例中的关键优化:
- ReadOnlyMany 访问:多个训练 Pod 可同时读取
- 大规模预取:50MB 预取可降低读取延迟
- 本地缓存:为频繁访问的数据提供 100GB 缓存
- 合适的实例类型:具有高网络带宽的 GPU 实例
存储性能优化
让我们探索在 EKS 中优化存储性能的多种策略。
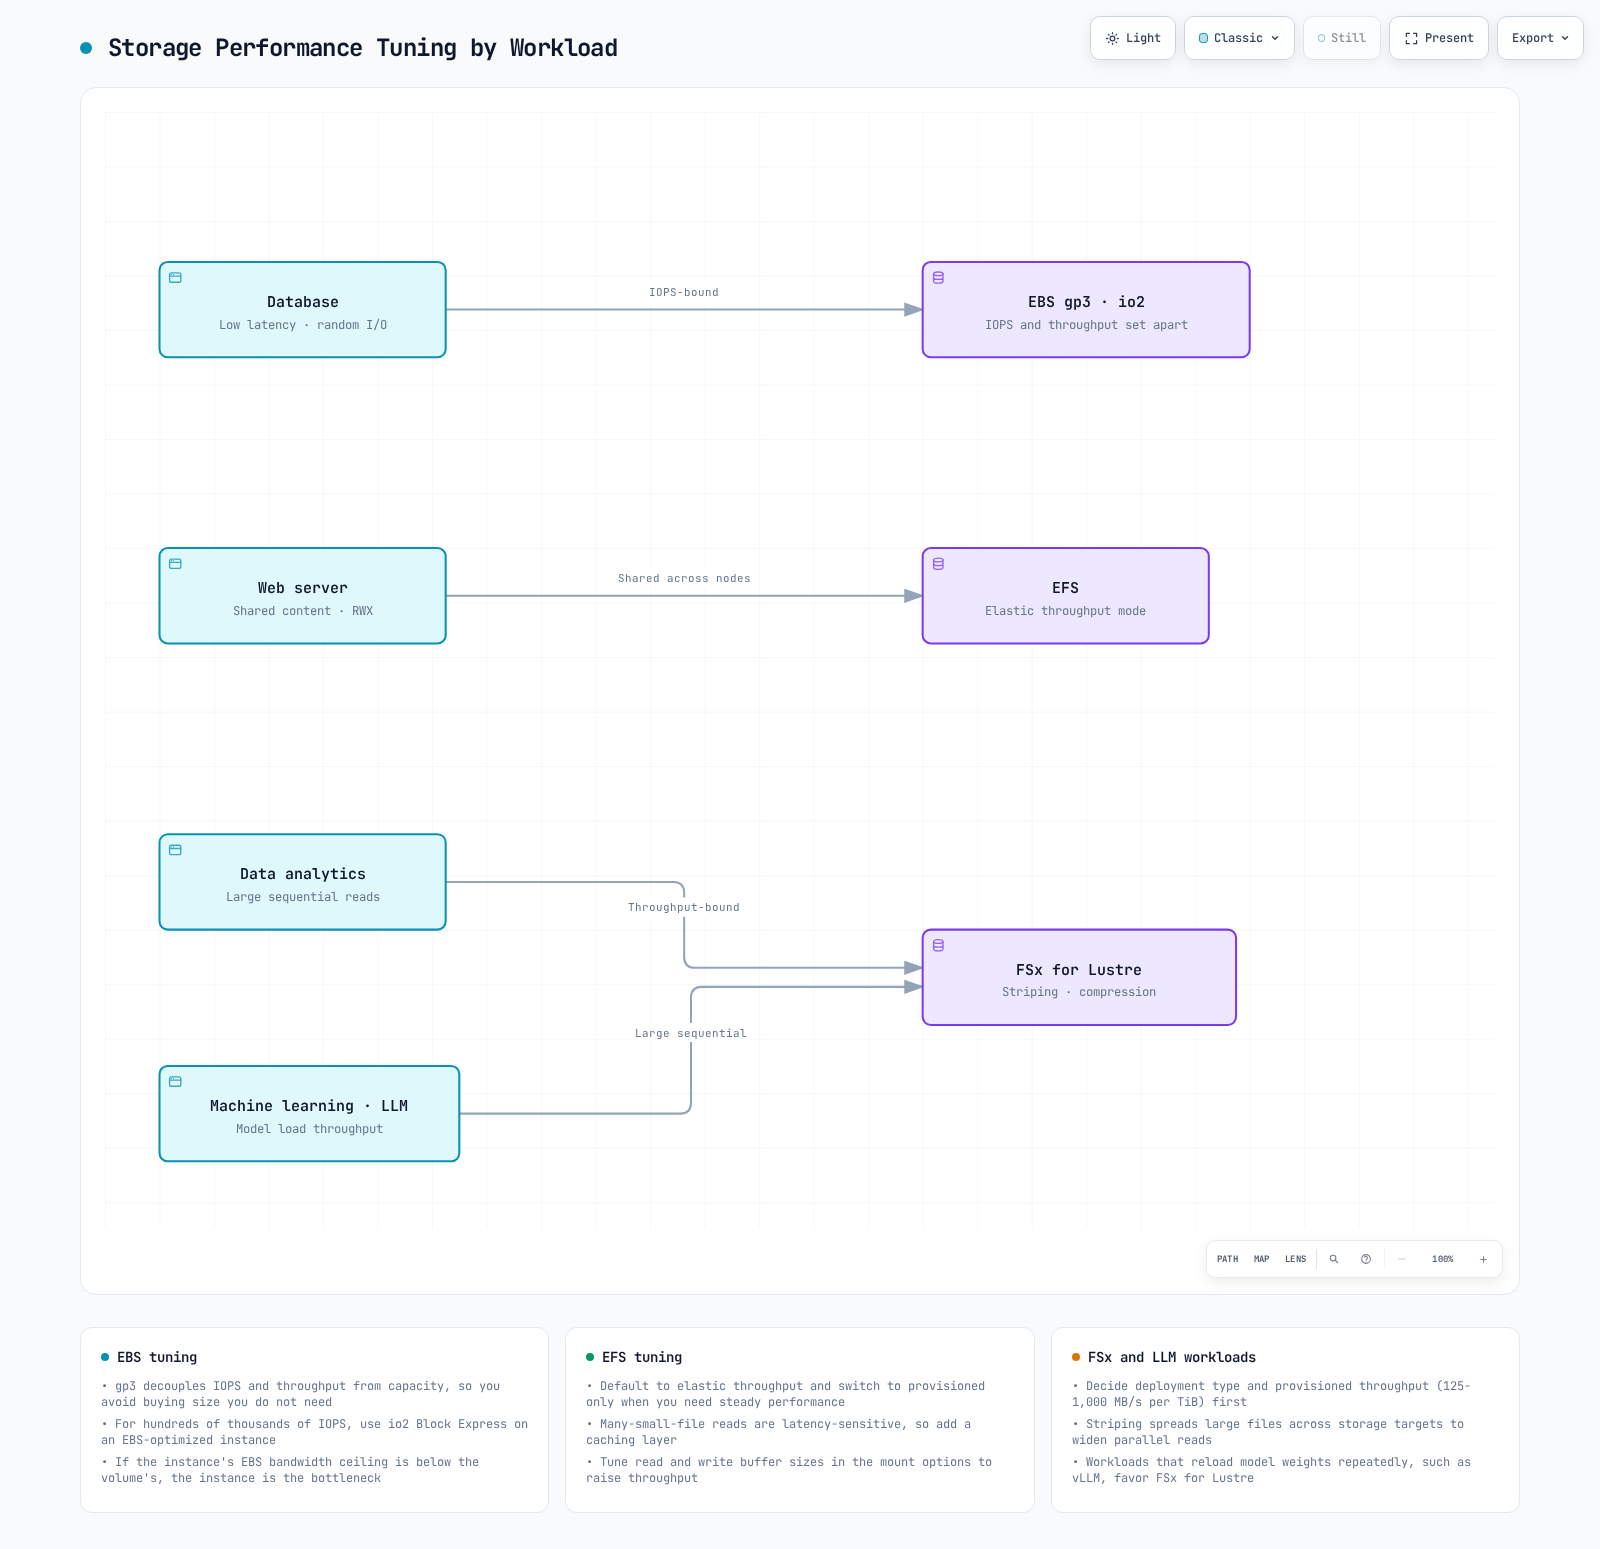
EBS 性能优化
- 选择合适的卷类型:
- 通用工作负载:gp3
- 高性能数据库:io2
- 以吞吐量为中心的工作负载:st1
- gp3 卷性能调优:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: ebs-gp3-high-perf
provisioner: ebs.csi.aws.com
parameters:
  type: gp3
  iops: "16000"  # Up to 16,000 IOPS
throughput: "1000" # Up to 1,000 MiB/s- 考虑实例类型:
- 使用 EBS 优化型实例
- 选择具有足够网络带宽的实例
- 卷初始化:
- 考虑在使用新卷前对其进行初始化:
dd if=/dev/zero of=/dev/xvdf bs=1M count=1000 oflag=directEFS 性能优化
- 选择合适的性能模式:
- 大多数工作负载:General Purpose 模式
- 高并发工作负载:Max I/O 模式
- 选择吞吐量模式:
- 可预测的工作负载:预置吞吐量
- 可变工作负载:Bursting 或 Elastic 吞吐量
- 优化访问模式:
- 大文件操作:使用较大的 I/O 大小
- 并行访问:使用多个线程或进程
- 优化挂载选项:
apiVersion: v1
kind: Pod
metadata:
  name: efs-app
spec:
  containers:
  - name: app
    image: nginx
    volumeMounts:
    - mountPath: "/data"
      name: efs-volume
  volumes:
  - name: efs-volume
    persistentVolumeClaim:
      claimName: efs-claim
    mountOptions:
      - nfsvers=4.1
      - rsize=1048576
      - wsize=1048576
      - timeo=600
      - retrans=2
      - noresvport
FSx for Lustre 性能优化
- 选择合适的部署类型和吞吐量:
- 高吞吐量要求:PERSISTENT_2 + 高吞吐量
- 经济高效的临时工作负载:SCRATCH_2
- 优化条带化:
- 大文件:跨多个 OST(Object Storage Targets)进行条带化
- 小文件:存储在单个 OST 上
- 客户端挂载选项:
mountOptions:
  - flock
  - noatime
- relatime- 启用数据压缩:
parameters:
  dataCompressionType: "LZ4"
vLLM 工作负载的存储优化
针对 vLLM 等大语言模型工作负载的存储优化:
- 使用 FSx for Lustre:
- 高吞吐量可缩短模型加载时间
- 多个节点可同时访问相同的模型文件
- 最佳配置:
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fsx-lustre-vllm
provisioner: fsx.csi.aws.com
parameters:
  deploymentType: PERSISTENT_2
  storageCapacity: "4800"  # 4.8TB
  perUnitStorageThroughput: "1000"  # 1000 MB/s per TiB
dataCompressionType: "LZ4" # Enable data compression- 模型文件优化:
- 将模型文件预加载到内存中
- 考虑模型量化
- 实现模型分片
- 节点实例类型选择:
- 选择具有足够内存和网络带宽的实例
- 考虑为 GPU 实例提供 EFA(Elastic Fabric Adapter)支持
结论
本文档介绍了 Amazon EKS 中的 FSx for Lustre、S3、快照、卷扩展和性能优化。每个存储选项都有不同的特性和使用场景,因此请务必根据您的应用程序需求选择并优化合适的存储解决方案。
下一部分将介绍 EKS 存储的监控、故障排除、成本优化和安全性。
参考资料
- Amazon FSx for Lustre CSI Driver
- Amazon S3 CSI Driver
- Kubernetes Volume Snapshots
- Velero Backup and Restore
- Amazon EKS Storage Best Practices
测验
要测试您在本章中学到的内容,请尝试主题测验。