第 4 部分:负载测试与自动扩缩容
难度:中级 · 预计时间:45 分钟 最后更新:September 13, 2026
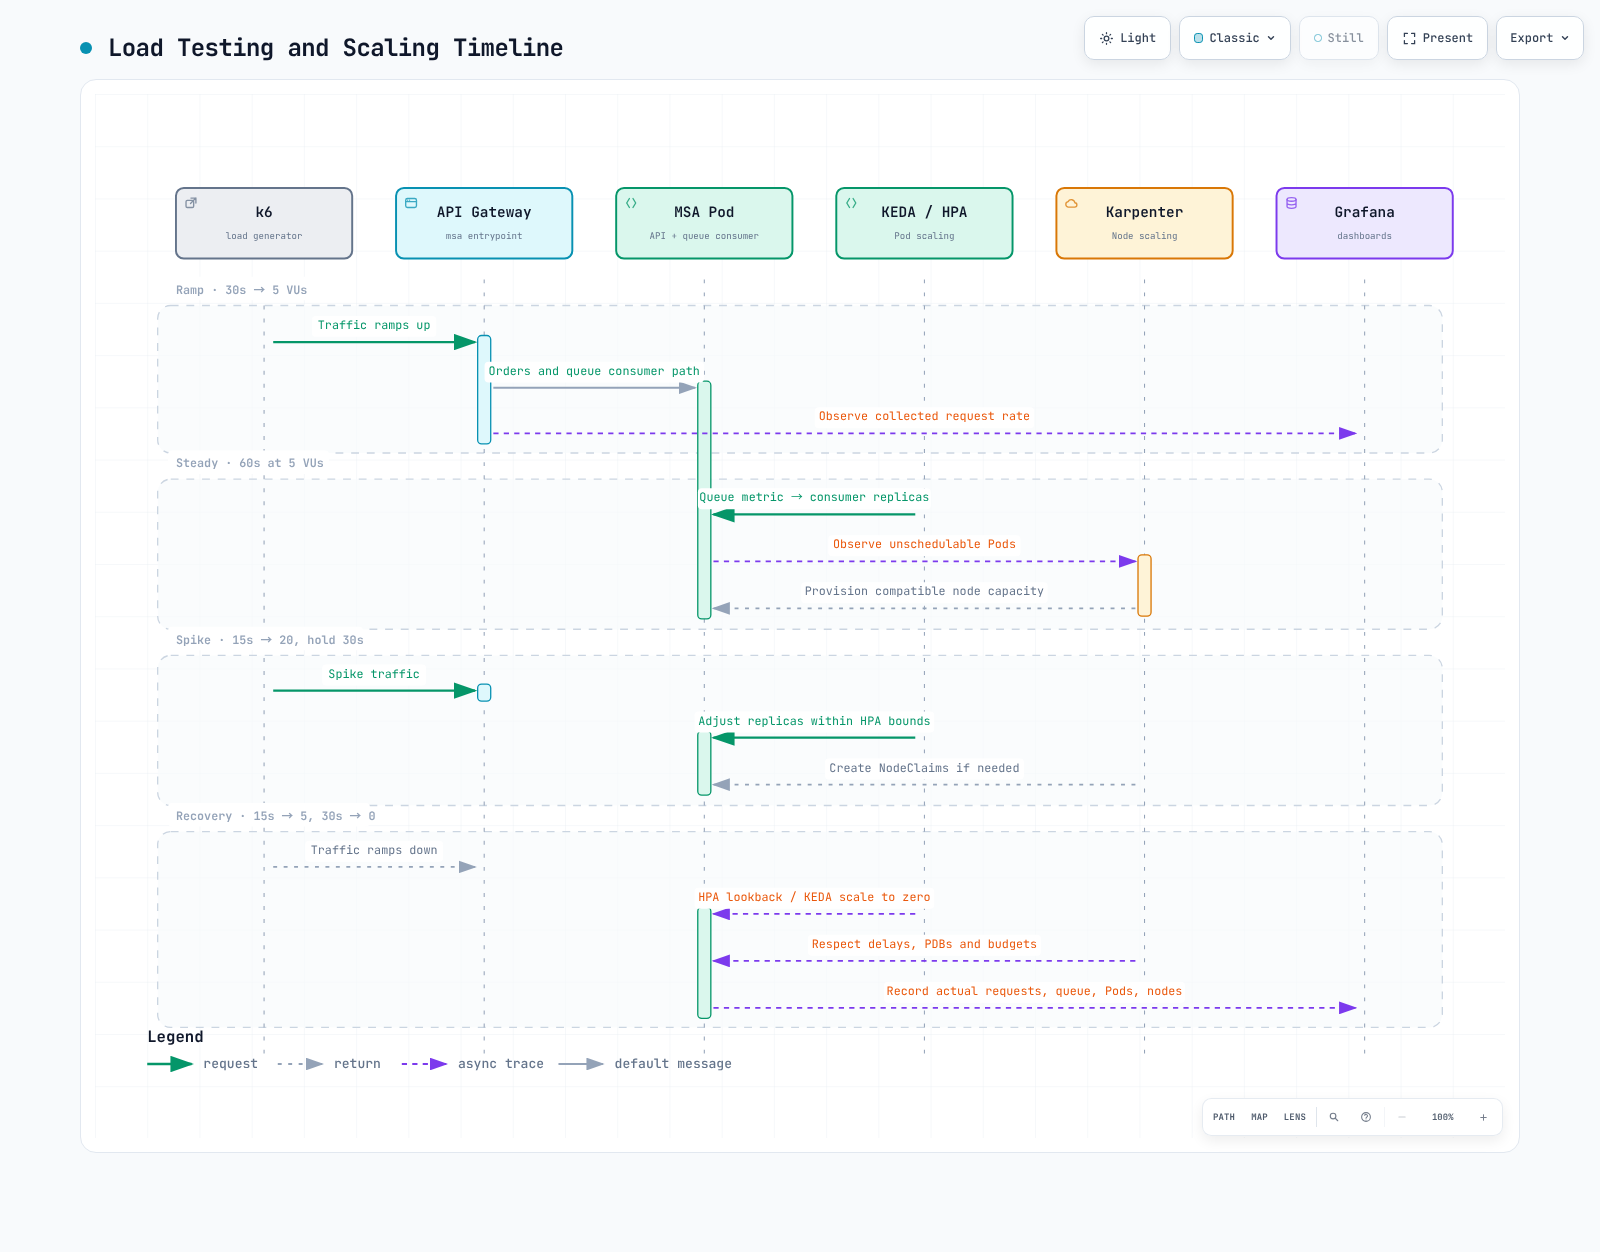
使用 k6 和 Locust 运行相同的订单/支付/读取流程,然后说明观察到的 Pod 和节点变化。仅针对可随时销毁的实验 API 进行测试。VU 数量和延迟阈值是练习设置,并非实测吞吐量或扩缩容结果。
前提条件
- 第 3 部分中的 API 必须已就绪:
POST /orders返回201和id;POST /payments返回200/201和status: completed;GET /orders/{id}返回该 ID。若使用其他 API,请同时更改路径、payload 和断言。 - 服务集群 context 为
service;每条命令都会显式选择它。 - 示例已使用 k6 2.2.0 和 Locust 2.46.5/Python 3.12 验证。请根据你的操作系统/CPU 架构遵循官方安装指南。
- 在第 3 部分中配置 KEDA ScaledObject 和 Karpenter NodePool/EC2NodeClass。基础设施查询需要实际采集 kube-state-metrics/cAdvisor 数据。
1. 使用小型测试验证 API
使用可运行示例中的 k6-scenario.js。在其终端中保持 port-forward 运行。
# Run from the repository root.
cd examples/labs/observability/load-test
kubectl --context service -n msa port-forward svc/api-gateway 8080:8080# In another terminal, from the same directory.
BASE_URL=http://127.0.0.1:8080 LOAD_PROFILE=smoke \
k6 run --no-usage-report k6-scenario.js默认 smoke 测试使用一个 VU 运行两次迭代。它仅读取由测试创建的 ID,并拒绝无效 JSON、缺失的 ID、被拒绝的支付以及响应中不同的订单。阈值会将失败的 check() 结果转为非零退出状态。请检查 k6-summary.json 和退出代码。由于摘要会打印它,summaryTrendStats 包含 p(99)。
2. 运行持续负载阶段
BASE_URL=http://127.0.0.1:8080 LOAD_PROFILE=scale \
k6 run --no-usage-report k6-scenario.js| 阶段 | 时长 | 目标 VU |
|---|---|---|
| 递增 | 30s | 5 |
| 稳定 | 60s | 5 |
| 峰值递增 | 15s | 20 |
| 峰值保持 | 30s | 20 |
| 恢复 | 15s | 5 |
| 冷却 | 30s | 0 |
各阶段共计三分钟,可能还会有额外的 graceful-stop 时间。单个 stages 序列可避免重叠的独立场景。VU 并非 RPS:响应时间、每次迭代的请求数和 sleep 决定吞吐量。仅在检查 NodePool 容量和预算后才增加负载。控制器限制和 AWS Budgets 通知并不是绝对的支出屏障。
k6-job.yaml 是一种集群内的仅 smoke 测试替代方案。请先使用其 README 中的命令创建 obs-lab-k6 ConfigMap。该 Job 的重试次数为零,截止时间为 120 秒,并且设有资源限制。创建 Job 并不能证明测试成功;请检查日志、Pod 退出代码和 Complete/Failed 状态。
3. Locust 替代方案
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/locust -f locustfile.py --headless \
  --host http://127.0.0.1:8080 --users 1 --spawn-rate 1 \
  --run-time 10s --stop-timeout 5 --exit-code-on-error 99 \
  --csv locust-results
Headless 模式避免暴露管理 UI 或 worker RPC Service。分布式执行需要单独的身份验证、内部网络和 worker 配置。这两种工具测试相同的 API 流程,但其调度器不同;仅凭相同的 VU/用户数量并不能使实验等效。
4. 分别观察 Pod 和节点
kubectl --context service -n msa get scaledobject,hpa
kubectl --context service -n msa describe scaledobject
kubectl --context service -n msa get pods -o wide
kubectl --context service get nodepools,nodeclaims
kubectl --context service get nodes -L karpenter.sh/nodepool,karpenter.sh/capacity-type
kubectl --context service -n msa get events --sort-by=.metadata.creationTimestamp
SQS scaler 会读取队列属性;它不会消费消息。请检查 consumer 队列和 ScaledObject URL 是否匹配。queueLength 是每个 Pod 的目标值;消息计数、in-flight/delayed 设置、副本边界和 HPA 行为都会影响结果。仅扩缩容 API producer 无法解决 consumer 积压。
Karpenter 会为无法调度、且其要求可由 NodePool 满足的 Pod 提供容量。还应诊断镜像拉取、PVC 和 taint:增加节点未必能解决这些问题。请使用实际的 NodePool 标签选择节点,而不是 hostname 子字符串。
5. Dashboard 和查询
# Running Pods: phase series also exist with value zero.
sum(kube_pod_status_phase{namespace="msa", phase="Running"})

# Deployment total/ready replicas are different measurements.
kube_deployment_status_replicas{namespace="msa"}
kube_deployment_status_replicas_ready{namespace="msa"}

# HPA desired/current replicas.
kube_horizontalpodautoscaler_status_desired_replicas{namespace="msa"}
kube_horizontalpodautoscaler_status_current_replicas{namespace="msa"}

# Container resource usage; exclude the empty and Pod infrastructure series.
sum by (pod) (rate(container_cpu_usage_seconds_total{namespace="msa", container!="", container!="POD"}[5m]))
sum by (pod) (container_memory_working_set_bytes{namespace="msa", container!="", container!="POD"})
对 Running phase 的 0/1 gauge 求和时,如果所有已观察到的 Pod 都处于 Pending,结果为零;当遥测缺失时则仍然缺失。使用 == 1 过滤掉每个 series 会丢失这一差异。
kube_deployment_status_replicas 不是 ready 数量。对于 Rollout workload,请使用 Rollouts exporter/ReplicaSet/Pod 状态,而不要假定 Deployment metrics 存在。只有 kube-state-metrics 允许时,自定义节点标签才会出现在 kube_node_labels 中。changes(kube_node_created[10m]) 观察的是恒定的创建时间戳,无法检测新创建的节点。
在添加 RED 面板之前,请检查实际的应用 metrics 名称、单位和标签。OTel HTTP histogram 和自定义 Prometheus counter 可能不同。聚合有界的 service/route/status 标签;切勿将订单或客户 ID 用作标签。在相同的 service/route 范围内计算错误率,并将无流量区间显示为缺失的测量值。
6. 缩容和验证记录
| 控制项 | 实际含义 |
|---|---|
KEDA cooldownPeriod | 在最后一个活跃 trigger 后、缩容至零之前等待 |
HPA scaleDown.stabilizationWindowSeconds | 对于 1→N 扩缩容,考虑回溯窗口中的最高建议值 |
Karpenter consolidateAfter | Pod 变更后,在考虑 consolidation 前的延迟时间 |
| PDB/disruption budget/constraints | 可能延迟或阻止 consolidation/termination |
不要承诺立即删除空节点,或在固定分钟数时达到精确的副本数量。记录实际的基线/峰值/恢复 RPS、错误、p99、队列深度、期望/ready Pod、NodeClaim 和 Pending 原因。仅凭节点数量无法量化 AWS 总节省额。
清理和后续步骤
确认测试已停止,如有使用则删除其 obs-lab-k6-smoke Job/ConfigMap,并停止 port-forward。继续学习第 5 部分以验证告警。请遵循第 6 部分进行基础设施清理。
参考资料和验证范围
每个实际的 k6/Locust 工具均已针对合成 loopback HTTP server 测试了六种成功/失败情形。未执行集群、实际 MSA、AWS 负载、节点扩缩容或容量测试。