第 1 部分:MLflow 跟踪
审查基线:MLflow 3.16.0;已检查最新版本 3.17.1 · 2026-10-16
实验环境设置
安装 mlflow==3.16.0,并使用 Python 3.10 或更高版本。以下示例已使用 Python 3.12、SQLite 和本地制品存储进行检查。它不需要 GPU、训练好的模型或远程服务器。
3.16.1 补丁版和后续的 3.17.x 系列(最新版本为 3.17.1)均已发布,但此示例尚未在 3.16.0 之后的任何版本上重新运行。第 3 部分介绍团队 HTTP 服务器和 EKS 操作。
什么是 MLflow 跟踪?
跟踪提供用于管理实验、运行、参数、指标、制品、记录的模型和追踪记录的 API 与 UI。SDK 可以连接到 HTTP 跟踪服务器,也可以直接连接到本地文件/SQL 后端。并非每次使用都需要单独的服务器进程。
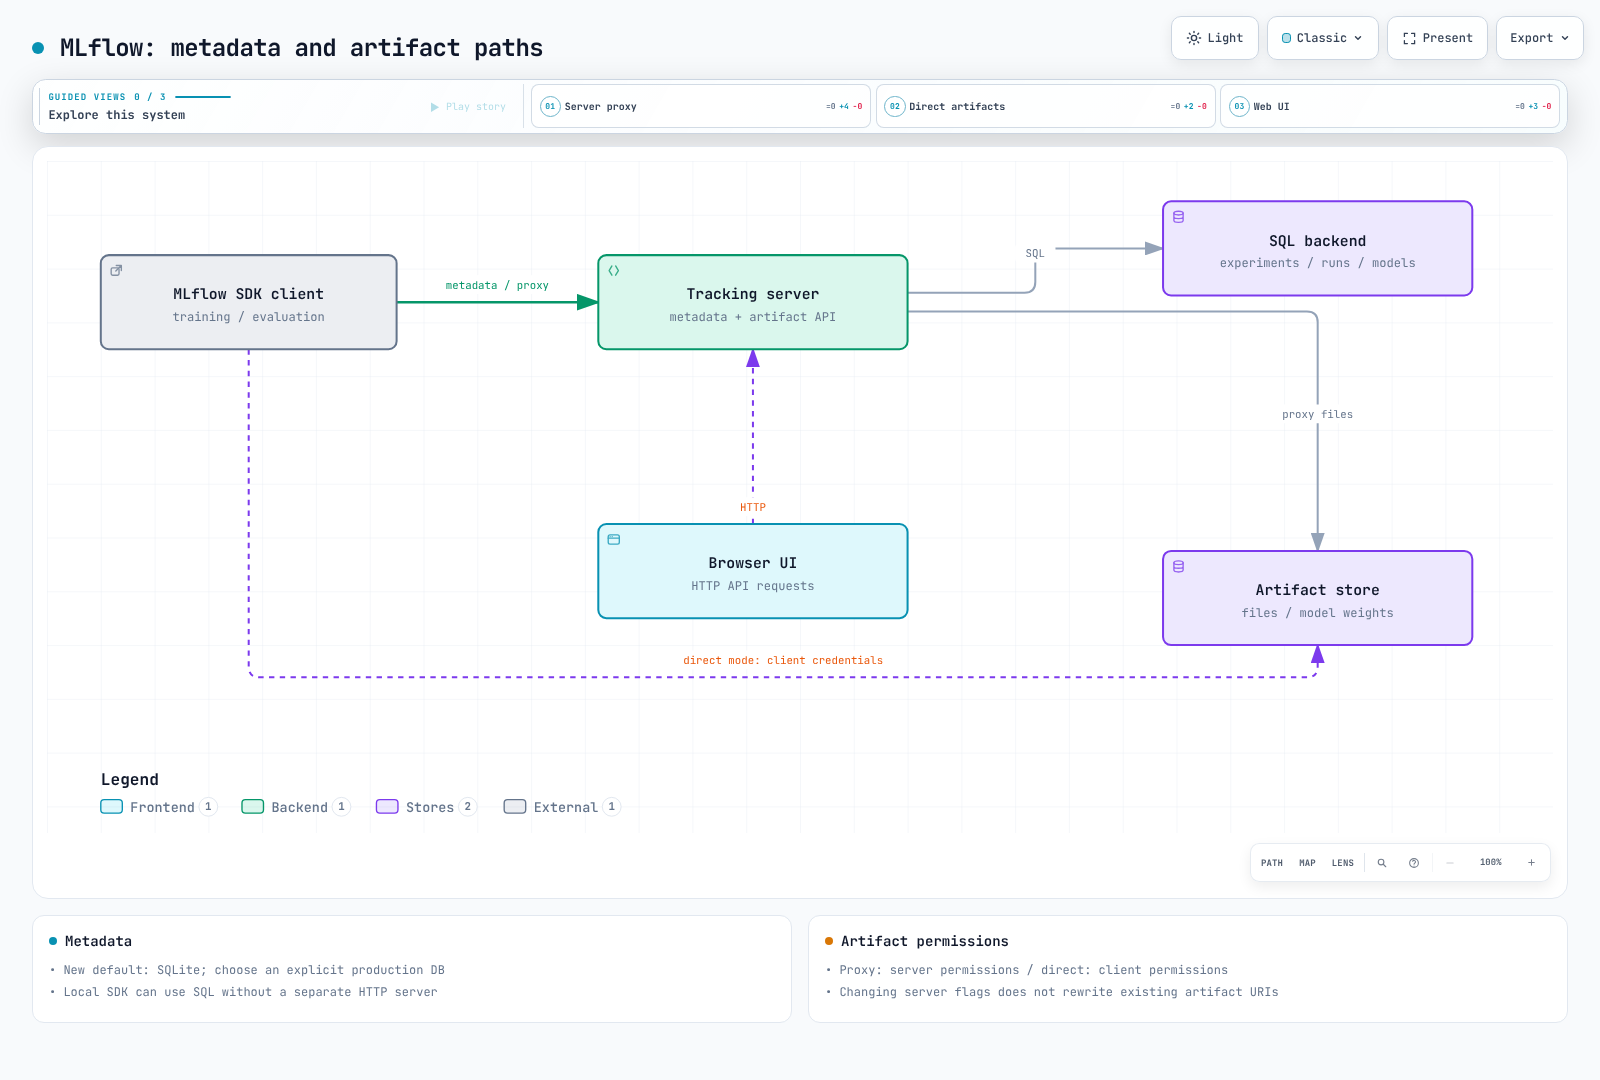
即使使用远程服务器,元数据和制品传输也可能采用不同的路径。元数据通过跟踪 API 传输;制品则可以由服务器代理,也可以在客户端和 S3 等存储之间直接传输。下文会区分这些配置。
核心概念:实验和运行
**Experiment(实验)**将运行及相关结果归在一起。**Run(运行)**可以代表评估、预处理或比较,也可以代表训练。在一次运行中,参数键的值不能更改。指标可以有多个带时间戳和步骤的观测值;请区分当前摘要和完整历史记录。
以下数值是跟踪 API 测试数据,并非实测模型准确率。此示例会自行创建 JSON 制品,不依赖未定义的图像文件。
from pathlib import Path
import mlflow
from mlflow import MlflowClient

root = Path(".mlflow-demo").resolve()
root.mkdir(exist_ok=True)
mlflow.set_tracking_uri(f"sqlite:///{root / 'mlflow.db'}")
client = MlflowClient()
experiment = client.get_experiment_by_name("tracking-demo")
experiment_id = (
    experiment.experiment_id if experiment else
    client.create_experiment(
        "tracking-demo", artifact_location=(root / "artifacts").as_uri()
    )
)
mlflow.set_experiment(experiment_id=experiment_id)

with mlflow.start_run(run_name="demo") as run:
    mlflow.log_param("learning_rate", 0.01)
    mlflow.log_metric("demo_score", 0.92, step=0)
    mlflow.log_metric("demo_score", 0.95, step=1)
    mlflow.log_dict({"synthetic_example": True}, "summary.json")
    run_id = run.info.run_id

assert client.get_run(run_id).info.status == "FINISHED"
assert len(client.get_metric_history(run_id, "demo_score")) == 2
正常退出上下文时,运行会以 FINISHED 结束;如果代码块中发生异常,则会以 FAILED 结束。运行终止不会备份制品,也不会验证整个训练过程是否成功。重复运行此示例会在同一实验中新增一次运行。此条件判断不会更改现有实验的制品位置。
自动记录
mlflow.autolog() 会配置受支持的集成。捕获的值、支持的框架版本、模型记录和输入示例收集因集成而异。不要假设普通 PyTorch 循环和 Lightning 工作流会获得相同的自动埋点。请检查特定框架的 API 和版本支持情况;其他指标应手动记录。
启用自动记录前,请检查输入、输出、模型和数据样本的存储位置。启用此功能既不会移除 PII,也不会为每条自定义代码路径添加埋点。
MLflow 3 的转变:模型成为一等实体
LoggedModel 有自己的 model_id、状态、制品位置和元数据。它可以通过 source_run_id 关联到训练运行,也可以与其他评估运行、指标和追踪记录建立关系。它不同于 Registered Models 和 Model Versions。
在没有显式 start_run() 代码块的情况下调用 log_model(),本身并非 3.x 中的新功能。 在必要时,2.22.0 中的 Model.log() 已经会使用 _get_or_start_run();3.16.0 的模型记录路径仍然具有此行为。重要变化在于模型拥有独立的身份标识,并且可以跟踪关系。
完成上述跟踪设置后,即使没有活动运行,也可以创建模型元数据:
model = mlflow.initialize_logged_model(
    name="metadata-only", model_type="demo"
)
assert mlflow.active_run() is None
assert model.source_run_id is None
print(model.model_id, model.status)  # PENDING
此时它尚不包含可用的模型权重或模型 flavor。实际使用前,请完成模型记录、制品保留和最终确认。READY 并不代表已获准部署、质量合格或通过安全审查。
GenAI 和 LLM 可观测性:追踪
MLflow Tracing 于 2024-06-17 在 2.14.0 中引入。3.x 扩展了模型、评估和 GenAI UI 集成;3.16.0 添加了 span links,并重新设计了追踪 UI。追踪功能并非到 3 版才首次出现。
追踪记录通过 spans 表示请求步骤,例如检索、工具执行和 LLM 调用。请区分父子结构与 span links。令牌收集取决于集成和提供商响应;检索或工具 span 不一定包含 LLM 令牌或费用字段。费用估算需要模型身份、用量和价格信息,并不等同于对账后的账单总额。
适当情况下,可将自动埋点与手动 spans 结合使用。输入、输出、异常、工具参数和推理内容可能包含敏感信息;请明确数据收集范围、访问权限、敏感信息隐藏和保留期限。安装集成并不能确保覆盖所有代码路径或完整核算费用。
后端存储与制品存储
| 存储或默认值 | 含义 |
|---|---|
| 后端 | 实验/运行/参数/指标/模型元数据;SQLite、PostgreSQL、MySQL 和其他受支持的 SQL 存储 |
| 制品 | 模型文件、图表、JSON 和其他文件;本地路径、S3 和其他存储 |
| 默认值 | 新的 3.16.0 环境使用 sqlite:///mlflow.db;如果 ./mlruns 已存在,请检查兼容性行为 |
| 旧版文件后端 | 处于维护模式;新操作应选择显式 SQL 后端并制定迁移计划 |
SQLite 也是一种关系型数据库。它适用于小型本地练习;并发写入、多台服务器副本、备份和高可用性则需要单独评估。备份元数据库不会自动包含制品文件。
远程服务器的两种制品传输路径
- **代理模式:**客户端使用
mlflow-artifacts:位置,并通过服务器发送文件,由服务器持有制品存储权限。客户端可能不需要自己的 S3 访问权限,因此跟踪服务器的身份验证和授权十分重要。 - **直接模式:**使用
--no-serve-artifacts和直接的s3://...制品根路径时,客户端会自行访问存储。客户端需要相应的 AWS 权限、网络访问权限和库。
更改服务器标志不会追溯性地重写现有实验的制品 URI。请检查实际的实验/运行 URI。浏览器 UI 会查询服务器 HTTP API;它不会直接连接 PostgreSQL。
后续步骤
第 2 部分介绍注册、版本和别名。第 3 部分介绍 EKS 存储和访问控制。仅更改别名不会自动重新部署所有服务进程。