跨组织 VPC 连接
原始报告时间戳:September 1, 2026
内容审查:September 12, 2026
本章比较连接不同 AWS Organizations 中账户的五种模式,例如连接现有环境与单独治理的 GPU 环境。表格保留早期文档报告的测量值。本次审查检查 AWS 行为和算术计算;不声称进行了新的实际部署或独立复现了基准测试。
目录
为什么需要跨组织连接
合同所有权、收购、独立治理或隔离要求,可能使 GPU 工作负载与现有服务位于不同 Organizations。组织结构应遵循这些要求,而不是假定第二个 Organization 会自动改善 GPU 折扣、配额或合规性。
EC2 资源配额通常按账户和区域设置;单独的账户即可实现这种分离,不必另建 Organization。计费汇总、协商折扣及重复的治理工作也需要审查。Organization 边界不能替代应用授权、网络分段或审计控制。
对于 EKS,应区分访问数据管道/推理 API 的普通 IP 通信与 GPU 集合通信。CPU 实例上的请求/响应基准测试不能证明 NCCL、吞吐量或 RDMA 性能。EFA 操作系统旁路流量不能跨越 VPC 或可用区;其 ENA 接口的普通 IP 流量仍可路由。
五种方案比较
PrivateLink 和 Lattice 列描述的是已测试的基于 NLB 的端点服务模式和 HTTP 服务模式。PrivateLink 还具有资源端点和服务网络端点类型;Lattice 也具有 TCP 资源配置。不能将这些产品一概描述为“必须使用 NLB”或“仅支持 L7”。
| 方面 | ① TGW RAM 共享 | ② VPC 对等连接 | ③ PrivateLink 端点服务 | ④ TGW 对等连接 | ⑤ VPC Lattice HTTP 服务 |
|---|---|---|---|---|---|
| 机制 | 与外部账户共享 TGW | 直接连接一对 VPC | 使用方接口端点 → 提供方 NLB/服务 | 连接各所有者的 TGW | 将服务和客户端 VPC 关联到服务网络 |
| 地址重叠 | 直接路由需要无歧义的地址规划 | CIDR 重叠的 VPC 无法建立对等连接 | 服务访问可处理 VPC CIDR 重叠 | 直接路由需要无歧义的地址规划 | 服务访问可处理 VPC CIDR 重叠 |
| 连接模型 | 获准时提供双向 IP 路由 | 获准时提供双向 IP 路由 | 使用方发起;响应可通过该连接返回 | 获准时提供双向 IP 路由 | 客户端向已发布服务发起请求;反向访问需要独立配置 |
| 路由设置 | VPC 路由加 TGW 路由表/关联 | 两端配置路由;VPC 对等连接不具传递性 | 端点/服务权限和网络控制,而非通用 VPC 中转 | 显式配置通向对端的静态路由,并配置 VPC 路由 | 服务/网络关联和策略,而非通用 VPC 中转 |
| 控制权 | TGW 所有者管理其 TGW 路由表;使用方保留自身 VPC 控制权 | 各 VPC 所有者 | 提供方控制服务权限/目标;使用方控制自身端点 | 各 TGW 所有者,并协调路由 | 网络/服务所有者及客户端网络控制 |
| 原报告中的预置时间 | TGW 约 3 分钟,另加接受操作 | 不到 1 分钟 | 端点约 3 分钟 | 约 7 分钟 | 约 5 分钟 |
预置时间是原始报告中的观测值,不是 SLA 或端到端交付时间估算。路由一行描述本章的双 TGW 拓扑;不表示可通过任意对等连接链进行无限制中转。NAT 或地址重新规划是处理重叠的其他方法,需要各自的设计。
原报告中的验证结果
原始报告称,已在两个 Organizations 之间建立全部五种模式并交换流量。AWS 文档支持这些模式的跨账户部署;本质上不要求属于同一个 Organization。不过,IAM/SCP/共享限制可能阻止设置,而路由、安全组、NACL、DNS 和服务授权决定流量能否正常通信。仅有账户 ID 和接受操作还不够。
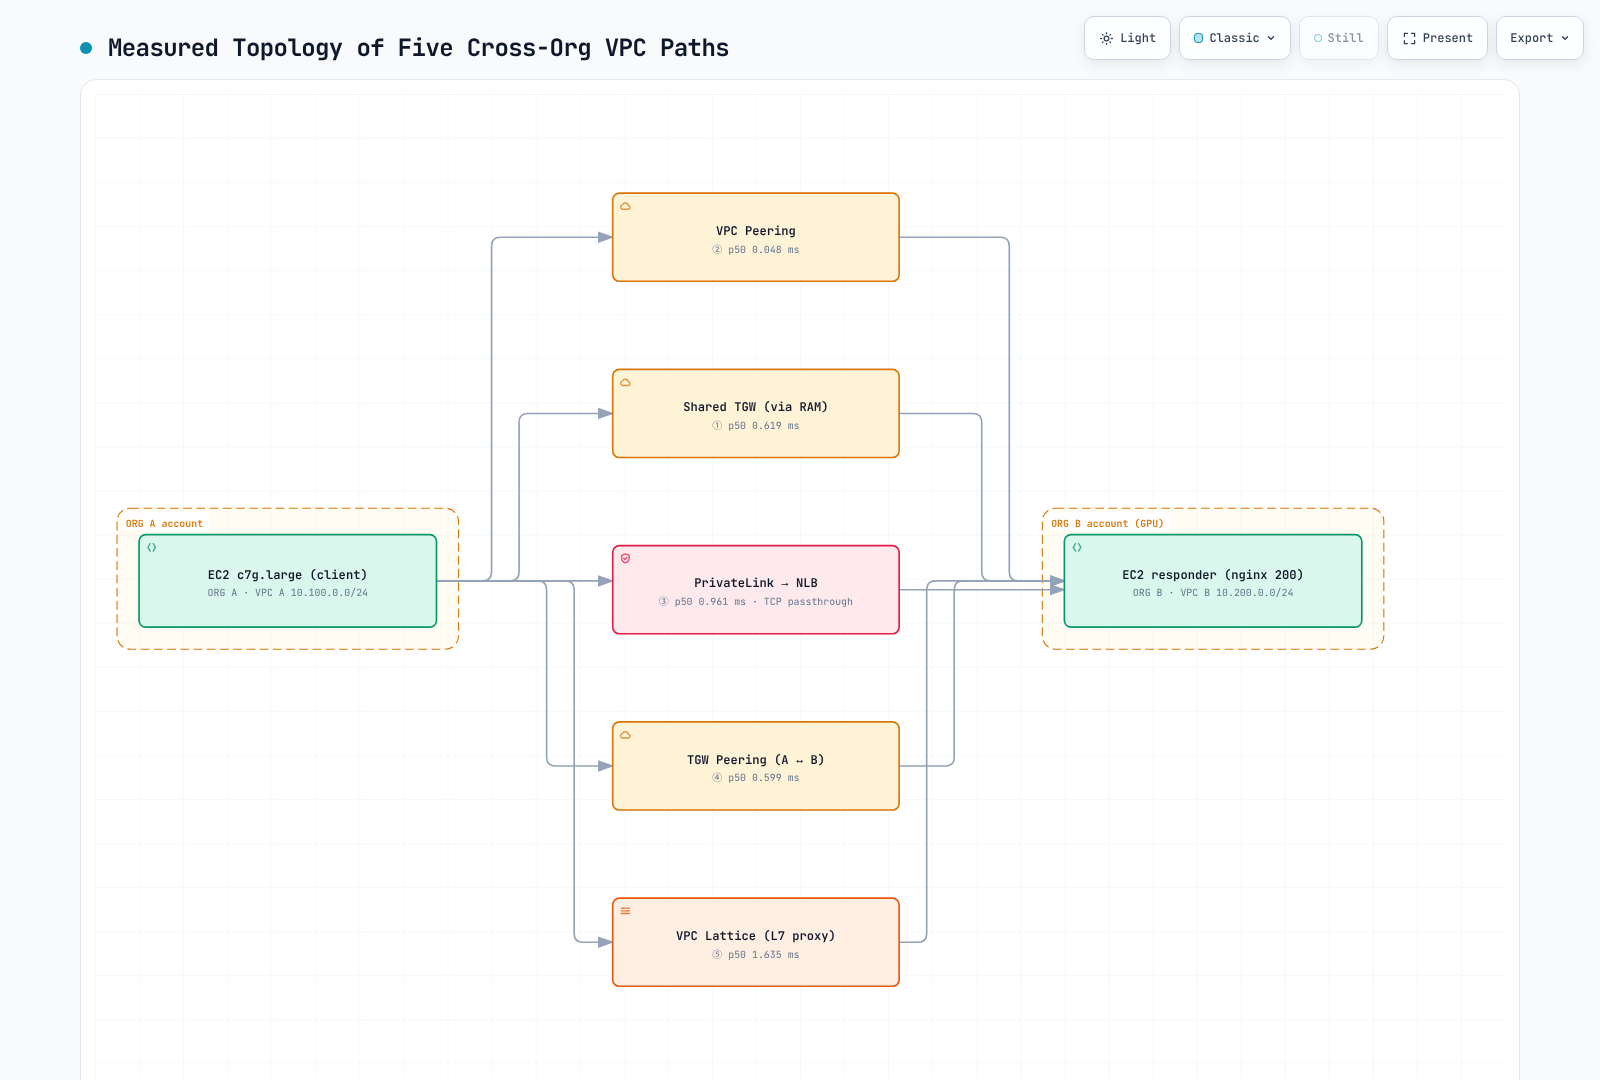
图中保留原始观测。Lattice 的值是 HTTP KA,而其他展示值是 TCP_RR;它们不是可以直接比较的同一种指标。“GPU”标签标识拟议环境,不表示 GPU 基准测试。
延迟测量(M1–M7)
报告中的设置: ap-northeast-2、跨账户匹配的 ZoneId apne2-az1、c7g.large,以及一个使用 nginx 返回固定 HTTP 200 的 EC2 响应端。报告描述了三个 ENI、各路径的子网/返回路由、五轮轮询交错测量、每路径 1,500 个持久连接 TCP_RR 样本、每路径 100 个 ICMP 样本,以及每路径 275 个 HTTP keep-alive 样本。
nginx 的描述标识 HTTP 响应端;本页未说明 TCP_RR 实现或消息大小。此处未链接原始样本、软件/内核版本、计时边界或 Linux 返回路径策略配置。持久连接旨在减少重复建立连接的影响,但无法仅凭这些表格独立检查计时边界。
下方所有延迟值的单位均为毫秒;TTL 是独立的数据包字段。 TCP_RR 和 ICMP 是请求/响应往返测量。HTTP KA 包含应用处理。下方两组测量必须分别解释。
| ID | 路径 | ICMP p50 | TCP_RR p50 | RR p99 | RR sd | HTTP KA p50 | TTL |
|---|---|---|---|---|---|---|---|
| M1 | 同 VPC → EC2(基线) | 0.121 | 0.049 | 0.062 | 0.007 | 0.087 | 127 |
| M2 | ② VPC 对等连接 → EC2 | 0.125 | 0.048 | 0.057 | 0.011 | 0.080 | 127 |
| M3 | ① 共享 TGW(RAM)→ EC2 | 0.535 | 0.619 | 0.695 | 0.141 | 0.686 | 126 |
| M4 | ④ TGW 对等连接(两个 TGW)→ EC2 | 0.912 | 0.599 | 0.855 | 0.133 | 0.488 | 125 |
| M5 | ③ PrivateLink → NLB → EC2 | 未测量 | 0.961 | 1.084 | 0.035 | 0.711 | — |
| M6 | ⑤ VPC Lattice → EC2 目标 | 未测量 | 此 HTTP 服务未测量 | — | — | 1.635 | — |
| M7 | ② 对等连接 → NLB → EC2(分离 NLB 跳点影响) | 未测量 | 0.841 | 0.909 | 0.119 | 0.883 | — |
报告中位数之间的差值
这些是路径中位数之差,不是分离出来的单向跳点开销,也不是单个 ENI/代理组件的测量值。
| 观测路径比较 | 差值 | Δ TCP_RR p50 | Δ ICMP p50 | Δ HTTP KA p50 |
|---|---|---|---|---|
| 对等连接与同 VPC 基线 | M2 − M1 | -0.001 | +0.004 | -0.007 |
| 共享 TGW 路径与对等连接 | M3 − M2 | +0.571 | +0.410 | +0.606 |
| 双 TGW 路径与对等连接 | M4 − M2 | +0.551 | +0.787 | +0.408 |
| 带 NLB 的对等连接与直接对等连接 | M7 − M2 | +0.793 | — | +0.803 |
| PrivateLink/NLB 与对等连接/NLB | M5 − M7 | +0.120 | — | -0.172 |
| Lattice HTTP 服务与直接对等连接 HTTP | M6 − M2 | — | — | +1.555 |
- M2 接近同 VPC 基线,但表格不能证明统计等效或零开销。
- 双 TGW 路径的 TCP_RR 中位数低于单个共享 TGW 路径的中位数。因此,数据不支持通用的“每 TGW 跳点 0.4–0.6 ms”或线性跳点开销公式。
- M5−M7 的差值为 TCP_RR +0.120 ms,但 HTTP KA −0.172 ms。不能将其标为纯 PrivateLink ENI 开销。
- Lattice 比较是 HTTP +1.555 ms,不是 TCP_RR。它描述本次 HTTP 服务测试,不代表每种 Lattice 模式。
- 没有初始 TTL 及相关网络行为信息,TTL 不能揭示路径跳数。
独立的服务前置测量
原始报告还在每条 L3 路径前放置了 NLB。对于这种服务暴露模式,这是有用的比较,但不是每个生产对等连接/TGW 部署的要求。
| 配置 | TCP_RR p50 | HTTP KA p50 |
|---|---|---|
| ② 对等连接 → NLB → EC2 | 0.622 | 0.648 |
| ③ PrivateLink → NLB → EC2 | 0.658 | 0.845 |
| ① 共享 TGW → NLB → EC2 | 1.273 | 1.257 |
| ④ TGW 对等连接 → NLB → EC2 | 1.425 | 1.279 |
| ⑤ Lattice HTTP 服务(本次测试无独立 NLB) | — | 1.680 |
在这组测量中,PrivateLink/NLB 减去对等连接/NLB 为 TCP_RR +0.036 ms 和 HTTP KA +0.197 ms。共享 TGW 与对等 TGW 的 TCP_RR 中位数分别为 PrivateLink 中位数的 1.93× 和 2.17×;HTTP 比率为 1.49× 和 1.51×。这些是延迟比率,不是吞吐量倍数,也不能证明路径等效。
Lattice 的 HTTP 中位数分别比共享 TGW/NLB 和对等 TGW/NLB 的 HTTP 中位数高 +0.423 ms 和 +0.401 ms。不要将这组测量与 M1–M7 组结合来推导组件开销:即使对等连接/NLB 的中位数,在不同运行之间也有差异。
原始报告还描述了一个已舍弃的预试验:使用突发性能实例、NLB→ALB 和每次新建连接的 curl,p95 约为 7 ms,首个流的增量为 0.6–1.6 ms。这些仍是归属于原报告、但未链接原始样本的观测,不是 AWS 保证。应针对实际应用分别测量连接建立和稳态行为。
运维发现
- RAM 外部共享: 必须允许外部主体,Organization 外部账户必须接受共享邀请。
CreateResourceShareAPI 的allowExternalPrincipals默认值为 true;显式设置--allow-external-principals可记录意图,但省略这个具体 CLI 标志并不总是失败原因。验证生效的共享配置和权限。 - 共享 TGW VPC 附件的接受操作:
AutoAcceptSharedAttachments禁用时(默认值),TGW 所有者必须接受共享附件。启用该选项会改变此流程。接受 RAM 共享和接受 TGW 附件是不同步骤。使用方不能修改所有者的 TGW 路由表,但仍控制自身 VPC 路由和安全设置。 - TGW 对等连接的接受操作: 接受方 TGW 所有者应在接受方区域接受待处理的对等连接请求,即使对等连接位于同一账户也如此。使用该请求的
TransitGatewayAttachmentId;不要与 TGW ID 或 VPC 附件 ID 混淆。NotFound响应不能证明两端必须使用不同 ID。原报告中约两分钟的可见性延迟是观测,不是固定等待时间保证。 - 对等连接路由: 直接 TGW 到 TGW 的对等连接使用显式配置的静态路由,不通过对等附件传播 BGP 路由。双向配置相关 TGW 和 VPC 路由表。自动化可管理这些静态路由。
- 路由优先级: 首先使用最长前缀匹配。目的前缀相同时,静态路由优先于传播路由;更宽泛的静态路由不会覆盖更具体的传播路由。
- Lattice 目标安全组: 对于文档中的 VPC 关联服务路径,在实际目标和健康检查端口上使用对应区域/IP 地址族的托管前缀列表(
com.amazonaws.REGION.vpc-lattice和com.amazonaws.REGION.ipv6.vpc-lattice)。原始169.254.171.0/24示例不是通用列表定义;托管列表可包含链路本地地址或不可路由的公有地址。端点/资源网关路径有自己的控制。还必须配置 IAM 服务身份验证;仅关联 VPC 不会启用它。 - 清理所有权: 原报告描述了 GuardDuty 管理的网络依赖、IAM 策略附加和剩余 Lattice 资源对拆除的影响。操作前检查实际依赖 ID 和所属服务。不要仅为强制删除 VPC/角色而禁用托管安全控制或删除无关资源。
按需求选择架构
| 需求 | 候选模式 | 重要检查 |
|---|---|---|
| 每个 Organization 必须保留自身 TGW 路由管理权 | ④ TGW 对等连接 | 静态路由协调、地址规划、吞吐量、可用性、流量检查及传输费用 |
| 仅暴露少量推理/服务端点 | ③ PrivateLink 端点服务 | 受支持协议/模型、端点接受、应用身份验证、DNS、成本及实际载荷/并发 |
| 跨重叠 CIDR 访问服务 | ③ PrivateLink 或 ⑤ Lattice | 服务/资源范围;若需更广 IP 路由,评估 NAT/地址重新规划 |
| 另一账户可使用集中控制的枢纽 | ① TGW RAM 共享 | 外部共享策略、接受设置及所有者的 TGW 控制模型 |
| 少量直接连接的 VPC 对 | ② VPC 对等连接 | 不重叠 CIDR、成对路由维护、配额和数据传输费用 |
| 需要托管 HTTP 服务身份、发现和治理 | ⑤ VPC Lattice | 显式 IAM 身份验证策略、签名请求、服务连接及工作负载测量 |
TGW 对等连接与 PrivateLink 的混合方案可能适合独立网络治理加有限 API 暴露的需求。已发布延迟表不能证明它对大多数 GPU 环境最优。应根据所需连接和控制选择,再测量实际工作负载。
限制和后续检查
原始报告未包含 Network Firewall 流量检查路径的实测、跨区域延迟以及吞吐量/并发测量。它报告了地址重叠的功能检查,但未公布重叠场景的延迟结果。本页也未确立 GPU 集合通信、EFA/RDMA、代表性载荷大小、不确定性估计或完整复现制品。
将报告数值保留为历史背景。部署前,验证目标账户的策略和受支持连接模型、所需双向路由或服务访问、故障行为,以及应用延迟/吞吐量预算。本次审查未执行 AWS 预置或实际基准测试。