指标概览
最后更新: September 13, 2026. 示例已使用 Prometheus 3.14.0 工具在本地检查;未执行集群或云部署。
目录
指标基础
指标以数值形式描述系统状态和行为。指标名称及其完整标签集合可标识一个时间序列;每个样本会添加一个值和一个时间戳。指标支持告警、故障排查、容量规划和性能分析,但一次采样的测量无法保留每一个单独事件。
例如,http_requests_total 表示一个请求计数器;method="GET" 和 status="200" 用于区分不同群体。样本值是累积计数。job 和 instance 等目标标签通常会在抓取期间添加。
时间戳取决于格式。旧版 Prometheus 文本暴露格式中的显式时间戳使用 Unix 毫秒,而 OpenMetrics 使用 Unix 秒。Exporter 通常会省略显式样本时间戳,由 Prometheus 分配抓取时间。不要将某一种单位视为所有遥测协议中的通用单位。
命名和单位
| 示例 | 含义 |
|---|---|
http_requests_total | Counter;_total 表示累积计数,而不是物理单位 |
http_request_duration_seconds | 以基本单位表示的持续时间 |
node_memory_MemAvailable_bytes | 现有的 node-exporter 指标;保留其已发布的拼写 |
requests | 对于新的应用程序指标而言上下文过少 |
httpRequestDurationMs | 包含单位,但使用 camelCase 和毫秒,而非通常的 Prometheus 命名/基本单位惯例 |
对于新指标,优先采用描述性前缀、以下划线分隔的小写单词,以及 _seconds 或 _bytes 等单位。命名约定并不授权重命名 Exporter 已确立的 API。
以下 text 块是合成的 Prometheus 文本暴露格式,不是 YAML。查询表达式位于单独的 promql 块中。查询选择器假定使用所示的抓取 job 名称;请将其调整为实际的目标标签。
指标类型
Prometheus 客户端库通常会暴露 Counter、Gauge、Histogram 和 Summary。应根据测量的含义选择类型,而不只是看哪种查询恰好能接受其样本。
1. Counter
Counter 会累积非负增量,例如请求、错误或已完成的任务。当被测量的进程/状态被重新创建时,它可能会重置;并非每次 Exporter 重启都一定会重置底层 Counter。
# TYPE http_requests_total counter
http_requests_total{method="GET",endpoint="/api/users",status="200"} 12345
http_requests_total{method="POST",endpoint="/api/users",status="500"} 23
每个时间序列的速率、服务范围的速率和估算增量:
rate(http_requests_total{job="example-app"}[5m])sum(rate(http_requests_total{job="example-app"}[5m]))increase(http_requests_total{job="example-app"}[1h])rate() 会处理观测到的 Counter 重置,并在请求的时间窗口内进行外推。它无法恢复两次观测之间丢失的增量。因此,即使对于整数 Counter,increase() 也可能返回小数估值。应在聚合之前应用 rate(),以免一个实例的重置被另一个实例的增长掩盖。
2. Gauge
Gauge 表示当前状态,可以升高或降低。这些值展示了真实的 node-exporter 和 kube-state-metrics 名称,以及应用程序定义的温度指标。
# TYPE node_memory_MemAvailable_bytes gauge
node_memory_MemAvailable_bytes 8589934592
# TYPE node_memory_MemTotal_bytes gauge
node_memory_MemTotal_bytes 17179869184
# TYPE kube_pod_status_ready gauge
kube_pod_status_ready{namespace="example-app",pod="example-0",uid="00000000-0000-4000-8000-000000000001",condition="true"} 1
# TYPE temperature_celsius gauge
temperature_celsius{location="datacenter-1"} 23.5100 * (1 - node_memory_MemAvailable_bytes{job="node-exporter"} / node_memory_MemTotal_bytes{job="node-exporter"})max_over_time(temperature_celsius{job="example-app"}[1h])内存表达式表示未被报告为 MemAvailable 的占比;它不是应用程序的常驻内存测量。Pod 就绪状态使用特定的 condition 时间序列:condition="false" 上值为一的含义不同于 condition="true" 上值为一的含义。
3. Histogram
经典 Histogram 会在插桩的应用程序/Exporter 中将观测值计入累积桶。Prometheus 随后计算分位数。le 是包含边界的上限,+Inf 桶等于 _count。
# TYPE http_request_duration_seconds histogram
http_request_duration_seconds_bucket{le="0.005"} 24054
http_request_duration_seconds_bucket{le="0.01"} 33444
http_request_duration_seconds_bucket{le="0.025"} 100392
http_request_duration_seconds_bucket{le="0.05"} 129389
http_request_duration_seconds_bucket{le="0.1"} 133988
http_request_duration_seconds_bucket{le="0.25"} 144320
http_request_duration_seconds_bucket{le="+Inf"} 144320
http_request_duration_seconds_sum 4800.8625
http_request_duration_seconds_count 144320
这是一个说明性的分布,而不是基准测试。其 144,320 次观测总计 4,800.8625 秒。旧的 53.42 秒总和与显示的桶计数不一致,后者意味着下限超过 2,704 秒。有限的 0.25 秒桶也避免了该示例的 p95 只能落在无边界桶中。
具有匹配桶布局的全局 p95 和均值:
histogram_quantile(0.95, sum by (le) (rate(http_request_duration_seconds_bucket{job="example-app"}[5m])))sum(rate(http_request_duration_seconds_sum{job="example-app"}[5m])) / sum(rate(http_request_duration_seconds_count{job="example-app"}[5m]))聚合经典桶时保留 le。分位数会在桶内插值;其准确性取决于分布和桶的分辨率。更改经典桶边界是一项插桩变更,而不是仅修改查询。
Native Histogram 以不同方式表示分布。当前 Prometheus 指导建议,当客户端、抓取协议和存储/查询流水线支持时优先使用它们。请沿整个路径验证兼容性和配置;这里的经典示例并非 Native Histogram 线缆输出。
4. Summary
Summary 可以在客户端窗口内计算已配置的分位数。这些值通常是具有依赖算法/窗口误差的近似值,而不是精确分位数。不同库的支持有所不同;Summary 实现可能只暴露 sum/count。
# TYPE rpc_request_duration_seconds summary
rpc_request_duration_seconds{quantile="0.5"} 0.052
rpc_request_duration_seconds{quantile="0.9"} 0.089
rpc_request_duration_seconds{quantile="0.99"} 0.245
rpc_request_duration_seconds_sum 29969.50
rpc_request_duration_seconds_count 562887rpc_request_duration_seconds{job="example-app",quantile="0.99"}sum(rate(rpc_request_duration_seconds_sum{job="example-app"}[5m])) / sum(rate(rpc_request_duration_seconds_count{job="example-app"}[5m]))第一个表达式返回每个匹配实例报告的 p99。对这些 p99 值求平均或求和并不能得到全局 p99。第二个表达式可以合理地聚合非负持续时间的 _sum 和 _count 速率,以计算全局均值。
| 问题 | 经典 Histogram | 带分位数的 Summary |
|---|---|---|
| 分布在哪里处理? | 桶在插桩时处理;分位数在查询时处理 | 分位数在插桩时处理 |
| 可以合并实例吗? | 可聚合兼容的桶 | 分位数不能;sum/count 可以 |
| 误差取决于 | 桶分辨率和观测值 | 客户端算法、目标和时间窗口 |
| 之后可以查询不同的百分位数/时间窗口吗? | 可从保留的桶样本中查询 | 仅有预计算分位数时不可以 |
零流量时均值可能为 NaN;缺失的时间序列可能产生空结果。两者均不应在未明确处理的情况下变成流量健康的证据。
拉取与推送模型
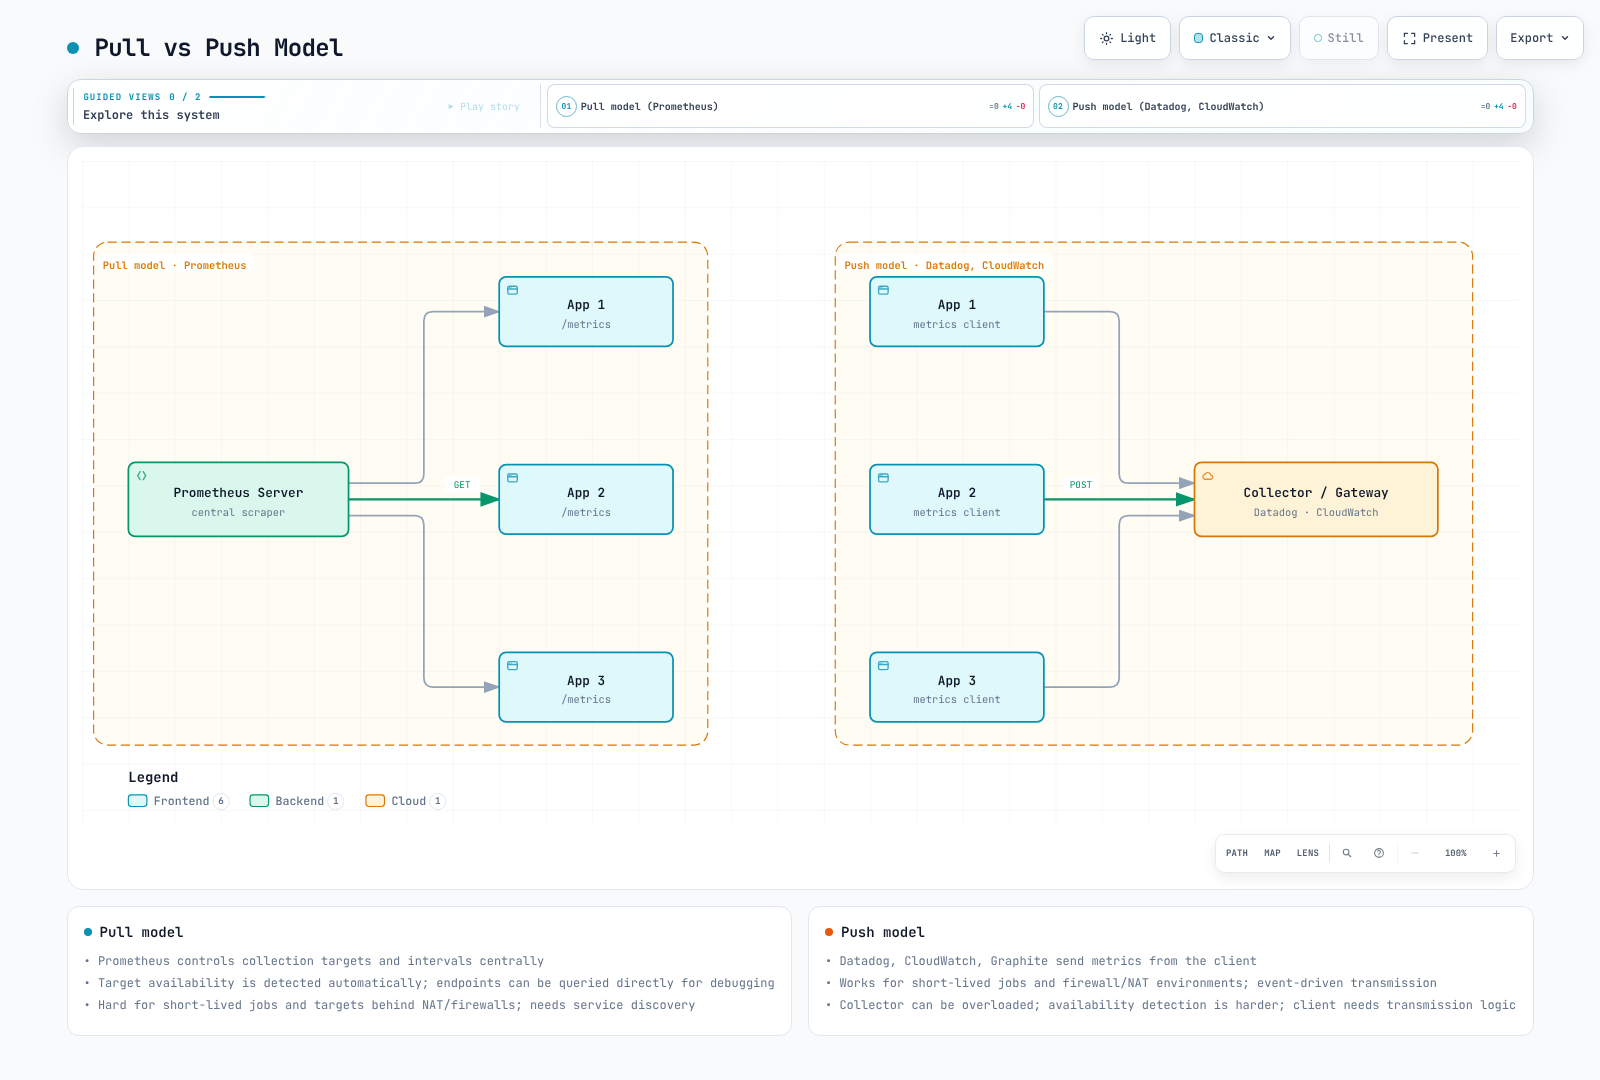
该图展示连接方向。真实流水线可以混合两种模型:Agent 可以抓取端点并转发结果。厂商名称并不意味着每个集成都使用同一种模型。
拉取和 Kubernetes 发现
拉取采集集中控制目标和间隔,并使端点易于检查。采集器需要出站连接能力,目标需要允许入站访问,并且必须配置路由、TLS 和授权。NAT 不会自动使目标可达。Prometheus up 报告抓取是否成功;它不是应用程序可用性 SLO。
此 Prometheus 配置片段会选择 example-app 中已 opt-in、具有命名 TCP metrics 容器端口的 Running Pod。它使用已发现的地址,而非通过仅支持 IPv4 的正则表达式重写该地址。
# pod-scrape.yaml
scrape_configs:
- job_name: example-app
  kubernetes_sd_configs:
  - role: pod
    namespaces:
      names:
      - example-app
  relabel_configs:
  - source_labels:
    - __meta_kubernetes_pod_annotation_prometheus_io_scrape
    action: keep
    regex: 'true'
  - source_labels:
    - __meta_kubernetes_pod_phase
    action: keep
    regex: Running
  - source_labels:
    - __meta_kubernetes_pod_container_port_name
    action: keep
    regex: metrics
  - source_labels:
    - __meta_kubernetes_pod_container_port_protocol
    action: keep
    regex: TCP
  - source_labels:
    - __meta_kubernetes_pod_annotation_prometheus_io_path
    action: replace
    target_label: __metrics_path__
    regex: (.+)
  - source_labels:
    - __meta_kubernetes_namespace
    target_label: namespace
  - source_labels:
    - __meta_kubernetes_pod_name
    target_label: pod
前提条件:Pod 注解 prometheus.io/scrape: "true"、名为 metrics 的已声明端口、可选的 prometheus.io/path,以及用于发现这些 Pod 的 Prometheus Kubernetes API 凭据/RBAC。端点必须实际在该端口/路径上提供指标。这是一个配置片段,而非集群安装或可达性证明。
推送和服务级批处理作业
推送适合具有出站访问能力的生产者,包括某些短生命周期工作负载。它仍然需要接收器容量、身份验证、超时/重试处理以及检测缺失生产者的方法。接收器健康检查成功,并不能证明批处理作业已经运行。
Prometheus 建议在有限的服务级批处理用例中使用 Pushgateway,而不是将其作为每个短生命周期 Pod 的默认方案。推送的分组不会自动过期。避免使用会遗留废弃分组的每 Pod HOSTNAME 分组;应定义稳定的 job 所有权和明确的退役/清理流程。
以下是一个针对单个逻辑批次的成功后集成片段,不是可运行的 Kubernetes Job。它假定存在可访问且已授权的 Pushgateway、sh、awk 和 curl。该批次提供其测量的持续时间、处理记录数和原始完成时间戳。如果重试交付,应保留该原始时间戳。请添加适合环境的 TLS/身份验证,而不要在示例中嵌入密钥。
set -eu
: "${PUSHGATEWAY_URL:?Set the reachable authorized Pushgateway base URL}"
: "${DURATION_SECONDS:?Set the measured duration of the successful batch}"
: "${RECORDS_PROCESSED:?Set the number of records processed by that batch}"
: "${COMPLETED_AT_SECONDS:?Set its original Unix completion time in seconds}"

# Reject nonnumeric metric values before sending anything.
awk -v n="$DURATION_SECONDS" 'BEGIN { exit !(n ~ /^[0-9]+([.][0-9]+)?$/) }'
case "$RECORDS_PROCESSED" in *[!0-9]*|'') exit 2;; esac
case "$COMPLETED_AT_SECONDS" in *[!0-9]*|'') exit 2;; esac

cat <<EOF | curl --fail --silent --show-error --connect-timeout 5 --max-time 15 \
  --request PUT --data-binary @- "${PUSHGATEWAY_URL%/}/metrics/job/example_batch"
# TYPE example_batch_last_run_duration_seconds gauge
example_batch_last_run_duration_seconds ${DURATION_SECONDS}
# TYPE example_batch_last_run_records_processed gauge
example_batch_last_run_records_processed ${RECORDS_PROCESSED}
# TYPE example_batch_last_success_timestamp_seconds gauge
example_batch_last_success_timestamp_seconds ${COMPLETED_AT_SECONDS}
EOF
PUT 会替换此稳定分组键的指标。独立 job 不得争用同一个键。不要在工作失败后推送成功时间戳,也不要在每次成功运行后、其尚未被抓取前删除该分组。当逻辑 job 退役时,有意地删除其所属分组。
使用 honor_labels 抓取 Pushgateway,以保留推送的 job 身份:
# pushgateway-scrape.yaml
scrape_configs:
- job_name: pushgateway
  honor_labels: true
  static_configs:
  - targets:
    - pushgateway:9091
上次成功完成的时长,单位为秒:
time() - max(example_batch_last_success_timestamp_seconds{job="example_batch"})根据计划和预期运行时长选择阈值,并单独处理完全缺失的时间序列。Pushgateway 的 up 仅描述网关抓取。
基数与指标设计
基数是在定义范围内不同时间序列的数量。标签值计数的乘积是在每种组合都可能出现时的上限,而非保证所有组合都存在。
五种方法 × 二十条规范化路由 × 十种状态,最多可产生 1,000 个应用程序标签组合。目标/副本标签以及经典 Histogram 桶加上 sum/count 会使该数量成倍增加。时间序列流失也会增加历史存储和索引成本。
使用 /users/{id} 等有界路由模板。避免将用户 ID、请求 ID、会话 ID 和不断变化的时间戳作为普通指标标签;它们也有暴露敏感数据的风险。仅在能够接受丢失细节时才对状态码分组。应将请求特定上下文放入采用适当控制措施的日志/追踪中。
这些限定范围的查询会统计当前可选择的时间序列,而不是 TSDB 中存储的全部历史时间序列:
topk(10, count by (__name__) ({job="example-app"}))count(http_requests_total{job="example-app"})count(count by (endpoint) (http_requests_total{job="example-app"}))指标和标签名称/值的长度仍会影响格式限制、存储和后端接收能力。基数很重要,但它不是唯一的设计约束。
长期存储要求
Prometheus 本地 TSDB 使用压缩,在经过相应配置和资源预配后,可以保留数据远超 30 天。其默认时间保留期为未提供时间/大小保留设置时的 15 天;这并非最大值。
本地存储不是复制型分布式存储。独立的 Prometheus 副本可以提供采集/告警冗余,而无需 Thanos 或 Mimir,但共享查询、去重、远程持久性和恢复需要各自的设计。长期查询成本取决于数据量和表达式,而不仅仅是日历时间。
保留规划
| 需求 | 规划问题 |
|---|---|
| 告警评估 | 需要哪些回溯窗口、中断缓冲和缺失数据行为? |
| 事件分析 | 有用的分辨率必须保持可用多久? |
| 容量/季节性 | 是否需要数个月的数据或同比比较? |
| 审计义务 | 此数据、访问和删除适用的实际策略是什么? |
| 恢复 | 是否需要备份、恢复测试和独立故障域? |
不存在通用的“指标必须保留 1–7 年”规则。应为工作负载指定保留期限和分辨率、删除/访问策略及恢复目标。
Remote write
此片段以已部署的单节点 VictoriaMetrics 接收器为目标。请将其与经过审查的抓取配置合并。集群接收器使用不同的路径/拓扑;租户 ID 本身并非身份验证。请使用适合环境的已授权、受 TLS 保护的端点。
# remote-write.yaml
global:
  scrape_interval: 15s
remote_write:
- url: http://victoriametrics:8428/api/v1/write
  queue_config:
    capacity: 10000
    max_samples_per_send: 2000
    max_shards: 10
  write_relabel_configs:
  - source_labels:
    - __name__
    regex: example_debug_payload_total
    action: drop
该示例保留了文档中 10,000/2,000 的队列/批次默认值;max_shards: 10 是说明性的并发上限,而非经测量的最优值。队列内存会随分片数量和容量增长。调优指南建议容量约为批次大小的 3–10 倍;从默认值开始,并测量积压、吞吐量和内存。
显式 drop 规则说明如何从远程交付中排除一个已审查的调试指标;它不会删除本地样本。丢弃所有 go_.* 指标并非通用的基数补救措施,还会丢弃运行时诊断信息。
Remote write 是异步的,其 WAL 缓冲是有限的。Prometheus 调优指南描述,在超出文档所述 WAL 窗口(该指南约为两小时)的长时间中断后,未发送数据会丢失。它不是备份,也不保证交付总能成功。
方案比较
部署和运维边界
| 选项 | 评估内容 |
|---|---|
| Prometheus server | 本地 TSDB、PromQL 和规则;保留/容量、独立副本和恢复 |
| VictoriaMetrics | 单节点与集群部署;MetricsQL/PromQL 兼容性、存储容量、租户授权、复制和特定版本功能 |
| Grafana Mimir | 分布式服务和对象存储;本地/摄取资源、复制、租户身份验证、限制和运维容量 |
| CloudWatch metrics | AWS 托管指标存储、指标数学/Metrics Insights 和相关集成;维度、查询产品、配额和分辨率 |
| Datadog metrics | SaaS 加 Agent/集成;标签基数、产品权益、查询汇总和计费 |
对象存储并不意味着可无限扩展,也不能消除所有本地磁盘需求。VictoriaMetrics 的备份目标和特定版本的功能不能与主要存储架构互换。诸如“7×”的压缩基准声明需要指定数据集、版本和方法;此处未作此类断言。
对于传统 CloudWatch metrics,分辨率会随时间变化:亚分钟数据点可用三小时,一分钟数据点可用 15 天,五分钟数据点可用 63 天,每小时数据点可用 455 天。必须单独检查其他指标产品/摄取路径。Datadog 已发布的保留表列出指标标签/值保留 15 个月,但查询会应用汇总;这并不保证每个图表中都保留原始抓取分辨率。
成本输入,而非无依据的月度总额
如果一百万是实际导出的时间序列数,以统一的 15 秒间隔运行 30 天,在交付筛选/去重前会产生 1,000,000 × 30 × 86,400 / 15 = 172,800,000,000 个样本。如果一百万仅指应用程序标签组合,则应先扩展目标、副本和 Histogram 时间序列。
| 选项 | 估算所需输入 |
|---|---|
| 自主管理存储 | CPU/RAM、每样本实测字节数、索引/WAL/余量、副本、存储/网络、备份和运维人员时间 |
| Amazon Managed Service for Prometheus | 摄取样本、存储、查询处理、选定的采集功能和区域价格 |
| CloudWatch | 可计费的指标/维度组合、分辨率、API/查询及选定的可观测性功能 |
| Datadog | 选定的计划、主机/容器、包含和额外的自定义指标、标签及其他已启用产品 |
比较等效的摄取、保留、HA 和功能假设。从下面的官方定价页面获取当前价格,并测试特定工作负载的资源使用情况。“开源”并不意味着基础设施和运维免费。
应根据所需查询/分辨率、基数和流失、故障/恢复目标、租户/访问边界、集成以及经测量的成本模型来选择方案。团队规模本身不是产品选择算法。
指标采集架构
分离采集、存储/查询、规则评估和通知职责:
| 组件 | 角色 |
|---|---|
| node-exporter | 主机 OS 指标,如内存、文件系统和网络计数器 |
| kube-state-metrics | Kubernetes API 对象状态;不能替代容器 CPU 测量 |
| kubelet/cAdvisor endpoints | 容器资源测量;端点可用性和抓取授权需要验证 |
| metrics-server | 用于自动扩缩容和 kubectl top 的 Resource Metrics API;不是历史 Prometheus TSDB |
| Prometheus | 抓取、本地存储/查询和规则评估 |
| vmagent | 采集和转发指标并进行缓冲;不是可查询的 Prometheus TSDB |
| VictoriaMetrics / Mimir | 根据其部署架构存储和查询指标 |
| Prometheus rules / vmalert / Mimir ruler | 评估表达式并将告警发送到 Alertmanager |
| Alertmanager | 对告警进行分组、路由、抑制和交付;它不查询 TSDB 来评估 PromQL |
| Grafana | 查询已配置的数据源并可视化结果 |
为每个连接规划发现、RBAC、凭据、TLS 和网络访问。抓取更多端点不能替代定义哪些信号能够回答工作负载的问题。
主要参考资料
- Prometheus 指标类型、Histogram 和 Summary以及暴露格式
- Prometheus 3.14 配置和存储
- 何时使用 Pushgateway、Pushgateway 生命周期/API以及remote-write 调优
- VictoriaMetrics 集群、vmagent以及Mimir 架构
- CloudWatch 指标保留、Datadog 保留以及Datadog 汇总
- 官方定价:Amazon Managed Service for Prometheus、CloudWatch、Datadog