EKS Spot 生产实验与结果评估
最后更新:2026 年 9 月 14 日 测量状态:部分已测量(稳定负载、节点排空、一次 Spot 回收、PDB 阻止驱逐,以及明确切换到按需容量)。第 7 节提供结果和原始记录。 范围:适用于 EKS Auto Mode、自行管理的 Karpenter 或 EKS 托管节点组的中断容忍型工作负载
评估是否采用 Spot,首先应检查节点回收时服务 SLO 和数据正确性是否仍能满足要求,其次才看节省金额。先测量按需容量基线,再在等效负载下比较混合配置的可用性和实际成本。第 1–6 节中的建议数字和时长均为实验设计示例。第 7 节单独列出实际测量结果;这些结果都不构成 AWS 保证。
可配合使用的设计是:启动阶段分配更多 CPU → 初始化后原地缩减 CPU → 保持 Guaranteed QoS。其目标是缩短替换 Pod 的初始化时间,同时让稳定运行阶段的资源设置保持一致。请参阅下文的按阶段配置资源和组合实验 E10。现有 E0–E9 测量并未验证此配置。
原始实验报告和工作负载映射链接到提供的 Go 控制器文档,并说明其适用范围:Deployment、StatefulSet、DaemonSet 和 Argo Rollouts。
当前决定是:暂缓扩大生产采用范围,先处理回收/切换期间的错误、版本兼容性和中断处理。这些合成 HTTP 测量用于诊断已安装配置;它们不能证明业务服务能持续不中断,也不能证明配置受支持。
1. 需要验证的行为和限制
| 主题 | 文档说明的行为或限制 | 实验依据 |
|---|---|---|
| Spot 通知 | EC2 通常会在中断前两分钟尽力发送终止/停止通知。休眠会立即开始。S1 | 事件送达延迟,以及未处理通知时的行为 |
| Pod 关闭时间 | 两分钟窗口并非全部留给应用。检测、驱逐、钩子和负载均衡器传播都会占用时间。部分 MNG Pod 可能收不到终止信号。S2 | 从 SIGTERM 到退出的实际时间、被强制退出的情况、失败请求 |
| PDB | PodDisruptionBudget 通过 Eviction API 限制自愿中断。它无法阻止实例丢失,也无法控制 Deployment 滚动更新的并发度。S3 | 分别评估自愿排空和节点被迫丢失 |
| 替换容量 | Node Ready 与应用开始承载流量是不同里程碑。S2、S4 | Node Ready → 拉取镜像 → Pod Ready → LB 目标健康 → SLO 恢复 |
| Spot 占比 | NodePool 优先级和允许的容量类型不能保证固定比例。S5 | 分别测量节点、vCPU、Pod 和请求的占比 |
按计算资源管理方式区分路径
| 计算资源管理方式 | 容量标签 | 中断处理 | 恢复到按需容量 |
|---|---|---|---|
| EKS Auto Mode | karpenter.sh/capacity-type: spot / on-demand | 检查托管功能、Kubernetes 事件和 NodeClaim。不要把开源版 Karpenter 的安装步骤照搬到 Auto Mode。S6 | 确认 NodePool 和 Pod 约束都允许 On-Demand |
| 自行管理的 Karpenter | karpenter.sh/capacity-type: spot / on-demand | 验证 EventBridge → SQS → Karpenter --interruption-queue、IAM、事件和控制器日志。再平衡建议与中断通知的处理方式不同。S4 | 在 NodePool 及兼容的 Pod selector、affinity 和 toleration 中允许 spot 和 on-demand。S5 |
| EKS 托管节点组(MNG) | eks.amazonaws.com/capacityType: SPOT / ON_DEMAND | 验证托管式容量再平衡和实际 ASG 设置。排空不一定会等待替换节点变为 Ready。S2 | Spot MNG 只能使用 Spot。应测试单独的 On-Demand MNG、Cluster Autoscaler 配置和 Pod 是否符合调度条件。S2 |
将 NodePool disruption budget 设为 0 不能阻止 EC2 回收。请把 Karpenter 自愿整合/漂移与中断事件分开记录。S4 在 Auto Mode 上另外安装 Node Termination Handler 并非这些实验的前置要求。
2. 环境和对照组
从专用测试集群开始,确保部署制品、网络和负载均衡路径与生产环境相同。不要默认使用现有生产集群。负载生成器和遥测采集器应位于目标回收范围之外。
每次运行前冻结并记录以下信息
| 字段 | 记录内容 |
|---|---|
| 运行标识 | Run ID、负责人、UTC 起止时间、配置 Git SHA、FIS 实验 ID |
| 平台 | AWS 账户别名和 Region、测试集群、Kubernetes/平台版本、Auto Mode 或 Karpenter/CA 版本 |
| 节点 | AMI/OS、架构、实例类型和 AZ、NodePool/MNG 配置、限额、配额、子网 IP 余量 |
| 应用 | 镜像摘要、副本数、requests/limits、HPA、PDB、放置规则、关闭钩子、重试/超时 |
| 流量 | 端点和操作、请求负载大小、请求率/并发量、keep-alive、重试策略、数据种子 |
| 遥测 | 采集间隔、仪表板/日志查询、客户端原始记录、时钟同步、证据保留位置 |
| 成本 | 每个节点的实际使用时长和计价依据、承诺折扣处理方式、共享成本分摊 |
公开结果中不要包含真实账户 ID、内部端点或客户数据;应在访问受控的证据库中保留可追溯信息。各组使用相同的镜像架构。使用 MNG 和 Cluster Autoscaler 时,应将 vCPU/内存规格相近的实例类型分组。避免把架构或实例规格变化误当作 Spot 影响。S2
对照组
| 组别 | 配置 | 用途 |
|---|---|---|
| A | 仅按需容量 | 在等效负载下测量基线错误、延迟、吞吐量和成本 |
| B | 按需容量保证最低服务容量,另以 Spot 扩容 | 生产候选配置;比较连续服务能力和成本 |
| C | 仅 Spot | 暴露中断和容量风险;不建议直接用于生产 |
组 B 的示例配置是:一个 3 副本、仅使用 On-Demand 的 Deployment,加上一个 3 副本、仅使用 Spot 的 Deployment,并由同一个 Service 提供服务。两个 Deployment 应使用不同且互不重叠的 selector,只共享 Service 标签。这并不意味着节点、成本或请求占比会是 50%。
应将这种固定占比实验与回退测试分开;回退测试使用优先选择 Spot、同时允许 On-Demand 的 Deployment。仅 Spot selector 会阻止 Pod 迁往 On-Demand,即使有可用节点也一样。在一个 NodePool 中允许两种容量类型,并不等于为运行中的 On-Demand 容量预留了最低值。S5
按服务存活需求确定 On-Demand 底线,而不是选一个任意百分比:
Required surviving replicas = ceil(required degraded-mode RPS / per-Pod RPS meeting SLO)
Surviving replicas after failure = all replicas - replicas on reclaimed nodes
Requirement: surviving replicas >= required surviving replicas例如,假设每个 Pod 在满足 SLO 的前提下能处理 100 RPS,而降级模式需要处理 300 RPS,则至少要保留 3 个副本。此计算还假设 CPU、内存、连接和下游容量都充足;它不能证明真实系统中 3 个副本就足够。如果还要覆盖 AZ 故障,则计算时应排除故障 AZ 内的 On-Demand 容量。
初期先固定 HPA 和自愿整合设置,再恢复生产设置进行单独的交互测试。记录 Pod 的实际放置情况:主机名/AZ 拓扑分布、DoNotSchedule、minDomains 以及 PV 可用区约束都可能阻止恢复。S8
增加启动阶段 CPU,同时保持 Guaranteed QoS
将 Kubernetes 路线图 1.36 节中的 MAP 和按阶段缩减 CPU 原型应用到 Spot 替换路径。容器级原地资源调整在 1.35 GA;MutatingAdmissionPolicy(MAP)在 1.36 GA。MAP 在 API Server 内使用 CEL,可替代变更型准入 Webhook。此示例不会部署外部 Webhook 服务器。S14、S16
| 阶段 | 执行的操作 | 需维持的条件 |
|---|---|---|
| 创建新 Pod | 工作负载模板为启动阶段 CPU 和内存设置相等的 requests 和 limits。MAP 为选择启用的 Pod 补上缺失的 resizePolicy 条目 | 从创建时起即为 Guaranteed;保留已有的显式 resize policy |
| 应用初始化 | 使用较高的启动 CPU 配额。通过真实的 startupProbe 确认初始化完成 | 仅处于 Running 不够;还要分别检查 readiness 和 LB readiness |
| 请求缩减 CPU | 独立的 resizer 通过 pods/resize PATCH CPU request 和 limit | CPU policy 为 NotRequired,内存不变,Pod UID 和容器不变 |
| 稳定运行 | 检查 kubelet 实际应用的 CPU、内存和 qosClass,再用有代表性的负载测 SLO | 缩减后仍为 Guaranteed;区分 API 接受请求、实际调整完成和服务质量 |
此例中的工作负载模板负责设置启动 CPU。MAP 仅注入 resizePolicy 默认值;它不会监控预热是否完成,也不会缩减运行中的 Pod。另一个控制器会在启动之后处理缩减。
此处优化的“初始化时间”指应用中CPU 密集型初始化或预热阶段。此设计不会调整已经完成的常规 initContainers。如果耗时主要来自拉取镜像、启动节点、等待外部 I/O 或简单的 sleep,仅改变 CPU 设置不会按比例缩短耗时。路线图中的 BusyBox sleep 示例用于说明状态转换,并非启动性能基准。
以下说明性对比配置采用路线图中的取值。每种配置都将容器的内存 request 和 limit 保持为 64Mi。选择资源值前,应测量实际应用的启动、峰值负载和内存使用情况。
| 配置 | 启动阶段 CPU request=limit | 稳定阶段 CPU request=limit | 用途 |
|---|---|---|---|
| G-steady | 50m | 50m | 固定低 CPU 基线 |
| G-phase | 200m | 50m | 初始化时使用更多 CPU,完成后缩减 |
| G-high | 200m | 200m | 启动和稳定阶段都使用更多 CPU 的固定配置对照 |
此设计不是先以 Burstable 启动,再变为 Guaranteed。 Pod 的 QoS 类别在创建时确定,不能通过 resize 改变。在此容器级配置中,应用容器、sidecar 和 init 容器所需的每项 CPU 和内存 request 都必须分别等于对应的正数 limit。缩减时应同时更改 CPU request 和 limit。仅 CPU 值相等不满足 Guaranteed 条件;内存值不同仍然不满足。S14、S15
现有原型还要求:
- 设置一个
WATCH_NAMESPACE和经过审查的MIN_STEADY_CPU。MAP binding 选择带map-demo: "true"标签的命名空间;Pod 模板还需resize.example.com/managed: "true"标签和resize.example.com/enabled: "true"annotation。这些 selector 本身不构成授权边界。 - 使用
resize.example.com/trigger: StartupProbePassed,并为每个目标常规容器验证真实的startupProbe和status.containerStatuses[].started=true。单独检查started,或等待固定时长,都不能证明预热已完成。S17 - 让
resize.example.com/steady-resources中的容器名与实际名称一致。当前 Spot 示例的容器名为http,仅调整 CPU 时值为{"http":{"requests":{"cpu":"50m"},"limits":{"cpu":"50m"}}}。仅添加此 annotation 不会安装 MAP 或 resizer,也不会增加启动 CPU。 - 明确为 Pod 选择 Linux OS 和 Linux 节点,并使用容器级资源。现有原型会拒绝 Pod 级预算、内存更改、升配、需要重启的 CPU policy、进行中的 resize 或观察到的资源不匹配情况。它不面向常规 init 容器或临时容器。还要检查所选节点上的 resize 限制,包括 static CPU/Memory manager policy。S14
- 为启动阶段预留容量余量,以便调度 CPU request 较大的新 Pod。如果当前 request 不适合节点,即使之后计划缩减,Pod 仍会保持 Pending。现有原型不会在同一 Pod 的容器重启时恢复启动 CPU;应单独测试这种情况。Spot 容量被回收后,新建的替换 Pod 会再次经过模板和准入流程。
保持 Guaranteed 有助于维持资源配置和 QoS 条件,但仍需通过应用 SLO 证明服务质量可接受。稳定阶段 CPU limit 较低可能导致节流和延迟;超过内存 limit 则可能 OOM。Guaranteed 无法阻止 Spot 节点回收。应先明确 HPA、VPA、GitOps 和 resizer 对资源设置的所有权。在 E7 中,验证 CPU request 变化对基于 CPU 利用率的 HPA 分母造成的影响。S1、S14、S15
原始实验报告和工作负载映射
随附来源:使用 Go 控制器进行自动按阶段资源调整:Deployment / StatefulSet / DaemonSet / Argo Rollouts。此 Notion 文档包含 Go 代码、Dockerfile、RBAC/部署清单以及所报告的 EKS 观察结果。访问可能需要 Notion 分享权限。
该来源的核心思路是在持续保持 Guaranteed QoS 的同时,分别设置启动阶段和稳定阶段的 CPU 配额。缩减实际生效后,较低的 request 可能为其他 Pod 腾出空间,而稳定阶段 CPU limit 仍能限制使用量。来源将缓解 noisy neighbor 和提高装箱效率列为值得评估的设计收益;下方 CPU/QoS 表并未测出性能提升、节点密度变化或成本节省。
通用入口是 Pod,而不是工作负载类型。Deployment 和 Rollout 的 Pod 通常由 ReplicaSet 直接拥有;StatefulSet 和 DaemonSet 也会创建 Pod。下表中的所有权路径用于区分实验组,并不要求为每种父控制器实现单独的 resizer 代码。
| 工作负载 | Pod 所有权路径 | 来源中提供的证据 |
|---|---|---|
| Deployment | Deployment → ReplicaSet → Pod | 第 6.2–6.3 节报告了自动 resize 日志及两个 Pod 调整前后的取值 |
| StatefulSet | StatefulSet → Pod | 第 6.2–6.3 节报告了自动 resize 日志及调整前后的取值 |
| DaemonSet | DaemonSet → Pod | 第 6.2–6.3 节报告了自动 resize 日志及调整前后的取值 |
| Argo Rollouts | Rollout → ReplicaSet → Pod | 第 4.1 节给出直接的 spec.template 示例和结构适用性说明;第 6.3 节的测量表没有这一项 |
对于来源中直接编写的 Pod 模板,应将通用设置应用到每种资源的 spec.template:annotation 放在 spec.template.metadata.annotations 下,启动资源、startupProbe 和 resizePolicy 放在目标 spec.template.spec.containers[] 中。来源区分了显式编写的 policy 与 MAP 注入的 policy。仅更改 Deployment 清单的 kind 并不足够。还需保留工作负载特有设置,包括 StatefulSet 的 serviceName/Service、存储与排序策略、DaemonSet 放置规则及 Rollout 策略。
下表是来源报告的调整前后值。其环境为 EKS 1.36.1、containerd 2.2.3,以及 arm64/Graviton 上带 cgroup v2 的 AL2023。这些值概述了提供的实验报告;本次文档更新没有重新运行实验。
| 报告中的工作负载 | CPU request=limit | 内存 request=limit | QoS | restartCount / containerID |
|---|---|---|---|---|
| 两个 Deployment Pod | 200m → 50m | 保持 64Mi | Guaranteed → Guaranteed | 0 → 0 / 不变 |
| StatefulSet Pod | 200m → 50m | 保持 64Mi | Guaranteed → Guaranteed | 0 → 0 / 不变 |
| DaemonSet Pod | 200m → 50m | 保持 64Mi | Guaranteed → Guaranteed | 0 → 0 / 不变 |
对 Argo Rollouts,应区分结构上适用和已观测验证。来源引言提到了全部四种类型,但详细测量表只有上述三种;对 Argo 的说明基于共同的 Pod 所有权结构。仅凭日志中的 ReplicaSet 标签无法区分 Deployment 和 Rollout,也不能证明 Rollout 测试已完成。应记录实际的 stable/canary 所有权链,并分别验证 promotion、abort/rollback、流量/Analysis 指标,以及修改 CPU request 的影响。
来源实现中的集群范围 watch、resized 标记和 sync.Map 属于早期实现。应保留当前路线图原型的命名空间范围、管理标签、CPU 下限、真实 startupProbe、UID/resourceVersion 测试和重试队列,不要用早期代码替代当前部署规范。containerID/restartCount 不变本身不能证明 cgroup 已应用更改或请求没有丢失;应分别看待来源报告、实际资源/SLO 观察和仍未执行的组合 Spot E10 测试。
3. 实验和验收标准
通用协议示例:将 10 分钟预热、15 分钟稳定负载、故障注入/恢复及恢复后 15 分钟分别记录。每种故障场景至少先进行五次独立运行,并改变运行时间和目标实例类型。这样的样本数不能证明生产可靠性。
SLO 示例:每分钟窗口内请求错误率不超过 0.1%、p99 不超过 500 ms、120 秒内恢复,且已确认的工作零丢失。测试前请替换为服务约定的 SLO 和错误预算。除 HTTP 错误外,还要把超时、连接失败和响应内容无效计为失败。分别报告原始尝试次数和重试后用户操作成功次数。
| ID | 假设与刺激条件 | 操作步骤 | 观察与判断 |
|---|---|---|---|
| E0 | 无故障时,组 B 达到与组 A 相同的 SLO | 在 A/B/C 上施加等效的代表性负载;排除预热阶段 | 错误、延迟分布、成功吞吐量、实际 Spot 占比 |
| E1 | 节点排空和应用关闭流程有效 | 通过 Eviction API 排空一个测试节点;之后恢复 | PDB 等待、关闭钩子、在途工作是否完成。不能替代 Spot 回收测试 |
| E2 | 回收一个 Spot 实例后仍满足 SLO | 按下文 FIS 步骤中断一个真实 Spot 实例 | 通知→排空→替换→服务恢复时间、失败请求、强制终止 |
| E3 | 并发回收仍能保留存活容量 | E2 通过后,在同一 AZ/类型中明确指定两个 Spot 实例 | 最大并发不可用量、PDB 阻塞、存活容量、损失情况。没有此类目标时记为 N/A |
| E4 | Spot 不可用时,On-Demand 能恢复服务 | 先执行切换为仅 On-Demand 的 Deployment 变更;再单独测试下方的容量错误 | 将切换演练和自动容量错误回退分别评分 |
| E5 | 没有通知处理时也能恢复 | 在专用测试基础设施中分别破坏中断处理或突然终止指定的 Spot VM | 与正常通知测试分开;观察无信号时的检测/重新调度延迟和工作正确性 |
| E6 | 约束和缓慢关闭流程会暴露失败 | 每次只改变一个条件:阻塞型 PDB、较长 preStop、仅 Spot 的 affinity 或 AZ 约束 | 检测预期失败;诊断并修正生产设置,再次测试 |
| E7 | 扩缩容和回收可能同时发生 | 恢复生产 HPA/CA/Karpenter 设置,在代表性峰值需求期间运行 E2 | Pending Pod、配额/IP、镜像拉取,以及新容量达到 SLO 所需时间 |
| E8 | 重试后的工作仍正确 | 使用固定的测试 job ID 集合,在处理期间运行 E2 | 对账已提交/已确认/已持久化的结果;区分重复执行和重复效果 |
| E9 | 成本改善能够持续 | 交替进行可比的 A/B 时段,或在等效负载下观察足够长时间 | 计入重试、重复容量和开销后的每次成功操作成本;确认没有性能回退 |
| E10 | 增加启动 CPU 可缩短替换 Pod 的初始化时间,并在缩减后保持质量 | 在放置、应用和负载相同的条件下比较 G-steady/G-phase/G-high,然后重复 E2 | 启动时间、resize 是否实际应用、Guaranteed QoS 是否保持、重启、节流和请求 SLO |
E3 测试的是并发 Spot 回收,并不等同于影响网络、存储和 On-Demand 容量的整个 AZ 故障。
E4:区分切换演练和容量不足
将 NodePool 改为仅 On-Demand,只能测试配置、调度和应用启动。它不能验证 EC2 返回 Spot 容量不足时是否自动回退。
若要可控地制造容量错误,应根据实际供给路径检查 AWS FIS EC2 API 容量不足操作或 ASG 容量不足操作是否适用,并参考官方操作说明和当前 get-action 输出。Karpenter 的 Fleet 调用、MNG 的 ASG 和 AWS 托管的 Auto Mode 是不同路径。将注入范围限制到专用测试角色/ASG 及 AZ,并验证它不会同时阻断 On-Demand 供给路径。
如果找不到覆盖实际供给路径且可重复的注入方法,应将自动回退标记为未验证。自然发生的容量错误可以作为辅助证据。限制实例类型/AZ 并不能保证真的出现容量不足。
E10:同时验证初始化变快和稳定阶段服务质量
先固定配置 A 或 B,只改变 CPU 配置。保持应用镜像、输入、副本数、稳定阶段内存、实例类型、AZ 和镜像缓存条件一致;初始化过程应实际执行 CPU 工作。在各 CPU 配置下比较正常负载,然后重复相同的 E2 回收测试。将 E7 自动扩缩容交互放在单独阶段检查。
| 评估项 | 所需证据 |
|---|---|
| 初始化是否缩短 | 分别记录应用初始化起止、容器启动、startupProbe 成功和 Ready/LB 时间戳。比较多次运行的分布,不要把初始化时间与节点启动或镜像拉取混为一谈 |
| resize 是否应用 | 同时保存期望的 spec.containers[].resources、kubelet 报告的 status.containerStatuses[].resources、generation/observed generation,以及 PodResizePending/PodResizeInProgress 状态 |
| 执行连续性和 QoS | 对同一个 Pod UID,记录调整前后的 CPU 和内存 requests/limits、qosClass=Guaranteed、containerID 和 restartCount。仅凭这些信息无法证明请求没有丢失 |
| 稳定运行质量 | 缩减后,在有代表性和峰值负载下确认错误、p99、吞吐量、CPU 节流、OOM、readiness 变化及业务工作正确性都满足现有 SLO |
| 替换和资源争用 | 并发创建 Pod 时的 Pending Pod、额外节点和启动容量;同一 Pod 中的容器重启;控制器失败、Deferred/Infeasible resize 及恢复路径 |
成功的 resize PATCH 只证明请求已接受。还要检查状态为 Deferred 或 Infeasible 的 PodResizePending、PodResizeInProgress 以及实际报告的资源。未应用的值不能当作稳定运行结果。以下是你拥有的一个 Pod 的只读快照,不能替代重复观察。S14
set -euo pipefail
: "${KUBE_CONTEXT:?}"; : "${NAMESPACE:?}"; : "${POD_NAME:?}"
kubectl --context "$KUBE_CONTEXT" --request-timeout=15s \
  -n "$NAMESPACE" get pod "$POD_NAME" -o json |
  jq '{
    capturedAt:(now|todateiso8601),
    uid:.metadata.uid,generation:.metadata.generation,
    observedGeneration:.status.observedGeneration,qosClass:.status.qosClass,
    desired:[.spec.containers[] | {name,resources}],
    reported:[.status.containerStatuses[]? |
      {name,started,ready,runningStartedAt:.state.running.startedAt,
       resources,restartCount,containerID}],
    resizeConditions:[.status.conditions[]? |
      select(.type=="PodResizePending" or .type=="PodResizeInProgress")]
  }'
分别评估 G-phase 初始化是否改善、CPU 是否实际缩减、缩减后 SLO 是否保持,以及Spot 回收期间服务是否符合标准。记录所有尚未测量的项目;仅凭 QoS 类别名称不能证明“没有质量问题”。本指南尚未测量启动 CPU 增加后再缩减所产生的影响。
4. 复现 E2:使用 AWS FIS 回收一个 Spot 节点
前置条件
所需工具:Bash、AWS CLI、kubectl 和 jq。
- 确认测试集群以及专用实验 NodePool/MNG。检查目标节点上的所有 Pod,排除业务工作负载和共享控制器,并盘点必需的节点 DaemonSet 及其资源开销。
- 准备经过审查的 FIS 执行角色及一个监控真实服务错误/延迟的 CloudWatch 停止告警。将操作限定到指定实验实例/标签;核实
fis.amazonaws.com信任关系、SourceAccount/SourceArn限制,以及调用方iam:PassRole的范围。S10 - 确认告警收到真实指标且状态为
OK。故障注入前先验证告警状态转换,并记录阈值、评估周期和缺失数据处理方式。 - 在注入前启动带 UTC 时间戳的客户端负载日志,以及 Kubernetes/控制器/LB 观察记录。
确认测试目标后再设置以下 Shell 输入:
export SPOT_PROFILE=''
export SPOT_REGION=''
export SPOT_CLUSTER=''
export SPOT_NODE=''
export SPOT_INSTANCE_ID=''
export SPOT_RUN_ID=''
export SPOT_FIS_ROLE_ARN=''
export SPOT_STOP_ALARM_ARN=''
使用专用 kubeconfig,避免更改工作站的默认 current-context。通过以下只读操作交叉核对集群 ARN、EC2 生命周期、providerID 和 Pod。单凭节点标签不能证明 EC2 容量属于 Spot。
set -euo pipefail
: "${SPOT_PROFILE:?}" "${SPOT_REGION:?}" "${SPOT_CLUSTER:?}"
: "${SPOT_NODE:?}" "${SPOT_INSTANCE_ID:?}" "${SPOT_RUN_ID:?}"
: "${SPOT_FIS_ROLE_ARN:?}" "${SPOT_STOP_ALARM_ARN:?}"
umask 077
SPOT_RESULT_DIR=$(mktemp -d "$PWD/eks-spot-run.XXXXXX")
SPOT_KUBECONFIG="$SPOT_RESULT_DIR/kubeconfig"
spot_aws() { aws --profile "$SPOT_PROFILE" --region "$SPOT_REGION" --output json "$@"; }
spot_kubectl() { kubectl --kubeconfig "$SPOT_KUBECONFIG" "$@"; }

spot_aws eks update-kubeconfig --name "$SPOT_CLUSTER" \
  --kubeconfig "$SPOT_KUBECONFIG" --alias "$SPOT_CLUSTER"
spot_aws sts get-caller-identity > "$SPOT_RESULT_DIR/caller.json"
spot_aws eks describe-cluster --name "$SPOT_CLUSTER" \
  > "$SPOT_RESULT_DIR/cluster.json"
spot_kubectl get node "$SPOT_NODE" -o json \
  > "$SPOT_RESULT_DIR/node-before.json"
spot_kubectl get pods -A --field-selector "spec.nodeName=$SPOT_NODE" -o json \
  > "$SPOT_RESULT_DIR/pods-on-target.json"
spot_aws ec2 describe-instances --instance-ids "$SPOT_INSTANCE_ID" \
  > "$SPOT_RESULT_DIR/instance-before.json"

jq -e --arg id "$SPOT_INSTANCE_ID" \
  '.spec.providerID | endswith("/" + $id)' \
  "$SPOT_RESULT_DIR/node-before.json"
jq -e '[.Reservations[].Instances[]] |
  length == 1 and .[0].InstanceLifecycle == "spot" and .[0].State.Name == "running"' \
  "$SPOT_RESULT_DIR/instance-before.json"
确认 caller.json 和 cluster.json 中的账户、Region、集群都对应指定测试环境,而且目标节点专供本实验使用。将以下 JSON 保存为 $SPOT_RESULT_DIR/fis-template.example.json。执行前,下方命令会用已核验的输入替换示例 ARN。必须保留一个明确的资源 ARN 和 COUNT(1)。
{
  "description": "E2: interrupt one isolated EKS Spot test node",
  "roleArn": "arn:aws:iam::111122223333:role/eks-spot-test-fis",
  "targets": {
    "oneSpotNode": {
      "resourceType": "aws:ec2:spot-instance",
      "resourceArns": ["arn:aws:ec2:ap-northeast-2:111122223333:instance/i-0123456789abcdef0"],
      "selectionMode": "COUNT(1)"
    }
  },
  "actions": {
    "interrupt": {
      "actionId": "aws:ec2:send-spot-instance-interruptions",
      "parameters": {"durationBeforeInterruption": "PT2M"},
      "targets": {"SpotInstances": "oneSpotNode"}
    }
  },
  "stopConditions": [
    {
      "source": "aws:cloudwatch:alarm",
      "value": "arn:aws:cloudwatch:ap-northeast-2:111122223333:alarm:eks-spot-test-slo"
    }
  ]
}
此 FIS 操作会实际中断实例。它还会在开始时发出再平衡建议,因此 E2 不能单独隔离出中断通知的处理效果。不要把 durationBeforeInterruption 当作应用宽限时间;请记录实际事件时间戳。S7、S9
启动前应读回模板并确认目标。不要假定停止告警或 stop-experiment 能取消已经发出的中断请求,或恢复已终止的实例。停止后续注入与恢复服务是两个独立操作。S11
SPOT_ACCOUNT_ID=$(jq -r '.Account' "$SPOT_RESULT_DIR/caller.json")
SPOT_PARTITION=$(jq -r '.Arn | split(":")[1]' "$SPOT_RESULT_DIR/caller.json")
SPOT_INSTANCE_ARN="arn:$SPOT_PARTITION:ec2:$SPOT_REGION:$SPOT_ACCOUNT_ID:instance/$SPOT_INSTANCE_ID"
jq --arg instance "$SPOT_INSTANCE_ARN" \
  --arg role "$SPOT_FIS_ROLE_ARN" --arg alarm "$SPOT_STOP_ALARM_ARN" \
  '.roleArn = $role |
   .targets.oneSpotNode.resourceArns = [$instance] |
   .stopConditions[0].value = $alarm' \
  "$SPOT_RESULT_DIR/fis-template.example.json" > "$SPOT_RESULT_DIR/fis-template.json"

SPOT_TEMPLATE_ID=$(spot_aws fis create-experiment-template \
  --cli-input-json "file://$SPOT_RESULT_DIR/fis-template.json" \
  --query experimentTemplate.id --output text)
spot_aws fis get-experiment-template --id "$SPOT_TEMPLATE_ID" \
  > "$SPOT_RESULT_DIR/template-resolved.json"

# Run after target review and telemetry startup: the test instance is reclaimed.
SPOT_EXPERIMENT_ID=$(spot_aws fis start-experiment \
  --experiment-template-id "$SPOT_TEMPLATE_ID" \
  --tags "RunId=$SPOT_RUN_ID" \
  --query experiment.id --output text)
spot_aws fis get-experiment --id "$SPOT_EXPERIMENT_ID" \
  > "$SPOT_RESULT_DIR/experiment-start.json"
spot_aws fis list-experiment-resolved-targets \
  --experiment-id "$SPOT_EXPERIMENT_ID" \
  > "$SPOT_RESULT_DIR/targets.json"
持续查询 get-experiment,直至实验到达终态,并确认解析出的目标正是预期实例。completed 表示故障操作已完成,不表示服务满足了 SLO。failed、stopped 或目标为空的运行都不能算通过。S7
5. 测量和结果记录
观察时间线
| 时间点 | 证据 |
|---|---|
| T0 | FIS 操作开始及实际解析出的目标 |
| T1 | EventBridge 事件的 time,以及观察方收到/处理事件的时间。仅在可获取时,另行记录来自 IMDS spot/instance-action 或明确控制器来源的大致中断时间 |
| T2 | cordon/taint、开始驱逐、Pod SIGTERM/退出日志 |
| T3 | 目标 EC2 状态变化、创建替换实例、Node Ready |
| T4 | 替换 Pod Ready、EndpointSlice 状态、LB 目标健康 |
| T5 | 连续五分钟满足约定的错误率、延迟和吞吐量标准的起始时间 |
报告 T0 到 T5 的恢复时间,并另行报告从首次违反 SLO 到恢复所需时间。如果服务在整个运行期间都满足标准,则服务停机时间为零;节点/Pod 替换时间仍应单独报告。缺少监测数据不代表恢复时间为零秒。
EventBridge 事件没有独立的计划中断时间字段。IMDS 只能提供近似时间;如果无法采集,应标记为不可用。不要仅为填充该字段而要求访问 Auto Mode 节点。推测出的时间应标明为估算值,并在 T3 记录 EC2 状态的实际变化。S1
在注入前、注入期间和注入后保留 Node/Pod JSON、事件、PDB、EndpointSlice 和 NodePool/MNG 配置。仅在完成后查询一次不够,因为事件会过期,遥测也可能延迟到达。自行管理的 Karpenter 还应添加控制器/SQS 指标,MNG 添加 ASG 活动记录,Auto Mode 则使用其可用的托管事件。
不要仅凭 LB 5xx 指标判断成功。还要纳入客户端连接重置、超时、DNS 故障和响应校验,并识别被重试掩盖的失败。在每个观察窗口内用原始样本或合并后的直方图计算 p99;不要把多个 p99 求平均来当作整体 p99。
实验状态
测量结果见第 7 节和原始数据。未运行或未验证不算通过。测量对象是合成 HTTP 请求;未测试业务数据丢失或重复效果。
| 实验 | 实际范围 | 状态 |
|---|---|---|
| E0 | 三个观察路径上的 120 秒稳定负载 | 运行一次;每条路径成功 2,400 次 |
| E1 | 排空一个专用 Spot 节点;观察 180 秒 | 运行一次;混合路径有 8 次失败 |
| E2 | 通过 FIS 回收一个 Spot 实例;观察 900 秒 | 运行一次;混合路径有 10 次失败 |
| E3 | 并发回收 | 未运行 |
| E4 | 将 Pod selector 改为 On-Demand;观察 240 秒 | 运行一次;实际容量错误后的自动回退仍未验证 |
| E5 | 突然丢失节点或通知送达失败 | 未运行 |
| E6 | 使用 PDB minAvailable: 2 拒绝驱逐,再恢复为 1 | 部分完成;关闭钩子和 AZ 约束变体未运行 |
| E7 | 峰值负载和 HPA 交互 | 未运行 |
| E8 | 业务工作正确性 | 未运行 |
| E9 | 查询实例小时价格 | 仅有价格快照;实际账单和每次成功操作的成本尚未测量 |
| E10 | Spot 下组合测试增加启动 CPU、缩减资源并保持 Guaranteed QoS | 未运行。路线图原型和历史报告是独立证据,并非本指南的 Spot 测量结果 |
将每次运行关联到 假设 → 确认已注入故障 → 观察 → 结论 → 原因 → 修正 → 重新运行 ID。保留失败和排除的运行记录。报告各次运行值、中位数和最差值;披露遗漏通知、采集失败和负载生成器饱和情况。
成本计算
Effective cost =
  actual Spot/On-Demand usage cost
  + additional capacity consumed by replacement overlap and retries
  + allocated EBS, LB, transfer, telemetry, EKS/Auto Mode costs

Cost per successful operation = effective cost / unique successful operations passing correctness checks
Savings = 1 - (B cost per successful operation / A cost per successful operation)不要重复计入已经包含在实际 EC2 费用中的替换容量或重试容量。第二行用于提醒分摊归属,避免遗漏。说明固定/共享 EKS 成本如何分配,并将 FIS 实验费用与持续运营成本分开报告。
将短时运行推算到整月的结果标记为估算值。Spot 折扣本身并不等同于实际节省。对组 A 实际使用的 Savings Plans/RI 折扣及未使用承诺也采用相同核算口径,并根据 Region 和账期对应的账单导出数据核验金额。S12
6. 采用与回滚
决策
| 决策 | 标准 |
|---|---|
| 可以采用 | 通过约定的必测场景,有代表性的负载和正确性证据,成本有所改善,且通过 On-Demand 恢复演练 |
| 有条件采用 | 明确限制、限定工作负载/Spot 占比、评估周期,以及对 Canary 负责的负责人 |
| 暂缓扩大范围 | 必需实验/证据缺失、违反 SLO、工作丢失/重复效果、恢复容量不足或自动回退未经验证 |
先从状态存于外部持久化系统的无状态 API,以及已验证重试/幂等性的工作进程开始。除非单独通过复制/恢复测试,否则不能将同一结论用于依赖法定人数、本地状态或保证优雅关闭的工作负载。还要为集群控制和可观测性功能保留存活容量。
一种示例推广顺序是:测试 → 单服务 Canary → 在已验证范围内扩大。每个阶段都要重新核查实际 Spot vCPU、Pod 和流量占比,以及错误预算的影响。不存在“所有地方默认使用 70% Spot”这样的固定答案。
回滚步骤
- 停止新的故障注入和 Spot 扩容。若 FIS 实验正在运行,请请求
stop-experiment,同时继续观察已经安排的回收所造成的影响。 - 在 GitOps 源中应用已测试的 On-Demand 配置。明确变更的负责人,防止协调流程覆盖临时补丁。
- 检查 On-Demand 限额、子网 IP 余量和 Pod 约束;扩展替换 Deployment。验证 Pod Ready、LB 目标健康和服务 SLO。
- 确认已具备存活容量后,分阶段缩减仅使用 Spot 的 Deployment。只更改 NodePool 允许的容量类型,不会立即迁移现有 Pod。
- 重新检查错误、延迟和工作正确性,并保留证据。只有完成修正并通过复测后才能再次扩大 Spot 使用范围。
清理
先将证据导出到访问受控的持久存储。比较变更前后的清单,并恢复 HPA、PDB、调度和中断处理设置。适当时,取消 E1 中存活节点的 cordon。仅删除本实验创建的 FIS 模板、告警、测试工作负载和专用节点。先调整期望容量,避免节点管理器重新创建资源,并检查剩余 EBS/LB 费用。/tmp 不是持久证据存储。
7. 2026-09-12 的测量结果
环境和解读
在现有 EKS 测试集群中创建了专用命名空间、NodePool 和 EC2NodeClass。FIS 的目标是一个新创建的 Spot 实例。Karpenter Pod 的现有配置在测试前后保持一致。导出证据后删除实验资源,并核实其已清除。
| 项目 | 实际配置 |
|---|---|
| 平台 | EKS 1.36 / kubelet 1.36.3-eks-cb19647,Karpenter 1.4.0 |
| 节点 | arm64 c6g.large,观察到的 AZ ID 为 apne2-az1;开始时有 1 个 On-Demand 和 2 个 Spot 节点 |
| 规格和放置灵活性 | 允许四种实例类型和两个 AZ;所有初始节点都落在同一实例类型和 AZ |
| 应用 | Fortio 1.69.4,镜像摘要固定;Pod requests 为 50m / 64Mi;终止宽限期 30 秒;每 2 秒执行一次 readiness 检查 |
| 放置 | 两个 Spot Pod 使用 hostname 反亲和;PDB minAvailable: 1 |
| 请求 | 每条路径 20 RPS,HTTP GET /,响应体为零字节,每个请求使用新连接,不重试 |
| 测量 | 专用 On-Demand Pod 上的 Python 3.12 探测器,逐请求 JSONL;约每 5 秒观察一次 Kubernetes 状态;单独使用 EventBridge 观察队列 |
| 停止告警 | 混合路径错误率超过 5% 或数据缺失时触发;10 秒周期,需 2/2 个数据点。此阈值与示例中的 0.1% 验收条件不同 |
这些数据并未验证按阶段资源调整。已发布的初始部署模板中三个 Deployment 的 CPU/内存 requests 为 50m/64Mi,limits 为 500m/256Mi。仅这些设置就不满足 Guaranteed 要求。模板没有按阶段 resize 启用设置、resizePolicy 或 startupProbe;已发布测量也没有调整前后的实际资源、QoS 或对比预热性能证据。不要把这份初始模板当作准入处理后 Pod 实际状态的观察结果。E10 需要单独运行。
这也不是对受支持版本配置的验证。已核对的官方兼容性矩阵要求 Kubernetes 1.36 使用 Karpenter 1.13 或更高版本。已安装的 1.4.0 低于此最低版本。升级影响尚未测量。S13
Karpenter 没有配置中断队列。新建的队列仅用于观察,未接入 Karpenter。不要把这些结果推广到已配置中断处理队列的 Karpenter 环境。
按需对照组有三个 Pod;混合路径有一个 On-Demand Pod 和两个 Spot Pod。Spot 观察路径与混合路径选择的是同两个 Spot Pod。对照 Pod、混合路径中的稳定 Pod 和探测器共用一个 On-Demand 节点,因此这些并不是彼此独立的成本或吞吐量对照组。E4 原始文件名 spot-only 指正在迁移的 Service;切换后它选择的是 On-Demand Pod。
请求结果
每个场景只运行一次。每条路径都发出了全部计划请求,负载生成器没有跳过请求。失败包括连接错误和 socket 超时,以及 HTTP 错误。p99 使用所有已完成延迟的原始样本,通过 nearest rank 计算,其中也包括失败请求。
| 试验 / 路径 | 请求数 | 失败数 | 总错误率 | 整体 p99 | 最差 60 秒错误率 |
|---|---|---|---|---|---|
| E0 / On-Demand 对照 | 2,400 | 0 | 0% | 3.41 ms | 0% |
| E0 / 混合路径 | 2,400 | 0 | 0% | 4.90 ms | 0% |
| E0 / Spot 观察路径 | 2,400 | 0 | 0% | 3.91 ms | 0% |
| E1 / On-Demand 对照 | 3,600 | 0 | 0% | 5.93 ms | 0% |
| E1 / 混合路径 | 3,600 | 8 | 0.2222% | 3.30 ms | 0.5833% |
| E1 / Spot 观察路径 | 3,600 | 1 | 0.0278% | 5.11 ms | 0.0833% |
| E2 / On-Demand 对照 | 18,000 | 0 | 0% | 5.17 ms | 0% |
| E2 / 混合路径 | 18,000 | 10 | 0.0556% | 5.63 ms | 0.8333% |
| E2 / Spot 观察路径 | 18,000 | 5 | 0.0278% | 5.09 ms | 0.4167% |
| E4 / On-Demand 对照 | 4,800 | 0 | 0% | 5.60 ms | 0% |
| E4 / 混合路径 | 4,800 | 9 | 0.1875% | 6.20 ms | 0.5833% |
| E4 / 迁移组 | 4,800 | 16 | 0.3333% | 6.99 ms | 1.3333% |
最差 60 秒错误率按完整观测的 60 秒窗口、每秒滑动一次计算;不包含末尾不完整窗口。E2 混合路径总错误率为 0.0556%,p99 为 5.63 ms,但最差 60 秒错误率为 0.8333%,超过预先写下的设计示例标准 0.1%。这只是诊断标准,不是业务服务约定的 SLO。
E1 和 E4 也出现了失败请求。排空或滚动发布完成,不代表切换期间没有错误。从首个失败请求开始到最后一个失败请求完成的时间跨度,既不是连续停机时间,也不是服务恢复时间。原始记录保留了所有失败,包括发生在其他时段的失败。
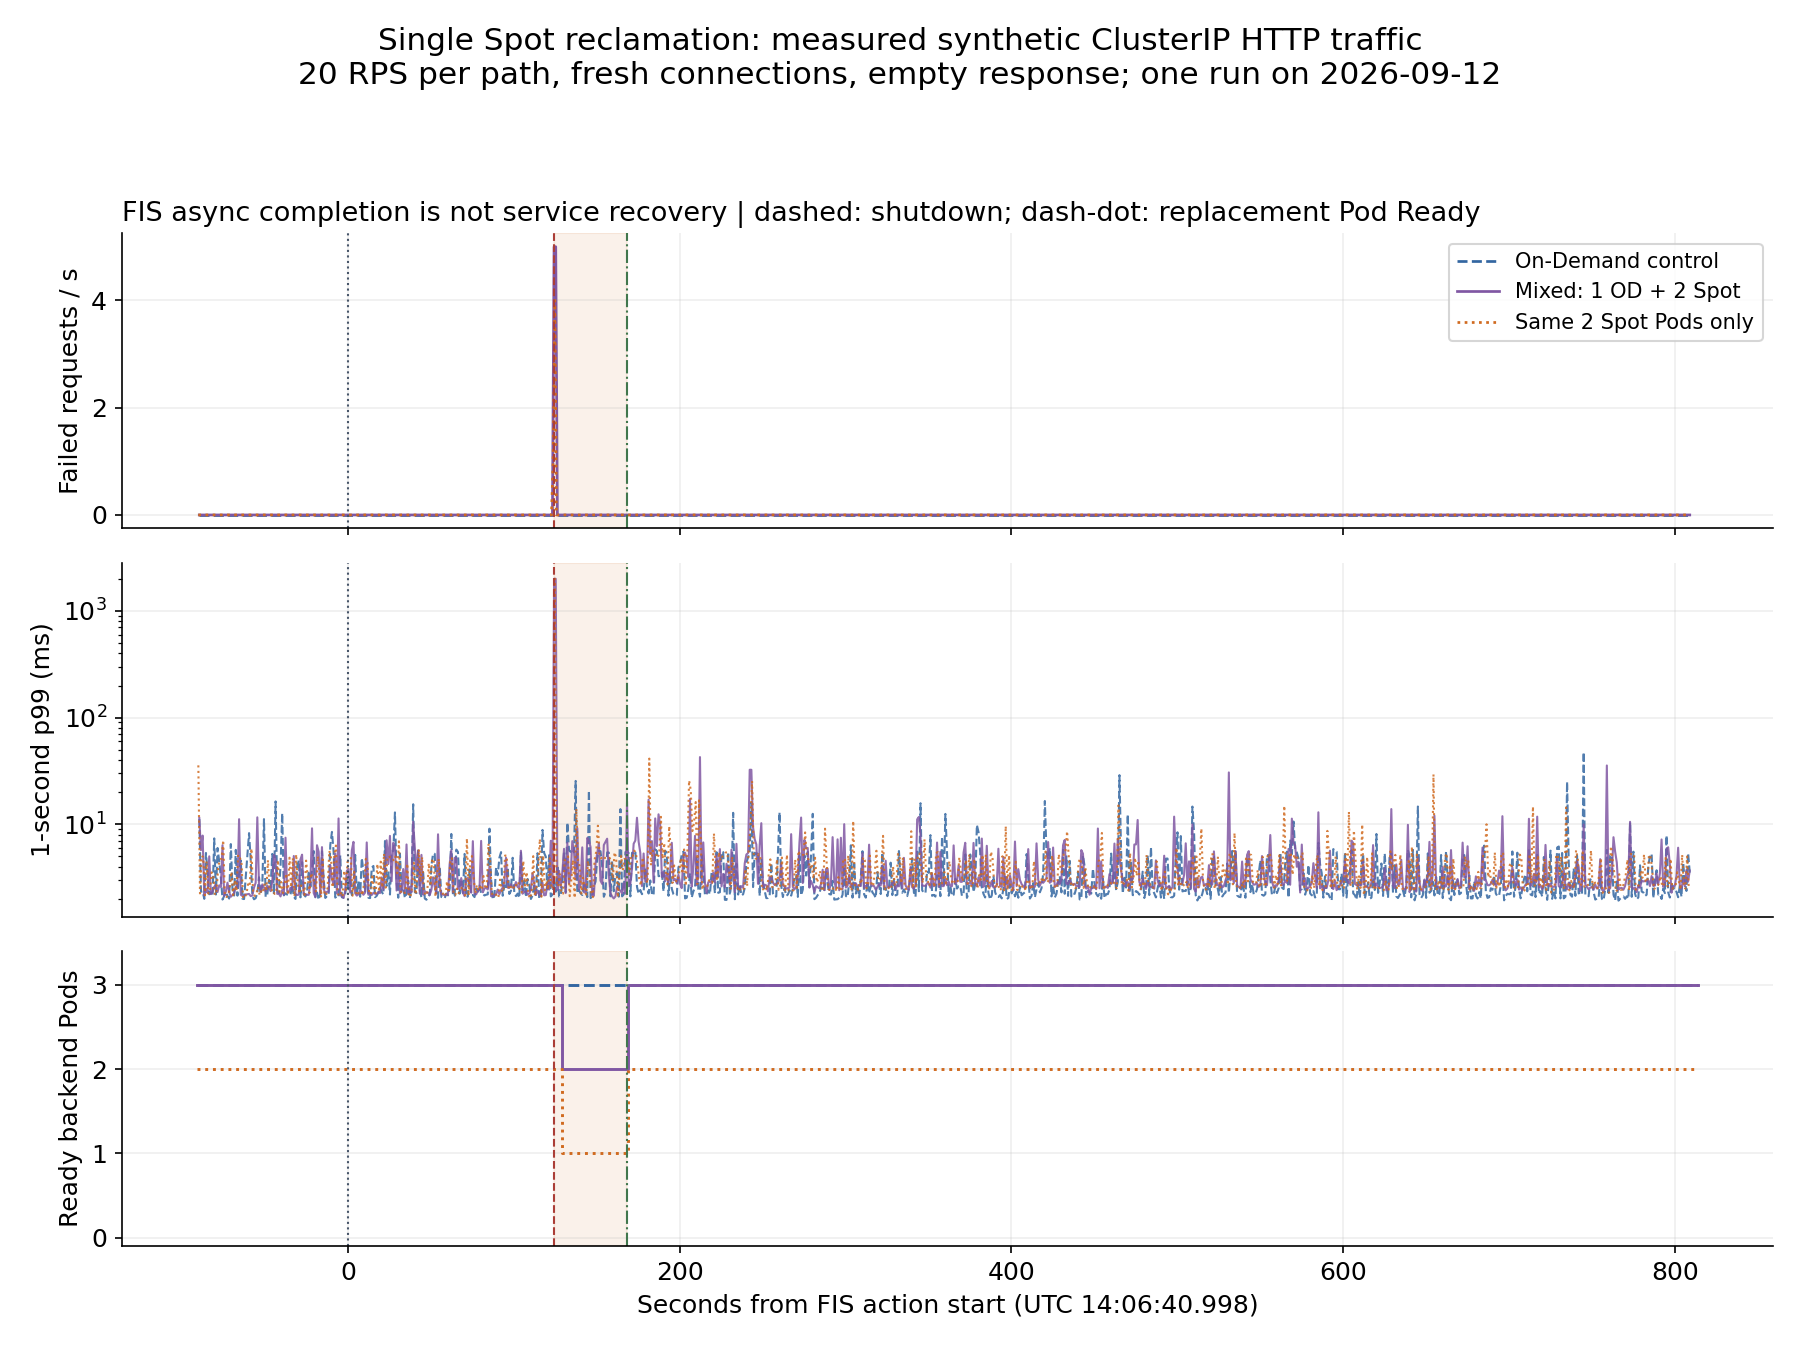
图中覆盖 E2 的完整观察窗口。延迟纵轴为对数刻度,采样率约为每秒 20 个请求。不能把 1 秒 p99 与整体 p99 等同。阴影范围从报告的节点关闭时间到替换 Pod Ready;它不代表服务总停机时间。
回收时间线
| 观察项 | UTC 时间 | 证据 |
|---|---|---|
| FIS 操作开始 | 14:06:40.998 | FIS startTime |
| 中断通知 | 14:06:41 | EventBridge 事件 time |
FIS completed | 14:06:41.755 | FIS endTime,与服务恢复时间不同 |
| kubelet 报告关闭 / 原 Pod 终止 | 14:08:45 | KubeletNotReady、TerminationByKubelet |
| 创建替换 NodeClaim | 14:08:48.212 | Karpenter 控制器日志 |
| 替换节点 Ready | 14:09:23 | Node 条件 |
| 替换 Pod Ready | 14:09:29 | Pod 条件 |
通知送达后、回收之前的观察结果显示目标仍可调度。替换 NodeClaim 是在节点关闭后创建的。替换 Pod 在报告的节点关闭后 44 秒才 Ready。这不等同于服务恢复时间,也不表示连续停机了 44 秒。kubelet 状态证明了 Pod 终止,但没有单独采集应用收到 SIGTERM 的时间。应考虑 API 采样间隔和精确到秒的事件时间戳。
切换、定价和决策
明确切换到 On-Demand 的滚动发布在 47.05 秒内完成。实际节点标签确认两个迁移中的 Pod 都位于 On-Demand 容量上。没有注入 EC2 容量错误,因此自动回退仍未验证。
在 2026-09-12 14:08:41 UTC 执行的价格查询显示,公开 On-Demand Linux c6g.large 价格为每实例小时 $0.077,观察 AZ 内 Spot 价格为每实例小时 $0.0248。单位价格差异为 67.79%,这不代表实际账单或工作负载成本节省。还应比较 EBS、EKS、FIS、遥测、承诺用量、重试、替换容量和等效可用性要求。
扩大生产使用范围之前:
- 根据 Kubernetes 兼容性矩阵调整 Karpenter,并验证 CRD、IAM 和升级路径。
- 配置实际的 Karpenter 中断队列、EventBridge 和 IAM 路径,再次执行回收测试。仅由观察队列收到事件还不够。
- 针对请求 SLO 测试应用关闭、readiness 传播、客户端重试策略和外部 LB 路径。
- 验证存活的 On-Demand 容量、AZ 放置、真实容量错误回退和并发回收。
- 获取有代表性的业务负载、正确性检查、不同时间的重复运行和实际成本证据。
已删除实验命名空间、两个 NodePool、EC2NodeClass、新实例配置文件、FIS 模板/角色、告警、EventBridge 规则和 SQS 队列。已核实没有遗留的实验 EC2 实例、EBS 卷或 Kubernetes 资源。历史 FIS 执行记录和指标数据仍依照 AWS 服务保留策略留存。
可查阅测量工具和测试,以及原始请求记录、摘要和时间线。公开证据不会披露账户、节点和网络标识符;详细基础设施原件另行保留。
8. 相关指南和来源
- 扩缩容策略
- Kubernetes 版本路线图:MAP 和按阶段缩减 CPU
- Go 按阶段资源调整来源:四种工作负载映射和实验报告结果(Notion)
- 事件容量规划
- FinOps 成本管理
- 故障排查手册
- 本指南测验
官方文档用于支持有关服务行为的说明,并不证明此仓库实际运行过某项实验。现有 S1–S13 链接核查于 2026-09-12;新增 S14–S17 链接核查于 2026-09-14。
N1 是在 2026-09-14 提供并阅读的实现/实验报告,并非 Kubernetes 官方规范,也不是新的 Spot 测量结果。