第 2 部分:部署可观测性技术栈
难度: 高级 最后更新: September 13, 2026 将 service 集群的应用与 management 集群的 metrics(指标)、logs(日志)和 traces(链路追踪)连接起来。请使用技术栈示例中已固定版本的 chart/TLS/身份文件。第 1 部分必须已经提供 context、gp3/EBS CSI、LBC、DNS/路由、IRSA 以及
helm-inputs/collector-identity.yaml。
1. 版本与基线路径
| Component | Chart | Application |
|---|---|---|
| kube-prometheus-stack | 90.0.0 | Operator0.93.1; inspect component images |
| Tempo | 3.0.0 | 3.0.3 |
| Loki | 18.13.0 | 3.7.7 |
| OTel Collector | 0.173.1 | contrib0.160.0 |
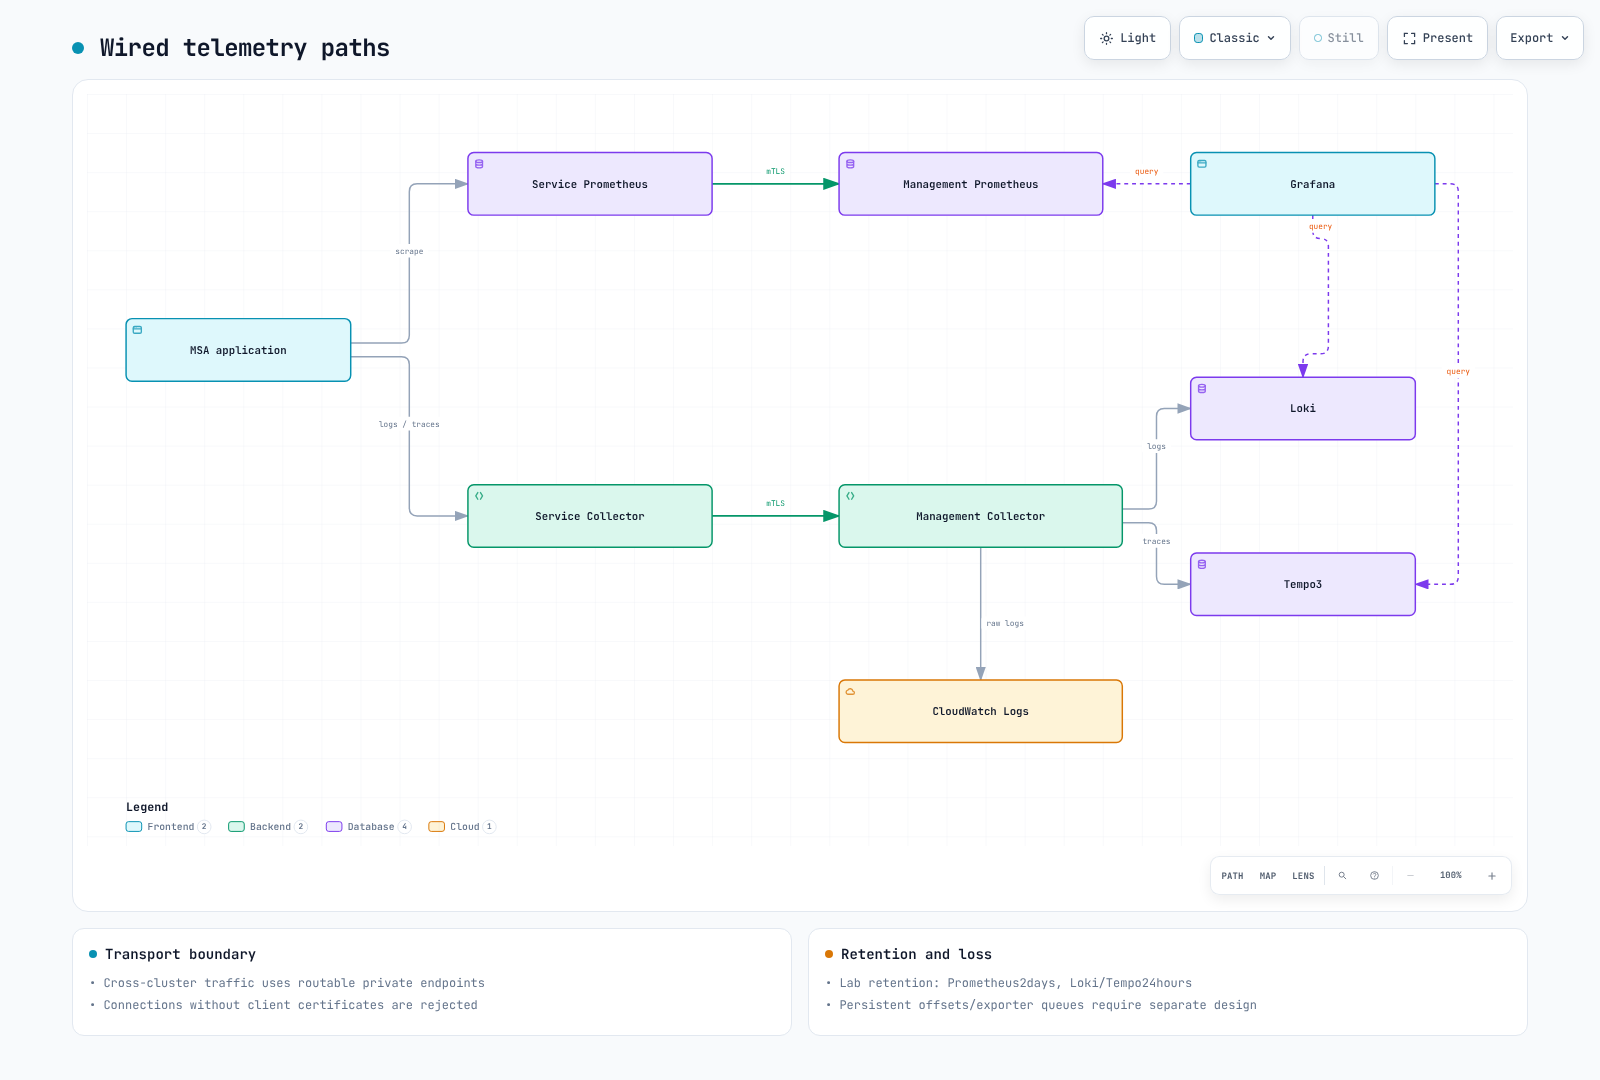
Service 端的 Prometheus 抓取 metrics,并通过 mTLS remote-write 发送到 management 端的 Prometheus。Collector 接收 CRI/JSON 日志和 OTLP traces,转发到需要认证的 management 端点。Management Collector 将数据发送到 Loki/Tempo;CloudWatch addon 为 AIOps 提供结构化日志。Grafana 的 UID 统一使用 prometheus、loki 和 tempo。
后端均为单实例、带持久化的实验用实例,既不是高可用(HA)配置,也未经过容量实测。Prometheus 保留两天、Loki/Tempo 保留 24 小时的设置并不能构成 30 天的 SLO。
2. 私有 TLS 与网络输入
cd examples/labs/observability/stack
python3.12 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/python prepare_tls.py   --collector-dns "$COLLECTOR_DNS" --prometheus-dns "$PROMETHEUS_DNS"   --output-directory "$LAB_STATE/tls"
.venv/bin/python render_network.py --service-source-cidr "$SERVICE_SOURCE_CIDR"   --nlb-security-group "$NLB_SECURITY_GROUP"   --nlb-source-cidr "$NLB_SUBNET_CIDR_A" --nlb-source-cidr "$NLB_SUBNET_CIDR_B"   --output-directory "$LAB_STATE/network"
生成有效期为七天的实验用 CA,以及用途分离的 server/client 证书。CA 私钥绝不会进入集群的 Secret。若使用组织的 PKI,则必须提供匹配的 Secret key、SAN 和 EKU。该辅助脚本不会创建任何 DNS、路由或 SG;请使用真实的服务来源 CIDR 和 NLB 健康检查子网 CIDR。
kubectl --context managed create namespace monitoring --dry-run=client -o yaml | kubectl --context managed apply -f -
kubectl --context service create namespace monitoring --dry-run=client -o yaml | kubectl --context service apply -f -
kubectl --context service create namespace observability --dry-run=client -o yaml | kubectl --context service apply -f -
kubectl --context managed apply -f "$LAB_STATE/tls/management-secrets.yaml"
kubectl --context service apply -f "$LAB_STATE/tls/service-monitoring-secrets.yaml"
kubectl --context service apply -f "$LAB_STATE/tls/service-observability-secrets.yaml"
3. 安装 management 端后端
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo add grafana-community https://grafana-community.github.io/helm-charts
helm repo add open-telemetry https://open-telemetry.github.io/opentelemetry-helm-charts
kubectl --context managed apply -f prometheus-probe.yaml
helm upgrade --install lab-monitoring prometheus-community/kube-prometheus-stack   --version 90.0.0 --kube-context managed -n monitoring -f monitoring-management-values.yaml
helm upgrade --install lab-loki grafana-community/loki --version 18.13.0   --kube-context managed -n monitoring -f loki-values.yaml
helm upgrade --install lab-tempo grafana-community/tempo --version 3.0.0   --kube-context managed -n monitoring -f tempo-values.yaml
Prometheus 的 web 接口要求 mTLS,因此默认的 kubelet HTTPS 探针无法提供客户端证书。请使用 promtool check ready/healthy --http.config.file=... 形式的 exec 探针与客户端 Secret;Operator 的探针合并行为已经过验证。Grafana 和 Tempo 的 metrics-generator 同样使用客户端证书。
Loki 采用 Monolithic/TSDB-v13/filesystem-PVC 配置。Tempo 3 使用 live-store/backend scheduler/worker,而不是混用 Tempo 2 的 ingester/compactor 设置。Grafana 使用单个 replica、PVC 以及私有的 admin Secret,而非众所周知的共享密码。Grafana 关闭了未使用的 dashboard sidecar、API token 和 RBAC;datasource 文件仍从指定的 Secret 挂载。
4. Collector、端点与 service 端采集
helm upgrade --install lab-collector open-telemetry/opentelemetry-collector   --version 0.173.1 --kube-context managed -n monitoring   -f collector-management-values.yaml -f collector-cloudwatch-values.yaml   -f "$LAB_STATE/helm-inputs/collector-identity.yaml"
kubectl --context managed apply -f backend-network-policies.yaml
kubectl --context managed apply -f "$LAB_STATE/network/endpoints.yaml"
kubectl --context managed -n monitoring get svc lab-collector-ingest lab-prometheus-ingest
将私有 DNS 映射到真实的内部 NLB 主机名,并在继续之前验证 Service 到 Pod 的路由、SG/NACL 以及客户端 IP 的行为。不要使用其他集群的 .svc.cluster.local 地址。TLS 在 Collector/Prometheus 处终止,通过 TCP NLB 保留了客户端认证。
helm upgrade --install lab-service-monitoring prometheus-community/kube-prometheus-stack   --version 90.0.0 --kube-context service -n monitoring   -f monitoring-service-values.yaml -f "$LAB_STATE/tls/prometheus-endpoint-values.yaml"
helm upgrade --install lab-agent open-telemetry/opentelemetry-collector   --version 0.173.1 --kube-context service -n observability   -f collector-service-values.yaml -f "$LAB_STATE/tls/collector-endpoint-values.yaml"
Service 端的 DaemonSet 通过只读挂载读取 msa Pod 的日志。为访问节点日志,明确指定了 root UID、丢弃 capabilities 和禁止权限提升;在该 namespace 的准入策略中只允许这个 collector。CRI 解析先于 JSON 解析执行,并在源集群中附加 Kubernetes metadata。Management Collector 无法凭空查询其他集群的 Pod。
本实验不会持久化文件 offset 与 exporter 队列;请记录重启/中断期间可能出现的丢失或重复,并另行设计持久化缓冲方案。CloudWatch 的 raw_log: true 会保留 service/level/trace_id;请验证真实的 IRSA 与 Logs 权限。
5. 验证数据并谨慎扩展
kubectl --context managed -n monitoring get pods,pvc
kubectl --context service -n observability get pods
kubectl --context managed -n monitoring port-forward svc/lab-grafana 3000:80
使用私有 admin Secret 登录。在第 3 部分部署应用之后,对比实际的抓取情况、exporter 错误、CloudWatch JSON 字段、Tempo trace ID、Loki trace_id 以及 exemplar。仅仅存在一个 datasource 或启用了某个 UI 选项,并不能证明数据已被接收。
VictoriaMetrics/Mimir/AMP、ClickHouse/OpenSearch、X-Ray、AMG 和 MWAA 属于可选扩展。在引入之前,请参考各自的metrics、logging和tracing指南,验证认证、存储、传输与成本。该基线并不声称能够同时部署所有后端。请继续阅读第 3 部分。
验证范围
验证覆盖了 chart/CRD/原生配置、本地 Collector 实际的 mTLS/CRI/JSON 转发、Prometheus mTLS 探针、合成 PKI 以及 NetworkPolicy schema。未执行真实的 EKS/LBC/DNS、策略强制、IRSA 以及 Grafana 实时 datasource 查询。
DaemonSet 配置会显式创建 lab-agent.observability.svc.cluster.local:4318 Service。其默认的 internalTrafficPolicy: Local 要求每个应用节点上都有就绪的 Collector;请检查 taint、toleration 与 DaemonSet 的就绪状态。