第 2 部分:Helm 部署和执行器选择
审查基线:chart 1.22.0 / Airflow 3.3.1 / KEDA 2.20 已检查的上游最新补丁版本:Airflow 3.3.2;chart 示例仍基于 3.3.1 · 2026 年 10 月 12 日
1. Chart 标识和实际默认值
本指南使用 Apache Airflow 仓库中的官方 chart。注册仓库别名 apache-airflow 后,Helm chart 名称为 apache-airflow/airflow。不要将它与 airflow-helm/charts 等独立 chart 中的 values 混用;它们并不是唯一存在的 chart。
Chart 1.22.0 默认使用 Airflow 3.2.2 和 CeleryExecutor,不是 KubernetesExecutor。示例会显式统一 image tag 和 airflowVersion 为 3.3.1,并选择执行器。版本字段不匹配或覆盖 digest 可能导致 chart 生成的配置与实际镜像不一致。
请使用 Helm 3.19.0 或更高版本。尽管打包的 README 中仍保留较旧的 Helm 3.0+ 说法,但 release 变更记录将 3.19.0 列为最低版本。Airflow 3.3.1 测试过的 Kubernetes 版本为 1.30–1.35。Chart 1.16.0 的 README 曾指定 1.29+,因此它并未引入 1.30+ 要求。不要假设 Chart.yaml 会强制执行所有文档中的最低版本要求:审查期间,模板可以针对 1.29 完成渲染,但这并不能证明其受支持。
2. 准备 Connection 和 Secret
本实验假设已准备好命名空间权限、外部 PostgreSQL 数据库以及 EKS 网络 / 容量。请准备数据库 schema / 用户、迁移权限、已测试的连接 URI / TLS 和备份 / 保留策略。只有在使用 Celery 扩缩配置时才需要 KEDA。
以下 values 引用 Secret,而不是嵌入密码。请将数据库 URI 作为单行写入受保护文件,并对密码和其他字段中的保留字符进行 URI 编码。对于 RDS 或其他远程数据库,请使用已验证的 TLS。任何 sslrootcert 路径都必须能被实际数据库客户端读取。KEDA 也会连接数据库:仅为 Airflow 配置 CA、DNS、网络和访问权限并不足够。chart 不会自动把 CA 文件复制到 KEDA。
以下是全新安装流程,不会覆盖现有 Secret。日常升级时不要重新生成 Fernet / API / JWT 密钥;备份和轮换应单独管理。
set -euo pipefail
# Fresh installation only. Keep existing Fernet/API/JWT keys during an ordinary upgrade.
# AIRFLOW_DB_URI_FILE contains the tested, single-line PostgreSQL URI; do not commit it.
: "${AIRFLOW_DB_URI_FILE:?Set the path to your protected database connection file}"
kubectl create namespace airflow --dry-run=client -o yaml | kubectl apply -f -
kubectl -n airflow create secret generic airflow-metadata \
  --from-file="connection=$AIRFLOW_DB_URI_FILE"

umask 077
AIRFLOW_SECRET_TMP_DIR="$(mktemp -d)"
trap 'rm -rf "$AIRFLOW_SECRET_TMP_DIR"' EXIT
python3 - "$AIRFLOW_SECRET_TMP_DIR" <<'PY'
import base64
from pathlib import Path
import secrets
import sys
folder = Path(sys.argv[1])
(folder / "fernet-key").write_text(base64.urlsafe_b64encode(secrets.token_bytes(32)).decode())
(folder / "api-secret-key").write_text(secrets.token_urlsafe(48))
(folder / "jwt-secret").write_text(secrets.token_urlsafe(48))
PY
kubectl -n airflow create secret generic airflow-fernet \
  --from-file="fernet-key=$AIRFLOW_SECRET_TMP_DIR/fernet-key"
kubectl -n airflow create secret generic airflow-api-secret \
  --from-file="api-secret-key=$AIRFLOW_SECRET_TMP_DIR/api-secret-key"
kubectl -n airflow create secret generic airflow-jwt \
  --from-file="jwt-secret=$AIRFLOW_SECRET_TMP_DIR/jwt-secret"
设置 metadataSecretName 后,metadataConnection 就不是权威的连接来源。仅禁用内置 PostgreSQL 并不会配置外部数据库。若 Airflow 和 KEDA 共用 PostgreSQL URI,应验证使用两者都理解的 scheme,例如 postgresql://;KEDA 可能不支持 SQLAlchemy 专用的 +driver scheme。
3. 显式安装 KubernetesExecutor
另存为 kubernetes-values.yaml。此实验禁用了 triggerer 持久化;临时本地日志不是持久历史。第 3 部分准备 DAG 交付,第 5 部分介绍远程日志 / 存储。生产使用前应验证 task 结束后的日志访问。
airflowVersion: 3.3.1
defaultAirflowTag: 3.3.1
executor: KubernetesExecutor
postgresql:
  enabled: false
redis:
  enabled: false
data:
  metadataSecretName: airflow-metadata
  metadataConnection:
    protocol: postgresql
fernetKeySecretName: airflow-fernet
apiSecretKeySecretName: airflow-api-secret
jwtSecretName: airflow-jwt
createUserJob:
  enabled: false
triggerer:
  persistence:
    enabled: false
config:
  core:
auth_manager: airflow.providers.fab.auth_manager.fab_auth_manager.FabAuthManagerhelm repo add apache-airflow https://airflow.apache.org
helm repo update apache-airflow
helm install airflow apache-airflow/airflow \
--namespace airflow --version 1.22.0 \
--values kubernetes-values.yaml --wait --timeout 10m
kubectl -n airflow get deployments,statefulsets,pods,jobs
helm list -n airflow--wait 成功或 Pod 处于 Running 状态,都不能证明 DAG 已执行成功。应确认迁移 Job 成功且长期运行组件已 Ready,然后使用第 3 部分的冒烟 DAG 检查 worker 启动、Execution API 通信、结果和日志。
初始用户
默认的 createUserJob 可以创建 admin/admin,因此此配置关闭了该功能。当前 values 位于 createUserJob.defaultUser;webserver.defaultUser 是兼容路径。不要将密码写入 values.yaml 或 Helm --set;应针对选定的 FAB auth manager 使用以下交互式命令。其他 auth manager 或 SSO 需要各自的用户管理流程。
# FAB auth manager, as selected in these values. Password is prompted twice.
kubectl -n airflow exec -it deployment/airflow-api-server -c api-server -- \
  airflow users create --username airflow-admin --role Admin \
  --email admin@example.com --firstname Airflow --lastname Admin
kubectl -n airflow port-forward --address 127.0.0.1 service/airflow-api-server 8080:8080
启用 port-forward 后,可通过本地 8080 端口查看 UI。生产访问需要合适的身份验证 / 授权 / TLS 路径;该命令不会创建公共 endpoint。API 和 task-JWT Secret 作用不同,需要稳定的生命周期管理。丢失或随意替换 Fernet 密钥可能使现有的加密 Connection / Variable 无法读取。
4. 根据工作负载和运维情况选择执行器
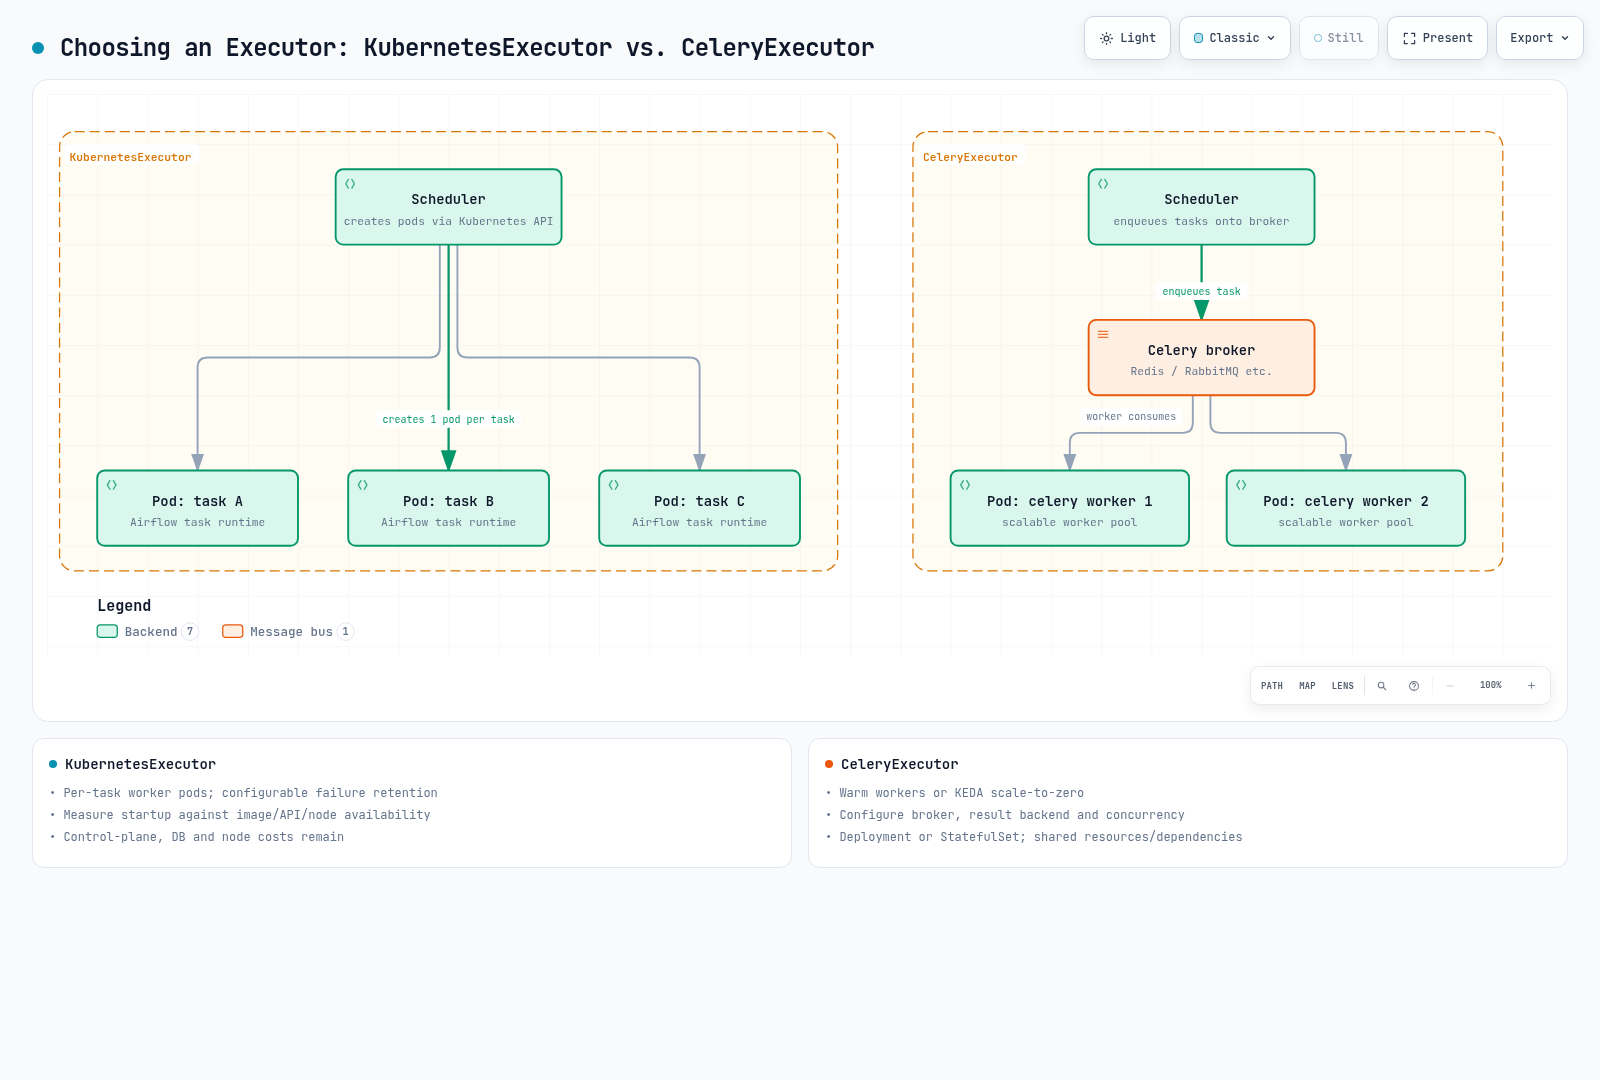
| 方面 | KubernetesExecutor | CeleryExecutor |
|---|---|---|
| Worker 单位 | 每个 task instance 一个 Pod | 从 broker 获取作业的 worker pool |
| 启动 | 测量镜像缓存、API / scheduler 延迟和节点可用性 | 预热容量可以缩短启动时间;扩缩到零会再次引入冷启动 |
| 空闲成本 | control plane、数据库、节点和日志仍会产生成本 | 除 worker 数量外,broker、数据库和节点成本仍然存在 |
| 资源 / 隔离 | 取决于 Pod spec、配额、service account、网络和节点 | 并发 task 会共享 worker 资源 / 依赖项 |
| 额外要求 | Task 运行时 / 镜像、DAG 交付和 Kubernetes API 权限 | broker、result backend、worker 生命周期、队列和并发度 |
不要假设启动时间固定为 1–2 分钟,或某种执行器在所有高流量场景下都更好。KubernetesExecutor worker 镜像需要兼容的 Airflow task runtime 和 DAG 依赖项,不能使用任意 GPU / CLI 镜像。KubernetesPodOperator 会以工作负载镜像创建单独的子 Pod,是另一条路径。失败 Pod 的保留 / 删除也取决于 provider 配置。
支持并行使用多个执行器,但多数部署并不必须混合运行。应根据实际工作负载,比较单一执行器的简洁性和混合方案的实测收益与额外策略。
5. 扩缩 Celery worker
首先准备外部 broker 和 result backend。这些 Secret 只供 Celery 配置使用;应针对实际服务验证协议、TLS 和权限。Celery SQLAlchemy 数据库 result backend 使用诸如 db+postgresql:// 的 URI,因此不要盲目复制 metadata 连接 URI。
# Use protected URI files for the chosen external broker and result backend.
: "${AIRFLOW_BROKER_URI_FILE:?Set the protected broker URI file}"
: "${AIRFLOW_RESULT_URI_FILE:?Set the protected Celery result-backend URI file}"
kubectl -n airflow create secret generic airflow-broker \
  --from-file="connection=$AIRFLOW_BROKER_URI_FILE"
kubectl -n airflow create secret generic airflow-result-backend \
  --from-file="connection=$AIRFLOW_RESULT_URI_FILE"
另存为 celery-values.yaml,它是一份独立的完整配置。新部署时,应在安装命令中选择此文件。切换现有活跃部署需要排空、迁移和恢复计划。
airflowVersion: 3.3.1
defaultAirflowTag: 3.3.1
executor: CeleryExecutor
postgresql:
  enabled: false
redis:
  enabled: false
data:
  metadataSecretName: airflow-metadata
  metadataConnection:
    protocol: postgresql
  brokerUrlSecretName: airflow-broker
  resultBackendSecretName: airflow-result-backend
fernetKeySecretName: airflow-fernet
apiSecretKeySecretName: airflow-api-secret
jwtSecretName: airflow-jwt
createUserJob:
  enabled: false
triggerer:
  persistence:
    enabled: false
config:
  core:
    auth_manager: airflow.providers.fab.auth_manager.fab_auth_manager.FabAuthManager
  celery:
    worker_concurrency: 4
workers:
  celery:
    persistence:
      enabled: false
    keda:
      enabled: true
      minReplicaCount: 0
      maxReplicaCount: 20
      pollingInterval: 10
      cooldownPeriod: 300
      advanced:
        horizontalPodAutoscalerConfig:
          behavior:
            scaleDown:
              stabilizationWindowSeconds: 300
Concurrency=4 和 maxReplicaCount=20 是示例上限,并非吞吐量或成本保证。应同时调优 worker 资源、task 内存、数据库 / broker 负载和节点上限。当 persistence=false 时,此配置生成 Deployment;persistence=true 时可能生成 StatefulSet,KEDA 也支持 StatefulSet。
实际 chart 默认值为 pollingInterval=5s 和 cooldownPeriod=30s。示例显式选择 10s / 300s。Cooldown 控制扩缩到零;应将其与高于零时的 HPA polling / stabilization 区分开。实际数据库轮询还取决于 KEDA 活动、HPA 请求和指标缓存,而不是固定为普遍适用的 10 秒间隔。
此配置会渲染以下 PostgreSQL 查询:
SELECT ceil(COUNT(*)::decimal / 4) FROM task_instance WHERE (state='running' OR state='queued') AND queue IN ('default')worker_concurrency 并不是数据库字段:chart 会插入数字 4。该查询统计此 worker 队列中运行 / 排队的工作,并据此计算所需副本。查询结果为 25 时,仍会受 maxReplicaCount=20 限制,因此可能保留积压。不要把查询或身份验证错误解释为零工作;应检查 ScaledObject / HPA 状态。
混合执行器和别名
混合使用执行器时,应排除 Celery 不会执行的工作。chart 默认查询会排除字面值 KubernetesExecutor,但存储为 k8s 等别名的值仍可能被统计。TaskInstance 会保留 task.executor 值。
以下示例查询覆盖假设默认 CeleryExecutor 与 KubernetesExecutor 并存。更改队列、别名或完整类名时,应根据实际存储值更新筛选条件。此配置中,NULL 表示默认 Celery executor。
executor: CeleryExecutor,KubernetesExecutor
workers:
  celery:
    keda:
      query: >-
        SELECT ceil(COUNT(*)::decimal / {{ .Values.config.celery.worker_concurrency }})
        FROM task_instance
        WHERE state IN ('running', 'queued')
        AND queue = 'default'
        AND (executor IS NULL OR executor = 'CeleryExecutor')
将此片段合并到完整的 Celery 配置中;变更部署前,应检查渲染出的 SQL 和目标。KubernetesExecutor task Pod 并不是按同样方式扩缩的副本池。Karpenter / Cluster Autoscaler 提供的节点容量、Airflow parallelism / pools / DAG concurrency 和 API 吞吐量是不同的限制。这并不意味着 KEDA 只支持 Deployment,或不能用于包含 KubernetesExecutor 的环境。
6. 验证和资源生命周期
kubectl -n airflow rollout status deployment/airflow-api-server --timeout=180s
kubectl -n airflow rollout status deployment/airflow-scheduler --timeout=180s
kubectl -n airflow rollout status deployment/airflow-dag-processor --timeout=180s
kubectl -n airflow get jobs
kubectl -n airflow logs deployment/airflow-scheduler -c scheduler --tail=100
kubectl -n airflow logs deployment/airflow-dag-processor -c dag-processor --tail=100
# Celery/KEDA profile only:
kubectl -n airflow get scaledobjects,hpa
kubectl -n airflow describe scaledobject airflow-worker
kubectl -n airflow get deployments,statefulsets -l component=worker
只访问一次 UI 或看到 Deployment 健康,并不能同时验证迁移、DAG 交付、task 执行、远程日志和缩容到零。应提交已知任务,检查 worker 数量 / 结果 / 日志,然后测试回到空闲状态和恢复能力。
此配置不使用内置 PostgreSQL。chart 默认使用较旧的 bitnamilegacy PostgreSQL 镜像;默认安装并不是生产基线。Helm uninstall 移除数据库 Pod 后,PVC / PV 数据不一定会立即删除。应分别检查 PVC 保留策略、StorageClass reclaim policy、外部数据库删除和备份;不要不加区分地删除命名空间、Secret 和数据库。
本次审查检查了 chart / KEDA 资源结构、公共镜像清单,并在实际 PostgreSQL 引擎中验证了 24 种 SQL 情况。未建立 EKS / 数据库连接、运行容器工作负载、创建用户或执行 KEDA controller 扩缩。