用于 LLM 服务的推理框架
审查基线:于 2026 年 9 月 12 日检查官方发布版本、API、图表和本地检查;未执行 GPU/Neuron 模型。 最后更新:2026 年 10 月 12 日
分别选择推理引擎、分布式执行层、Kubernetes 控制器和提供商网关。“OpenAI-compatible”并不表示端点、字段、流式传输、工具调用或身份验证完全相同。
推理框架概览
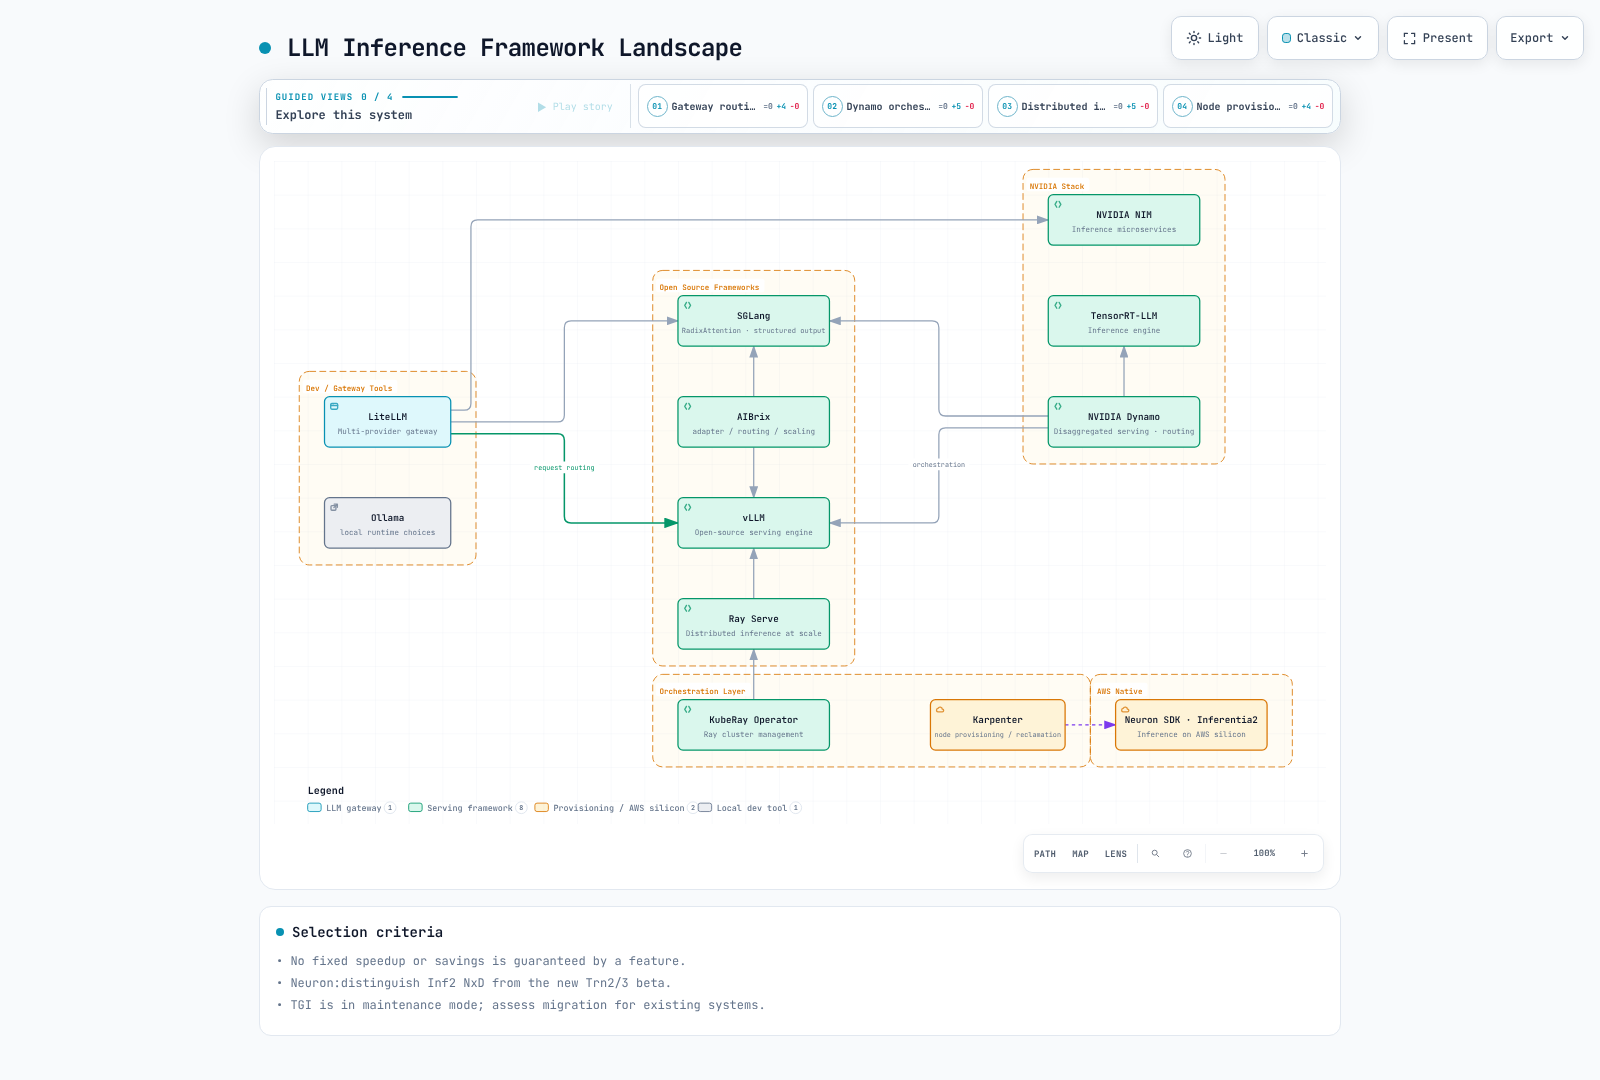
| 组件 | 已检查的基线 | 选择检查项 |
|---|---|---|
| NIM LLM/VLM | 2.0.12 文档;独立的 3.0 产品 | 模型、配置文件、硬件、支持协议和后端 |
| Dynamo | 1.4.2 | 聚合式/解耦式服务、KV 传输、规划器和控制器 |
| AIBrix | 0.7.0 | Envoy Gateway、适配器/控制器和自动扩缩容 |
| SGLang | 0.5.19 | 模型、语法后端、设备和测量的工作负载 |
| vLLM / Ray Serve | vLLM 0.29.0 / Ray 2.58.0 / KubeRay 1.7.0 | 单独验证的镜像/模型/控制器组合 |
| TGI | 3.3.7;维护模式 | 现有系统维护和迁移规划 |
| Ollama | 0.34.0 | 本地 API 访问、模型存储和准备 |
| LiteLLM | 1.100.1 | 提供商适配、身份验证、回退和成本度量 |
| Neuron | SDK 2.32.0;Helm 1.10.0 | 特定实例的插件/编译器/驱动程序兼容性 |
vLLM 0.31.0 于 2026 年 10 月 5 日发布,晚于表中现有的 0.29.0 本地验证基线。表中的版本标识已检查的组合;并不声称它们是最新版本或一组相互兼容的版本。请参阅部署章节更新,了解默认按请求限制多模态参数的 0.31.0 变更。
避免使用通用的“是/否”功能矩阵。Dynamo 规划以及 vLLM/SGLang 的解耦、CPU 和 GGUF 支持取决于发布版本、后端和硬件。适配器加载和模型别名并不是租户身份验证边界。
NVIDIA NIM
同时检查容器、模型配置文件、GPU 兼容性和支持协议。NIM Operator 3.1.2 与 LLM/VLM 2.0.12 容器是独立的。检查的 2.0.12 版本记录了 vLLM 0.27.1;NIM 并不总是使用 TensorRT-LLM。不要将基于 Dynamo 的 3.0 产品视为与 2.0 相同的部署路径。
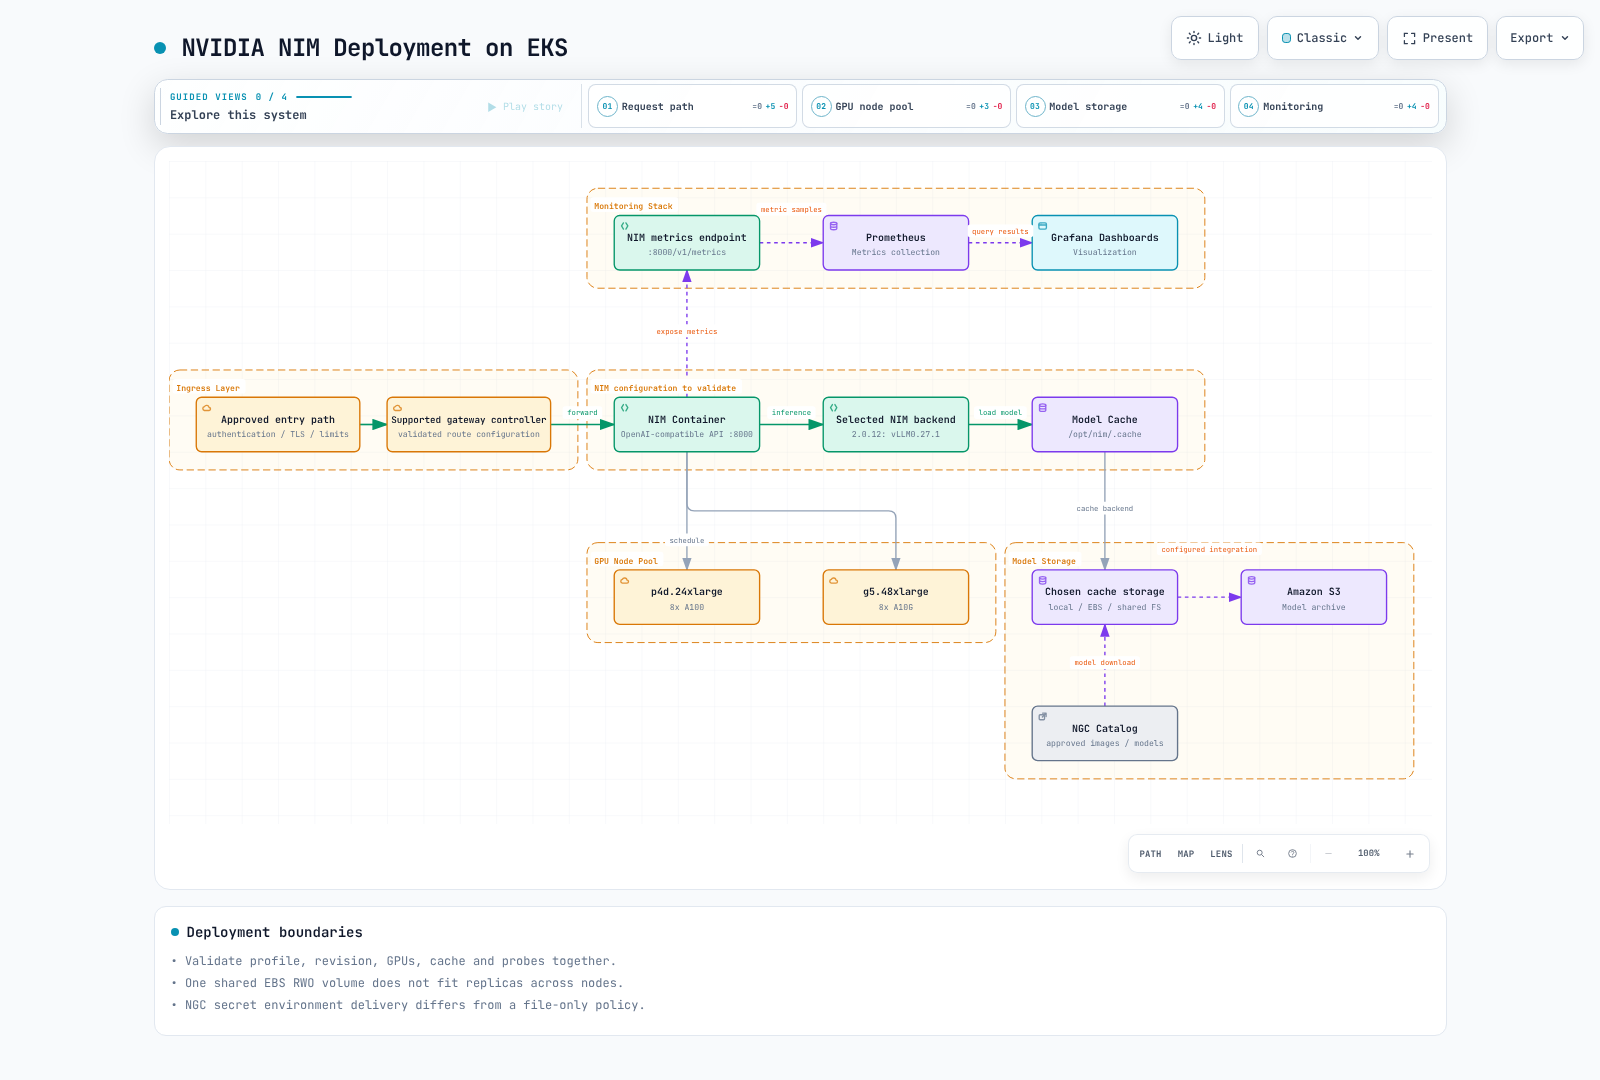
部署准备和配置文件
有关 AMI、驱动程序/工具包和设备插件要求,请使用 GPU 指南。始终启用驱动程序安装可能与提供商 AMI 冲突。检查 Karpenter NodePool/EC2NodeClass、实际可调度的 CPU/RAM/GPU 资源和设备数量。八 GPU Pod 无法装入一台一/四 GPU 节点,Custom AMI 需要显式的 EKS 引导配置。
使用容器配置文件列表中受支持的配置文件 ID/名称设置 NIM_MODEL_PROFILE。不要假定旧的 NIM_MANIFEST_PROFILE 或虚构的 vllm-bf16-tp8 字符串有效。将镜像摘要、模型修订版本、配置文件、驱动程序和实际验证一同记录。
NGC 镜像拉取凭据和运行时模型下载凭据具有不同作用。记录在案的 NGC_API_KEY 环境变量路径不符合仅文件凭据策略。使用获批准的准备模型路径或经过验证的凭据适配器;切勿将实际密钥放在 shell 参数或源代码中。仅有内部 Service 并不会验证推理请求的身份。
避免在不同节点上的副本之间共享一个 EBS RWO PVC。选择每副本存储/本地缓存或合适的共享文件系统,并测试下载失败、存储性能、启动探针和滚动更新。模型并非普遍嵌入镜像中,缓存也不会自动与 FSx/S3 同步。
指标和 GenAI-Perf
检查的 NIM 2.0.12 文档公开了 /v1/metrics,并透传原生 vLLM 后端指标。检查实际名称、单位和标签,而非复制虚构的 nim_* 名称或 /metrics。Grafana ConfigMap 需要对应的数据源/sidecar 和 Prometheus 抓取。不要在毫秒面板中原样显示秒数。
为 TTFT、ITL、端到端延迟、成功吞吐量和排队定义特定工作负载的 SLO。在均匀 token 间隔下,近似值为 TTFT + (output tokens - 1) × ITL,另加独立的网络/后处理开销。500ms 或 GPU80% 等目标不是通用的健康标准。
GenAI-Perf 0.0.16 使用 profile 子命令和 synthetic-input-tokens-mean/output-tokens-mean 选项。以下命令将对准备好的内部端点施加负载,且在本次审计中未执行。先准备 perf_analyzer、tokenizer 和其他分发依赖项。
genai-perf profile --endpoint-type chat --service-kind openai --url http://127.0.0.1:8000 --model approved-model-alias --concurrency 2 --synthetic-input-tokens-mean 128 --output-tokens-mean 64 --num-prompts 20 --profile-export-file profile_export.json不要假定 analyze 仅是 JSON 后处理:扫测设置可能执行额外的性能分析。保留原始请求、失败、tokenizer、预热、并发度以及模型/后端修订版本。GPU 利用率需要实际的指标收集。
NVIDIA Dynamo
官方 1.4.2 Kubernetes 路径使用 Dynamo platform、DynamoGraphDeployment (DGD) 和 DynamoGraphDeploymentRequest (DGDR)。它并非由之前虚构的 dynamo-router/dynamo-worker 镜像、KV_CACHE_HOST 和任意 router YAML 实现。DGDR 请求性能分析和 DGD 创建;它不是只读检查。
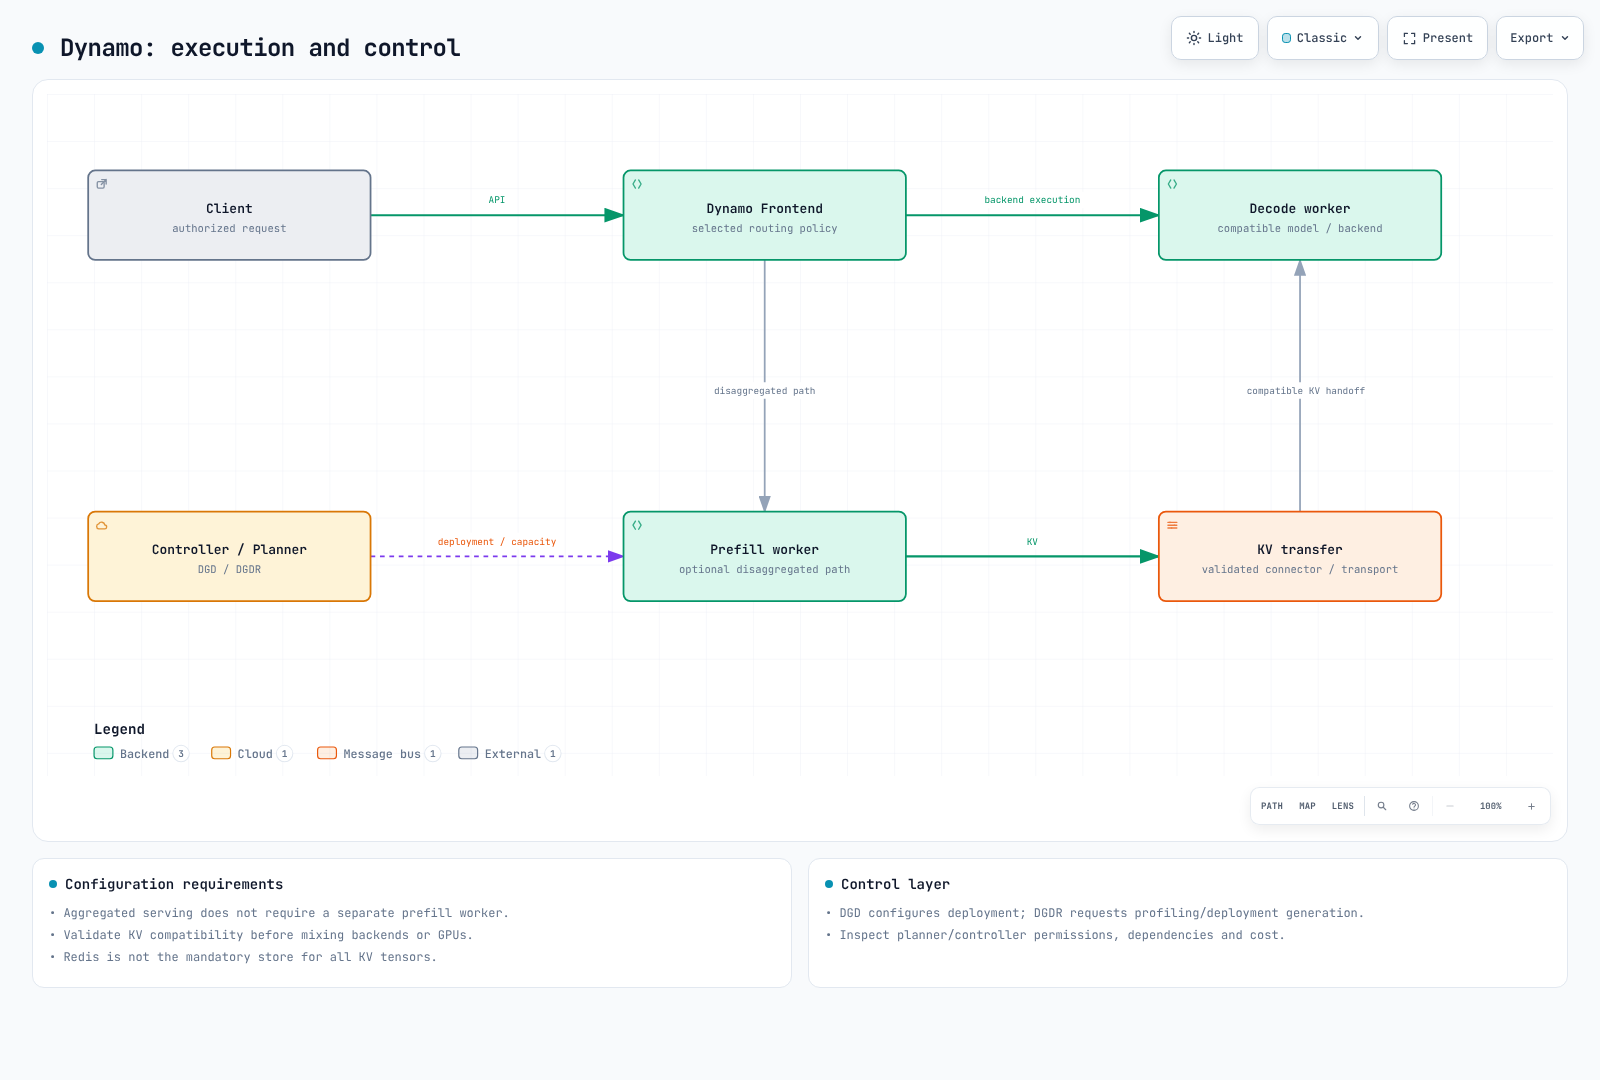
实际 DGD 结构
此经过 schema 检查的配置改编自官方 1.4.2 v1beta1 面向公共模型和有界执行设置的聚合式示例。它需要 platform/controller、namespace、GPU、模型访问和网络。部署前请固定模型/镜像摘要并验证实际硬件;本次审计未执行模型。
apiVersion: nvidia.com/v1beta1
kind: DynamoGraphDeployment
metadata:
  name: vllm-agg
  namespace: dynamo-system
spec:
  components:
  - name: Frontend
    podTemplate:
      spec:
        containers:
        - image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.2
          name: main
          resources:
            requests:
              cpu: 250m
              memory: 512Mi
            limits:
              cpu: '1'
              memory: 2Gi
    replicas: 1
    type: frontend
  - name: VllmDecodeWorker
    podTemplate:
      spec:
        containers:
        - args:
          - --model
          - Qwen/Qwen3-0.6B
          - --max-model-len
          - '2048'
          - --max-num-seqs
          - '8'
          command:
          - python3
          - -m
          - dynamo.vllm
          image: nvcr.io/nvidia/ai-dynamo/vllm-runtime:1.4.2
          name: main
          resources:
            limits:
              nvidia.com/gpu: '1'
              cpu: '4'
              memory: 12Gi
            requests:
              ephemeral-storage: 2Gi
              cpu: '2'
              memory: 4Gi
          workingDir: /workspace/examples/backends/vllm
    replicas: 1
    type: worker
解耦需要兼容的 prefill/decode 角色、KV 连接器/格式、模型修订版本和网络。任意混合的后端或 GPU 不会自动互操作。KV 感知路由平衡局部性和负载;固定的 0.7/0.3 公式不是通用实现。Redis 并非所有 Dynamo 部署都必须使用的 KV tensor 存储。
检查的 platform chart 的集群范围 operator 通过 crd-apply init container 管理 CRD。upgradeCRD=false 选择外部管理;它不会移除 CRD 要求。检查 planner、discovery、NATS/etcd、Grove/KAI 和其他特定版本设置。Chart 渲染并不能验证 CRD 应用、授权或实时发现。
AIBrix
版本 0.7.0 使用 Envoy Gateway、gateway plugin、controller-manager 和 metadata services。KubeRay 对基于 Ray 的功能是可选的。之前独立的 aibrix-registry server 和 /v1/lora/register API 并不是检查的 0.7.0 安装路径。
ModelAdapter 和 PodAutoscaler
实际的 ModelAdapter 字段包括 baseModel、podSelector 和 artifactURL。省略 replicas 会在所有匹配的 Pod 上加载适配器;1 选择一个 Pod;其他值会被拒绝。将示例 bucket/revision 和基础模型替换为获批准的值。单独验证控制器下载权限、运行时兼容性、适配器容量/生命周期和租户授权。
apiVersion: model.aibrix.ai/v1alpha1
kind: ModelAdapter
metadata:
  name: support-lora
  namespace: ai-inference
spec:
  baseModel: approved-base-model
  podSelector:
    matchLabels:
      model.aibrix.ai/name: approved-base-model
  artifactURL: s3://REPLACE_WITH_APPROVED_BUCKET/adapters/support/REVISION/
  replicas: 1
PodAutoscaler 0.7.0 使用 metricsSources 和 HPA/KPA/APA 策略,而非任意 autoscaler ConfigMap。此 CPU 示例需要 metrics-server、工作负载 CPU requests 和控制器。它并不验证基于 GPU 队列的扩缩容。避免同一目标存在相互竞争的 scaler 所有者。
apiVersion: autoscaling.aibrix.ai/v1alpha1
kind: PodAutoscaler
metadata:
  name: model-cpu
  namespace: ai-inference
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: prepared-model-server
  minReplicas: 1
  maxReplicas: 3
  scalingStrategy: HPA
  metricsSources:
  - metricSourceType: resource
    targetMetric: cpu
    targetValue: '70'
Ray Serve 集成
使用经审计的 Ray Serve 和 KubeRay API。KubeRay 协调、Ray worker 自动扩缩容和 Serve 副本自动扩缩容具有不同角色。不要将 RayCluster 作为普通 Deployment HPA 扩缩目标,也不要猜测生成的 cluster/Serve Service 名称和 selector。
代码和依赖项必须到达执行 worker,而不只是 head。user_config 不会自动更改构造函数参数;请实现相应的 reconfigure 路径。兼容的 API 需要实际的 chat template、流式传输、取消、finish reason、usage 和错误。拼接 role 字符串并忽略 stream=true 是不够的。旧的 Ray2.9/operator1.1 示例以及无条件的 trust_remote_code=True 已被移除。
SGLang
版本 0.5.19 的 RadixAttention 为公共前缀复用 KV;任意重叠的中间子字符串不是可互换的缓存前缀。模型、KV 格式和访问策略必须匹配。当前 grammar 后端包括默认 XGrammar 和替代方案 Outlines/Llguidance。“由于压缩 FSM,始终快 10 倍”并非普遍结论。
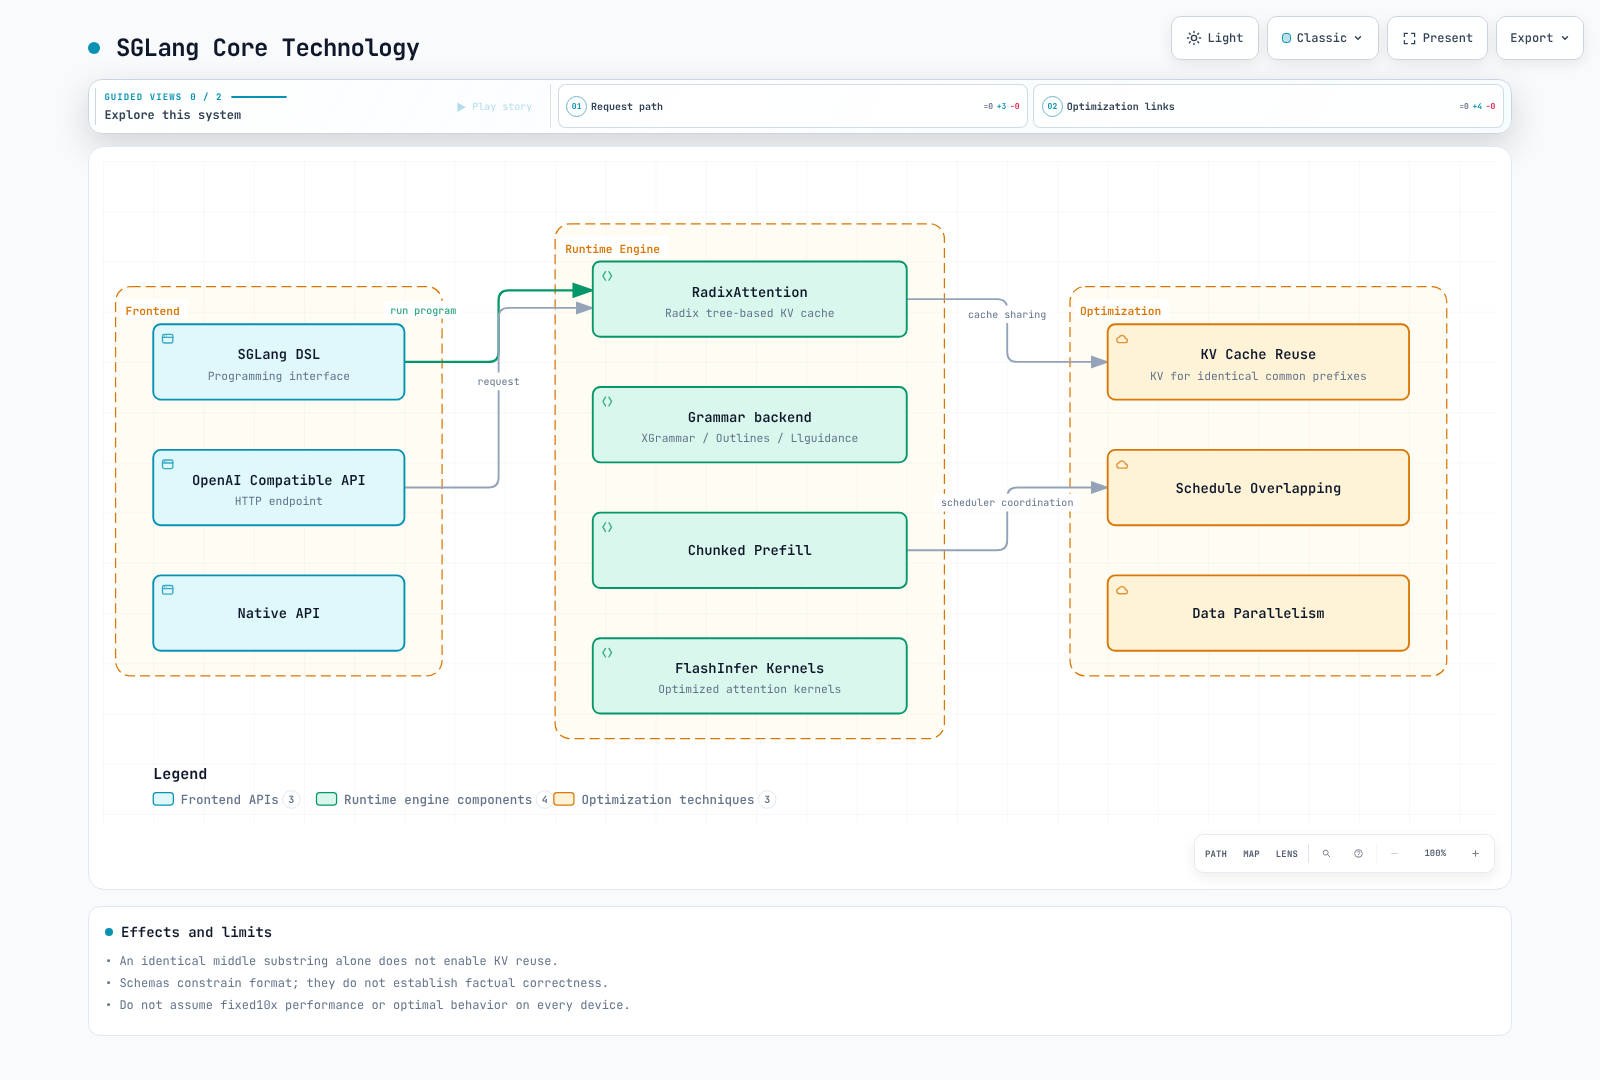
结构化请求示例
此客户端假设经批准的 gateway 支持 SGLang 的 json_schema 请求形状。它检查正常完成和输出形状。验证使用带有合成响应和失败案例的本地 HTTP fixture;它不衡量模型准确性。JSON 有效性并不确定事实正确性或工具授权。
from pathlib import Path
import json
from urllib.request import Request, urlopen

# Existing private gateway and a scoped credential mounted as a file.
base_url = "https://inference.example.internal/v1"
credential = Path("/run/secrets/inference/token").read_text().strip()
payload = {
    "model": "approved-model-alias",
    "messages": [{"role": "user", "content": "Return the city Seoul and country Korea."}],
    "temperature": 0,
    "max_tokens": 128,
    "response_format": {
        "type": "json_schema",
        "json_schema": {
            "name": "location",
            "schema": {
                "type": "object",
                "properties": {"city": {"type": "string"}, "country": {"type": "string"}},
                "required": ["city", "country"],
                "additionalProperties": False,
            },
        },
    },
}
request = Request(
    base_url + "/chat/completions",
    data=json.dumps(payload).encode(),
    headers={"Content-Type": "application/json", "Authorization": "Bearer " + credential},
    method="POST",
)
with urlopen(request, timeout=30) as response:
    result = json.load(response)
choice = result["choices"][0]
if choice["finish_reason"] != "stop":
    raise RuntimeError("Generation did not complete normally")
location = json.loads(choice["message"]["content"])
if set(location) != {"city", "country"} or not all(isinstance(v, str) for v in location.values()):
    raise ValueError("Unexpected output shape")
print(location)
SGLang 的 function/system/user/assistant/gen DSL API 在此版本中仍然存在。声明 function 并不会运行推理:请连接准备好的 RuntimeEndpoint/backend 并执行它。在安装期间验证 Torch、FlashInfer 和硬件兼容性。本次审计未安装完整 GPU SDK,也未将 DSL 连接到模型。
Hugging Face TGI
官方仓库声明为维护模式;最新检查的版本是 3.3.7(2025 年 12 月 19 日)。它接受小型修复、文档和维护,并引导采用新引擎时转向 vLLM/SGLang 等。它不再是新项目的通用默认推荐。迁移现有部署时,请验证模型、template、流式传输、指标和 SLO 兼容性。
添加 --quantize=awq 并不会自动从普通模型生成 AWQ weights。请使用以该格式准备的受支持模型。浮动 tag、缺少 gated-model 凭据和过短的 liveness deadline 会损害可复现性和成功启动。
Ollama
在 0.34.0 中,拉取模型和提供服务是独立操作。带有 sleep10 的 postStart hook 不确保就绪。预置获批准的模型,或使用具有健康检查、有界重试和失败处理的独立准备流程。记录可变的模型 tag 和存储权限。
本地 Ollama API 不提供用户身份验证;在公开之前,请在其前面放置授权和路径控制。仅绑定到 Pod localhost 的 server 无法通过其 Service 访问。OLLAMA_HOST 更改监听范围,而非身份验证。分别限定模型管理和推理端点。
Modelfile 定义基础模型、系统提示和生成设置;它不会训练模型或构建 Kubernetes 镜像。请按模型大小、设备和后端验证 CPU/GPU 支持,而非假定大规模多租户。
LiteLLM
在 Agentic AI 指南中使用经过审计的 1.100.1 Router 配置。提供商 gateway 与推理引擎属于不同层。将别名称为 gpt-4-equivalent 并不能确立等效质量。回退必须首先满足允许的提供商和数据出口策略。
将实际配置文件连接至 proxy 命令,并按需配置 client credentials、DB/Redis 和 callbacks。虚拟 key 或 ClusterIP 并非身份验证;drop_params=true 可能移除有意义的请求条件。区分请求、成功、失败、重试和缓存成本。
AWS Neuron 和 Inferentia2
区分芯片、NeuronCore 以及主机 RAM/HBM。每个 Inferentia2 芯片具有两个 NeuronCore-v2 core 和 32GiB HBM。
| 实例 | 芯片 | NeuronCores-v2 | 设备 HBM (GiB) | 主机 RAM (GiB) | vCPU |
|---|---|---|---|---|---|
| inf2.xlarge | 1 | 2 | 32 | 16 | 4 |
| inf2.8xlarge | 1 | 2 | 32 | 128 | 32 |
| inf2.24xlarge | 6 | 12 | 192 | 384 | 96 |
| inf2.48xlarge | 12 | 24 | 384 | 768 | 192 |
设备分配和插件路径
aws.amazon.com/neuron 分配整个设备;aws.amazon.com/neuroncore 分配核心。之前的 inf2.xlarge 示例在具有一个设备、四个 vCPU 和 16Gi RAM 的节点上请求 neuron:2、八个 CPU 和 24Gi RAM;它无法调度。NEURON_RT_VISIBLE_CORES 选择运行时范围,并不创建未分配设备。针对所选版本检查与 NUM_CORES 和 logical-core policy 的优先级。
检查的官方 Helm 1.10.0 包含 device-plugin、scheduler 和 node-problem-detector 选项。安装前检查渲染的 DaemonSet、hostPath、RBAC 和恢复行为。此命令仅生成本地输出。
helm template neuron-audit oci://public.ecr.aws/neuron/neuron-helm-chart --version 1.10.0 --namespace kube-system --include-crds > neuron-rendered.yamlSDK 2.32.0 记录了两条独立路径:用于 Inf2/Trn1/Trn2 的 NxD Inference plugin 0.5.x 与 vLLM 0.16,以及仅用于 Trn2/Trn3 的新 vLLM Neuron beta 0.24.0.1.1.0。详细的 NxD 指南仍显示 0.5.0/SDK 2.29,而概览显示 0.5.3;请验证所选 plugin tag、DLC 和确切依赖项。在 Inf2 上安装最新 beta,或向旧的 2.18 DLC 添加 pip install,并非兼容性验证。
Neuron 编译需要受支持的模型实现、shape/batch/sequence bucket、TP、编译器/SDK、硬件和缓存产物。使用未使用的 tp_degree dictionary 在通用 Transformers 模型上调用 torch_neuronx.trace 并未实现分布式 causal-LM 服务。编译器输出文件和 tokenizer 目录是不同产物。本次审计未执行编译器或 Neuron 实例。
性能、成本和运维
已移除无来源的 A100 排名表和固定 40–70% 节省的声明。比较相同的模型/修订版本/精度、输入/输出 token 分布、并发度、成功率、SLO、预热和标注日期的价格。每天一百万请求持续 30 天为 3000 万请求:假设每月 48,000 美元即每 1,000 请求 1.60 美元。之前的 0.80 数值在算术上是错误的;此示例并非当前 AWS 定价。
更换引擎时,对实际 payload、template、流式传输、usage 和失败行为进行回归测试。区分分片模型组与独立副本,并检查 StatefulSet 有序就绪是否会阻塞相互等待的 worker。仅有 StatefulSet 并不会配置 TP/PP、rendezvous 或 NCCL。
根据模型大小、重启/下载并发度、授权和成本比较本地缓存、EBS、EFS 和 FSx。EFS 并不一定比 FSx 慢,历史 gp3 限制也不是当前保证。请参阅 GPU/存储示例。
在运维之前,请在实际环境中测试身份验证、TLS、管理路径、探针、放置、配额、单一 scaler 所有者、指标单位、固定模型修订版本、缓存生命周期、滚动更新/回滚和中断恢复。
验证范围
检查涵盖官方 chart/CRD、实际 SDK/CLI 源代码、本地 HTTP 请求/失败 fixture、Markdown 和图像。未执行 GPU/Neuron 模型、吞吐量/成本测量、云部署或模型下载。Schema/chart 成功并不能证明准入、授权、模型兼容性或生产就绪状态。
参考资料
- NIM 2.0 发行说明
- NIM 配置
- NIM 可观测性
- Dynamo 1.4.2
- AIBrix 0.7.0
- SGLang 0.5.19 结构化输出
- TGI 维护通知
- Ollama 0.34.0
- GenAI-Perf 0.0.16
- Neuron SDK 2.32.0 推理路径
- Inf2 架构
- Neuron Kubernetes 组件