理解扩缩容行为
支持的版本:EKS Auto Mode GA;示例基线为 EKS 1.36 最后更新:October 12, 2026
本章区分预置、整合、漂移和过期。请使用入门中已审核的账户/上下文。这些清单假定已配置 default NodeClass,并使用按需容量,以便专注于生命周期行为。限制值仅作示例,仍可能允许产生大量成本。
本次审计期间未运行集群、工作负载或延迟基准测试。配置和诊断转换已在本地检查;在投入生产前,请在受控环境中验证准入、IAM、调度和中断行为。
从不可调度的 Pod 到容量
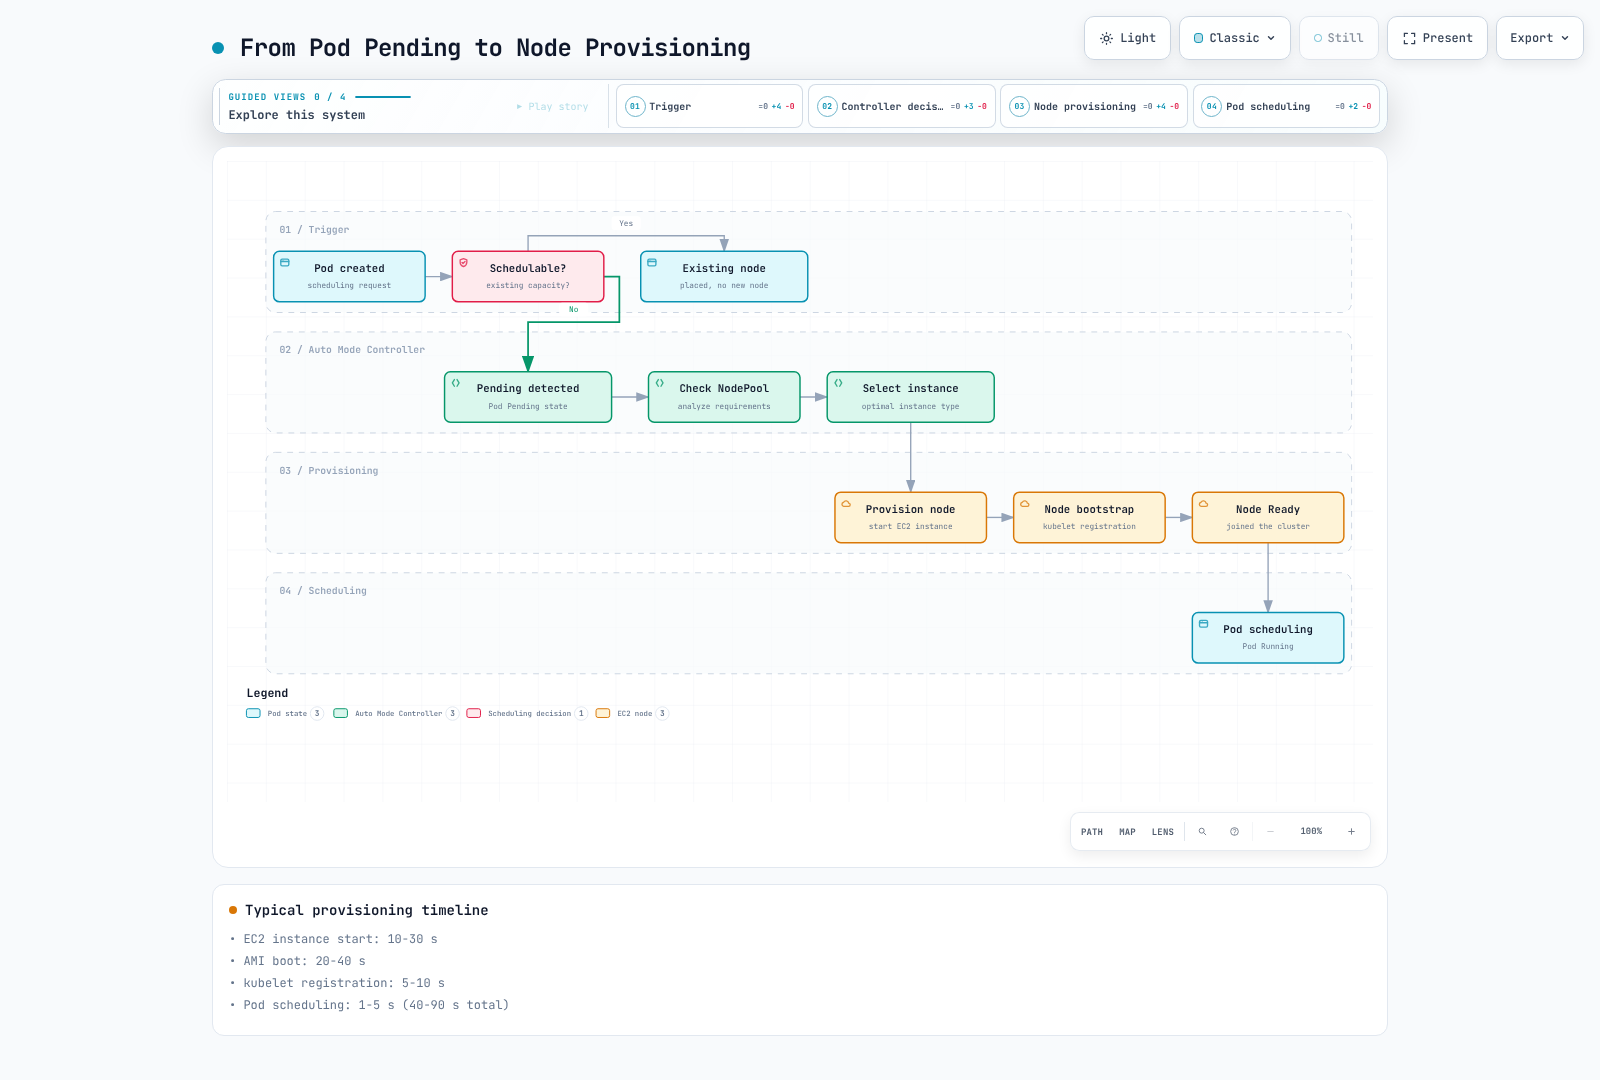
Auto Mode 会观察调度器无法放置到现有容量上的 Pod。要使预置成功,必须存在合适的 NodePool/NodeClass、兼容的约束条件、可用配额和 EC2 容量。请求、亲和性、污点、拓扑、卷放置和架构都会产生影响。HPA/KEDA 或其他应用程序控制器负责增加副本;节点自动化不是基于应用程序 CPU 利用率的自动扩缩容器。
仅 Pending 并不能证明节点不足。Pod 可能已分配到节点,但正在等待镜像或初始化。该图显示的是成功的容量路径,省略了失败分支;兼容的实例选择并非全局最优,也不保证就绪时间。Running 也不表示应用程序已就绪。
历史教学估算
先前的指南在没有原始观测数据或可复现基准测试的情况下发布了以下数字。它们作为未经验证的历史估算保留,而非使用 EKS 1.36 测得的时长或 AWS SLO。阶段定义可能重叠;请勿将其相加作为测量到的追踪记录。
| 先前示意图中的阶段 | 公布的时长 |
|---|---|
| Pending 检测 | 1–5 秒 |
| 实例选择 | 1–3 秒 |
| EC2 启动 | 10–30 秒 |
| AMI 引导 | 20–40 秒 |
| kubelet 注册 | 5–10 秒 |
| Pod 调度 | 1–5 秒 |
| 声称的总计 | 40–90 秒 |
整合:资格条件,而非定时器保证
整合会寻找在保持可调度的同时节省成本的移除或替换操作。不要将其建模为固定的、测量得到的 CPU 或内存利用率阈值:资源请求和放置约束都很重要。PDB、中断预算、注释、替换容量和排空进度都可能阻止或延迟操作。
consolidateAfter 是稳定性/资格延迟。Pod 的添加/移除会重置计时器。30 秒的值并不承诺在 30 秒后删除,也不限制替换容量就绪所需的时间。
WhenEmpty
此策略会考虑符合条件的空节点。“空”不一定意味着 kubectl get pods 中显示零个 Pod:仅运行 DaemonSet 的节点可能符合条件。它对整合采取保守策略,但不会禁用其他中断原因,例如漂移、过期或 Spot 中断。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: when-empty-example
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
  disruption:
    consolidationPolicy: WhenEmpty
    consolidateAfter: 30s
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
    memory: 400Gi
WhenEmptyOrUnderutilized
当非空节点上的工作负载可在相关约束条件下以更低成本重新打包时,此策略允许整合。它可能会利用现有的备用容量删除节点,或用成本更低的容量替换节点;并非总是需要新节点。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: when-underutilized-example
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 1m
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
    memory: 400Gi
Balanced
在 EKS 1.37 上,新建的自定义 NodePool 若省略整合策略,默认使用 Balanced。内置的 general-purpose 和 system 池也使用 Balanced,且其策略无法更改。若需要其他行为,请显式设置自定义池的策略。Balanced 会同时考虑中断成本和节省,并可能跳过 WhenEmptyOrUnderutilized 会执行的边际操作;它并不保证不会中断。本章示例均显式设置策略。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: balanced-example
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
  disruption:
    consolidationPolicy: Balanced
    consolidateAfter: 1m
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
    memory: 400Gi
解读打包图
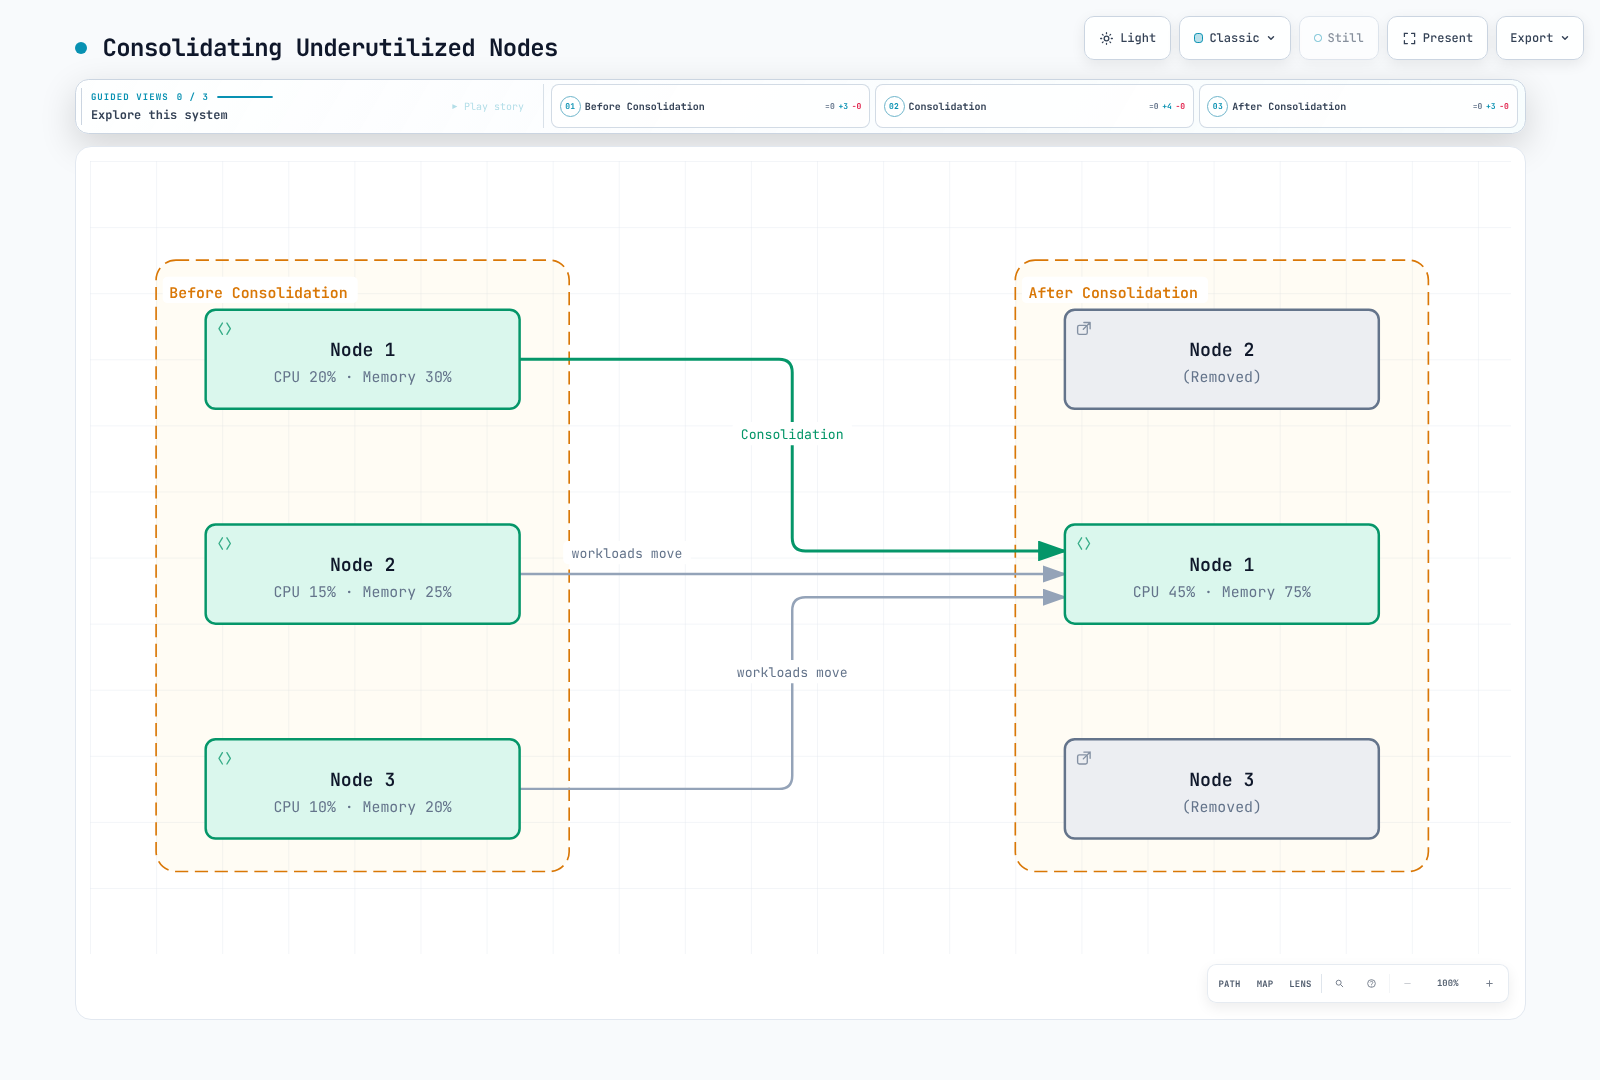
图中的 CPU 20/15/10% 和内存 30/25/20% 在等容量节点上分别相加为 45% 和 75%。这些是示例性打包值,而不是通用整合阈值的测量输入。实际放置还必须满足请求、拓扑、存储和可用性要求。Pod 由工作负载控制器驱逐和重新创建;它们不会实时迁移。
漂移检测与替换
漂移表示 NodeClaim 不再匹配相关的所需配置或已解析配置。请检查其 Drifted 条件;旧的 karpenter.sh/drift-hash 节点注释查询不是有效的公开漂移状态检查。缺失的条件会在下方报告为 NotReported,而不会臆造为确定的 false 结果。
kubectl --context "$CLUSTER_NAME" --request-timeout=15s get nodeclaims -o json |
  jq '[.items[] | {
    claim: .metadata.name,
    node: .status.nodeName,
    pool: .metadata.labels["karpenter.sh/nodepool"],
    drift: ((.status.conditions // [] | map(select(.type == "Drifted") |
              {status, reason, lastTransitionTime, observedGeneration}) | first)
            // {status: "NotReported"})
}]'| 更改 | 解读 |
|---|---|
| 要求排除当前实例 | 可能导致漂移 |
| 要求放宽但仍允许该实例 | 不一定导致漂移 |
| 相关 NodeClass 设置或已解析的子网/安全组选择发生更改 | 可能导致漂移;检查实际条件 |
| AWS 选择新的托管 Auto Mode AMI | 可能导致替换;用户不能选择 amiFamily |
| 编辑已被引用的安全组上的规则 | 不等同于选择不同的组;不要假定它始终会导致节点漂移 |
| NodePool 权重、限制或中断行为 | 自身不是节点模板漂移;它们可能更改允许执行哪些操作 |
expireAfter 或 terminationGracePeriod 更改 | 现有 NodeClaim 字段不会被重写;替换节点会获得新值 |
典型的优雅路径会检查预算和调度可行性,阻止在选定节点上进行新的放置,在需要时准备替换容量,然后驱逐/排空并终止旧节点。替换容量可能会与旧容量重叠并产生费用。并行度受预算限制;替换不一定是顺序进行的。不得将强制中断/过期路径描述为总是在先等待健康的替换容量。
过期和终止宽限期
AWS 记录的 Auto Mode 节点最长生命周期为 21 天。默认过期时间为 336 小时,并且自定义 NodePool 省略 terminationGracePeriod 时,Auto Mode 会在 NodeClaim 上将其默认为 24 小时。不要将通用上游的 720 小时默认值作为 Auto Mode 建议。
以下配置请求在 168 小时后过期,并指定了显式宽限期。过期会开始排空;它并不承诺恰好在七天后有健康的替换容量。节点可能会因其他原因更早中断。
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: with-expiration
spec:
  template:
    spec:
      requirements:
      - key: eks.amazonaws.com/instance-category
        operator: In
        values:
        - m
        - c
      - key: karpenter.sh/capacity-type
        operator: In
        values:
        - on-demand
      nodeClassRef:
        group: eks.amazonaws.com
        kind: NodeClass
        name: default
      expireAfter: 168h
      terminationGracePeriod: 24h
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 1m
    budgets:
    - nodes: 10%
  limits:
    cpu: '100'
memory: 400Gi| 先前指南中讨论的策略值 | 当前解读 |
|---|---|
| 24–72 小时 | 可选的短生命周期策略,变动更多;并不能证明每个周期都有新补丁 |
| 168 小时 | 上述七天示例;评估可用性和替换开销 |
| 336 小时 | 记录的 Auto Mode 默认过期时间 |
| 720 小时 / 30 天 | 超过 Auto Mode 记录的 21 天最大值;不要将其用作节点复用承诺 |
NodePool 中断预算对优雅方法进行速率限制;它们并不是防止过期、中断或修复的通用屏障。PDB 和 do-not-disrupt 会影响排空/中断决策,但不能保证无限期保留。配置的终止宽限期结束后,剩余 Pod 可能会被强制移除。请选择考虑有状态工作负载、存储分离、应用程序宽限期和故障场景的策略。
在不虚构基准测试的情况下诊断延迟
以下命令会采集选定的元数据和状态,而非完整的 Pod 规格。请将证据保密。快照的最后一次条件转换可能反映较晚的转换或波动,而非第一个启动里程碑。
umask 077
: "${WORK_DIR:?Use the private evidence directory from the getting-started guide}"
kubectl --context "$CLUSTER_NAME" --request-timeout=15s get nodeclaims -o json |
  jq '[.items[] | {
    claim: .metadata.name, uid: .metadata.uid,
    node: .status.nodeName, createdAt: .metadata.creationTimestamp,
    pool: .metadata.labels["karpenter.sh/nodepool"],
    expireAfter: .spec.expireAfter,
    terminationGracePeriod: .spec.terminationGracePeriod,
    conditions: [.status.conditions[]? |
      select(.type == "Launched" or .type == "Registered" or .type == "Initialized" or .type == "Ready") |
      {type, status, reason, lastTransitionTime}]
}]' > "$WORK_DIR/nodeclaims-summary.json": "${WORKLOAD_NAMESPACE:?Set the controlled test namespace}"
: "${POD_NAME:?Set the controlled test Pod name}"
kubectl --context "$CLUSTER_NAME" --request-timeout=15s -n "$WORKLOAD_NAMESPACE" \
get pod "$POD_NAME" -o json |
jq '{name: .metadata.name, uid: .metadata.uid,
createdAt: .metadata.creationTimestamp, node: .spec.nodeName, phase: .status.phase,
conditions: [.status.conditions[]? |
select(.type == "PodScheduled" or .type == "Ready") |
{type, status, reason, lastTransitionTime}]}' > "$WORK_DIR/pod-summary.json"对于实际基准测试,请在创建工作负载时开始受控观察,关联对象 UID 和 NodeClaim/节点分配,并分别记录首次调度、节点就绪和应用程序就绪。包括失败的尝试/超时,以及环境、镜像和工作负载配置。仅依靠快照数据和保留的 Kubernetes 事件无法建立完整的延迟分布。
支持的存储调优
Auto Mode 会选择其 Bottlerocket 变体。不要设置 amiFamily 或 blockDeviceMappings 来寻求声称的启动时间改进。此有效的存储模板使用 ephemeralStorage;请将配置文件和选择器替换为经过审核的资源,并从预期的池中引用此 NodeClass。
apiVersion: eks.amazonaws.com/v1
kind: NodeClass
metadata:
  name: image-storage-example
spec:
  instanceProfile: eks-node-instance-profile
  subnetSelectorTerms:
  - tags:
      Name: private-subnet
  securityGroupSelectorTerms:
  - tags:
      Name: eks-cluster-sg
  advancedNetworking:
    associatePublicIPAddress: false
  ephemeralStorage:
    size: 50Gi
    iops: 3000
    throughput: 125
在更改设置前,请分析实际的镜像传输、解包、CPU、网络和存储瓶颈。之前的“Bottlerocket 节省 10–20 秒”、“更小的 EBS 节省 5–10 秒”和“更高的 IOPS 节省 5–10 秒”数字没有经过验证的测量结果。它们不是当前的调优保证。更小的容量反而可能导致镜像/临时存储压力。
更广泛的兼容实例/AZ 选择可以改善容量选项,但必须遵守工作负载和卷约束。占位 Pod 可以以空闲成本预留容量;它们无法保证近乎即时的镜像拉取或应用程序就绪。
观察正确的信号
请检查明确报告为不可调度的 Pod,而不是将每个 Pending Pod 都视为容量请求:
kubectl --context "$CLUSTER_NAME" --request-timeout=15s \
  get pods -A --field-selector=status.phase=Pending -o json |
  jq '[.items[] | select(any(.status.conditions[]?;
    .type == "PodScheduled" and .status == "False" and .reason == "Unschedulable")) |
    {namespace: .metadata.namespace, name: .metadata.name, uid: .metadata.uid,
     createdAt: .metadata.creationTimestamp}]'
事件可以解释决策,但它们可能会被聚合、重复或过期。此查询使用显式的 events.k8s.io 资源,并选择状态标识符,而不是转储工作负载数据:
kubectl --context "$CLUSTER_NAME" --request-timeout=15s \
  get events.events.k8s.io -A -o json |
  jq '[.items[] |
    select(.regarding.kind == "NodeClaim" or .regarding.kind == "Node" or .regarding.kind == "Pod") |
    {time: (.eventTime // .deprecatedLastTimestamp // .metadata.creationTimestamp),
     reason, regarding: {kind: .regarding.kind, name: .regarding.name, uid: .regarding.uid},
count: (.series.count // .deprecatedCount // 1)}] | sort_by(.time)'| 信号 | 证据和告警设计注意事项 |
|---|---|
| 持续存在的不可调度 Pod | Kubernetes 条件加上已配置的收集器;先前的持续 5 分钟超过 10 个阈值仅为示例 |
| NodeClaim 创建/失败率 | 持久事件/日志或检测工具;当前对象快照会遗漏已删除的尝试 |
| 预置/应用程序延迟 | 包括失败情况的关联观测;先前 p99 超过 120 秒的阈值不是 AWS SLO |
| 池资源接近限制 | NodePool 状态、配额和容量检查;区分请求/预留资源与实际利用率 |
不要假定先前的 karpenter_* 表名是内置的 Auto Mode CloudWatch 指标。自行管理的 Karpenter Prometheus 指标、EKS 控制平面指标和您自己的收集器是独立接口;请从实际配置的发布者中选择指标名称和维度。
AWS 托管组件日志
Auto Mode 通过 CloudWatch Vended Logs 传输公开托管组件日志。这与普通 EKS 控制平面日志的配置是分开的:
- 用于托管 Karpenter 决策的
AUTO_MODE_COMPUTE_LOGS AUTO_MODE_BLOCK_STORAGE_LOGSAUTO_MODE_LOAD_BALANCING_LOGSAUTO_MODE_IPAM_LOGS
文档所述设置使用传输源、传输目标和传输。启用前请检查目标权限以及传输/存储费用。现有控制平面审计日志还可显示 Kubernetes 事件,例如 DisruptionBlocked、Unconsolidatable、FailedScheduling、NodeClassNotReady 和终止失败;请使用 AWS 故障排除参考资料和限定的时间范围。这些是诊断事件,而非自动发布的延迟直方图。
参考资料
- EKS Auto Mode 行为和最长节点生命周期
- Auto Mode NodePool 策略和宽限期
- Karpenter v1.14 中断和漂移
- Auto Mode NodeClass 字段
- Auto Mode 故障排除
- AWS 托管组件日志传输
< 上一页:NodePool 配置 | 目录 | 下一页:Spot 策略 >