Kubernetes 网络
最后更新:October 15, 2026
固定示例版本:Cilium 1.20.1、Calico Open Source 3.32.2、Flannel 0.28.9,以及上游 AWS VPC CNI/Helm chart 1.23.0。
当前发布信息:AWS 为 Kubernetes 1.31–1.37 列出了由 EKS 管理的 VPC CNI add-on
v1.23.1-eksbuild.1。Calico 3.33.0 是最新的 Open Source 版本,并已在 Kubernetes 1.35–1.37 上测试。在更改固定示例之前,请查看其发行说明。这些版本并非经过联合测试的集群配置。安装前请检查每个产品的 Kubernetes/平台支持矩阵。
概述
Kubernetes 网络是实现容器化应用程序通信的核心基础设施层。本节涵盖从基本 Kubernetes 网络概念,到 AWS EKS 环境中的高级 CNI(Container Network Interface)解决方案和网络模式的全部内容。
学习路径
完成初级课程后,使用专家网络路径将协议项目、路由策略、EVPN、Linux 性能、云设计和自动化评估联系起来。请先检查每个工作簿的环境、证据和恢复标准。
如果你刚接触 Linux 或网络,请从初级课程开始。其八节课程关联了 CLI、寻址、DNS、SSH、防火墙、监控和综合项目。下方路径会将这一基础扩展至协议、内核和集群实现。
从协议概念逐步构建到观测结果,然后将它们关联到容器、集群和云的职责。使用先决条件选择起点,并在继续之前通过学习成果检查理解程度。
| 阶段 | 角色 | 先决条件 | 学习成果 | 阅读 / 练习 |
|---|---|---|---|---|
| 协议、寻址、HTTP | 建立术语体系 | 基本命令行使用 | 跟踪一个请求,并区分寻址、传输和应用程序行为 | 网络基础第 1 部分、第 2 部分、第 3 部分、第 4 部分 |
| Linux socket、VFS、数据包路径 | 将 API 连接至内核 | TCP/IP 基础 | 区分 FD、socket 缓冲区、窗口和队列 | 内核网络栈 |
| Linux 网络诊断 | 用证据检验假设 | Socket 和数据包路径概念 | 关联 socket、数据包和应用程序观测 | 诊断练习 · 测验 |
| Docker 和容器网络 | 定位 namespace 边界 | Linux 数据包路径和基本诊断 | 解释 bridge 网络、发布端口和容器名称解析 | 容器技术 |
| Kubernetes Service、DNS、Ingress | 映射集群抽象 | 容器网络 | 跟踪一个名称经由 Service 到其 endpoint,并识别 ingress 角色 | Service 和网络 · 实验 |
| eBPF、CNI、策略 | 比较实现职责 | Pod 和 Service 路径 | 区分数据包转发、策略实施和可观测性 | eBPF 基础 · Cilium · Calico |
| AWS 网络边界和性能 | 将模型应用于云路径 | CNI 概念和测量技能 | 识别 VPC、node 和 AZ 边界,并在上下文中解读测量结果 | VPC CNI · AWS Load Balancer Controller · 跨组织 VPC 连接 · Pod 网络基准测试 |
Kubernetes 网络模型
当前 Kubernetes 模型提供一个 Pod 网络,其中 Pod 可跨 node 直接通信,无需地址转换或 proxy,但受有意设置的网络分段约束。kubelet 等 node agent 必须能够访问其自身 node 上的 Pod。网络策略、路由和应用程序监听器仍决定特定连接是否成功。
普通 Pod 有自己的网络 namespace 和集群范围地址;一个 Pod 中的容器共享该 namespace 和 localhost。Host-network Pod 共享 node 网络,双栈或多网络配置需要更精确的地址处理。重新创建 Pod 可能会分配不同 IP;在同一 Pod 内重启容器不一定会重新创建其网络 sandbox。
| 组件 | 角色 |
|---|---|
| Pod 网络 | workload 网络 namespace 之间的寻址和连接性 |
| Service/发现 | 在不断变化的 endpoint 之上提供稳定的服务名称或虚拟地址 |
| Ingress/Gateway 实现 | 配置的外部入口和应用程序路由 |
| 网络策略引擎 | 实施所选实现支持的策略 |
这些角色不构成强制性的串行数据包路径。Service 转换、L7 proxy 和 workload 策略可以改变特定请求穿过网络的方式。
Pod 网络
Pod 网络为 Pod 通信提供寻址和路由。下图显示普通 IPv4 Pod;其连接假定适用策略和网络控制允许它们。
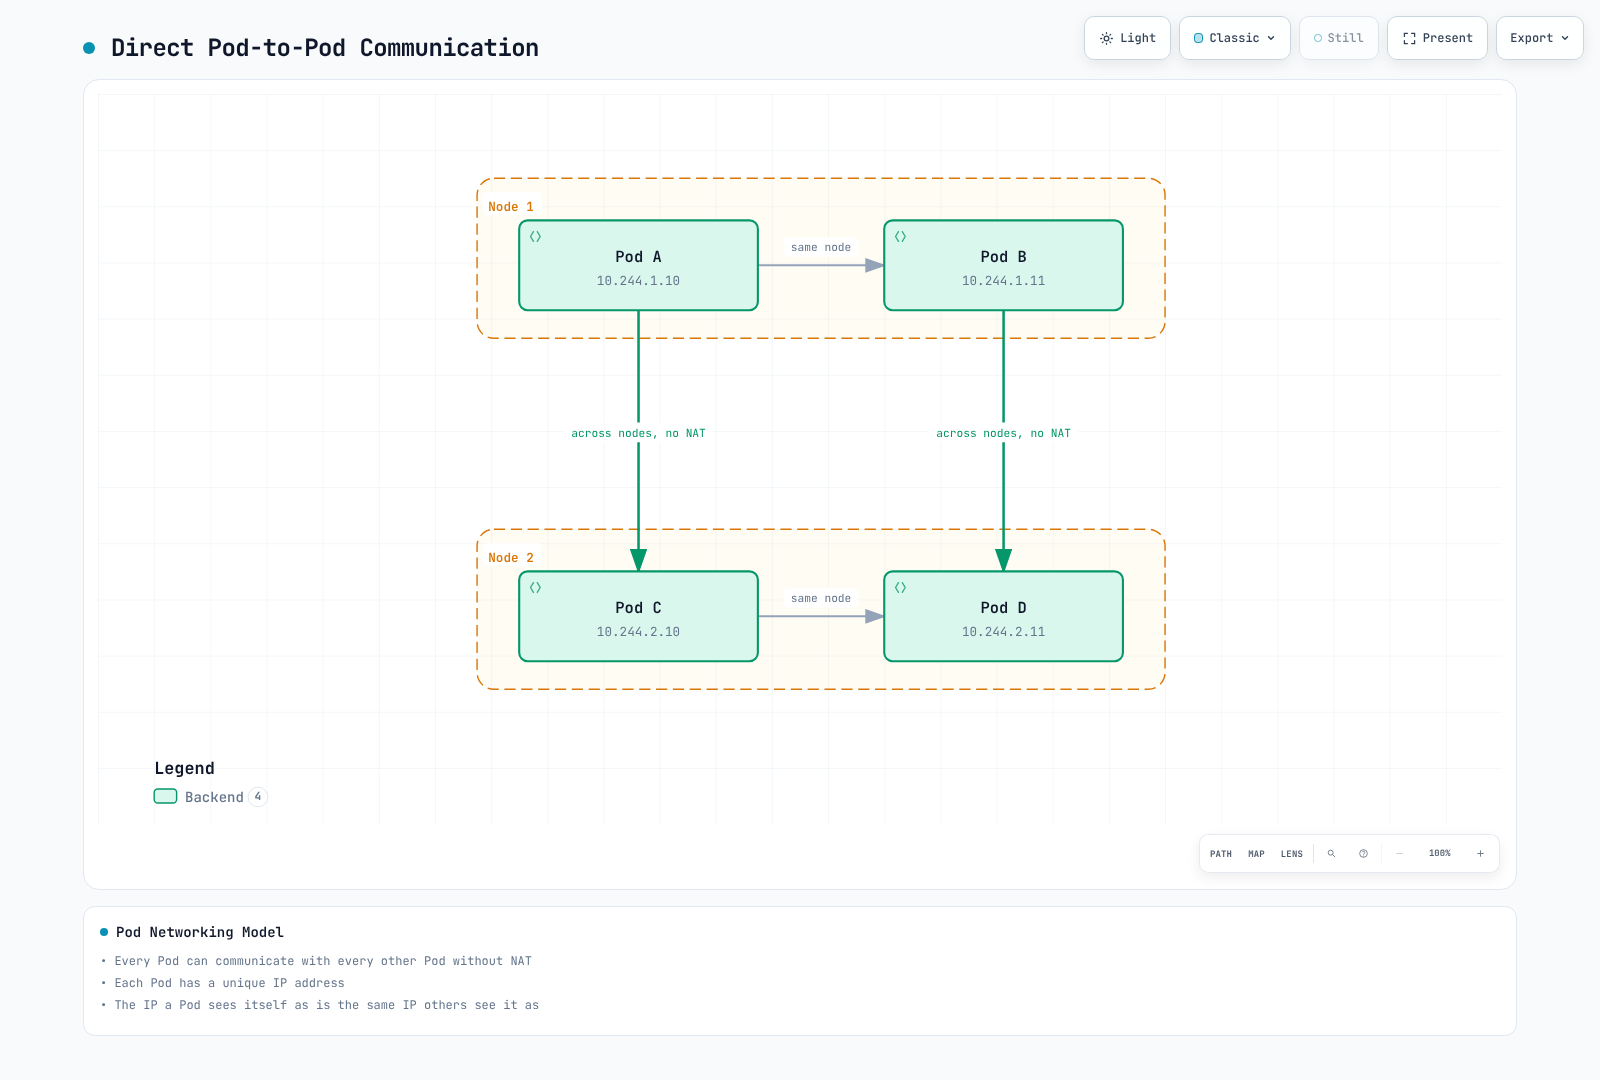
这些地址是示例性的普通 Pod 地址。有意隔离以及 host-network 或多网络配置需要各自进行解读。
Pod 网络实现方法
| 方法 | 说明 | 示例 CNI |
|---|---|---|
| Overlay Network | 在现有网络上封装流量 | Flannel VXLAN、Calico VXLAN/IPIP、Cilium VXLAN/Geneve |
| Native Routing | 在底层网络中使用路由,不进行该 overlay 封装 | AWS VPC CNI、Calico routing/BGP、Cilium native routing |
| Conditional Encapsulation | 根据配置的拓扑使用直接路径或封装 | 支持的 Calico/Flannel/Cilium 模式,具有不同先决条件 |
Service 网络
Service 描述一组逻辑 endpoint(通常为 Pod)及其访问方式。ClusterIP 默认提供稳定的虚拟 IP;headless Service 省略该虚拟 IP,ExternalName 使用 DNS CNAME 映射。Service 还可具有无需 Pod selector 管理的 endpoint。
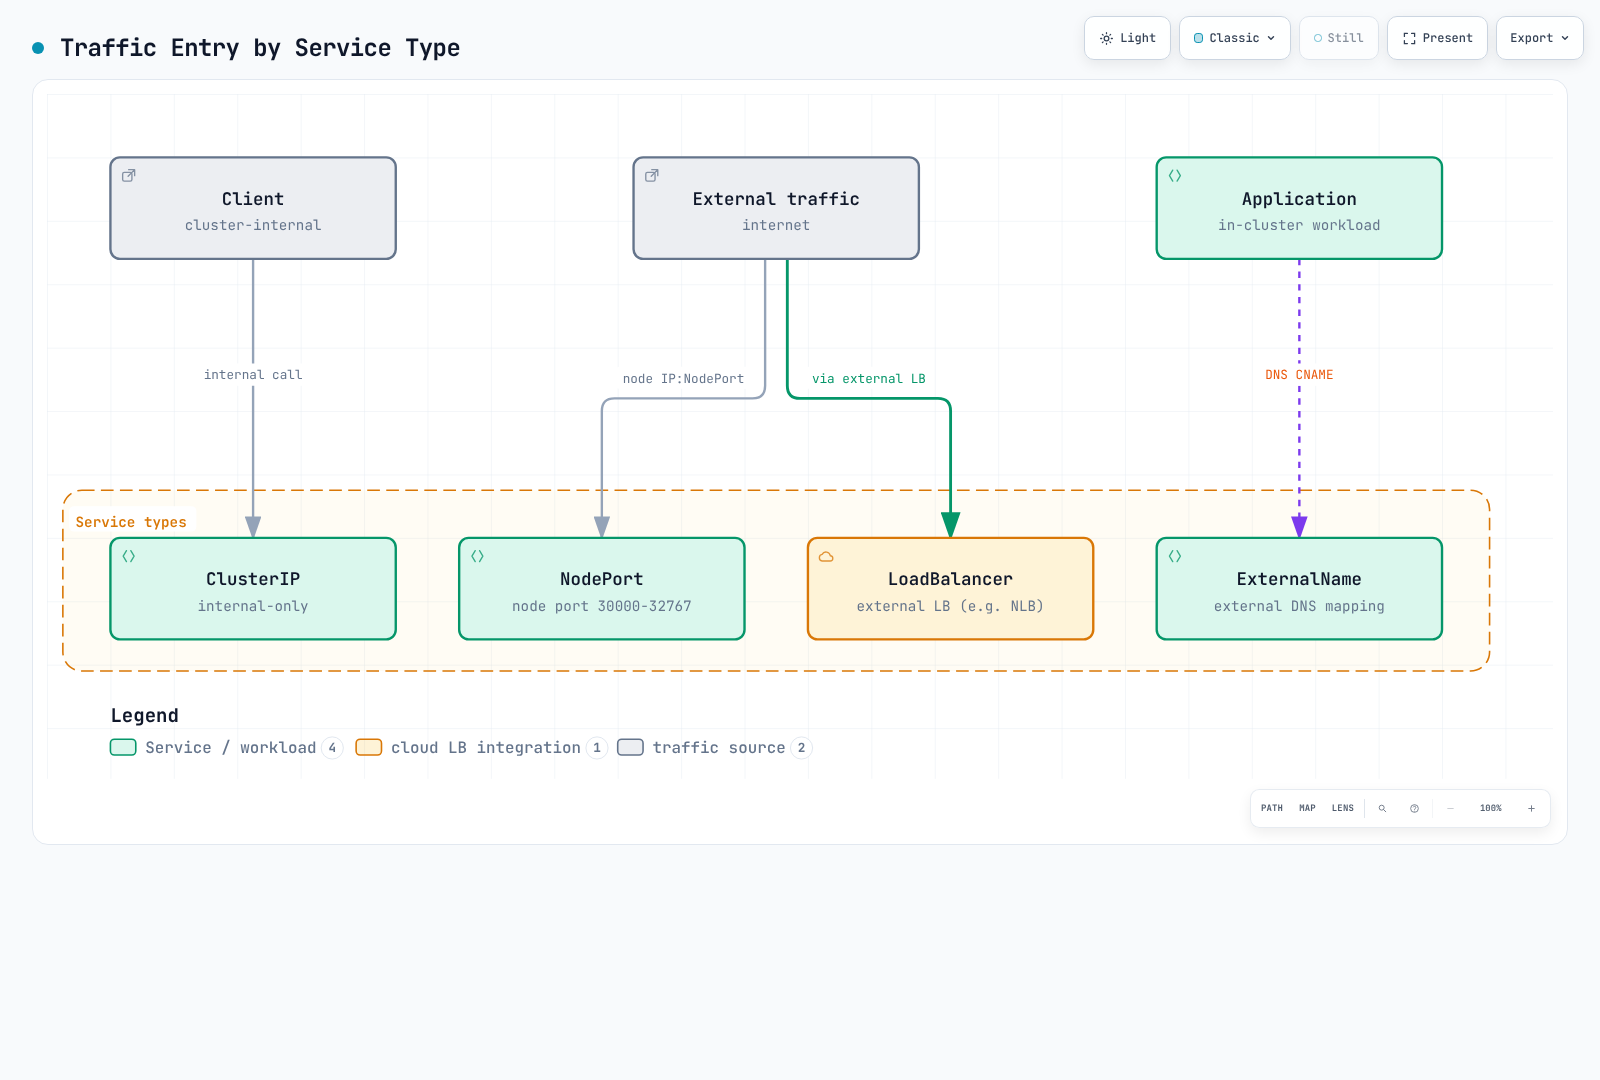
这些是典型暴露机制,而非安全保证。NodePort 范围和可访问的 node 地址可配置;LoadBalancer 可以是内部的。ExternalName 返回 DNS 别名,不会创建转发 proxy。
Service 类型特性
在 default 中创建匹配 app: my-app 的 Pod,并在所示 target port 上监听。NodePort 默认分配范围为 30000–32767,且可以配置。外部可达性仍取决于地址、路由和访问控制。
LoadBalancer 示例明确选择 AWS Load Balancer Controller,使用 EC2 instance target 和已分配的 NodePort。请先安装/配置该 controller 及其 IAM/subnet 先决条件。EKS Auto Mode 使用不同的 controller/class。此处端口 443 仅选择 TCP 端口;必须由后端在 8443 上提供 TLS,或在 load balancer 上单独配置。
这些端口映射说明通用 Kubernetes Service API。AWS 目前记录了额外的原生 EKS 网络策略要求:Service 端口必须与 container 端口匹配,并且带有 metadata.ownerReferences 的 controller 管理 Pod 才能提供可靠实施。在测试该策略实现前,请根据这些要求调整示例。
apiVersion: v1
kind: Service
metadata:
  name: my-service
  namespace: default
spec:
  type: ClusterIP
  selector:
    app: my-app
  ports:
  - protocol: TCP
    port: 80
    targetPort: 8080
---
apiVersion: v1
kind: Service
metadata:
  name: my-nodeport-service
  namespace: default
spec:
  type: NodePort
  selector:
    app: my-app
  ports:
  - protocol: TCP
    port: 80
    targetPort: 8080
    nodePort: 30080
---
apiVersion: v1
kind: Service
metadata:
  name: my-loadbalancer-service
  annotations:
    service.beta.kubernetes.io/aws-load-balancer-scheme: internet-facing
    service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: instance
  namespace: default
spec:
  type: LoadBalancer
  selector:
    app: my-app
  ports:
  - protocol: TCP
    port: 443
    targetPort: 8443
  loadBalancerClass: service.k8s.aws/nlb
  allocateLoadBalancerNodePorts: true
Ingress 网络
Ingress 资源需要 controller 及其数据平面。此 HTTP 示例使用 AWS LBC、spec.ingressClassName: alb 和 IP target。引用的 api-v1、api-v2 和 web-frontend Service 必须存在于 default 中,暴露端口 80,并具有就绪、VPC 可路由的 Pod endpoint。需要时请单独配置 HTTPS/certificate。有关安装和 target 先决条件,请参阅 LBC 指南。
Ingress 定义将 HTTP/HTTPS 流量路由到内部集群 Service 的规则。
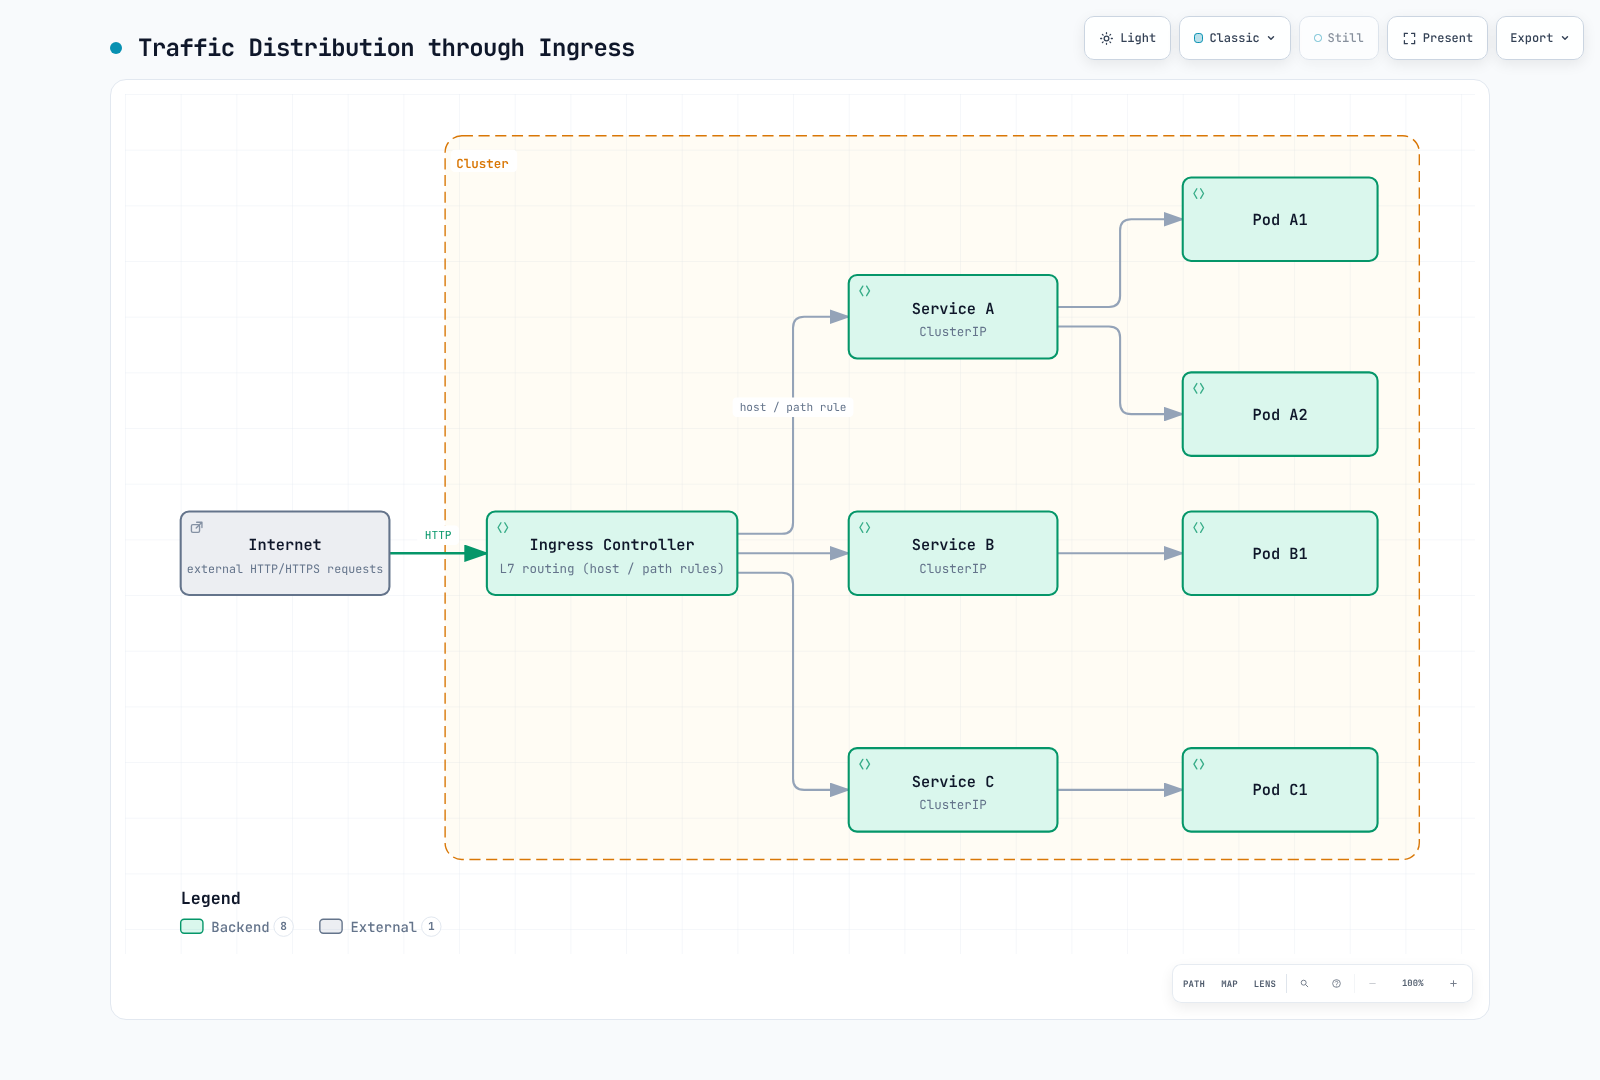
该框表示 Ingress 数据平面功能。AWS LBC 配置 ALB;应用程序流量不会穿过 controller 的协调过程。根据 target 模式,数据平面可以到达 Pod IP 或 NodePort,而不是把 Service 虚拟 IP 作为字面上的额外跳点穿过。
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: my-ingress
  annotations:
    alb.ingress.kubernetes.io/scheme: internet-facing
    alb.ingress.kubernetes.io/target-type: ip
  namespace: default
spec:
  rules:
  - host: api.example.com
    http:
      paths:
      - path: /v1
        pathType: Prefix
        backend:
          service:
            name: api-v1
            port:
              number: 80
      - path: /v2
        pathType: Prefix
        backend:
          service:
            name: api-v2
            port:
              number: 80
  - host: web.example.com
    http:
      paths:
      - path: /
        pathType: Prefix
        backend:
          service:
            name: web-frontend
            port:
              number: 80
  ingressClassName: alb
CNI(Container Network Interface)
CNI 标准化了 runtime 配置容器网络时所经过的接口。对于当前 Kubernetes,kubelet 通过 CRI 请求 Pod-sandbox 操作,且container runtime 管理 CNI。kubelet 过去直接管理 CNI 的 flags 已在 Kubernetes 1.24 中移除。
Runtime 和 plugin 职责
| 参与方 | 职责 |
|---|---|
| kubelet | 通过 container runtime interface 请求创建/移除 sandbox |
| Container runtime | 选择网络配置并调用 CNI plugin chain |
| CNI plugin | 接收配置、执行 ADD/DEL 和其他受支持操作,并返回结果 |
| IPAM 实现 | 分配/释放地址;可为委托 plugin 或 provider 特定 agent 的一部分 |
| 可选 node agent | 维护 provider 特定路由、策略、IP pool 或 datapath 状态 |
runtime 通过 CNI 接口将配置传递给 plugin;每个 plugin 并非都必须有单独的长期运行 agent 或 IPAM binary。接口类型也各不相同:veth pair 很常见,但并非唯一实现。
CNI 对比
| 项目 / 范围 | 网络和策略 | 需区分的功能和限制 |
|---|---|---|
| Cilium 1.20.1 | eBPF 网络;用于相关 L7 功能的 Envoy;Cilium 网络策略和 Hubble | Linux worker dataplane,具有 AMD64/Arm64 要求。Windows CLI 可用性并非 Windows CNI 支持。WireGuard/IPsec 和 Beta ztunnel mTLS 具有不同范围。 |
| Calico Open Source 3.32.2 示例;3.33.0 当前版本 | 路由/封装选择;iptables、nftables 和 eBPF 选项;有序策略 tier 以及 host/workload 策略 | Calico 3.33.0 已在 Kubernetes 1.35–1.37 上测试。升级前请查看其发行说明。Windows 有单独限制,包括不支持 Linux eBPF 或 WireGuard dataplane。Whisker/Goldmane flow 可观测性以 Tech Preview 形式提供。请查阅版本矩阵以了解付费功能。 |
| Flannel 0.28.9 | Host subnet 分配和 node 间传输;VXLAN、host-gw 和其他 backend | flanneld 本身不实施 NetworkPolicy;chart 的可选 netpol.enabled 会部署 SIGs 策略 controller。WireGuard 是记录在案的 backend;IPsec 为实验性功能。Windows VXLAN 有特定设置/限制。 |
AWS VPC CNI 1.23.0 上游/Helm 示例;EKS add-on v1.23.1-eksbuild.1 | VPC 地址分配和 EC2 ENI/prefix;受支持 Linux EC2 node 上的 EKS standard 和 Admin 网络策略能力 | AWS 为 Kubernetes 1.31–1.37 列出了该 managed add-on build;请验证区域可用性和集群的实际版本。EKS Auto Mode 是一种具有额外 DNS 策略功能的托管网络实现。Windows、Fargate、custom networking、prefix delegation 和 multi-NIC 支持有各自条件。 |
| 原始 Weave Net 项目 | 历史性的 overlay 网络实现 | 原始 weaveworks/weave repository 已归档。不要将其描述为新集群活跃且受支持的默认选择。 |
策略、加密和可观测性
- Cilium 通过适用的 L7 组件提供 HTTP/DNS 感知策略,以及 cluster-wide/host 策略。其 deny/allow 语义不同于 Calico 的有序 Tier API。
- Calico Open Source 包括分层策略 tier 和 host 策略。当前产品矩阵将应用层策略、DNS/FQDN 策略和 Cluster Mesh 归为 Cloud/Enterprise;不得将其悄然归因于开源版本。Calico 记录在案的传输中加密使用 WireGuard。
- Amazon EKS 为 Auto Mode 和受支持 EC2/VPC-CNI 安装提供
ClusterNetworkPolicyAdmin/Baseline 控制。AWS 所述的 DNS/FQDNApplicationNetworkPolicy功能适用于 Auto Mode。其名称并不代表当前支持 HTTP method/body 检查。 - Flannel 的可选策略 controller 有自己的要求;仅选择网络 backend 不会启用实施。
- node 到 node 加密、经认证的 workload identity 和应用程序 mTLS 是不同的控制措施。网络 flow 可见性也不同于应用程序 tracing 或 process/file 实施。
路由和性能
Calico 和 Cilium 可以使用 BGP 发布路由;这本身不提供多集群 Service 发现、策略同步或加密。Flannel host-gw 使用直接路由,并要求适当的二层连接性。overlay 会带来封装和 MTU 考量,但不能根据 CNI 名称推断通用性能排名。
原先的 100/98/95/85/80/75 percent 吞吐量数字没有可复现的 workload、版本或测量来源。请使用可比较的硬件、kernel、数据包/请求大小、并发度、加密/策略设置、吞吐量、丢包和尾延迟。独立的 Pod 基准测试保留了自身的历史环境和测量结果。
CNI 选择指南
先选择所需的路由、策略、操作系统和支持模型,再测试该组合。
| 需求 | 评估路径 |
|---|---|
| 标准 EKS VPC 寻址和受支持网络策略 | 在添加第二个策略引擎之前,评估 AWS VPC CNI/EKS 能力。 |
| 有序策略 tier、host 策略或基础设施 BGP | 评估相关 Calico 版本/dataplane 和路由先决条件。 |
| Cilium 策略、Hubble 或选定 mesh 功能 | 检查 Linux/kernel/平台兼容性和 Cilium mesh 指南。Envoy 仍是适用 L7 路径的一部分。 |
| 功能集有限的小型网络 | 根据实际需求评估 Flannel 的 backend 和可选策略 controller。 |
| Process、syscall 或 file 实施 | 将 Tetragon 等 runtime-security 组件与网络策略分开评估。 |
EKS Managed Add-on 配置
以下是一个配置 payload示例,并非指示在同一 workload 上同时安装 Calico 和 VPC CNI 策略引擎:
{
  "enableNetworkPolicy": "true"
}
字符串 "true" 是此设置记录在案的类型。为现有 Kubernetes 版本选择兼容的 EKS add-on build,并检查该 build 的配置 schema:
EKS_REGION=ap-northeast-2
KUBERNETES_MINOR=1.35  # Replace with the existing cluster's minor version
aws eks describe-addon-versions --region "$EKS_REGION" --addon-name vpc-cni \
  --kubernetes-version "$KUBERNETES_MINOR"
: "${VPC_CNI_ADDON_VERSION:?Set the compatible eksbuild version selected from metadata}"
aws eks describe-addon-configuration --region "$EKS_REGION" --addon-name vpc-cni \
  --addon-version "$VPC_CNI_ADDON_VERSION"
上游 1.23.0 release number 与 EKS eksbuild 版本是不同标识符。AWS 当前 add-on table 为 Kubernetes 1.31–1.37 列出了 v1.23.1-eksbuild.1;请在目标 Region 中使用 describe-addon-versions 选择兼容 build。将更改合并到预期的 managed add-on 配置中;不要盲目选择 latest 或替换无关值。从第三方策略实现迁移还需要移除其现有实施状态,以及经过测试的 node/workload 转换计划。
EKS 网络基础
EKS 默认网络架构
| 位置 / 组件 | 职责 |
|---|---|
| EKS-managed VPC | AWS 跨多个 Availability Zone 运行托管 Kubernetes control plane。 |
| 客户 cluster VPC | Worker 网络、选定 subnet 和 EKS-managed cross-account ENI 提供到 control plane 的已配置路径。 |
| 选定客户 VPC subnet 中的 ALB/NLB | 提供选定的公共或内部应用程序入口;internet gateway/NAT gateway 不能替代该路由配置。 |
| NAT gateway 或私有服务 endpoint | 提供 workload 设计所需的特定出站路径。 |
之前的图将 control plane 放在客户 VPC 内、load balancer 放在其外;现已由这些所有权边界取代。
按计算模式划分的 DNS 和网络
| 计算模式 | DNS / 组件放置 |
|---|---|
| Standard EC2 node | 通常使用已配置的 CoreDNS Deployment 和安装的网络组件;替换项需要其自身受支持的配置。 |
| 纯 EKS Auto Mode | CoreDNS、VPC CNI 和 kube-proxy 功能以 managed node systemd service 形式运行。这些 node 不需要 CoreDNS Deployment/add-on。 |
| Auto Mode 与非 Auto node 混合 | 为非 Auto node 保留 CoreDNS Deployment;它们不能使用其他 node 的 Auto Mode DNS service。 |
Auto Mode 的第一个 DNS resolver 为 node-local。上游转发和 control-plane 通信仍可能需要网络访问;这并不保证每一个 DNS 相关数据包都留在 node 上。AWS 为 Auto Mode 记录了 Admin 和 DNS 策略,而 standard EC2 VPC-CNI Admin 策略有自己的版本/启用要求。
VPC CNI 的工作原理
AWS VPC CNI 使用选定 IPAM 模式向普通 Pod 提供 VPC 可路由地址。secondary IPv4 address、delegated prefix、branch ENI 和 multi-NIC 配置各不相同;host-network Pod 共享 node 网络。
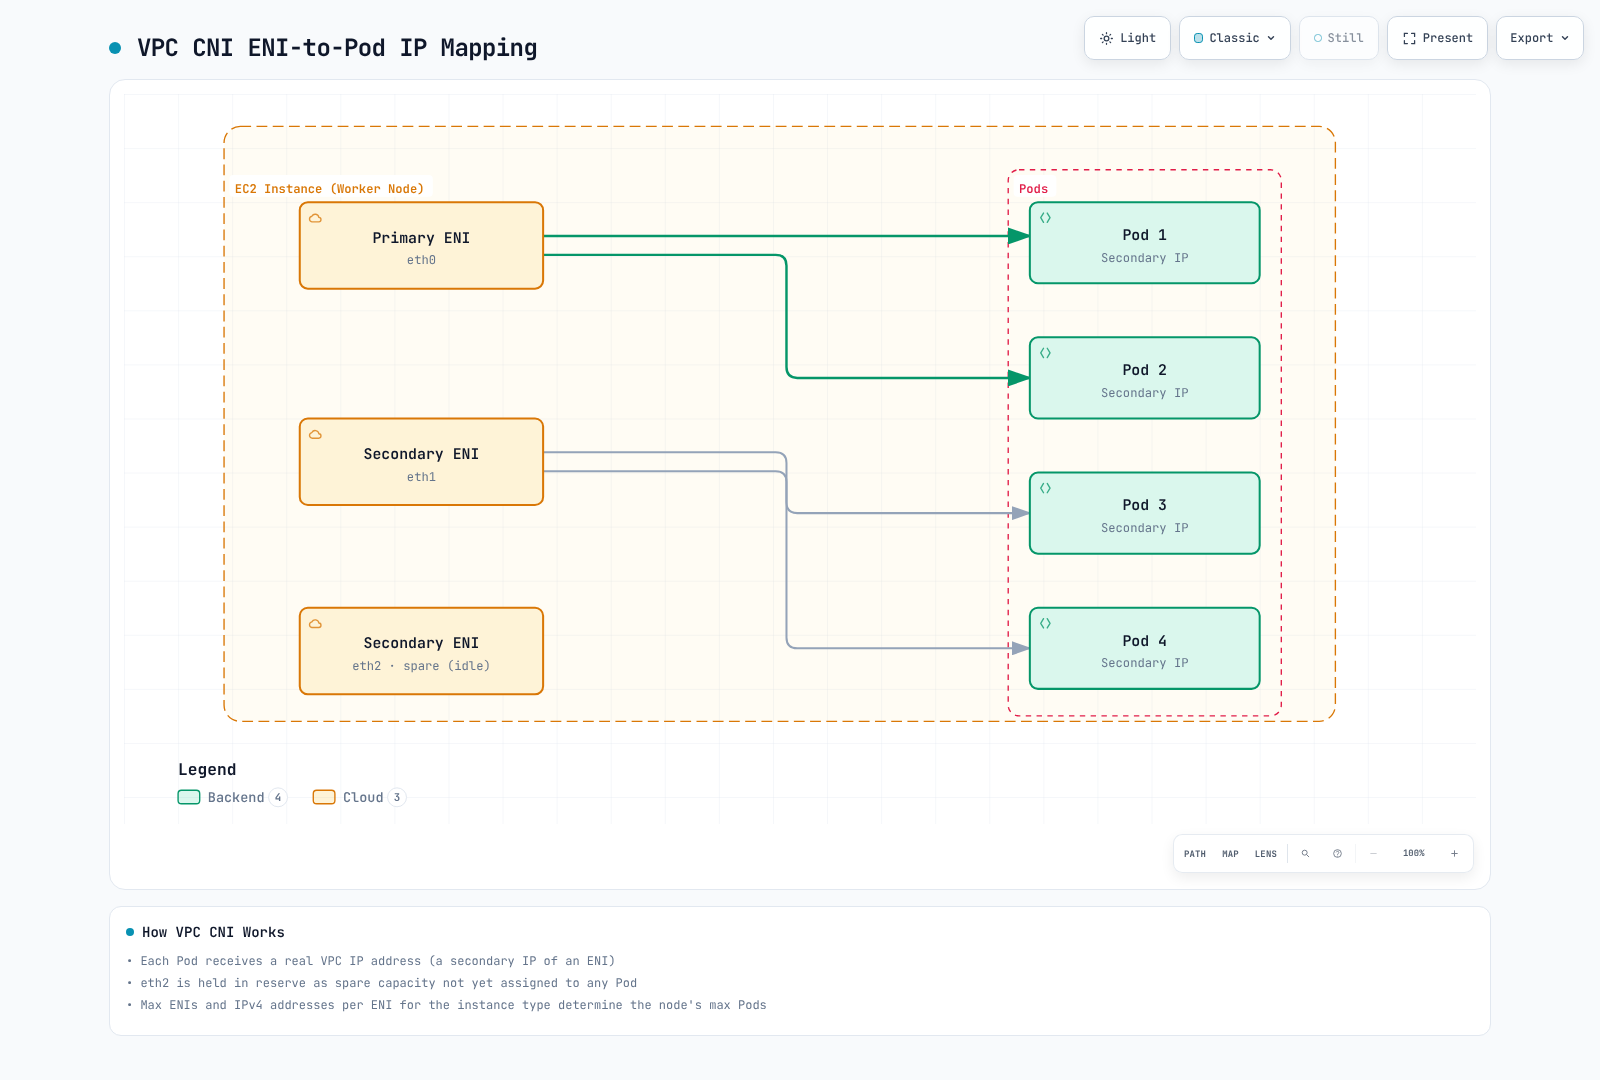
这只描绘了 secondary-IP 模式。warm ENI 是一种可配置的分配策略,并不要求每个 node 始终恰好保留一个。prefix delegation、custom networking 和 branch ENI 有不同的分配规则。
ENI 和 IP 限制
| Instance Type | 最大 ENI 数 | 每 ENI IPv4 slot | 旧版 secondary-IP bootstrap 值 |
|---|---|---|---|
| t3.medium | 3 | 6 | 17 |
| t3.large | 3 | 12 | 35 |
| m5.large | 3 | 10 | 29 |
| m5.xlarge | 4 | 15 | 58 |
| m5.2xlarge | 4 | 15 | 58 |
| c5.4xlarge | 8 | 30 | 234 |
这些值已根据 VPC CNI 1.23.0 instance limit 和旧版 max-Pods table 验证。历史计算方式为 ENIs × (IPv4 slots per ENI − 1) + 2;它并非当前通用建议。prefix delegation、custom networking、branch ENI 和多个 network card 会改变地址容量。Kubernetes 调度也受 kubelet maxPods 和资源限制。对于 vCPU 少于 30 的 instance,EKS managed node group 将 maxPods 上限设为 110,否则为 250;仅可用 IP 数量不能覆盖该上限。
EKS 网络注意事项
IP 地址管理
对于 Linux VPC CNI,请通过所选的 add-on/Helm/DaemonSet 管理机制配置记录在案的环境变量。以下是 EKS add-on 配置片段。带有 enable-prefix-delegation 的旧 amazon-vpc-cni ConfigMap 不会以此方式配置 Linux IPAMD。应用更改时请保留其他预期 add-on 值。
{
  "env": {
    "ENABLE_PREFIX_DELEGATION": "true",
    "WARM_PREFIX_TARGET": "1"
  }
}
或者,调整总分配下限和空闲 IP target。配置 MINIMUM_IP_TARGET 或 WARM_IP_TARGET 中任一个时,它优先于 WARM_PREFIX_TARGET;这些是替代策略而非四个独立的叠加 target。分配仍以 prefix 大小的单位发生。Nitro 支持、IPv4 的连续 /28 空间和适当的 kubelet Pod limit 是单独的先决条件。
Windows prefix 分配是不同配置路径:AWS 在 amazon-vpc-cni ConfigMap 中记录了 enable-windows-prefix-delegation 及其 warm-target key。不要将 Linux 环境变量流程原样复制到 Windows。
{
  "env": {
    "ENABLE_PREFIX_DELEGATION": "true",
    "MINIMUM_IP_TARGET": "5",
    "WARM_IP_TARGET": "2"
  }
}
Custom Networking
这些 IPv4 示例要求在目标 AZ 和 VPC 中使用真实 subnet/security-group ID。启用 custom networking,并通过每个 node 的 zone label 选择其 ENIConfig。显式 ENIConfig node annotation 优先于该 label。以下示例名称在两种语言中使用相同 region;请将它们替换为实际 node zone。仅安装 ENIConfig object 不会激活 custom networking。
{
  "env": {
    "AWS_VPC_K8S_CNI_CUSTOM_NETWORK_CFG": "true",
    "ENI_CONFIG_LABEL_DEF": "topology.kubernetes.io/zone"
  }
}apiVersion: crd.k8s.amazonaws.com/v1alpha1
kind: ENIConfig
metadata:
name: ap-northeast-2a
spec:
securityGroups:
- sg-0123456789abcdef0
subnet: subnet-0123456789abcdef0
---
apiVersion: crd.k8s.amazonaws.com/v1alpha1
kind: ENIConfig
metadata:
name: ap-northeast-2b
spec:
securityGroups:
- sg-0123456789abcdef0
subnet: subnet-fedcba9876543210f高级网络概念
下列项目在本概述的其他部分被顺带提及。完整设置过程和测量数字位于链接的深入页面中;本节按层组织这些部分的差异及其各自适用位置。
L2–L7 以及 Router 与 Load Balancer 的区别
“Router”和“load balancer”经常出现在同一句中,但它们回答不同的问题。router(通常)选择通向单个 destination 的一条路径;load balancer 使用分配算法从多个等效 candidate 中选择一个 target。
| 层 | 设备/功能 | 决策依据 | Kubernetes/AWS 映射 |
|---|---|---|---|
| L2(链路) | Switch、bridge | 目的 MAC address | 由 CNI 创建的 veth pair 和 Linux bridge、ENI 暴露的 virtual NIC |
| L3(网络) | Router 或透明 appliance 插入 | 用于路由的目的 IP;用于 appliance 选择的 flow identity | VPC 的隐式 router、TGW;GWLB 为 appliance 封装 IP 数据包 |
| L4(传输) | L4 load balancer | connection/flow identity,通常是 5-tuple | NLB;kube-proxy(iptables、IPVS、nftables);独立 eBPF Service 实现 |
| L7(应用程序) | L7 load balancer/reverse proxy | 每请求的 host、path、header;协议感知 | ALB、Ingress/Gateway API 实现、service-mesh sidecar(Envoy) |
关键差异是分配单位。L4 load balancer 通常为 TCP connection 或被跟踪 UDP flow 选择 target。L7 proxy 可以为每个受支持应用程序请求选择 target,包括共享 connection 的请求。GWLB 将封装的 IP flow 分配给安全 appliance,而非解析应用程序请求。flow stickiness 取决于配置的 timeout、health 和 failover 行为;它并不保证 flow 永远无法重新分配或中断。
📎 L2/L3 概念的协议级定义请参见网络基础第 1 部分;ALB/NLB target type 和实际配置请参见 AWS Load Balancer Controller。
跨账号/VPC 连接:TGW、VPC Peering、GWLB、PrivateLink、Lattice
这五种连接选项在层级和流量模型上有所不同。跨 TGW RAM sharing、VPC Peering、PrivateLink、TGW Peering 和 VPC Lattice 的测量延迟位于跨组织 VPC 连接。本节加入不在该对比表中的 GWLB,并按层重新框定全部五种选择。
| 连接方式 | 层/模型 | 特征 |
|---|---|---|
| VPC Peering | L3、双向 IP 路由 | 不可传递;不能跨重叠 CIDR 配置 |
| Transit Gateway (TGW) | L3、hub-and-spoke IP 路由 | 使用一个或多个 TGW route table 中的 attachment association 和 propagation;通过 RAM 跨账号共享 |
| Gateway Load Balancer (GWLB) | L3、透明 appliance 插入 | 在 GENEVE(UDP 6081)中封装原始数据包;VPC endpoint service 模型将 consumer 流量连接至 provider 的 appliance fleet |
| PrivateLink | Private endpoint 连接 | NLB-backed endpoint service 是一种模型;还存在 resource endpoint。consumer/provider CIDR 可以重叠 |
| VPC Lattice | 应用程序和资源网络 | HTTP/HTTPS service 支持 L7 路由和可选 IAM authorization;TLS passthrough 和 resource configuration 有不同能力 |
GWLB 通过 Gateway Load Balancer endpoint 在 IP 路径中插入 firewall 和 IDS/IPS 等检查 appliance。其默认 flow stickiness 使用五个字段;受支持配置可改用两个或三个字段。请验证正向和返回路由、appliance health、封装 MTU、NACL,以及实际 workload/appliance 的 security group。GWLB 本身没有 ALB 式 security group,flow stickiness 也不能代替故障测试。
有关安全设计,请参见 WAF/origin protection、Palo Alto/Fortinet NGFW 和 GWLB/GENEVE 路径与故障。GWLBE 也不支持 SG。对于所有 target 均不健康的情况,AWS 描述为按 flow 选择 target 并在恢复前丢弃,且不直接绕过 appliance。请结合审查 reduced-tuple stickiness、cross-zone、NAT 和 TGW appliance mode。
📎 完整的 EKS/VPC Lattice 集成(Gateway API Controller、IAM authorization、路由)位于 VPC Lattice。
DNS Resolver 和 Route Table 的实际行为
**DNS resolver:**AmazonProvidedDNS 就是 Route 53 Resolver。其地址包括 VPC 主 IPv4 network address 加二(对于 10.0.0.0/16 为 10.0.0.2)以及 169.254.169.253;它根据 Resolver rule 解析关联的 private zone 和公共名称。CoreDNS 通常服务于配置的 Kubernetes cluster domain(通常为 cluster.local);kube-dns 是其 Service 名称,而非 namespace 或 DNS zone。外部转发遵循 Corefile 和 DNS Pod 可见的 resolver file。请检查这些设置,而非假定 node 的 resolver file 被原样使用。在 Resolver endpoint 设计中,inbound endpoint 接受 on-premises query,而 outbound endpoint 和关联 rule 将选定 VPC query 转发至 on-premises DNS。Auto Mode 的 node-local resolver 不会消除上游依赖。
**Route table:**VPC 路由计算通常使用最长 prefix 匹配。AWS 允许替换 local route 的 target,并为 appliance 路由添加受支持的更具体 subnet route;local 并非无条件最具体的路由。对于相同 destination,静态 VPC route 优先于从 virtual private gateway 传播的 route。以 TGW 为 target 的 VPC route 是静态的;TGW 内的 propagation 属于其独立 route table。无效 target 可留下会丢弃流量的 blackhole entry,因此请检查 route state 以及 destination。没有显式 route-table association 的 subnet 使用 VPC 的 main route table。
📎 TGW/Peering route priority 和 static-route 配置示例请参见跨组织 VPC 连接的操作发现。
Kernel Dataplane:iptables、IPVS、eBPF 和 Packet Filtering
Linux Service 转发和 network-policy 实施可使用不同机制。Netfilter 提供 iptables 和 nftables 使用的数据包路径 hook。eBPF 实现可附加至 XDP、tc 或 socket hook,并在其中执行 Service 选择。这并不意味着启用 eBPF 的集群中每个数据包都绕过 Netfilter 或 connection tracking;路径取决于 CNI、kernel、路由和功能配置。
| 实现 | 所在位置 | 特征 |
|---|---|---|
| iptables | netfilter hook 上的顺序 rule chain | 计算时间随 rule count 扩展(O(n));kube-proxy 长期默认模式 |
| IPVS | Kernel-native L4 load balancer、netfilter extension | 基于 hash 的查找(接近 O(1));从 Kubernetes 1.35 开始作为 kube-proxy 模式弃用 |
| nftables | netfilter 的 iptables 后继 framework | 自 1.33 起 kube-proxy 的稳定模式;请先检查 kernel/CNI 兼容性 |
| eBPF(如 Cilium) | 配置的 XDP、tc 和 socket hook | 可替代 kube-proxy Service 处理;它是独立实现,具有路径特定的 Netfilter/conntrack 行为 |
切换实现可能会遗留 kernel rule 和活动 connection。请遵循发行版/CNI 的迁移流程,按需 drain workload,并在清理需要时计划 node restart。用基于 eBPF 的 CNI 替换 kube-proxy 还要求受支持的切换顺序,以免实现争夺相同 Service 流量。
📎 IPVS 弃用时间线和 nftables 稳定过渡请参见Kubernetes 简介;Cilium 的 eBPF kube-proxy 替换请参见 Cilium eBPF;Calico 的 eBPF data plane 和迁移流程请参见 Calico eBPF。
计算密集型网络:ENI、EFA、NVLink 和 Optical Transceiver
ENI、EFA 和 NVLink 服务于不同路径。ENI 是附加到一个 Availability Zone 中 EC2 instance 的虚拟网络接口;其正常 IP 流量在路由和策略允许时可到达其他 AZ 和已连接 VPC(参见 VPC CNI)。EFA 提供由兼容 MPI/NCCL 软件通过 libfabric 使用的 OS-bypass device。EFA device 流量不可路由,且无法跨越 VPC/AZ 边界;具有 ENA 的 EFA-with-ENA interface 中,通过 ENA device 的正常 IP 流量仍可路由。EFA-only interface 没有 ENA device 或 IP addressing。NVLink 在受支持系统内连接 GPU,包括受支持的 rack-scale NVLink domain。请测量所选 hardware、collective operation 和 placement,而非假定相对 EFA 的固定加速比。
Optical transceiver 是通用数据中心网络概念。Copper DAC(Direct Attach Copper)cable 适用于短距离;optical module 和 fiber 支持其他距离和带宽需求。QSFP 和 OSFP 描述 module form factor,并不保证使用 optical media。请将其视作一般背景:这并不能确定特定 AWS workload 的物理布线。
📎 NVLink/IMEX topology-aware scheduling 和 GPU Pod placement 示例请参见 AI/ML Infrastructure;EFA 的 VPC/AZ 边界限制和测量结果请参见跨组织 VPC 连接。
下一代协议对 Kubernetes 的意义:HTTP/3、gRPC、QUIC
HTTP/3(RFC 9114)及其 QUIC transport(RFC 9000)的协议机制在网络基础第 2 部分和第 3 部分中介绍。这里仅讨论实际影响 Kubernetes 流量分配的内容。
- **gRPC 和 L4 load balancer:**gRPC 通过 HTTP/2 connection 多路复用请求。L4 balancer 通常使已建立的 TCP connection 保持在选定 endpoint 上;若该 endpoint 是 proxy,它可以作出进一步路由决策。仅添加 Pod 不会重新分配现有 connection。每 RPC 分配需要兼容 L7 proxy 或 client-side 策略。streaming RPC 仍是一项 call;其单独 message 不会被独立均衡。
- **Gateway API 的 GRPCRoute:**Ingress 没有 gRPC 特定资源,但 Gateway API 通过
GRPCRoute标准化 service/method-level 路由。支持程度因实现而异(header match 数量、retry policy 等),所以请检查 controller 自身文档。 - **HTTP/3/QUIC 实际深入集群的范围:**client 与 edge(CDN、load balancer)之间的 HTTP/3 支持,与集群内或 Ingress 后端 connection 上的 HTTP/3 支持是不同问题。许多 Ingress/Gateway 实现仍与 backend 使用 HTTP/1.1 或 HTTP/2,是否支持端到端 HTTP/3 也因实现和版本而异——不要泛化;请检查实际使用 controller 的文档。
网络子页面
本节详细介绍以下主题:
从零开始学习 Linux 网络
如果你刚接触 Linux 或网络,请从初级课程开始。其八节课程关联了 CLI、寻址、DNS、SSH、防火墙、监控和综合项目。下方路径会将这一基础扩展至协议、内核和集群实现。
专家网络路径
完成初级课程后,使用专家网络路径将协议项目、路由策略、EVPN、Linux 性能、云设计和自动化评估联系起来。请先检查每个工作簿的环境、证据和恢复标准。
Linux 网络诊断练习
在学习 CNI 实现之前,将内核 socket 和数据包路径概念与观测联系起来。使用诊断测验检查你的解读。
VPC CNI
EKS 网络使用普通 Pod 的 VPC 地址,以及特定模式的 IPAM/策略先决条件。
Cilium 深入解析
基于 eBPF 的高性能 CNI 解决方案。提供 L7 Network Policy、Service Mesh 和可观测性(Hubble)等高级功能。
Calico 深入解析
最广泛使用的 CNI 之一。强大的 Network Policy、BGP 支持和企业功能。涵盖简介、架构、网络模式、BGP 深入解析、Network Policy、eBPF、高级主题、EKS 集成和运维指南。
VPC Lattice
AWS 托管应用程序网络服务。跨 VPC、跨账号的 service-to-service 通信。
AWS Load Balancer Controller
将 Kubernetes Service 和 Ingress 与 AWS ELB(ALB/NLB)集成。
Gateway API
下一代 Kubernetes ingress API。标准化的资源模型和基于角色的配置。
Pod 网络基准测试
在 EKS 上针对同一 node、同一 AZ 和跨 AZ 测量的 Pod-to-pod RTT、HTTP latency 和 throughput,以及 DNS ndots:5 query amplification。
网络故障排除
常见问题和解决方案
Pod 到 Pod 通信失败
NAMESPACE=default
POD_NAME=iperf-client  # An existing diagnostic Pod with nslookup/curl
SERVICE_NAME=my-service
kubectl -n "$NAMESPACE" get pods -o wide
kubectl -n "$NAMESPACE" exec "$POD_NAME" -- nslookup "$SERVICE_NAME"
kubectl -n "$NAMESPACE" exec "$POD_NAME" -- \
  curl --connect-timeout 3 --max-time 5 -v "http://$SERVICE_NAME:80/"
kubectl -n kube-system logs -l k8s-app=aws-node -c aws-node --tail=100
kubectl -n kube-system logs -l k8s-app=cilium -c cilium-agent --tail=100
从带有指定工具的现有 Pod 运行诊断。仅查询集群中安装的 CNI;Auto Mode system service 不是这些 DaemonSet。DNS 成功、TCP 可达性和应用程序 HTTP response 是不同检查。ICMP 可能被阻止或需要额外权限,因此仅 ping 失败并不能证明 TCP service 不可达。
Service 不可达
NAMESPACE=default
SERVICE_NAME=my-service
kubectl -n "$NAMESPACE" get service "$SERVICE_NAME" -o yaml
kubectl -n "$NAMESPACE" get endpointslices \
  -l "kubernetes.io/service-name=$SERVICE_NAME" -o yaml
kubectl -n kube-system logs -l k8s-app=kube-proxy --tail=100
对当前 endpoint 诊断使用 EndpointSlice。检查 Service selector、target port、endpoint readiness、address family 和适用策略。仅在该组件实际负责 Service 转发时检查 kube-proxy log;eBPF 替代实现或 Auto Mode 需要其自身诊断。
网络策略调试
kubectl get networkpolicies.networking.k8s.io -A
kubectl -n kube-system exec ds/cilium -c cilium-agent -- cilium-dbg policy get
kubectl -n kube-system exec ds/cilium -c cilium-agent -- cilium-dbg endpoint list
# For a Calico installation using its standard CRD datastore:
kubectl get networkpolicies.crd.projectcalico.org -A
kubectl get globalnetworkpolicies.crd.projectcalico.org
Cilium command 检查由 DaemonSet reference 选择的一个 Agent;追踪 incident 时请选择受影响 node 的 Agent。Calico native API installation 可能暴露不同 API group,因此请检查安装所提供的 resource。Kubernetes、Calico 和 AWS extension policy 是不同 resource,且可能有不同 precedence。
网络性能测试
此有界 TCP 练习使用发布者固定的 Netshoot v0.16 image index,其中包含 Linux AMD64 和 Arm64 image;其 Dockerfile 包含 iperf3。在允许 TCP 5201 的测试环境中创建这些 Pod。这是一个说明性 workload,而非测量的 CNI 对比。
apiVersion: v1
kind: Pod
metadata:
  name: iperf-server
  namespace: default
  labels:
    app: iperf-server
spec:
  restartPolicy: Never
  automountServiceAccountToken: false
  nodeSelector:
    kubernetes.io/os: linux
  containers:
  - name: netshoot
    image: nicolaka/netshoot:v0.16@sha256:b09d9b21381f47a79b3cbcb30da25266dc17186ea00ae65e99fdc51396f48e70
    command:
    - iperf3
    - -s
    workingDir: /tmp
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
    securityContext:
      runAsNonRoot: true
      runAsUser: 1000
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
        type: RuntimeDefault
    ports:
    - containerPort: 5201
      protocol: TCP
---
apiVersion: v1
kind: Pod
metadata:
  name: iperf-client
  namespace: default
  labels:
    app: iperf-client
spec:
  restartPolicy: Never
  automountServiceAccountToken: false
  nodeSelector:
    kubernetes.io/os: linux
  containers:
  - name: netshoot
    image: nicolaka/netshoot:v0.16@sha256:b09d9b21381f47a79b3cbcb30da25266dc17186ea00ae65e99fdc51396f48e70
    command:
    - sleep
    - '3600'
    workingDir: /tmp
    resources:
      requests:
        cpu: 100m
        memory: 64Mi
      limits:
        cpu: 500m
        memory: 256Mi
    securityContext:
      runAsNonRoot: true
      runAsUser: 1000
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
      seccompProfile:
type: RuntimeDefaultkubectl -n default wait --for=condition=Ready pod/iperf-server pod/iperf-client --timeout=120s
IPERF_SERVER_IP="$(kubectl -n default get pod iperf-server -o jsonpath='{.status.podIP}')"
test -n "$IPERF_SERVER_IP"
kubectl -n default exec iperf-client -- iperf3 -c "$IPERF_SERVER_IP" -t 10 -b 10Mclient 休眠一小时,该 command 将提供流量限制为十秒内 10 Mbit/s。这会测试选定路径,而非最大吞吐量。解释结果前,请记录实际 Pod/node/AZ placement、resource limit 和 policy。请为 Windows node 选择 Windows 专用工具。完成时仅移除你创建的测试 resource。
这些独立诊断 Pod 用于连接测试。对于原生 EKS network-policy 实施测试,请使用 Deployment/Job 管理的 Pod 和记录在案的 Service/container-port 要求。
最佳实践
1. IP 地址规划
- 设计足够大的 CIDR block
- 将 Pod 网络与 Service 网络分开
- 设计 subnet 时考虑未来扩展
2. 应用网络策略
使用此示例前,请创建隔离的 networking-demo namespace。它选择其中的每个 Pod,并按标准 Kubernetes NetworkPolicy 语义隔离 ingress 和 egress;所需 DNS 和应用程序 flow 需要显式 allow rule。实施需要受支持的策略引擎。额外的 cluster/admin policy API 可以改变 precedence,且此 manifest 并非完整的 zero-trust 架构。
- 应用默认拒绝策略(Zero Trust)
- 仅显式允许必需流量
- 隔离 namespace
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: networking-demo
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
3. 性能优化
- 选择合适的 CNI(与 workload 匹配)
- MTU 优化
- Kernel parameter 调优
4. 安全加固
- 选择受支持的传输加密,并验证其覆盖哪些流量。
- 在需要时配置 workload/application identity 和 mTLS;使其与基于 DNS/IP 的 allowlist 分离。
- 定期审查策略、certificate 和 access-control 更改。
5. 确保可观测性
- 收集网络指标
- 启用 flow log
- 实现 distributed tracing
后续步骤
完成初级课程后,继续学习内核网络栈,然后是 Linux 网络诊断练习及其测验。学习路径在下方 CNI 和 AWS 主题之前,将这些基础关联至容器和 Service。
- VPC CNI - 默认 EKS CNI
- Cilium 深入解析 - 基于 eBPF 的网络
- Calico 深入解析 - 路由、策略和 dataplane
- VPC Lattice - AWS 托管网络
- AWS Load Balancer Controller - ELB 集成
- Gateway API - 下一代 ingress
- 跨组织 VPC 连接 - 跨 AWS Organizations 连接 VPC(经现场验证)
- Pod 网络基准测试 - 按 node/AZ 边界测量的延迟和吞吐量
参考资料
- Kubernetes 网络模型
- Kubernetes Service
- Container runtime 和 CNI
- Kubernetes NetworkPolicy
- CNI 规范
- Calico 产品版本
- Calico Open Source 3.33.0 发行版
- Calico 策略 tier
- Calico Whisker flow log
- Calico Windows 限制
- Flannel 0.28.9 网络和策略
- Flannel backend
- 原始 Weave repository 状态
- AWS VPC CNI 1.23.0
- Amazon EKS 最新 VPC CNI add-on 版本
- EKS 网络策略配置
- EKS standard 和 Admin 网络策略
- EKS prefix delegation 和 maxPods
- EKS Admin 和 DNS 策略部署模型
- EKS Auto Mode 网络
- EKS add-on 要求
- EKS control plane 架构
- Netshoot v0.16 image metadata
- Netshoot v0.16 Dockerfile
- Tetragon runtime security
- AWS LBC 3.5 NLB 配置
- AWS LBC 3.5 Ingress 配置
- Gateway Load Balancer 概念
- GENEVE 封装 (RFC 8926)
- VPC DNS resolver
- Route 53 Resolver endpoint 和 rule
- VPC route table 计算顺序
- Local route 和更具体的 subnet route
- 静态和传播路由优先级
- AmazonProvidedDNS 地址和行为
- GWLB flow stickiness 和 failover
- Kubernetes Service virtual IP 和 kube-proxy 模式
- CoreDNS Service 名称和转发配置
- PrivateLink resource endpoint
- Netfilter/iptables 项目文档
- EC2 Elastic Fabric Adapter
- QUIC transport protocol (RFC 9000)
- HTTP/3 (RFC 9114)
- HTTP/2 上的 gRPC 和 load balancing
- Gateway API GRPCRoute