第 4 部分:Katib(超参数调优和 AutoML)
支持的版本:Katib 0.19.0,Kubeflow Community Distribution 26.03.1 最后更新:September 12, 2026
实验环境设置
使用 Katib 0.19.0 控制器、DB manager/storage、所需的 Suggestion 镜像和命名空间权限来创建 Experiments。区分完整平台的 Profile 访问权限与独立安装。GPU 容量为可选项;Karpenter 是一种节点供应器。
Katib 是什么
Katib 支持超参数优化(HPO)和神经架构搜索(NAS)。Experiment 定义目标、搜索空间、算法和 Trial 模板;Suggestion 及其算法服务会提出候选项;一个 Trial 管理一个候选项的执行。先前结果如何影响建议,取决于所用算法。
这些是由 CRD 定义的自定义资源对象,并非每次运行都要安装新的 CRD 定义。Trial 控制器会创建配置的作业资源;该作业的控制器和 Kubernetes 负责处理 Pod 创建和节点放置。0.19.0 的默认 trialResources 包含 TrainJob.v1alpha1.trainer.kubeflow.org、Kubernetes Job 和旧版训练作业类型。请确保实际使用的 Trainer API/运行时、权限、成功/失败条件以及指标收集器的目标 Pod/容器彼此匹配;兼容性并非自动保证。
使用 kubectl get experiments.kubeflow.org 和 kubectl get trials.kubeflow.org 检查状态。这些资源与 KFP 中名称相似的 Experiment API 并不相同。
搜索算法
算法名称必须与已安装的 KatibConfig 条目和 Suggestion 镜像相匹配。0.19.0 的默认配置包括:
| 名称 | 策略和限制 |
|---|---|
random | 对配置的空间/分布进行采样;并非每个参数都必然采用均匀采样 |
grid | 有限组合;目标、失败或 Trial 限制可能导致无法穷尽执行 |
bayesianoptimization、tpe、multivariate-tpe | 不同的基于模型的候选项策略;不能保证 Trial 数量更少或一定找到最优解 |
hyperband | 资源预算和逐次减半;训练代码必须遵循预算参数 |
cmaes、sobol | 分别为协方差自适应进化和低差异采样,两者并非相同算法 |
pbt | 基于种群的训练,需要共享检查点;与 CMA-ES 不同 |
enas、darts | 具有各自模板/依赖项的架构搜索算法 |
PBT 指南要求使用 RWX 卷和 resumePolicy: FromVolume。更改算法名称并不会让任意训练代码自动兼容。
Experiment 的组成
| 字段 | 含义 |
|---|---|
objective | 指标名称、最大化/最小化以及可选目标值 |
parameters | double/int/discrete/categorical 搜索空间、范围/列表/分布 |
algorithm | 已安装的 Suggestion 算法及其设置 |
trialTemplate | trialParameters 替换和作业 spec、主要容器/Pod 选择、成功/失败条件 |
parallelTrialCount | 并发处理的 Trial 数量,而非 Pod/GPU/EC2 数量 |
maxTrialCount | 基于完成数量的停止条件,而非成功训练次数或不可变的生命周期成本上限 |
maxFailedTrialCount | 失败阈值,包括失败和无法获取指标的 Trial |
metricsCollectorSpec / earlyStopping | 指标报告和单独配置的提前停止 |
达到目标、完成数量达到上限或建议耗尽,都可能使 Experiment 成功结束;达到失败阈值或发生 Suggestion 错误,则可能导致 Experiment 失败。完成状态会统计成功、失败、已终止、提前停止和无法获取指标的 Trial。恢复策略和 spec 变更也会影响生命周期,因此不要将 maxTrialCount 视为不可变的生命周期创建数量或支出上限。
Succeeded 表示控制循环的结果,而非对模型质量的认证。status.currentOptimalTrial 描述收集到的最佳观测结果;如果缺少指标,可能无法得到可用的最佳模型。
提前停止和 0.19.0 的 medianstop 实现
提前停止可以终止正在进行的 Trial。官方指南要求使用 StdOut/File 收集器和带时间戳的日志。不要假设每种收集器或任意训练循环都受到同等支持。默认值为 min_trials_required=3 和 start_step=4。
请区分文档描述的规则与此版本的实现。 官方指南描述的是已完成 Trial 的运行平均值的中位数。然而,在 v0.19.0 中,get_median_value 会存储每个成功 Trial 前 start_step 个观测值的平均值,并返回这些已存储平均值的算术平均值。在本地使用 [1, 2, 100] 执行未修改的函数,结果约为 34.333,而非统计学意义上的中位数 2。此版本的算法名称并不保证会进行中位数计算。
Hyperband 的预算分配与提前停止服务属于不同的配置/执行路径。请评估丢弃有潜力候选项的风险,以及指标格式、报告频率和预算参数带来的影响。
Experiment 的端到端运行流程
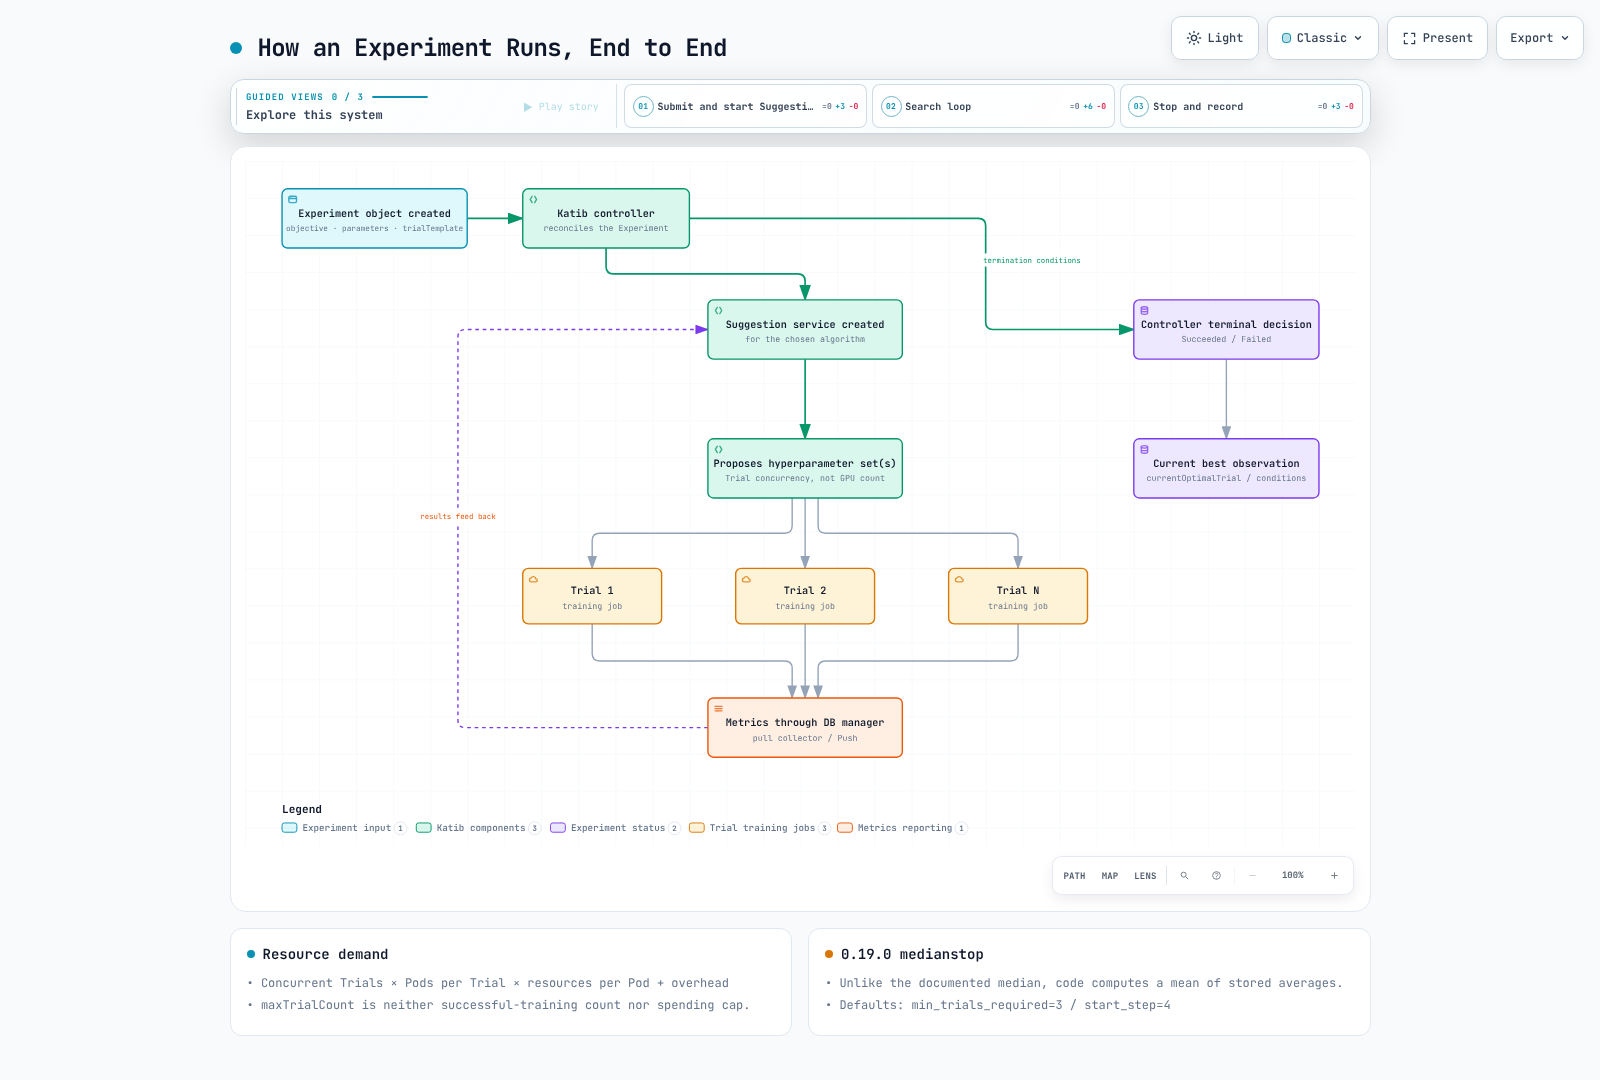
Experiment 控制器通过 Suggestion 资源请求候选项并创建 Trial 对象。Trial 和训练作业控制器负责执行流程,指标则通过 DB manager 报告。算法会根据各自的实现来使用结果。请检查终止条件和剩余的子作业;最优超参数本身并不是可部署的模型制品。
指标收集
| 模式 | 配置和限制 |
|---|---|
StdOut | 默认拉取模式;从主要容器的日志格式中提取指标 |
File | TEXT 或按行分隔的 JSON;配置路径和筛选器 |
TensorFlowEvent | 事件文件目录,包括兼容的 TensorBoard writer |
Custom | 用户提供的收集器实现;任意 HTTP 抓取并非内置默认功能 |
Push | 训练代码调用 SDK report_metrics() 将指标报告给 DB manager;并非总是需要收集器 sidecar |
拉取注入需要命名空间标签 katib.kubeflow.org/metrics-collector-injection: enabled、正常工作的 webhook,以及正确选择目标 Pod/容器。分布式训练需要明确的报告 rank 策略。请验证指标名称、数值格式、时间戳、连接和策略。训练作业成功并不保证已收集到指标。
EKS 上的容量和成本
需求大致为并发 Trial 数 × 每个 Trial 的 Pod 数 × 每个 Pod 的资源需求,再加上收集器/Suggestion/数据库的开销。如果每个 Trial 有两个 Pod,且每个 Pod 请求四个 GPU,那么 parallelTrialCount 为 8 时可能会请求 64 个 GPU,而不是八个。
对于 Pending Pod,请检查事件、调度约束、配额、NodePool/EC2 容量、驱动程序和引导状态。Karpenter 并不总能提供所需容量,提高并发度也不保证总运行时间更短。提前停止可以释放 Pod 资源,但保留节点仍会继续产生 EC2 费用。
请一并配置 Trial 总数条件、并发数、作业重试/分布式规模、截止时间和数据保留策略。在扩大 GPU 规模之前,先用小型 CPU 工作负载验证指标收集和终止流程。
验证和来源
已检查 v0.19.0 配置、控制器/API、收集器路径和 medianstop 源码。使用预加载的成功 Trial 历史记录,并阻止网络调用,在本地执行了未修改的 medianstop 函数。未运行任何 Experiment 或 GPU 工作负载。
后续步骤
继续了解第 5 部分分布式训练 API 和运行时:Trainer。
测验
若要测试你在本章学到的内容,请尝试主题测验。