EKS 上的 Spark 深入指南
审查基线:Apache Spark 4.2.0,Kubernetes 1.34 或更高版本
最后审阅日期:2026 年 9 月 12 日
Apache Spark 可运行批处理、SQL、流处理和其他分布式数据工作负载。 Spark 从 2.3 开始支持原生 Kubernetes;客户端模式支持则从 2.4 开始。 Spark 4.2.0 文档将 Kubernetes 1.34+ 列为前置条件。 应使用与实际 EKS 版本兼容的 kubectl,而不要依赖过时的固定最低版本。
Spark 可以使用你已经运行的 Kubernetes 容量和控制平面,无需额外部署 Spark Standalone master 或 YARN ResourceManager。你仍需运维或预置节点容量、镜像、身份、网络、存储和可观测性。 YARN ResourceManager/NodeManager 是 YARN 组件,并非 Spark 专属守护进程。
执行职责
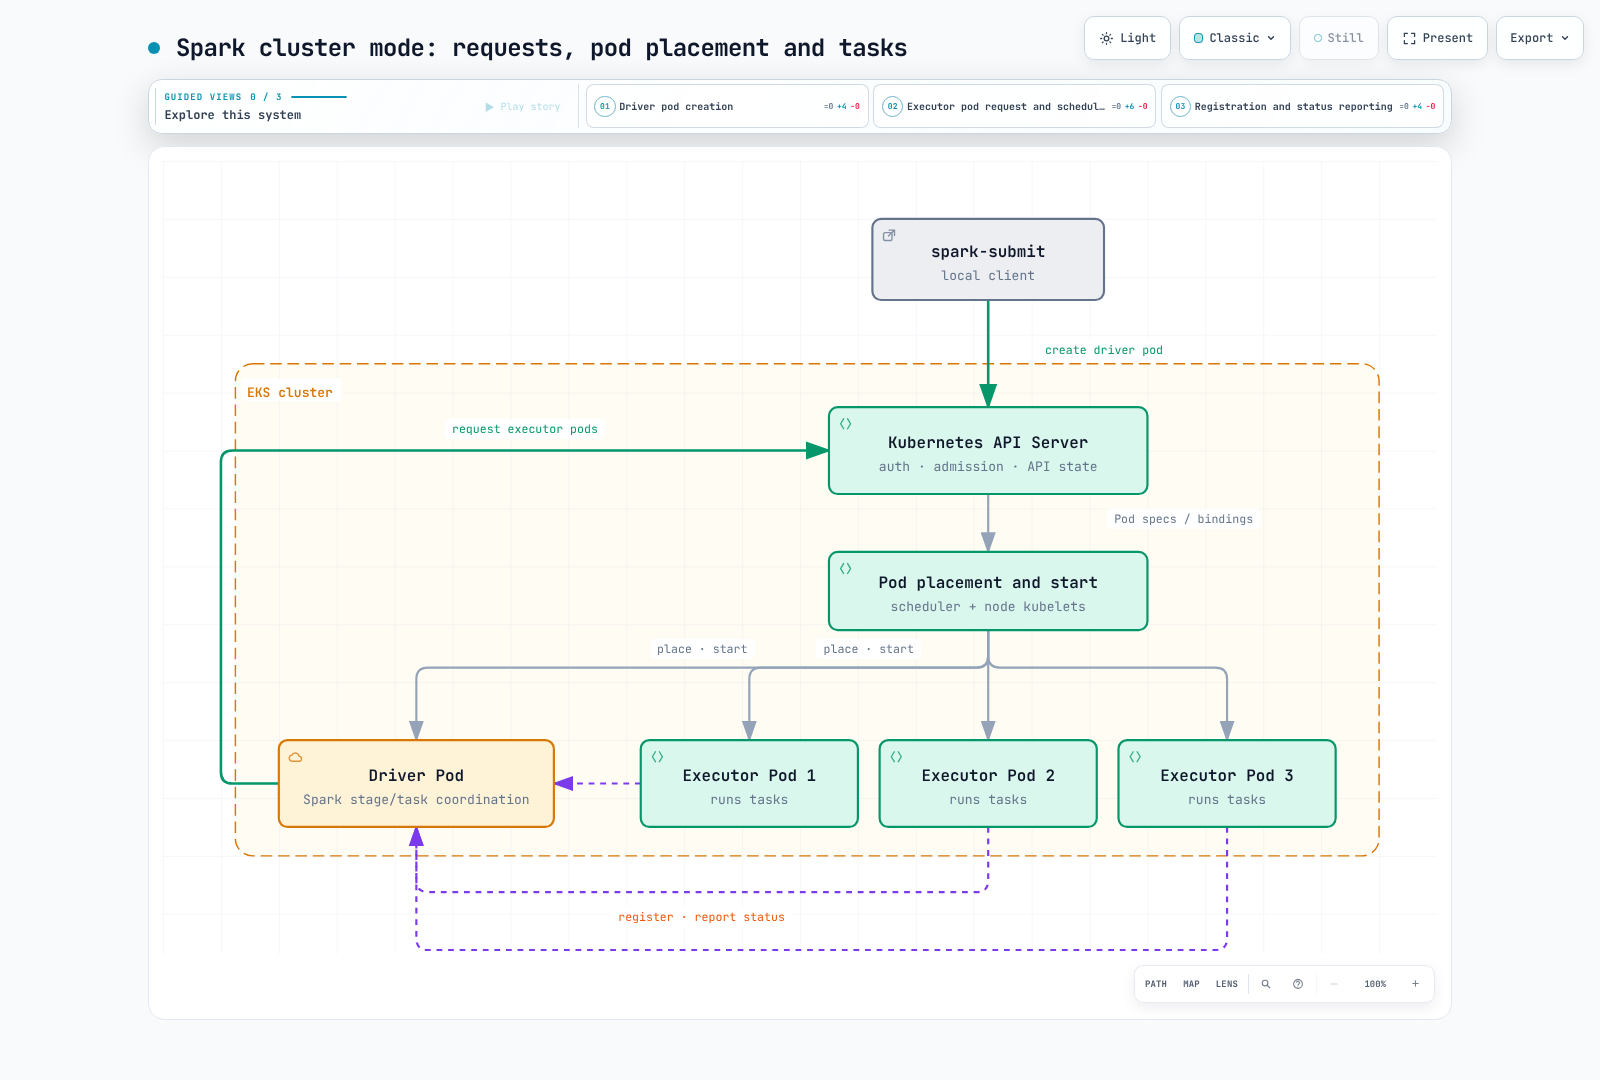
在 cluster 部署模式下,提交客户端会请求 Kubernetes API 创建 driver Pod。Kubernetes admission、scheduler 和节点 kubelet 负责 Pod 的放置与启动。Spark driver 请求 executor Pod,并协调 Spark stage/task;它不会取代 Kubernetes scheduler。
Executor 会注册到 driver,并直接与 driver 通信以执行 Spark 工作。Kubernetes 继续管理它们的 Pod 生命周期。在 client 模式下,driver 与提交应用一起运行,可以位于 Pod 内或其他主机上;executor 必须能够访问它。两种模式都支持 Spark 应用。
各章节
- Kubernetes 上的 Spark 基础知识:cluster/client 提交、资源映射、动态分配和 decommission 条件。
- Spark Operator:区分 Apache 和 Kubeflow Operator,以及它们的 API、作业生命周期、提交和监控。
- EKS 上的 EMR:虚拟集群、作业提交和执行身份;区分托管运行时功能与 EKS 容量运维。
- 性能和成本:shuffle/存储/CPU/内存瓶颈、合适的节点能力、Spot 恢复,以及 executor 与节点扩缩容。
- 最佳实践与安全:Kubernetes 和 AWS 身份、数据访问、事件日志/历史记录、指标、网络策略和恢复。
Spark 动态资源分配会调整应用内的 executor 数量。它与 Kubernetes 面向设备的 Dynamic Resource Allocation 以及节点自动扩缩容不同。Decommission 可以减少重新计算,但不能保证强制终止时每个 block 都能保留。