第 9 部分:EKS 上的 Kafka 基准测试(报告结果与复现限制)
报告的实验:2026 年 9 月 2 日,02:07–02:36 UTC
审阅更新:2026 年 9 月 12 日
实验版本:Kafka 4.3.1、EKS Kubernetes 1.36;三个合并 broker/controller Pod
本页保留了 PR #166 中报告的单次运行表格,并审查其单位、比较方式和复现流程。仓库报告没有附带原始遥测数据和负载哈希。本次审查没有重新运行 AWS 实验,也没有独立确认其历史测量结果。
这些数据表明,存储、缓存和客户端方面的限制值得测试。它们不能证明 RF3 存在普遍适用或可持续数小时的 130–135 MiB/s 上限。特别是,RF 对比同时改变了 acks,批次对比则改变了 linger 和运行时长。不能将观测到的比率描述为单独的因果效应。
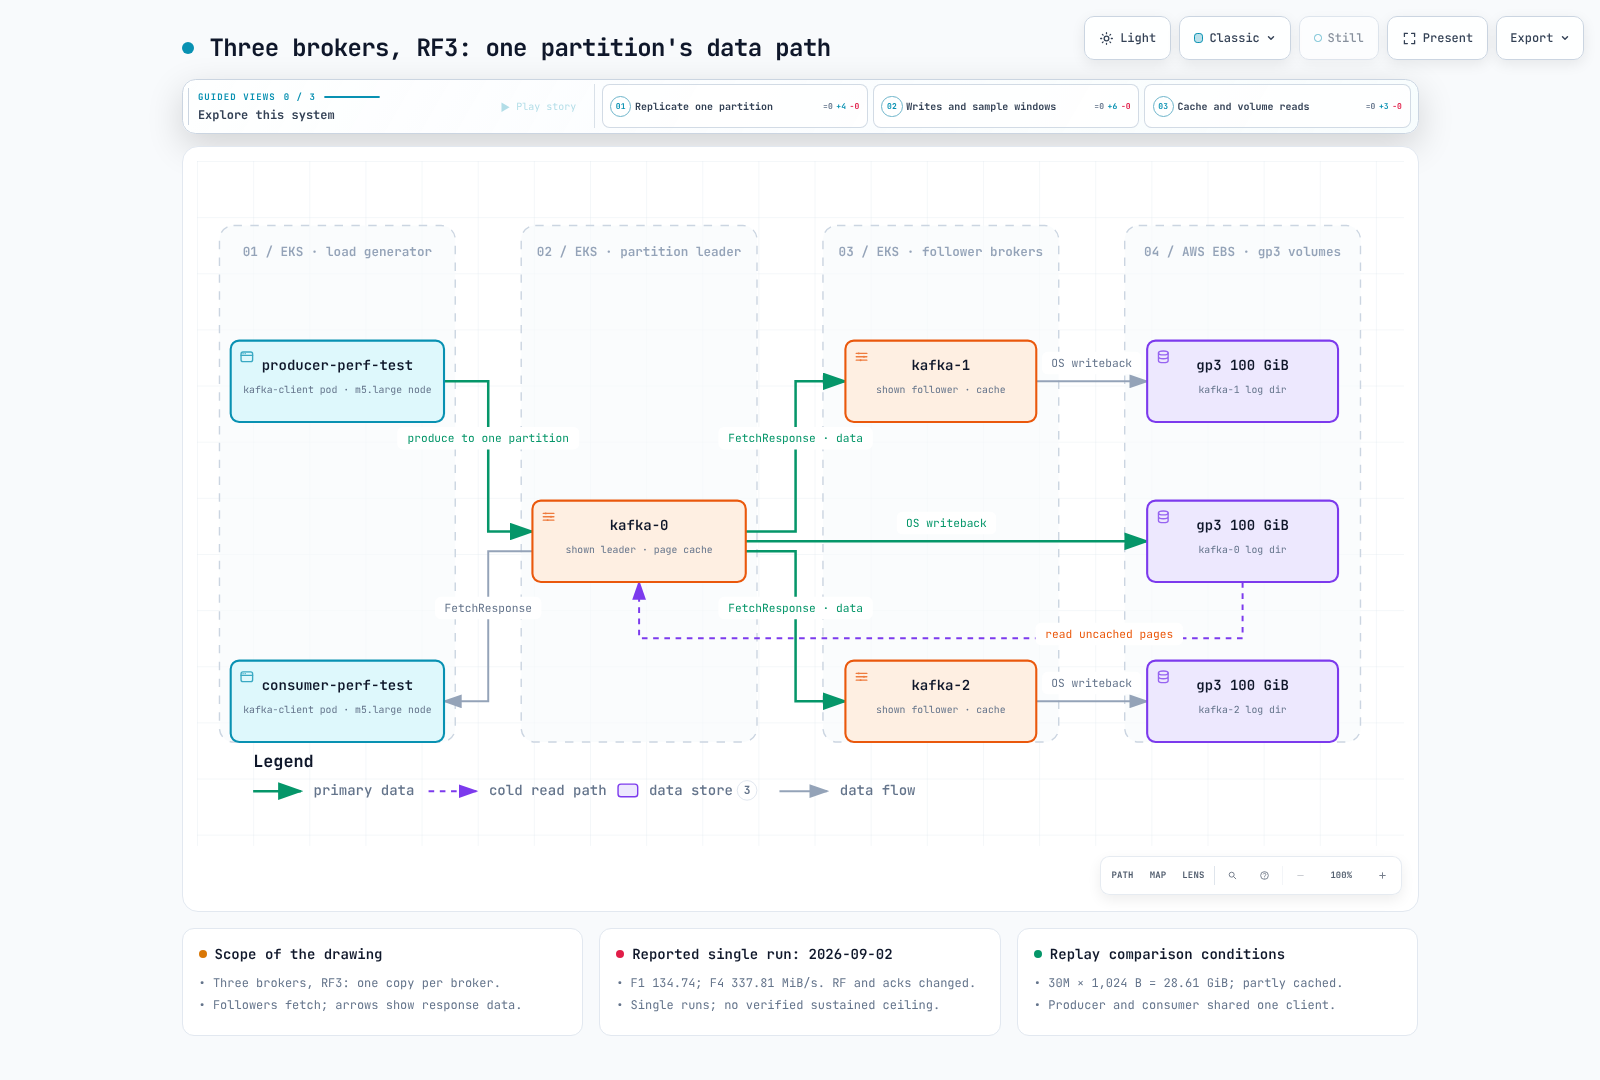
主要观测结果及其不能证明的内容
| 报告的比较 | 记录值 | 解释限制 |
|---|---|---|
| F1 RF3 / acks=all | 客户端吞吐量 134.74 MiB/s;broker 采样窗口约 75 s | 短时客户端速率,并非经认证的持续磁盘写入速率 |
| F4 与 F1 对比 | 337.81 / 134.74 = 2.507× | RF、acks/隐式幂等性、运行时长和缓存状态均不同 |
| F6 与 F1 对比 | 148.38 与 134.74 MiB/s,相差 +10.12%;报告的 broker CPU 较低 | batch、linger 和记录数均有变化;没有重复运行的方差估计 |
| B1 与 B2 对比 | 两者 p50 均为 3 ms;p99 为 126 与 17 ms | 一组限速测试,并非普遍适用的“仅尾延迟成本” |
| E4 与 E0 对比 | Producer 为 57.37 与 103.36 MiB/s,下降 −44.49% | 读写竞争是合理的解释;共用客户端也会引入竞争 |
报告的环境
| 项目 | 值 |
|---|---|
| 集群 | Amazon EKS、Kubernetes 1.36、ap-northeast-2(首尔)、由 Karpenter 管理的节点 |
| Brokers | 3 × apache/kafka:4.3.1(Kafka 4.3.1 发行版,报告的 OpenJDK 21.0.11),KRaft 合并模式(每个 Pod 同时是 broker + controller),StatefulSet,无 operator |
| Broker 节点 | 3 × m5.xlarge 按需实例(4 vCPU、16 GiB),全部位于 ap-northeast-2b,每个节点一个 broker(podAntiAffinity),来自 Karpenter system NodePool 的全新节点 |
| Broker Pod 资源 | requests:3 vCPU / 10 Gi,limits:4 vCPU / 12 Gi;KAFKA_HEAP_OPTS=-Xms4G -Xmx4G(其余内存也用于堆外/原生分配和页缓存) |
| Broker 存储 | 每个 broker 一个 gp3 100 GiB PVC(EBS CSI,StorageClass gp3),默认 gp3 性能为 3,000 IOPS / 125 MiB/s(与容量无关) |
| Broker 配置 | num.partitions=6、default.replication.factor=3、min.insync.replicas=2、log.segment.bytes=1 GiB、num.network.threads=4、num.io.threads=8、num.replica.fetchers=2、log.retention.hours=2 |
| 内核 | Amazon Linux 2023,6.18.41-94.142.amzn2023.x86_64;vm.dirty_ratio=20、vm.dirty_background_ratio=10、vm.dirty_expire_centisecs=3000 |
| m5.xlarge EC2 限制 | 网络基准带宽 1.25 Gbps(突发 10 Gbps);EBS 基准带宽 1,150 Mbps = 143.75 MB/s(≈ 137 MiB/s),6,000 IOPS;这是基准值,不是突发上限 |
| 负载生成器 | 一个 kafka-client Pod(相同镜像),运行在同一 AZ 的 m5.large 节点上(2 vCPU、8 GiB),cgroup 1.9 CPU 限制,KAFKA_HEAP_OPTS=-Xms2G -Xmx2G;m5.large 网络基准带宽 0.75 Gbps(突发 10 Gbps) |
| 工具 | apache/kafka 4.3.1 中自带的 kafka-producer-perf-test.sh、kafka-consumer-perf-test.sh |
| 网络路径 | 单个 AZ 内的 Pod 到 Pod,PLAINTEXT(无 TLS、无 SASL) |
| Topics | 每项测试使用新 topic,6 个分区;除非另有说明,使用 RF3 / min.insync.replicas=2(RF1 测试:RF1 / min.isr=1);retention.bytes=-1 |
| 测试 producer 设置 | 除非另有说明,使用 linger.ms=5、batch.size=65536、buffer.memory=67108864(64 MiB)、compression.type=none |
| 每小时成本 | 3 × m5.xlarge 按需实例,$0.236/h + 3 × gp3 100 GiB,$0.0912/GB-month(首尔区域,Pricing API,2026-09) |
报告称,在首次测量测试之前,kafka-1 于 02:05:22Z 重启过一次,测试期间没有重启。报告用“启动竞态”解释这一现象,但未查明根因。请保留这一区别。
据报告,所有 brokers 和负载生成器都位于同一 AZ,使用 PLAINTEXT,不使用 SASL,也不使用 Strimzi Operator。这不是一个跨三个 AZ 的生产环境对比。TLS、跨 AZ 流量、不同的节点/存储限制,以及独立的 controllers 都需要单独测量。
负载与工具语义
报告使用的文件包含 20,000 行合成 JSON,每行有 1,008 字节负载,其中约 63.2% 是容易压缩的 x 填充。换行分隔符不属于每个生成值。1,000 万个这样的值共包含 9.388 GiB 负载;按报告中每条记录 1,018 个磁盘字节计算,每个副本约为 9.481 GiB。
E2/E3 工作负载为 30,000,000 × 1,024 B = 28.610 GiB 负载。早先标为“30 GiB”或“29.3 GiB”的数值并非精确的 GiB 换算。三百万个 1,024 字节的值为 2.861 GiB。
在 Kafka 4.3.1 中:
--record-size会为每条记录生成 A–Z 字节,增加客户端 CPU 工作量。--payload-file则选择一个已加载的值。负载生成发生在工具开始报告发送延迟计时器之前。- 输出中的 “MB/sec” 将字节数除以 1,024²,因此单位是 MiB/s。 使用压缩时,该数值统计的是未压缩负载字节,而非网卡或卷上的字节。
- 发送延迟从
send()前一刻开始计时,包含同步发送/缓冲等待,直到 callback 返回。它不包括之前的负载生成,也不衡量下游处理。使用acks=0时,callback 完成并不代表 broker 已确认持久性。 - 大规模运行会对整数毫秒延迟进行周期性采样。两个测试的 p50 都报告为 3 ms,并不能证明其底层延迟相同。
- 失败的 callback 会被打印出来,但不会计入成功发送的记录数。请检查最终成功计数和 stderr,而不只是进程退出状态。
- Consumer 总耗时、fetch 耗时(不包括 group join)和所选时间间隔内的速率,其分母各不相同。最后一个 poll 批次可能超过请求的记录数。
旧版 --producer-props 和 consumer 的 --messages 选项在此版本中仍然可用,但已弃用。修订后的示例使用 --command-property 和 --num-records。
1. RF、确认方式与采样窗口
使用 payload-file 模式,不进行压缩;以下为原始报告中的数据。
| 测试 | acks | RF | producers | 记录数 | rec/s | MiB/s | 平均 ms | p50 | p95 | p99 | p99.9 | 最大值 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| F1 | all | 3 | 1 | 10 M | 140,164 | 134.74 | 443.89 | 321 | 1,276 | 2,689 | 4,026 | 4,038 |
| F2 | 1 | 3 | 1 | 6 M | 248,221 | 238.62 | 222.66 | 230 | 321 | 398 | 426 | 650 |
| F3 | 0 | 3 | 1 | 6 M | 241,138 | 231.81 | 235.02 | 191 | 333 | 1,977 | 4,327 | 4,340 |
| F4 | 1 | 1 | 1 | 10 M | 351,407 | 337.81 | 159.51 | 138 | 290 | 358 | 515 | 642 |
| F5 | all | 3 | 2 | 2 × 5 M | 67,694 + 67,360 = 135,054 | 65.07 + 64.75 = 129.82 | 893.88 / 889.22 | 639 / 630 | 2,536 / 2,493 | 3,270 / 3,301 | 4,284 / 4,228 | 4,662 / 4,660 |
| F6 | all | 3 | 1 | 6 M | 154,349 | 148.38 | 395.82 | 238 | 1,142 | 2,094 | 2,594 | 2,621 |
F4/F1 的算术比率为 2.507,但 F4 使用 RF1/acks=1,F1 使用 RF3/acks=all。 当省略幂等性设置时,Kafka 4.3.1 的默认值也会因确认方式不同而异。这不是一项只测量复制影响的受控测量。F4 约 32 秒的运行时间只会将其数据的约三分之一分散到每个 broker 上,因此缓存和客户端限制可能对其结果造成显著影响。
对于 F5,129.82 是两个分别报告的速率之和。严谨的合并速率应使用成功传输的总字节数除以共同的起止时间间隔;将时间窗口不同的速率相加,未必能得到这个结果。
报告的 broker 计数器
| 窗口 | 写入 MiB/s 平均值(峰值 10s) | wIOPS | 读取 MiB/s (rIOPS) | broker CPU 核数 | NIC tx / rx MiB/s |
|---|---|---|---|---|---|
| F1 RF3 acks=all 10 M (75 s) | 115.2–117.5 (134.9–135.1) | 495–505 | 0 | 0.64–0.84 | 80.2–108.1 / 134.2–135.8 |
| F2 RF3 acks=1 6 M (28 s) | 92.8–100.4 (124.1–127.6) | 397–427 | 0 | 0.53–0.62 | 64.4–80.4 / 123.7–125.0 |
| F3 RF3 acks=0 6 M (28 s) | 97.2–120.5 (123.5–124.1) | 414–514 | 0 | 0.80–0.81 | 87.3–94.4 / 163.5–170.6 |
| F4 RF1 acks=1 10 M (32 s) | 72.5–80.4 (117.6–129.1) | 312–346 | 0 | 0.30–0.31 | 0.3 / 119.9–125.4 |
| F5 2 producers RF3 acks=all (81 s) | 99.9–102.2 (134.8–135.5) | 431–439 | 0 | 0.59–0.81 | 66.5–89.7 / 113.8–115.6 |
| F6 RF3 acks=all batch 256 KiB (43 s) | 102.3–107.7 (134.8–135.4) | 426–445 | 0 | 0.40–0.50 | 68.7–110.4 / 124.2–124.5 |
| E2 填充 30M × 1,024 B,随机模式 (262 s) | 110.0–111.5 (134.5–135.0) | 468–473 | 0 | 0.72–0.80 | 74.9–77.5 / 114.3 |
原始采样器在顺序执行的 kubectl 调用之间休眠十秒,因此实际采样间隔约为十二秒。它只在对三个 brokers 采样之前为一轮采样统一打了一次时间戳。因此,执行延迟、时间戳分辨率和窗口边界都很重要。最高采样值并不是稳态估计值,约 135 MiB/s 的数值也不能证明应将 gp3 配置的 125 MiB/s 吞吐量建模为 135。
报告中的 CloudWatch E2 窗口包含每分钟 7,008–7,257 MiB,即 116.8–121.0 MiB/s;每分钟写入 29,637–30,730 次,即约 494–512 IOPS。这些聚合值与大量顺序 I/O 相符,但仅凭这些值无法区分卷限制、实例 EBS 限制、缓冲区影响或短采样伪差。broker CPU 较低也不能排除客户端瓶颈。
存储平衡模型,而非测得的普遍上限
令 Xlog 表示单个副本的编码日志字节速率,R 表示复制因子,B 表示 broker 数量,D 表示每个 broker 的持续存储预算。在放置均衡的情况下,每个 broker 的平均写入量约为 R × Xlog / B,另加其他 I/O。对于恰好三个 brokers 和 RF3,每个 broker 都拥有每个分区的一个副本。均衡的 leader 流量也意味着每个 broker 的副本传输流量约为 2 × Xlog / 3;整个集群的副本流量约为 2 × Xlog。
这种核算有助于提出假设,但不等同于负载速率基准测试:编码、压缩、缓存/回写、读取和元数据会消耗不同的预算。在单独控制其他条件后,应测试提高 broker/卷吞吐量,再判断瓶颈。
2. 确认延迟
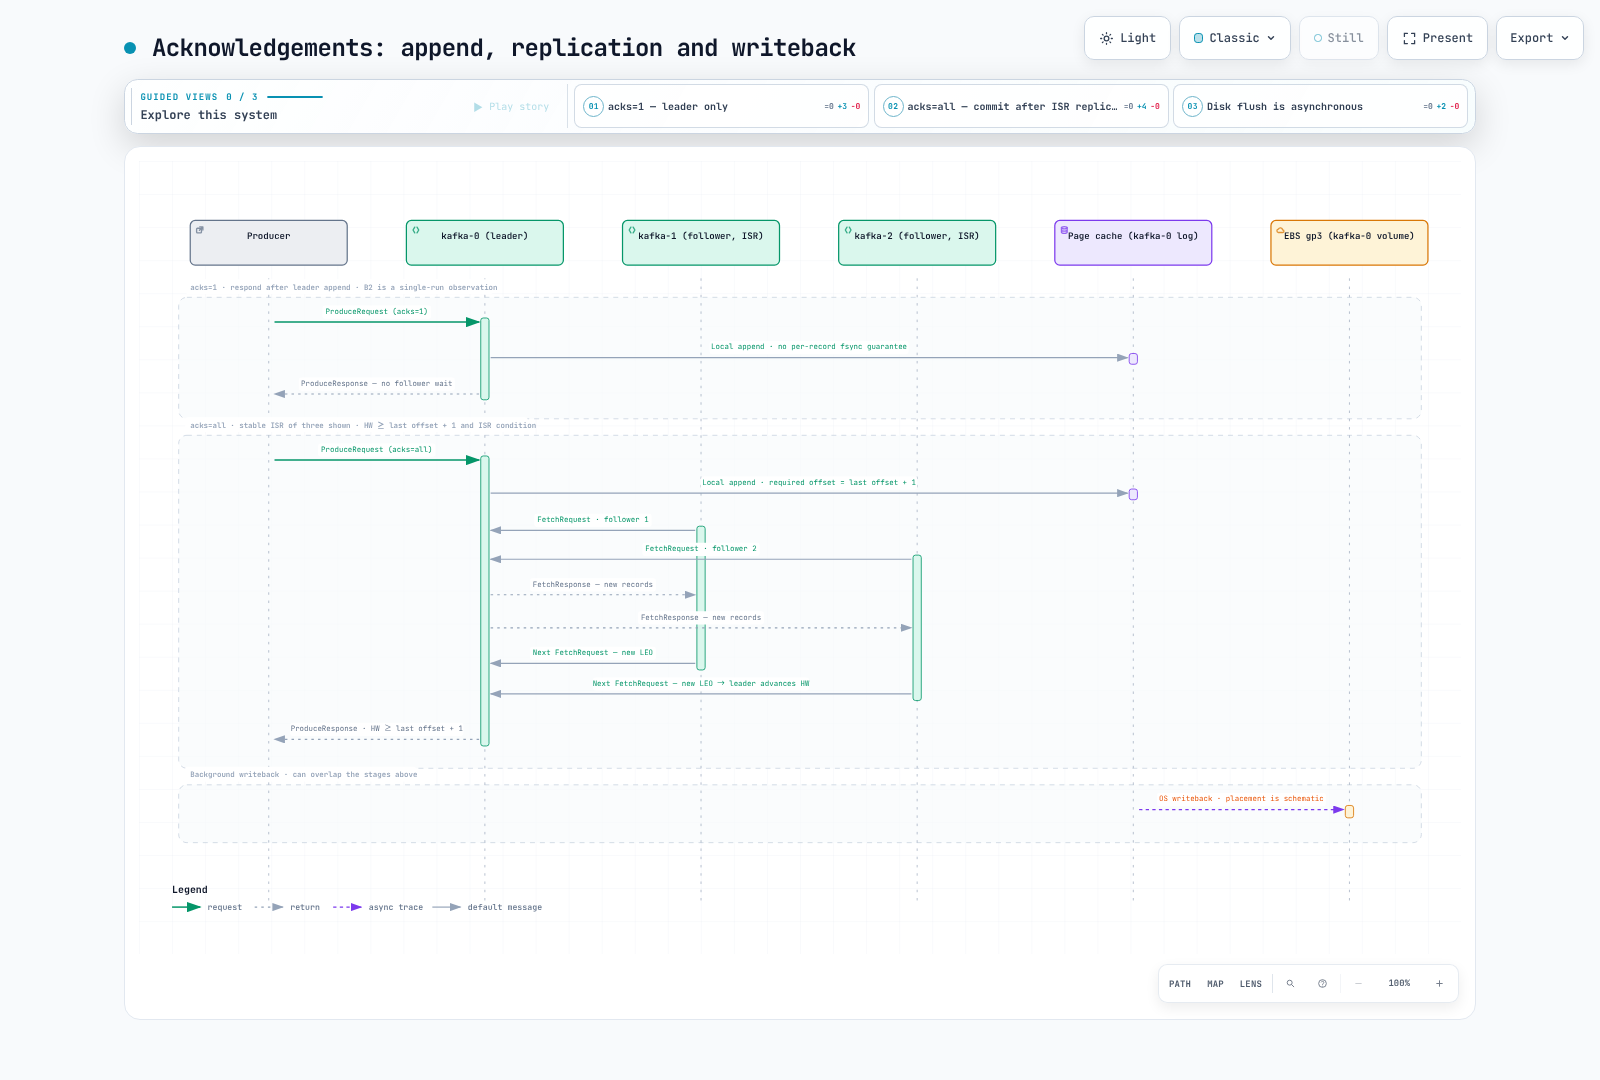
受限速率的 B 测试使用 20,000 条记录/秒、RF3 和随机 1,024 字节值:
| 测试 | acks | linger.ms | 平均 ms | p50 | p95 | p99 | p99.9 | 最大值 |
|---|---|---|---|---|---|---|---|---|
| B1 | all | 5 | 5.27 | 3 | 6 | 126 | 173 | 771 |
| B2 | 1 | 5 | 2.58 | 3 | 5 | 17 | 40 | 642 |
| B3 | all | 0 | 3.23 | 3 | 5 | 25 | 59 | 752 |
报告中的 p99 比率 B1/B2 为 7.412;平均延迟也不同(5.27 与 2.58 ms),因此说“只有尾延迟不同”夸大了结果。B3 改变了 linger,但若要将较小批次作为因果解释,需要请求大小、请求数量和重复运行的证据。报告中没有限速的 acks=0 结果。
以下 A 测试还包含随机负载生成开销:
| 测试 | acks | RF | rec/s | MiB/s | 平均 ms | p50 | p95 | p99 | p99.9 | 最大值 |
|---|---|---|---|---|---|---|---|---|---|---|
| A1 | all | 3 | 107,150 | 104.64 | 11.38 | 3 | 50 | 164 | 263 | 871 |
| A2 | 1 | 3 | 105,955 | 103.47 | 3.00 | 1 | 11 | 38 | 79 | 812 |
| A3 | 0 | 3 | 112,461 | 109.82 | 1.48 | 0 | 6 | 26 | 52 | 636 |
| A4 | 1 | 1 | 109,926 | 107.35 | 1.57 | 1 | 6 | 11 | 36 | 662 |
A 组各配置的吞吐量相近,这表明它们可能受到共同限制,但这本身并不是 CPU 分析。使用 acks=0 时,客户端/缓冲区/socket 仍会受到背压;缺少 broker 确认并不会消除所有形式的背压。成功的 callback 也不能证明某个副本包含该记录。
在时序图中,高水位是一个next offset。对于最后一条记录位于 r 的批次,所需 offset 为 r+1;确认需要满足相应的 HW 检查和 ISR 条件。跟踪图显示的是稳定 ISR 中的全部三个副本,而不是说 minISR=2 时始终必须有两个 follower 留在 ISR 中。
3. 批次大小与 producer 数量
| 测试 | 相对 F1 的变化 | MiB/s | 平均 ms | p99 ms | broker CPU 核数 |
|---|---|---|---|---|---|
| F1 | 基线:1 个 producer、batch.size=65536、linger.ms=5、10 M 条记录 | 134.74 | 443.89 | 2,689 | 0.64–0.84 |
| F5 | 2 个 producers(每个 5 M 条记录),属性相同 | 65.07 + 64.75 = 129.82 | 893.88 / 889.22 | 3,270 / 3,301 | 0.59–0.81 |
| F6 | batch.size=262144、linger.ms=10、6 M 条记录 | 148.38 | 395.82 | 2,094 | 0.40–0.50 |
F6 改变了 batch size、linger 和记录数。报告中的吞吐量高出 10.12%,broker CPU 范围也较低。中点计算 1 − 0.45/0.74 = 39.19% 描述的是这些报告范围,并不能说明批次大小单独导致 CPU 节省 40%。没有重复测试,就无法判断吞吐量差异是否“在噪声范围内”。
在此设置中,F5 没有提高记录速率。它还在同一个受限客户端 Pod 上运行了两个 producers。在断定增加 producers 永远没有帮助之前,应使用独立配置的客户端进行重复测试,并采用共同的计时区间。
4. 使用填充语料进行压缩
| 编解码器 | rec/s | MiB/s(报告值,未压缩) | 平均 ms | p50 | p95 | p99 | p99.9 | 磁盘 B/记录(每副本) | 相对 none 的比率 |
|---|---|---|---|---|---|---|---|---|---|
| none | 203,887 | 196.00 | 259.59 | 266 | 370 | 425 | 458 | 1,018 | 1.00× |
| lz4 | 275,356 | 264.70 | 4.38 | 3 | 11 | 24 | 60 | 113.1 | 缩小 9.0× |
| snappy | 198,557 | 190.87 | 5.07 | 3 | 10 | 35 | 205 | 141.7 | 7.2× |
| zstd | 160,274 | 154.07 | 5.39 | 5 | 10 | 18 | 47 | 61.3 | 16.6× |
| gzip | 53,418 | 51.35 | 6.01 | 6 | 10 | 17 | 45 | 60.7 | 16.8× |
none/lz4/snappy/zstd/gzip 的原始单副本日志大小分别为 2,912.4 / 323.5 / 405.3 / 175.3 / 173.8 MiB。除以三百万条记录,可以复算得到表中四舍五入后的每条记录字节数。这是报告中的 Kafka 日志大小,不包括所有索引、文件系统或已配置的卷空间。
填充内容使这些结果无法代表许多真实数据集。**这些比率和编解码器排序都不具有普遍性,也不是数学上的上限。**原报告中,整个语料的 zlib-6 数据在有填充和无填充时分别为 18.5× 和 7.8×。本次审查使用 GNU Awk 5.1.0 重新生成已发布的 AWK 脚本,得到 20,000 行有效的 1,008 字节数据,填充占 63.17%,但比率分别为 15.92× 和 6.53×。这是一个新的语料,不是对历史测量结果的替代;请固定镜像/AWK 实现并保留负载哈希。
将 topic 压缩设置为 producer 时,会保留 codec 的选择,而不会有意重新压缩为另一种已配置的 codec。Broker 验证和其他处理仍会消耗 CPU。报告中压缩后延迟较低,这与存储/传输字节数减少相符;但要声称瓶颈发生了单一且明确的转移,还需要客户端 CPU 和分阶段 I/O 证据。
5. 记录大小
| 测试 | 记录大小 | 记录数 | rec/s | MiB/s | 平均 ms | p50 | p95 | p99 | p99.9 |
|---|---|---|---|---|---|---|---|---|---|
| D1 | 100 B | 10,000,000 | 506,380 | 48.29 | 3.18 | 2 | 9 | 15 | 33 |
| A1 | 1,024 B | 3,000,000 | 107,150 | 104.64 | 11.38 | 3 | 50 | 164 | 263 |
| D2 | 10,240 B | 300,000 | 12,326 | 120.37 | 17.40 | 5 | 84 | 157 | 223 |
这些测试采用了不同的记录生成工作负载和记录数。100 字节测试的记录数/秒约为另一测试的 4.73×,但负载速率只有 1,024 字节测试的 46.15%。这说明记录数/秒和字节数/秒都很重要;但它并不能将 broker 的单条记录成本与客户端生成、批次或缓存影响区分开来。只有在聚合处理的延迟、键和失败语义符合应用需求时,才应考虑聚合。
6. 与生产同时进行重放
报告中的 E0 producer 速率为 103.36 MiB/s,p99 为 82 ms。E1 选定的热点时间间隔为 434.11 MiB/s。E2 生成三千万个 1,024 字节的值(28.610 GiB),报告速率为 112.84 MiB/s,p99 为 1,531 ms。观测到了反复出现的慢速时间间隔,但脏页回写只是一个假设。
E2 记录的其他延迟值为:平均 60.17 ms、p50 为 2、p95 为 125、p99.9 为 5,034、最大值为 5,258 ms。在报告的 51 个时间间隔中,有五个速率低于 60 MiB/s:56.8、36.3、45.3、40.8 和 45.8。这些观测无法确定暂停的原因。
E3 的 13 个完整时间间隔速率的算术平均值为 438.615 MiB/s: 337.6、431.3、414.2、495.7、454.9、452.1、387.9、458.7、439.9、452.4、 447.7、491.0 和 438.6。重放时缓存仅部分冷却;没有建立完全冷缓存状态。不要简单地用不同窗口的网卡平均值减去磁盘平均值,来推算精确的页缓存字节速率。
| 单独运行 | 重放期间 | 测试 | |
|---|---|---|---|
| Producer 吞吐量 | 103.36 MiB/s (105,843 rec/s) | 57.37 MiB/s (58,746 rec/s) | E0 → E4 |
| Producer 平均值 / p50 | - / - | 294.06 ms / 18 ms | E4 |
| Producer p95 / p99 / p99.9 / 最大值 | p99 为 82 ms | 1,587 / 2,147 / 2,425 / 2,569 ms | E0 → E4 |
| Consumer 吞吐量(完整 5 秒时间间隔的平均值与 fetch 耗时速率) | 438.6 MiB/s | fetch 耗时内为 299.62 MiB/s,295,726 msg/s(总速率为 288.79 MiB/s,包含 3,666 ms 的再均衡;101.4 s 总耗时内处理 29,297.33 MiB / 30,000,466 条消息) | E3 → E4 |
| 每个 broker(produce 窗口) | 写入 60.4–67.4 MiB/s(其余由页缓存吸收),读取 0 | 写入 39.4–47.2 + 读取 28.6–37.7 MiB/s,tx 92.6–106.0 MiB/s,CPU 0.36–0.42 核 | E0 → E4 |
E4 的 producer 速率下降了 44.49%。由于读写共用每个卷,存储竞争是合理的解释;但 producer 和 consumer 也共用了一个 1.9-CPU 客户端 Pod 及其网卡。整个会话的 throttling 总量和较低的 broker CPU,不能排除特定阶段发生的客户端竞争。
报告记录 E4 消费了 29,297.33 MiB 和 30,000,466 条记录,总体速率为 288.79 MiB/s,排除 join 时间后为 299.62 MiB/s。最后一个 poll 批次导致消费数量超过请求数量是可能的;仅凭额外的记录数并不能证明发生了重复。
E1 选定的时间间隔、E3 未加权的时间间隔平均值,以及 E4 的 fetch/总耗时速率不能互换。特别是,“438.6 → 299.62”并不是使用相同分母进行的受控吞吐量下降比较。应保留原始时间戳、总字节数和分阶段资源计数器,以便比较共同的时间间隔。
7. 多久才算足够长?
Kafka 确认并不意味着每个副本都会对每条记录执行 fsync。追加操作可能累积在页缓存中,同时由异步回写机制处理;但这并不意味着复制可以保证抵御所有相关故障。
报告包含高于理想化 3 × 125 = 375 MiB/s 卷预算的 F4 时间间隔,以及 E0 结束后的回写。这些情况说明需要核对缓冲区和测量窗口。**不存在一个普遍适用的十 GiB 或一分钟阈值,可以证明磁盘已达到稳态。**F1 运行中约 9.5 GiB 的编码数据也不能作为此类证明。
请采用固定预热时间和较长的稳态测量期,记录运行后的排空情况,监视脏内存以及 EBS/网络额度行为,并以随机顺序重复测试。进行因果比较时,每次只改变一个因素。在其他因素保持稳定的情况下提高存储吞吐量,是一项有价值的后续实验。
正确比较网络与 EBS
EC2 使用独立的入站和出站网络额度桶。不要将 rx 和 tx 相加,再用总和与单向基准带宽比较。报告的 F1 最大 rx 为 136 MiB/s,约 1.141 Gbps;tx 为 108 MiB/s,约 0.906 Gbps;二者各自都低于 m5.xlarge 的 1.25 Gbps 基准带宽。这些 F1 数值不能证明 broker 网络发生了突发。
F4 客户端负载速率为 337.81 MiB/s,约 2.834 Gbps,高于 m5.large 的 0.75 Gbps 基准带宽。依赖额度的客户端性能仍是一项重要限制。还需要观测数据包速率、流量限制以及节点上的其他流量。
m5.xlarge EBS 带宽标称为基准 1,150 Mbps、最大 4,750 Mbps,约为 137.09 / 566.24 MiB/s。基准值并非绝对的瞬时上限。当前 gp3 的最大值为 2,000 MiB/s,但受其 IOPS/卷条件和实例限制约束;此前关于 1,000 MiB/s 的说法已经过时。更大的卷或更强的 broker 都不能自动证明究竟是哪项资源限制了报告中的运行。
成本计算,不是账单或当前价格报价
使用历史报告中的费率 $0.236/broker-hour 和 $0.0912/GB-month,并依据其成本归因假设:
| 计算 | 结果 |
|---|---|
| 三个 brokers × 50 分钟 | $0.590 |
| 三个 100-GiB 卷 × 39 分钟,按 730 小时折算 | $0.02436 |
| 单次运行归因到上述项目的成本 | 约 $0.614 |
| 三个 brokers × 730 小时,加 300 GiB-month 存储 | $544.20 |
按 730 小时计算是一种规划惯例,并非九月份的账单。原始客户端节点、EKS/控制平面费用、网络费用及其他共享基础设施均未计入。如果节点还为其他工作负载保留,运行时长的成本归因也只是估算。在配置资源之前,请重新核对当前区域价格;本次审查没有查询账单,也没有确认新的价格凭据。
仅凭 broker CPU 较低,并不意味着计算资源的开销是浪费:内存、网络、EBS 带宽、故障余量和部署位置都可能需要这种实例规格。
修订后的复现示例
请使用全新的专用测试环境/namespace,并确保标准 EBS CSI 支持和对应实例类型/AZ 的容量充足。不要应用到现有 Kafka/PVC 数据之上。为新一轮测试替换示例集群 ID,使用新生成的 kafka-storage.sh random-uuid 值,并记录实际镜像 digest 和运行时版本。
以下清单是一个修订后的复现模板,并非原封不动的历史清单。它固定了指定 AZ,明确配置 gp3 IOPS/吞吐量/加密,在 readiness 之前发布无头 DNS,添加 TCP 启动/就绪检查,并将 broker 入站流量限定为基准测试 Pod。它还禁用了 API token 自动挂载。NetworkPolicy 需要 CNI 执行策略。此隔离测试保留 PLAINTEXT 和合并角色,但不将其作为生产设计提供。
apiVersion: v1
kind: Namespace
metadata:
  name: bench-kafka
---
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: bench-kafka-gp3
provisioner: ebs.csi.aws.com
volumeBindingMode: WaitForFirstConsumer
reclaimPolicy: Delete
parameters:
  type: gp3
  iops: '3000'
  throughput: '125'
  encrypted: 'true'
---
apiVersion: v1
kind: Service
metadata:
  name: kafka-hs
  namespace: bench-kafka
spec:
  clusterIP: None
  selector:
    app: kafka
  ports:
  - name: broker
    port: 9092
  - name: controller
    port: 9093
  publishNotReadyAddresses: true
---
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: kafka
  namespace: bench-kafka
spec:
  serviceName: kafka-hs
  replicas: 3
  podManagementPolicy: Parallel
  selector:
    matchLabels:
      app: kafka
  template:
    metadata:
      labels:
        app: kafka
      annotations:
        karpenter.sh/do-not-disrupt: 'true'
    spec:
      terminationGracePeriodSeconds: 60
      nodeSelector:
        node.kubernetes.io/instance-type: m5.xlarge
        karpenter.sh/capacity-type: on-demand
        topology.kubernetes.io/zone: ap-northeast-2b
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchLabels:
                app: kafka
            topologyKey: kubernetes.io/hostname
      securityContext:
        fsGroup: 1000
      containers:
      - name: kafka
        image: apache/kafka:4.3.1
        command:
        - /bin/bash
        - -c
        - |
          set -e
          ORD=${HOSTNAME##*-}
          export KAFKA_NODE_ID=$ORD
          export KAFKA_ADVERTISED_LISTENERS="PLAINTEXT://${HOSTNAME}.kafka-hs.bench-kafka.svc.cluster.local:9092"
          exec /etc/kafka/docker/run
        env:
        - name: CLUSTER_ID
          value: UdHYY7YQRrunSRromZFozw
        - name: KAFKA_PROCESS_ROLES
          value: broker,controller
        - name: KAFKA_CONTROLLER_QUORUM_VOTERS
          value: 0@kafka-0.kafka-hs.bench-kafka.svc.cluster.local:9093,1@kafka-1.kafka-hs.bench-kafka.svc.cluster.local:9093,2@kafka-2.kafka-hs.bench-kafka.svc.cluster.local:9093
        - name: KAFKA_LISTENERS
          value: PLAINTEXT://0.0.0.0:9092,CONTROLLER://0.0.0.0:9093
        - name: KAFKA_LISTENER_SECURITY_PROTOCOL_MAP
          value: PLAINTEXT:PLAINTEXT,CONTROLLER:PLAINTEXT
        - name: KAFKA_INTER_BROKER_LISTENER_NAME
          value: PLAINTEXT
        - name: KAFKA_CONTROLLER_LISTENER_NAMES
          value: CONTROLLER
        - name: KAFKA_LOG_DIRS
          value: /var/lib/kafka/data/kafka
        - name: KAFKA_NUM_PARTITIONS
          value: '6'
        - name: KAFKA_DEFAULT_REPLICATION_FACTOR
          value: '3'
        - name: KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR
          value: '3'
        - name: KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR
          value: '3'
        - name: KAFKA_TRANSACTION_STATE_LOG_MIN_ISR
          value: '2'
        - name: KAFKA_MIN_INSYNC_REPLICAS
          value: '2'
        - name: KAFKA_LOG_RETENTION_HOURS
          value: '2'
        - name: KAFKA_LOG_SEGMENT_BYTES
          value: '1073741824'
        - name: KAFKA_NUM_NETWORK_THREADS
          value: '4'
        - name: KAFKA_NUM_IO_THREADS
          value: '8'
        - name: KAFKA_NUM_REPLICA_FETCHERS
          value: '2'
        - name: KAFKA_HEAP_OPTS
          value: -Xms4G -Xmx4G
        ports:
        - containerPort: 9092
        - containerPort: 9093
        resources:
          requests:
            cpu: '3'
            memory: 10Gi
          limits:
            cpu: '4'
            memory: 12Gi
        volumeMounts:
        - name: data
          mountPath: /var/lib/kafka/data
        startupProbe:
          tcpSocket:
            port: 9092
          periodSeconds: 5
          failureThreshold: 60
        readinessProbe:
          tcpSocket:
            port: 9092
          periodSeconds: 5
      automountServiceAccountToken: false
  volumeClaimTemplates:
  - metadata:
      name: data
    spec:
      accessModes:
      - ReadWriteOnce
      storageClassName: bench-kafka-gp3
      resources:
        requests:
          storage: 100Gi
---
apiVersion: v1
kind: Pod
metadata:
  name: kafka-client
  namespace: bench-kafka
  labels:
    app: kafka-client
spec:
  restartPolicy: Never
  nodeSelector:
    node.kubernetes.io/instance-type: m5.large
    topology.kubernetes.io/zone: ap-northeast-2b
    karpenter.sh/capacity-type: on-demand
  containers:
  - name: client
    image: apache/kafka:4.3.1
    command:
    - sleep
    - infinity
    env:
    - name: KAFKA_HEAP_OPTS
      value: -Xms2G -Xmx2G
    resources:
      requests:
        cpu: 500m
        memory: 2500Mi
      limits:
        cpu: 1900m
        memory: 4Gi
  automountServiceAccountToken: false
---
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: benchmark-brokers
  namespace: bench-kafka
spec:
  podSelector:
    matchLabels:
      app: kafka
  policyTypes:
  - Ingress
  ingress:
  - from:
    - podSelector:
        matchExpressions:
        - key: app
          operator: In
          values:
          - kafka
          - kafka-client
    ports:
    - protocol: TCP
      port: 9092
    - protocol: TCP
      port: 9093
保存为 bench-kafka.yaml,检查资源和可用容量,然后运行:
kubectl apply -f bench-kafka.yaml
kubectl -n bench-kafka rollout status statefulset/kafka --timeout=600s
kubectl -n bench-kafka wait --for=condition=Ready pod/kafka-client --timeout=600s
kubectl -n bench-kafka get pods -o wide
kubectl -n bench-kafka get pods -o jsonpath='{range .items[*]}{.metadata.name}{"\t"}{.status.containerStatuses[*].imageID}{"\n"}{end}'
将已发布的生成器保存为 payload.awk,并在 client Pod 内部运行。 保留该生成器以便比较;其中可压缩的填充是有意设计的。
BEGIN{srand(42); split("payments orders inventory auth search checkout shipping catalog notify gateway",ns," ");
     split("INFO INFO INFO INFO WARN ERROR DEBUG",lv," ");
     for(i=0;i<20000;i++){
       n=ns[int(rand()*10)+1]; l=lv[int(rand()*7)+1]; d=int(rand()*900)+5; u=int(rand()*100000);
       msg=sprintf("{\"ts\":\"2026-09-02T02:%02d:%02d.%03dZ\",\"level\":\"%s\",\"namespace\":\"%s\",\"pod\":\"%s-7d9f8b6c4-%05x\",\"trace_id\":\"%08x%08x%08x%08x\",\"http\":{\"method\":\"POST\",\"path\":\"/api/v1/%s/%d\",\"status\":%d,\"duration_ms\":%d,\"bytes\":%d},\"user_id\":%d,\"region\":\"ap-northeast-2\",\"msg\":\"request completed upstream=%s-svc:8080 retries=%d cache=%s\"",
         int(rand()*60),int(rand()*60),int(rand()*1000),l,n,n,int(rand()*1048576),int(rand()*4294967296),int(rand()*4294967296),int(rand()*4294967296),int(rand()*4294967296),n,u,(l=="ERROR"?500:200),d,int(rand()*20000),u,n,int(rand()*3),(rand()<0.7?"hit":"miss"));
       pad=1000-length(msg)-2; if(pad<0)pad=0; p=""; for(k=0;k<pad;k++)p=p "x";
printf "%s,\"pad\":\"%s\"}\n", msg, p }}mkdir -p /tmp/results
LC_ALL=C awk -f payload.awk > /tmp/results/payload-1k.txt
sha256sum /tmp/results/payload-1k.txt
wc -l -c /tmp/results/payload-1k.txt以下 runs.sh 也在 client Pod 内运行。它会预先创建并填充 topics,将日志分别保存,检查 producer 最终成功计数,并使用 20 分钟的墙钟超时以及 30 秒的强制终止宽限期。Consumer 的 --timeout 是无活动超时限制,不是墙钟时间限制。
#!/bin/bash
set -euo pipefail
BIN=/opt/kafka/bin
BS="kafka-0.kafka-hs.bench-kafka.svc.cluster.local:9092,kafka-1.kafka-hs.bench-kafka.svc.cluster.local:9092,kafka-2.kafka-hs.bench-kafka.svc.cluster.local:9092"
BENCH_RESULTS=/tmp/results
mkdir -p "$BENCH_RESULTS"
RUN_ID="$(date -u +%Y%m%dT%H%M%SZ)-$$"

new_topic() {
  "$BIN/kafka-topics.sh" --bootstrap-server "$BS" --create --topic "$1" \
    --partitions 6 --replication-factor "$2" \
    --config "min.insync.replicas=$3" --config retention.bytes=-1
}
produce() {
  local topic="$1" count="$2" mode="$3" value="$4" rate="$5" acks="$6" codec="$7"
  shift 7
  local result="$BENCH_RESULTS/$topic-$BASHPID.log"
  date -u +%Y-%m-%dT%H:%M:%SZ > "$result.start"
  timeout -k 30 1200 "$BIN/kafka-producer-perf-test.sh" \
    --bootstrap-server "$BS" --topic "$topic" --num-records "$count" \
    --throughput "$rate" "$mode" "$value" --print-metrics \
    --command-property "acks=$acks" "compression.type=$codec" \
      linger.ms=5 batch.size=65536 buffer.memory=67108864 "$@" 2>&1 | tee "$result"
  date -u +%Y-%m-%dT%H:%M:%SZ > "$result.end"
  # The tool can print callback errors without making every failure a nonzero exit.
  # This check is for warmup-records=0 and the final, non-window summary.
  awk -v expected="$count" '/ms 99[.]9th[.]/ {seen=1; actual=$1}
    END {if (!seen || actual != expected) exit 1}' "$result"
}

# Historical F1-shaped workload: a new topic and the published padded payload.
F_TOPIC="bench-f1-$RUN_ID"
new_topic "$F_TOPIC" 3 2
produce "$F_TOPIC" 10000000 --payload-file "$BENCH_RESULTS/payload-1k.txt" -1 all none

# Historical B1-shaped workload: pre-create the latency topic.
B_TOPIC="bench-b1-$RUN_ID"
new_topic "$B_TOPIC" 3 2
produce "$B_TOPIC" 1200000 --record-size 1024 20000 all none

# E2/E3-shaped replay: populate before consuming; 30M*1024 B = 28.61 GiB.
E_TOPIC="bench-e2-$RUN_ID"
new_topic "$E_TOPIC" 3 2
produce "$E_TOPIC" 30000000 --record-size 1024 -1 all none
timeout -k 30 1200 "$BIN/kafka-consumer-perf-test.sh" --bootstrap-server "$BS" \
  --topic "$E_TOPIC" --num-records 30000000 --group "bench-e3-$RUN_ID" \
  --timeout 600000 --show-detailed-stats --reporting-interval 5000 --print-metrics \
  2>&1 | tee "$BENCH_RESULTS/$E_TOPIC-consumer.log"

printf '%s\n' "$F_TOPIC" "$B_TOPIC" "$E_TOPIC" > "$BENCH_RESULTS/topics-$RUN_ID.txt"
# Preserve logs and validate success/readback before deleting this run's topics.
该模板演示了 F1、B1 和 E2/E3 类型的工作负载。对于其他行,请使用新 topics,并采用表格中的 RF/minISR、记录数、acks、codec 及 batch/linger 设置;produce helper 在七个必需参数之后接受额外的 Kafka 属性。对于 F6,这些属性为 batch.size=262144 linger.ms=10。对于 F5,运行两个各有五百万条记录的 producers,分别保存日志并记录共同的时间间隔。对于 E4,请同时记录共用客户端的复现结果,以及使用独立负载生成器容量的受控变体。各次运行之间留出回写/排空时间,并验证 topic 内容/错误,尤其是 acks=0 的情况。不要仅仅因为达到请求记录数,就将有限时长的已完成运行重新标记为稳态。
采样正确的块设备和实际时间间隔
将每个基准测试 PVC 映射到其 PV/EBS 卷,并在写入 devices.txt 之前确认对应的块设备。nvme1n1 并非通用的 EBS 数据设备名称。脚本假设使用文档所述的 cgroup-v2 CPU 计数器、sysfs 可见性和 eth0;只有在确认实际环境后才进行调整。
在运行 kubectl 的机器上保存为 sample-broker.sh:
#!/bin/sh
set -eu
device="${1:?Pass the verified data-volume block-device name}"
interface="${2:-eth0}"
case "$device" in *[!a-zA-Z0-9_-]*|'') echo "Invalid block-device name" >&2; exit 2;; esac
case "$interface" in *[!a-zA-Z0-9_.-]*|'') echo "Invalid network interface" >&2; exit 2;; esac
read -r start_uptime ignored < /proc/uptime
read -r read_ios read_merges read_sectors read_ms write_ios write_merges write_sectors write_ms rest \
  < "/sys/class/block/$device/stat"
cpu_usage="$(awk '$1=="usage_usec" {print $2}' /sys/fs/cgroup/cpu.stat)"
cpu_throttled="$(awk '$1=="throttled_usec" {print $2}' /sys/fs/cgroup/cpu.stat)"
: "${cpu_usage:?Missing cgroup v2 CPU usage counter}"
: "${cpu_throttled:?Missing cgroup v2 CPU throttling counter}"
net_tx="$(cat "/sys/class/net/$interface/statistics/tx_bytes")"
net_rx="$(cat "/sys/class/net/$interface/statistics/rx_bytes")"
read -r end_uptime ignored < /proc/uptime
printf '{"device":"%s","interface":"%s","start_uptime_s":%s,"end_uptime_s":%s,"read_ios":%s,"read_sectors":%s,"write_ios":%s,"write_sectors":%s,"cpu_usage_usec":%s,"cpu_throttled_usec":%s,"net_tx_bytes":%s,"net_rx_bytes":%s}\n' \
  "$device" "$interface" "$start_uptime" "$end_uptime" "$read_ios" "$read_sectors" "$write_ios" "$write_sectors" \
  "$cpu_usage" "$cpu_throttled" "$net_tx" "$net_rx"
将包装脚本保存为 sampler.sh;devices.txt 每行包含一个经过验证的 kafka-N device-name [interface] 条目;interface 默认为 eth0:
#!/bin/bash
set -euo pipefail
# devices.txt: "pod block-device [interface]" per line; interface defaults to eth0.
# Example only: kafka-0 nvme1n1. Verify PVC -> PV -> EBS volume -> device first.
while true; do
  while read -r pod device interface; do
    [[ "$pod" =~ ^kafka-[0-2]$ ]] || { echo "Invalid benchmark pod" >&2; exit 2; }
    utc="$(date -u +%Y-%m-%dT%H:%M:%SZ)"
    sample="$(kubectl -n bench-kafka exec -i "$pod" -- sh -s -- "$device" "${interface:-eth0}" < sample-broker.sh)"
    printf '%s\t%s\t%s\n' "$utc" "$pod" "$sample" >> broker-samples.tsv
  done < devices.txt
  sleep 10
done
使用每个 Pod 的实际单调时钟采样间隔,并将起止跨度作为计时不确定性。扇区增量 × 512 / 经过秒数可得字节/秒;I/O 增量可得 IOPS;usage_usec 增量 / 1,000,000 / 经过秒数可得 CPU 核数。丢弃重置/负增量以及缺失的采样数据。在相同阶段捕获客户端 CPU/NIC 和 producer 缓冲区/请求指标。根据已验证的卷 ID 对齐 CloudWatch VolumeReadBytes/VolumeWriteBytes/VolumeWriteOps 窗口。
请在清理之前导出结果。删除 namespace 会造成破坏,但不会自动删除节点或集群范围的 StorageClasses。模板使用 Delete 回收策略;请验证 PVC/PV/EBS 是否已删除,并检查是否还存在节点费用:
kubectl delete namespace bench-kafka
# After confirming this run's PVs/volumes are gone and no claims use the class:
kubectl delete storageclass bench-kafka-gp3
审查依据与延伸阅读
本次审查检查了算术、已发布的负载生成器、Kafka 原生性能工具的选项解析和 callback 行为、资源 schema、shell 语法及图表渲染。本次审查没有进行新的 AWS 吞吐量基准测试。