Pod 网络基准测试 — 同节点、同一 AZ、跨 AZ 与 DNS ndots
支持版本: Kubernetes 1.36 (Amazon EKS), Amazon VPC CNI v1.21.1, kube-proxy iptables mode 最后更新: September 2, 2026
当 EKS 上的两个 Pod 位于同一节点、同一 AZ 的不同节点,或不同 AZ 时,实际会发生什么变化?这个问题常伴随着两个误解。第一个是,跨越 AZ “会让速度变慢并降低带宽”——在本次运行中,AZ 边界改变了延迟和账单,但完全没有改变带宽。第二个与 DNS 有关:每个 EKS Pod 获得的 ndots:5 和四项搜索列表,会悄然将一次外部查找——对于任何点数少于五个的名称——从 2 次 DNS 查询变为 10 次。本页汇集了在 September 2, 2026、使用“如何复现”中所述装置,对 fsi-demo-cluster(首尔)测得的 RTT、HTTP/gRPC 延迟、iperf3 吞吐量、区域内数据传输成本和 DNS 查询次数。每个数字均为 Pod IP 到 Pod IP(不经 ClusterIP);原因见“注意事项”。
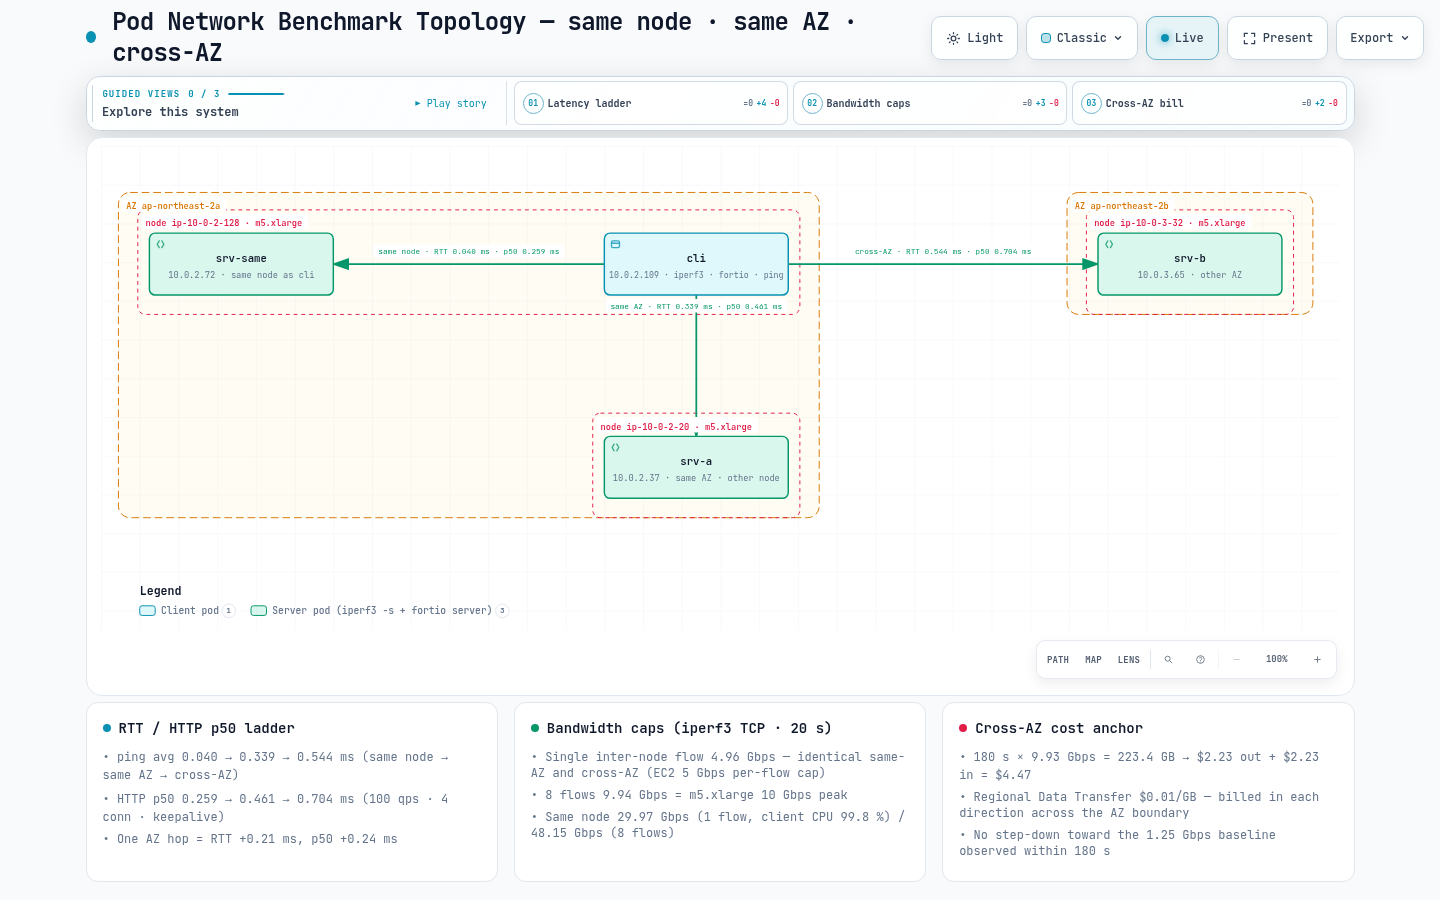
TL;DR — 我们测得了什么
- RTT 阶梯:同节点 0.040 ms → 同一 AZ 0.339 ms → 跨 AZ 0.544 ms(ping,200 个探测的平均值)。一次 AZ 跳转增加 +0.21 ms,相比同一节点则增加 +0.50 ms。
- HTTP p50 / p99(fortio,100 qps,4 个连接,keepalive,60 s):0.259 / 0.350 ms → 0.461 / 0.667 ms → 0.704 / 0.812 ms —— 从应用层看到相同的阶梯。
- 带宽:无论流量留在 AZ 内还是跨越 AZ,单个 TCP 流最高均为 4.96 Gbps(EC2 5 Gbps 单流限制)。八个流达到 9.94 Gbps = m5.xlarge 10 Gbps 峰值。跨越 AZ 不会降低吞吐量。
- 同节点 Pod 到 Pod:单个流为 29.97 Gbps(受 CPU 限制——客户端使用了一个核心的 99.8 %),8 个流为 48.15 Gbps。流量经过一对 veth,完全不会接触 NIC。
- 账单:以线速跨 AZ 运行 3 分钟 = 223.4 GB = 约 $4.47 的区域数据传输费用(每个方向 $0.01/GB)。在 180 s 内未观察到向 1.25 Gbps 基线的突发积分降速。
- DNS:使用默认的
ndots:5时,glibc Pod 一次解析sts.ap-northeast-2.amazonaws.com会发送 10 次查询(其中 8 次回答 NXDOMAIN),预热中位数为 3.78 ms。末尾点将其降至 2 次查询(A+AAAA)/ 0.80 ms;ndots:1为 2 次查询 / 0.54 ms。 - 每个请求的新连接多花一个 RTT:关闭 keepalive 时,p50 从 0.259 → 0.664、0.461 → 1.079 和 0.704 → 1.517 ms。跨 AZ 时,每请求延迟增加超过一倍。
测试环境
| 项目 | 值 |
|---|---|
| 集群 | Amazon EKS fsi-demo-cluster、ap-northeast-2(首尔)、控制平面 v1.36.2-eks-bca9cf6、使用两个 AZ(2a、2b) |
| 节点 | 3 × m5.xlarge,由 Karpenter system NodePool 为本测试新启动——2a 中的一个客户端节点、一个服务器节点,以及 2b 中的一个服务器节点。4 vCPU,Intel Xeon Platinum 8175M @ 2.50GHz |
| 节点 OS | Amazon Linux 2023.12.20260817、内核 6.18.41-94.142.amzn2023.x86_64、containerd 2.2.5、kubelet v1.36.3-eks-cb19647 |
| CNI | Amazon VPC CNI v1.21.1-eksbuild.8(+ network-policy-agent v1.3.4);ENABLE_PREFIX_DELEGATION=false、ENABLE_POD_ENI=false、AWS_VPC_K8S_CNI_EXTERNALSNAT=false、NETWORK_POLICY_ENFORCING_MODE=standard、WARM_ENI_TARGET=1、WARM_IP_TARGET=3 |
| kube-proxy | v1.35.3-eksbuild.5、mode: "iptables" |
| CoreDNS | v1.14.2-eksbuild.4、2 个副本——每个 AZ 一个(10.0.2.106 / 2a、10.0.3.14 / 2b);Service kube-dns ClusterIP 172.20.0.10;Corefile kubernetes cluster.local … { pods insecure }、forward . /etc/resolv.conf、cache 30、loadbalance;没有 NodeLocal DNSCache,没有 autopath 插件 |
| Pod resolv.conf(默认) | search bench-net.svc.cluster.local svc.cluster.local cluster.local ap-northeast-2.compute.internal / nameserver 172.20.0.10 / options ndots:5 |
| Pod NIC | eth0 MTU 9001(巨型帧)、TCP 拥塞控制 cubic、iperf3 tcp_mss_default: 8949 |
| EC2 网络规格 | m5.xlarge “Up to 10 Gigabit”——基线 1.25 Gbps、峰值 10 Gbps、4 vCPU(对比:m5.large 基线 0.75 Gbps、峰值 10 Gbps、2 vCPU)。使用 aws ec2 describe-instance-types 验证;需要 ENA |
| 定价 | usagetype APN2-DataTransfer-Regional-Bytes、“Regional Data Transfer - in/out/between AZs or when using public IP or Elastic IP addresses”、$0.01/GB(aws pricing get-products --region us-east-1,查询于 2026-09) |
| 工具 | nicolaka/netshoot:v0.14 —— iperf 3.19、fortio 1.69.5、iputils ping 20250605、tcpdump 4.99.5;DNS 客户端 python:3.12-slim(Debian 13、glibc 2.41、Python 3.12.14) |
| 测试时段 | 2026-09-02 07:58–08:40 UTC(首个 Pod 于 07:58:22Z,DNS Pod 于 08:16:24Z) |
“Up to”表示可突发网络:实例拥有网络 I/O 积分时可以使用峰值带宽,积分耗尽后会向基线限速(AWS EC2 User Guide,“Amazon EC2 instance network bandwidth”)。测量 2 中的持续运行仅表明该限制未在 180 s 内触发(未观察到向基线降速,且没有测试更长时间)。
本次运行期间的装置放置:
| Pod | IP | 节点 | 区域 | 角色 / requests |
|---|---|---|---|---|
cli | 10.0.2.109 | ip-10-0-2-128(nodeclaim system-76r87) | ap-northeast-2a | 客户端;2500m / 1Gi |
srv-same | 10.0.2.72 | ip-10-0-2-128 — 与 cli 同一节点(required podAffinity) | ap-northeast-2a | 服务器;200m / 256Mi |
srv-a | 10.0.2.37 | ip-10-0-2-20(nodeclaim system-ksrbg,与 cli podAntiAffinity) | ap-northeast-2a | 服务器;2800m / 1Gi |
srv-b | 10.0.3.65 | ip-10-0-3-32(nodeclaim system-svdvk) | ap-northeast-2b | 服务器;2500m / 1Gi |
dns-default | 10.0.2.5 | ip-10-0-2-20(与 srv-a podAffinity) | ap-northeast-2a | glibc 解析器,默认 ndots:5 |
dns-ndots1 | 10.0.2.143 | ip-10-0-2-20 | ap-northeast-2a | glibc 解析器,dnsConfig.options ndots=1 |
服务器 Pod 运行 sh -c "iperf3 -s -p 5201 & exec fortio server -http-port 8080 -grpc-port 8079 -tcp-port 8078",每个基准 Pod 均带有 karpenter.sh/do-not-disrupt: "true"。srv-a 最初请求 m5.large / 1500m,但 Karpenter 报告 no instance type has enough resources——DaemonSet 开销占用了 m5.large 的 1930m 可分配资源中的 821m——因此改为 m5.xlarge / 2800m。
装置 manifest
仅移除了较长的英文注释头;nodeSelector、affinity、requests、command 和 annotations 与实际运行的内容完全一致。由于该装置只使用 Pod IP,因此没有 Service 对象(原因见“注意事项”)。
apiVersion: v1
kind: Namespace
metadata:
  name: bench-net
  labels:
    bench: net
---
# client — fresh m5.xlarge in ap-northeast-2a
apiVersion: v1
kind: Pod
metadata:
  name: cli
  namespace: bench-net
  labels: { app: cli, role: client }
  annotations: { karpenter.sh/do-not-disrupt: "true" }
spec:
  nodeSelector:
    topology.kubernetes.io/zone: ap-northeast-2a
    node.kubernetes.io/instance-type: m5.xlarge
    karpenter.sh/nodepool: system
  terminationGracePeriodSeconds: 5
  containers:
    - name: netshoot
      image: nicolaka/netshoot:v0.14
      command: ["sleep", "infinity"]
      resources:
        requests: { cpu: "2500m", memory: "1Gi" }
---
# same-node — co-located with cli through required podAffinity
apiVersion: v1
kind: Pod
metadata:
  name: srv-same
  namespace: bench-net
  labels: { app: srv-same, role: server, zone: a }
  annotations: { karpenter.sh/do-not-disrupt: "true" }
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector: { matchLabels: { app: cli } }
          topologyKey: kubernetes.io/hostname
  terminationGracePeriodSeconds: 5
  containers:
    - name: netshoot
      image: nicolaka/netshoot:v0.14
      command: ["sh", "-c", "iperf3 -s -p 5201 & exec fortio server -http-port 8080 -grpc-port 8079 -tcp-port 8078"]
      ports: [{ containerPort: 8080 }, { containerPort: 5201 }]
      resources:
        requests: { cpu: "200m", memory: "256Mi" }
---
# same-AZ — same AZ as cli, different node (podAntiAffinity). m5.large did not fit because of DaemonSet overhead, hence m5.xlarge
apiVersion: v1
kind: Pod
metadata:
  name: srv-a
  namespace: bench-net
  labels: { app: srv-a, role: server, zone: a }
  annotations: { karpenter.sh/do-not-disrupt: "true" }
spec:
  nodeSelector:
    topology.kubernetes.io/zone: ap-northeast-2a
    node.kubernetes.io/instance-type: m5.xlarge
    karpenter.sh/nodepool: system
  affinity:
    podAntiAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector: { matchLabels: { app: cli } }
          topologyKey: kubernetes.io/hostname
  terminationGracePeriodSeconds: 5
  containers:
    - name: netshoot
      image: nicolaka/netshoot:v0.14
      command: ["sh", "-c", "iperf3 -s -p 5201 & exec fortio server -http-port 8080 -grpc-port 8079 -tcp-port 8078"]
      ports: [{ containerPort: 8080 }, { containerPort: 5201 }]
      resources:
        requests: { cpu: "2800m", memory: "1Gi" }
---
# cross-AZ — fresh m5.xlarge in ap-northeast-2b
apiVersion: v1
kind: Pod
metadata:
  name: srv-b
  namespace: bench-net
  labels: { app: srv-b, role: server, zone: b }
  annotations: { karpenter.sh/do-not-disrupt: "true" }
spec:
  nodeSelector:
    topology.kubernetes.io/zone: ap-northeast-2b
    node.kubernetes.io/instance-type: m5.xlarge
    karpenter.sh/nodepool: system
  terminationGracePeriodSeconds: 5
  containers:
    - name: netshoot
      image: nicolaka/netshoot:v0.14
      command: ["sh", "-c", "iperf3 -s -p 5201 & exec fortio server -http-port 8080 -grpc-port 8079 -tcp-port 8078"]
      ports: [{ containerPort: 8080 }, { containerPort: 5201 }]
      resources:
        requests: { cpu: "2500m", memory: "1Gi" }
两个 DNS Pod 被放置在与 srv-a 相同的节点上。app 容器使用 glibc(python:3.12-slim、Debian 13、glibc 2.41):本页测量 glibc 解析器,未测量其他解析器(musl/alpine)的结果;sniffer(netshoot)共享 Pod 的网络命名空间,因此其 tcpdump 能看到 app 发送的每一项查询。这两个 Pod 唯一的差异是 dnsConfig。
apiVersion: v1
kind: Pod
metadata:
  name: dns-default          # the second Pod is name: dns-ndots1 plus the dnsConfig block below
  namespace: bench-net
  labels: { app: dns-default, role: dns }
  annotations: { karpenter.sh/do-not-disrupt: "true" }
spec:
  affinity:
    podAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        - labelSelector: { matchLabels: { app: srv-a } }
          topologyKey: kubernetes.io/hostname
  # present only in dns-ndots1:
  # dnsConfig:
  #   options:
  #     - name: ndots
  #       value: "1"
  terminationGracePeriodSeconds: 5
  containers:
    - name: app
      image: python:3.12-slim
      command: ["sleep", "infinity"]
      resources: { requests: { cpu: "50m", memory: "64Mi" } }
    - name: sniffer
      image: nicolaka/netshoot:v0.14
      command: ["sleep", "infinity"]
      resources: { requests: { cpu: "50m", memory: "64Mi" } }
测量 1 — RTT 和 HTTP 延迟:同节点 → 同一 AZ → 跨 AZ
先使用 ICMP 测量纯网络路径(ping -c 200 -i 0.05 -q),然后使用 fortio 将相同的三条路径作为 HTTP/1.1 和 gRPC 请求进行测试。列出单个冷 curl 请求的连接 / 总时间供参考。
| 路径 | RTT 最小 / 平均 / 最大 / mdev (ms) | 丢失 | curl,1 个冷请求:连接 / 总计 |
|---|---|---|---|
| 同节点 → 10.0.2.72 | 0.021 / 0.040 / 0.089 / 0.007 | 0/200 | 0.194 ms / 0.497 ms |
| 同一 AZ → 10.0.2.37 | 0.300 / 0.339 / 0.450 / 0.017 | 0/200 | 0.497 ms / 2.333 ms |
| 跨 AZ → 10.0.3.65 | 0.504 / 0.544 / 0.625 / 0.015 | 0/200 | 0.694 ms / 4.038 ms |
差值:同一 AZ − 同节点 = +0.30 ms,跨 AZ − 同一 AZ = +0.21 ms,跨 AZ − 同节点 = +0.50 ms。三条路径都非常稳定——mdev 均为 0.017 ms 或更低。curl 的“总计”是包含进程启动的一次冷运行,因此仅作指示用途;请从下面的 fortio 表中读取延迟。
HTTP/1.1 — 100 qps、4 个连接、keepalive、60 s(6,000 个请求)、ms
| 路径 | 平均 | p50 | p90 | p99 | p99.9 | 最大 | 最小 |
|---|---|---|---|---|---|---|---|
| 同节点 | 0.260 | 0.259 | 0.299 | 0.350 | 1.267 | 2.080 | 0.111 |
| 同一 AZ | 0.468 | 0.461 | 0.560 | 0.667 | 0.783 | 2.823 | 0.336 |
| 跨 AZ | 0.706 | 0.704 | 0.782 | 0.812 | 1.150 | 4.581 | 0.551 |
gRPC ping — 100 qps、4 个连接、30 s(3,000 个请求)、ms
| 路径 | 平均 | p50 | p90 | p99 | p99.9 | 最大 | 最小 |
|---|---|---|---|---|---|---|---|
| 同节点 | 0.410 | 0.397 | 0.449 | 0.869 | 1.187 | 1.314 | 0.241 |
| 同一 AZ | 0.601 | 0.592 | 0.687 | 0.889 | 1.052 | 1.105 | 0.448 |
| 跨 AZ | 0.878 | 0.865 | 0.967 | 1.209 | 2.582 | 2.826 | 0.692 |
响应体约为 75 字节(fortio echo,空 payload),且每次运行均以 0 错误(200 / SERVING)完成。
**如何解读。**HTTP p50 是 ping 平均值加上 0.12–0.22 ms(0.259 − 0.040 ≈ 0.22、0.461 − 0.339 ≈ 0.12、0.704 − 0.544 ≈ 0.16)——该余量来自客户端和服务器用户空间栈。AZ 跳转在 p50 上增加 +0.24 ms(0.461 → 0.704),与 ping 的 +0.21 ms 大小相同,也接近节点跳转(+0.20 ms,0.259 → 0.461)。换言之,“同节点 → 不同节点”和“同一 AZ → 不同 AZ”各自都是约 0.2 ms 的恒定阶跃。每条路径上 gRPC ping p50 均比 HTTP/1.1 高约 0.13–0.16 ms(0.397 / 0.592 / 0.865 对比 0.259 / 0.461 / 0.704)——这是 fortio ping 中 HTTP/2 framing 加 protobuf 所致。路径差异最大的地方在尾部:HTTP p99 为 0.350 → 0.667 → 0.812 ms,而 gRPC p99.9 为 1.187 → 1.052 → 2.582 ms,只有跨 AZ 路径超过 2 ms。
**一个对比点。**在本仓库的 Istio sidecar 与 ambient 测量中,单个 sidecar 在 p50 上增加 +1.29 ms。此处一次 AZ 跳转的成本为 +0.21–0.24 ms——**一次 mesh 跳转的成本高于一次 AZ 跳转。**在将慢请求归咎于“另一个 AZ”之前,先数一数其路径中的代理。
新连接的成本 — keepalive=false、100 qps、4 个连接、30 s(3,000 个请求)、ms
当每个请求都建立新的 TCP 连接(fortio -keepalive=false)时,延迟会怎样?
| 路径 | 平均 | p50 | p90 | p99 | p99.9 | 最大 | 最小 | 相比 keepalive p50 |
|---|---|---|---|---|---|---|---|---|
| 同节点 | 0.672 | 0.664 | 0.782 | 0.957 | 1.253 | 1.306 | 0.364 | +0.405 ms |
| 同一 AZ | 1.066 | 1.079 | 1.185 | 1.369 | 1.582 | 1.795 | 0.769 | +0.618 ms |
| 跨 AZ | 1.530 | 1.517 | 1.678 | 1.796 | 1.981 | 2.009 | 1.300 | +0.813 ms |
一个新连接大约需要一个 RTT(TCP 握手)加上约 0.3 ms 的 socket 建立和拆除时间。路径的 RTT 越大,附加成本越高:跨 AZ 时,单个请求的 p50 从 0.704 变为 1.517 ms——超过两倍。连接池(HTTP keepalive、gRPC channel 重用、数据库连接池)不是性能优化;它是所有跨 AZ 调用的前提条件(并且和任何每请求一个连接的客户端一样,每个新连接还会留下一个 TIME_WAIT socket——此处未测量)。
固定连接池的最大 qps — 延迟就是吞吐量(闭环、16 个连接、20 s)
使用 -qps 0(无限制、闭环)时,16 个连接可持续的最大请求速率会将延迟差异转变为吞吐量差异。
| 路径 | 请求数 | 达到的 qps | 平均 ms | p50 | p90 | p99 | p99.9 | 最大 |
|---|---|---|---|---|---|---|---|---|
| 同节点 | 899,827 | 44,991 | 0.355 | 0.249 | 0.733 | 1.695 | 3.389 | 13.593 |
| 同一 AZ | 770,156 | 38,507 | 0.415 | 0.396 | 0.537 | 0.728 | 1.147 | 4.502 |
| 跨 AZ | 512,060 | 25,602 | 0.624 | 0.597 | 0.770 | 0.949 | 1.293 | 4.725 |
Little 定律(推导:吞吐量 = 并发数 ÷ 延迟)几乎完全成立——16 ÷ 0.000355 s = 45,070(实测 44,991)、16 ÷ 0.000415 = 38,554(38,507)、16 ÷ 0.000624 = 25,641(25,602)。对于固定大小的池,AZ 跳转的 +0.2 ms 将可达到的吞吐量降低 34 %(38.5k → 25.6k qps)。对于请求/响应服务,另一个 AZ 昂贵的原因是此延迟而非带宽。同节点的 p99/最大值比同一 AZ 更差也并非网络问题:在 45k qps 下,客户端和服务器共享一个节点的 4 vCPU 并争用 CPU。
测量 2 — 吞吐量:5 Gbps 单流上限和 10 Gbps 实例上限
iperf3 3.19、TCP、每次运行 20 s、-J、客户端 cli。CPU 列为 iperf3 自身的每进程数值,其中 100 % = 一个 vCPU。
| 路径 | 流数 (-P) | 发送 Gbps | 接收 Gbps | 重传 | 已发送字节 | 客户端 CPU | 服务器 CPU | 发送方 TCP 平均 RTT(流 1) | 最大 snd_cwnd |
|---|---|---|---|---|---|---|---|---|---|
| 同节点 (cli→srv-same) | 1 | 29.97 | 29.97 | 13 | 74,921,541,632 | 99.8 % | 80.9 % | 34 µs | 1,861,392 B |
| 同节点 | 8 | 48.15 | 48.08 | 14,567 | 120,375,083,008 | 179.0 % | 186.9 % | 201 µs / 767 µs(流 1、2) | 5,888,442 B |
| 同一 AZ (cli→srv-a, 2a→2a) | 1 | 4.96 | 4.96 | 4 | 12,411,731,968 | 19.5 % | 15.4 % | 5,641 µs | 4,349,214 B |
| 同一 AZ | 8 | 9.94 | 9.93 | 5,874 | 24,846,139,392 | 36.3 % | 159.3 % | 2,720 µs / 1,626 µs | 1,163,370 B |
| 跨 AZ (cli→srv-b, 2a→2b) | 1 | 4.96 | 4.96 | 2 | 12,411,994,112 | 20.0 % | 22.5 % | 5,420 µs | 4,304,469 B |
| 跨 AZ | 8 | 9.94 | 9.93 | 5,979 | 24,845,090,816 | 36.7 % | 138.2 % | 3,671 µs / 3,237 µs | 1,226,013 B |
这里有四点需要解读。
- **同节点是内存复制速度。**单个流达到 29.97 Gbps 时,客户端 iperf3 使用了一个核心的 99.8 %;8 个流将其推至 48.15 Gbps。通过一对 veth 的数据包不会经过 NIC 或 ENA shaper,因此这些是此实例的 CPU 数据,在其他实例系列上会不同。
- **节点之间的单个 TCP 流在 4.96 Gbps 停止——同一 AZ 与跨 AZ 精确到小数点后两位都相同。**AWS 文档说明,在 cluster placement group 外部,单个流被限制为 5 Gbps(“Amazon EC2 instance network bandwidth”),测得的正是此限制。该流仅使用约一个核心的 20 %,因此 CPU 不是瓶颈。
- 八个流达到 9.94 Gbps = m5.xlarge 10 Gbps 峰值,同样在两条路径上完全一致。跨越 AZ 边界不会降低带宽。仅当达到实例上限时才出现重传(8 个流为 5,874 / 5,979,而 1 个流为 2–13)——这是符合 ENA allowance shaping 在上限处丢包的间接信号;本次运行没有收集 ENA
*_allowance_exceeded计数器(注意事项)。 - **流饱和时,搭乘它的每个请求都会等待。**单个流固定在上限时,发送方 TCP RTT 从空闲 ping RTT 的 0.34 ms(同一 AZ)/ 0.54 ms(跨 AZ),增长为拥塞窗口约 4.3 MB 下的 5.6 ms / 5.4 ms。该延迟是 shaper 中的排队,因此与批量传输复用在同一 TCP 连接上的请求/响应交换会损失约 5 ms。
MSS 8949 源自 9001 字节 MTU(巨型帧),已发送字节列是下一节成本计算的基础。
**所以呢:**一个 gRPC stream、一个 Kafka replica fetcher、一次 volume copy——位于不同节点的两个 Pod 之间的“一条连接”无论承载什么,均不会超过约 5 Gbps。要使用实例的 10 Gbps,必须将工作拆分到并行连接(
num.replica.fetchers、multipart uploads、并行 rsync 等);反之,“保留在一个 AZ 内会使带宽翻倍”的预期也不受这些测量支持。
3 分钟持续运行与突发积分
“Up to 10 Gigabit”的基线是 1.25 Gbps。积分耗尽后,实例应从峰值降向基线,因此以 10 s 间隔监控了一个 4 流跨 AZ 运行 180 s(iperf3 -c 10.0.3.65 -p 5201 -t 180 -P 4 -i 10 -J)。
| 项目 | 值 |
|---|---|
| 每个 10 s 间隔的 Gbps(18 个间隔) | 9.94、9.93 ×12、9.92、9.93 ×4 —— 最小 9.92、最大 9.94 |
| 总发送量 | 223,376,179,200 B = 180.0 s 内 223.4 GB(9.93 Gbps) |
| 重传 | 44,842(≈ 249/s;每个 10 s 间隔 2,273–2,669) |
| CPU | 客户端 30.7 %(系统 30.1 %),服务器 54.2 %(系统 52.2 %) |
**在 180 s 内没有观察到向 1.25 Gbps 基线的下降。**这并不表示突发积分不存在。AWS 记录,在“Up to”实例上,较长时间的持续传输可能被限速至基线;此处没有测试超过 180 s 的情况,因此本次运行无法说明何时——或者对于新节点是否——达到该点。如果正在为 m5.xlarge 上持续数小时的备份、重新平衡或重放做计划,请按 1.25 Gbps 基线预算(其他规格有各自的基线),并将 10 Gbps 视为额外收益。
测量 3 — 真正的跨 AZ 成本是账单
测量 1 和 2 显示,AZ 跳转增加 +0.2 ms 延迟,但带宽不受影响。那么不同 AZ 之间真正的差异在哪里?在账单上。
在一个区域内,AWS 对 AZ 跨越两侧均收取 $0.01/GB——发送 AZ 的“out”和接收 AZ 的“in”(EC2 On-Demand pricing page,“Data Transfer within the same AWS Region”)。此账户的 Pricing API 条目为 APN2-DataTransfer-Regional-Bytes,“Regional Data Transfer - in/out/between AZs or when using public IP or Elastic IP addresses”,$0.0100000000 USD/GB。对于单向批量传输,发送 AZ 的“out”按 $0.01/GB 计费,接收 AZ 的“in”也按 $0.01/GB 计费,因此在一个账户内,实际为每 GB 跨越 AZ 边界 $0.02(推导:$0.01 × 2)。
| 场景 | 跨越 AZ 边界的字节数 | 成本(推导:GB × $0.01 × 2) |
|---|---|---|
| 本页的 180 s 持续运行(实测) | 223.4 GB | 223.4 × $0.01 = 每个方向 $2.23,合计 $4.47 |
| 测量 2 中所有跨 AZ 传输(实测:12.41 + 24.85 + 223.38 GB) | 260.6 GB | ≈ 每个方向 $2.61,合计 ≈ $5.21(fortio 和 ping 流量低于 0.2 GB,忽略) |
| 跨 AZ 平均 1 Gbps 持续 30 天(假设) | 0.125 GB/s × 86,400 s × 30 天 = 324,000 GB ≈ 324 TB | 324,000 × $0.02 ≈ $6,480 / 月 |
| 分布在 3 个 AZ 的 RF3 StatefulSet,leader ingest 为 100 MiB/s(假设,仅复制流量) | 两个 follower 各位于另一个 AZ → 2 × 100 MiB/s = 209,715,200 B/s × 2,592,000 s ≈ 543,600 GB ≈ 544 TB / 月 | 543,600 × $0.02 ≈ $10,870 / 月 |
最下面两行不是测量值,而是按该单价得出的估算,且忽略了生产者/消费者流量和 AZ 放置。关键在于量级:三节点基准测试在三分钟内花费了 $4.47,全天持续运行则会变成每月数千美元。带宽不受损地跨越边界,但每个字节都带有价格标签。
运维人员应该做什么。
- 将流量保留在 AZ 内。
Service.spec.trafficDistribution: PreferClose——Kubernetes 1.31 中为 beta、1.33 中为 GA(Kubernetes 文档,“Traffic Distribution”)——使 kube-proxy 优先选择同一区域的 endpoint。本次运行未测量它——无法创建 Service(注意事项)——因此本页没有其效果的数值。 - **按区域对齐有状态工作负载。**具有大量复制 fan-out 的 StatefulSet(Kafka RF3、分布式数据库)会将大部分复制字节跨 AZ 发送,如上表第四行所示。区域级放置和 AZ failover 设计见 Zonal Cluster Operations guide。
- **了解批量传输的方向和体量。**记录 AZ 备份、重新平衡和重放的流向及流量,并记住在同一账户中,“in”和“out”作为两个独立的账单项计费。
测量 4 — DNS:ndots:5 的查询放大
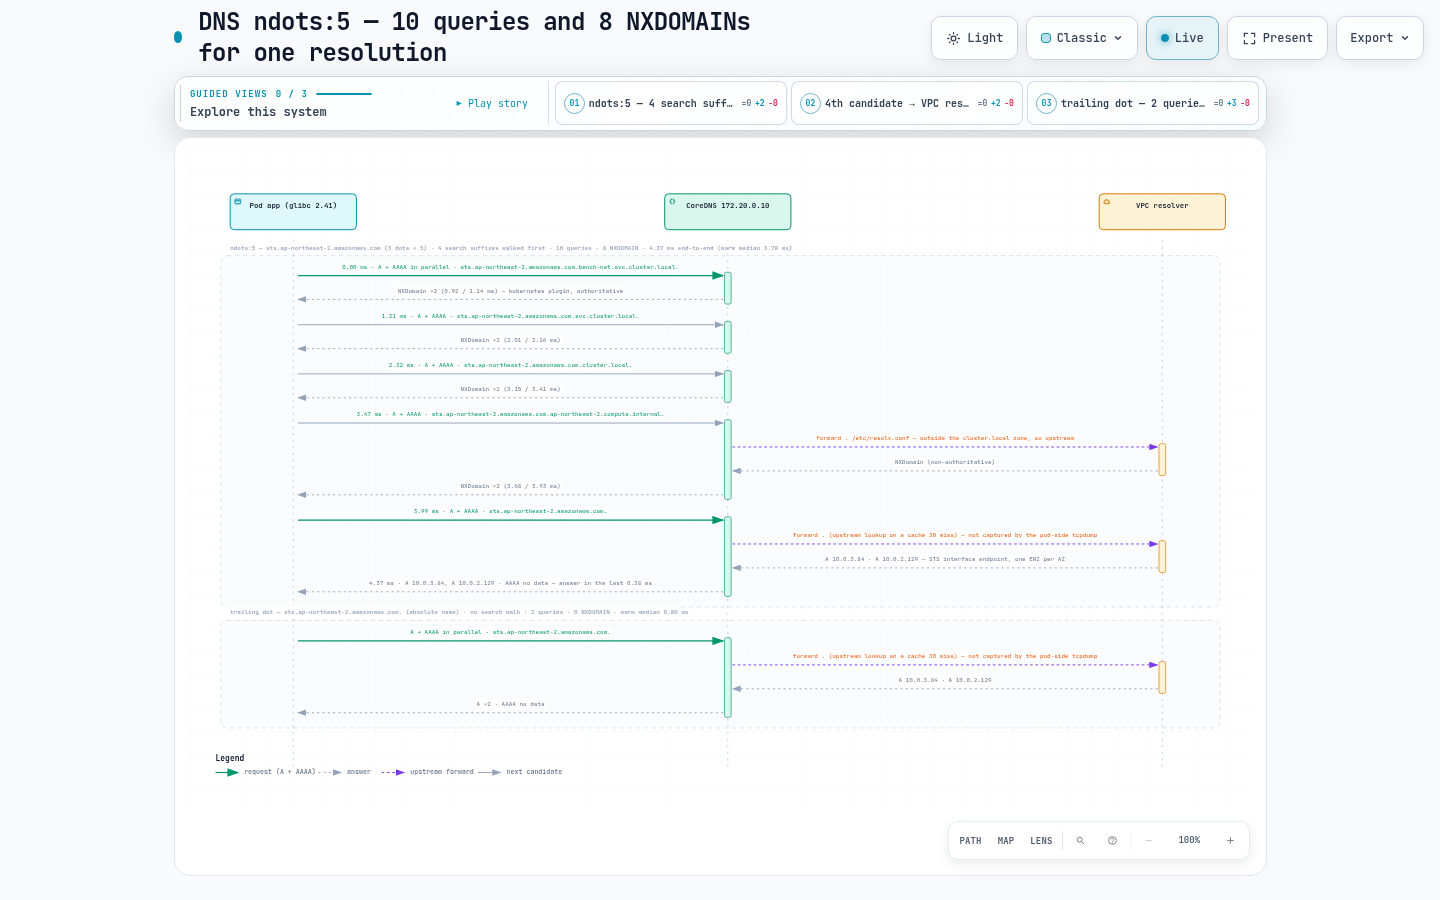
EKS Pod 的 /etc/resolv.conf 有四个搜索域(bench-net.svc.cluster.local svc.cluster.local cluster.local ap-northeast-2.compute.internal)和 options ndots:5。glibc 解析器会将点数少于 ndots 的任何名称先尝试附加每个搜索后缀,并为每个候选并行发送 A 和 AAAA(默认关闭 single-request)。因此有 3 个点的 sts.ap-northeast-2.amazonaws.com,必须先为全部四个候选收集 NXDOMAIN,才会查询绝对名称。方法:在 dns-default / dns-ndots1 的 app 容器中,执行一次冷 socket.getaddrinfo(name, 80, AF_UNSPEC, SOCK_STREAM) 调用,同时 sniffer sidecar 中的 tcpdump(-i eth0 -nn udp port 53)捕获并计数该次解析的 DNS 数据包;随后再解析相同名称 20 次并在进程内计时——这就是预热延迟。
单次解析的发送查询数与预热延迟(20 次重复)、ms
| Pod / ndots | 名称(点数) | 发送查询数 | NXDOMAIN 响应数 | 预热最小 | 中位数 | p90 | 最大 |
|---|---|---|---|---|---|---|---|
| 默认 / 5 | kubernetes.default (1) | 4 | 2 | 0.87 | 1.71 | 1.97 | 2.61 |
| 默认 / 5 | kubernetes.default.svc.cluster.local (4) | 10 | 8 | 1.53 | 3.63 | 4.45 | 6.41 |
| 默认 / 5 | kubernetes.default.svc.cluster.local.(末尾点) | 2 | 0 | 0.33 | 0.46 | 1.09 | 1.58 |
| 默认 / 5 | sts.ap-northeast-2.amazonaws.com (3) | 10 | 8 | 3.08 | 3.78 | 4.66 | 4.84 |
| 默认 / 5 | sts.ap-northeast-2.amazonaws.com.(末尾点) | 2 | 0 | 0.42 | 0.80 | 1.25 | 2.17 |
| 默认 / 5 | www.amazon.com (2) | 10 | 8 | 2.51 | 3.46 | 3.74 | 5.86 |
| ndots1 / 1 | kubernetes.default (1) | 6 | 4 | 1.16 | 2.04 | 2.80 | 4.54 |
| ndots1 / 1 | kubernetes.default.svc.cluster.local (4) | 2 | 0 | 0.35 | 0.97 | 1.08 | 1.35 |
| ndots1 / 1 | kubernetes.default.svc.cluster.local. | 2 | 0 | 0.34 | 0.40 | 0.97 | 1.17 |
| ndots1 / 1 | sts.ap-northeast-2.amazonaws.com (3) | 2 | 0 | 0.45 | 0.54 | 1.22 | 1.42 |
| ndots1 / 1 | sts.ap-northeast-2.amazonaws.com. | 2 | 0 | 0.47 | 0.75 | 1.20 | 1.30 |
| ndots1 / 1 | www.amazon.com (2) | 2 | 0 | 0.63 | 0.90 | 1.27 | 2.74 |
冷的首次解析(包括 glibc NSS 初始化;仅作指示用途)为:默认 / sts 6.22 ms、默认 / sts. 2.87 ms、默认 / www.amazon.com 9.58 ms、默认 / kubernetes.default.svc.cluster.local 7.40 ms、ndots1 / kubernetes.default 10.52 ms、ndots1 / sts 2.84 ms。
如何解读。在默认 ndots:5 下,两个外部名称(sts.…、www.amazon.com)以及——或许令人意外的——没有末尾点的集群 FQDN(kubernetes.default.svc.cluster.local:4 个点,少于 5)均需要10 次查询、8 个 NXDOMAIN,中位数 3.5–3.8 ms。给相同名称加一个点(….com.),则变为 2 次查询 / 0.46–0.80 ms——查询数仅为五分之一,且 sts 的预热中位数从 3.78 降至 0.80 ms,集群 FQDN 从 3.63 降至 0.46 ms。短名称 kubernetes.default 在第二个候选(svc.cluster.local)匹配并停止在 4 次查询 / 1.71 ms。CoreDNS 的 cache 30 也最多缓存 NXDOMAIN 30 s,因此预热状态下昂贵的不是上游查找,而是等待 5 次顺序的 Pod↔CoreDNS 往返。
实际遍历过程 — 一次 sts.ap-northeast-2.amazonaws.com 的冷解析(ndots:5、tcpdump、从第一个数据包起算 ms)
| t (ms) | 发送至 172.20.0.10 的候选(并行 A + AAAA) | 响应 |
|---|---|---|
| 0.00 | sts.ap-northeast-2.amazonaws.com.bench-net.svc.cluster.local. | NXDomain(权威,CoreDNS kubernetes plugin)于 0.92 / 1.14 |
| 1.21 | sts.ap-northeast-2.amazonaws.com.svc.cluster.local. | NXDomain 于 2.01 / 2.26 |
| 2.32 | sts.ap-northeast-2.amazonaws.com.cluster.local. | NXDomain 于 3.15 / 3.41 |
| 3.47 | sts.ap-northeast-2.amazonaws.com.ap-northeast-2.compute.internal. | NXDomain(转发至 VPC resolver——非权威)于 3.68 / 3.93 |
| 3.99 | sts.ap-northeast-2.amazonaws.com. | A 10.0.3.84, A 10.0.2.129 于 4.37(AAAA:无数据) |
10 次查询、8 个 NXDOMAIN、5 次顺序往返、端到端 4.37 ms——有用的响应在最后 0.38 ms 到达。每个候选的 Pod→CoreDNS→Pod 往返为 0.8–1.1 ms,其中包含 CoreDNS 处理时间及测量 1 中的 RTT 阶梯。172.20.0.10 通过 iptables 随机选择分配到两个 CoreDNS Pod,且其中一个位于另一个 AZ,因此约一半 DNS 查询跨越 AZ 边界。sts.ap-northeast-2.amazonaws.com 解析为两个私有 IP(10.0.2.x / 10.0.3.x),因为该 VPC 有一个 STS interface endpoint,每个 AZ 一个 ENI。没有末尾点的 kubernetes.default.svc.cluster.local 走过相同的路径;其 .ap-northeast-2.compute.internal 候选耗时 2.2 ms,因为 CoreDNS 将其向上游转发;整个遍历冷状态为 5.6 ms,而带末尾点时为 0.4–0.5 ms。
ndots:1 的作用及其副作用
- 外部名称:10 → 2 次查询,中位数 3.5–3.8 → 0.5–0.9 ms(约快 4–7 倍,查询数为五分之一)。
- 短集群名称变差。
kubernetes.default(1 个点,≥ ndots 1)首先作为绝对名称kubernetes.default.尝试;CoreDNS 没有其 zone,因而将它转发至 VPC resolver(1.6 ms 后 NXDomain),然后遍历bench-net.svc.cluster.local(NXDOMAIN),最后从svc.cluster.local获取172.20.0.1——6 次查询、4 个 NXDOMAIN、中位数 2.04 ms,比 ndots:5 下的 1.71 ms 更慢。集群内部名称也会泄漏到上游 resolver。若使用ndots:1,请通过 FQDN(name.namespace.svc.cluster.local)访问集群内 Service。 - 无论 ndots 如何,末尾点均有效——所有情况下均为 2 次查询、0.4–0.8 ms。
放大计算(推导)
每个请求解析一个外部名称的应用,在 ndots:5 下会发送 10 次而不是 2 次 DNS 查询,并为每次解析花费约 +3 ms(推导:sts 为 3.78 − 0.80 = 2.98 ms,未带末尾点的 FQDN 为 3.63 − 0.46 = 3.17 ms)。假设全集群每秒 1,000 次解析,CoreDNS 将接收 10,000 次而不是 2,000 次查询,其中 8,000 次回答 NXDOMAIN。两个 CoreDNS 副本上五分之四的负载用于生成“不存在”,而其中约一半数据包还会以区域数据传输费率跨越 AZ 边界(体量小,但并非零)。
所以呢——四种修复方法。(1) 在配置中的外部 endpoint 加上末尾点(
sts.ap-northeast-2.amazonaws.com.)——立即变为 2 次查询,无需改代码。(2) 对发起大量外部调用的 Pod 设置dnsConfig: {options: [{name: ndots, value: "1"}]}——但随后要通过 FQDN 访问集群名称。(3) NodeLocal DNSCache——本集群不存在它;有了它,Pod↔CoreDNS 往返(其中一半跨 AZ)将变为节点本地缓存命中(未测量)。(4) CoreDNSautopath插件会代表 Pod 在服务器端遍历搜索路径;它不在此 Corefile 中(未测量)。
如何复现
将上述 manifest 保存为
bench-net.yaml,应用它,并检查放置是否符合预期。每次运行的 Pod IP 都不同,因此请从-o wide中读取并替换到下面的命令中。bashkubectl apply -f bench-net.yaml kubectl -n bench-net get pods -o wide # cli and srv-same on one node (2a), srv-a on another 2a node, srv-b in 2b kubectl -n bench-net exec -it cli -- bashRTT——每条路径以 50 ms 间隔进行 200 次探测:
bashping -c 200 -i 0.05 -q 10.0.2.72 # same-node ping -c 200 -i 0.05 -q 10.0.2.37 # same-AZ ping -c 200 -i 0.05 -q 10.0.3.65 # cross-AZ curl -s -o /dev/null -w 'connect=%{time_connect} total=%{time_total}\n' http://10.0.3.65:8080/ # one cold request, for reference吞吐量——iperf3,20 s、1 个流和 8 个流、JSON 输出。持续运行是跨 AZ 的 180 s / 4 个流 / 10 s 间隔:
bashfor SRV in 10.0.2.72 10.0.2.37 10.0.3.65; do iperf3 -c $SRV -p 5201 -t 20 -P 1 -J > t1-$SRV-P1.json iperf3 -c $SRV -p 5201 -t 20 -P 8 -J > t1-$SRV-P8.json done iperf3 -c 10.0.3.65 -p 5201 -t 180 -P 4 -i 10 -J > t1-b-sustained180-P4.json表格列来自 JSON:
end.sum_sent.bits_per_second、retransmits、end.cpu_utilization_percent.host_total/remote_total,以及每个流的sender.mean_rtt和max_snd_cwnd。请求延迟——fortio。每次运行均使用
-quiet -r 0.00001 -json -:bashSRV=10.0.3.65 # repeat per path fortio load -quiet -r 0.00001 -json - -qps 100 -c 4 -t 60s http://$SRV:8080/ # HTTP keepalive fortio load -quiet -r 0.00001 -json - -qps 100 -c 4 -t 30s -keepalive=false http://$SRV:8080/ # new connection per request fortio load -quiet -r 0.00001 -json - -qps 0 -c 16 -t 20s http://$SRV:8080/ # qps 0 = unlimited, closed loop fortio load -quiet -r 0.00001 -json - -grpc -ping -qps 100 -c 4 -t 30s $SRV:8079 # gRPC ping**不要去掉
-r 0.00001。**fortio 的默认直方图分辨率为-r 0.001,即 1 ms 的 bucket。本页的每个延迟都低于 1 ms,因此使用默认值时,每个请求都会落入第一个 bucket,p50/p99 会变为该 bucket 内的线性插值——任何低于 1 ms 的值 p50 = 0.5 ms。首次 T2 运行正是得到了该结果;其百分位数被丢弃(平均值有效),而上面的表为 10 µs 分辨率下的重新运行。任何使用 fortio 测量亚毫秒延迟的人都会遇到这一问题。DNS——从
bench-dns.yaml部署两个 Pod;一个终端中通过sniffersidecar 捕获,同时另一个终端中app容器冷解析该名称一次、预热解析 20 次:bashkubectl apply -f bench-dns.yaml kubectl -n bench-net exec dns-default -c app -- cat /etc/resolv.conf # confirm 4 search domains + ndots:5 kubectl -n bench-net exec dns-ndots1 -c app -- grep ndots /etc/resolv.conf # options ndots:1 # terminal 1 — every DNS packet this Pod sends or receives kubectl -n bench-net exec dns-default -c sniffer -- tcpdump -i eth0 -nn udp port 53 # terminal 2 — one cold resolution (count queries and NXDOMAIN in the capture above) + 20 warm timings kubectl -n bench-net exec dns-default -c app -- python3 - <<'PY' import socket, statistics, time name = "sts.ap-northeast-2.amazonaws.com" # trailing-dot variant: name + "." def one(): t = time.perf_counter() socket.getaddrinfo(name, 80, socket.AF_UNSPEC, socket.SOCK_STREAM) return (time.perf_counter() - t) * 1000 print("cold ms", round(one(), 2)) xs = sorted(one() for _ in range(20)) print("warm min/median/p90/max", round(xs[0], 2), round(statistics.median(xs), 2), round(xs[int(len(xs)*0.9)-1], 2), round(xs[-1], 2)) PY对
dns-ndots1重复相同过程,以获得表格的最后六行。该表测量 glibc 解析器(python:3.12-slim);未测量其他解析器(musl/alpine)的结果,因此请使用 glibc 镜像复现这些数字。完成后删除 namespace——
kubectl delete ns bench-net。Karpenter 会移除空节点。
注意事项
- **节点是新建的,但并非完全独占。**Karpenter 为此测试启动三个 m5.xlarge 节点后不久,consolidation 将其他 namespace 中少量小 Pod 移至这些节点(
cli节点一个,srv-b节点三个——与基准流量无关的小型内部服务和 controller)。运行期间它们空闲或流量很低,负载被限制为最长 180 s 的突发。cli节点显示 CPU requests 为 3901m / 3920m(99 %),这并未说明实际利用率。 - **单次运行(每个单元 n = 1、仅一天)。**未做重复以估计方差。请将这些数字视为量级锚点,而非 SLA,并基于比例和模式得出结论(RTT 阶梯、5 Gbps 流上限、10 Gbps 实例上限、10 对 2 次查询)。
- **无法测量 ClusterIP(kube-proxy iptables 跳转)和
trafficDistribution: PreferClose。**集群中的每次 Servicekubectl apply均被拒绝,错误为Internal error occurred: failed calling webhook "mservice.elbv2.k8s.aws": … no endpoints available for service "aws-load-balancer-webhook-service"。只读诊断结果:aws-load-balancer-controller已持续数周处于 CrashLoopBackOff,因此其后的failurePolicy: Failwebhook 有零个就绪 endpoint——在 controller 恢复之前,集群中任何位置都无法创建 Service。本基准没有绕过该 webhook;装置只使用 Pod IP。症状 → 诊断 → 修复已写入 Troubleshooting Playbook,第 11 项“无法创建 Service:failed calling webhook” (English)。 - 未收集 ENA allowance 计数器。
ethtool -S eth0 | grep allowance_exceeded(bw_in_allowance_exceeded、bw_out_allowance_exceeded、pps_allowance_exceeded、conntrack_allowance_exceeded、linklocal_allowance_exceeded)需要节点上的 hostNetwork Pod,此处未运行。重传计数是间接信号。 - **仅是在 180 s 内未观察到突发积分耗尽。**在“Up to”实例上,较长的持续传输可能被限速至基线(1.25 Gbps)。未测试超过 180 s 的情况。
- **DNS 延迟包含 CoreDNS 缓存效应。**冷首次解析和 20 次预热重复不同(
cache 30也会缓存 NXDOMAIN),外部名称经过 VPC resolver。预热值之间的比较有效;绝对值取决于缓存状态。 - **同节点 iperf3 受一个客户端核心限制(99.8 %)。**29.97 / 48.15 Gbps 是此实例系列的 CPU 数值,在其他系列上会不同。
- **未比较其他 CNI 模式。**关闭 prefix delegation、关闭 Security Groups for Pods、network policy enforcing mode 为
standard(eBPF agent 存在,但 namespace 没有 policy)。这些设置改变时会发生什么不在本页范围内。
相关阅读
- Amazon VPC CNI —— 这些测量所基于的数据平面:Pod 直接接收 VPC IP、prefix delegation、ENI/IP warming
- Zonal Cluster Operations —— 减少测量 3 账单的区域对齐放置和 AZ failover 设计
- Troubleshooting Playbook,第 11 项 — 无法创建 Service:failed calling webhook (English) —— 使 ClusterIP 未纳入本基准的故障
- Sidecar vs Ambient Mode Selection Guide —— 将 sidecar 跳转的 +1.29 ms p50 与此处测得的 +0.21 ms AZ 跳转并列比较
- EBS gp2 vs gp3 Measured Benchmark —— 同一集群的存储路径测量
- Kafka on EKS Measured Benchmark —— RF3 复制流量如何遇到本页的 5 Gbps 流上限和跨 AZ 定价
- Guidebook Roadmap — 测量基准系列
- 测验:Pod 网络基准测试