第 1 部分:Kubernetes 上的 Flink 架构
最后更新:2026 年 9 月 12 日。集成示例使用:Flink 2.2.1 / Java 17 / Operator 1.15.0。
本章介绍集群角色和资源规划。请准备当前受支持的 EKS/Kubernetes 版本、兼容的 kubectl、Flink 发行版以及客户端访问权限。第 2 部分介绍安装、服务账户、RBAC 和 Operator 资源。历史上的 Kubernetes 最低版本要求不代表当前的支持矩阵。
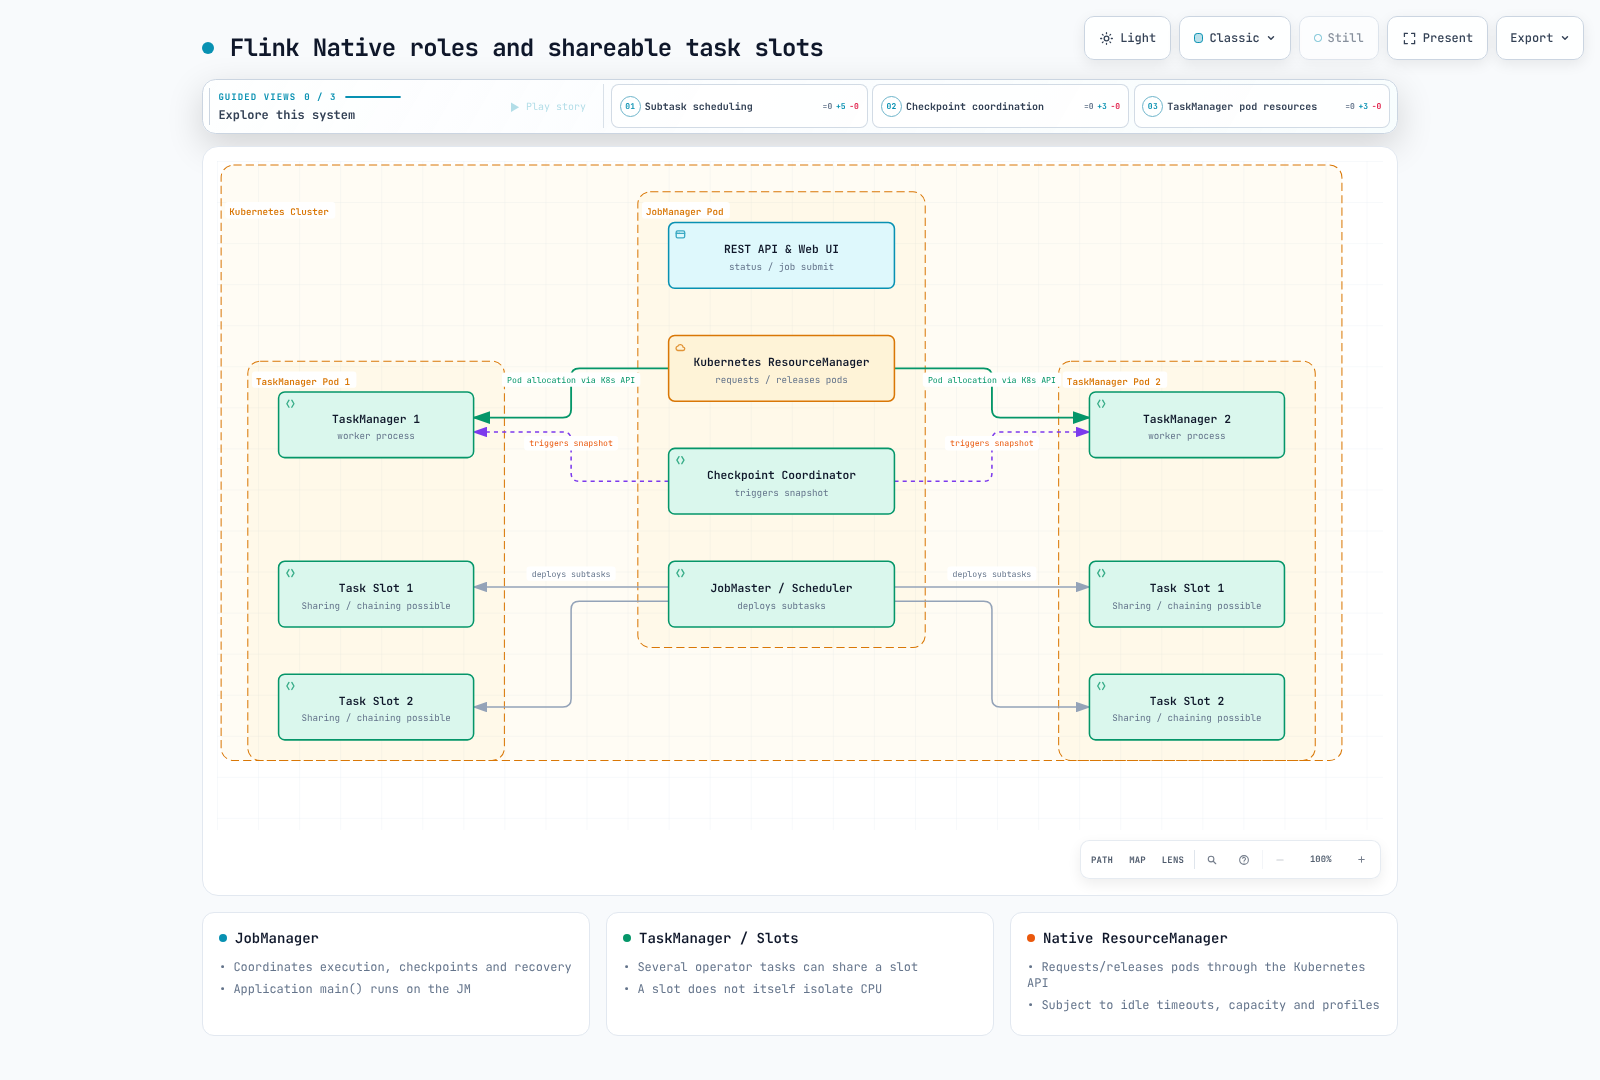
1. JobManager、TaskManager 和客户端
| 角色 | 职责 |
|---|---|
| 客户端 | 根据提交方式运行应用程序的 main() 来构建执行图,或请求集群执行应用程序 |
| JobManager | Dispatcher、ResourceManager 和每个作业的 JobMaster 负责协调提交、slot、执行、检查点和恢复 |
| TaskManager | 执行任务线程、交换/缓冲数据并处理状态 |
| Kubernetes ResourceManager | 在 Native 模式下通过 Kubernetes API 请求/释放 TaskManager Pod |
JobManager 并非在所有部署模式下都会构建初始执行图。Application 模式会在 JobManager 上运行 main();常规的 2.2 Session CLI 提交则在客户端构建执行图。TaskManager 负责处理常规算子记录,但应用程序的 main() 属于用户代码,因此不能假设它始终不会增加 JobManager 的负载。
Slot、算子链和 slot 共享
Task slot 是 TaskManager 的资源分配单位。经典的固定 slot 配置会划分受管理内存,但本身不会提供 CPU 隔离。每个 TaskManager 都是一个 JVM,可以承载多个任务线程。
Flink 可以将多个算子子任务链接为一个任务/线程。同一作业中的不同任务也可以通过 slot 共享组共享 slot。因此,四个 slot 并不意味着算子子任务最多只能有四个。
| 示例假设 | 简化的 slot 计算 |
|---|---|
| source(4) → map(4) → sink(2),都在同一个共享组中 | 最多可放入 4 个 slot,即最大并行度 |
| source/map 在组 A,sink 在组 B | 两组同时运行需要 4 + 2 = 6 个 slot |
这些只是共享组和资源要求兼容时的简单流处理示例。批处理调度、细粒度资源配置、其他作业和算子链都需要单独考虑。每个 TM 有两个 slot 时,四个 slot 至少需要两个 TM,六个 slot 至少需要三个 TM。实际 CPU、网络、状态大小和余量也必须满足要求。
2. Application/Session 决定集群生命周期和共享方式
| 模式 | main() 和集群生命周期 | 运维边界 |
|---|---|---|
| Application | 在专用于某个应用程序的集群上运行 main();集群生命周期随该应用程序而定 | 一次 main() 可以创建多个作业,因此并非总是一项作业对应一个集群 |
| Session | 向现有集群提交应用程序/作业;常规的 2.2 CLI 会在客户端运行 main() | 作业共享 JM/TM 容量;一个 TM 故障可能影响多个作业 |
Application 模式会隔离不同应用程序的 JVM 和生命周期,但不会完全隔离共享的 EKS 节点、网络、存储或 API 配额。同一应用程序内的多个作业也会共享其集群。2.2 基线文档说明了单次执行应用程序的 Application HA;对于多作业应用程序,应检查对应版本的限制,不能把 2.3 的改进追溯套用到较早版本。
Session 模式可以复用已分配的资源,并避免集群启动开销。如果没有可用 slot,它并不保证作业能立即运行;共享故障和资源争用也仍需考虑。
Per-Job 是一种历史模式:由客户端构建执行图,并为每个作业创建专用集群。它不是 Native Kubernetes 的选项。此处介绍的当前 Kubernetes 选项是 Application 和 Session,而不是三种受支持模式。
3. Native/Standalone 是另一个资源管理维度
Application/Session 与 Native/Standalone 是两种不同的分类。Operator 1.15.0 支持 Application/Session 集群,以及 Native/Standalone 部署。
| 方面 | Native | Standalone |
|---|---|---|
| TM Pod 管理 | JM 的 Kubernetes ResourceManager 通过 API 请求/释放 Pod | Operator 等外部管理器负责协调 Kubernetes 资源 |
| 运行时权限 | Native 资源管理需要 Kubernetes API 权限 | 可以由外部管理;还应单独检查 HA 等附加功能所需的 API 权限 |
| 副本数变更 | 由 Flink 的 slot 需求、空闲策略和限制决定 | 可由 Operator/其他控制器管理,并非只能手动编辑 YAML |
Native 是通常的默认路径,但 Standalone 并不是已经废弃的旧模式。通过 CR 的 spec.mode 选择模式,并评估资源创建权限应归属何处以及适用哪些功能限制。这并不会自动消除所有 Kubernetes API 交互,也不会完全隔离不可信代码。
Native 下的 TaskManager 分配还取决于资源配置、上下限和空闲超时。2.2.1 中 resourcemanager.taskmanager-timeout 的默认值为 30 秒。作业完成或并行度降低,并不意味着 Pod/节点数量会立即按严格比例减少。Karpenter/Cluster Autoscaler 在另一个层面管理节点容量。
当前 CLI 提交方式
这是不使用 Operator 的 Native Application 提交方式,前提是已按照第 2 部分准备好命名空间、flink 服务账户和 RBAC。 不要让 Operator CR 和 CLI 同时管理相同的集群 ID。 随附的 state-machine 示例会持续运行,并不是一个运行后即退出的批处理冒烟测试。
# Illustration after namespace/ServiceAccount/RBAC preparation from Part 2.
# Use the Flink 2.2.1 distribution and a cluster ID not owned by an Operator CR.
./bin/flink run \
  --target kubernetes-application \
  -Dkubernetes.cluster-id=flink-cli-example \
  -Dkubernetes.container.image.ref=flink:2.2.1-java17 \
  -Dkubernetes.namespace=data-processing \
  -Dkubernetes.jobmanager.service-account=flink \
  -Dtaskmanager.numberOfTaskSlots=2 \
  -p 2 \
  local:///opt/flink/examples/streaming/StateMachineExample.jar
2.2.1 CLI 使用 run --target kubernetes-application。不要照搬旧的 run-application 操作。image.ref 是当前使用的键;container.image 是已弃用的别名。本地 URI 指向此示例镜像内部的 JAR。请验证客户端/JM 权限、镜像拉取、DNS、容量以及实际的 REST/日志结果。
4. 运行时和验证范围
对于此基线,推荐/默认选择 Java 17 镜像。 官方镜像元数据也列出了 Java 11 变体,因此声称所有 2.x Java 11 镜像都已移除是不正确的。2.2 文档将 Java 21 支持描述为实验性功能;不能认为所有高于 17 的 JDK 都得到同等支持。 还应匹配应用程序字节码、连接器和反射设置。
已检查架构、CLI 分发/配置键、Operator 源码和镜像标签元数据。此处未执行集群创建、CLI 作业提交、HA 或吞吐量测试。