在 EKS 上进行模型训练
最后更新:October 16, 2026 基线版本:Slinky1.2.3、MPI Operator0.8.2、Volcano1.15.2、PyTorch2.14.0、Neuron SDK2.32.0
分布式训练需要兼容的模型代码、数据分片、启动器、设备分配、通信和检查点。有效的清单或处于 Running 状态的 Pod,并不能证明训练或恢复功能正常。
有关单 GPU QLoRA 以及 SageMaker AI/EKS 对比,请参阅 Qwen 指南,其中包括镜像支持生命周期和执行限制。
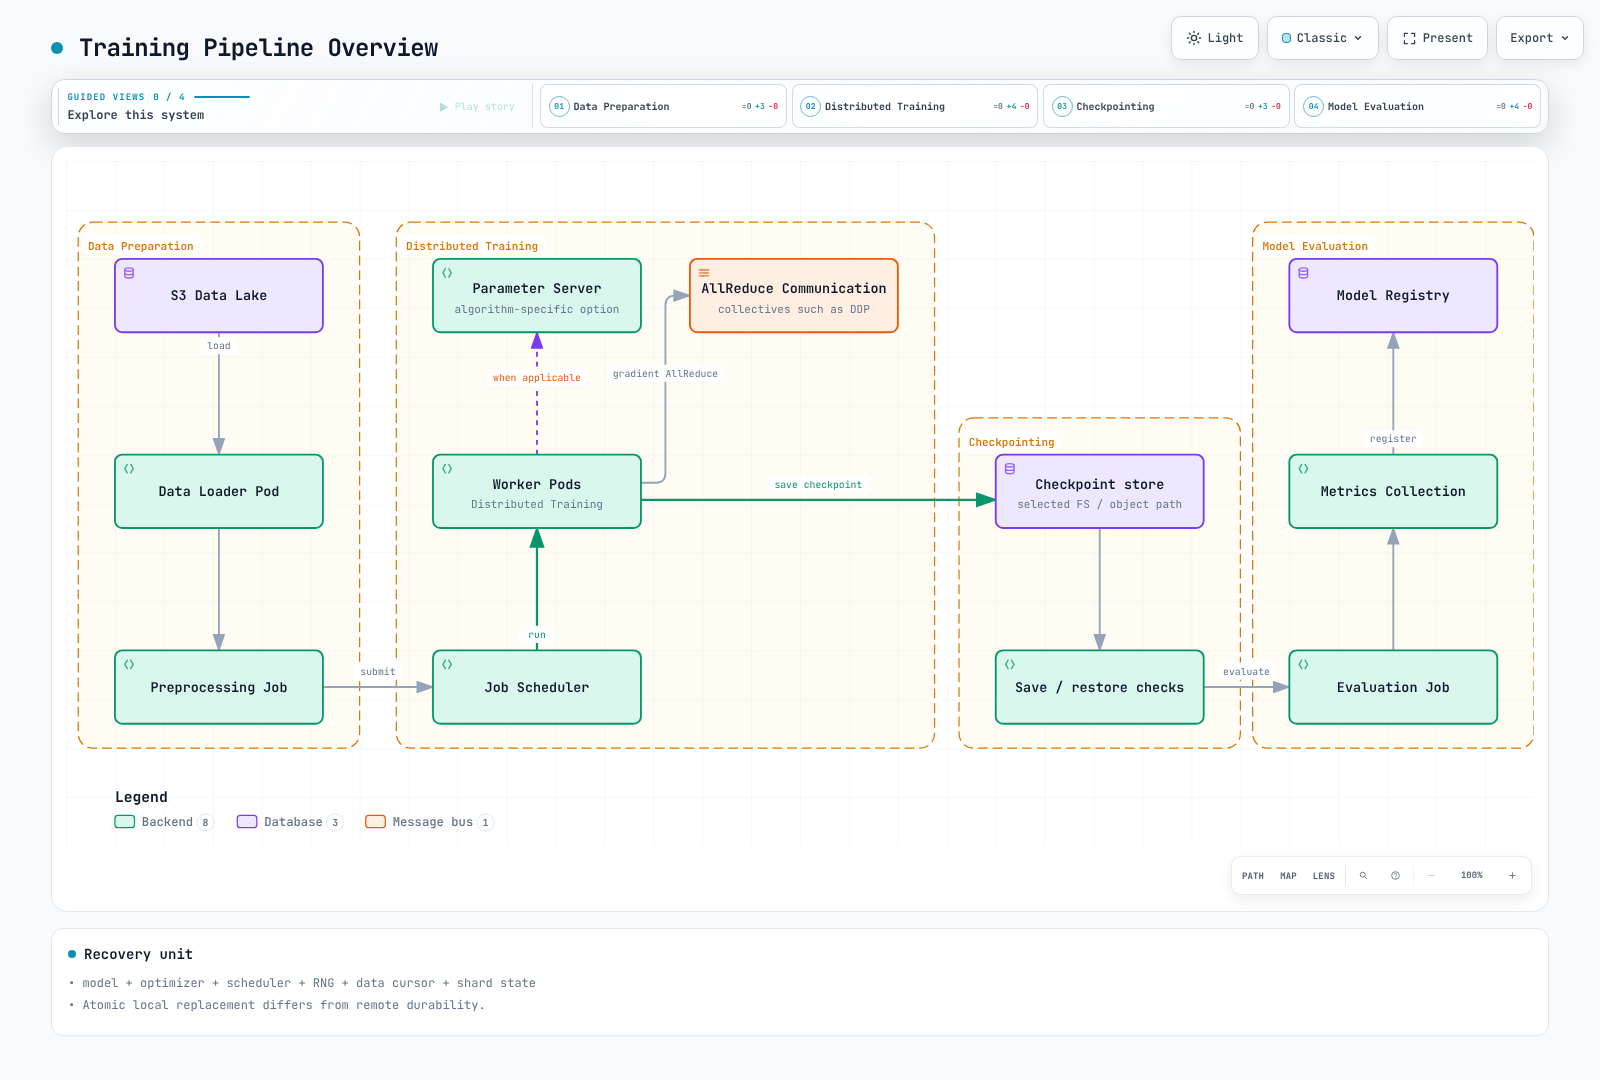
训练流水线
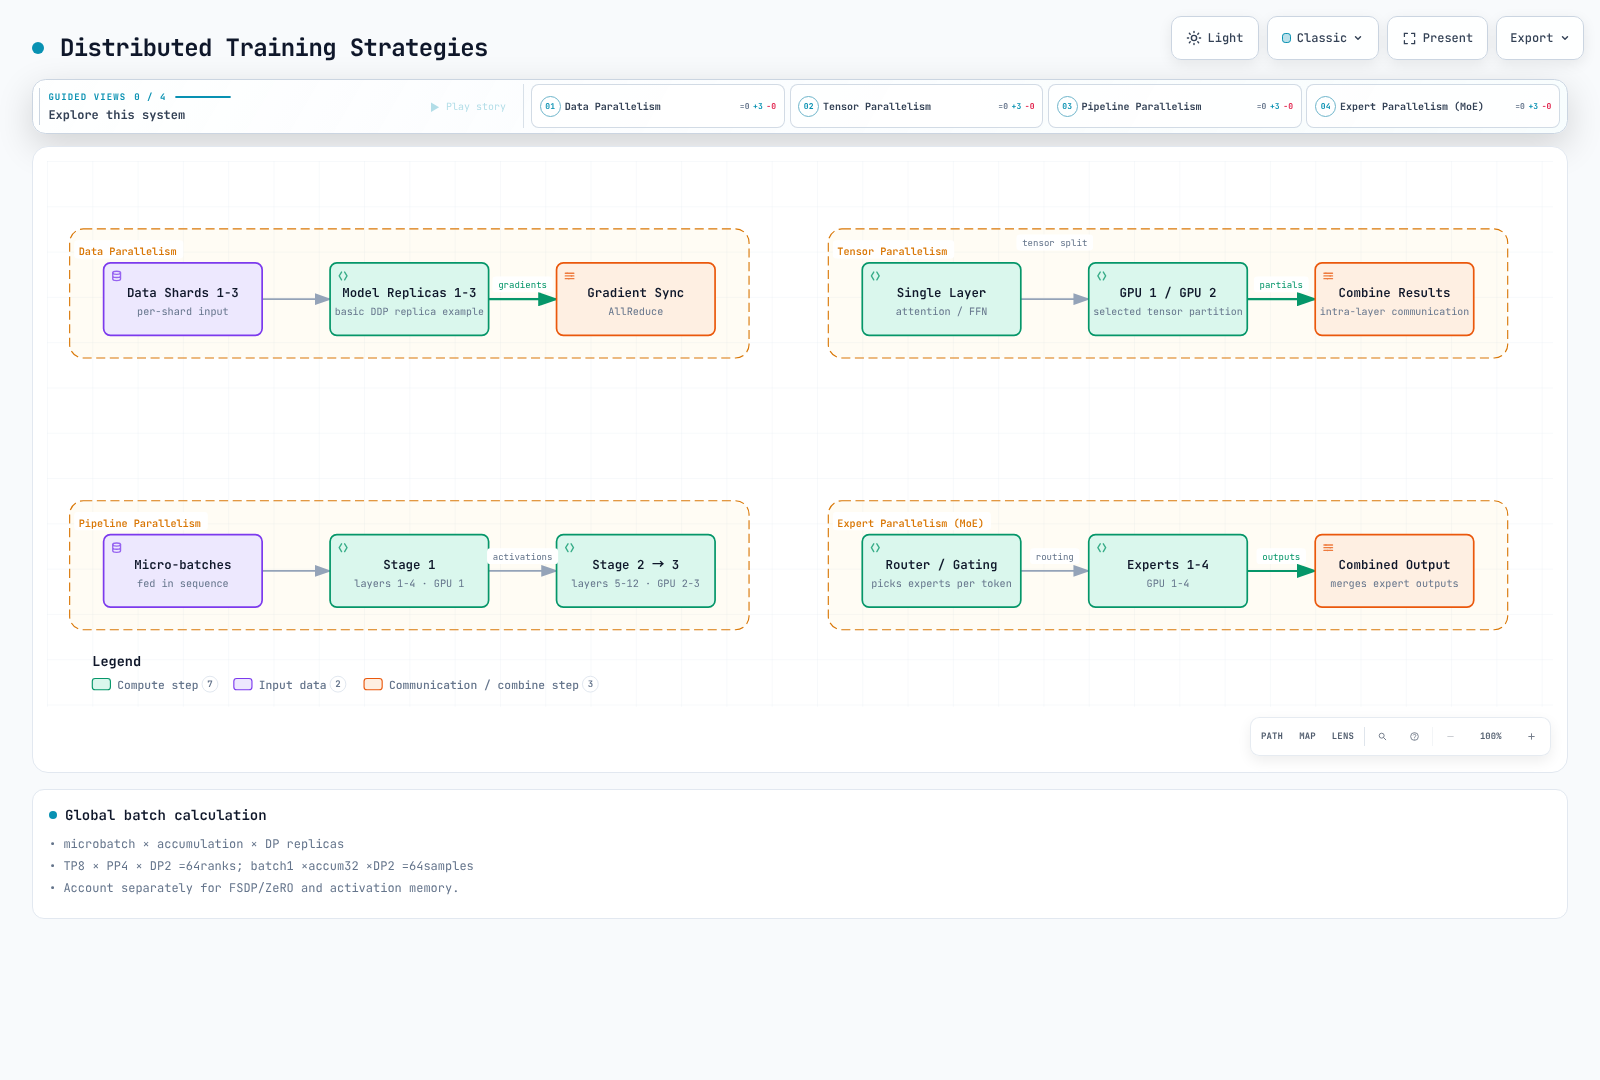
分布式训练策略
| 策略 | 分区单元 | 需要验证的约束 |
|---|---|---|
| DDP | 不同的数据批次;模型副本 | 训练状态/激活值内存和梯度同步 |
| FSDP / ZeRO | 参数、梯度和优化器状态 | 特定阶段的通信和检查点格式 |
| TP | 层内的张量运算 | 注意力头/隐藏维度、后端和拓扑 |
| PP | 层阶段 | 微批次、流水线气泡和激活值传输 |
| 专家并行 | MoE 专家和 Token 分发 | 负载不均衡、全互连通信和路由容量 |
| 组合策略 | DP/TP/PP/上下文/专家组 | 支持的设备网格和总 rank 数 |
不要认为参数量超过 100B 时,3D 并行总是最佳选择。除了权重,还要考虑优化器、梯度、激活值和通信所需的内存,然后比较吞吐量和恢复成本。DDP 的 all-reduce 不需要参数服务器。
TP8×PP4×DP2 表示 64 个 rank。全局批次大小为 微批次 × 累积步数 × DP 副本数:1×32×2=64,而不是再次将所有 TP/PP rank 相乘得到的 2048。使用可变长度打包时,应分别跟踪样本数和 Token 数。
Slurm 和 Slinky
官方仓库为 SlinkyProject/slurm-operator。已验证 Tag1.2.3 及其 OCI charts;GitHub releases/latest 返回 404,因此不会将其描述为最新 GitHub release。1.2 文档列出的最低要求为 Kubernetes1.29 和 Slurm25.11(data parser0.0.44)。最低兼容性并不保证实际支持生命周期。
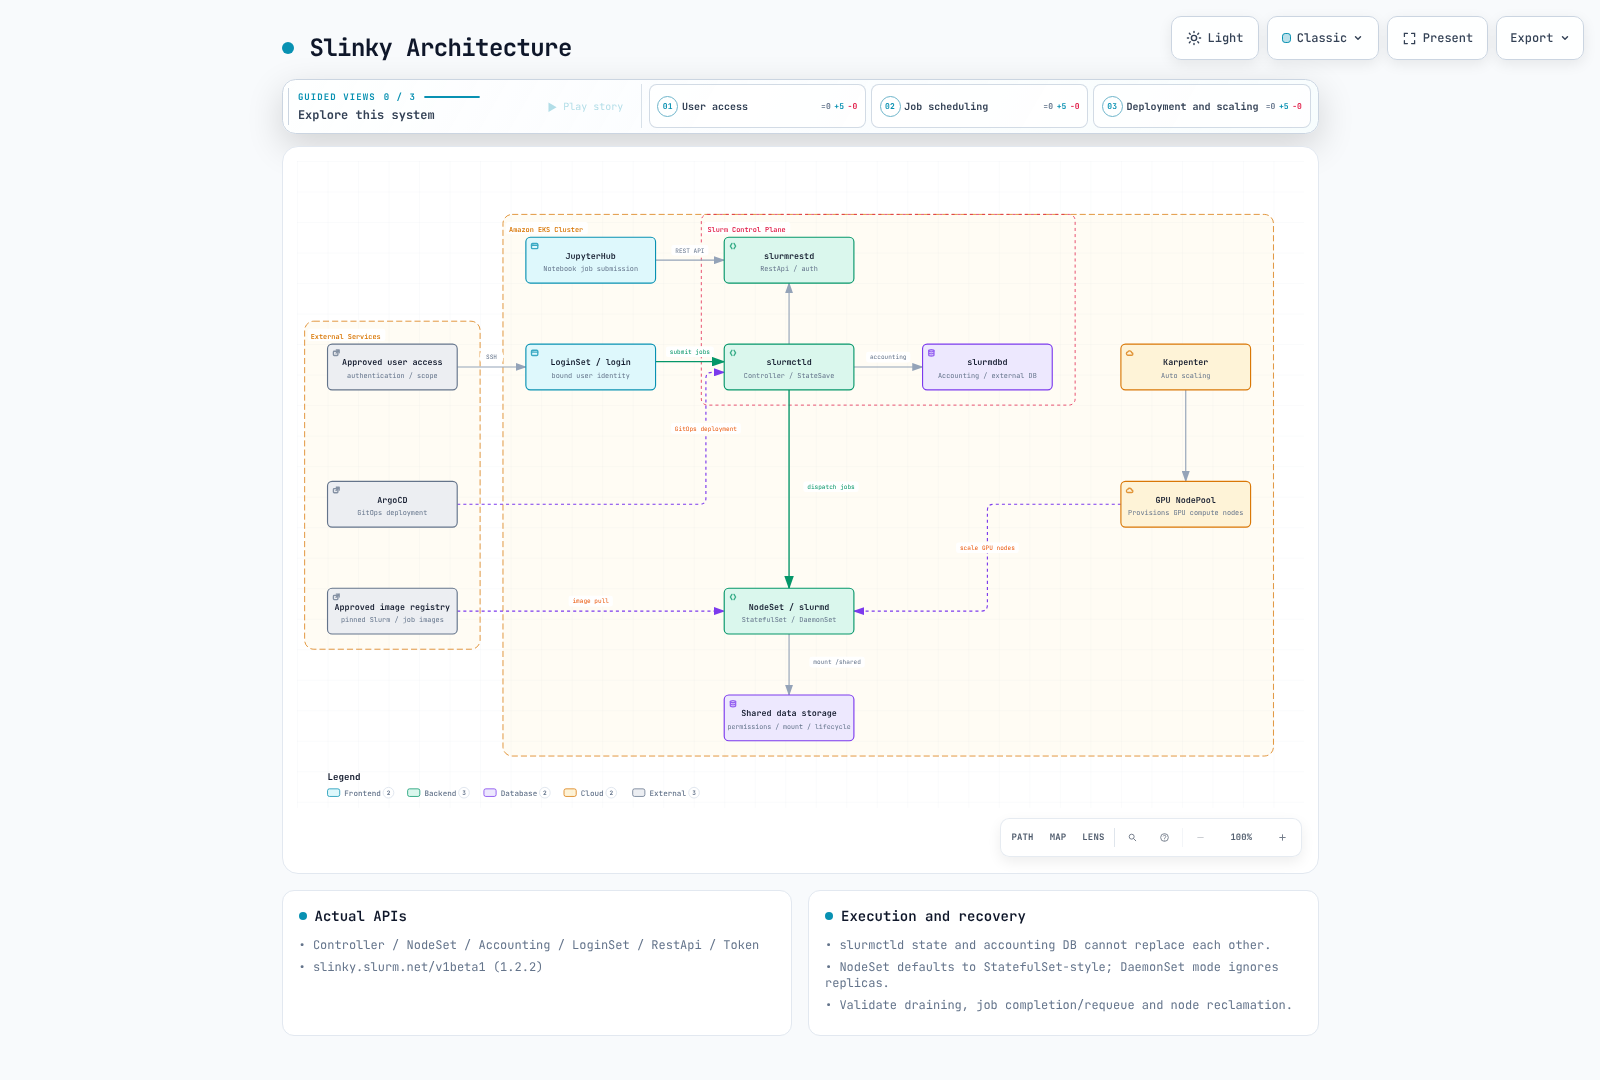
实际 API 和生命周期
Version1.2.3 在 slinky.slurm.net/v1beta1 中定义了 Controller、NodeSet、Accounting、LoginSet、RestApi 和 Token。以前的 SlurmCluster/SlurmNodeSet 示例并非此 API。NodeSet 使用 controllerRef 和 Pod 模板。其默认 scalingMode 的行为类似 StatefulSet;DaemonSet 模式会为每个匹配的 Kubernetes 节点创建一个 Pod,并忽略 replicas。这些是 NodeSet-controller 模式,并不能证明 slurmd 始终以 Kubernetes DaemonSet 资源的形式运行。
slurmctld 管理作业/节点/分区状态和调度;应保留其 StateSaveLocation。slurmdbd 处理记账数据库的访问和记录,并不能替代 controller 状态。应一并设计 login/REST/job 身份、文件系统权限、Slurm 密钥/JWT 和数据库凭证的交付/轮换。公开 NLB SSH 暴露并非默认前提条件。
先渲染实际 charts。这些命令只会生成本地文件。实际部署还需要分别处理 cert-manager/CRD/operator/Slurm 的部署顺序、持久化/数据库、用户身份和兼容的 Slurm 镜像。
helm template slurm-api oci://ghcr.io/slinkyproject/charts/slurm-operator-crds   --version 1.2.3 > slurm-crds.yaml
helm template slurm-control oci://ghcr.io/slinkyproject/charts/slurm-operator   --version 1.2.3 --namespace slinky > slurm-operator.yaml
helm template slurm-example oci://ghcr.io/slinkyproject/charts/slurm   --version 1.2.3 --namespace slurm   --set-json 'nodesets={"cpu-example":{}}'   --set partitions.all.enabled=true > slurm-example.yaml
Argo CD Application 必须引用真实的 chart 路径/修订版本和实际 values。臆造的 compute.partitions/efa.enabled 设置无法配置它。应检查 pruning、CRD/PVC 删除、Slurm 节点排空/重新排队以及作业终止超时。NodeSet 缩容和 EC2 终止是独立的控制循环。
从 Slurm 启动 torchrun
每个节点运行一个 torchrun 启动器,由它为每个 GPU 创建进程。之前的八个 Slurm 任务各自启动了八个进程,因此每个节点产生 64 个进程。本示例的目标是 4 个节点 × 8 个进程;本次审计并未实际运行 Slurm/GPU 分配。
#!/bin/bash
#SBATCH --job-name=distributed-training
#SBATCH --nodes=4
#SBATCH --ntasks-per-node=1
#SBATCH --gpus-per-node=8
#SBATCH --cpus-per-task=16
#SBATCH --time=01:00:00
set -euo pipefail

: "${SLURM_NNODES:?Run within an approved Slurm allocation}"
: "${SLURM_JOB_ID:?}"
: "${SLURM_JOB_NODELIST:?}"
export MASTER_ADDR
MASTER_ADDR=$(scontrol show hostnames "$SLURM_JOB_NODELIST" | head -n 1)
export MASTER_PORT=29500

# One torchrun launcher per Slurm node, eight training processes per launcher.
# train.py, dependencies, data, credentials and checkpoints must be prepared.
srun --ntasks="$SLURM_NNODES" --ntasks-per-node=1 bash -c '
  exec torchrun \
    --nnodes="$SLURM_NNODES" \
    --nproc-per-node=8 \
    --node-rank="$SLURM_PROCID" \
    --rdzv-id="$SLURM_JOB_ID" \
    --rdzv-backend=c10d \
    --rdzv-endpoint="$MASTER_ADDR:$MASTER_PORT" \
    /workspace/train.py
'
如果 Slurm 会限制每个任务的 GPU 可见性,请确保每个启动器都能访问预期的全部八个 GPU。train.py 必须实现 LOCAL_RANK/RANK/WORLD_SIZE、设备绑定、DDP/sampler、带版本的数据/模型以及恢复功能。Shell 测试夹具验证了四个启动器、不同的节点 rank 和共同的 rendezvous endpoint。
GPU 通信和 EFA
FI_PROVIDER=efa 用于选择 libfabric provider;它不会安装 EFA、附加接口或集成 NCCL。应一并验证支持 EFA 的实例、驱动/libfabric、aws-ofi-nccl、device plugin/Pod 分配、安全组和实际传输。RAID0 或子网标签不会启用 EFA。
通信节点必须位于同一个 AZ;建议使用集群 placement group 以提升性能。确保训练 Pods 确实使用受限的 NodePool。带宽和 EFA 设备数量因实例而异;400Gbps 并非通用值。盲目强制使用过时的 Ring/Simple、IB_DISABLE、SOCKET_IFNAME 或 FI_EFA_USE_DEVICE_RDMA 设置,可能会干扰当前插件。请核对版本文档、日志和集合通信测试。
Karpenter 的 budgets.nodes=0 会限制主动中断路径;它无法阻止 Spot 回收、节点故障、强制终止或所有过期事件。检查 do-not-disrupt/PDB 与 terminationGracePeriod/expireAfter 的交互,并确保能够通过检查点恢复。避免在每次引导时下载浮动版本的驱动安装程序,也不要对不同设备类型硬编码 GPU 时钟频率。
BioNeMo
已检查的 3.0.0 版本是 BioNeMo Recipes,提供基于 TransformerEngine 的模型/检查点,以及适用于 PyTorch、Accelerate 和 Lightning 的 recipes。应针对 ESM-2、AMPLIFY、Geneformer 等模型逐一检查 recipe 特定的支持情况。不要将 BioNeMo1.5 的 MegaMolBART 模块当作 3.0 API 来执行。生物学评估以及模型/数据权限仍是独立要求;仅分配 GPU 并不能完成 recipe 的准备工作。
Trainium 和 Neuron
应区分 SDK2.32.0 torch-neuronx、NeuronX Distributed Training/模型实现和 Optimum Neuron 路径。transformers-neuronx 的推理支持并不等于通用训练支持。应根据所选硬件/SDK 检查 TensorFlow/JAX/PyTorch 版本,而不是向旧版 2.18 DLC 随意添加 pip 包。
Optimum Neuron0.4.5 包含 NeuronTrainer/NeuronTrainingArguments 和专用的 Neuron 训练模型实现。加载通用的 BertForPreTraining 并传入未定义的数据集/分词器变量,并不构成完整的 TP 训练。应准备受支持的模型/配置、标签/collator、分词器/修订版本、优化器/检查点格式和启动器。CPU 示例中的 PyTorch2.14 并不代表其与 Neuron SDK 兼容。
多节点作业和预编译
Job 的 parallelism=4 只会启动四个 Pods;它不会配置 rank 或 rendezvous。Indexed Jobs 需要 completionMode/index 和一个共享的 master endpoint。将每个 Pod 的 MASTER_ADDR 设置为各自的 status.podIP,会导致 worker 指向不同的 master。应使用 coordinator/controller 拓扑和受支持的启动器,并准备好 train_lora.py、数据、编译缓存和设备。
neuron_parallel_compile 用于提取/编译计算图;它不能替代实际训练。之后应单独运行训练,并验证缓存命中、形状和编译器/SDK 修订版本。有关 core 与 device 的区别,请参阅 Neuron 单位区别。
Ray Train、MPI 和 Volcano
请使用经过审计的 Ray2.58/KubeRay1.7 Train 指南。确保各 worker 的 report 调用次数一致,并报告实际的 Checkpoint 对象。get_checkpoint() 用于获取先前的恢复状态,并不是新的保存上下文管理器。resources_per_worker GPU8 不会自动在一个 worker 内启动八个 DDP 进程。
MPI Operator0.8.2 使用 kubeflow.org/v2beta1。slotsPerWorker 声明 hostfile slots;它不会单独决定 mpirun -np、映射方式或 GPU 绑定。应准备 Launcher/Worker 代码、MPI/SSH 实现、受支持的镜像以及 CRD/RBAC。四个 workers × 八个 slots 本身并不能保证创建 32 个 GPU 进程。
Volcano1.15.2 的 minAvailable 计算的是 Pods/成员,而不是 EC2 节点。三个资源充足的节点可能足以容纳四个 Pods。gang plugin 会应用最小成员数/资源条件,但无法保证容器同时启动或训练成功。应检查额外 workers、elastic-runtime 支持以及 RestartJob/重新排队行为。
JupyterHub GPU profiles 必须与实际镜像/设备标签和授权相匹配。g5.xlarge 使用的是 A10G,而不是 A100 profile。应将配置接入正在运行的 Hub,并配置每用户存储、配额、网络和空闲回收。
训练存储和检查点
请使用 GPU/存储指南 中经过审计的 CSI 路径。通过静态 PV 挂载现有 FSx 文件系统,与通过动态预置创建新文件系统不同。不要臆造 FileSystem dataRepositoryAssociations 字段,也不要将 SCRATCH_2 与仅持久存储适用的吞吐量设置混用。应分别验证 DRA/import/export API、策略和完成状态。
EFS PVC 容量请求并不是物理存储配额。应验证访问点 UID/GID、目录权限、CSI 身份、网络和挂载目标。S3 传输完成之前,本地检查点并不具备远程持久性。
恢复需要模型、优化器、scheduler、RNG、使用时的 scaler、数据/sampler 游标以及所有分片状态。避免多个 rank 覆盖同一个文件;应使用支持框架的分布式保存方式。在删除之前有效的检查点之前,应验证完成清单/校验和、远程传输和恢复。臆造的 checkpoint-manager 镜像或 auto_resume=true ConfigMap 并不能实现这些功能。
可执行的微型 CPU 示例
此合成示例使用 16 个样本和一个 CPU 线程,执行四次优化器更新。它演示梯度累积、有界余弦调度、临时文件替换以及优化器/RNG 恢复。在 PyTorch2.14.0+cpu 上,不间断训练与两步后恢复训练得到了相同结果。这并不是 GPU、分布式或远程持久性测试。
from pathlib import Path
import math
import os
import tempfile
import torch


def lr_factor(step, warmup_steps, total_steps, min_ratio=0.1):
    if not 0 <= warmup_steps < total_steps or not 0 <= min_ratio <= 1:
        raise ValueError("Invalid schedule bounds")
    if step < 0:
        raise ValueError("Step must be non-negative")
    if step < warmup_steps:
        return step / max(1, warmup_steps)
    progress = min(1.0, (step - warmup_steps) / (total_steps - warmup_steps))
    return min_ratio + (1 - min_ratio) * (1 + math.cos(math.pi * progress)) / 2


def save_checkpoint(path, state):
    path = Path(path)
    path.parent.mkdir(parents=True, exist_ok=True)
    temporary = None
    try:
        with tempfile.NamedTemporaryFile(dir=path.parent, delete=False) as output:
            temporary = output.name
            torch.save(state, output)
            output.flush()
            os.fsync(output.fileno())
        os.replace(temporary, path)
    finally:
        if temporary is not None and os.path.exists(temporary):
            os.unlink(temporary)


def train_toy(checkpoint_path, stop_after=4, resume=False):
    # Tiny deterministic CPU example; no GPU, dataset or model download.
    torch.set_num_threads(1)
    torch.manual_seed(17)
    model = torch.nn.Linear(2, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9)
    scheduler = torch.optim.lr_scheduler.LambdaLR(
        optimizer, lambda step: lr_factor(step, 1, 4)
    )
    inputs = torch.arange(32, dtype=torch.float32).reshape(16, 2) / 32
    targets = inputs.sum(dim=1, keepdim=True)
    start = 0
    if resume:
        saved = torch.load(checkpoint_path, map_location="cpu", weights_only=True)
        model.load_state_dict(saved["model"])
        optimizer.load_state_dict(saved["optimizer"])
        scheduler.load_state_dict(saved["scheduler"])
        torch.set_rng_state(saved["torch_rng"])
        start = saved["optimizer_step"]
    if not start <= stop_after <= 4:
        raise ValueError("Invalid stopping point")
    for step in range(start, stop_after):
        optimizer.zero_grad(set_to_none=True)
        # Two equal-sized microbatches per optimizer update.
        for microbatch in range(2):
            offset = step * 4 + microbatch * 2
            prediction = model(inputs[offset:offset + 2])
            loss = torch.nn.functional.mse_loss(prediction, targets[offset:offset + 2]) / 2
            loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
        optimizer.step()
        scheduler.step()
        save_checkpoint(checkpoint_path, {
            "model": model.state_dict(),
            "optimizer": optimizer.state_dict(),
            "scheduler": scheduler.state_dict(),
            "optimizer_step": step + 1,
            "torch_rng": torch.get_rng_state(),
        })
    return {name: value.detach().clone() for name, value in model.state_dict().items()}


if __name__ == "__main__":
    path = Path("toy-training.pt")
    train_toy(path, stop_after=2)
    train_toy(path, stop_after=4, resume=True)
    print("Completed four CPU optimizer updates, including checkpoint resume.")
该示例演示的是同一文件系统上的已完成文件替换,而不是文件系统崩溃/目录元数据持久性、S3 事务或分布式检查点协议。其固定数据顺序也没有实现通用的 sampler 恢复。选择检查点间隔/保留策略时,应考虑保存延迟、故障率、可接受的工作损失和成本,而不是采用通用的 500 步/保留五份规则。
数值精度和内存优化
当前 PyTorch API 使用 torch.amp.autocast 和 torch.amp.GradScaler。BF16 与 FP32 的指数位数相同,但尾数精度和最大有限值并不相同。BF16 通常无需像 FP16 那样进行损失缩放,但仍应验证硬件、运算和收敛情况。Autocast 不会将所有权重/优化器状态都转换为 BF16。
激活检查点会在反向传播期间重新计算激活值,以计算量换取内存。它不同于磁盘检查点,也不能保证节省 3–4 倍内存或只造成 30% 的减速。应明确指定 use_reentrant,并验证梯度、dropout/RNG 和有状态层。
Flash Attention/SDPA 后端的选择取决于 dtype、head size、设备和掩码。应定义训练状态,并在评估期间传入 dropout_p=0。应检查 API 是否支持显式掩码/因果掩码组合;仅设置 use_cache=False 并不会安装 attention 后端。
DeepSpeed0.19.6 ZeRO1 会分区优化器状态;ZeRO2 还会分区梯度;ZeRO3 则还会分区参数。CPU/NVMe offload 需要单独配置,不会因使用 Stage3 而自动启用。应区分会替换 auto 值的上层集成和纯 DeepSpeed 配置。缓冲区、激活值和最大层会限制内存缩减幅度,无法无限减少内存占用。
应按优化器更新而不是累积微步来推进 scheduler。应限制进度,使余弦曲线在训练周期结束后不会再次上升,并像示例中那样验证预热步数/总步数范围。
验证范围
已审查指南/测验中的所有文本和 76 个唯一原始代码块。检查涵盖官方 Slinky Helm/CRD、MPI/Volcano API 和 SDK 源码、微型 CPU 训练/恢复以及 shell 启动器测试夹具。未运行 GPU/Neuron/EFA、Slurm/MPI 集群、实际预训练模型或云资源。本地代码/架构验证不同于生产部署验证。
参考资料
- Slinky 1.2.3
- Slurm controller
- Slurm accounting daemon
- MPI Operator 0.8.2
- Volcano 1.15.2 gang plugin
- EKS EFA 网络
- BioNeMo 3.0.0 recipes
- Optimum Neuron 0.4.5
- Neuron SDK 2.32.0
- PyTorch 2.14 启动器
- DeepSpeed 0.19.6 ZeRO 配置