第 3 部分:状态、检查点与流处理模式
最后更新:2026 年 9 月 12 日。Operator 1.15.0。Kafka 示例使用 Flink 2.2.1;Iceberg 示例使用单独的 Flink 2.1.3 组合。
状态是聚合、联接和去重所记住的数据。并非每个窗口都会保留每条输入记录:增量 SUM/COUNT 聚合可以只保存累加器。无状态处理也可能因源重放、确认或外部写入失败而丢失或重复输出。应一并验证内部状态、可重放的数据源和接收器提交保证。
1. 首先固定兼容的版本组合
| 示例 | Flink | 额外依赖 |
|---|---|---|
| Kafka sink/SQL | 2.2.1 / Java 17 | flink-connector-kafka 5.0.0-2.2、connector-base 以及必需的 SQL/运行时/格式模块 |
| 动态 Iceberg sink | 2.1.3 / Java 17 | iceberg-flink-runtime-2.1 1.11.0 |
Iceberg 1.11.0 官方发行版列出了 Flink 2.1、2.0 和 1.20 的运行时 JAR。此处并未将用于 Flink 2.1 的 JAR 作为已验证组合用于 Flink 2.2.1。下面的 Java helper 分别针对其对应版本编译;实际执行仍需要配置数据源、安全、Catalog 和存储。
2. 状态后端不同于检查点存储
| 后端 | 特征 | 需要评估的限制 |
|---|---|---|
| HashMap | 键控状态以 JVM 堆对象形式存储 | 堆、GC 和序列化成本;应针对工作负载测量 |
| EmbeddedRocksDB | 序列化的键控状态保存在本地 RocksDB;使用本机内存/缓存和磁盘 | 除磁盘外,还需要托管/本机内存、I/O 和 CPU |
| ForSt | 分离式状态,使用远程文件系统 SST 和本地缓存 | 2.2 中为实验性功能;应检查异步状态 API 和快照限制 |
RocksDB 并不意味着每个 slot 恰好对应一个实例,也不意味着所有 operator 状态/用户对象都位于堆外。键控 operator 可以各自使用不同的后端;一个 slot 内的实例可能共用托管内存预算/缓存。Operator 状态、定时器、缓冲区和用户对象也会消耗内存。
不要采用任意 MB 阈值来强制要求使用 RocksDB。应比较状态形态、序列化、GC/I/O 和检查点/恢复时间。ForSt 也支持增量快照,因此增量并非 RocksDB 独有。本实验使用 RocksDB。
增量检查点能减少什么
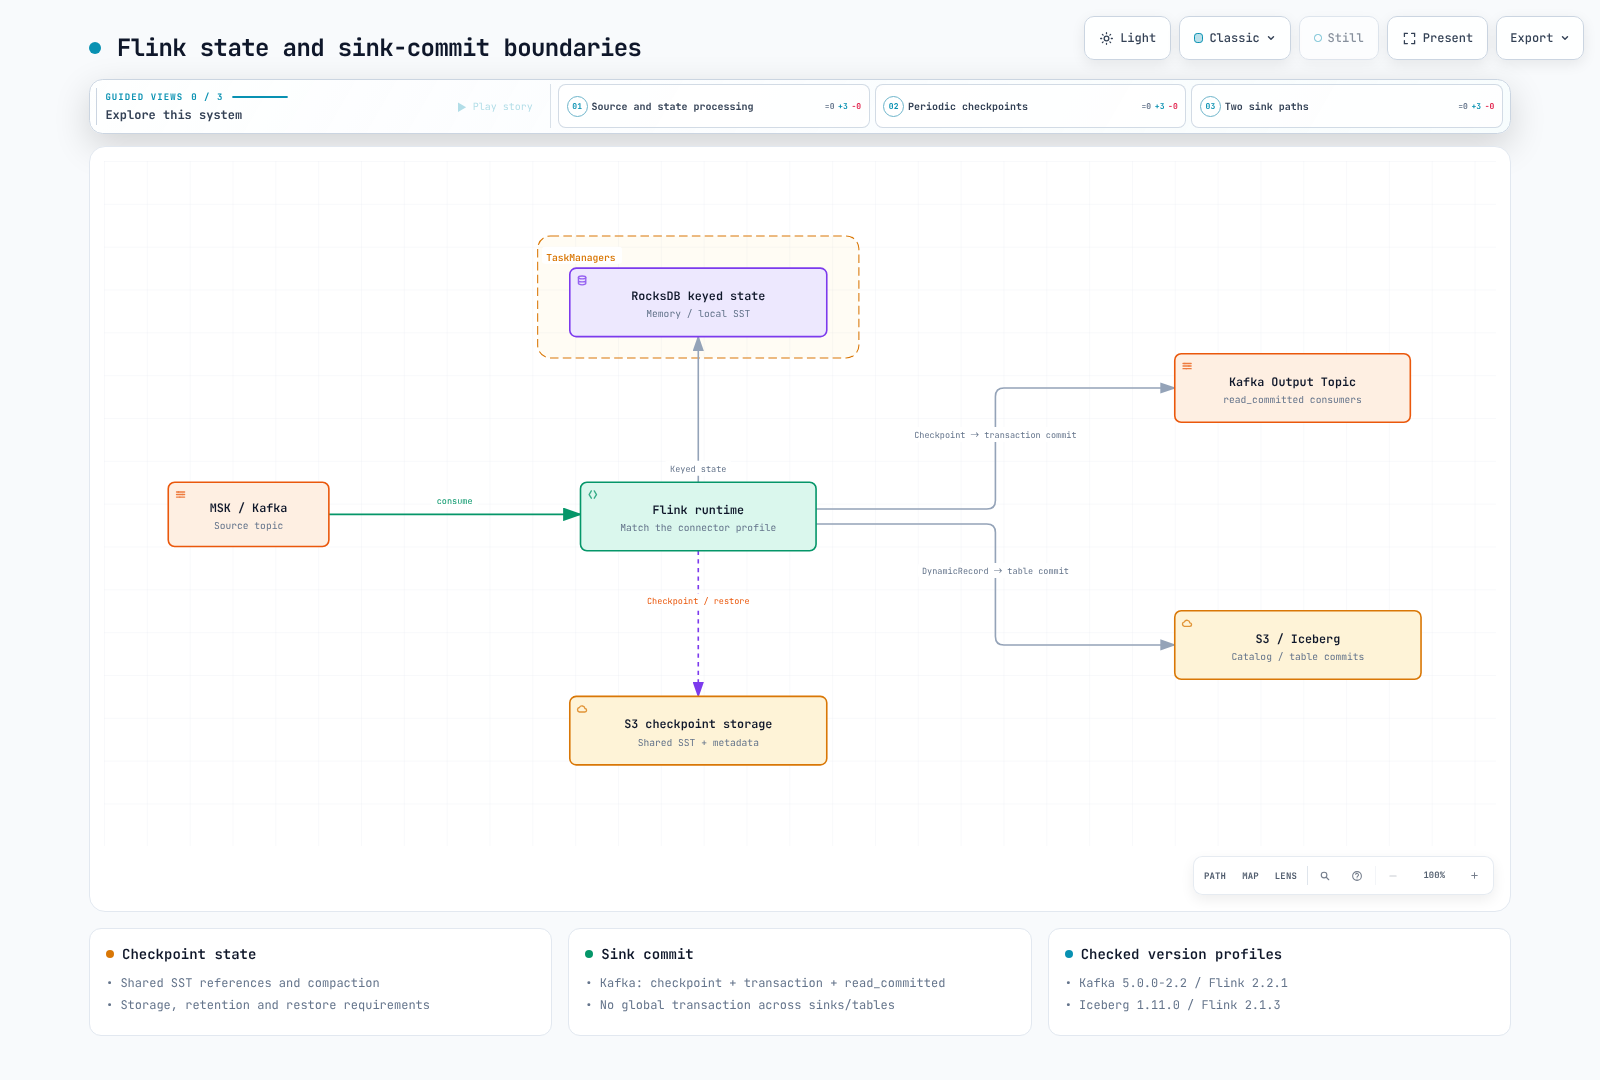
RocksDB 检查点会持久化新的 SST 文件和元数据,同时引用可重复使用的共享 SST 文件。它不会直接对逻辑键值变更做差分。即使逻辑变更很小,压缩也可能重写大型文件。
恢复时需要选定检查点引用的所有文件,而不是按顺序重放所有历史检查点。完整检查点也不一定是单个文件。原生 SST 恢复可以避免根据规范化键值状态重建 RocksDB,但传输量、文件数、网络和 I/O 可能让恢复变快,也可能变慢。不要自行过期仍被活动检查点引用的共享 S3 文件。
3. 保留 S3 状态的实际前提条件
使用第 2 部分的 Operator、数据处理命名空间以及 chart 创建的 Role/flink。准备存储桶/前缀和 IAM 角色,并替换下方的示例值。应按路径验证读取/写入/列出、清理/删除、分段上传和所需的 KMS 权限。ServiceAccount 注解既不会创建 IAM 角色,也不会配置 OIDC 信任关系。
apiVersion: v1
kind: ServiceAccount
metadata:
  name: flink-state
  namespace: data-processing
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/flink-state-checkpoints
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: flink-state
  namespace: data-processing
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: flink
subjects:
- kind: ServiceAccount
  name: flink-state
  namespace: data-processing
此 FlinkDeployment 使用 IRSA,为 JM/TM 启用 S3 插件,并用 emptyDir 保存本地 RocksDB 文件。Pod/节点丢失后可恢复的状态保存在 S3 中。fsGroup 与此镜像的 flink UID/GID 9999 相匹配。
有一项重要的版本限制:经审查的 2.2.1 S3 Hadoop 插件包含 Hadoop 3.3.4 和适用于 Java 的 AWS SDK 1.12.779。SDK 1.x 已于 2025-12-31 结束支持。此示例使用该制品实际包含的 v1 凭证类;它不是经验证的 SDK v2 配置。生产环境应评估上游文件系统支持/安全性以及兼容的运行时/连接器替代方案。不要跨 SDK 代际随意替换单个 JAR 或提供程序类名称。
apiVersion: flink.apache.org/v1beta1
kind: FlinkDeployment
metadata:
  name: flink-state-demo
  namespace: data-processing
spec:
  image: flink:2.2.1-java17
  flinkVersion: v2_2
  mode: native
  flinkConfiguration:
    taskmanager.numberOfTaskSlots: '2'
    state.backend.type: rocksdb
    state.backend.rocksdb.localdir: /opt/flink/state
    execution.checkpointing.storage: filesystem
    execution.checkpointing.dir: s3://replace-with-your-bucket/flink-state-demo/checkpoints
    execution.checkpointing.savepoint-dir: s3://replace-with-your-bucket/flink-state-demo/savepoints
    execution.checkpointing.interval: 2 s
    execution.checkpointing.mode: EXACTLY_ONCE
    execution.checkpointing.timeout: 10 min
    execution.checkpointing.min-pause: 30 s
    execution.checkpointing.incremental: 'true'
    execution.checkpointing.num-retained: '3'
    execution.checkpointing.externalized-checkpoint-retention: RETAIN_ON_CANCELLATION
    high-availability.type: org.apache.flink.kubernetes.highavailability.KubernetesHaServicesFactory
    high-availability.storageDir: s3://replace-with-your-bucket/flink-state-demo/ha
    fs.s3a.aws.credentials.provider: com.amazonaws.auth.WebIdentityTokenCredentialsProvider
  serviceAccount: flink-state
  jobManager:
    resource:
      memory: 2048m
      cpu: 1
  taskManager:
    resource:
      memory: 2048m
      cpu: 1
  job:
    jarURI: local:///opt/flink/examples/streaming/StateMachineExample.jar
    parallelism: 2
    upgradeMode: last-state
    state: running
    args:
    - --backend
    - rocksdb
    - --checkpoint-dir
    - s3://replace-with-your-bucket/flink-state-demo/checkpoints
    - --incremental-checkpoints
    - 'true'
  podTemplate:
    spec:
      securityContext:
        fsGroup: 9999
      containers:
      - name: flink-main-container
        env:
        - name: ENABLE_BUILT_IN_PLUGINS
          value: flink-s3-fs-hadoop-2.2.1.jar
        volumeMounts:
        - name: rocksdb-local
          mountPath: /opt/flink/state
      volumes:
      - name: rocksdb-local
        emptyDir: {}
StateMachineExample 在代码中显式设置了 2 秒的检查点间隔。示例配置与该设置相符。最小暂停为 30 秒,加上检查点持续时间意味着实际快照不会固定每 2 秒生成一次。应用代码可以覆盖 60 秒的配置值;应检查实际生效的运行时设置。
对于 Pod Identity,应准备 ServiceAccount 身份关联、Agent 和网络设置,而不是配置 IRSA。对这个 v1 制品,应验证类似 com.amazonaws.auth.DefaultAWSCredentialsProviderChain 的容器凭证路径。1.12.779 满足文档所述的 Pod Identity 最低版本 1.12.746,但仍是已结束支持的 SDK。还应检查较早优先级的环境变量/IRSA/其他凭证来源。
部署后应验证已完成的检查点、S3 元数据/数据文件、重启/恢复和应用结果,而不只是检查状态是否为 Running。emptyDir 不是持久备份。本次审查没有实际执行 AWS 部署或故障恢复。
4. 检查点与 Savepoint 生命周期
| 方面 | Checkpoint | Savepoint |
|---|---|---|
| 典型用途 | 用于故障恢复的状态/数据源位置 | 有意创建的恢复、升级或分叉点 |
| 触发方式 | 定期触发或显式请求 | 用户/Operator 请求;自动化也可以定期创建 |
| 保留方式 | 数量、外部化保留和作业终止策略 | 用户/Operator 策略及恢复所有权 |
| 格式/存储 | JobManager 或文件系统存储,以及其他选项 | 规范/原生格式和可访问的存储 |
Savepoint 不会自动永久保留,Checkpoint 也不总是在 S3 中。规范格式的目标是支持后端可移植性;原生格式则特定于后端。应验证状态 schema、UID、序列化器、最大并行度和版本兼容性。
CLAIM/NO_CLAIM 恢复模式会影响快照所有权和删除责任。从 NO_CLAIM 恢复后,第一个 RocksDB 检查点可能是完整检查点,以建立独立状态。在恢复仍依赖某个快照时,不要删除它。Operator 的 last-state 恢复可能使用可访问的 HA 元数据或最后一个检查点/Savepoint;它并不总是单个最新的检查点文件。
使用唯一 CR 请求新的 Savepoint
generateName 会在创建时分配新名称,避免复用已完成的资源而误把旧快照当作新操作成功的结果。
apiVersion: flink.apache.org/v1beta1
kind: FlinkStateSnapshot
metadata:
  generateName: flink-state-before-upgrade-
  namespace: data-processing
spec:
  jobReference:
    kind: FlinkDeployment
    name: flink-state-demo
  savepoint:
    formatType: CANONICAL
disposeOnDelete: falsekubectl create -f savepoint.yaml
kubectl get flinkstatesnapshots -n data-processing --watch检查新 CR 的 status.state=COMPLETED 和 status.path。如果结果为 FAILED 或 ABANDONED,应调查错误/作业状态。disposeOnDelete=false 是此示例的保留选择;默认值为 true,且它与 Operator 清理策略不同。应记录由谁负责删除保留文件。
5. Kafka exactly-once 需要检查点、事务和消费者配合
KafkaSink 的 EXACTLY_ONCE 会将 Kafka 事务提交与检查点完成协调起来。它需要可重放的数据源、可恢复状态和正确的 sink 配置;下游消费者必须使用 read_committed。 它不会在所有子任务、分区和其他 sink 系统之间创建一个全局原子事务。 Kafka 事务可以跨多个 topic/partition;多个 sink 子任务各自拥有的独立事务,并不合并为整个 Flink 检查点的一笔事务。
此 helper 使用 Kafka connector 5.0.0-2.2 和 Flink 2.2.1 编译。 调用方需提供输入流、实际 bootstrap server、TLS/SASL producer 设置和超时,并执行应用。它不是 Kafka 集群安装指南。
import java.util.Properties;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.connector.base.DeliveryGuarantee;
import org.apache.flink.connector.kafka.sink.KafkaRecordSerializationSchema;
import org.apache.flink.connector.kafka.sink.KafkaSink;
import org.apache.flink.streaming.api.datastream.DataStream;

public final class KafkaExample {
    private KafkaExample() {}

    public static void attach(
            DataStream<String> input,
            String bootstrapServers,
            String transactionalIdPrefix,
            int transactionTimeoutMs,
            Properties securityProperties) {
        if (transactionTimeoutMs <= 0 || transactionalIdPrefix.isBlank()) {
            throw new IllegalArgumentException("Positive timeout and a unique stable prefix are required");
        }
        Properties producer = new Properties();
        producer.putAll(securityProperties);
        producer.setProperty("transaction.timeout.ms", Integer.toString(transactionTimeoutMs));
        input.getExecutionEnvironment().enableCheckpointing(60_000);

        KafkaSink<String> sink = KafkaSink.<String>builder()
                .setBootstrapServers(bootstrapServers)
                .setKafkaProducerConfig(producer)
                .setRecordSerializer(KafkaRecordSerializationSchema.<String>builder()
                        .setTopic("orders-enriched")
                        .setValueSerializationSchema(new SimpleStringSchema())
                        .build())
                .setDeliveryGuarantee(DeliveryGuarantee.EXACTLY_ONCE)
                .setTransactionalIdPrefix(transactionalIdPrefix)
                .build();
        input.sinkTo(sink).name("orders-enriched").uid("orders-enriched-sink");
    }
}
transactionalIdPrefix 在同一 Kafka 集群上运行的不同并发 sink/作业之间必须唯一,并且重启时保持稳定。更改该值可能导致旧事务未中止,并在事务超时之前阻止 read_committed 消费进度。跨蓝绿发布盲目共用此前缀可能引发 fencing/冲突。
5.0.0 builder 将事务超时默认为一小时。应与 broker 允许的最大值匹配,并为最坏情况下的检查点/重启/恢复留足时间。事务过期后,配置标签并不能恢复 exactly-once 保证。
检查点间隔为 60 秒,并不表示新增延迟上限是 60 秒。等待、检查点持续时间、提交、故障/重试以及消费者延迟都会增加等待时间。间隔过短会增加提交/元数据负载。默认 INCREMENTING 命名会创建新的 ID;可选的 POOLING 会重用 ID,并要求 Kafka 3+、额外的 topic 读取权限和有记录的迁移流程。并非所有配置都会无限创建新的事务 ID。
6. 动态 Iceberg sink:真实 API 与单独的运行时
此 helper 面向 Iceberg 1.11.0 / Flink 2.1.3。 输入 RowData 字段为 target_table STRING、id BIGINT 和 value STRING;它是仅插入模式。调用方需提供配置好 Catalog、warehouse 和身份验证的 CatalogLoader。目标表名称应限制为受信任/获准的值。
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.table.data.GenericRowData;
import org.apache.flink.table.data.RowData;
import org.apache.iceberg.DistributionMode;
import org.apache.iceberg.PartitionSpec;
import org.apache.iceberg.Schema;
import org.apache.iceberg.catalog.TableIdentifier;
import org.apache.iceberg.flink.CatalogLoader;
import org.apache.iceberg.flink.sink.dynamic.DynamicIcebergSink;
import org.apache.iceberg.flink.sink.dynamic.DynamicRecord;
import org.apache.iceberg.types.Types;

public final class IcebergExample {
    private IcebergExample() {}
    private static final Schema PAYLOAD_SCHEMA = new Schema(
            Types.NestedField.required(1, "id", Types.LongType.get()),
            Types.NestedField.optional(2, "value", Types.StringType.get()));

    // Insert-only input RowData: target_table STRING, id BIGINT, value STRING.
    // The caller supplies an authenticated, authorized CatalogLoader.
    public static void attach(DataStream<RowData> input, CatalogLoader catalogLoader) {
        input.getExecutionEnvironment().enableCheckpointing(60_000);
        DynamicIcebergSink.forInput(input)
                .generator((row, out) -> {
                    TableIdentifier target = TableIdentifier.of("docs", row.getString(0).toString());
                    GenericRowData payload = GenericRowData.of(
                            row.getLong(1), row.isNullAt(2) ? null : row.getString(2));
                    out.collect(new DynamicRecord(
                            target, "main", PAYLOAD_SCHEMA, payload,
                            PartitionSpec.unpartitioned(), DistributionMode.HASH, 2));
                })
                .catalogLoader(catalogLoader)
                .uidPrefix("docs-dynamic-iceberg")
                .writeParallelism(2)
                .append();
    }
}
实际 API 的调用流程是 forInput → generator → catalogLoader → append。 Generator 会通过 Collector 发出零条或多条记录,而不是返回单条记录。旧版 forRecords/withTableIdentifierSelector/withSchemaEvolutionEnabled 示例在该发行版中并不存在。
每个 DynamicRecord 都提供一个目标、schema、RowData 和分区规范。Schema 演进会遵循受支持的变更和配置;它不会自动解决任意重命名/类型变更。CDC 更新/删除需要验证 RowKind、相等字段、upsert 和表格式。不要将这个仅插入 helper 用作完整 CDC 处理器。多个表提交以及同时写入 Kafka/Iceberg 并非全局原子提交。
对于较简单的数据导入,可以考虑 MSK → Firehose → S3 Tables/Iceberg,或使用 MSK Connect sink。应检查受支持的数据源/网络、身份验证、Catalog/表格式、行操作/键、缓冲和故障处理。例如,Firehose Iceberg 文档要求使用 V2/Parquet/MOR。托管基础设施并不能免除验证配置、schema 和交付语义的责任。
7. SQL、时间属性与迟到数据
SQL/Table API 用于描述关系变换/聚合;DataStream 用于定义自定义状态、定时器和 operator 逻辑。SQL 也支持高级功能;DataStream 并不允许任意绕过检查点屏障/背压。应检查 2.x 公共 API 以及 connector/format JAR。Kafka/Iceberg/JDBC 并非总是全部捆绑,历史 Scala API 也并非都仍受支持。
此规划示例包含表定义和 watermark。 执行前,应将 broker/安全设置以及 JSON 字段/时间编码与实际数据源相匹配。
-- Schema/planning example. Supply real broker/authentication settings before execution.
CREATE TEMPORARY TABLE orders (
  customer_id STRING,
  amount DECIMAL(12,2),
  event_time TIMESTAMP(3),
  WATERMARK FOR event_time AS event_time - INTERVAL '5' SECOND
) WITH (
  'connector' = 'kafka',
  'topic' = 'orders',
  'properties.bootstrap.servers' = 'kafka.example.invalid:9093',
  'properties.group.id' = 'docs-orders',
  'scan.startup.mode' = 'earliest-offset',
  'format' = 'json'
);

SELECT window_start, window_end, customer_id, SUM(amount) AS total_amount
FROM TABLE(TUMBLE(TABLE orders, DESCRIPTOR(event_time), INTERVAL '1' MINUTE))
GROUP BY window_start, window_end, customer_id;
Flink 2.2.1 planner 接受此查询,并拒绝缺少 watermark/时间属性的普通 TIMESTAMP 列。这只是规划阶段的验证,并非读取 Kafka 或执行窗口并检查结果。
Watermark 是对事件时间进度的估计;它不能保证不会再收到更早的事件。并非每条记录都会自动包含事件时间戳。应配置时间戳提取、watermark 策略和输入空闲检测。缓慢/空闲的输入可能会阻碍进度,恢复后的输入则可能产生迟到数据。
- Tumbling:固定大小、互不重叠的窗口。
- Sliding:固定大小并设置滑动间隔;滑动间隔越小,重叠越多。
- Session:根据事件时间间隔和 watermark 进度划分,不只是一个墙上时钟空闲计时器。
当 DataStream 设置 allowedLateness>0 时,保留的窗口状态可以接受迟到记录并触发更新结果。清理状态后,迟到记录会被丢弃,或被发送到显式配置的 late-data side output。单独设置 allowedLateness 并不会创建此输出。不要将此 DataStream 选项的行为泛化到 SQL 窗口。
验证范围
两个依赖不同运行时的 Java helper 都以 release 17 为目标完成编译。检查包括有效/缺少 watermark 的 SQL 规划、S3 插件归档中的 v1 凭证类、CRD/YAML 结构以及已发布源码。本地 Java 工具使用 Corretto 21;未在 Java 17 集群执行,也未测试 AWS/Kafka/Iceberg 连接、CDC 或故障恢复。