第 4 部分:运维、高可用与托管 Flink
最后更新:2026 年 9 月 12 日。自管理示例使用 Flink 2.2.1 / Operator 1.15.0;托管服务比较依据 AWS 的 Flink 2.3 文档。
将可观测性和 HA 与第 3 部分的有状态部署关联起来,然后验证故障、恢复和容量。Karpenter 并非必选项;应检查实际使用的节点容量管理模型。示例假设安装了 Prometheus Operator,且 Prometheus 配置会选择这些监视器。
1. 协同配置 reporter、Pod 端口和 PodMonitor
仅配置 reporter 并不足以完成 Prometheus 数据采集。 JAR、监听端口、命名容器端口、选择器 / 命名空间以及 Prometheus 自身的 PodMonitor 选择器都必须匹配。
以下内容是应合并到第 3 部分完整 CR spec 中的字段。 启用 Prometheus 插件时,仍会保留 S3 插件 / 卷配置。不同 Pod 通常有各自的 IP,因此 JM / TM 可以使用相同的 9249 端口。在使用 host networking 或在同一 Pod 中运行多个 reporter 时,需要单独处理端口冲突和服务发现。
flinkConfiguration:
  metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory
  metrics.reporter.prom.port: '9249'
  state.backend.rocksdb.metrics.block-cache-usage: 'true'
  state.backend.rocksdb.metrics.block-cache-capacity: 'true'
  state.backend.rocksdb.metrics.num-running-compactions: 'true'
  state.backend.rocksdb.metrics.compaction-pending: 'true'
podTemplate:
  spec:
    securityContext:
      fsGroup: 9999
    containers:
    - name: flink-main-container
      env:
      - name: ENABLE_BUILT_IN_PLUGINS
        value: flink-s3-fs-hadoop-2.2.1.jar;flink-metrics-prometheus-2.2.1.jar
      volumeMounts:
      - name: rocksdb-local
        mountPath: /opt/flink/state
      ports:
      - name: flink-metrics
        containerPort: 9249
        protocol: TCP
    volumes:
    - name: rocksdb-local
      emptyDir: {}
  metadata:
    labels:
metrics-group: flink-state-demoapiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
name: flink-state-metrics
namespace: monitoring
labels:
release: monitoring
spec:
selector:
matchLabels:
metrics-group: flink-state-demo
namespaceSelector:
matchNames:
- data-processing
podMetricsEndpoints:
- port: flink-metrics
path: /metrics
interval: 30s此 PodMonitor 位于 monitoring 命名空间,并选择 data-processing 中的工作负载。metadata.labels.release=monitoring 只是一个示例:必须与实际的 Prometheus podMonitorSelector 和 podMonitorNamespaceSelector 匹配。PodMonitor 自身的 namespaceSelector 会另外选择目标 Pod 的命名空间。
确认 Pod 确实带有 metrics-group 标签和名为 flink-metrics 的端口。假设存在 app.kubernetes.io/managed-by 标签或未声明端口名,可能导致没有监控目标。还应检查 Prometheus target 健康状态、实际 /metrics 响应、网络策略和服务发现 RBAC。
Operator 自身的指标需要单独配置
添加 Dropwizard reporter 并不会启用 Prometheus HTTP endpoint。Operator 镜像提供 reporter 插件,但 chart 默认选择 Slf4j,并且不设置 metrics.port。此示例会在第 2 部分的 values 基础上,补充 Prometheus 配置和命名端口。
watchNamespaces:
- data-processing
image:
  repository: ghcr.io/apache/flink-kubernetes-operator
  tag: 1.15.0
  digest: sha256:5372e4461b433ee37391b0ee3fc3e4029980d14e9b64576b0cb78493d1cafe3a
webhook:
  create: true
metrics:
  port: 9249
defaultConfiguration:
  flink-conf.yaml: 'kubernetes.operator.metrics.reporter.prom.factory.class: org.apache.flink.metrics.prometheus.PrometheusReporterFactory

    kubernetes.operator.metrics.reporter.prom.port: 9249

'apiVersion: monitoring.coreos.com/v1
kind: PodMonitor
metadata:
name: flink-operator-metrics
namespace: monitoring
labels:
release: monitoring
spec:
selector:
matchLabels:
app.kubernetes.io/name: flink-kubernetes-operator
namespaceSelector:
matchNames:
- flink-operator
podMetricsEndpoints:
- port: metrics
path: /metrics
interval: 30s此 chart 中实际的 Operator Pod 带有 app.kubernetes.io/name,但默认没有 app.kubernetes.io/instance 标签。Deployment 元数据标签不会自动成为 Pod 标签。更改 values 后应重新检查已渲染的 Pod 和监控目标。 本次审查验证了两个 monitor 的 selector / 端口相互匹配,但没有进行实时 Prometheus 数据采集。
RocksDB 指标单位和成本
block-cache-usage 和 block-cache-capacity 的单位都是字节;usage 本身不是比率。比较时要处理容量为零 / 缺失的情况。缓存已满本身并不能证明发生故障:应检查命中 / 未命中行为、读取延迟、I/O 和压缩。num-running-compactions 是计数;compaction-pending 是状态信号。应有选择地启用指标,并考虑 column family / subtask 序列和开销。
此 Prometheus reporter 会将 Flink Counter 映射为 Gauge,并将 Histogram 映射为 Summary。选择 counter / histogram 查询之前,应检查导出的 TYPE、名称和标签。在仪表板中关联 checkpoint 成功 / 失败 / 恢复时间、吞吐量 / 延迟 / 背压、JVM / native 内存 / GC / 磁盘以及 Pod 调度健康状态。
2. Managed memory 和网络内存是独立区域
TaskManager 内存模型比四个不加区分的内存区域更详细。
| 区域 | 示例 |
|---|---|
| Framework heap / task heap | 框架结构、用户对象和堆上状态 |
| Framework off-heap / task off-heap | 框架和用户的直接 / native 内存分配 |
| Managed memory | 供 RocksDB、sort / hash operator 和 Python UDF 使用的预算 |
| Network memory | 独立的 shuffle / 网络缓冲预算 |
| JVM metaspace | 类元数据 |
| JVM overhead | 线程栈、代码缓存及其他 JVM 开销 |
RocksDB 和网络缓冲区并不直接共用同一个 managed-memory pool,但仍受整体进程内存预算限制。显式指定 managed 大小时会覆盖其比例设置;应避免总量 / 组件设置互相矛盾,并考虑各消费者的权重。
以下结果来自实际的 Flink 2.2.1 计算:总进程内存为 4GiB,其他设置均为默认值。这些是配置预算,不是实测 RSS。
| Managed 比例 | JVM heap(MiB) | Managed(MiB) | Network(MiB) |
|---|---|---|---|
| 0.4 | 1587.20 | 1372.16 | 343.04 |
| 0.5 | 1244.16 | 1715.20 | 343.04 |
在此示例中,增大 managed 比例不会改变网络内存,却会减少 task heap。其他配置组合可能表现不同。应检查 Pod requests / limits、sidecar、native 分配 / 页缓存以及 RSS / GC 峰值。process.size 不能保证覆盖所有 Pod 内存使用方。
3. Kubernetes HA:协调和持久状态
Kubernetes HA 无需自行运维外部 ZooKeeper 集群;ZooKeeper HA 仍是受支持的替代方案。经审查的 Flink 实现使用 ConfigMapLock(Fabric8),而不是单独的 Kubernetes leader-election server / API,也不一定使用 Lease 对象。Kubernetes control plane 可用是前提条件。
| 位置 | 作用 |
|---|---|
| ConfigMaps | Leader 信息和恢复状态句柄 / 引用 |
| high-availability.storageDir | JM 恢复所需的持久元数据 / job graph 文件 |
| execution.checkpointing.dir | 实际 checkpoint 状态的存储位置 |
第 3 部分介绍的插件、凭证和存储前提仍然适用。设置 HA 目录并不意味着所有 checkpoint 数据文件都会写入此处。以下字段可以合并到 Operator 管理的 CR 中:
# Merge into the existing FlinkDeployment spec.
jobManager:
  replicas: 2
flinkConfiguration:
  high-availability.type: org.apache.flink.kubernetes.highavailability.KubernetesHaServicesFactory
  high-availability.storageDir: s3://replace-with-your-bucket/flink-state-demo/ha
不要在 Operator CR 中设置 kubernetes.cluster-id、kubernetes.namespace 或 high-availability.cluster-id。1.15 validator 会禁止这些设置;Operator 根据 CR 的名称 / 命名空间管理身份。这与低层级 Flink CLI 指南不同。
JM service account 需要 ConfigMap 协调权限。Native 资源管理还需要 Pod / Service 权限。仅供 HA 使用的 ConfigMap Role 无法提供 Native 部署所需的全部权限。故障可能会显示为 API 错误、日志和重启;并非总是静默失败且 Pod 健康。
两个 JM 副本可以缩短启动延迟,但不能保证即时且无中断的故障转移。应测试节点 / AZ 放置、选举超时、存储访问、恢复 / 重放时间以及外部写入重复情况。不要随意删除 HA ConfigMap / 文件,也不要将删除 Operator CR 等同于删除其子 Deployment。
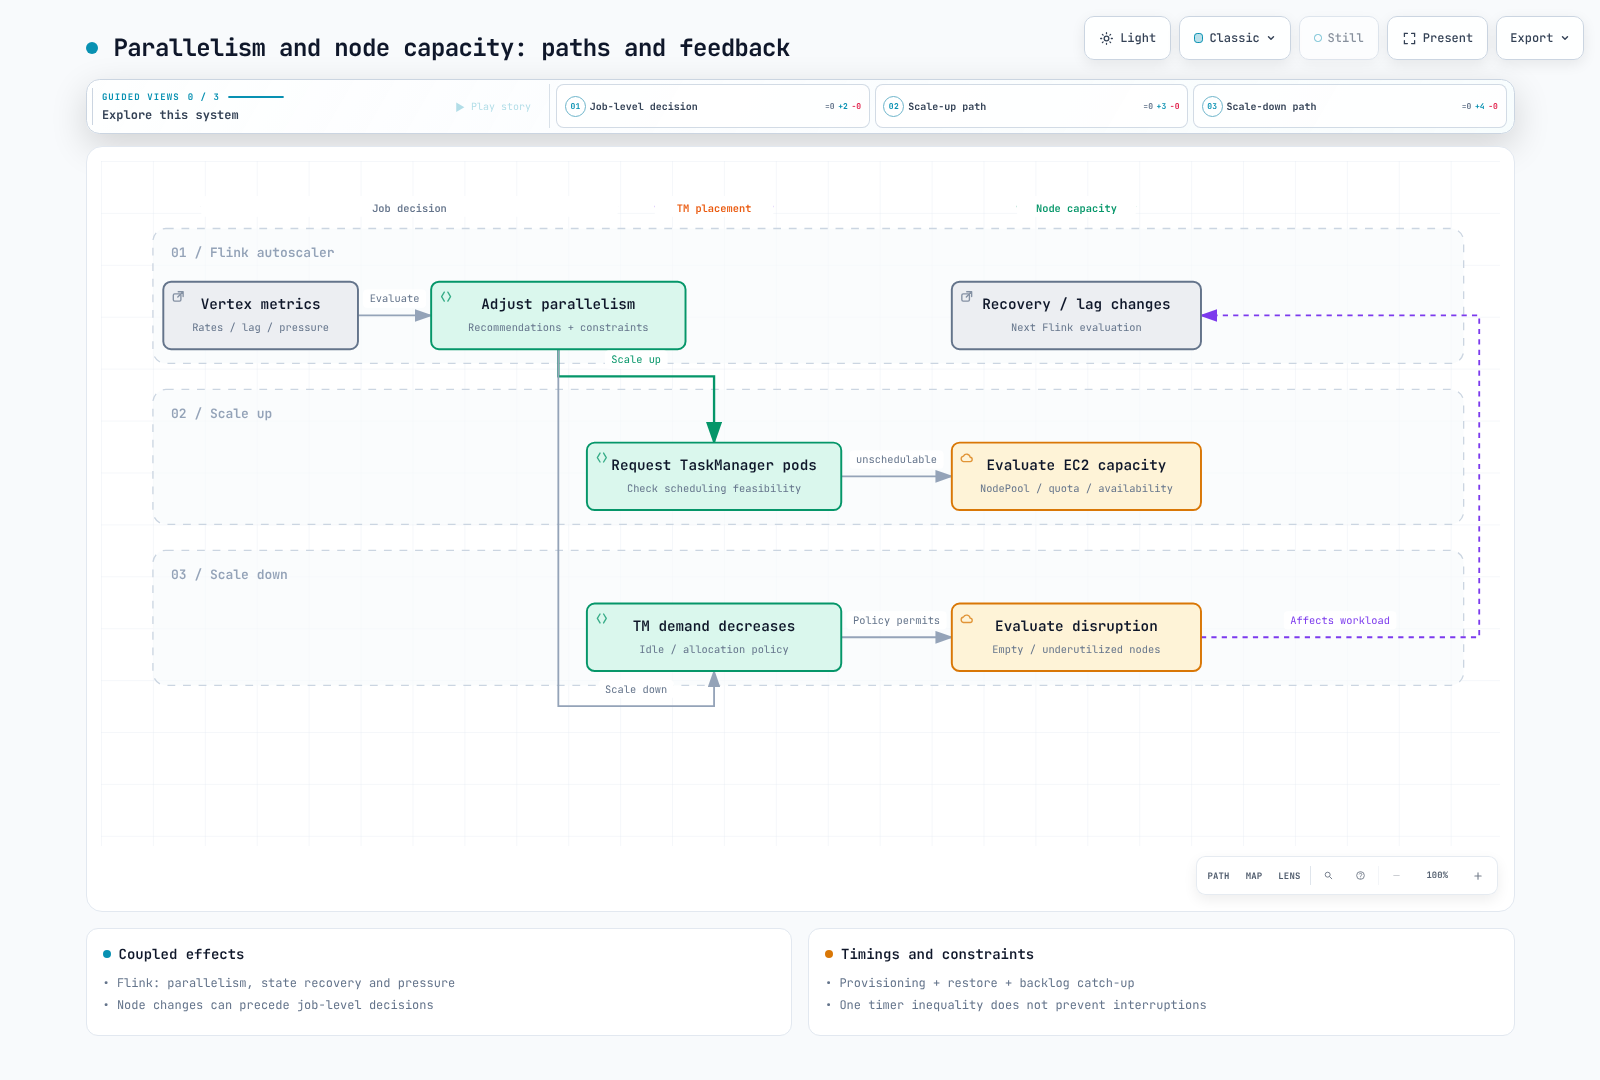
4. 自动扩缩与节点容量相互影响
Flink autoscaler 主要调整顶点并行度;节点 autoscaler 调整可调度容量。第 2 部分关于压力 / 配额和有状态 / 原位扩缩的限制仍然适用。不存在 Flink 总是先扩缩、Karpenter 只跟随的通用固定顺序。节点故障、Spot 回收、漂移或整合都可能首先改变作业恢复和延迟情况。
并非每个 Pending Pod 都意味着需要添加节点。应区分调度失败与镜像拉取、PVC、准入和其他问题。NodePool 要求 / taint、资源请求、可用实例、配额、PDB 和中断策略也会产生影响。整合过程可能会针对符合条件的低利用率节点,而不仅仅是空节点。
即使整合延迟长于 Flink stabilization 时间,也不保证容量一定保留或执行不中断。应测量容量预置、状态恢复和积压追赶情况;并共同调优备用容量、重试 / checkpoint 目标和中断策略。
5. 与 Amazon Managed Service for Apache Flink 比较
AWS 现在记录支持 Flink 2.3.0,建议使用 Java 17 和 Python 3.12。应区分服务支持与自管理运行时 / connector 示例。2.3 服务文档列出 Java 21、ForSt、Native S3 filesystem、自定义 telemetry / reporter、Materialized Table 和 Studio 的限制。不要原样移植自管理 Prometheus 设置或实验性功能。
| 方面 | 托管服务 | EKS + Operator |
|---|---|---|
| 基础设施 | AWS 管理服务基础设施以及主机 / AZ 恢复 | 运维节点、Operator、HA 和升级 |
| 用户职责 | 应用、IAM / 网络、connector / 状态、容量选择和恢复验证 | 同样的应用职责,另外还包括 Kubernetes 运维 |
| 扩缩 | 默认根据 CPU 调整应用并行度;应检查配置、限制和自定义扩缩 | 协调顶点扩缩、节点容量和中断 |
| 可观测性 | 使用受支持的 CloudWatch / telemetry 路径 | 配置 reporter、Prometheus 和其他采集 |
| 成本 | 应用 KPU、存储、编排和相关服务 | EC2 / EBS / control plane、存储 / 网络、可观测性和工程投入 |
托管 HA / 迁移并不会自动修复应用错误或不兼容的状态 / connector。应验证 checkpoint / snapshot 和恢复。该服务的韧性文档描述了内部基于 ZooKeeper 的多 AZ HA;客户无需自行管理该集群或内部 EKS 集群。
默认自动扩缩根据 CPU 调整应用并行度,这与上游的逐顶点 autoscaling 不同。应检查 Parallelism、ParallelismPerKPU、AutoScalingEnabled 和配额。扩缩 / 重启可能暂停处理,并需要追回积压。
一个 KPU 提供一个 vCPU、4GB 内存和运行存储。文档还列出额外的编排 KPU 费用。不要只比较单个运行中 KPU 的价格。同样,评估 Spot 成本节省时,也要考虑中断 / 恢复成本。应在相同吞吐量、延迟和恢复目标下进行比较;更改默认值本身不是目标。
6. 运维验收
- [ ] 记录运行时 / connector / 状态格式兼容性,以及选择 Application / Session 的原因。
- [ ] 验证实际 Prometheus target / CloudWatch 指标、服务 / task 日志和告警送达情况。
- [ ] 在峰值负载下测量 heap / managed / network / native 内存、磁盘和 GC。
- [ ] 测试 HA 协调、checkpoint 存储、凭证、恢复和外部写入结果。
- [ ] 测量节点 / AZ 故障、容量延迟、Spot / 中断以及积压追赶时间。
- [ ] 记录升级 / 回滚、snapshot 保留 / 删除、成本和响应职责。
只要满足要求,保留默认值也是合理选择。应接受实测结果和仍然存在的限制,不要把勾选项当作生产保证。
验证范围
已检查 Flink 2.2.1 的两种原生内存计算、工作负载 / PodMonitor CRD、Operator Helm 渲染结果以及 selector / 命名端口匹配情况。未进行实时 Prometheus 抓取、集群部署、HA 故障转移、托管应用运行或成本测量。