第 1 部分:Kubernetes 上的 Spark 基础
审查基线:Spark 4.2.0、Kubernetes 1.34+;示例镜像使用 Java 21
最后审查:2026 年 9 月 12 日
Cluster 模式和 Client 模式
Kubernetes 支持 Spark 的两种部署模式。Spark 2.4 起便支持 Client 模式,它并非只适用于 notebook。
| 模式 | Driver 位置 | 运维影响 |
|---|---|---|
| Cluster | 为本次提交创建的 driver Pod | 提交方需要 API 访问权限;driver 需要自己的 service account / RBAC |
| Client | 提交应用所在的 Pod 或主机 | Executor 必须能访问 driver 通告的 RPC / block-manager 端点;driver 必须保持运行 |
能够访问 Kubernetes API 并不足以证明 executor 能连上 driver。Client 模式的网络可能需要稳定的 Service / 主机名和固定端口。如果 driver 位于 Pod 中,应配置实际的 driver Pod 名称用于 executor owner-reference 垃圾回收;若 driver 运行在 Kubernetes 之外,不要虚构 Pod 所有者。
谁负责调度什么?
API Server 负责身份验证和准入并存储 API 对象;Kubernetes scheduler 负责放置 Pod,节点上的 kubelet 负责启动容器。Spark driver 会请求 executor Pod,而 Spark 自身的 scheduler 会协调已注册 executor 上的 stage / task。这些属于不同的层次。
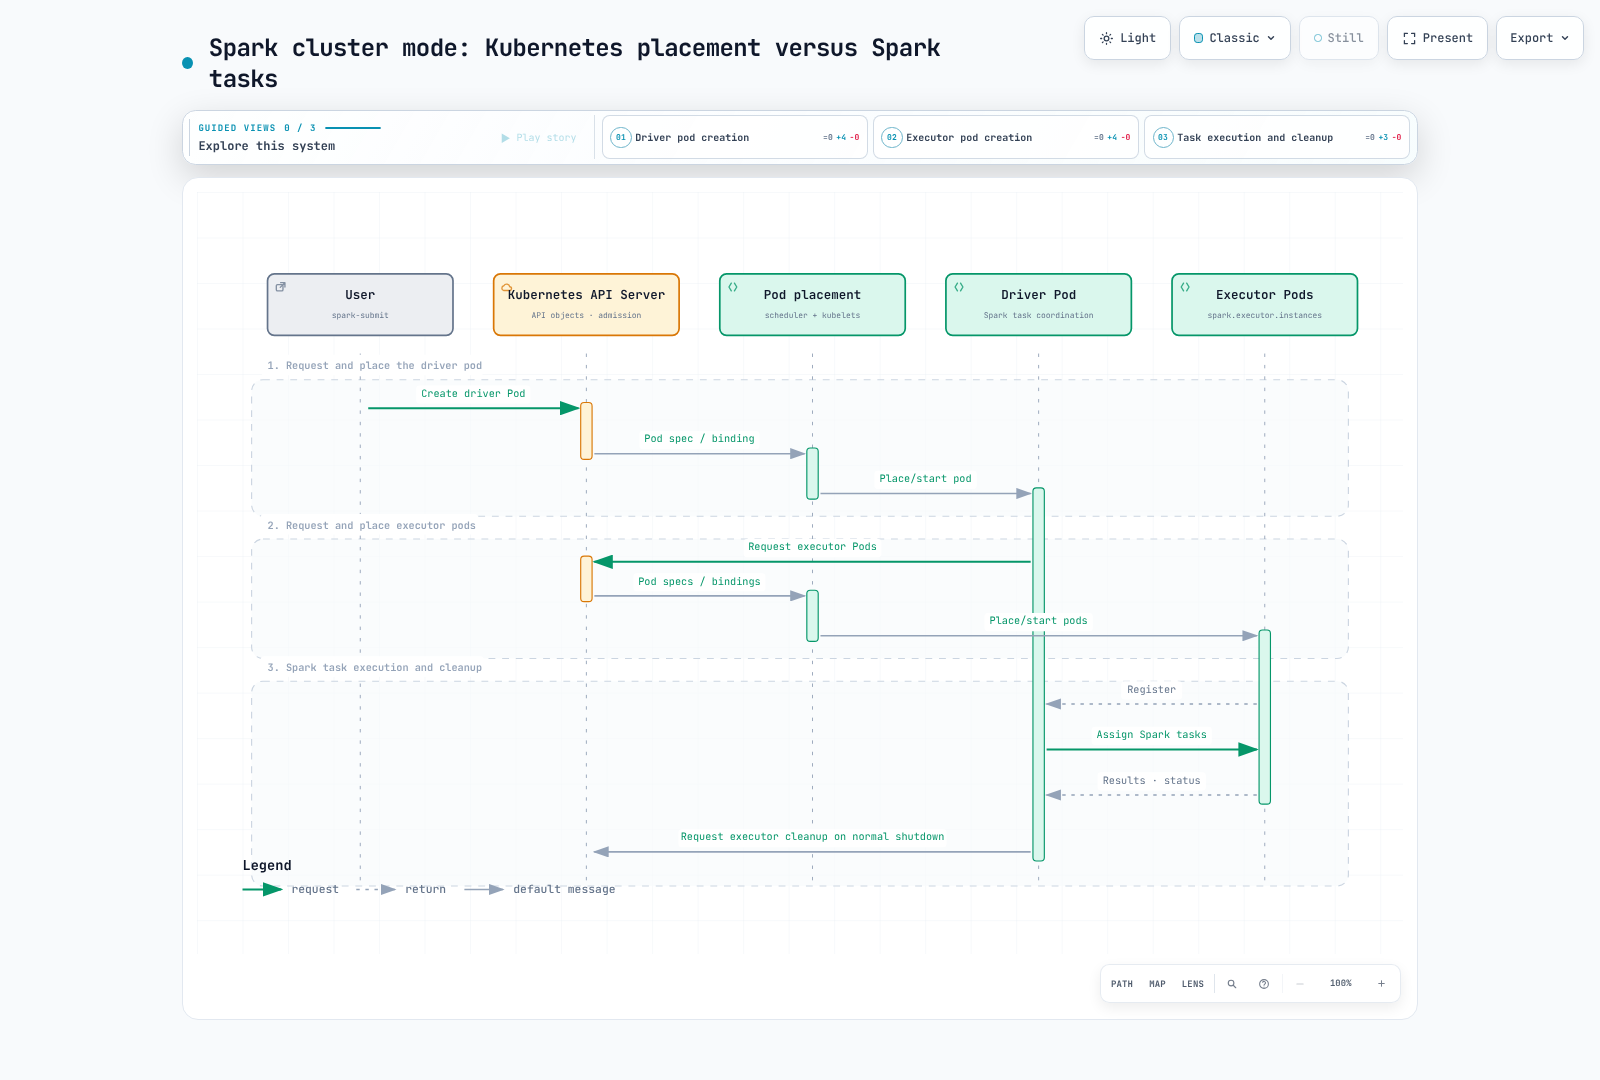
- 提交方请求创建 driver Pod 和相关资源。
- Kubernetes 放置并启动 driver;driver 请求创建 executor Pod。
- Kubernetes 放置 / 启动 executor;executor 向 driver 注册。
- Driver 分配 Spark task;executor 执行并报告结果 / 状态。
- 正常关闭时,Spark 会按配置清理 executor。已完成 / 失败的 driver Pod 可能仍保留用于查看日志;需要考虑失败和 owner-reference 行为,不能假设所有资源都会立即清理。
这避免了单独部署 YARN 或 Spark Standalone 控制层,但并不免除 Kubernetes 容量、节点、存储、网络或镜像运维。
Cluster 模式的具体示例
前提条件:本地安装 Spark 4.2.0、兼容的 kubectl / 当前 kubeconfig context、Kubernetes 1.34+、命名空间容量和镜像访问权限。提交方的 API 凭证与集群内 driver 的 RBAC 相互独立。SparkPi 示例不需要 AWS 数据权限;访问 S3 的工作负载还需要选择合适的工作负载身份以及兼容的 Hadoop / AWS 库。
由命名空间管理员审查 / 应用 rbac.yaml:
apiVersion: v1
kind: Namespace
metadata:
  name: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-driver
  namespace: spark-jobs
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: spark-executor
  namespace: spark-jobs
automountServiceAccountToken: false
---
apiVersion: rbac.authorization.k8s.io/v1
kind: Role
metadata:
  name: spark-driver
  namespace: spark-jobs
rules:
- apiGroups:
  - ''
  resources:
  - pods
  - services
  - configmaps
  verbs:
  - create
  - get
  - list
  - watch
  - delete
  - patch
---
apiVersion: rbac.authorization.k8s.io/v1
kind: RoleBinding
metadata:
  name: spark-driver
  namespace: spark-jobs
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: Role
  name: spark-driver
subjects:
- kind: ServiceAccount
  name: spark-driver
  namespace: spark-jobs
此角色可支持基础示例,不含动态创建 PVC 的功能。其他卷 / 资源管理功能可能需要相应的范围受限权限。Executor Pod 使用单独的 service account,并禁用 API token 自动挂载。只有可信的作业代码 / 提交方才应使用 driver 可以创建 Pod 的命名空间;RBAC 本身不是不可信应用代码的沙箱。
将以下文件保存为 Pod template,不要把它们当作独立 Pod 通过 kubectl apply 部署。Spark 会填充镜像、命令和其他字段:
Driver template,driver-template.yaml:
apiVersion: v1
kind: Pod
metadata:
  name: spark-driver-template
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    runAsGroup: 185
    seccompProfile:
      type: RuntimeDefault
  containers:
  - name: spark-kubernetes-driver
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
Executor template,executor-template.yaml:
apiVersion: v1
kind: Pod
metadata:
  name: spark-executor-template
spec:
  securityContext:
    runAsNonRoot: true
    runAsUser: 185
    runAsGroup: 185
    seccompProfile:
      type: RuntimeDefault
  containers:
  - name: spark-kubernetes-executor
    securityContext:
      allowPrivilegeEscalation: false
      capabilities:
        drop:
        - ALL
  automountServiceAccountToken: false
  terminationGracePeriodSeconds: 60
提交进程必须能访问这些文件。在 Cluster 模式中,Spark 会将 executor template 挂载到 driver 中。Spark 会覆盖部分模板字段,因此结合模板、Operator webhook 和 Spark 设置使用时,应检查生成的 Pod。
#!/bin/bash
set -euo pipefail
# Run in the directory containing driver-template.yaml and executor-template.yaml.
KUBE_CONTEXT="$(kubectl config current-context)"
KUBE_API_URL="$(kubectl --context "$KUBE_CONTEXT" config view --minify -o jsonpath='{.clusters[0].cluster.server}')"
case "$KUBE_API_URL" in https://*) ;; *) echo "Expected an HTTPS Kubernetes API URL" >&2; exit 1;; esac
SPARK_APP_NAME="spark-pi-$(date -u +%Y%m%d%H%M%S)"
spark-submit \
  --master "k8s://${KUBE_API_URL}" \
  --deploy-mode cluster \
  --name "$SPARK_APP_NAME" \
  --class org.apache.spark.examples.SparkPi \
  --conf "spark.kubernetes.context=$KUBE_CONTEXT" \
  --conf spark.kubernetes.namespace=spark-jobs \
  --conf spark.kubernetes.container.image=spark:4.2.0-scala2.13-java21-ubuntu \
  --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark-driver \
  --conf spark.kubernetes.authenticate.executor.serviceAccountName=spark-executor \
  --conf "spark.kubernetes.driver.pod.name=$SPARK_APP_NAME-driver" \
  --conf spark.kubernetes.driver.podTemplateFile=driver-template.yaml \
  --conf spark.kubernetes.executor.podTemplateFile=executor-template.yaml \
  --conf spark.kubernetes.executor.terminationGracePeriodSeconds=60s \
  --conf spark.driver.cores=1 \
  --conf spark.driver.memory=1g \
  --conf spark.kubernetes.driver.limit.cores=1 \
  --conf spark.executor.cores=1 \
  --conf spark.executor.memory=1g \
  --conf spark.kubernetes.executor.limit.cores=1 \
  --conf spark.executor.instances=3 \
  local:///opt/spark/examples/jars/spark-examples.jar 10
kubectl -n spark-jobs logs "$SPARK_APP_NAME-driver"
kubectl -n spark-jobs get pod "$SPARK_APP_NAME-driver" -o jsonpath='{.status.phase}{"\n"}'
运行提交脚本前先应用 rbac.yaml。版本化的官方镜像包含 spark-examples.jar 符号链接;local:/// 表示制品已在容器中,而不是要从本地笔记本上传的文件。若有需要,请通过常规供应链流程镜像 / 固定该镜像。辅助脚本会使用新的 driver 名称和选定的 kubeconfig context;发生故障时应保留这些值供调查。
此示例会请求三个固定 executor,但配额、准入、调度、镜像拉取或节点容量都可能导致 Pod 处于 Pending。请检查 driver / executor 事件和日志;仅运行 spark-submit 并不能证明 task 执行成功。
资源包含 requests、limits 和 task slot
| Spark 设置 | Kubernetes / 默认配置影响 |
|---|---|
spark.driver.cores | 除非被覆盖,否则为 driver CPU request |
spark.executor.cores | Executor task 容量和默认 CPU request |
spark.kubernetes.{driver,executor}.request.cores | 覆盖 Kubernetes CPU request,不会覆盖 executor 的 Spark task-slot 设置 |
spark.kubernetes.{driver,executor}.limit.cores | 显式设置 CPU limit;cores 并不会自动推导出 CPU limit |
| Driver memory | Request 和 limit 均包括 heap 加配置 / 计算得出的 overhead |
| Executor memory | Request 和 limit 均包括 heap、overhead 以及适用的 off-heap / PySpark 内存 |
对于此 JVM 示例,1 GiB heap 加上默认的最小 384 MiB overhead,得到 1,408 MiB 内存 request / limit。这是已验证的默认计算,并非适用于所有作业的固定规格。Python / native 内存和自定义 ResourceProfile 需要单独审查。CPU request 低于 task 容量可能导致争用;更改 request 并不等于更改一个 executor 可运行的 Spark task 数量。
动态资源分配
Spark DRA 会根据 task 积压 / 空闲情况更改 executor 数量。它不同于面向设备的 Kubernetes DRA,也不同于节点自动扩缩器对 Pending Pod 的响应。
标准 Spark on Kubernetes 不支持 YARN 风格的外部 shuffle service。Shuffle tracking 是受支持的选项,但不是 Spark 唯一提供的机制:基于 decommission 的 shuffle 保留,以及适用且可靠的 ShuffleDataIO 实现也都是可选方案,各自有不同前提条件。
对于 shuffle-tracking 配置:
spark.dynamicAllocation.enabled=true
spark.dynamicAllocation.shuffleTracking.enabled=true
spark.dynamicAllocation.minExecutors=2
spark.dynamicAllocation.initialExecutors=3
spark.dynamicAllocation.maxExecutors=20
spark.kubernetes.allocation.batch.size=5
使用 --conf 或属性文件传递这些属性。Shuffle tracking 于 Spark 3.0 引入,在 4.2 中已默认启用;显式指定可记录所作选择。过去认为两个显式开关始终必需的说法不正确。
Tracking 会尝试保留仍持有活动 shuffle 数据的 executor。已配置的 tracking / cached-executor 空闲超时、强制终止和节点故障仍可能导致重新计算。它不是持久化共享存储。启用相互重叠的数据保留机制可能延迟释放 executor;应测试它们的交互行为。
初始 executor 数量会考虑 minExecutors、initialExecutors 和现有的 spark.executor.instances 值。此示例固定请求三个 executor,与三个初始 executor 一致;min=2 并不表示启动时必须只有两个。
spark.kubernetes.allocation.batch.size 控制一批 Pod 请求的数量。它不是直接的 EC2 扩缩策略:API 限流、Pod 分配时间、ResourceQuota、调度限制和节点预置仍需分别考虑。
优雅 decommission 属于尽力而为
以下设置会启用 executor / block-manager decommission,以及适用的 RDD / shuffle block 迁移:
spark.decommission.enabled=true
spark.storage.decommission.enabled=true
spark.storage.decommission.rddBlocks.enabled=true
spark.storage.decommission.shuffleBlocks.enabled=true
spark.kubernetes.executor.terminationGracePeriodSeconds=60s
在所选的 Spark 4.2 Kubernetes 路径中,启用 decommission 会注入一个 preStop hook,运行 spark.kubernetes.decommission.script;默认脚本是 /opt/decom.sh。官方镜像包含该脚本。该脚本会查找 executor JVM、发送 SIGPWR 并等待;Spark 默认的 decommission 信号是 PWR。因此,正常 Pod 终止由此 hook 介导,不能假设发送普通 SIGTERM 就会自动迁移数据。
自定义镜像必须包含可正常工作的脚本及其工具;如果更改信号,脚本必须相应匹配。Spark 可能会覆盖模板中的 lifecycle 设置。应检查实际 hook,并分别测试计划内缩容和中断路径。
此提交显式设置 spark.kubernetes.executor.terminationGracePeriodSeconds=60s。Spark 4.2 会使用此设置覆盖 Pod template 中的值;该设置默认是 30 秒。只在模板中设置 terminationGracePeriodSeconds: 60 并不够。宽限期包括 preStop 执行时间。它是一个可用时间上限,并不保证数据迁移一定完成,也不会延迟底层 Spot 终止期限。还需要健康的目标 executor、磁盘 / 网络容量、时间,以及任何已配置的回退存储。节点硬故障或强制删除可能完全跳过迁移机会。显式删除宽限期设置(包括 Spark 动态分配删除路径中的设置)也会改变可用时间。
这些标志不会重启失败的 driver、替代应用 checkpoint,也不保证端到端输出恰好一次。应区分可重新计算的中间 block 与持久输入 / 输出,并据此制定恢复计划。
参考资料和验证范围
已在本地运行 SparkPi 作业,driver 绑定到 loopback 并禁用了 UI。Spark 4.2 原生 feature-step 测试确认了内存映射、默认 CPU limit 行为和自动插入 decommission hook,未创建 Kubernetes client。这些检查并不能证明 EKS 提交、RBAC / CNI 执行、实际迁移完成或 AWS 数据访问成功。
- Kubernetes 上的 Spark 4.2.0
- Spark 4.2.0 配置
- Spark 4.2.0 动态资源分配替代方案
- Driver 资源映射
- Executor 资源和 decommission hook
- 官方 decommission 脚本
- 官方 Spark 镜像标签